
Apuntes · Capítulo 15Transacciones y distribuidos
Recuperación: log, WAL y ARIES
Recuperación: log, WAL y ARIES
En la semana 13 repartimos las cuatro letras de ACID entre las partes del DBMS. El aislamiento le tocó al control de concurrencia, y la semana pasada vimos cómo lo logra: locks, deadlocks, MVCC. La consistencia es responsabilidad de quien escribe las transacciones, con ayuda de las restricciones. Quedaron dos letras, la A y la D, y las dos le tocan al mismo componente: el sistema de recuperación (recovery system).
- Atomicidad: si una transacción no termina, no debe quedar ningún
rastro de lo que alcanzó a hacer. Da lo mismo si no terminó porque hizo
ROLLBACK, porque violó una restricción, porque el sistema la eligió como víctima de un deadlock o porque se cortó la luz. - Durabilidad: si el DBMS respondió que una transacción hizo commit, sus cambios sobreviven a cualquier caída posterior, aunque sea un milisegundo después.
En la semana 9 vimos por qué esto no es trivial. Las páginas modificadas viven en el buffer pool, en memoria, y el buffer manager las escribe en disco cuando le conviene, no cuando la transacción termina. En el momento de una caída puede haber en disco cambios de transacciones que nunca hicieron commit, y puede faltar en disco lo que hicieron transacciones que sí lo hicieron. La herramienta para arreglar las dos cosas es el log: un archivo donde, antes de tocar los datos, el motor anota qué va a cambiar. Escribir al final de un archivo es secuencial y barato; escribir páginas sueltas por todo el disco, no.
El capítulo tiene dos partes. En la primera clasificamos los fallos, vemos qué almacenamiento sobrevive a cada uno, definimos los registros del log y la regla que los ordena (write-ahead logging, WAL), y deducimos cuándo hace falta deshacer (undo) y cuándo rehacer (redo) a partir de cómo trabaja el buffer pool. Terminamos con el algoritmo de recuperación del libro y con el WAL de PostgreSQL, que vamos a leer registro por registro. En la segunda parte vemos ARIES, el algoritmo que usan casi todos los motores comerciales: LSNs, compensation log records, checkpoints que no detienen el sistema y las tres fases de la recuperación, con un ejemplo completo y un simulador en Node.js. Cerramos con los checkpoints de PostgreSQL, una caída provocada de verdad y lo que hace falta cuando lo que se pierde es el disco.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “Lo que se pierde en una caída” y “Clasificación de fallos”. Sesión B: “Tres ideas”, de “ARIES”.
- En clase. Sesión A: “Almacenamiento volátil, no volátil y estable”, “El log”, “Steal, force y lo que cada política exige”, “La regla WAL”, “El algoritmo de recuperación del libro” y “El WAL de PostgreSQL”. Sesión B: “ARIES”, “Las tres fases de ARIES”, “Un ejemplo completo”, “Checkpoints y recuperación en PostgreSQL” y “Cuando se pierde el disco”.
- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 19.1–19.7 y 19.9. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-15, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
Lo que se pierde en una caída
Un envío a medias
Registrar la entrega de un envío en Chasqui toca dos tablas: se agrega una
fila a shipment_event con kind = 'delivered' y se actualizan status y
delivered_at en shipment. Es una transacción:
BEGIN;
INSERT INTO shipment_event (shipment_id, seq, at, agency_id, kind)
VALUES (503, 2, now(), 20, 'delivered');
UPDATE shipment
SET status = 'delivered', delivered_at = now()
WHERE shipment_id = 503;
COMMIT;
Cada sentencia cambia una página en el buffer pool: la última página de
shipment_event, la página de shipment donde está el envío 503 y, de
paso, una hoja del índice de la clave primaria de shipment_event. Ninguna
de esas páginas tiene por qué llegar al disco en el COMMIT. Ahora
imaginen un corte de luz en tres momentos distintos:
- Entre el
INSERTy elUPDATE. La transacción no terminó. Si el buffer manager ya había escrito la página deshipment_event(por ejemplo, porque necesitaba el marco para otra página), en disco queda un eventodeliveredde un envío que sigue en estadoregistered. Hay que deshacer ese cambio. - Justo después del
COMMIT. El cliente recibióCOMMIT; para él, el envío está entregado. Si ninguna de las páginas llegó al disco, al volver a arrancar no hay rastro de la entrega. Hay que rehacer los dos cambios. - Mientras se escribe una página. El disco escribe sectores de 512 bytes o 4 KiB; una página de PostgreSQL tiene 8 KiB. Un corte en medio deja una página con la mitad nueva y la mitad vieja (una torn page). No es ni el estado de antes ni el de después.
Un DBMS tiene que sobrevivir a los tres casos sin que nadie revise nada a mano. Para eso no basta con los datos: necesita una descripción, guardada en un lugar que sobreviva a la caída, de lo que cada transacción cambió. Esa descripción es el log.
Idea clave. La recuperación tiene dos partes que trabajan juntas. En operación normal, el sistema anota en el log lo necesario para poder deshacer y rehacer. Después de una falla, lee el log y lleva la base a un estado donde están todos los cambios de las transacciones que hicieron commit y ninguno de las demás.
Clasificación de fallos
Silberschatz (sec. 19.1) distingue los fallos según lo que se pierde.
Fallo de una transacción
La transacción no puede seguir, pero el sistema sí. Hay dos clases:
- Error lógico (logical error): la transacción encuentra una condición
que le impide terminar. Un dato de entrada malo, una fila que no existe,
una restricción violada. En Chasqui, un
INSERTenshipmentconweight_kg = 0violashipment_weight_kg_check. - Error del sistema (system error): el sistema entra en un estado que
obliga a terminar la transacción, aunque ella no hizo nada malo. El ejemplo
típico es el deadlock de la semana 14: PostgreSQL aborta a una de las
transacciones del ciclo con el error
40P01. Esa transacción se puede reintentar más tarde.
En los dos casos la memoria está intacta. Lo que hay que hacer es un rollback de esa transacción, y el sistema sigue funcionando.
Caída del sistema
Un corte de luz, un bug del DBMS, un kernel panic. Se pierde todo lo que estaba en memoria volátil: el buffer pool, el buffer del log, las tablas del lock manager. Las transacciones que estaban corriendo se interrumpen. Se supone que el contenido del almacenamiento no volátil queda intacto: es la suposición fail-stop. Un sistema bien diseñado tiene muchas verificaciones internas (checksums en las páginas, aserciones en el código) que lo detienen apenas detecta algo raro, justamente para no seguir escribiendo basura en disco.
Este es el caso que ocupa casi todo el capítulo: después de una caída hay que deshacer a las transacciones que no terminaron y rehacer a las que sí.
Fallo del disco
Un sector ilegible, una cabeza que toca el plato, un SSD que se gasta, un
rm equivocado en el directorio de datos. Se pierde almacenamiento no
volátil. El log de ese disco no ayuda, porque también se puede haber
perdido. Hacen falta copias en otro lugar: un backup y el log archivado desde
ese backup (sec. 19.6, al final del capítulo), o un servidor de respaldo que
recibe el log en otro sitio (sec. 19.7).
Error común. Pensar que una caída del sistema y un fallo de disco son lo mismo con distinta gravedad. Se resuelven con mecanismos distintos. Para la caída basta el log que está en el mismo servidor; para el fallo de disco hacen falta copias fuera de ese disco. Un RAID protege contra la pérdida de un disco, pero no contra un
DELETEequivocado: eseDELETEtambién se copia en todos los discos.
Almacenamiento volátil, no volátil y estable
Los tres tipos
La semana 9 separó la jerarquía de almacenamiento en volátil y no volátil. Para la recuperación hace falta un tercer tipo, que es una idealización (sec. 19.2):
| Tipo | Ejemplos | Sobrevive a |
|---|---|---|
| Volátil | memoria principal, cachés | nada: se pierde con una caída |
| No volátil | disco magnético, SSD, cinta | caídas del sistema, pero no fallos del propio dispositivo |
| Estable (stable storage) | varias copias no volátiles con fallos independientes | se supone que a todo |
Nada es estable de verdad: un incendio o una inundación pueden destruir todas las copias que estén en el mismo edificio. Pero con suficientes copias en suficientes lugares, la probabilidad de perderlas todas se vuelve despreciable. El log se escribe en almacenamiento estable, o en lo más parecido que se tenga.
Cómo se aproxima el almacenamiento estable
La forma más simple de acercarse es guardar cada bloque dos veces, en dos discos distintos (o en dos sitios). El problema es que una escritura puede fallar a la mitad, y el libro distingue tres resultados de una transferencia entre memoria y disco:
- Éxito: la información llegó completa a su destino.
- Fallo parcial: se cortó a la mitad y el bloque quedó con información incorrecta.
- Fallo total: no se escribió nada; el bloque quedó como estaba.
Si se escribieran las dos copias a la vez, un corte podría dañar las dos. Por eso el procedimiento es secuencial:
- Escribir la información en el primer bloque.
- Cuando esa escritura terminó bien, escribir la misma información en el segundo bloque.
- La escritura está completa solo cuando terminó la segunda.
Después de una caída, el sistema revisa los pares de bloques. Si las dos copias son iguales y no tienen errores detectables (los bloques llevan una suma de verificación, un checksum), no hay nada que hacer. Si una tiene un error, se reemplaza por la otra. Si las dos están bien pero son distintas, la caída ocurrió entre los pasos 1 y 2, y se copia una sobre la otra. Cualquiera de las dos direcciones sirve: copiar la primera sobre la segunda completa la escritura, y copiar la segunda sobre la primera la deja sin efecto. En ningún caso quedan las dos dañadas. Revisar todos los bloques sería lento, así que en la práctica se anota en un lugar aparte qué escrituras estaban en curso y solo se revisan esas.
Bloques, buffers y variables locales
El libro usa un modelo simple para hablar de dónde está cada dato (sec. 19.2). La base está dividida en bloques en disco; los bloques que están en memoria se llaman buffer blocks. Hay dos operaciones entre disco y memoria:
input(B)trae el bloque físico B a memoria.output(B)escribe el buffer block B en disco, en su lugar.
Cada transacción tiene además un área de trabajo privada donde guarda copias de los ítems que lee. Para un ítem X, xᵢ es la copia de la transacción Tᵢ:
read(X)copia el valor de X a xᵢ (coninputantes, si el bloque no estaba en memoria).write(X)copia xᵢ al buffer block de X (también coninputantes, si hacía falta).
Lo importante: write(X) no escribe en disco. Cambia la copia del bloque
en memoria. El output puede pasar mucho después, o mucho antes de que la
transacción termine, y lo decide el buffer manager. Toda la dificultad de la
recuperación está en esa separación.
El log
Registros del log
El log es una secuencia de registros del log (log records), uno detrás de otro, que solo crece por el final. El libro usa cuatro tipos (sec. 19.3):
| Registro | Significado |
|---|---|
<Ti start> |
Tᵢ empezó |
<Ti, Xj, V1, V2> |
Tᵢ escribió el ítem Xⱼ: tenía el valor V1 (old value) y ahora tiene V2 (new value) |
<Ti commit> |
Tᵢ hizo commit |
<Ti abort> |
Tᵢ terminó su rollback |
El registro de update tiene todo lo necesario para las dos operaciones de recuperación: con V1 se puede deshacer (undo) el cambio, y con V2 se puede rehacer (redo). El ítem Xⱼ se identifica de forma que el sistema pueda encontrarlo en disco; en un motor real es algo como (archivo, página, posición dentro de la página).
Para que el log sirva después de una caída, tiene que estar en almacenamiento
estable. Y el orden importa: el registro de un cambio se crea antes de
hacer el cambio en el buffer block. El libro define el momento del commit
con precisión: una transacción hizo commit cuando su registro
<Ti commit> llegó a almacenamiento estable. Si la caída ocurre un
instante antes, la transacción no hizo commit, aunque ya haya ejecutado
todas sus sentencias.
Modificación diferida y modificación inmediata
Hay dos formas de usar el log (sec. 19.3):
- Modificación diferida (deferred modification): la transacción no toca la base hasta hacer commit. Sus cambios viven en su área privada; al hacer commit, se aplican. Nunca hace falta undo, porque nada de lo que no hizo commit llegó a la base. Pero la transacción tiene que guardar copias locales de todo lo que cambia, y leer sus propias escrituras se complica.
- Modificación inmediata (immediate modification): la transacción cambia los buffer blocks mientras corre, y esos bloques pueden ir a disco antes del commit. Es lo que hacen los motores reales y lo que suponemos de aquí en adelante.
Undo y redo con el log
Con modificación inmediata, el sistema dispone de dos procedimientos sobre el log (sec. 19.3):
- redo(Tᵢ) recorre los registros de Tᵢ hacia adelante y pone en cada ítem su valor nuevo.
- undo(Tᵢ) recorre los registros de Tᵢ hacia atrás y pone en cada ítem
su valor viejo. Además, por cada valor que restaura escribe en el log un
registro especial
<Ti, Xj, V>, que solo tiene el valor que se puso. Es un registro redo-only: describe un cambio que, si hiciera falta, se vuelve a aplicar, pero que nunca se deshace. Cuando termina, escribe<Ti abort>.
Después de una caída, el sistema decide qué hacer con cada transacción mirando solo el log:
- Si el log tiene
<Ti start>pero ni<Ti commit>ni<Ti abort>, se hace undo(Tᵢ): no terminó. - Si el log tiene
<Ti start>y además<Ti commit>o<Ti abort>, se hace redo(Tᵢ).
La segunda regla sorprende la primera vez: ¿por qué rehacer una transacción que abortó? Porque su rollback dejó en el log, después de los cambios originales, los registros redo-only que restauraron los valores viejos. Rehacer todo en orden, incluidos esos registros, deja los ítems con el valor viejo. Es más simple que tratar las transacciones abortadas como un caso aparte, y es la primera aparición de una idea que ARIES lleva al extremo: repetir la historia (repeating history).
Un ejemplo pequeño
Tres ítems de Chasqui: A es el price del envío 501, B el del 502 y C el
vehicle_id del viaje 12. T0 pasa 5 soles de descuento del envío 501 al
502; después, T1 cambia el vehículo del viaje 12.
<T0 start>
<T0, A, 50.25, 45.25>
<T0, B, 45.26, 50.26>
<T0 commit>
<T1 start>
<T1, C, 11, 7>
<T1 commit>
Qué hace la recuperación según dónde se corte el log (lo que llegó a almacenamiento estable):
| El log llega hasta | Decisión | Valores después de recuperar |
|---|---|---|
<T0, B, 45.26, 50.26> |
undo(T0) | A = 50.25, B = 45.26 |
<T1, C, 11, 7> |
redo(T0) y undo(T1) | A = 45.25, B = 50.26, C = 11 |
<T1 commit> |
redo(T0) y redo(T1) | A = 45.25, B = 50.26, C = 7 |
En la segunda fila, A, B y C son ítems distintos y da igual en qué orden se hagan el redo de T0 y el undo de T1. Si dos transacciones hubieran tocado el mismo ítem, no daría igual. El algoritmo de la sec. 19.4 fija un orden que funciona siempre: primero todo el redo, hacia adelante, y después todo el undo, hacia atrás. Lo vemos más abajo.
Physical, logical y physiological logging
¿Qué se guarda exactamente en V1 y V2? Hay tres estilos:
- Physical logging: los bytes de la página antes y después, en una
posición dada. “En la página 6 de
shipment, a partir del byte 4120, estos 8 bytes pasaron de esto a esto”. Es fácil de aplicar y no depende de nada más, pero puede ser enorme (si unINSERTmueve registros dentro de la página, cambian muchos bytes). - Logical logging: la operación de alto nivel. “Se ejecutó
UPDATE shipment SET price = price + 1 WHERE shipment_id = 501”. Es compacto, pero rehacer una operación lógica exige que todo lo demás (los índices, el orden de las filas) esté exactamente como estaba. Si la caída dejó una parte escrita y otra no, eso no se cumple. - Physiological logging: física para elegir la página, lógica dentro de
ella. “En la página 147 de
shipment, en el slot 65, se insertó esta tupla”. La página se identifica físicamente, pero dentro de la página el cambio se describe en términos del slotted page de la semana 9, así que se puede compactar la página sin invalidar el log. Es lo que usan los motores, y lo que vamos a ver en el WAL de PostgreSQL.
Steal, force y lo que cada política exige
Dos decisiones del buffer manager
Si la recuperación necesita undo, redo o las dos cosas depende de dos decisiones del buffer manager (sec. 19.5 y CS186):
- Force / no-force. Con force, en el commit se obliga a escribir en disco todas las páginas que la transacción modificó. Con no-force, no: el commit solo escribe el log, y las páginas van a disco cuando el buffer manager quiera.
- Steal / no-steal. Con steal, el buffer manager puede escribir en disco (y desalojar) una página que tiene cambios de una transacción que todavía no hizo commit: le “roba” el marco a esa transacción. Con no-steal, una página con cambios sin commit no sale del buffer pool hasta que la transacción termine.
Cuándo hace falta undo y cuándo redo
Las dos preguntas se contestan por separado:
- ¿Hace falta undo? Solo si en disco puede haber cambios de una transacción que no hizo commit. Eso pasa con steal.
- ¿Hace falta redo? Solo si una transacción puede haber hecho commit sin que sus páginas estén en disco. Eso pasa con no-force.
| force | no-force | |
|---|---|---|
| no-steal | ni undo ni redo | solo redo |
| steal | solo undo | undo y redo |
La esquina de arriba a la izquierda parece la ideal: no necesita recuperación. Pero cuesta mucho:
- No-steal obliga a tener en memoria todas las páginas que modificó cada
transacción activa. Una transacción que actualiza todas las filas de
shipmentenchasqui_big(24 667 páginas, más que las 16 384 deshared_buffersque vimos en la semana 9) no podría terminar. - Force obliga a hacer, en cada commit, una escritura aleatoria por cada
página modificada. Si diez transacciones seguidas cambian la misma página
caliente (la última de
shipment_event), force la escribe diez veces; no-force, quizás una. Y force tampoco es atómico por sí solo: si la caída ocurre después de escribir la mitad de las páginas, el commit queda a medias.
Por eso los motores eligen la esquina de abajo a la derecha, steal + no-force: la más rápida y la que más trabajo le da a la recuperación, que tiene que poder deshacer y rehacer.
Idea clave. Steal significa “lo que no hizo commit puede estar en disco”, y por eso exige undo. No-force significa “lo que hizo commit puede no estar en disco”, y por eso exige redo. Las dos políticas son las que hacen rápido al buffer pool, y el log es lo que las hace seguras.
Undo logging y redo logging
Las notas de CS186 describen dos esquemas que ocupan las esquinas intermedias. Ayudan a ver para qué sirve cada mitad del registro de update.
Undo logging (steal + force). Los registros de update guardan solo el valor viejo. Hay dos reglas: el registro de un cambio llega al disco antes que la página modificada, y todas las páginas de la transacción llegan al disco antes que su registro de commit. Al recuperar, se lee el log desde el final hacia atrás: las transacciones con commit o abort están completas; a las demás se les restauran los valores viejos. Nunca hace falta redo, porque el commit está en el log solo si las páginas ya estaban en disco.
Redo logging (no-steal + no-force). Los registros guardan solo el valor nuevo. La regla: el registro de update y el de commit llegan al disco antes que cualquier página de la transacción. Al recuperar, se lee el log hacia adelante y se rehacen solo las transacciones con commit. Nunca hace falta undo, porque ninguna página con cambios sin commit llegó al disco.
Cada uno paga con una de las políticas caras. Guardar los dos valores en el registro de update es lo que permite steal y no-force a la vez.
La regla WAL
Las dos partes
Con steal + no-force, el orden en que el log y las páginas llegan al disco es lo único que hace posible la recuperación. La regla se llama write-ahead logging (WAL) y tiene dos partes:
- Antes de que una página modificada se escriba en disco, todos los registros del log que describen cambios de esa página tienen que estar en almacenamiento estable. Así, si la página tiene un cambio sin commit, siempre está en el log el valor viejo para deshacerlo. Esta parte es la que permite steal.
- Antes de que el commit responda, todos los registros de la
transacción, incluido
<Ti commit>, tienen que estar en almacenamiento estable. Así, si las páginas no llegaron, siempre está en el log el valor nuevo para rehacerlas. Esta parte es la que permite no-force.
El libro (sec. 19.5) agrega una tercera regla que se sigue del orden del
log: los registros se escriben en el orden en que se crearon. Si el registro
<Ti commit> está en almacenamiento estable, también lo están todos los
anteriores.
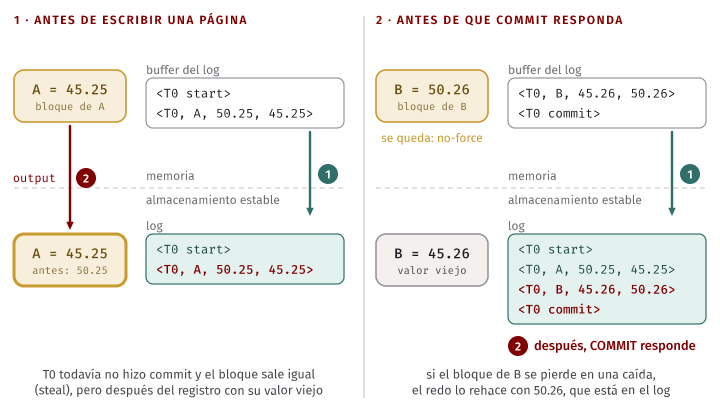
Error común. Pensar que
COMMITescribe las páginas de datos en disco. Con no-force, solo fuerza el log hasta el registro de commit. Las páginas las escriben después otros procesos: en PostgreSQL, el background writer y el checkpointer. Un commit cuesta una escritura secuencial del log, no una escritura por cada página tocada.
El buffer del log y group commit
Escribir en almacenamiento estable cada registro apenas se crea sería muy caro: un registro de update tiene unas decenas de bytes y el disco escribe bloques. Por eso el log también tiene un buffer en memoria (sec. 19.5). Los registros se acumulan ahí y se escriben en bloques. Las dos partes de la regla WAL dicen cuándo es obligatorio forzar ese buffer: antes de escribir una página de datos (hasta el último registro de esa página) y en cada commit (hasta el registro de commit).
En un servidor con mucha carga, varias transacciones hacen commit casi al mismo tiempo. Group commit aprovecha eso: en vez de forzar el log una vez por transacción, se espera un instante a que lleguen más commits y se fuerza el log una sola vez para todos. Cada transacción espera un poco más, pero el servidor hace muchos más commits por segundo, porque el número de escrituras al disco ya no crece con el número de commits.
El sistema operativo también tiene una caché
Cuando un programa llama a write, el sistema operativo normalmente no
escribe en el disco: copia los datos a su propia caché de páginas (la que
vimos en la semana 9) y vuelve. Si el servidor se cae, esa caché se pierde.
Para que un registro del log esté de verdad en almacenamiento no volátil,
el DBMS tiene que llamar a fsync (o fdatasync), que no vuelve hasta que
el sistema operativo confirma que los datos llegaron al dispositivo (sec.
19.5). Y el propio disco puede tener una caché de escritura volátil: la
documentación de PostgreSQL (Reliability)
advierte que un disco que responde “escrito” cuando el dato solo está en su
caché, sin batería que la proteja, rompe la durabilidad aunque el DBMS haga
todo bien.
Idea clave. Con Sistemas Operativos: un file system con journaling, como ext4, anota en el journal la operación sobre los metadatos (crear un archivo, asignar bloques) antes de hacerla, y al montar después de una caída vuelve a aplicar las operaciones completas del journal. Es la misma idea que el WAL. La diferencia está en lo que cada uno sabe: el log de un DBMS conoce las transacciones y puede deshacer las que no terminaron; el journal típico solo rehace operaciones completas y descarta las incompletas.
El algoritmo de recuperación del libro
Checkpoints
Con lo visto hasta aquí, la recuperación tendría que leer el log desde el principio: cualquier transacción, por vieja que sea, podría tener cambios que no llegaron al disco. Con un log de meses, la recuperación tardaría horas, y casi todo ese trabajo sería inútil: la mayoría de esas páginas se escribieron hace mucho.
Un checkpoint acota cuánto log hay que leer. La versión simple del libro (sec. 19.3) hace tres cosas, sin que ninguna transacción haga updates mientras tanto:
- Escribir en almacenamiento estable todos los registros del log que están en memoria.
- Escribir en disco todos los buffer blocks modificados.
- Escribir en almacenamiento estable un registro
<checkpoint L>, donde L es la lista de transacciones activas en ese momento.
Después del checkpoint, todo cambio anterior a él está en disco. Al recuperar, solo importan las transacciones de L y las que empezaron después del checkpoint. El problema es el “sin que ninguna transacción haga updates”: mientras se escriben todas las páginas sucias, el sistema está detenido. Con un buffer pool de varios gigabytes, eso son segundos o minutos sin atender a nadie. La Sesión B lo arregla.
Rollback en operación normal
Antes de la caída, veamos qué pasa cuando una transacción Tᵢ hace rollback mientras el sistema funciona (sec. 19.4):
- Se recorre el log hacia atrás desde el final.
- Por cada registro
<Ti, Xj, V1, V2>, se escribe V1 en Xⱼ y se agrega al log el registro redo-only<Ti, Xj, V1>. - Al llegar a
<Ti start>, se escribe<Ti abort>y se termina.
Un rollback normal, entonces, también escribe en el log. El log de una
transacción abortada se lee así: cambios hacia adelante, sus compensaciones
hacia atrás y el abort.
Recuperación después de una caída
El algoritmo del libro (sec. 19.4) tiene dos fases:
Fase de redo. Se busca el último <checkpoint L> y se lee el log hacia
adelante desde ahí. Se mantiene una undo-list, que empieza siendo L.
- Cada registro de update
<Ti, Xj, V1, V2>o redo-only<Ti, Xj, V>se rehace: se escribe V2 (o V) en Xⱼ. Todos, de todas las transacciones, hayan hecho commit o no. - Con
<Ti start>, Tᵢ entra a la undo-list. - Con
<Ti commit>o<Ti abort>, Tᵢ sale de la undo-list.
Al final, la undo-list tiene las transacciones que no hicieron ni commit ni abort: las que estaban a medias.
Fase de undo. Se lee el log hacia atrás desde el final.
- Cada registro de update de una transacción de la undo-list se deshace
como en un rollback normal: se escribe V1 y se agrega
<Ti, Xj, V1>. - Al llegar a
<Ti start>de una transacción de la undo-list, se escribe<Ti abort>y Tᵢ sale de la lista. - Se termina cuando la undo-list queda vacía. Si una transacción de la lista
empezó antes del checkpoint, el recorrido hacia atrás sigue más allá del
checkpoint hasta su
<Ti start>.
Al terminar, las transacciones que estaban a medias quedan exactamente como
si hubieran hecho un rollback normal, con su <Ti abort> en el log, y el
sistema vuelve a aceptar transacciones.
Un ejemplo con checkpoint y rollback
Seguimos con A (price del envío 501), B (price del 502) y C (price del
503). Los números de la izquierda solo sirven para referirse a cada registro.
 1  <T1 start>
 2  <T1, A, 50.25, 45.25>
 3  <T2 start>
 4  <checkpoint {T1, T2}>
 5  <T2, B, 45.26, 40.00>
 6  <T1 commit>
 7  <T3 start>
 8  <T3, C, 114.90, 120.00>
 9  <T2, A, 45.25, 47.00>
10  <T2, A, 45.25>
11  <T2, B, 45.26>
12  <T2 abort>
13  <T3, A, 45.25, 44.00>
---- caída ----
T2 hizo un rollback normal antes de la caída: los registros 10 y 11 son sus compensaciones, hacia atrás (primero A, que cambió último, después B), y 12 es su abort.
Redo, desde el checkpoint (registro 4). La undo-list empieza como {T1, T2}.
| Registro | Acción | undo-list |
|---|---|---|
| 5 | B = 40.00 | {T1, T2} |
| 6 | T1 hizo commit | {T2} |
| 7 | T3 empieza | {T2, T3} |
| 8 | C = 120.00 | {T2, T3} |
| 9 | A = 47.00 | {T2, T3} |
| 10 | A = 45.25 | {T2, T3} |
| 11 | B = 45.26 | {T2, T3} |
| 12 | T2 terminó su rollback | {T3} |
| 13 | A = 44.00 | {T3} |
El registro 2 no se rehace: es anterior al checkpoint, y el checkpoint escribió en disco todas las páginas sucias, incluida la de A.
Undo, desde el final hacia atrás, solo para T3:
| Registro | Acción | Se escribe en el log |
|---|---|---|
| 13 | A = 45.25 | <T3, A, 45.25> |
| 8 | C = 114.90 | <T3, C, 114.90> |
| 7 | T3 llegó a su start | <T3 abort> |
Resultado: A = 45.25 (el valor que dejó T1, que hizo commit), B = 45.26 (T2 se deshizo) y C = 114.90 (T3 se deshizo). Fíjense en el registro 9: T2 lo escribió y lo deshizo antes de la caída. El redo vuelve a aplicar el cambio (A = 47.00) y enseguida su compensación (A = 45.25), sin preguntar si T2 hizo commit. Repetir la historia completa es lo que permite que la fase de undo solo tenga que mirar a T3.
Idempotencia
¿Qué pasa si el sistema vuelve a caer durante la recuperación? Se vuelve a empezar. Para que eso funcione, rehacer o deshacer un cambio tiene que ser idempotente: aplicarlo una vez o varias tiene que dar el mismo resultado. Escribir “A = 45.25” es idempotente; “restar 5 a A” no lo es. Por eso los registros del libro guardan valores, no operaciones.
Además, la fase de undo escribe registros mientras trabaja. Si la caída
ocurre a la mitad del undo, los registros redo-only que ya se escribieron se
rehacen en el siguiente arranque, y el <Ti abort> (si alcanzó a
escribirse) saca a la transacción de la undo-list. La recuperación siempre
avanza.
Error común. Pensar que undo solo hace falta cuando una transacción hace
ROLLBACK. Con steal, una caída deja en disco cambios de transacciones que nunca hicieron commit ni rollback: estaban corriendo. La fase de undo existe sobre todo para ellas.
El WAL de PostgreSQL
Steal, no-force y sin undo
El buffer pool de PostgreSQL es steal y no-force, como el de cualquier motor: el background writer escribe páginas sucias aunque tengan cambios sin commit, y el commit solo fuerza el WAL. Según la tabla de arriba, necesitaría undo y redo. Pero su WAL es solo de redo: no hay fase de undo.
La razón es MVCC, que vimos la semana pasada. Un UPDATE no sobrescribe la
fila: escribe una versión nueva con xmin igual al identificador de la
transacción, y marca la vieja con xmax. Si la transacción no hace commit,
las dos versiones quedan en la página, pero la nueva es invisible y la vieja
sigue visible, porque la decisión se toma mirando el estado de la
transacción en pg_xact (el commit log: dos bits por transacción, que dicen
si está en curso, hizo commit o abortó). Una transacción que no llegó a
escribir su registro de commit nunca figura como confirmada. Deshacer, en
PostgreSQL, es no hacer nada: las versiones de una transacción abortada se
ignoran y VACUUM las limpia después.
El precio es otro: la tabla se llena de versiones muertas y hace falta
VACUUM. Otros motores con MVCC, como Oracle o MySQL con InnoDB, guardan
las versiones viejas en un área aparte (el undo log o los rollback
segments), y esos sí necesitan una fase de undo.
En PostgreSQL. El log se llama WAL, vive en el directorio
pg_waldentro del directorio de datos y está partido en archivos (segmentos) de 16 MB. Dentro del contenedor:$ ls -l $PGDATA/pg_wal | head -3 total 753672 -rw------- 1 postgres postgres 16777216 Nov 1 20:30 0000000100000001000000EE -rw------- 1 postgres postgres 16777216 Nov 1 20:29 0000000100000001000000EFEl nombre de cada segmento son tres números de 8 dígitos hexadecimales: la línea de tiempo (timeline, que cambia después de un point-in-time recovery) y la posición del segmento en el WAL.
LSN: una posición en bytes
Cada registro del WAL se identifica por su LSN (log sequence number).
En PostgreSQL, el LSN es la posición en bytes del registro en el flujo del
WAL, un número de 64 bits que se muestra como dos mitades en hexadecimal:
1/A6E7FE70 quiere decir 0x1A6E7FE70. Como el WAL solo crece, los LSN
crecen. wal.sql empieza mostrando la configuración y la posición actual
(en una corrida en chasqui_w15):
        name        | setting  | unit
--------------------+----------+------
 checkpoint_timeout | 300      | s
 data_checksums     | on       |
 full_page_writes   | on       |
 max_wal_size       | 1024     | MB
 synchronous_commit | on       |
 wal_level          | replica  |
 wal_segment_size   | 16777216 | B
(7 rows)

    lsn     |         segment
------------+--------------------------
 1/A6E7FE70 | 0000000100000001000000A6
(1 row)
El LSN 1/A6E7FE70 está en el segmento ...00000001000000A6: el LSN
dividido por 16 MB (2²⁴ bytes) da el número de segmento, 0x1A6, que en el
nombre se escribe en dos partes, 00000001 y 000000A6. El resto,
0xE7FE70, es la posición dentro del segmento.
Los registros de una transacción
Ahora la transacción del laboratorio: un CHECKPOINT, y después un INSERT
en shipment_event (copia el último evento del envío 501 con el número de
secuencia siguiente) y un UPDATE del precio del envío 501, en la misma
transacción. Con pg_current_wal_insert_lsn() antes y después se guarda el
rango del WAL que ocupó, y pg_get_wal_records_info de la extensión
pg_walinspect lo muestra registro por registro:
CHECKPOINT;
SELECT pg_current_wal_insert_lsn() AS antes \gset
BEGIN;
INSERT INTO shipment_event (shipment_id, seq, at, agency_id, kind)
SELECT shipment_id, seq + 1, now(), agency_id, kind
FROM shipment_event
WHERE shipment_id = 501
ORDER BY seq DESC
LIMIT 1;
UPDATE shipment SET price = price + 1 WHERE shipment_id = 501;
SELECT pg_current_xact_id() AS xid \gset
COMMIT;
SELECT pg_current_wal_insert_lsn() AS despues \gset

SELECT start_lsn, end_lsn, prev_lsn, xid, resource_manager AS rmgr,
  record_type, record_length AS len, fpi_length AS fpi,
  pg_filenode_relation(0, substring(block_ref FROM 'rel \d+/\d+/(\d+)')::oid) AS rel,
  substring(block_ref FROM 'blk (\d+)')::int AS blk
FROM pg_get_wal_records_info(:'antes', :'despues')
WHERE xid = :'xid' OR block_ref LIKE :'esta_base';
\gset guarda el resultado de una consulta en variables de psql. La
columna block_ref dice qué página toca cada registro, como
rel 1663/84015/84105 fork main blk 147 (tablespace, base de datos,
archivo de la relación y número de bloque); las dos últimas columnas de la
consulta la traducen al nombre de la relación y al bloque. El WHERE deja
solo los registros de esta transacción o de esta base, porque el servidor
del contenedor puede tener otras bases con actividad al mismo tiempo. El
resultado:
 start_lsn  |  end_lsn   |  prev_lsn  |  xid  |    rmgr     |   record_type   | len  | fpi  |         rel         | blk
------------+------------+------------+-------+-------------+-----------------+------+------+---------------------+-----
 1/A6E82070 | 1/A6E84068 | 1/A6E82038 |     0 | XLOG        | FPI_FOR_HINT    | 8157 | 8108 | pg_statistic        |  22
 1/A6E84068 | 1/A6E860B8 | 1/A6E82070 |     0 | XLOG        | FPI_FOR_HINT    | 8241 | 8192 | pg_statistic        |  23
 1/A6E860B8 | 1/A6E86BD0 | 1/A6E84068 | 24439 | Heap        | INSERT          | 2838 | 2784 | shipment_event      | 341
 1/A6E86BD0 | 1/A6E88920 | 1/A6E860B8 | 24439 | Btree       | INSERT_LEAF     | 7473 | 7420 | shipment_event_pkey |   7
 1/A6E88920 | 1/A6E8A958 | 1/A6E86BD0 | 24439 | XLOG        | FPI_FOR_HINT    | 8221 | 8172 | pg_statistic        |  20
 1/A6E8A958 | 1/A6E8C958 | 1/A6E88920 | 24439 | Heap        | LOCK            | 8167 | 8108 | shipment            |   6
 1/A6E8C958 | 1/A6E8D198 | 1/A6E8A958 | 24439 | Heap        | LOCK            | 2111 | 2052 | agency              |   0
 1/A6E8D198 | 1/A6E8F078 | 1/A6E8C958 | 24439 | XLOG        | FPI_FOR_HINT    | 7877 | 7828 | pg_proc             |  33
 1/A6E8F078 | 1/A6E8F0B0 | 1/A6E8D198 | 24439 | Heap2       | PRUNE_ON_ACCESS |   52 |    0 | pg_proc             |  33
 1/A6E8F0B0 | 1/A6E8F0E8 | 1/A6E8F078 | 24439 | Heap        | LOCK            |   54 |    0 | shipment            |   6
 1/A6E8F0E8 | 1/A6E90A60 | 1/A6E8F0B0 | 24439 | Heap        | UPDATE          | 6489 | 6416 | shipment            | 147
 1/A6E90A60 | 1/A6E92798 | 1/A6E8F0E8 | 24439 | Btree       | INSERT_LEAF     | 7453 | 7400 | shipment_pkey       |   2
 1/A6E92798 | 1/A6E927C0 | 1/A6E90A60 | 24439 | Transaction | COMMIT          |   34 |    0 |                     |
(13 rows)
Dos sentencias produjeron trece registros. Vamos por partes.
Heap INSERTen la página 341 deshipment_event: la tupla nueva. La columnarmgr(resource manager) dice qué parte del motor sabe aplicar el registro:Heappara tablas,Btreepara índices B+ tree,Transactionpara commits y aborts,XLOGpara el propio WAL.Btree INSERT_LEAFen la hoja 7 deshipment_event_pkey: la entrada del índice de la clave primaria. Cada índice se mantiene con sus propios registros; si la tabla tuviera tres índices, habría tres.- Dos
Heap LOCK, en la página 6 deshipmenty la página 0 deagency: son las verificaciones de las claves foráneas deshipment_event. Para comprobar que el envío 501 y la agencia existen, PostgreSQL bloquea esas filas en modoFOR KEY SHARE(así nadie las borra antes del commit), y como los locks de fila se guardan en la tupla (enxmax, semana 14), cambiar la tupla deja un registro en el WAL. - Otro
Heap LOCKy elHeap UPDATEenshipment. El envío 501 está en la página 6, que está llena; la versión nueva se escribió en la página 147, la última. Antes de soltar la página 6 para ir a buscar espacio en otra, elUPDATEmarca la versión vieja como bloqueada, y eso también se anota. Como la versión nueva quedó en otra página, el update no es HOT, y el índiceshipment_pkeynecesita una entrada nueva: el segundoBtree INSERT_LEAF. Transaction COMMIT: el registro de commit, de 34 bytes. Es el<Ti commit>del libro, y elCOMMITde la sesión no responde hasta que el WAL está en disco hasta suend_lsn.FPI_FOR_HINTyPRUNE_ON_ACCESSenpg_statisticypg_proc: son tablas del catálogo, que el motor leyó para planear las consultas. Al leerlas, actualizó hint bits (bits en la cabecera de la tupla que guardan el resultado de consultarpg_xact) y limpió versiones muertas. Con los data checksums activados (PostgreSQL 18 los activa por defecto al crear el cluster), cambiar solo hint bits también cambia el checksum de la página, y la primera vez después de un checkpoint se copia la página entera al WAL.
En PostgreSQL. La columna
prev_lsnno es el prevLSN de ARIES que vamos a ver en la Sesión B. Apunta al registro anterior en todo el WAL, de cualquier transacción: el primer registro de la tabla tieneprev_lsn1/A6E82038, un registro que elWHEREdejó afuera (de otra base, o sin página asociada). PostgreSQL no necesita encadenar los registros de cada transacción, porque no recorre esa cadena hacia atrás para hacer undo.
Full-page writes
La columna fpi es la que más llama la atención: el registro del INSERT
mide 2838 bytes, pero la tupla nueva tiene menos de 100. Los otros 2784 son
una imagen completa de la página (full-page image, FPI).
Es la defensa de PostgreSQL contra las torn pages del principio del
capítulo. Una página de 8 KiB no se escribe de forma atómica: si el corte
llega a la mitad, la página queda con la mitad de cada versión, y un
registro physiological (“en el slot 46 se insertó esta tupla”) no se puede
aplicar sobre una página que no es ninguna versión coherente. La solución,
con full_page_writes = on: la primera vez que se modifica una página
después de un checkpoint, el registro del WAL lleva la página entera. Al
recuperar, el redo empieza en el checkpoint, así que lo primero que
encuentra para esa página es su imagen completa, y la copia encima de lo que
haya en disco, esté roto o no. Los registros siguientes se aplican sobre
esa imagen.
La imagen no siempre mide 8192 bytes, porque PostgreSQL no copia el hueco
libre entre pd_lower y pd_upper de la slotted page. La imagen de la
página 0 de agency mide 2052 bytes: en la semana 9 vimos que esa página
tenía 6140 bytes libres, y 8192 − 6140 = 2052.
Si se repite el UPDATE, sin CHECKPOINT de por medio:
 start_lsn  |  end_lsn   |  xid  |    rmgr     |   record_type   | len | fpi |   rel    | blk
------------+------------+-------+-------------+-----------------+-----+-----+----------+-----
 1/A6E98760 | 1/A6E98798 |     0 | Heap2       | PRUNE_ON_ACCESS |  56 |   0 | shipment |   6
 1/A6E98798 | 1/A6E987E0 | 24440 | Heap        | HOT_UPDATE      |  71 |   0 | shipment | 147
 1/A6E987E0 | 1/A6E98808 | 24440 | Transaction | COMMIT          |  34 |   0 |          |
(3 rows)
Ahora el update es un HOT_UPDATE de 71 bytes y sin imagen: la página 147
ya tuvo su imagen completa después del último checkpoint, y la versión
nueva cupo en la misma página, así que no hizo falta tocar el índice. El
PRUNE_ON_ACCESS de la página 6 lo hizo la consulta al pasar: limpió la
versión muerta que dejó el primer UPDATE (por eso tiene xid 0; no es
parte de ninguna transacción). pg_get_wal_stats resume el rango por
resource manager (cuenta todo lo que hay en el rango, también de otras
bases; aquí no había nada más):
    rmgr     | count | record_size | fpi_size
-------------+-------+-------------+----------
 Transaction |     1 |          34 |        0
 Heap2       |     1 |          56 |        0
 Heap        |     1 |          71 |        0
(3 rows)
La diferencia entre las dos corridas es el costo de los full-page writes: justo después de un checkpoint, el WAL crece mucho más rápido. Es una de las razones para no hacer checkpoints demasiado seguidos.
El pageLSN de una página real
En la semana 9 vimos que los primeros 8 bytes del encabezado de una página
de PostgreSQL son pd_lsn. Ahora sabemos qué guardan:
   ctid
----------
 (147,65)
(1 row)

  page_lsn
------------
 1/A6E987E0
(1 row)
La versión actual del envío 501 está en el slot 65 de la página 147, y el
LSN de la página es 1/A6E987E0: el end_lsn del HOT_UPDATE, el último
registro que la cambió. PostgreSQL guarda en la página el final del
último registro; ARIES, en la Sesión B, guarda el comienzo. La idea es la
misma: con ese número, el motor sabe qué registros del WAL ya están
aplicados en la página. Y el buffer manager lo usa para cumplir la primera
parte de la regla WAL: antes de escribir una página, fuerza el WAL hasta su
pd_lsn.
Commit síncrono y asíncrono
synchronous_commit = on es la segunda parte de la regla WAL: el COMMIT
no responde hasta que el WAL llegó a disco. Con synchronous_commit = off
(que se puede cambiar por sesión o por transacción, con SET), el commit
responde apenas el registro está en el buffer del WAL, y el proceso WAL
writer lo escribe un poco después, cada wal_writer_delay (200 ms por
defecto). Una caída puede perder los últimos commits: según la
documentación (Asynchronous Commit),
como mucho, unas tres veces wal_writer_delay. Pero la base nunca queda
inconsistente: se pierden transacciones completas, en el orden del WAL, como
si no hubieran ocurrido.
fsync = off es otra cosa, mucho más peligrosa: PostgreSQL deja de llamar a
fsync, y ya no sabe en qué orden llegan las cosas al disco. Una página
puede llegar antes que el WAL que la describe, y eso rompe la primera parte
de la regla WAL. Una caída puede dejar la base corrupta.
PostgreSQL hace group commit por su cuenta: cuando varios procesos esperan
que el WAL llegue a disco, el primero que llama a fsync arrastra los
registros de commit de los demás, si ya estaban en el buffer.
commit_delay (0 por defecto) agrega una espera a propósito para juntar
más.
ARIES
Tres ideas
ARIES (Algorithm for Recovery and Isolation Exploiting Semantics) es el algoritmo que C. Mohan y sus colegas de IBM publicaron en 1992, y es la base de la recuperación de DB2, SQL Server y muchos otros motores. Funciona con steal + no-force y descansa en tres ideas:
- Write-ahead logging, con la regla de la Sesión A.
- Repetir la historia en el redo (repeating history): después de una caída, primero se deja la base exactamente como estaba en el momento de la caída, con los cambios de todas las transacciones, hayan hecho commit o no. Recién después se deshace a las que no terminaron.
- Anotar en el log lo que se hace durante el undo, con registros de compensación, para no deshacer nunca dos veces el mismo cambio, aunque haya caídas repetidas.
Las tres ya aparecieron en el algoritmo del libro. Lo que ARIES agrega son números que permiten saltarse trabajo: comparar un número con otro para saber, sin leer una página, que no hace falta rehacer nada en ella.
LSN, pageLSN y prevLSN
- LSN. Cada registro del log tiene un log sequence number único y creciente. En los ejemplos usaremos 10, 20, 30; en PostgreSQL es la posición en bytes.
- pageLSN. Cada página guarda el LSN del último registro del log que la modificó. Al aplicar un cambio en el buffer pool, se actualiza el pageLSN de la página. Si la página llega a disco, su pageLSN llega con ella: el pageLSN en disco dice hasta qué registro está aplicada esa copia.
- flushedLSN. El sistema sabe hasta qué LSN está escrito el log en almacenamiento estable. Con esto, la primera parte de la regla WAL se vuelve una comparación: una página solo puede ir a disco si su pageLSN ≤ flushedLSN. Si no, primero hay que forzar el log hasta el pageLSN.
- prevLSN. Cada registro guarda el LSN del registro anterior de la misma transacción. Los registros de cada transacción quedan encadenados hacia atrás, y el undo puede recorrer la cadena sin leer los registros de las demás.
Un registro de update de ARIES tiene, entonces: LSN, transacción, tipo, prevLSN, página, y los datos para undo y redo de esa página (physiological).
La transaction table y la dirty page table
Mientras el sistema funciona, el DBMS mantiene en memoria dos tablas:
- Transaction table (TT): una fila por transacción activa, con su estado (running, committed o aborting) y su lastLSN, el LSN del último registro que escribió. El lastLSN es el comienzo de su cadena de prevLSN.
- Dirty page table (DPT): una fila por página sucia del buffer pool, con su recLSN: el LSN del primer registro que la ensució desde la última vez que se escribió en disco. Todo cambio anterior al recLSN ya está en la copia de disco de esa página. Cuando la página se escribe, sale de la DPT.
Una consecuencia que vale la pena ver: si una página está en la DPT, su recLSN es mayor que el pageLSN de su copia en disco. El cambio que ensució la página (recLSN) no llegó a disco, así que es posterior al último que sí llegó. Esto vale para la DPT de verdad, la que está en memoria mientras el sistema funciona. La DPT que reconstruye la recuperación puede no cumplirlo, porque la escritura de una página no se anota en el log: en el ejemplo completo de más abajo, P3 queda con recLSN 50 y pageLSN 50 en disco.
Las dos tablas se pierden en una caída. Parte del trabajo de la recuperación es reconstruirlas.
Compensation log records
Cuando ARIES deshace un update, sea en un rollback normal o en la recuperación, escribe un compensation log record (CLR). Un CLR describe el cambio que restauró el valor viejo, igual que el registro redo-only del libro, y lleva un campo más: undoNextLSN, el LSN del siguiente registro de esa transacción que falta deshacer. Es el prevLSN del update que se acaba de deshacer.
- Un CLR se rehace como cualquier cambio: describe un cambio en una página.
- Un CLR nunca se deshace. Si el undo encuentra un CLR, salta directo a su undoNextLSN: lo que está entre medio ya se deshizo.
Con eso, el trabajo del undo queda acotado. Si una transacción tenía cien updates y el sistema cae después de deshacer sesenta, en el siguiente arranque el último registro de la transacción es un CLR, y el undo salta directo a los cuarenta que faltan.
En un rollback normal (la transacción hace ROLLBACK o el sistema la
aborta), ARIES escribe primero un registro abort, después un CLR por cada
update, siguiendo la cadena de prevLSN desde el lastLSN, y al final un
registro end. El end dice que la transacción terminó del todo y ya no
necesita nada más del log. El commit funciona igual: se escribe commit, se
fuerza el log, se responde al cliente, y después se escribe end.
Fuzzy checkpoints
El checkpoint del libro detenía las transacciones y escribía todas las páginas sucias. Un fuzzy checkpoint no hace ninguna de las dos cosas:
- Escribe un registro
begin_checkpoint. - Escribe un registro
end_checkpointcon una copia de la TT y de la DPT tal como están en ese momento. Las transacciones siguen trabajando entre los dos registros. - Cuando el
end_checkpointllegó a almacenamiento estable, guarda el LSN delbegin_checkpointen un registro maestro (master record), en un lugar fijo del disco.
No escribe ninguna página. No hace falta: la DPT del checkpoint dice qué páginas estaban sucias y desde qué registro (su recLSN), y eso basta para saber desde dónde hay que rehacer. Para que la recuperación no tenga que ir demasiado atrás, el buffer manager sigue escribiendo páginas sucias en segundo plano, y los recLSN de la DPT avanzan.
El libro (sec. 19.9) presenta el checkpoint de ARIES como un solo registro
con las dos tablas; las notas de CS186, como un par begin_checkpoint y
end_checkpoint. Es la misma idea: el par solo deja claro que las tablas se
copian mientras el sistema sigue funcionando.
Las tres fases de ARIES
Después de una caída, ARIES lee el registro maestro para encontrar el último
begin_checkpoint y hace tres pasadas por el log.
Analysis
Objetivo: reconstruir la TT y la DPT tal como estaban en el momento de la caída, para saber quiénes son las perdedoras (losers, las transacciones que hay que deshacer) y desde dónde hay que rehacer.
Empieza en el begin_checkpoint y lee hacia adelante hasta el final del
log. Al llegar al end_checkpoint, carga sus tablas. Pero entre los dos
registros las transacciones siguieron trabajando, y analysis ya pudo haber
visto algunos registros cuando llega al end_checkpoint. Las tablas del
checkpoint se combinan con lo ya visto así:
- En la TT, una transacción que ya se vio desde el
begin_checkpointse queda con lo que se vio, que es más reciente. Tampoco se vuelve a agregar una transacción cuyoendya apareció. - En la DPT, si la página ya estaba, se queda con el menor de los dos
recLSN: el del checkpoint puede ser anterior al primer cambio que analysis
vio desde el
begin_checkpoint.
Con cada registro de una transacción:
- Si la transacción no está en la TT, entra con estado running.
- Su lastLSN pasa a ser el LSN del registro.
- Con un
commit, su estado pasa a committed; con unabort, a aborting. - Con un
end, sale de la TT. - Con un update o un CLR, si la página no está en la DPT, entra con recLSN igual al LSN del registro. Si ya estaba, su recLSN no cambia: el primer cambio que la ensució es anterior.
Al final de analysis:
- Las perdedoras son las transacciones de la TT que no hicieron commit: running o aborting.
- El punto donde empieza el redo es el menor recLSN de la DPT. Ningún cambio anterior a ese LSN puede faltar en disco.
La DPT que sale de analysis es una aproximación conservadora: puede incluir páginas que en realidad ya se habían escrito en disco (analysis no ve las escrituras de páginas, porque no se anotan en el log). No importa: el redo lo va a descubrir al comparar con el pageLSN.
Redo
Objetivo: repetir la historia, dejar cada página como estaba en el momento de la caída.
Empieza en el menor recLSN de la DPT y lee hacia adelante. Cada update y cada CLR se rehace, salvo en tres casos:
- La página no está en la DPT. Entonces, todos sus cambios llegaron a disco antes del checkpoint o desde entonces.
- La página está en la DPT, pero el LSN del registro es menor que el recLSN de la página. Ese cambio es anterior al primero que dejó sucia la página, así que ya estaba en disco.
- El pageLSN de la página, leído de disco, es mayor o igual que el LSN del registro. La página se escribió después de este cambio.
Los dos primeros casos se deciden sin leer la página, solo con la DPT.
El tercero obliga a traerla a memoria. Rehacer es aplicar el cambio y poner
el pageLSN de la página igual al LSN del registro; no se escribe nada en el
log. Los registros que no son de cambios (commit, end, abort,
checkpoints) no se rehacen.
Repetir la historia significa que el redo no mira si la transacción hizo commit: rehace también los cambios de las perdedoras. Con eso, el undo trabaja sobre la base tal como estaba en el momento de la caída, y deshace con las mismas reglas que un rollback normal. Y como el redo también rehace los CLR, un rollback que estaba a medias queda exactamente en el punto donde se interrumpió.
Undo
Objetivo: deshacer a las perdedoras.
Se arma un conjunto con el lastLSN de cada perdedora. Mientras no esté vacío, se toma siempre el mayor LSN del conjunto (el log se recorre hacia atrás una sola vez, mezclando las cadenas de todas las perdedoras):
- Si es un update: se deshace el cambio, se escribe un CLR con undoNextLSN igual al prevLSN del update, y se agrega ese prevLSN al conjunto.
- Si es un CLR: no se deshace nada; se agrega su undoNextLSN al conjunto.
- Si es un abort: no cambió nada; se sigue con su prevLSN.
- Si el siguiente LSN de la transacción es nulo (llegó al principio de su
cadena), se escribe su registro
end.
Error común. Creer que la recuperación solo rehace las transacciones que hicieron commit. ARIES rehace todo, de todas las transacciones, y después deshace a las perdedoras. Rehacer solo las confirmadas parece ahorrar trabajo, pero con steal hay en disco cambios de las perdedoras mezclados en las mismas páginas, y un CLR solo se puede aplicar sobre la página en el estado exacto en que se escribió.
Un ejemplo completo
El log
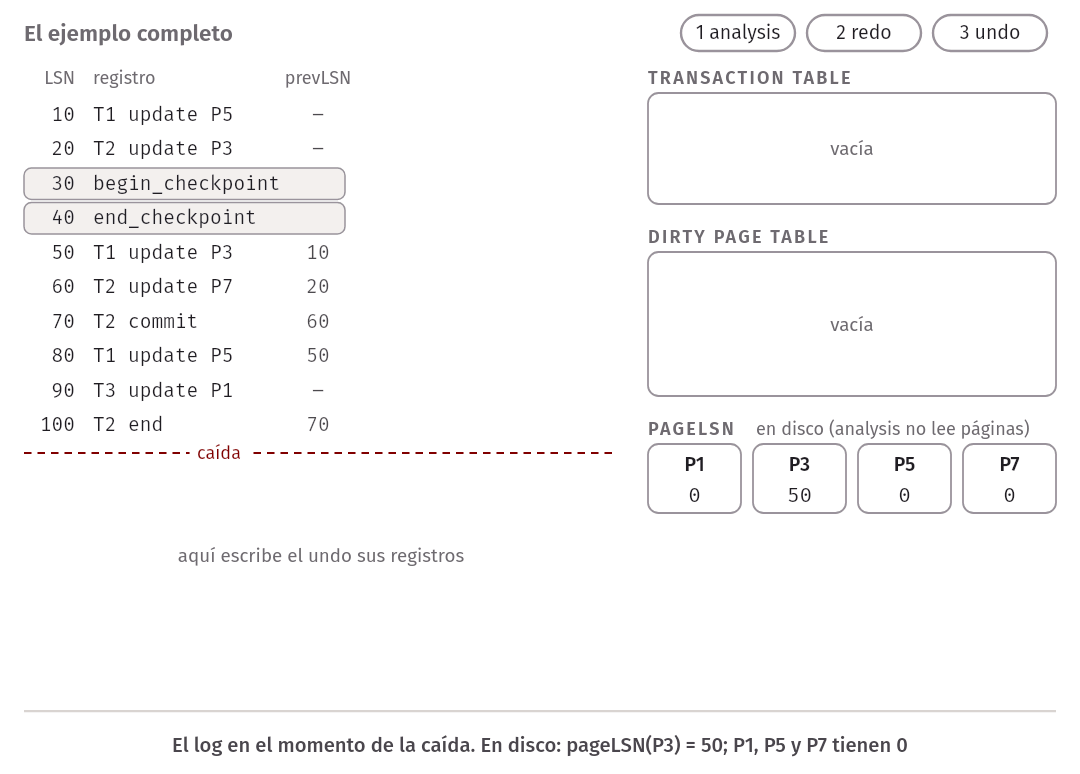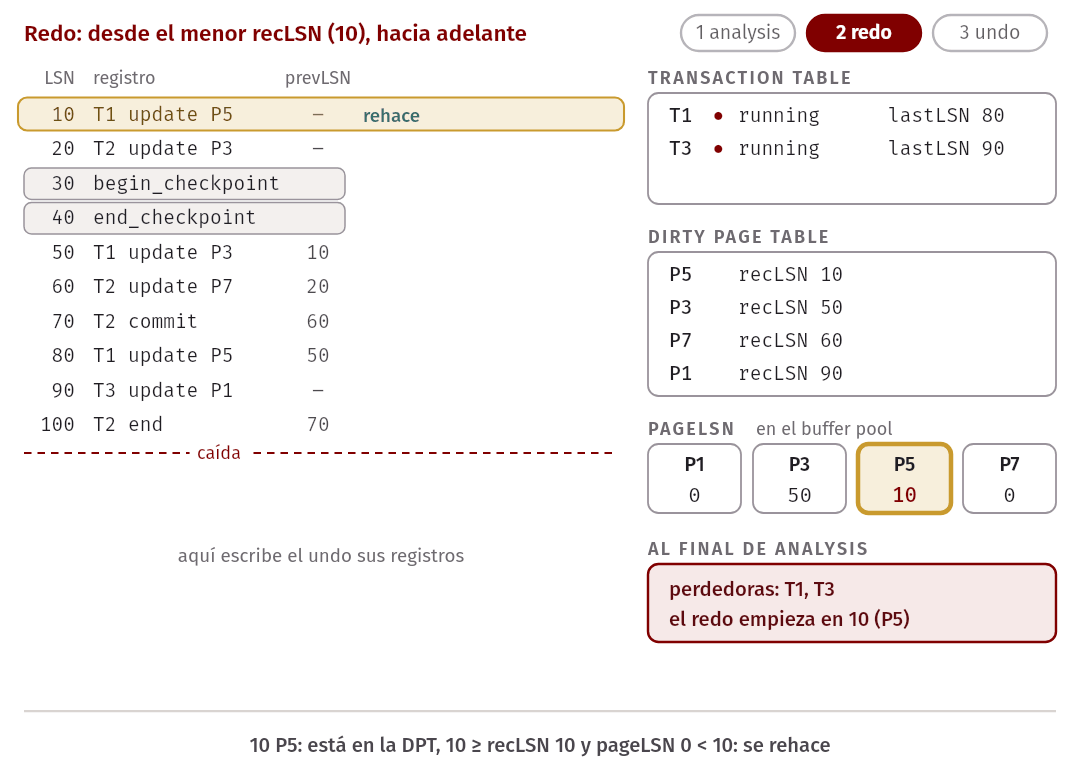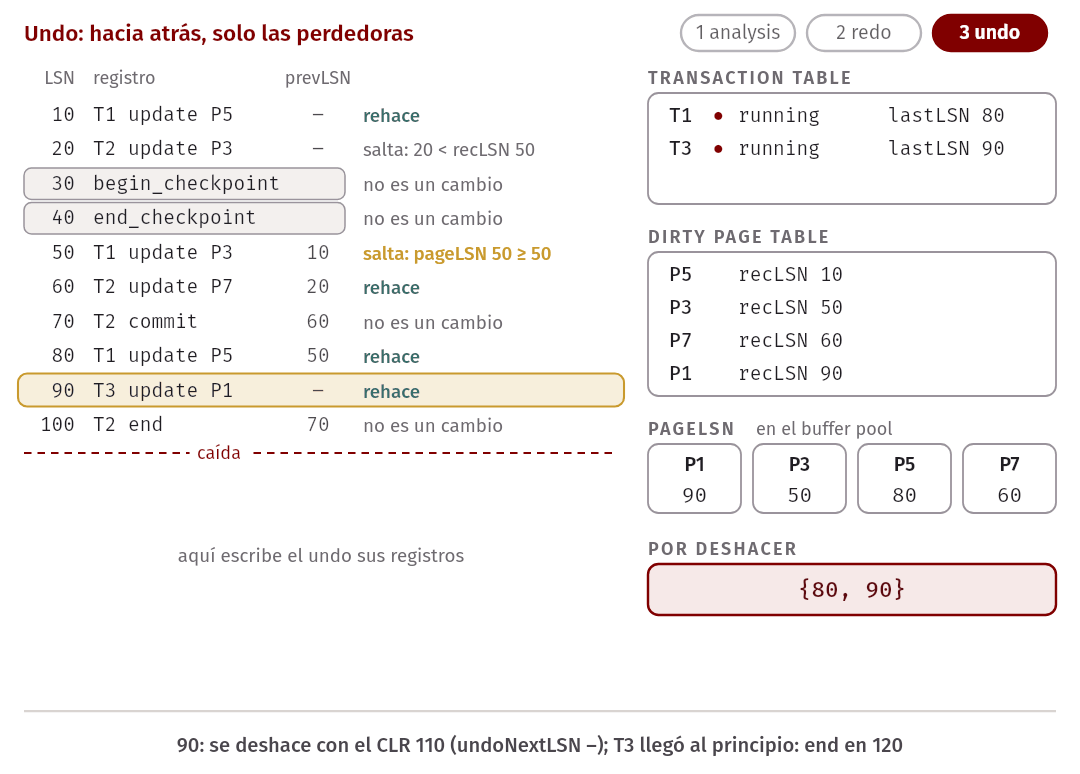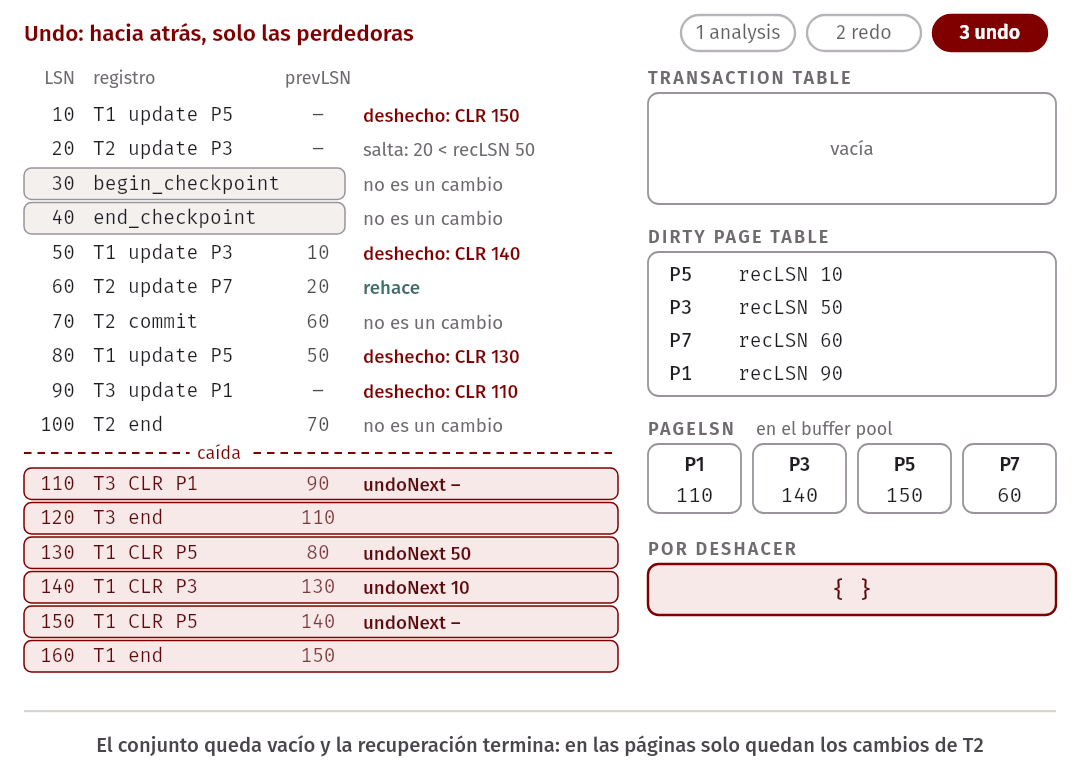
El log en el momento de la caída. P1 y P7 son páginas de trip; P3 y P5,
de shipment. El simulador de esta semana lo tiene en
example.mjs, con el ítem que cambia cada
update:
LSN  registro                       prevLSN
10   T1 update P5                   –        shipment 501.status: in_transit → delivered
20   T2 update P3                   –        shipment 233.price: 30 → 35
30   begin_checkpoint
40   end_checkpoint  TT = {T1: 10, T2: 20}  DPT = {P5: 10}
50   T1 update P3                   10       shipment 240.price: 18.5 → 20
60   T2 update P7                   20       trip 12.vehicle_id: 11 → 7
70   T2 commit                      60
80   T1 update P5                   50       shipment 502.status: registered → in_transit
90   T3 update P1                   –        trip 40.vehicle_id: 1 → 3
100  T2 end
---- caída ----
En disco: pageLSN(P1) = 0, pageLSN(P3) = 50, pageLSN(P5) = 0, pageLSN(P7) = 0
Antes de resolverlo, lo que dice el estado del disco:
- La DPT del checkpoint no tiene P3, aunque T2 la cambió en 20. Entonces P3 se escribió en disco entre 20 y el checkpoint.
- En disco, P3 tiene pageLSN 50. Se volvió a escribir después del cambio 50 de T1, que nunca hizo commit: es steal. En disco hay un cambio de una perdedora.
- T2 hizo commit en 70, pero P7 tiene pageLSN 0: su cambio de 60 no llegó a disco. Es no-force. Falta en disco un cambio de una transacción que hizo commit.
La recuperación tiene que arreglar las dos cosas.
Analysis
Desde el begin_checkpoint, en 30:
- 40: se cargan TT = {T1: 10, T2: 20} y DPT = {P5: 10}.
- 50: lastLSN(T1) = 50. P3 no está en la DPT: entra con recLSN 50.
- 60: lastLSN(T2) = 60. P7 entra con recLSN 60.
- 70: T2 queda committed; lastLSN(T2) = 70.
- 80: lastLSN(T1) = 80. P5 ya está en la DPT, con recLSN 10: no cambia.
- 90: T3 entra a la TT con lastLSN 90. P1 entra con recLSN 90.
- 100: T2 sale de la TT.
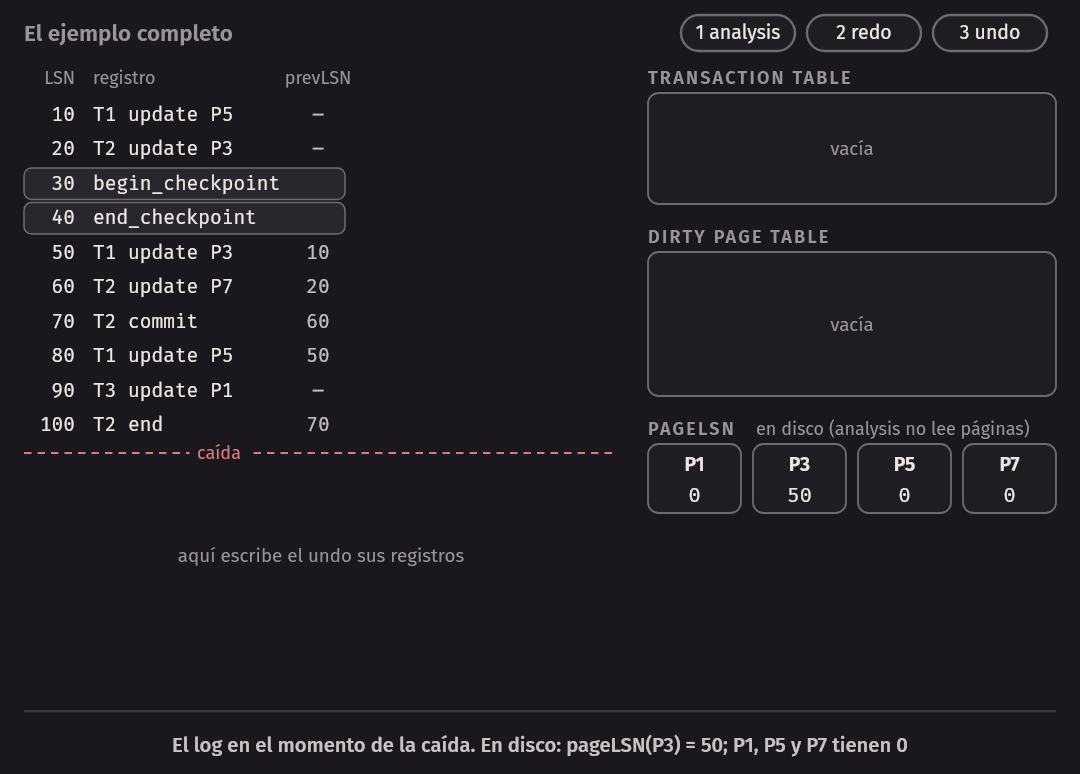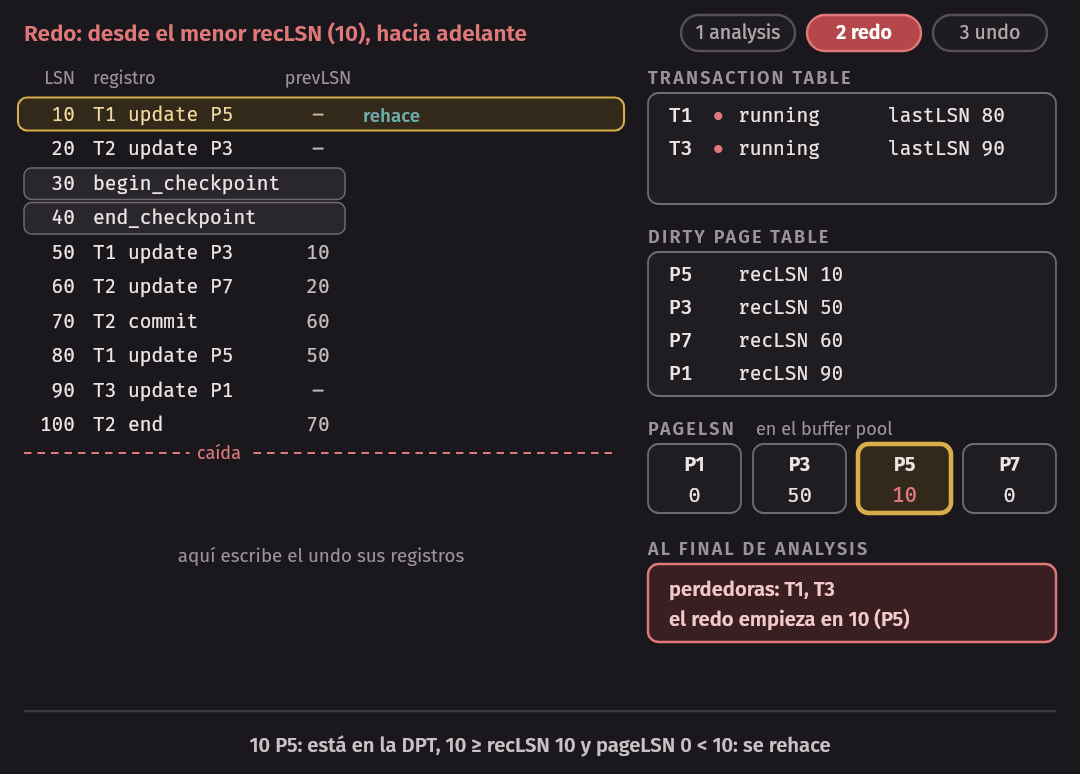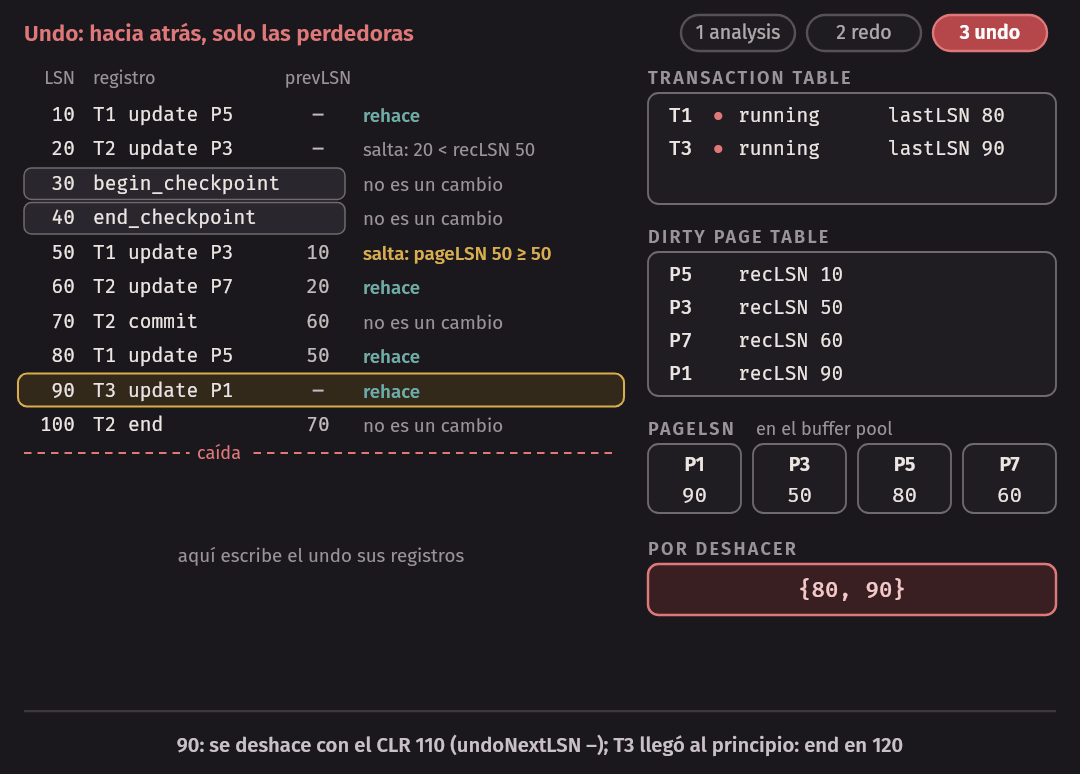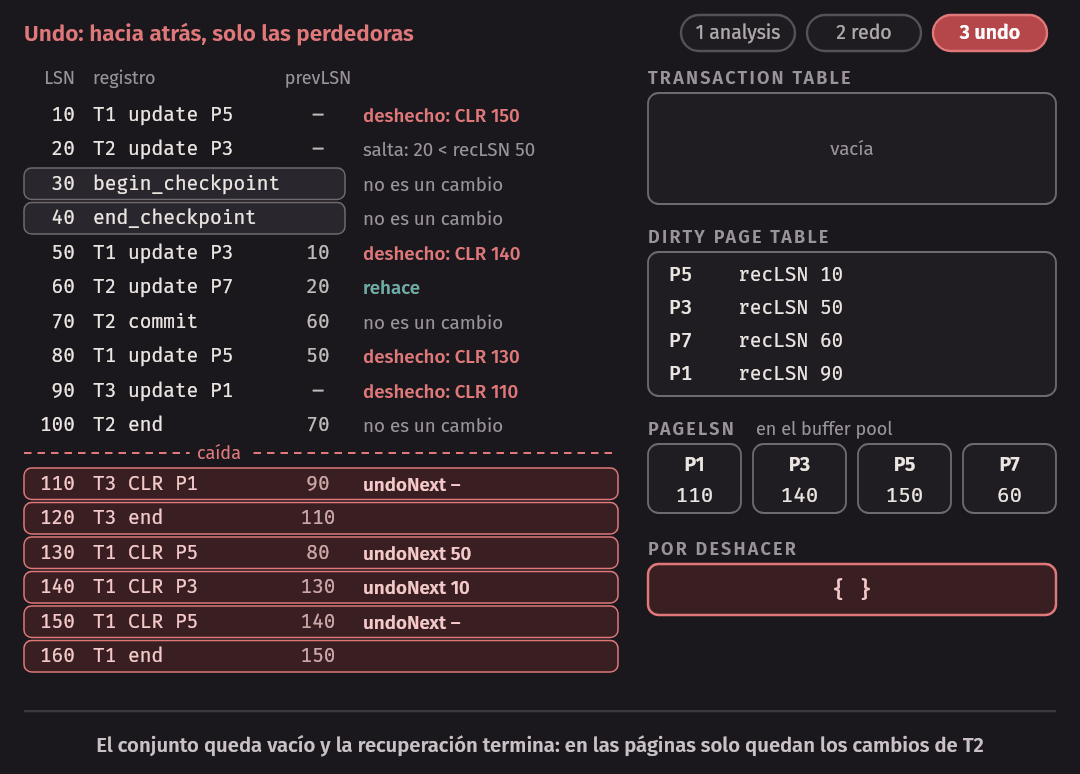
Al final: TT = {T1: 80, T3: 90}, las dos running, así que las perdedoras son T1 y T3. DPT = {P5: 10, P3: 50, P7: 60, P1: 90}; el menor recLSN es 10, y ahí empieza el redo. Fíjense en que el redo empieza antes del checkpoint: el checkpoint de ARIES no escribió páginas, y P5 estaba sucia desde 10.
Redo
Desde 10, cada update:
- 10, P5: está en la DPT, 10 ≥ recLSN 10, y el pageLSN en disco es 0 < 10. Se rehace; pageLSN(P5) = 10.
- 20, P3: 20 < recLSN 50. Se salta sin leer la página: el cambio ya estaba en disco antes de que P3 se ensuciara otra vez.
- 50, P3: 50 ≥ recLSN 50, así que hay que leer la página: su pageLSN es 50 ≥ 50. Se salta: la página en disco ya tiene este cambio.
- 60, P7: se rehace. Aquí se recupera el cambio de T2, que hizo commit.
- 80, P5: el pageLSN de P5 ahora es 10 (del redo de 10) < 80. Se rehace.
- 90, P1: se rehace.
El commit, el end y los registros del checkpoint no se rehacen. Ahora las cuatro páginas están como en el momento de la caída, con los cambios de T1 y T3 incluidos.
Undo
El conjunto empieza con los lastLSN de las perdedoras: {80, 90}. Los LSN nuevos siguen después del último del log, de diez en diez.
- Se toma 90 (T3 update P1): se deshace y se escribe el CLR 110 de T3
sobre P1, con undoNextLSN = prevLSN de 90 = –. T3 llegó al principio: se
escribe
T3 enden 120. - Se toma 80 (T1 update P5): CLR 130 sobre P5, con undoNextLSN 50. Entra 50 al conjunto.
- Se toma 50 (T1 update P3): CLR 140 sobre P3, con undoNextLSN 10.
- Se toma 10 (T1 update P5): CLR 150 sobre P5, con undoNextLSN –, y
T1 enden 160.
El conjunto queda vacío y la recuperación termina.
Idea clave. En el undo, cada CLR tiene como prevLSN el registro anterior de su transacción, que puede ser otro CLR: el CLR 140 tiene prevLSN 130. La cadena de prevLSN de T1 queda 150 → 140 → 130 → 80 → 50 → 10, y la de undoNextLSN de sus CLR, 130 → 50, 140 → 10, 150 → –.
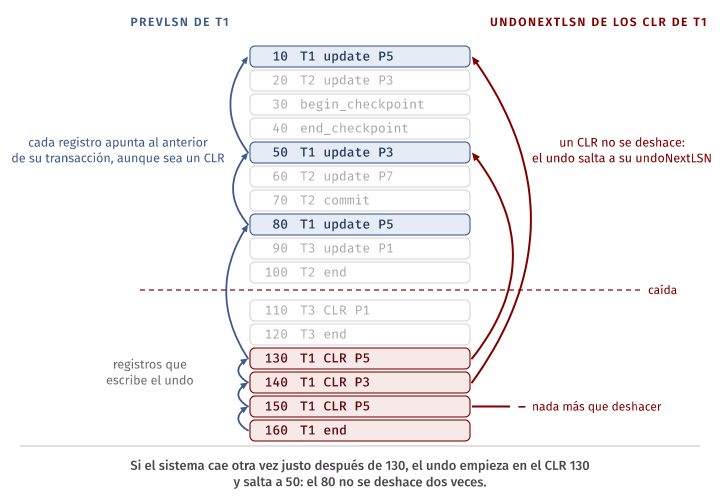
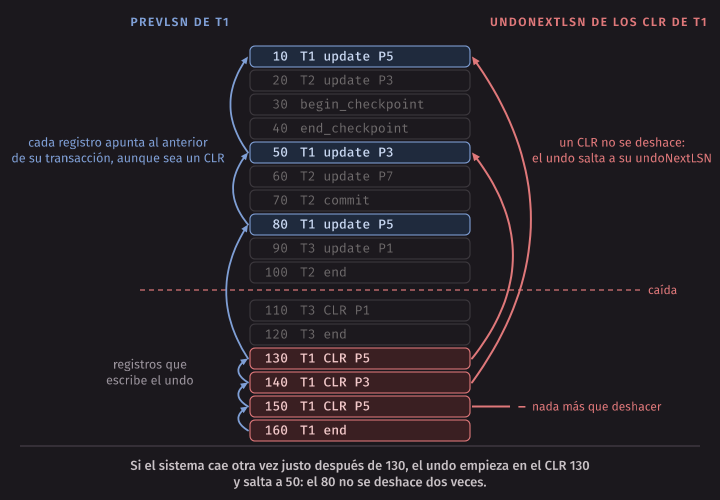
Hay dos convenciones para el undo. Este ejemplo sigue la del libro: el undo
escribe los CLR y el end directamente. Las notas de CS186 además escriben
un registro abort para cada perdedora al final de analysis (y un end
para las que tenían commit sin end), así que sus CLR quedan con LSN
corridos. El resultado sobre las páginas es el mismo.
El simulador
aries.mjs hace estas cuentas. No es un motor:
no tiene archivos, páginas de verdad ni buffer pool. Recibe un arreglo de
registros del log y el estado de las páginas en disco, y tiene una función
por fase:
| Función | Recibe | Devuelve |
|---|---|---|
analysis(log) |
el log | tt, dpt, losers, redoLSN y un paso por registro |
redo(log, a, disk) |
el log, el resultado de analysis y el disco | las páginas y, por cada update o CLR, si se rehace o por qué se salta |
undo(log, a, pages) |
el log, el resultado de analysis y las páginas | los registros nuevos (CLR y end) y las páginas |
restart(log, disk) |
el log y el disco | las tres fases, y el log con los registros nuevos al final |
Un registro es un objeto como
{ lsn: 50, type: 'update', txn: 'T1', page: 'P3', item: 'shipment 240.price', before: 18.5, after: 20, prevLSN: 10 }.
trace.mjs corre restart sobre el ejemplo y
muestra cada fase:
$ node trace.mjs
Analysis (desde el LSN 30)
   30  begin_checkpoint
   40  end_checkpoint     se cargan la TT y la DPT del checkpoint
   50  T1 update P3       lastLSN(T1) = 50; P3 entra a la DPT con recLSN 50
   60  T2 update P7       lastLSN(T2) = 60; P7 entra a la DPT con recLSN 60
   70  T2 commit          T2 queda committed; lastLSN(T2) = 70
   80  T1 update P5       lastLSN(T1) = 80
   90  T3 update P1       T3 entra a la TT; lastLSN(T3) = 90; P1 entra a la DPT con recLSN 90
  100  T2 end             T2 sale de la TT
  TT  = {T1: running 80, T3: running 90}
  DPT = {P5: 10, P3: 50, P7: 60, P1: 90}
  perdedoras: T1, T3; el redo empieza en 10
Redo
   10  T1 update P5       se rehace
   20  T2 update P3       se salta (20 < recLSN 50)
   50  T1 update P3       se salta (pageLSN 50 ≥ 50)
   60  T2 update P7       se rehace
   80  T1 update P5       se rehace
   90  T3 update P1       se rehace
Undo
   90  T3 update P1       CLR 110, undoNextLSN –; end en 120
   80  T1 update P5       CLR 130, undoNextLSN 50
   50  T1 update P3       CLR 140, undoNextLSN 10
   10  T1 update P5       CLR 150, undoNextLSN –; end en 160
Registros nuevos
  110  T3 CLR P1, undoNextLSN –  (prevLSN 90)
  120  T3 end  (prevLSN 110)
  130  T1 CLR P5, undoNextLSN 50  (prevLSN 80)
  140  T1 CLR P3, undoNextLSN 10  (prevLSN 130)
  150  T1 CLR P5, undoNextLSN –  (prevLSN 140)
  160  T1 end  (prevLSN 150)
Páginas al final
  P1 (pageLSN 110): trip 40.vehicle_id = 1
  P3 (pageLSN 140): shipment 233.price = 35, shipment 240.price = 18.5
  P5 (pageLSN 150): shipment 501.status = in_transit, shipment 502.status = registered
  P7 (pageLSN 60): trip 12.vehicle_id = 7
Las páginas del final tienen exactamente los cambios de T2 (el precio 35 del envío 233 y el vehículo 7 del viaje 12) y ninguno de T1 ni de T3.
Una segunda caída durante la recuperación
Supongamos que el sistema vuelve a caer justo después de escribir el CLR
130, y que ninguna página llegó a disco durante la primera recuperación. El
log ahora tiene, después de 100, los registros 110 (CLR de T3), 120 (T3 end) y 130 (CLR de T1). node trace.mjs 130 simula ese caso:
---- segunda caída después del registro 130 ----

Analysis (desde el LSN 30)
...
  110  T3 CLR P1          lastLSN(T3) = 110
  120  T3 end             T3 sale de la TT
  130  T1 CLR P5          lastLSN(T1) = 130
  TT  = {T1: running 130}
  DPT = {P5: 10, P3: 50, P7: 60, P1: 90}
  perdedoras: T1; el redo empieza en 10
Redo
...
   90  T3 update P1       se rehace
  110  T3 CLR P1          se rehace
  130  T1 CLR P5          se rehace
Undo
  130  T1 CLR P5          se salta a undoNextLSN 50
   50  T1 update P3       CLR 140, undoNextLSN 10
   10  T1 update P5       CLR 150, undoNextLSN –; end en 160
T3 ya no es perdedora: su end llegó al log. El redo rehace los dos CLR,
y así P1 y P5 quedan con los valores que la primera recuperación había
restaurado. El undo empieza en el lastLSN de T1, que ahora es el CLR 130, y
salta directo a 50: el cambio 80 no se deshace dos veces. Por mucho que
se repitan las caídas, cada update de una perdedora se deshace una sola vez,
y el trabajo total de la recuperación está acotado.
Error común. Pensar que un checkpoint hace commit de algo o que, después de un checkpoint, ya no hace falta el log anterior para nada. El checkpoint solo acota dónde empieza la recuperación, y ni siquiera eso del todo: en el ejemplo, el redo empezó en 10, antes del checkpoint, y el undo de T1 también llegó hasta 10. Y un backup con point-in-time recovery, al final del capítulo, necesita todo el log archivado desde el backup.
Checkpoints y recuperación en PostgreSQL
El checkpoint de PostgreSQL
El checkpoint de PostgreSQL está entre el del libro y el de ARIES. No detiene a las transacciones, como el fuzzy checkpoint, pero sí escribe páginas: escribe todas las páginas que estaban sucias cuando empezó, y recién después termina. Así, no necesita guardar una DPT, porque al terminar el checkpoint todo cambio anterior a su comienzo está en disco. La recuperación empieza en ese comienzo, el punto de redo (redo point).
Al ejecutar CHECKPOINT, wal.sql muestra los dos LSN que guarda el
archivo de control pg_control:
  redo_lsn  | checkpoint_lsn
------------+----------------
 1/A6E7FF08 | 1/A6E7FF60
(1 row)
El redo_lsn apunta a un registro CHECKPOINT_REDO, que el checkpoint
escribe al empezar, y el checkpoint_lsn a un registro
CHECKPOINT_ONLINE, que escribe al terminar, después de escribir las
páginas. Es el par begin_checkpoint y end_checkpoint de ARIES, y
pg_control es el registro maestro. Las pruebas de la semana lo comprueban
leyendo con pg_get_wal_record_info el registro que hay en cada LSN.
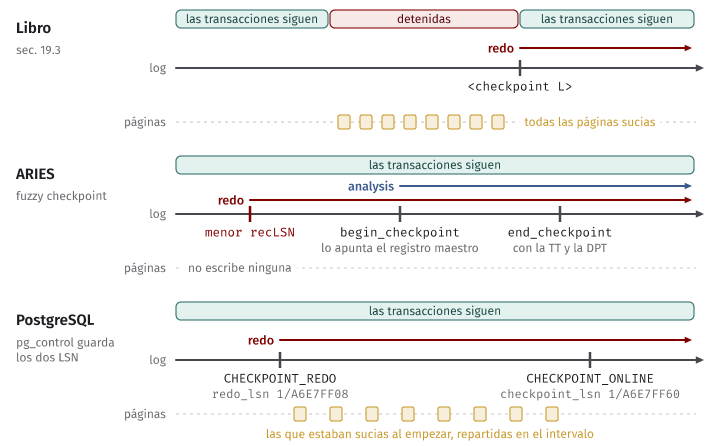
¿Cuándo hay checkpoint? Cada checkpoint_timeout (300 s por defecto), o
antes, si desde el último se escribió max_wal_size de WAL (1 GB por
defecto), o cuando alguien ejecuta CHECKPOINT. Para no saturar el disco,
el checkpointer reparte la escritura de las páginas a lo largo del intervalo:
con checkpoint_completion_target = 0.9, trata de terminar cuando pasó el
90 % del tiempo hasta el siguiente. Hay un compromiso, como en el ejemplo de
ARIES: checkpoints seguidos significan recuperaciones cortas, pero más
escrituras de páginas y más full-page writes en el WAL.
Una caída de verdad
crash.sh provoca una caída en un cluster de
prueba: un servidor PostgreSQL nuevo, creado con initdb en /tmp, en el
puerto 5415, que no tiene nada que ver con el servidor del curso. Crea una
tabla payment, hace un checkpoint, inserta 1000 filas en una transacción
con commit, deja abierta otra transacción que actualiza todas las filas sin
hacer commit, y detiene el servidor con pg_ctl -m immediate stop: sin
checkpoint y sin cierre ordenado, como un corte de luz. Después lo vuelve a
arrancar, muestra las líneas nuevas del log del servidor y revisa los datos.
Al final borra el cluster. Con make crash:
== Antes de la caída
redo_lsn del último checkpoint: 0/178F720
commit de 1000 filas; WAL insertado hasta 0/17B3EF0
transacción 754 abierta: UPDATE payment SET amount = 0 (sin commit)
WAL insertado hasta 0/17E9998
== Caída: pg_ctl -m immediate stop
== Arranque (líneas nuevas del log del servidor)
LOG:  starting PostgreSQL 18.6 (Debian 18.6-1.pgdg13+2) on aarch64-unknown-linux-gnu, compiled by gcc (Debian 14.2.0-19) 14.2.0, 64-bit
LOG:  listening on Unix socket "/tmp/.s.PGSQL.5415"
LOG:  database system was interrupted; last known up at 2026-11-01 20:29:04 UTC
LOG:  database system was not properly shut down; automatic recovery in progress
LOG:  redo starts at 0/178F720
LOG:  invalid magic number 0000 in WAL segment 000000010000000000000001, LSN 0/17E8000, offset 8290304
LOG:  redo done at 0/17E7F80 system usage: CPU: user: 0.00 s, system: 0.00 s, elapsed: 0.00 s
LOG:  checkpoint starting: end-of-recovery immediate wait
LOG:  checkpoint complete: wrote 23 buffers (0.1%), wrote 3 SLRU buffers; 0 WAL file(s) added, 0 removed, 0 recycled; write=0.005 s, sync=0.002 s, total=0.009 s; sync files=9, longest=0.001 s, average=0.001 s; distance=354 kB, estimate=354 kB; lsn=0/17E8048, redo lsn=0/17E8048
LOG:  database system is ready to accept connections
== Después de la recuperación
filas y total: 1000 10000.00
filas con xmax = 754: 969
estado de la transacción 754: aborted
registros del WAL con xid 754: 2922; de ellos COMMIT o ABORT: 0
Línea por línea:
database system was not properly shut down; automatic recovery in progress: el archivo de control dice que el servidor no se detuvo bien, y la recuperación empieza sola, sin que nadie la pida.redo starts at 0/178F720: es elredo_lsndel último checkpoint, el quecrash.shanotó antes de la caída. ElINSERTde las 1000 filas vino después, así que su WAL se va a rehacer.invalid magic number 0000 ... LSN 0/17E8000: ahí se acaba el WAL válido en disco. Lo que sigue son ceros: páginas del segmento que nunca se escribieron. Así reconoce PostgreSQL el final del log.redo done at 0/17E7F80: el último registro que rehízo. ElUPDATEsin commit había insertado WAL hasta 0/17E9998, pero en disco solo llegó hasta antes de 0/17E8000. El resto estaba en el buffer del WAL y se perdió con la caída. No pasa nada: ese WAL era de una transacción sin commit, y por la primera parte de la regla WAL ninguna página con esos cambios pudo haber llegado a disco sin él.checkpoint starting: end-of-recovery: al terminar el redo, PostgreSQL hace un checkpoint, para que una caída inmediata no tenga que repetir todo el trabajo.
Y los datos:
- Las 1000 filas del
INSERTestán, con el total de 10 000: el commit forzó el WAL hasta su registro (0/17B3EF0 es anterior a 0/17E7F80), y el redo rehízo las páginas. Es la durabilidad. - El
UPDATEsin commit no aparece: el total es 10 000, no 0. Pero el redo sí lo rehízo, hasta donde llegó el WAL: 969 filas tienenxmax = 754. Es repeating history en un motor real: el redo aplicó los cambios de una transacción que nunca hizo commit. Esas 969 versiones viejas siguen visibles porquexmaxapunta a una transacción que no hizo commit. El número cambia de una corrida a otra, según cuánto WAL alcanzó a escribir el WAL writer antes de la caída. pg_xact_statusdiceaborted: la transacción 754 no está en curso y no hizo commit, así que cuenta como abortada. En el WAL hay 2922 registros con suxiddesde el punto de redo, y ninguno es unCOMMITni unABORT. La recuperación no escribió nada para deshacerla: no hay fase de undo. Basta con que su commit no exista.
En PostgreSQL. El servidor del curso también se puede hacer caer, con
db-crashdentro del contenedor, como en el laboratorio: el script corre el mismopg_ctl -m immediate stop, ydb-startlo vuelve a arrancar. Lo que no se debe hacer nunca es borrar archivos depg_walpara “liberar espacio”: sin ese WAL, la recuperación no puede rehacer lo que hizo commit y la base puede quedar corrupta.
Cuando se pierde el disco
Backups y el log archivado
Todo lo anterior supone que el disco sobrevive. Para sobrevivir a la pérdida del almacenamiento no volátil (sec. 19.6), la idea es la misma, pero con copias fuera del servidor:
- Un dump (archival dump) o copia completa de la base, hecha de vez en cuando y guardada en otro lugar. El libro describe primero un dump que detiene las transacciones y después un fuzzy dump, que copia mientras el sistema funciona, igual que un fuzzy checkpoint.
- Todo el log desde el comienzo de esa copia, también guardado fuera del servidor.
Para recuperar, se restaura la copia y se rehace el log desde ahí. Una copia
hecha mientras el sistema funciona no es consistente por sí misma (tiene
páginas de distintos momentos), pero el log desde su comienzo la deja
consistente, igual que el redo deja consistente una base después de una
caída. Y como el log tiene todo, se puede detener el redo en cualquier
punto: point-in-time recovery (PITR). Si alguien ejecuta DELETE FROM shipment por error a las 10:15, se restaura la copia de la noche y se
rehace el log hasta las 10:14.
En PostgreSQL.
pg_basebackuphace la copia física del directorio de datos con el servidor funcionando, y el archivado del WAL (archive_modeconarchive_commandoarchive_library) copia cada segmento a otro lugar cuando se llena. Para recuperar, se restaura la copia, se indica de dónde sacar los segmentos (restore_command) y, opcionalmente, hasta dónde rehacer (recovery_target_time). Lo explica Continuous Archiving and Point-in-Time Recovery.pg_dump, el que usaron en las primeras semanas, es otra cosa: un dump lógico (sentencias SQL o un formato propio) de un snapshot, que no se puede combinar con el WAL.
Un servidor de respaldo
Restaurar un backup tarda. Para seguir funcionando cuando se pierde un servidor entero (sec. 19.7), se mantiene un remote backup: otro servidor, en otro lugar, que recibe el log del primario a medida que se genera y lo aplica continuamente. Si el primario cae, el respaldo termina de aplicar el log que recibió y toma su lugar. El libro identifica tres preguntas: cómo detectar que el primario falló (sin confundirlo con una falla de la red), cómo pasar el control al respaldo y cuánto tarda en estar listo.
La pregunta central es cuándo puede responder un commit:
- One-safe: el commit responde cuando su registro está en el log del primario. Es rápido, pero si el primario cae antes de enviar el log, el respaldo toma el control sin los últimos commits.
- Two-very-safe: el commit espera a que el registro esté en el log del primario y del respaldo. No se pierde nada, pero si uno de los dos está caído, no se puede hacer commit.
- Two-safe: como two-very-safe mientras los dos funcionan; si solo funciona el primario, sigue como one-safe.
En PostgreSQL. Es la streaming replication: el respaldo (standby) recibe el WAL por la red y lo rehace sin parar, con el mismo código que la recuperación después de una caída. Por defecto es asíncrona (one-safe). Con
synchronous_standby_names, el commit espera a un standby, ysynchronous_commitdice hasta dónde:remote_write(el standby recibió el WAL y se lo pasó a su sistema operativo),on(lo escribió en su disco) oremote_apply(además lo aplicó, y una consulta en el standby ya ve el cambio). La semana 16 vuelve sobre la replicación.
En el laboratorio
El laboratorio de la semana recorre lo mismo con la base chasqui, en dos
terminales del contenedor: las extensiones y la configuración, los
registros de una transacción con pg_get_wal_records_info, los full-page
writes, el pageLSN de una página, una caída con db-crash y la
recuperación en /var/log/postgresql.log, y el costo de un commit
durable con synchronous_commit. Los archivos de code/week-15 sirven para
repasar sin tocar chasqui: wal.sql sobre chasqui_w15 y make crash
en un cluster aparte.
El código de la semana y make test
Dentro del contenedor, en code/week-15, make crea la base de datos
chasqui_w15 con pg_walinspect y pageinspect, y make test la vuelve a
crear y corre las pruebas:
$ make test
chasqui-load chasqui_w15
Base de datos chasqui_w15 lista.
...
✔ analysis empieza en el begin_checkpoint y reconstruye la TT y la DPT
✔ redo: 20 se salta por recLSN, 50 por pageLSN; los demás updates se rehacen
...
✔ segunda caída después del CLR 130: el cambio 80 no se deshace dos veces
...
✔ el redo empieza en el redo_lsn del último checkpoint
✔ sobreviven las 1000 filas con commit; el UPDATE sin commit no aparece
...
✔ el mismo UPDATE sin checkpoint antes: sin full-page write, y pageLSN = end_lsn
✔ prev_lsn apunta al registro anterior del WAL, no al anterior de la transacción
ℹ tests 19
ℹ pass 19
ℹ fail 0
...| Archivo | Qué muestra |
|---|---|
wal.sql |
Configuración del WAL, LSN y segmento, los registros de una transacción después de un checkpoint y sin él, y el pageLSN de la página del envío 501 |
crash.sh |
Caída y recuperación en un cluster de prueba en el puerto 5415, que se crea y se borra (make crash) |
aries.mjs |
Simulador de las tres fases de ARIES sobre un arreglo de registros |
example.mjs |
El log y el disco del ejemplo completo |
trace.mjs |
Muestra las fases del ejemplo; con un LSN, también una segunda caída (make trace) |
aries.test.mjs |
El ejemplo del apunte, la idempotencia del redo y la segunda caída |
wal.test.mjs |
Lo que el apunte dice del WAL, con las sentencias de wal.sql |
crash.test.mjs |
Corre crash.sh en el puerto 5515 y revisa el log y los datos |
wal.test.mjs hace CHECKPOINT en el servidor del curso (no cambia datos)
y crash.test.mjs arranca y detiene su propio cluster, así que los
archivos de prueba se corren uno después de otro (--test-concurrency=1).
Las pruebas no comparan LSN, que cambian en cada corrida, ni el número de
filas que alcanzó a rehacer el UPDATE sin commit.
El simulador no es P5. En P5, quipu tiene páginas de verdad en un archivo,
un buffer pool y un log en disco, y la recuperación tiene que dejar los
datos bien después de descartar el buffer pool; el simulador solo hace las
cuentas sobre un log escrito a mano. Sirve para comprobar los ejercicios en
papel antes de llevarlos al proyecto.
Resumen
- La recuperación garantiza atomicidad y durabilidad. Los fallos se clasifican en fallo de una transacción (error lógico o del sistema), caída del sistema (se pierde la memoria; fail-stop) y fallo del disco (se pierde almacenamiento no volátil).
- Almacenamiento volátil, no volátil y estable. El estable se aproxima con dos copias escritas una después de la otra: una escritura a medias nunca daña las dos.
- El log tiene registros
<Ti start>,<Ti, X, V1, V2>,<Ti commit>y<Ti abort>. V1 sirve para undo y V2 para redo. Una transacción hizo commit cuando su registro de commit está en almacenamiento estable. Los motores usan logging physiological. - Steal exige undo; no-force exige redo. Los motores eligen steal + no-force porque es la combinación más rápida, y pagan con un log que permite las dos cosas.
- La regla WAL: el log de un cambio llega a disco antes que la página (permite steal), y todo el log de una transacción llega antes de que el commit responda (permite no-force). Group commit junta varios commits en una escritura.
- El algoritmo del libro: redo hacia adelante desde el último checkpoint,
repitiendo la historia y armando la undo-list; después undo hacia
atrás, con registros redo-only y
<Ti abort>. Redo y undo son idempotentes. - ARIES: LSN, pageLSN, prevLSN, flushedLSN; la transaction table (con lastLSN) y la dirty page table (con recLSN); CLR con undoNextLSN, que se rehace y nunca se deshace; fuzzy checkpoints que no detienen nada ni escriben páginas.
- Analysis reconstruye las tablas y da las perdedoras y el menor recLSN.
Redo rehace desde ahí, salvo si la página no está en la DPT, si el LSN
es menor que el recLSN o si el pageLSN ya es mayor o igual. Undo toma
siempre el mayor LSN pendiente de las perdedoras y escribe CLR y
end. - PostgreSQL: WAL solo de redo (MVCC y
pg_xacthacen innecesario el undo); LSN en bytes; full-page writes después de cada checkpoint contra las torn pages;pd_lsncomo pageLSN;synchronous_commit; checkpoints conCHECKPOINT_REDOyCHECKPOINT_ONLINE, ypg_controlcomo registro maestro. - Para la pérdida del disco: un backup más el log archivado, con
point-in-time recovery (
pg_basebackupy el archivado del WAL), y servidores de respaldo one-safe, two-safe o two-very-safe (streaming replication).
Ejercicios
-
Clasifiquen cada falla y digan qué se pierde y qué mecanismo la resuelve: (a) un
INSERTenshipmentconprice = -5; (b) PostgreSQL elige una transacción como víctima de un deadlock; (c) el proceso del servidor se termina por falta de memoria; (d) se corta la luz del centro de datos; (e) un SSD deja de responder; (f) un empleado ejecutaUPDATE shipment SET status = 'returned'sinWHEREy hace commit. -
Un bloque de almacenamiento estable se guarda en dos discos, como en la sec. 19.2. Describan el estado de las dos copias y lo que hace la recuperación si la caída ocurre (a) a la mitad de la primera escritura, (b) entre las dos escrituras y (c) a la mitad de la segunda. ¿Por qué no sirve escribir las dos copias al mismo tiempo?
-
Con el log del “ejemplo pequeño” (T0 y T1 sobre A, B y C), supongan que antes de
<T1 commit>la transacción T1 hace un rollback normal. Escriban los registros que agrega al log. Si después el sistema cae, ¿qué decide la recuperación para T1 con las reglas de la sec. 19.3, y por qué el resultado es correcto aunque “rehaga” una transacción que abortó? -
Apliquen el algoritmo de la sec. 19.4 a este log. Den la undo-list al final de la fase de redo, los valores que se rehacen y los registros que escribe la fase de undo. ¿Hasta dónde tiene que retroceder el undo?
1 <T1 start> 2 <T1, A, 10, 20> 3 <T2 start> 4 <T2, B, 30, 40> 5 <checkpoint {T1, T2}> 6 <T2 commit> 7 <T3 start> 8 <T1, C, 50, 60> 9 <T3, D, 70, 80> 10 <T3 commit> ---- caída ---- -
Un motor usa steal + force. (a) ¿Qué guardaría en los registros de update y qué haría al recuperar? (b) ¿En qué orden tienen que llegar al disco las páginas y el registro de commit? (c) Una transacción de Chasqui cambia el
statusde 5000 envíos repartidos en 148 páginas. Comparen lo que cuesta su commit con force y con no-force. -
El buffer pool quiere desalojar una página con pageLSN = 340, y el log está escrito en disco hasta flushedLSN = 310. Al mismo tiempo, tres transacciones esperan su commit, con registros de commit en 320, 335 y 350. ¿Cuál es la menor escritura del log que permite desalojar la página y hacer commit de dos de las tres transacciones? ¿Cuál de las tres queda esperando? ¿Qué es group commit en este caso?
-
Recuperen con ARIES este log: TT y DPT al final de analysis, el LSN donde empieza el redo, qué se rehace y qué se salta (y por qué), y los registros que escribe el undo, con prevLSN y undoNextLSN. En disco, pageLSN(P1) = 40, pageLSN(P2) = 0 y pageLSN(P3) = 0. Fíjense en que T2 ya había empezado un rollback antes de la caída. Después comprueben su respuesta escribiendo el log en el formato de
example.mjsy corriendorestart.LSN registro prevLSN 10 T1 update P1 – 20 T2 update P2 – 30 begin_checkpoint 40 T1 update P1 10 50 end_checkpoint TT = {T1: 40, T2: 20} DPT = {P1: 10, P2: 20} 60 T2 update P3 20 70 T1 commit 40 80 T2 abort 60 90 T2 CLR P3, undoNextLSN 20 80 100 T1 end 70 ---- caída ---- -
En el ejemplo completo del apunte, cambien el disco: P5 se escribió después del cambio 80 (pageLSN(P5) = 80, con los dos valores nuevos) y P7 nunca. Predigan qué cambia en analysis, en redo y en undo. Comprueben con el simulador. ¿Cambian los registros que escribe el undo? ¿Por qué?
-
Corran
wal.sqlsobrechasqui_w15después demake. (a) Anoten elfpidel registroHeap LOCKdeagency: ¿coincide con 8192 menos el espacio libre de esa página, que pueden medir conpage_header(get_raw_page('agency', 0))? (b) ¿Por qué el segundoUPDATEesHOT_UPDATEy el primero no? (c) Repitan elUPDATEuna tercera vez, ahora conCHECKPOINTantes. ¿Qué registro vuelve a llevar una imagen completa? -
En
crash.sh, la transacción sin commit dejó 969 filas conxmax = 754en esa corrida. (a) Corranmake crashvarias veces y anoten el número. ¿Por qué cambia? (b) Modifiquen una copia del script para que elINSERTde las 1000 filas se haga conSET synchronous_commit = offjusto antes y la caída inmediatamente después. ¿Qué puede pasar ahora con esas filas? ¿Puede quedar la tabla con, por ejemplo, 500 filas? Expliquen por qué no. -
A las 10:15, alguien ejecuta
DELETE FROM shipment_eventen el servidor de producción de Chasqui y hace commit. Hay unpg_basebackupde las 2:00 y el WAL se archiva. (a) ¿Sirve de algo el checkpoint de las 10:12? (b) ¿Qué hace falta para volver a las 10:14? (c) ¿Qué pasa con los envíos que se registraron entre las 10:15 y el momento de la recuperación? (d) ¿Habría servido un standby síncrono? -
(Desafío) Agreguen a
aries.mjsuna opción para seguir la convención de CS186: al final de analysis, escribir unendpara cada transacción con commit y sin end, y unabortpara cada perdedora que estaba running. Escriban una prueba con el ejemplo del apunte que compruebe los LSN nuevos de los CLR, y otra que compruebe que las páginas del final son las mismas que con la convención del libro.