
Apuntes · Capítulo 14Transacciones y distribuidos
Control de concurrencia: locks, deadlocks y MVCC
Control de concurrencia: locks, deadlocks y MVCC
La semana pasada definimos qué queremos: que varias transacciones corran a la vez y que el resultado sea el de algún orden serial. Para eso aprendimos a mirar un schedule, armar su grafo de precedencia y decidir si es conflict serializable; y vimos que los niveles de aislamiento de SQL relajan esa exigencia a cambio de dejar pasar ciertas anomalías. Pero un DBMS no puede esperar a que termine el schedule para revisarlo: tiene que decidir en el momento, operación por operación, si deja pasar una lectura o una escritura, si la hace esperar o si aborta a alguien. Esa parte del motor es el control de concurrencia (concurrency control), y es el tema de este capítulo.
Hay dos grandes familias de soluciones. La primera es pesimista: antes de tocar un ítem, la transacción pide un permiso, un lock, y si otra lo tiene, espera. Es lo que hace un mutex en Sistemas Operativos, con una disciplina extra, el two-phase locking, que es la que garantiza la serializabilidad. Con las esperas llegan los deadlocks, y hay que prevenirlos o detectarlos. La segunda familia guarda varias versiones de cada fila para que los lectores no esperen a nadie: es el multiversion concurrency control (MVCC), y es lo que usa PostgreSQL para casi todo. MVCC tiene su propia anomalía, el write skew, que vamos a reproducir con la capacidad de un vehículo de Chasqui.
Todo lo que se muestra de PostgreSQL en este capítulo es la salida real de dos
sesiones trabajando a la vez sobre la base chasqui_w14, más una tercera que
observa pg_locks. Los scripts están en el código de la semana y las pruebas
verifican cada afirmación. Esta semana también se publica P5, donde ustedes
construyen el lock manager de quipu: la teoría está aquí; el diseño, en el
enunciado.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “Shared y exclusive”, “Tener locks no basta” y “Two-phase locking”. Sesión B: “Que los lectores no esperen” y “Snapshot isolation”.
- En clase. Sesión A: “Locks”, “Deadlocks”, “Granularidad múltiple” e “Inserciones, borrados y phantoms”. Sesión B: “Multiversion concurrency control”, “MVCC en PostgreSQL” y “Write skew”.
- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 18.1–18.4 y 18.7–18.8; “Protocolos con timestamps” de este capítulo (secs. 18.5–18.6), opcional. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-14, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
Locks
Shared y exclusive
Seguimos con el modelo de la semana 13: una transacción lee y escribe ítems
(read(Q), write(Q)), y un ítem puede ser una fila, una página o una tabla.
La forma más directa de evitar que dos transacciones se pisen es exigir que,
para tocar un ítem, la transacción tenga un lock sobre él: un permiso que
el DBMS da y quita. Silberschatz (sec. 18.1.1) usa dos modos:
- Shared (S). Si Ti tiene un lock S sobre Q, puede leer Q pero no
escribirlo. Se pide con
lock-S(Q). - Exclusive (X). Si Ti tiene un lock X sobre Q, puede leer y escribir Q.
Se pide con
lock-X(Q).
Un lock se suelta con unlock(Q). La regla que decide si un pedido se concede
es la matriz de compatibilidad: el modo A es compatible con el modo B si
una transacción puede recibir un lock A sobre Q mientras otra tiene un lock B
sobre Q.
| S | X | |
|---|---|---|
| S | ✓ | |
| X |
Varias transacciones pueden leer el mismo ítem a la vez; si una lo escribe, nadie más puede ni leerlo ni escribirlo. Cuando el modo pedido no es compatible con alguno de los locks ya concedidos sobre Q, la transacción espera hasta que todos los incompatibles se suelten.
Definamos formalmente: Ti pide un lock en modo A sobre Q. El pedido se puede
conceder si y solo si, para todo lock en modo B que otra transacción Tj tenga
sobre Q, comp(A, B) es verdadero. Con S y X, comp(A, B) solo es verdadero
cuando A = B = S.
Si vienen de Sistemas Operativos: un lock X es un mutex sobre un ítem, y el par S/X es un readers-writer lock. Lo nuevo no es el lock, sino cuándo se sueltan, porque de eso depende que el schedule sea serializable.
Tener locks no basta
Sea A el precio del envío 501 y B el del envío 502. La transacción T2 pasa 10 soles de descuento del primero al segundo (resta 10 a A y suma 10 a B): la suma A + B no cambia. La transacción T1 calcula esa suma para un reporte. Las dos usan locks y cada una suelta su lock apenas termina de usar el ítem:
| T1 | T2 |
|---|---|
lock-S(A) |
|
read(A) |
|
unlock(A) |
|
lock-X(A) |
|
read(A), write(A) (A − 10) |
|
lock-X(B) |
|
read(B), write(B) (B + 10) |
|
unlock(A), unlock(B) |
|
lock-S(B) |
|
read(B) |
|
unlock(B) |
|
| muestra A + B |
Ningún lock se violó, y sin embargo T1 sumó el A de antes del descuento con el
B de después: le salen 10 soles de más. En el grafo de precedencia, r1(A)
antes de w2(A) da T1 → T2 y w2(B) antes de r1(B) da T2 → T1. Hay ciclo:
el schedule no es serializable. El problema es que T1 soltó un lock y
después pidió otro, y en ese hueco se metió T2.
Idea clave. Los locks por sí solos solo garantizan que no haya dos escrituras a la vez sobre el mismo ítem. Para la serializabilidad hace falta un protocolo: una regla sobre cuándo se pide y cuándo se suelta cada lock.
Two-phase locking
El protocolo de two-phase locking (2PL) divide la vida de cada transacción en dos fases (sec. 18.1.3):
- Fase de crecimiento (growing phase). La transacción puede pedir locks, pero no puede soltar ninguno.
- Fase de contracción (shrinking phase). La transacción puede soltar locks, pero no puede pedir ninguno.
Al principio está en crecimiento; en cuanto suelta su primer lock, pasa a
contracción y ya no puede volver. En el ejemplo de arriba, T1 no cumple 2PL:
suelta A y después pide B. Una versión 2PL de T1 pide los dos locks antes de
soltar cualquiera: lock-S(A) read(A) lock-S(B) read(B) unlock(A) unlock(B).
Con ella, T2 no puede tomar el X de A hasta que T1 haya leído también B, y el
schedule de arriba es imposible.
El momento en que una transacción obtiene su último lock (el final de la fase de crecimiento) es su lock point.
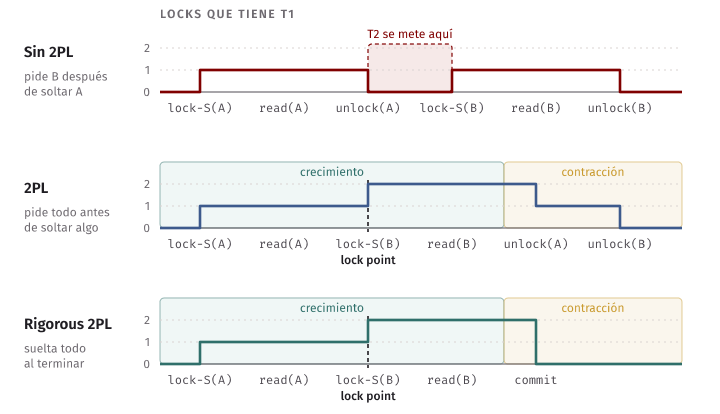
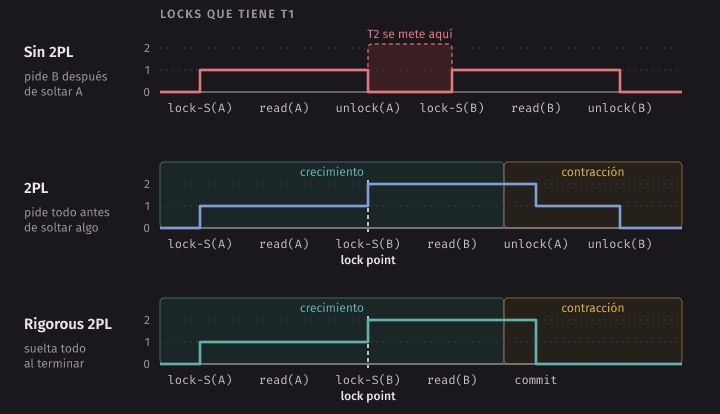
Teorema. Todo schedule producido por transacciones que siguen 2PL es conflict serializable; un orden serial equivalente es el de sus lock points.
Demostración. Supongamos que el grafo de precedencia tiene una arista
Ti → Tj. Entonces hay un ítem Q y dos operaciones en conflicto, la de Ti
primero. Como están en conflicto, al menos una es una escritura, así que los
locks que usaron sobre Q son incompatibles: Ti tuvo que soltar el suyo antes
de que Tj obtuviera el suyo. Ti suelta locks solo en su fase de contracción,
así que su lock point va antes de ese unlock(Q); y Tj pide locks solo en su
fase de crecimiento, así que su lock point va después de su lock(Q). Por lo
tanto, lockpoint(Ti) < lockpoint(Tj). Si hubiera un ciclo T1 → T2 → … → T1,
tendríamos lockpoint(T1) < lockpoint(T1), lo cual es imposible. El grafo es
acíclico y el schedule es conflict serializable. ∎
El teorema va en un solo sentido. Hay schedules conflict serializables que 2PL no puede producir: 2PL es una condición suficiente, no necesaria. A cambio, funciona sin saber nada de antemano: cada transacción decide sus locks a medida que avanza.
Rollbacks en cascada: strict y rigorous 2PL
2PL garantiza serializabilidad, pero no que el schedule sea recuperable ni cascadeless (semana 13). Miren este schedule, en el que las dos transacciones cumplen 2PL:
| T1 | T2 |
|---|---|
lock-X(A), write(A) |
|
lock-S(B), read(B) |
|
unlock(A) (empieza la contracción) |
|
lock-S(A), read(A) |
|
| … | … |
| abort |
T2 leyó un valor de A que T1 escribió y que nunca va a hacer commit. Si T2 ya hizo commit, el schedule no es recuperable; si no, hay que abortarla también: un rollback en cascada (cascading rollback). Dos variantes de 2PL lo impiden:
- Strict 2PL. Además de 2PL, una transacción guarda todos sus locks X hasta que hace commit o abort. Nadie puede leer lo que escribió una transacción que todavía no terminó, así que los schedules son cascadeless (y por lo tanto recuperables).
- Rigorous 2PL. Una transacción guarda todos sus locks, S y X, hasta el commit o el abort. Además de cascadeless, las transacciones quedan serializadas en el orden de sus commits.
¿Por qué strict 2PL no basta para que el orden serial sea el de los commits? Porque permite soltar un S antes del final. T1 lee A y suelta su S en la fase de contracción; T2 toma el X de A, escribe y hace commit; T1 hace commit después. La arista es T1 → T2 (T1 leyó antes de que T2 escribiera), pero los commits van en el orden T2, T1. Con rigorous 2PL, T2 no puede escribir A hasta que T1 termine.
Los sistemas comerciales usan strict o rigorous 2PL. En la práctica, guardar los locks hasta el final es también lo más simple de implementar: el DBMS los suelta todos de una vez, al hacer commit o abort.
En PostgreSQL. Los locks de fila y de tabla de una transacción se guardan hasta su fin: es la regla de rigorous 2PL. Pero PostgreSQL no usa 2PL para las lecturas normales: un
SELECTno toma locks de fila (lo vemos en la Sesión B, con MVCC). Solo los tomanUPDATE,DELETE,SELECT ... FOR UPDATE/FOR SHAREy las verificaciones de claves foráneas.
Conversiones de lock
A veces una transacción lee un ítem y, más adelante, decide escribirlo.
Pedir X desde el principio quita concurrencia (nadie más puede leer mientras
tanto); pedir S y soltarlo para pedir X rompe 2PL. La salida son las
conversiones de lock (sec. 18.1.3): upgrade(Q) pasa de S a X sin soltar
el S, y downgrade(Q) pasa de X a S. Con conversiones, 2PL queda así: los
upgrades solo se pueden hacer en la fase de crecimiento y los downgrades solo
en la de contracción. Un upgrade espera, como cualquier pedido, a que los
demás suelten sus locks incompatibles sobre Q, que ahora son todos los S de
otras transacciones.
La mayoría de los DBMS no le pide a la aplicación que escriba lock-S y
lock-X: los genera solos (sec. 18.1.4). Cuando Ti hace read(Q), el
sistema pide lock-S(Q) si no tiene ya un lock; cuando hace write(Q), pide
upgrade(Q) si tiene un S o lock-X(Q) si no tiene nada; y suelta todo al
final. Eso es exactamente rigorous 2PL.
Por dentro: el lock manager
El lock manager es el componente que recibe los pedidos de lock y unlock y responde “concedido”, “espera” o “abortar” (sec. 18.1.4). Su estructura típica:
- Una lock table: una hash table indexada por el identificador del ítem
(en
quipu,'shipment:<rid>'). En cada entrada hay una lista de pedidos, cada uno con la transacción, el modo y si ya fue concedido. - Los pedidos de un ítem forman una cola FIFO. Un pedido nuevo se agrega al final. Se concede si es compatible con todos los concedidos y todos los pedidos anteriores ya fueron concedidos.
- Al soltar un lock, se borra su pedido y se revisan los siguientes de la cola en orden: cada uno que ahora se puede conceder, se concede.
- Al abortar una transacción, se borran todos sus pedidos, los concedidos y los que esperaban. Para hacerlo rápido, el lock manager guarda también, por transacción, la lista de sus locks.
¿Por qué la segunda condición, “nadie esperando antes”? Imaginen que T1 tiene S sobre Q y T2 pide X: espera. Llega T3 y pide S. Es compatible con el S de T1, así que podría concederse de inmediato. Si se concede, y luego llega T4 con otro S, y luego T5, el lock X de T2 nunca se puede conceder: siempre hay algún lector. Es starvation (inanición). Con la cola FIFO, T3 espera detrás de T2 aunque sea compatible con lo concedido.
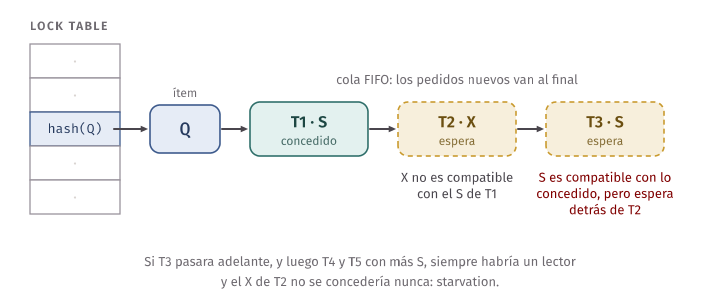
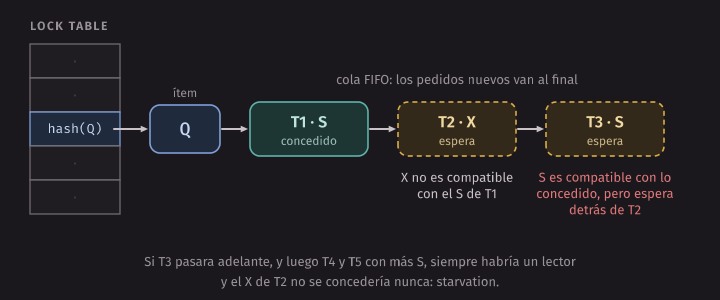
El upgrade es el caso delicado: el pedido de X de una transacción que ya tiene S no puede ponerse simplemente al final de la cola, detrás de otros que esperan algo incompatible con su propio S, porque se esperaría a sí misma. Cómo resolverlo es parte del diseño de P5.
Idea clave. Esto es lo que van a implementar en P5, en
quipu: un lock manager con locks S y X sobre registros, strict 2PL, upgrades, una cola de espera por recurso y detección de deadlocks. El enunciado está enprojects/p5-transacciones. El código de esta semana no es un lock manager: usa los locks de PostgreSQL y solo trae una función genérica para buscar ciclos en un grafo.
Protocolos basados en grafos
Si se sabe algo sobre el orden en que se accede a los ítems, se puede renunciar a 2PL y aun así garantizar serializabilidad. El ejemplo del libro (sec. 18.1.5) es el protocolo de árbol (tree protocol): los ítems forman un árbol, solo hay locks X, el primer lock puede ir sobre cualquier ítem, y después Ti puede bloquear Q solo si tiene bloqueado al padre de Q. Los locks se pueden soltar en cualquier momento, pero un ítem que Ti ya soltó no lo puede volver a bloquear. Los schedules son conflict serializables y, a diferencia de 2PL, no hay deadlocks; a cambio, a veces hay que bloquear ítems que no se van a usar (los ancestros en el camino), y sin reglas extra el schedule puede no ser recuperable. Es la idea detrás del lock crabbing en los B+ trees: para bajar por el índice se bloquea un nodo, luego su hijo, y recién entonces se suelta el padre.
Lo que hace PostgreSQL con una lectura y una escritura
Basta de teoría por un momento. locks.mjs abre dos sesiones, A y B, y una
tercera que observa pg_locks: una fila por cada lock concedido o pedido en
el servidor. El script filtra las filas de A y B, quita los locks de las
tablas del sistema y el virtualxid que toda transacción tiene, y muestra el
resultado con psql. Primero, A abre una transacción y lee el envío 501:
A: BEGIN
A: SELECT price FROM shipment WHERE shipment_id = 501
 session | locktype |   relation    | tuple | xid |      mode       | granted
---------+----------+---------------+-------+-----+-----------------+---------
 A       | relation | shipment      |       |     | AccessShareLock | t
 A       | relation | shipment_pkey |       |     | AccessShareLock | t
(2 rows)
La lectura tomó un lock ACCESS SHARE sobre la tabla y sobre el índice por
el que la encontró, y ningún lock sobre la fila. ACCESS SHARE solo choca con
ACCESS EXCLUSIVE, que es el lock que toman DROP TABLE o ALTER TABLE: su
trabajo es que nadie borre la tabla mientras A la está leyendo. Ahora A
actualiza el precio:
A: UPDATE shipment SET price = price + 1 WHERE shipment_id = 501
 session |   locktype    |   relation    | tuple |  xid  |       mode       | granted
---------+---------------+---------------+-------+-------+------------------+---------
 A       | relation      | shipment      |       |       | AccessShareLock  | t
 A       | relation      | shipment      |       |       | RowExclusiveLock | t
 A       | relation      | shipment_pkey |       |       | AccessShareLock  | t
 A       | relation      | shipment_pkey |       |       | RowExclusiveLock | t
 A       | transactionid |               |       | 25434 | ExclusiveLock    | t
(5 rows)
Aparecen dos cosas. La primera, un ROW EXCLUSIVE sobre la tabla y su índice:
el lock de tabla que toma toda escritura (en la sección de granularidad vamos
a ver que cumple el papel de un lock de intención). La segunda, un
ExclusiveLock de tipo transactionid sobre 25434. Ese número es el id de
transacción (xid) de A, que PostgreSQL le asigna en su primera escritura (la
lectura no lo necesitó). Toda transacción con xid tiene un lock X sobre su
propio xid hasta que termina; ya vamos a ver para qué.
Lo que no aparece es un lock sobre la fila 501, aunque A la modificó y la
tiene bloqueada. PostgreSQL no guarda los locks de fila en la lock table:
los anota en la propia tupla, en su campo xmax (la Sesión B lo explica).
Una lock table en memoria con una entrada por fila no alcanzaría para un
UPDATE de millones de filas.
Ahora B intenta actualizar la misma fila, y se queda esperando:
B: BEGIN
B: UPDATE shipment SET price = price + 1 WHERE shipment_id = 501   -- espera
 session |   locktype    |   relation    | tuple  |  xid  |       mode       | granted
---------+---------------+---------------+--------+-------+------------------+---------
 A       | relation      | shipment      |        |       | AccessShareLock  | t
 A       | relation      | shipment      |        |       | RowExclusiveLock | t
 A       | relation      | shipment_pkey |        |       | AccessShareLock  | t
 A       | relation      | shipment_pkey |        |       | RowExclusiveLock | t
 A       | transactionid |               |        | 25434 | ExclusiveLock    | t
 B       | relation      | shipment      |        |       | RowExclusiveLock | t
 B       | relation      | shipment_pkey |        |       | RowExclusiveLock | t
 B       | transactionid |               |        | 25435 | ExclusiveLock    | t
 B       | tuple         | shipment      | 147,65 |       | ExclusiveLock    | t
 B       | transactionid |               |        | 25434 | ShareLock        | f
(10 rows)

 session | pid  | blocked_by | wait_event_type |        state
---------+------+------------+-----------------+---------------------
 A       | 3908 | {}         | Client          | idle in transaction
 B       | 3909 | {3908}     | Lock            | active
(2 rows)
Lean la última fila de pg_locks: B pide un ShareLock sobre el xid de A
(25434) y no se lo dan (granted = f). Así espera PostgreSQL a que una fila
se libere: B vio en la tupla que la tiene bloqueada la transacción 25434, y
pide un lock compatible con nada de lo que tiene A sobre su xid. Ese pedido
se concede recién cuando A termina, con commit o con rollback, y suelta su
ExclusiveLock. El lock de fila vive en la tupla; la espera se hace en
la lock table, sobre el xid.
La fila tuple es el lugar de B en la fila de espera: un lock sobre la tupla
(147,65) (página 147, slot 65: la versión actual del envío 501, que los
experimentos de la Sesión B, corridos antes, ya movieron de lugar). Si llega una tercera sesión por la misma fila, espera ese lock de
tupla, detrás de B, en vez de pedir el xid de A por su cuenta. Así
PostgreSQL ordena a los que esperan una misma fila sin tener una cola por
fila en memoria. Estas filas tuple solo aparecen cuando alguien espera.
La consulta sobre pg_stat_activity, con pg_blocking_pids(pid), dice lo
mismo de forma directa: B está bloqueada por A, que está “idle in
transaction” (abrió una transacción y no hace nada).
Cuando A hace ROLLBACK, B continúa:
A: ROLLBACK
B: UPDATE 1   -- continúa
B: ROLLBACK
Deadlocks
Dos maneras de trabarse
Con locks, una transacción puede esperar a otra. Si la espera es circular, nadie avanza: un deadlock. Formalmente (sec. 18.2), un conjunto de transacciones está en deadlock si cada una espera a otra del conjunto. El caso más simple en Chasqui:
| T1 | T2 |
|---|---|
lock-X(501), actualiza el envío 501 |
|
lock-X(502), actualiza el envío 502 |
|
lock-X(502): espera a T2 |
|
lock-X(501): espera a T1 |
Hay otro más traicionero, porque cada transacción toca una sola fila. T1 y
T2 leen el envío 501 con S (compatibles) y después las dos quieren
escribirlo. T1 pide el upgrade a X: espera a que T2 suelte su S. T2 pide el
upgrade a X: espera a que T1 suelte su S. Ninguna lo va a soltar, porque con
2PL no se suelta nada antes de terminar. Es el deadlock por upgrade, y es
la razón de que existan SELECT ... FOR UPDATE (leer pidiendo X desde el
principio) y, en otros motores, un modo intermedio, el update lock (U): es
compatible con S, pero no con otro U, y es el que se pide al leer algo que
quizá se va a escribir.
Las cuatro condiciones de Coffman que vieron en Sistemas Operativos se cumplen en 2PL por diseño: exclusión mutua (el lock X), hold and wait (la fase de crecimiento: se piden locks nuevos sin soltar los que se tienen), no preemption (nadie le quita un lock a una transacción, salvo abortándola) y espera circular (el ciclo de arriba). Quitar cualquiera de ellas evita el deadlock; las técnicas de esta sección atacan la última, o la tercera.
Error común. Pensar que 2PL evita los deadlocks. Es al revés: retener locks mientras se piden otros es justamente hold and wait. Solo la variante conservadora de 2PL, que pide todos los locks al empezar (o ninguno), los evita, y casi nunca se puede usar: una transacción no sabe de antemano qué filas va a tocar, porque eso depende de lo que lea.
Error común. Confundir 2PL con 2PC. Two-phase locking es control de concurrencia dentro de un servidor; two-phase commit es un protocolo para que varios servidores hagan commit atómico de una transacción distribuida (semana 16). Solo comparten las “dos fases”.
Hay dos estrategias (sec. 18.2): prevenir, con un protocolo que haga imposible el deadlock, o detectar y recuperar, dejando que ocurra y rompiéndolo después. La prevención conviene cuando los deadlocks serían frecuentes; la detección, cuando son raros, porque prevenir tiene un costo aunque nunca haya deadlock (esperas o rollbacks innecesarios).
Prevención
Un orden fijo. Si todas las transacciones piden sus locks en el mismo
orden (por ejemplo, de menor a mayor shipment_id), la espera circular es
imposible: si T1 espera a T2 por un ítem, ese ítem es mayor que todos los que
T1 ya tiene, y siguiendo el ciclo se llegaría a que un ítem es mayor que sí
mismo. Es el orden de locks de Sistemas Operativos. En una aplicación es la
técnica más útil: si un proceso de Chasqui actualiza varios envíos en una
transacción, que los actualice en orden de shipment_id.
Timestamps. El sistema le da a cada transacción un timestamp TS(Ti) al empezar; un timestamp menor significa una transacción más antigua. Cuando Ti pide un lock que tiene Tj, hay dos esquemas (sec. 18.2.1):
| Esquema | Si Ti es más antigua que Tj (TS(Ti) < TS(Tj)) | Si Ti es más joven |
|---|---|---|
| Wait-die (no preemptivo) | Ti espera | Ti muere: rollback |
| Wound-wait (preemptivo) | Ti hiere a Tj: rollback de Tj | Ti espera |
En wait-die, las esperas siempre van de una más antigua a una más joven; en wound-wait, de una más joven a una más antigua. En los dos casos, todas las aristas del waits-for graph apuntan “en la misma dirección” del tiempo, y no puede haber un ciclo.
Un ejemplo con dos transacciones: T1 tiene timestamp 3 y T2 tiene 8. T2 tiene un lock X sobre el envío 501 y T1 lo pide. Con wait-die, T1 es más antigua: espera. Con wound-wait, T1 hiere a T2: T2 hace rollback y T1 recibe el lock. Al revés, si T1 tiene el lock y T2 lo pide: con wait-die, T2 (más joven) muere; con wound-wait, T2 espera.
Detalle importante: una transacción que hace rollback se reinicia con su timestamp original. Así, con el tiempo, termina siendo la más antigua del sistema, y la más antigua nunca muere (en wait-die) ni es herida (en wound-wait). No hay starvation. Si se reiniciara con un timestamp nuevo, podría ser la más joven para siempre.
Las diferencias prácticas: en wait-die, una transacción más antigua espera más cuanto más vieja es, y una joven puede morir varias veces seguidas por el mismo ítem (cada vez que se reinicia y vuelve a pedirlo). En wound-wait una transacción antigua nunca espera a una joven, y hay menos rollbacks. Los dos esquemas tienen el mismo defecto: hacen rollback de transacciones aunque no haya ningún deadlock, solo por el orden de los timestamps.
Timeouts. La solución más simple: si una transacción espera un lock más
de cierto tiempo, se asume que hay un deadlock y se hace rollback (sec.
18.2.2). Es fácil de implementar, pero adivina: con un timeout corto aborta
transacciones que solo estaban esperando a una lenta; con uno largo, un
deadlock de verdad tarda en resolverse. Y puede haber starvation. PostgreSQL
tiene lock_timeout (por defecto 0, sin límite) para quien quiera abortar
por tiempo, pero no lo usa para resolver deadlocks.
Detección: el waits-for graph
El waits-for graph tiene un nodo por transacción y una arista Ti → Tj si Ti espera un lock que tiene Tj (sec. 18.2.3). La arista aparece cuando Ti empieza a esperar y desaparece cuando Tj suelta el lock. El resultado es inmediato:
Idea clave. Hay un deadlock si y solo si el waits-for graph tiene un ciclo. Las transacciones del ciclo son las que están en deadlock.
Si Ti espera a Tj, que no espera a nadie, Tj va a terminar y Ti va a avanzar; si Tj espera a Tk, el argumento se repite. Una cadena de esperas termina; un ciclo, no. Por ejemplo: T1 tiene X sobre A y espera S sobre B; T2 tiene X sobre B y espera X sobre C; T3 tiene X sobre C. Las aristas son T1 → T2 y T2 → T3: no hay ciclo, y cuando T3 termine avanzarán T2 y luego T1. Si ahora T3 pide S sobre A, aparece T3 → T1 y se cierra el ciclo T1 → T2 → T3 → T1.
¿Cada cuánto buscar ciclos? Depende de cuán frecuentes sean los deadlocks y de cuántas transacciones afectan. Se puede buscar cada vez que se agrega una arista (caro), cada cierto tiempo o, como hace PostgreSQL, solo cuando una transacción lleva un tiempo esperando.
Cuando se encuentra un ciclo, hay que recuperarse (sec. 18.2.3.1):
- Elegir una víctima. Una transacción del ciclo cuyo rollback cueste menos. Los criterios del libro: cuánto ha trabajado y cuánto le falta, cuántos ítems ha usado, cuántos más necesita, y cuántas transacciones más habría que deshacer con ella.
- Rollback. Total (abortar y reiniciar) o parcial, solo hasta el punto en que tomó el lock que rompe el ciclo. El parcial exige que el sistema recuerde la secuencia de locks y actualizaciones; los savepoints de SQL son la versión que ve el programador.
- Evitar starvation. Si el criterio de costo elige siempre a la misma transacción, nunca termina. Se agrega al costo el número de veces que ya fue víctima.
Buscar un ciclo es un recorrido en profundidad (DFS), igual que buscar un
ciclo en el grafo de precedencia de la semana 13: los dos grafos tienen una
transacción por nodo. En code/week-14, waitsfor.mjs
trae una sola función para los dos usos:
import { findCycle } from './waitsfor.mjs';

// Grafo de precedencia de la semana 13: S = r1(A) r2(B) w1(A) r3(A) w2(B) r3(B) w3(A) r1(B)
findCycle([['T1', 'T3'], ['T2', 'T3'], ['T2', 'T1']]);
// -> { acyclic: true, order: ['T2', 'T1', 'T3'] }

// Waits-for graph del ejemplo de arriba, con T3 esperando a T1
findCycle([['T1', 'T2'], ['T2', 'T3'], ['T3', 'T1']]);
// -> { acyclic: false, cycle: ['T1', 'T2', 'T3'] }
Recibe una lista de aristas [desde, hasta] y devuelve el ciclo o, si no lo
hay, un orden topológico (para el grafo de precedencia, un orden serial
equivalente). Usa tres colores: blanco (no visitado), gris (en el camino
actual) y negro (terminado); una arista hacia un nodo gris cierra un ciclo.
Las pruebas de waitsfor.test.mjs
cubren los ejemplos de este capítulo. No es un lock manager: no sabe nada de
locks ni de colas, y en P5 el grafo tienen que armarlo ustedes a partir de
su lock table.
Un deadlock en PostgreSQL
deadlock.mjs reproduce el primer caso con dos sesiones reales. Cada sesión
fija su propio deadlock_timeout (A, 4 s; B, 2 s) para que haya tiempo de
mirar. Mientras las dos esperan, una tercera sesión muestra pg_locks y
pg_blocking_pids, y arma el waits-for graph con findCycle:
A: BEGIN
B: BEGIN
   (A es el pid 3936, xid 25437; B es el pid 3937, xid 25438)
A: UPDATE shipment SET price = price + 1 WHERE shipment_id = 501
B: UPDATE shipment SET price = price + 1 WHERE shipment_id = 502
A: UPDATE shipment SET price = price + 1 WHERE shipment_id = 502   -- espera
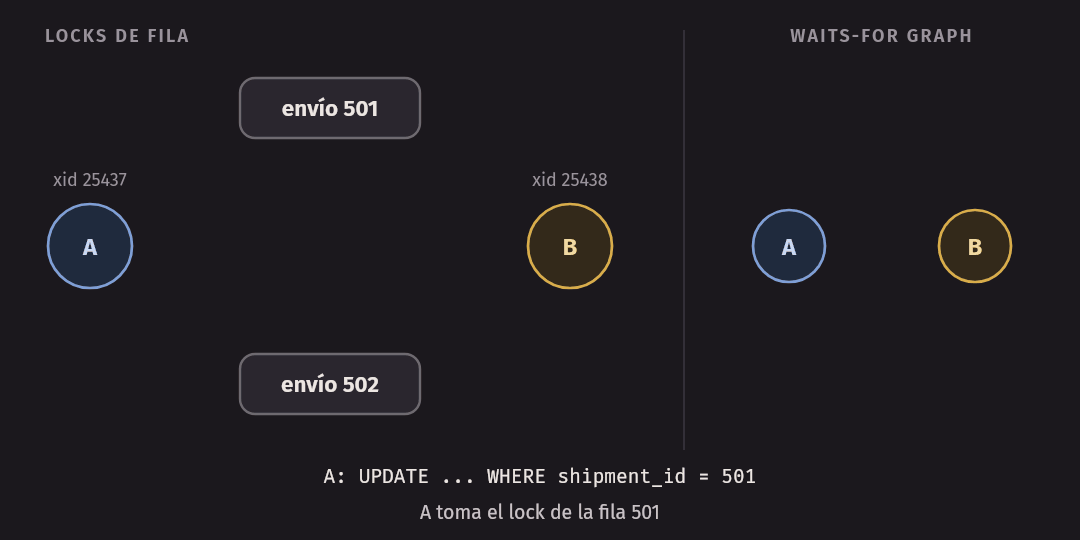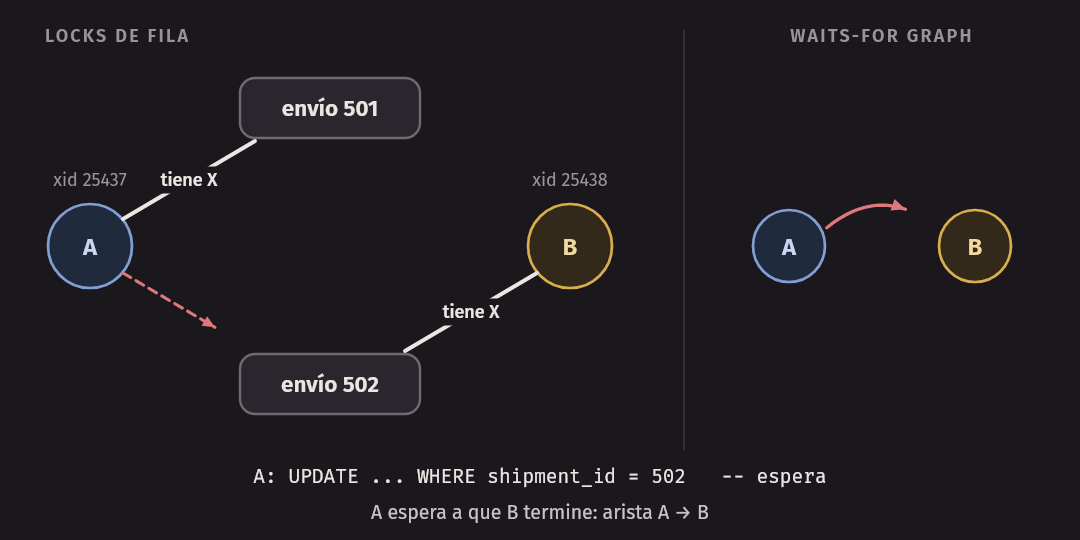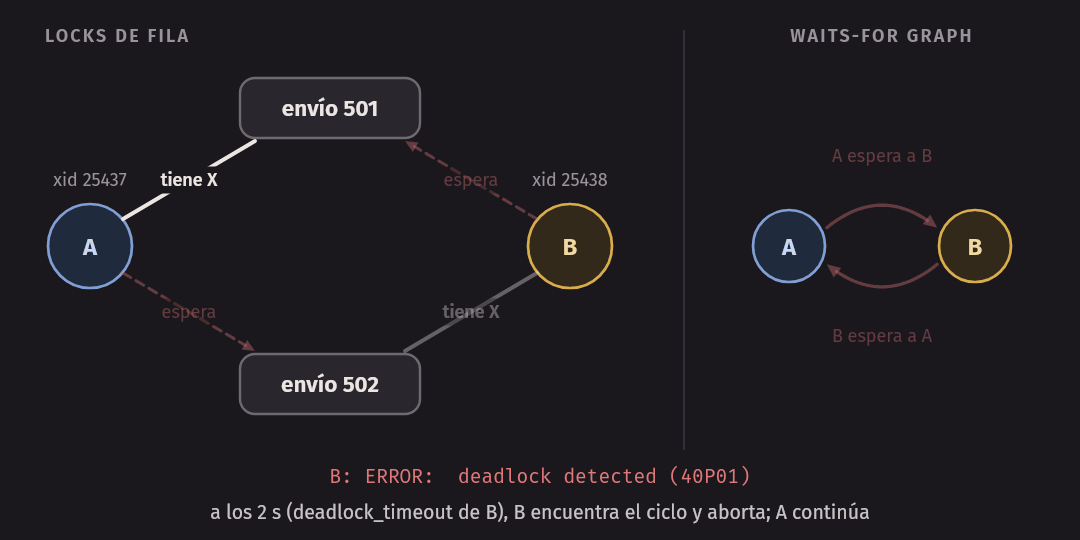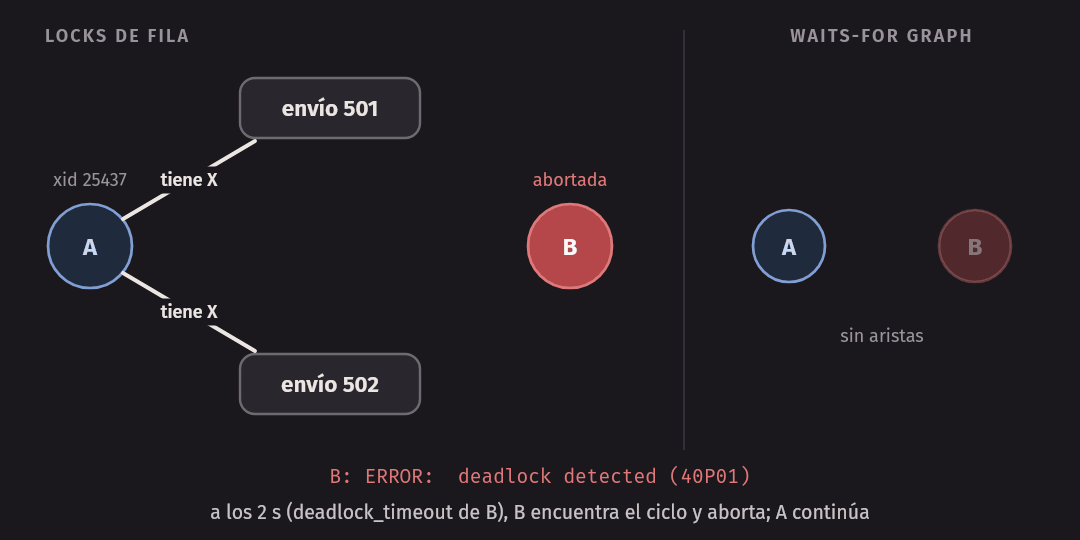
B: UPDATE shipment SET price = price + 1 WHERE shipment_id = 501   -- espera

pg_locks con las dos esperando:
 session |   locktype    |   relation    | tuple  |  xid  |       mode       | granted
---------+---------------+---------------+--------+-------+------------------+---------
 A       | relation      | shipment      |        |       | RowExclusiveLock | t
 A       | relation      | shipment_pkey |        |       | RowExclusiveLock | t
 A       | transactionid |               |        | 25437 | ExclusiveLock    | t
 A       | tuple         | shipment      | 6,15   |       | ExclusiveLock    | t
 A       | transactionid |               |        | 25438 | ShareLock        | f
 B       | relation      | shipment      |        |       | RowExclusiveLock | t
 B       | relation      | shipment_pkey |        |       | RowExclusiveLock | t
 B       | transactionid |               |        | 25438 | ExclusiveLock    | t
 B       | tuple         | shipment      | 147,65 |       | ExclusiveLock    | t
 B       | transactionid |               |        | 25437 | ShareLock        | f
(10 rows)

 session | pid  | blocked_by | wait_event_type | state
---------+------+------------+-----------------+--------
 A       | 3936 | {3937}     | Lock            | active
 B       | 3937 | {3936}     | Lock            | active
(2 rows)

findCycle: {"acyclic":false,"cycle":[3936,3937]}
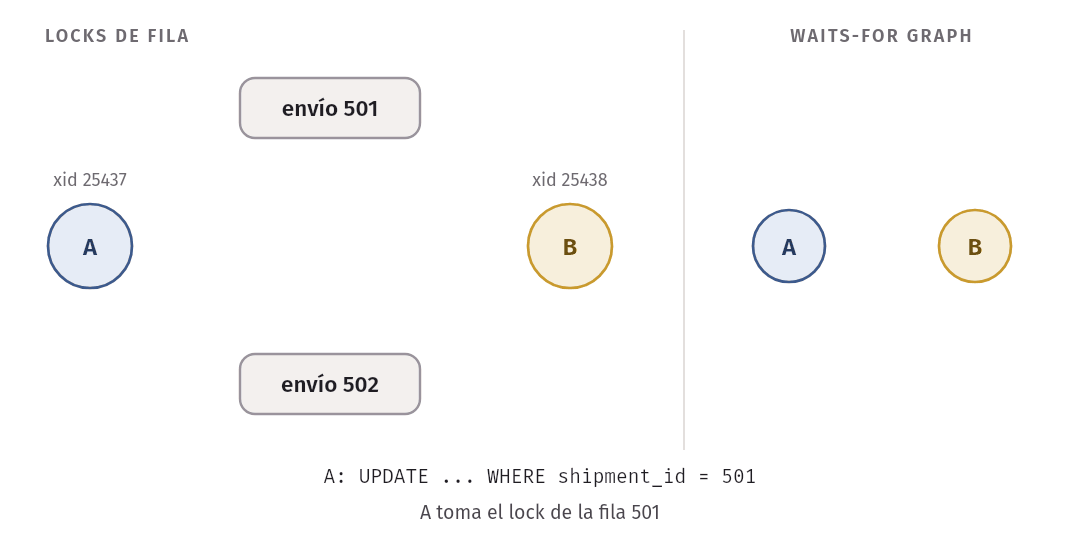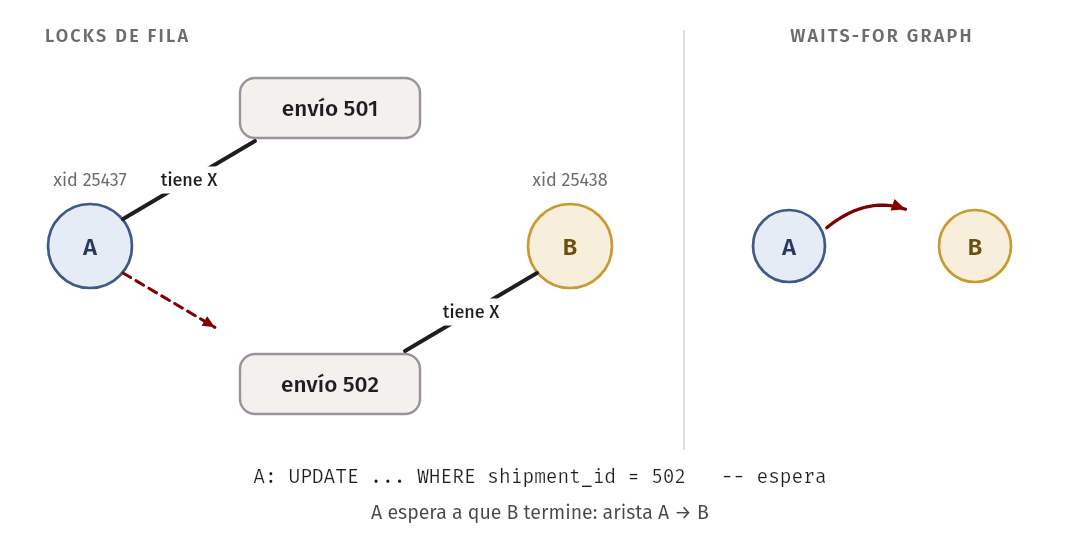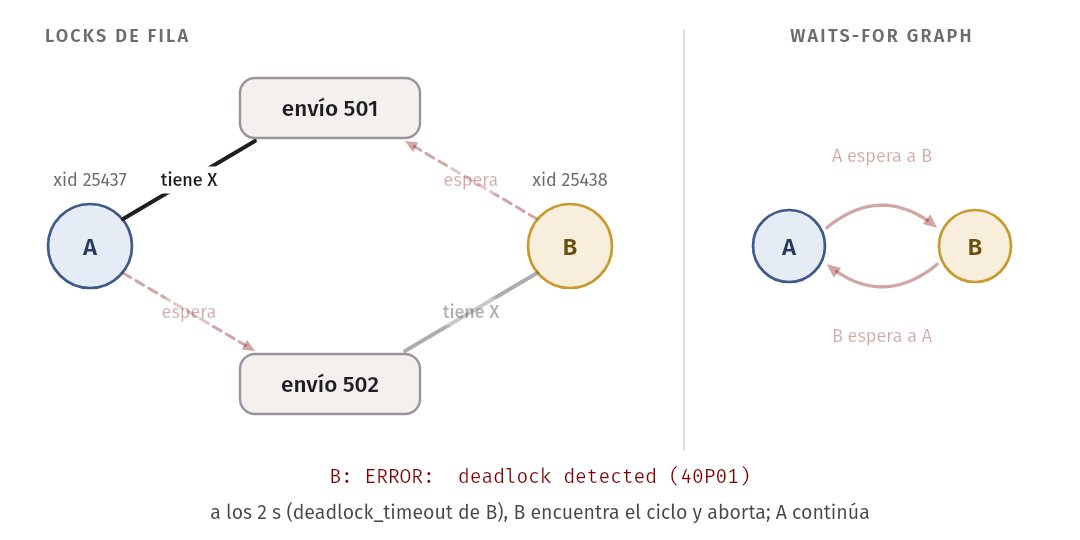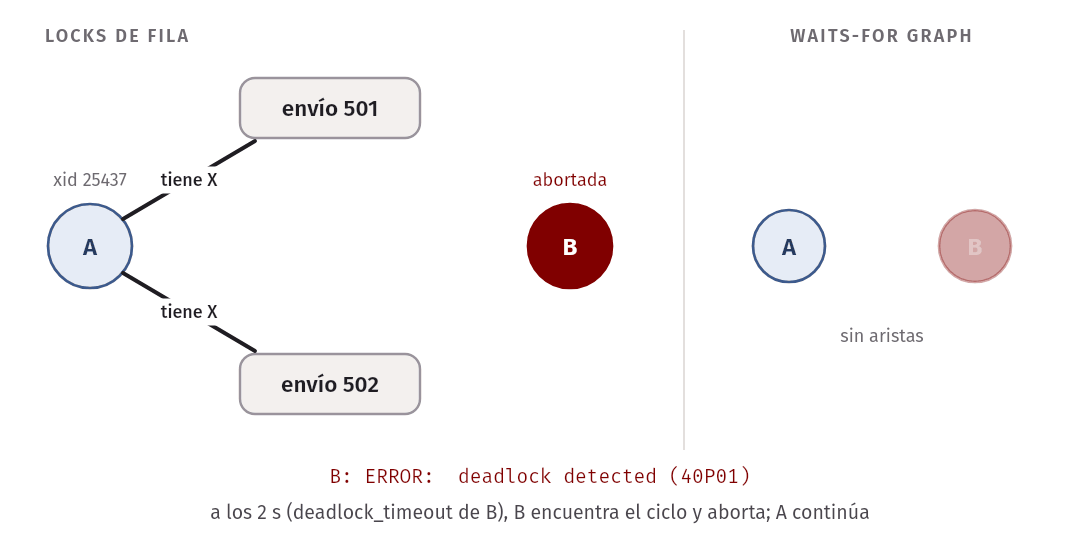
Cada sesión tiene su ExclusiveLock sobre su propio xid y pide un
ShareLock sobre el xid de la otra: esas dos filas con granted = f son las
dos aristas del waits-for graph, A → B y B → A. Cada una tiene además el lock
tuple de la fila que quiere: A, el de (6,15) (el envío 502); B, el de
(147,65) (la versión actual del envío 501). pg_blocking_pids da
directamente las aristas, y findCycle encuentra el ciclo. Dos segundos
después de empezar a esperar, B revisa y encuentra el deadlock:
B: ERROR:  deadlock detected  (código 40P01)
DETAIL:  Process 3937 waits for ShareLock on transaction 25437; blocked by process 3936.
         Process 3936 waits for ShareLock on transaction 25438; blocked by process 3937.
A: UPDATE 1   -- continúa
B: ROLLBACK
A: ROLLBACK
El error es 40P01 (deadlock_detected). El DETAIL describe el ciclo: el
proceso 3937 (B) espera la transacción 25437 (A) y el 3936 (A) espera la
25438 (B). La transacción de B queda abortada y suelta sus locks en ese
momento; A recibe su lock y su UPDATE termina. B solo puede hacer
ROLLBACK. En psql, el error trae además un HINT (See server log for query details.): el log del servidor guarda el texto de las consultas del
ciclo.
En PostgreSQL. La detección es perezosa. Una sesión que empieza a esperar un lock pone un temporizador de
deadlock_timeout(1 s por defecto). Si el lock llega antes, no pasó nada. Si no, al vencer el temporizador esa sesión recorre el waits-for graph buscando un ciclo que pase por ella y, si lo encuentra, se aborta a sí misma. No hay una elección de víctima por costo, como en el libro: la víctima es la primera cuyo temporizador vence con el ciclo ya formado. La idea es que buscar ciclos es caro y los deadlocks son raros, así que conviene no buscarlos en cada espera; el precio es que un deadlock dura al menosdeadlock_timeout.
Para comprobarlo, node deadlock.mjs cross 1s 4s invierte los tiempos (A,
1 s; B, 4 s). Ahora la víctima es A:
A: ERROR:  deadlock detected  (código 40P01)
DETAIL:  Process 5518 waits for ShareLock on transaction 27055; blocked by process 5519.
         Process 5519 waits for ShareLock on transaction 27054; blocked by process 5518.
B: UPDATE 1   -- continúa
A: ROLLBACK
B: ROLLBACK
Las pruebas de deadlock.test.mjs hacen
lo mismo con tiempos cortos y verifican la víctima en los dos sentidos.
Y el deadlock por upgrade, con node deadlock.mjs upgrade:
A: SELECT price FROM shipment WHERE shipment_id = 501 FOR SHARE
B: SELECT price FROM shipment WHERE shipment_id = 501 FOR SHARE
A: UPDATE shipment SET price = price + 1 WHERE shipment_id = 501   -- espera
B: UPDATE shipment SET price = price + 1 WHERE shipment_id = 501   -- espera

pg_locks con las dos esperando:
 session |   locktype    |   relation    | tuple |  xid  |       mode       | granted
---------+---------------+---------------+-------+-------+------------------+---------
 A       | relation      | shipment      |       |       | RowExclusiveLock | t
 A       | relation      | shipment      |       |       | RowShareLock     | t
 A       | relation      | shipment_pkey |       |       | RowExclusiveLock | t
 A       | relation      | shipment_pkey |       |       | RowShareLock     | t
 A       | transactionid |               |       | 25440 | ExclusiveLock    | t
 A       | transactionid |               |       | 25441 | ShareLock        | f
 B       | relation      | shipment      |       |       | RowExclusiveLock | t
 B       | relation      | shipment      |       |       | RowShareLock     | t
 B       | relation      | shipment_pkey |       |       | RowExclusiveLock | t
 B       | relation      | shipment_pkey |       |       | RowShareLock     | t
 B       | transactionid |               |       | 25441 | ExclusiveLock    | t
 B       | transactionid |               |       | 25440 | ShareLock        | f
(12 rows)

 session | pid  | blocked_by | wait_event_type | state
---------+------+------------+-----------------+--------
 A       | 3958 | {3959}     | Lock            | active
 B       | 3959 | {3958}     | Lock            | active
(2 rows)

findCycle: {"acyclic":false,"cycle":[3958,3959]}

B: ERROR:  deadlock detected  (código 40P01)
DETAIL:  Process 3959 waits for ShareLock on transaction 25440; blocked by process 3958.
         Process 3958 waits for ShareLock on transaction 25441; blocked by process 3959.
FOR SHARE es el lock-S de una fila; el UPDATE necesita el X. Las dos
tienen un S sobre la misma fila y cada una espera que la otra termine. Esta
vez no hay filas tuple: las dos ya tienen un lock sobre la fila (su
FOR SHARE), y en ese caso PostgreSQL no las pone en la fila de espera de la
tupla; solo esperan el xid de la otra. Fíjense
también en los locks de tabla: FOR SHARE toma ROW SHARE (RowShareLock)
y el UPDATE, además, ROW EXCLUSIVE; son compatibles entre sí y con los de
la otra sesión, así que nadie espera en la tabla. La forma de evitarlo es
leer con FOR UPDATE si se piensa escribir: la segunda sesión espera en la
lectura, no después.
Regla. Ante un
40P01, lo correcto es lo mismo que ante un40001(semana 13):ROLLBACKy reintentar la transacción completa. La función de reintento de la semana pasada ya trata los dos códigos. Y para que los deadlocks sean raros, se toman los locks en un orden fijo. Por ejemplo, para bloquear varios envíos de una vez:SELECT shipment_id FROM shipment WHERE shipment_id = ANY ($1) ORDER BY shipment_id FOR UPDATE;.
Granularidad múltiple
El problema
Hasta aquí, un ítem era una fila. Pero una transacción que recalcula el precio de los 12 000 envíos tendría que pedir 12 000 locks, y la lock table crecería en proporción. Al revés, si los ítems fueran tablas enteras, una transacción que cambia un envío bloquearía a todas las demás que quieren tocar cualquier otro envío. Lo ideal es dejar que cada transacción elija el tamaño de lo que bloquea: la granularidad.
Los ítems se organizan en un árbol (sec. 18.3): la base de datos en la raíz,
debajo las tablas (el libro dice areas y files), debajo las páginas y en
las hojas las filas. Bloquear un nodo en modo S o X bloquea implícitamente,
en el mismo modo, todo su subárbol. Si T1 tiene X sobre la tabla shipment,
tiene X sobre cada envío sin haberlo pedido uno por uno.
El problema aparece al pedir. Si T2 quiere S sobre el envío 501, tiene que saber que T1 tiene un X implícito sobre él. Revisar el envío no basta (T1 no lo bloqueó explícitamente): habría que revisar todos sus ancestros. Y si T3 quiere X sobre la tabla entera, tendría que revisar todas las filas de la tabla por si alguna tiene un lock, que es justo lo que queríamos evitar.
Locks de intención
La solución son los locks de intención (intention locks): antes de bloquear un nodo, una transacción marca a todos sus ancestros con su intención. Hay tres:
- IS (intention-shared): voy a bloquear en S algo más abajo.
- IX (intention-exclusive): voy a bloquear en X (o S) algo más abajo.
- SIX (shared and intention-exclusive): leo todo este subárbol (S explícito sobre el nodo) y voy a escribir algunas partes (IX).
Con eso, T3 ve el IX de T1 en la tabla y sabe, sin bajar, que no puede tomar X sobre ella. La matriz de compatibilidad completa (✓ = compatible):
| IS | IX | S | SIX | X | |
|---|---|---|---|---|---|
| IS | ✓ | ✓ | ✓ | ✓ | |
| IX | ✓ | ✓ | |||
| S | ✓ | ✓ | |||
| SIX | ✓ | ||||
| X |
Se lee razonando sobre los subárboles. IX con IX es compatible: dos transacciones que van a escribir filas de la misma tabla pueden convivir, y si chocan en una fila, el conflicto se resuelve en esa fila. IX con S no: quien tiene S leyó toda la tabla, y quien tiene IX va a escribir alguna parte de ella. SIX es S más IX, así que es compatible solo con lo que es compatible con los dos, que es IS.
El protocolo
Ti puede bloquear un nodo Q si sigue estas reglas (sec. 18.3):
- Respeta la matriz de compatibilidad.
- Bloquea primero la raíz, en cualquier modo.
- Bloquea Q en S o IS solo si tiene el padre de Q en IX o IS.
- Bloquea Q en X, SIX o IX solo si tiene el padre de Q en IX o SIX.
- Sigue 2PL: no bloquea un nodo después de haber soltado alguno.
- Suelta Q solo si no tiene bloqueado a ninguno de sus hijos.
Los locks se piden de la raíz hacia las hojas y se sueltan de las hojas hacia la raíz. Ejemplos con Chasqui:
- Leer el envío 501: IS en la base, IS en
shipment, S en la fila. - Actualizar el envío 501: IX en la base, IX en
shipment, X en la fila. - Leer toda la tabla
agency: IS en la base, S enagency. Un solo lock de tabla, ninguno de fila. - Leer todos los envíos y corregir el precio de algunos: IX en la base, SIX
en
shipmenty X en cada fila que cambia. Las filas que solo lee están cubiertas por el S implícito del SIX.
El protocolo aumenta la concurrencia y baja el número de locks, sobre todo en una mezcla de transacciones cortas que tocan pocas filas y transacciones largas que leen tablas enteras. Un complemento es el lock escalation: cuando una transacción acumula demasiados locks de fila en una tabla, el sistema los reemplaza por un solo lock de tabla. Se ahorra memoria, a costa de concurrencia. Es otra forma de deadlock por upgrade: dos transacciones con IX sobre la misma tabla que escalan a X a la vez se esperan mutuamente.
Los locks de tabla de PostgreSQL
PostgreSQL tiene ocho modos de lock de tabla, con nombres históricos que
confunden (todos se llaman “lock de tabla”, aunque varios solo sirven para
anunciar locks de fila). node locks.mjs matrix mide su matriz de
conflictos: la sesión A toma cada modo sobre agency con LOCK TABLE y la
sesión B pide cada uno de los ocho con NOWAIT, que en vez de esperar falla
con el error 55P03:
tiene \ pide               AS   RS   RE  SUE    S  SRE    E   AE
ACCESS SHARE               ok   ok   ok   ok   ok   ok   ok    X
ROW SHARE                  ok   ok   ok   ok   ok   ok    X    X
ROW EXCLUSIVE              ok   ok   ok   ok    X    X    X    X
SHARE UPDATE EXCLUSIVE     ok   ok   ok    X    X    X    X    X
SHARE                      ok   ok    X    X   ok    X    X    X
SHARE ROW EXCLUSIVE        ok   ok    X    X    X    X    X    X
EXCLUSIVE                  ok    X    X    X    X    X    X    X
ACCESS EXCLUSIVE            X    X    X    X    X    X    X    X
Es la tabla de Conflicting Lock Modes de la documentación, y
locks.test.mjs la compara entrada por
entrada. Con la matriz IS/IX/S/SIX/X al lado, el parecido es claro:
| Modo de PostgreSQL | Quién lo toma | Papel |
|---|---|---|
ACCESS SHARE |
SELECT |
como IS: solo choca con el X de DROP / ALTER |
ROW SHARE |
SELECT ... FOR UPDATE / FOR SHARE |
intención de bloquear filas |
ROW EXCLUSIVE |
INSERT, UPDATE, DELETE |
como IX |
SHARE UPDATE EXCLUSIVE |
VACUUM, ANALYZE, CREATE INDEX CONCURRENTLY |
no choca con lecturas ni escrituras, sí consigo mismo |
SHARE |
CREATE INDEX |
como S: la tabla no cambia mientras se construye el índice |
SHARE ROW EXCLUSIVE |
CREATE TRIGGER y algunas formas de ALTER TABLE |
como SIX |
EXCLUSIVE |
REFRESH MATERIALIZED VIEW CONCURRENTLY |
como X, pero deja pasar los SELECT |
ACCESS EXCLUSIVE |
DROP TABLE, TRUNCATE, VACUUM FULL, muchas formas de ALTER TABLE |
X |
ROW EXCLUSIVE es compatible consigo mismo (dos UPDATE de filas distintas
conviven) y choca con SHARE, como IX con S. SHARE ROW EXCLUSIVE es
compatible solo con los dos modos más débiles, como SIX con IS. La analogía
no es exacta (EXCLUSIVE deja leer, y SHARE UPDATE EXCLUSIVE no tiene
equivalente), pero la idea es la misma: el lock de tabla anuncia lo que la
transacción hace adentro.
locks.mjs también reproduce el conflicto IX contra S con una espera real. A
actualiza un envío (toma ROW EXCLUSIVE) y B quiere congelar la tabla con
LOCK TABLE shipment IN SHARE MODE:
A: BEGIN
A: UPDATE shipment SET price = price + 1 WHERE shipment_id = 501
B: BEGIN
B: LOCK TABLE shipment IN SHARE MODE   -- espera
 session |   locktype    |   relation    | tuple |  xid  |       mode       | granted
---------+---------------+---------------+-------+-------+------------------+---------
 A       | relation      | shipment      |       |       | RowExclusiveLock | t
 A       | relation      | shipment_pkey |       |       | RowExclusiveLock | t
 A       | transactionid |               |       | 25436 | ExclusiveLock    | t
 B       | relation      | shipment      |       |       | ShareLock        | f
(4 rows)

A: ROLLBACK
B: LOCK TABLE   -- continúa
 session | locktype | relation | tuple | xid |   mode    | granted
---------+----------+----------+-------+-----+-----------+---------
 B       | relation | shipment |       |     | ShareLock | t
(1 row)
B espera hasta que A termina. Ojo con los nombres: este ShareLock es el
modo SHARE sobre la tabla; el ShareLock de un deadlock era el mismo
modo sobre un xid. PostgreSQL usa los mismos ocho nombres para todos los
tipos de lock.
En PostgreSQL. Los locks de fila no están en la lock table, así que no hay lock escalation: un
UPDATEde un millón de filas sigue teniendo un solo lock de tabla y un xid. Hay cuatro modos de lock de fila, de más fuerte a más débil:FOR UPDATE(el que tomanDELETEy losUPDATEque cambian una columna con índice único, que podría ser destino de una clave foránea),FOR NO KEY UPDATE(el resto de losUPDATE),FOR SHAREyFOR KEY SHARE. Este último lo toma la verificación de una clave foránea sobre la fila referenciada: al insertar un envío, PostgreSQL bloquea su agencia de origen para que nadie la borre antes del commit, pero deja que otros actualicen su ciudad (cityno tiene índice único). Por eso, después dechasqui-load, las tuplas referenciadas tienenxmaxigual axmin, como vimos en la semana 9: la transacción de la carga dejó anotado su propio lockFOR KEY SHARE.
Inserciones, borrados y phantoms
delete e insert
El modelo de read(Q) y write(Q) deja afuera dos operaciones: crear y
borrar ítems (sec. 18.4). Para 2PL, delete(Q) necesita un lock X sobre Q
(entra en conflicto con cualquier lectura o escritura de Q: si se borra
antes, la otra operación falla; si se borra después, la otra vio la fila). Un
insert(Q) le da a la transacción un X sobre el ítem nuevo: nadie lo ve
hasta que ella termine.
El phantom
Eso no basta. El ejemplo de Chasqui: T1 suma el peso de los envíos del viaje 12 para ver si cabe uno más,
SELECT sum(weight_kg) FROM shipment WHERE trip_id = 12;y mientras tanto T2 registra un envío nuevo con trip_id = 12 y hace commit.
T1 tiene S sobre todas las filas que leyó; T2 tiene X sobre una fila que no
existía cuando T1 leyó. No comparten ninguna fila, así que no hay ningún
conflicto entre sus locks, y sin embargo T1 y T2 sí están en conflicto: si T1
vuelve a sumar, el resultado cambia. La fila nueva es un phantom. El
conflicto no es sobre una tupla, sino sobre un predicado: “los envíos con
trip_id = 12”.
La serializabilidad por conflictos de la semana 13 asumía un conjunto fijo de ítems. Con inserciones, el schedule de 2PL con locks de fila no es serializable: T1 vio la tabla antes de T2 en su primera lectura y después de T2 en la segunda. Hay tres soluciones:
- Bloquear la tabla. T1 toma S sobre
shipment(o, con granularidad múltiple, T2 necesita IX, que choca). Funciona, pero un reporte del viaje 12 detendría todas las inserciones de envíos de cualquier viaje. - Index locking. Si hay un índice sobre
trip_id, toda búsqueda portrip_id = 12pasa por las hojas del índice donde está (o estaría) ese valor. El protocolo: quien busca bloquea en S las hojas del índice que recorre; quien inserta, borra o cambiatrip_idbloquea en X las hojas que modifica. T1 y T2 chocan en la hoja del índice que contiene el 12. La variante usada en la práctica es next-key locking: en vez de la hoja entera, se bloquean los valores de clave que se leyeron más el siguiente, lo que cubre el “hueco” donde se insertaría un 12 nuevo. - Predicate locking. Bloquear el predicado mismo (
trip_id = 12) y, al insertar, revisar si la fila nueva satisface algún predicado bloqueado. Es la solución exacta, pero decidir si dos predicados se pueden superponer es caro en general, y los motores lo hacen solo en forma aproximada.
En PostgreSQL. En
REPEATABLE READ, PostgreSQL no permite phantoms sin usar ningún lock de predicado: la transacción lee siempre de la misma foto (la Sesión B lo explica), así que la segunda suma da lo mismo que la primera, aunque T2 ya haya hecho commit. Es más de lo que exige el estándar SQL, que sí permite phantoms en ese nivel. EnSERIALIZABLE, además, usa locks de predicado aproximados (losSIReadLock), que no bloquean a nadie: los vamos a ver con el write skew.
Multiversion concurrency control
Que los lectores no esperen
Con 2PL, un reporte que lee el envío 501 espera a quien lo está modificando,
y quien quiere modificarlo espera a que el reporte termine. Las lecturas y
las escrituras se bloquean entre sí aunque la lectura no necesite el valor
nuevo para nada: le bastaría el valor de antes. Esa es la idea del
multiversion concurrency control (MVCC): cada write(Q) crea una
versión nueva de Q en vez de sobrescribirla, y cada read(Q) elige la
versión que le corresponde a la transacción que lee (sec. 18.7). Así una
lectura nunca espera ni hace que nadie espere. Lo que hay que definir es qué
versión le corresponde a cada lectura, de modo que el resultado siga siendo
serializable o, al menos, coherente.
Multiversion timestamp ordering
El primer esquema del libro (sec. 18.7.1) usa timestamps. Cada transacción
recibe un TS(Ti) al empezar, y cada versión Qk de un ítem Q guarda tres
cosas: su valor, W-timestamp(Qk), el timestamp de la transacción que la
creó, y R-timestamp(Qk), el timestamp más grande de las transacciones que
la leyeron. Cuando Ti hace read(Q) o write(Q), sea Qk la versión de Q con
el W-timestamp más grande que sea menor o igual que TS(Ti) (la última versión
“anterior” a Ti):
read(Q): devuelve Qk, y sube R-timestamp(Qk) si TS(Ti) es mayor.write(Q): si TS(Ti) < R-timestamp(Qk), una transacción más nueva ya leyó Qk y no vio lo que Ti quiere escribir: rollback de Ti. Si TS(Ti) = W-timestamp(Qk), Ti sobrescribe su propia versión. Si no, se crea una versión nueva con W-timestamp = R-timestamp = TS(Ti).
Las lecturas nunca fallan ni esperan. El orden serial equivalente es el de los timestamps. Los costos: cada lectura actualiza R-timestamp (una escritura más), los conflictos se resuelven con rollbacks y, sin reglas extra, los schedules pueden no ser recuperables (Ti puede leer una versión de una transacción que después aborta).
Multiversion 2PL
El segundo esquema (sec. 18.7.2) separa dos tipos de transacciones. Las de
actualización usan rigorous 2PL: guardan todos sus locks hasta el commit,
y cada escritura crea una versión nueva. Las de solo lectura no toman
locks: al empezar reciben como timestamp el valor actual de un contador,
ts-counter, y leen la versión con el timestamp más grande que no supere el
suyo. Cuando una transacción de actualización hace commit, a sus versiones
nuevas se les pone el timestamp ts-counter + 1 y se incrementa el contador
(un commit a la vez). Una lectura nunca ve versiones de transacciones que
hicieron commit después de que ella empezó, ni versiones sin commit. Los
schedules son recuperables y cascadeless.
Snapshot isolation
Los motores actuales usan sobre todo una variante más simple (sec. 18.8): la snapshot isolation (SI).
- Cada transacción lee de un snapshot: la base tal como estaba con las transacciones que habían hecho commit cuando ella empezó. No ve nada de lo que hicieron después las demás, aunque hagan commit.
- Sus escrituras son privadas hasta el commit (ella sí las ve).
- Si dos transacciones concurrentes (que se superponen en el tiempo) escriben el mismo ítem, solo una puede hacer commit.
Para la tercera regla hay dos variantes. First committer wins: cuando Ti
va a hacer commit, si alguna transacción concurrente que ya hizo commit
escribió un ítem que Ti también escribió, Ti aborta. First updater wins:
cuando Ti quiere escribir un ítem, pide un lock de escritura; si lo tiene una
transacción concurrente Tj, Ti espera. Si Tj hace commit, Ti aborta; si Tj
aborta, Ti recibe el lock y sigue (si nadie más que haya hecho commit
escribió el ítem desde su snapshot). PostgreSQL usa first updater wins: es lo
que vieron la semana pasada con could not serialize access due to concurrent update (40001) en REPEATABLE READ.
SI evita dirty reads, non-repeatable reads, lost updates y, como el snapshot
es fijo, también los phantoms. Los lectores nunca bloquean a los escritores
ni al revés. Parece serializable, y por eso durante años Oracle la llamó
SERIALIZABLE. Pero no lo es: más abajo vamos a construir un schedule que SI
deja pasar y que no es equivalente a ningún orden serial.
Error común. Creer que snapshot isolation es serializable. Evita todas las anomalías de la tabla de niveles de aislamiento del estándar, pero permite una que esa tabla no nombra: el write skew.
Con muchas versiones hay que limpiar. Una versión vieja se puede borrar
cuando ninguna transacción activa puede necesitarla, es decir, cuando hay una
versión más nueva que todas las transacciones activas ya ven. Ese trabajo es
la recolección de basura (garbage collection) de versiones, y en
PostgreSQL se llama VACUUM.
MVCC en PostgreSQL
xmin, xmax y ctid
En la semana 9 vimos que un UPDATE en PostgreSQL no sobrescribe la fila:
escribe una tupla nueva y marca la vieja. Esas tuplas son las versiones de
MVCC. Cada una guarda en su encabezado, entre otras cosas:
xmin: el xid de la transacción que creó esa versión (conINSERToUPDATE).xmax: el xid de la transacción que la borró o la reemplazó (conDELETEoUPDATE), o que tiene un lock sobre ella; 0 si no hay ninguna.ctid: la posición física de la versión, (página, slot).
Las tres se pueden consultar como columnas del sistema (ocultas en
SELECT *). El estado de cada transacción (en curso, commit o abortada) se
guarda aparte, en pg_xact, dos bits por xid. Para no consultarlo cada vez,
el primero que lo averigua lo anota en el encabezado de la tupla con unos
bits de ayuda (hint bits), como el HEAP_XMIN_COMMITTED que vimos con
pageinspect en la semana 9; mientras no estén puestos, la fuente es
pg_xact. mvcc.mjs versions sigue al envío 501 con dos sesiones:
A: SELECT ctid, xmin, xmax, price FROM shipment WHERE shipment_id = 501
   ctid=(6,14) xmin=25380 xmax=25380 price=50.25
A: BEGIN
A: UPDATE shipment SET price = price + 1 WHERE shipment_id = 501
   (xid de A: 25428)
A: SELECT ctid, xmin, xmax, price FROM shipment WHERE shipment_id = 501
   ctid=(147,64) xmin=25428 xmax=0 price=51.25   -- A ve su versión nueva
B: SELECT ctid, xmin, xmax, price FROM shipment WHERE shipment_id = 501
   ctid=(6,14) xmin=25380 xmax=25428 price=50.25   -- B ve la versión vieja
B: SELECT pg_current_snapshot();
   25369:25428:25369
A: COMMIT
B: SELECT ctid, xmin, xmax, price FROM shipment WHERE shipment_id = 501
   ctid=(147,64) xmin=25428 xmax=0 price=51.25   -- ahora B ve la nueva
Paso por paso:
- Antes de empezar, la versión del envío 501 está en
(6,14). Suxmaxes igual a suxmin: no está borrada; es el lockFOR KEY SHAREque dejó la carga de datos al insertar los eventos del envío (shipment_eventtiene una clave foránea haciashipment). - A actualiza el precio. Su versión nueva está en otro lugar,
(147,64), conxmin= 25428 (A) y sinxmax. A la ve porque es suya. - B, al mismo tiempo, ve la versión vieja,
(6,14), que ahora tienexmax= 25428: A la reemplazó, pero A no ha hecho commit, así que para B sigue siendo la versión vigente. B no esperó a nadie. - Después del commit de A, la siguiente sentencia de B (en
READ COMMITTED) ve la versión nueva.
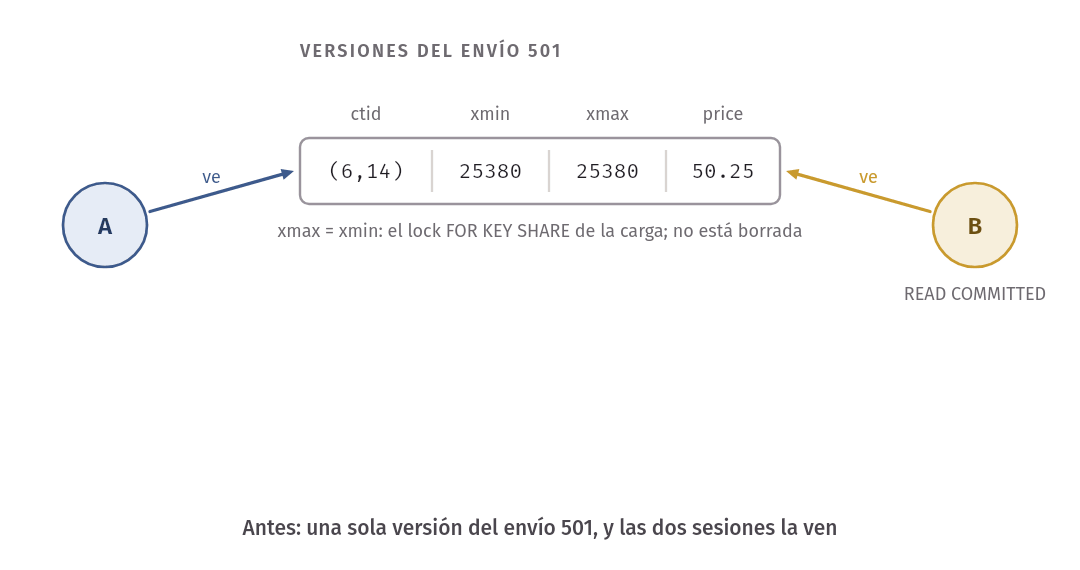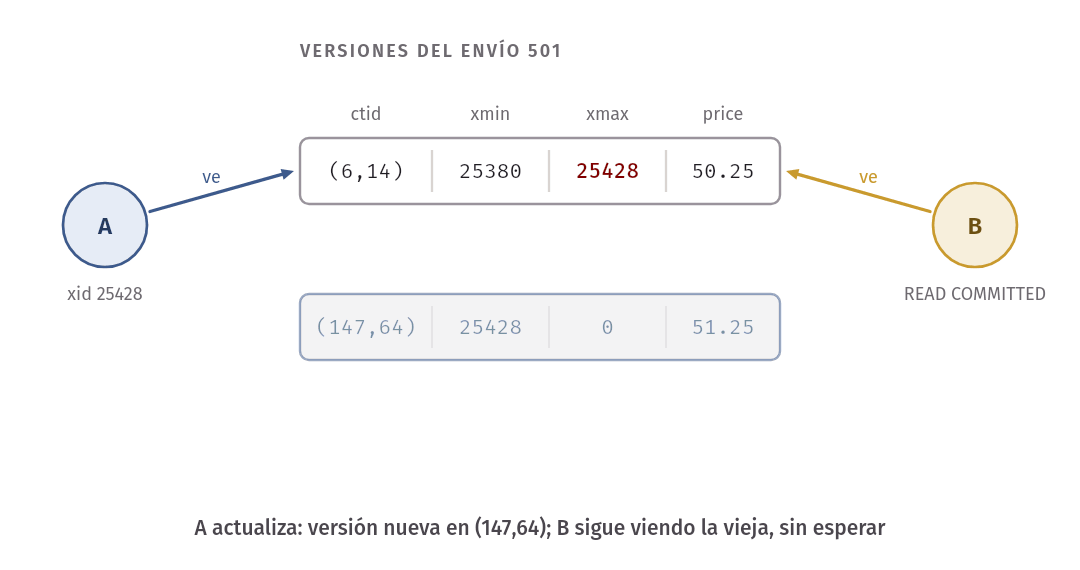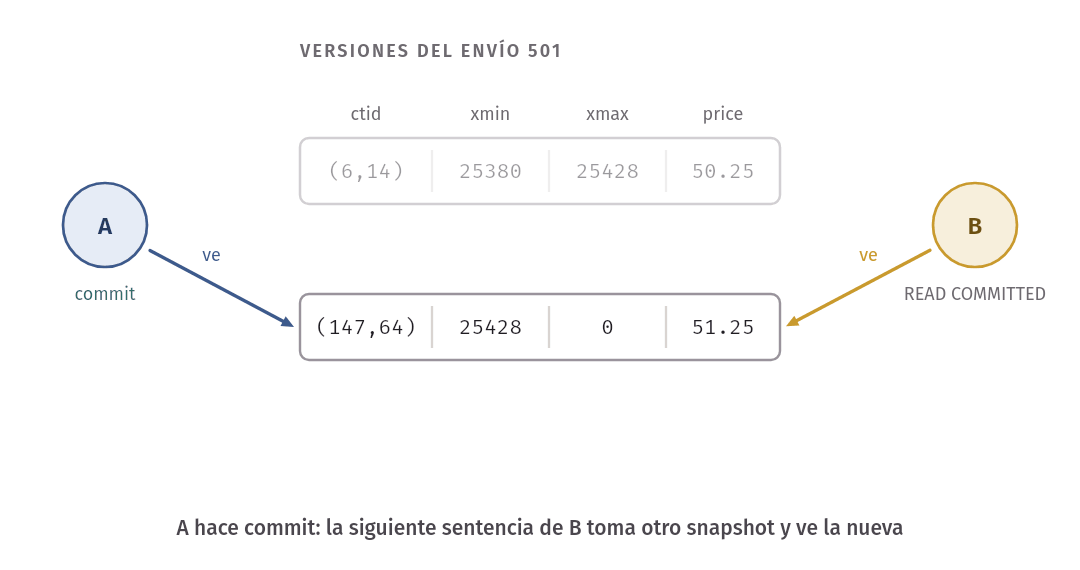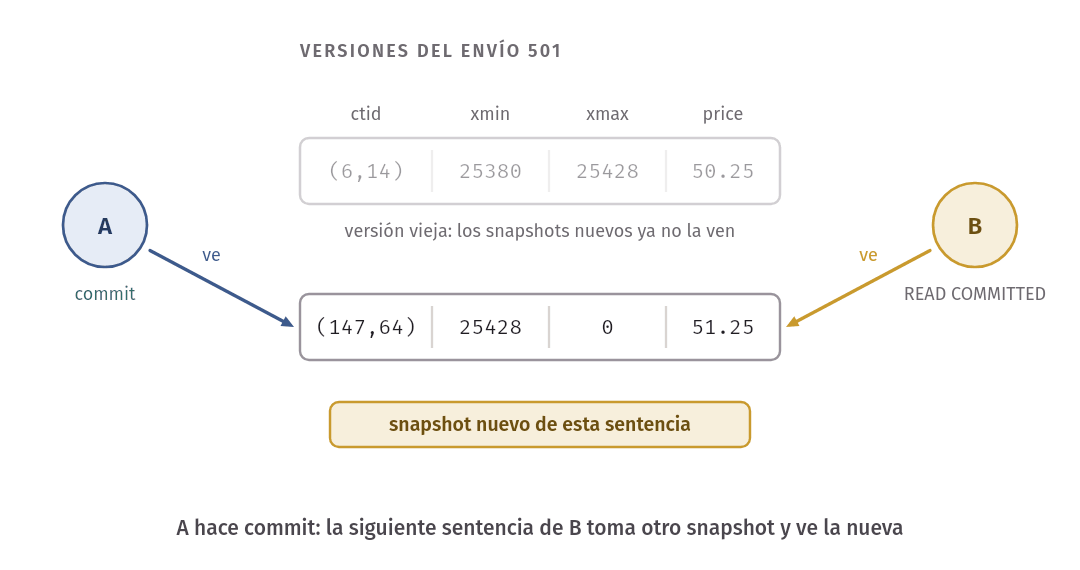
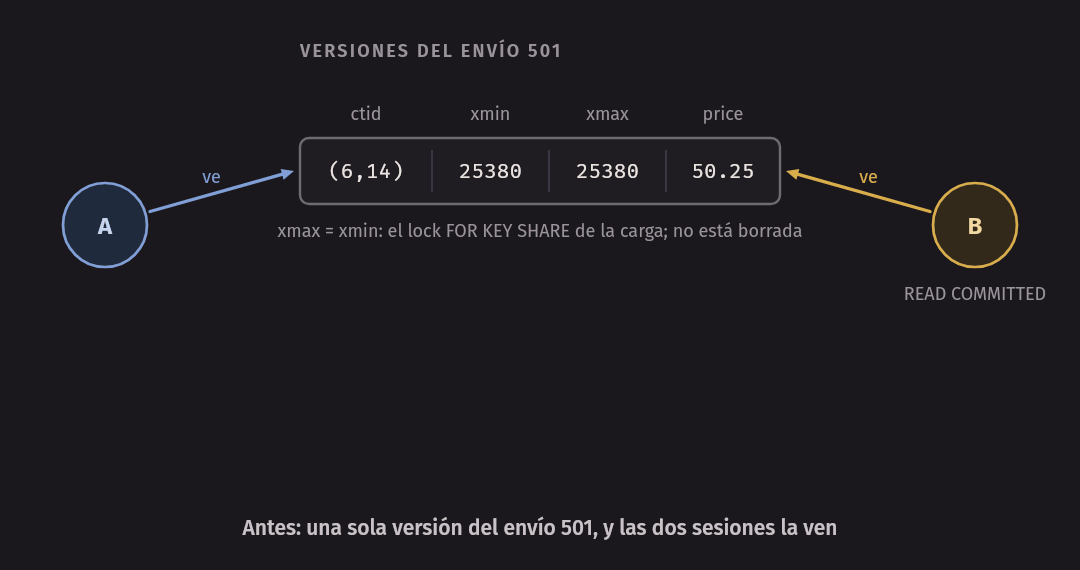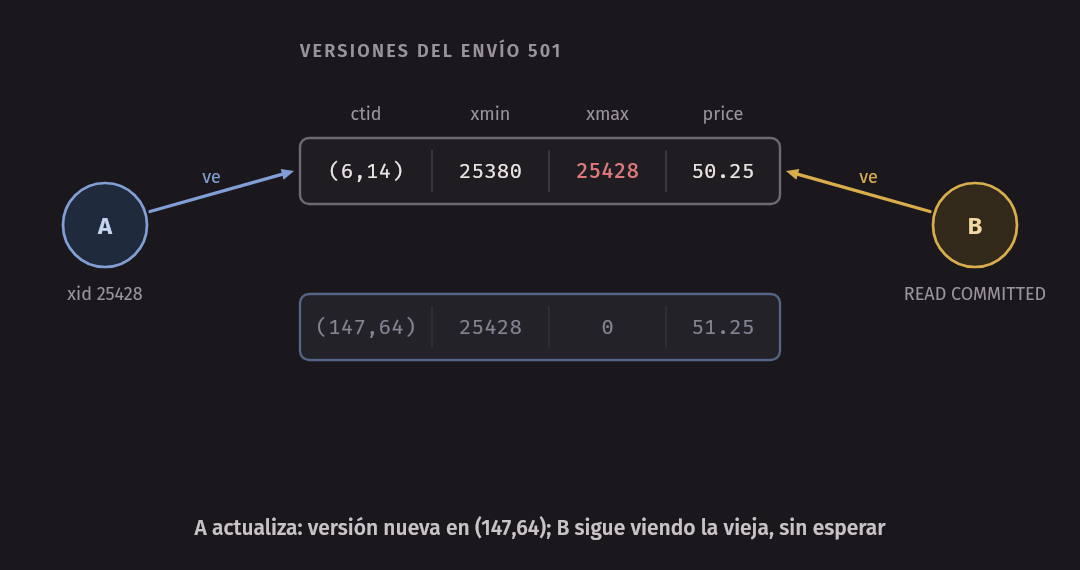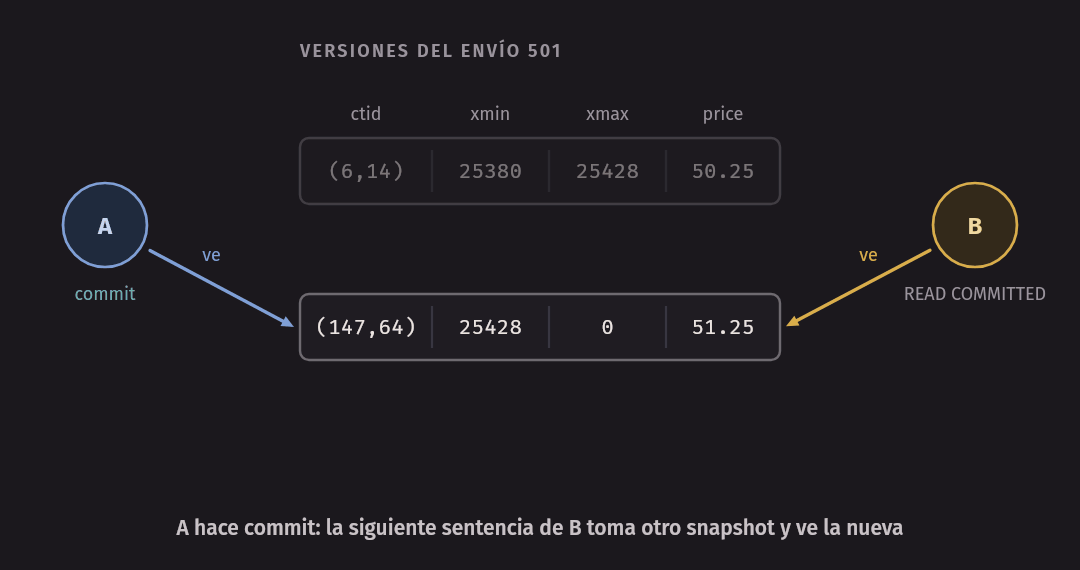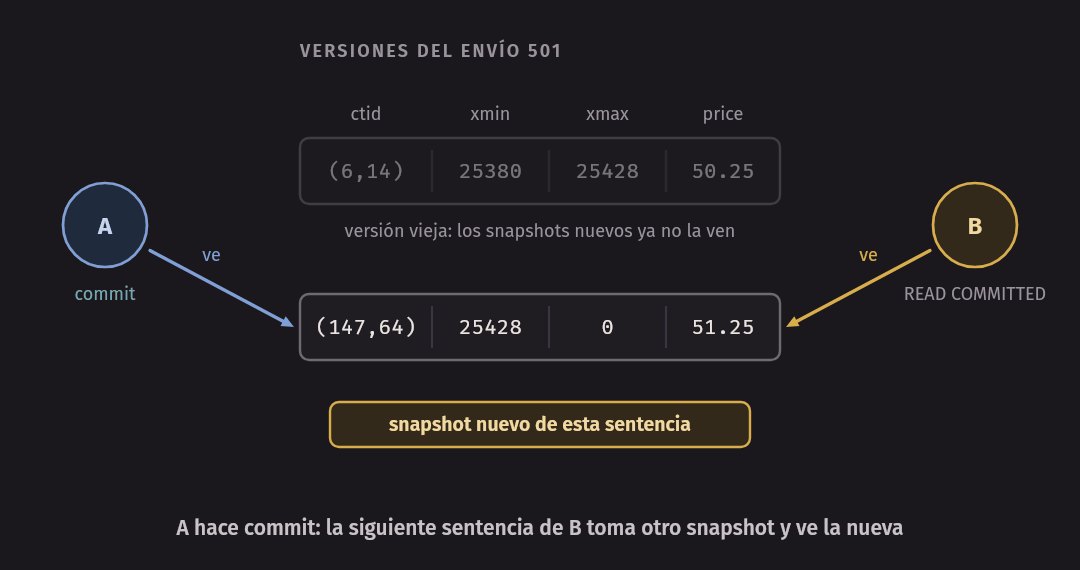
Ahora un lock sin escritura:
A: BEGIN
A: SELECT price FROM shipment WHERE shipment_id = 501 FOR UPDATE
   (xid de A: 25429)
B: SELECT ctid, xmin, xmax, price FROM shipment WHERE shipment_id = 501
   ctid=(147,64) xmin=25428 xmax=25429 price=51.25   -- mismo ctid, xmax es A
A: ROLLBACK
B: SELECT ctid, xmin, xmax, price FROM shipment WHERE shipment_id = 501
   ctid=(147,64) xmin=25428 xmax=25429 price=51.25   -- xmax sigue ahí, pero A abortó
SELECT ... FOR UPDATE no creó una versión nueva (el ctid es el mismo),
pero escribió el xid de A en xmax de la tupla, con una marca en el
encabezado que dice “solo lock”. Ese es el lock de fila de PostgreSQL. Cuando
A hace rollback, xmax queda escrito: no hace falta borrarlo, porque
cualquiera que lo lea consulta pg_xact, ve que 25429 abortó y lo ignora.
Snapshots y visibilidad
En PostgreSQL un snapshot es, casi, solo una lista de transacciones.
pg_current_snapshot() lo muestra como xmin:xmax:xip:
xmin: el xid más chico que todavía estaba en curso. Toda transacción con un xid menor ya terminó (con commit o con rollback).xmax: uno más que el xid más grande que ya había terminado. Toda transacción con un xid mayor o igual se considera en curso: no se ve.xip: los xids entrexminyxmaxque estaban en curso.
El snapshot de B en la salida de arriba es 25369:25428:25369. A (25428) no
aparece en la lista porque es xmax mismo: todo xid mayor o igual que 25428
cuenta como en curso. El 25369 es una transacción de otra sesión del
servidor, en otra base de datos (los xid son de todo el servidor, no de cada
base).
Con eso, la regla de visibilidad, simplificada: una versión es visible para una transacción con snapshot S si se cumplen las dos condiciones.
- La creó ella misma, o su
xminhizo commit y no estaba en curso según S (es menor quexmaxde S y no está enxip). - No tiene un
xmaxque cuente:xmaxes 0, o es solo un lock, o es de una transacción que abortó, o es de una transacción que estaba en curso según S. (Si elxmaxes de ella misma, la borró o la reemplazó ella, y no la ve.)
Cuándo se toma el snapshot depende del nivel de aislamiento:
- En
READ COMMITTED, cada sentencia toma un snapshot nuevo al empezar. Por eso B vio la versión nueva en la sentencia siguiente al commit de A. - En
REPEATABLE READySERIALIZABLE, la transacción toma un snapshot, en su primera sentencia, y lo usa hasta el final.
Si una sentencia de READ COMMITTED quiere actualizar una fila cuya versión
visible ya fue reemplazada por una transacción que hizo commit, PostgreSQL no
aborta: espera, toma la versión más nueva, vuelve a evaluar el WHERE sobre
ella y, si se sigue cumpliendo, la actualiza. En REPEATABLE READ eso
violaría el snapshot, y la transacción recibe el 40001 de first updater
wins.
Error común. Decir que
REPEATABLE READen PostgreSQL permite phantoms. No los permite, porque el snapshot es fijo: una consulta repetida no puede ver filas nuevas. Lo que sí permite es write skew.
VACUUM
Una versión vieja que ningún snapshot puede ver es una tupla muerta
(dead tuple). Sigue ocupando su lugar en la página hasta que VACUUM (o
autovacuum, el proceso que lo corre solo cada cierto tiempo) la quita, deja
su slot libre y actualiza el free space map. mvcc.mjs vacuum lo muestra.
Primero, sin nadie más en la base, actualiza 100 envíos sin cambiar su valor
(price = price igual crea versiones nuevas) y corre VACUUM (VERBOSE):
A: VACUUM (VERBOSE) shipment
   tuples: 2 removed, 12000 remain, 0 are dead but not yet removable
   removable cutoff: 25431, which was 1 XIDs old when operation ended
A: UPDATE shipment SET price = price WHERE shipment_id BETWEEN 1 AND 100
   UPDATE 100
A: VACUUM (VERBOSE) shipment
   tuples: 100 removed, 11982 remain, 0 are dead but not yet removable
   removable cutoff: 25433, which was 0 XIDs old when operation ended
El primer VACUUM deja la tabla limpia (encontró 2 tuplas muertas de antes).
Después del UPDATE, quita exactamente 100. Ahora B abre una transacción
REPEATABLE READ, lee algo (y con eso toma su snapshot), y A repite el
UPDATE:
B: BEGIN ISOLATION LEVEL REPEATABLE READ
B: SELECT count(*) FROM shipment
A: UPDATE shipment SET price = price WHERE shipment_id BETWEEN 1 AND 100
A: VACUUM (VERBOSE) shipment
   tuples: 0 removed, 11910 remain, 100 are dead but not yet removable
   removable cutoff: 25369, which was 65 XIDs old when operation ended
B: COMMIT
A: VACUUM (VERBOSE) shipment
   tuples: 100 removed, 11643 remain, 0 are dead but not yet removable
   removable cutoff: 25434, which was 0 XIDs old when operation ended
Con B abierta, VACUUM no quita nada: las 100 versiones viejas están
muertas para todos los snapshots nuevos, pero B todavía podría leerlas. El
removable cutoff lo explica: VACUUM solo quita versiones borradas por
transacciones anteriores a 25369, que es el xmin del snapshot de B (la
transacción más vieja que estaba en curso cuando B empezó). Cuando B termina,
el corte avanza y las 100 se quitan. (El número de remain es una
estimación: VACUUM solo recorre las páginas que pueden tener algo que
limpiar.)
Esto tiene una consecuencia práctica muy concreta: una transacción abierta durante horas impide limpiar todo lo que se borró desde que empezó, en todas las tablas de la base. Las tablas se inflan (bloat), los scans leen más páginas y el problema no se arregla solo cuando la transacción termina: el espacio liberado queda dentro del archivo. Una aplicación que deja conexiones “idle in transaction” es la causa típica.
VACUUM tiene un segundo trabajo. Los xid son de 32 bits, y PostgreSQL los
compara en forma circular: cada xid ve unos 2 000 millones de xids como
“pasado” y otros tantos como “futuro”. Si una tupla vieja conservara su
xmin original para siempre, cuando el contador diera la vuelta (wraparound)
su xmin pasaría a estar “en el futuro” y la tupla desaparecería. Para
evitarlo, VACUUM congela (freeze) las tuplas suficientemente viejas: las
marca como visibles para todos, sin importar su xmin. Autovacuum fuerza un
VACUUM de congelamiento sobre una tabla cuando su tupla sin congelar más
vieja tiene más de autovacuum_freeze_max_age transacciones (200 millones
por defecto).
Write skew
El caso del viaje 12
El viaje 12 usa el vehículo 11. Para el experimento, skew.mjs le deja una
capacidad de 60 kg (y al final se la devuelve). Hay dos envíos registrados
sin viaje: el 55, de 48,20 kg, y el 444, de 43,50 kg. Cada uno cabe solo;
los dos juntos, no. La empleada A quiere asignar el 55 y el empleado B, el
444. Cada uno revisa la carga del viaje con esta consulta y, si su envío
cabe, lo asigna:
SELECT v.capacity_kg, coalesce(sum(s.weight_kg), 0) AS load_kg
FROM trip t
  JOIN vehicle v ON v.vehicle_id = t.vehicle_id
  LEFT JOIN shipment s ON s.trip_id = t.trip_id
WHERE t.trip_id = 12
GROUP BY v.capacity_kg;
Con node skew.mjs rr, las dos sesiones trabajan en REPEATABLE READ y se
intercalan así:
A: BEGIN ISOLATION LEVEL REPEATABLE READ
B: BEGIN ISOLATION LEVEL REPEATABLE READ
A: carga del viaje 12
   capacity_kg=60 load_kg=0 -> 48.2 kg cabe
B: carga del viaje 12
   capacity_kg=60 load_kg=0 -> 43.5 kg cabe
A: UPDATE shipment SET trip_id = 12 WHERE shipment_id = 55
B: UPDATE shipment SET trip_id = 12 WHERE shipment_id = 444
A: COMMIT
B: COMMIT

 capacity_kg | load_kg
-------------+---------
          60 |   91.70
(1 row)
Las dos hicieron commit, y el viaje quedó con 91,70 kg en un vehículo de 60. Ninguna regla de SI se violó: A escribió la fila del envío 55 y B la del 444, filas distintas, así que no hubo conflicto de escritura. Cada una leyó un snapshot coherente. Y sin embargo ningún orden serial da este resultado: si A va primero, B ve 48,20 kg y no asigna; si B va primero, A ve 43,50 kg y no asigna.
Por qué no es serializable
Para verlo con un grafo hay que mirar las dependencias de lectura-escritura (rw-dependencies, o antidependencias): Ti → Tj si Ti leyó algo y Tj escribió después una versión nueva de eso, sin que Ti la viera. En el orden serial equivalente, Ti tiene que ir antes que Tj.
- A leyó “los envíos con
trip_id = 12” (ninguno). B escribió el 444 contrip_id = 12, que cambia ese resultado: A → B. - B leyó lo mismo, y A escribió el 55 con
trip_id = 12: B → A.
Dos antidependencias en ciclo: A antes que B y B antes que A. Esa es la forma del write skew: dos transacciones leen un conjunto de datos que se solapa, cada una toma una decisión con lo que leyó y escribe en partes distintas de ese conjunto. Como no escriben lo mismo, la regla de SI no las detiene.
Los ejemplos típicos son de este estilo: dos médicos de guardia que se retiran a la vez porque cada uno vio que había otro; dos reservas de la última plaza de un vuelo registradas en filas distintas; dos retiros de cuentas distintas de un mismo cliente que, juntos, dejan el saldo total en negativo. En Chasqui, cualquier regla que relacione varias filas (la capacidad de un viaje, el número de envíos por cliente) puede romperse así.
Arreglo 1: SERIALIZABLE
En PostgreSQL, SERIALIZABLE es serializable snapshot isolation (SSI):
la misma snapshot isolation, más un registro de qué leyó cada transacción.
Con eso detecta las antidependencias entre transacciones concurrentes. La
teoría dice que todo ciclo en el grafo de un schedule de SI tiene dos
antidependencias seguidas, Tin → Tpivot → Tout, entre transacciones
concurrentes: la estructura peligrosa (dangerous structure). PostgreSQL
busca esa estructura y, cuando la encuentra, aborta una de esas
transacciones con 40001 (en el write skew, Tin y Tout son la misma). Con node skew.mjs serializable:
A: BEGIN ISOLATION LEVEL SERIALIZABLE
B: BEGIN ISOLATION LEVEL SERIALIZABLE
A: carga del viaje 12
   capacity_kg=60 load_kg=0 -> 48.2 kg cabe
B: carga del viaje 12
   capacity_kg=60 load_kg=0 -> 43.5 kg cabe
A: UPDATE shipment SET trip_id = 12 WHERE shipment_id = 55
B: UPDATE shipment SET trip_id = 12 WHERE shipment_id = 444

 session | locktype |   relation    | page | tuple |    mode
---------+----------+---------------+------+-------+------------
 A       | relation | vehicle       |      |       | SIReadLock
 A       | tuple    | trip          |    0 |    12 | SIReadLock
 A       | page     | trip_pkey     |    1 |       | SIReadLock
 A       | relation | shipment      |      |       | SIReadLock
 A       | page     | shipment_pkey |    1 |       | SIReadLock
 B       | relation | vehicle       |      |       | SIReadLock
 B       | tuple    | trip          |    0 |    12 | SIReadLock
 B       | page     | trip_pkey     |    1 |       | SIReadLock
 B       | relation | shipment      |      |       | SIReadLock
 B       | page     | shipment_pkey |    2 |       | SIReadLock
(10 rows)

A: COMMIT
B: COMMIT
   ERROR:  could not serialize access due to read/write dependencies among transactions  (código 40001)

 capacity_kg | load_kg
-------------+---------
          60 |   48.20
(1 row)
Esta vez B falló, y en el COMMIT: hasta ahí no había forma de saber si la
estructura se iba a completar. Antes de los commits, la tabla muestra lo que
cada transacción leyó, como locks de modo SIReadLock. No bloquean a nadie
(no son locks en el sentido de 2PL; son marcas), pero cuando otra transacción
escribe algo cubierto por uno, PostgreSQL registra una antidependencia. Son
locks de predicado aproximados, a tres granularidades: una tupla (la fila 12
de trip), una página (de los índices) o una tabla entera. Para la suma de
pesos, PostgreSQL recorrió toda la tabla shipment con un sequential scan
(no hay índice sobre trip_id), así que bloqueó la tabla entera: cualquier
escritura en shipment de otra transacción SERIALIZABLE concurrente cuenta
como un conflicto con esa lectura.
Por eso SSI puede abortar de más (falsos positivos): con un lock de tabla,
dos transacciones que asignan envíos a viajes distintos también pueden
chocar. El costo de SERIALIZABLE es ese: hay que estar preparados para
reintentar cualquier transacción, como vimos la semana pasada, y conviene
tener índices que permitan locks de predicado finos. A cambio, el programador
no tiene que pensar en cada regla que relaciona filas: la base garantiza que
el resultado es el de algún orden serial.
Arreglo 2: materializar el conflicto
La otra salida es convertir el conflicto de lectura en uno de escritura que la base sí vea. Las dos transacciones toman un lock sobre una fila que representa la regla, la del viaje, antes de revisar la carga:
SELECT trip_id FROM trip WHERE trip_id = 12 FOR UPDATE;Con node skew.mjs rc-lock, en READ COMMITTED:
A: BEGIN ISOLATION LEVEL READ COMMITTED
B: BEGIN ISOLATION LEVEL READ COMMITTED
A: SELECT trip_id FROM trip WHERE trip_id = 12 FOR UPDATE
A: carga del viaje 12
   capacity_kg=60 load_kg=0 -> 48.2 kg cabe
B: SELECT trip_id FROM trip WHERE trip_id = 12 FOR UPDATE   -- espera
A: UPDATE shipment SET trip_id = 12 WHERE shipment_id = 55
A: COMMIT
   -- B continúa
B: carga del viaje 12
   capacity_kg=60 load_kg=48.20 -> 43.5 kg no cabe
B: COMMIT

 capacity_kg | load_kg
-------------+---------
          60 |   48.20
(1 row)
B espera en el FOR UPDATE hasta que A hace commit. Su siguiente sentencia,
la consulta de carga, toma un snapshot nuevo (es READ COMMITTED), ve el
envío 55 y concluye que el 444 no cabe. Los dos empleados quedan
serializados por el lock del viaje: la fila de trip hace de lock del
predicado “envíos del viaje 12”. El costo es que las asignaciones a un mismo
viaje ya no son concurrentes, que es justo lo que se quería.
node skew.mjs rr-lock repite exactamente lo mismo en REPEATABLE READ.
Comparen su salida con la de arriba (es el ejercicio 9):
B: SELECT trip_id FROM trip WHERE trip_id = 12 FOR UPDATE   -- espera
A: UPDATE shipment SET trip_id = 12 WHERE shipment_id = 55
A: COMMIT
   -- B continúa
B: carga del viaje 12
   capacity_kg=60 load_kg=0 -> 43.5 kg cabe
B: UPDATE shipment SET trip_id = 12 WHERE shipment_id = 444
B: COMMIT

 capacity_kg | load_kg
-------------+---------
          60 |   91.70
(1 row)
Arreglo 3: una restricción
La tercera opción es que la base verifique la regla, con un trigger que
revise la capacidad del viaje al asignar un envío (semana 5). Hay que tener
cuidado: el trigger lee con el mismo snapshot que la transacción, así que dos
triggers concurrentes en REPEATABLE READ tienen el mismo problema que las
dos consultas de arriba. Un trigger así necesita también el lock del viaje o
el nivel SERIALIZABLE. Las restricciones que el motor sí verifica sin
importar el snapshot son las de una sola fila (CHECK) y las de unicidad y
claves foráneas, que usan locks internos.
Protocolos con timestamps (opcional)
Esta sección acompaña las secciones 18.5 y 18.6 del libro. Si no alcanza el tiempo de clase, queda como lectura.
Timestamp ordering
En vez de esperar, se puede fijar el orden serial de antemano: el de los timestamps (sec. 18.5). Cada transacción recibe TS(Ti) al empezar (de un reloj o de un contador), y cada ítem Q guarda W-timestamp(Q), el TS más grande de las transacciones que lo escribieron, y R-timestamp(Q), el más grande de las que lo leyeron. El protocolo de timestamp ordering exige que toda operación en conflicto se ejecute en orden de timestamps:
- Ti hace
read(Q).- Si TS(Ti) < W-timestamp(Q), Ti querría leer un valor que ya sobrescribió una transacción más nueva: se rechaza y Ti hace rollback.
- Si no, se lee y R-timestamp(Q) pasa a ser el máximo entre su valor y TS(Ti).
- Ti hace
write(Q).- Si TS(Ti) < R-timestamp(Q), una transacción más nueva ya leyó Q sin el valor de Ti: rollback.
- Si TS(Ti) < W-timestamp(Q), Ti querría escribir un valor obsoleto: rollback.
- Si no, se escribe y W-timestamp(Q) = TS(Ti).
Una transacción que hace rollback se reinicia con un timestamp nuevo (al revés que en wait-die y wound-wait: con el viejo, volvería a fallar). El protocolo garantiza conflict serializability, porque todas las aristas del grafo de precedencia van de un timestamp menor a uno mayor, y no tiene deadlocks, porque nadie espera. Pero una transacción larga puede reiniciarse una y otra vez (starvation), y los schedules pueden no ser recuperables: Ti puede leer lo que escribió Tj y hacer commit antes de que Tj aborte. Para evitarlo, se pueden hacer todas las escrituras al final, de forma atómica, o hacer esperar las lecturas de datos sin commit.
La regla de escritura de Thomas (Thomas’ write rule) cambia un caso: si
TS(Ti) < W-timestamp(Q) en un write(Q), en vez de abortar, se ignora la
escritura. Nadie va a leer ese valor obsoleto: en el orden de timestamps, la
escritura de la transacción más nueva lo habría sobrescrito igual. Con esta
regla se aceptan schedules que no son conflict serializables. Un ejemplo es
el de la semana pasada, r1(A) w2(A) w1(A) w3(A) con TS(T1) < TS(T2) <
TS(T3): la escritura de T1 llega tarde y se descarta, y el resultado es el
del orden serial T1, T2, T3. Ese schedule es view serializable; la regla de
Thomas, en efecto, borra las escrituras obsoletas para aprovechar la view
serializability.
Validación
Si los conflictos son raros, pedir locks o revisar timestamps en cada operación es un costo que casi nunca rinde. El control de concurrencia optimista (optimistic concurrency control), o basado en validación (sec. 18.6), deja que cada transacción trabaje sin restricciones y revisa al final. Cada transacción pasa por tres fases:
- Lectura. Lee los ítems y hace sus escrituras en copias locales.
- Validación. Revisa si sus escrituras se pueden aplicar sin violar la serializabilidad.
- Escritura. Si pasó la validación, copia sus cambios a la base; si no, hace rollback.
El timestamp de Ti es el momento en que empieza su validación,
Validation(Ti), y el orden serial es el de esos timestamps. Ti pasa la
validación si, para toda Tk con TS(Tk) < TS(Ti), se cumple una de dos
condiciones: Tk terminó su fase de escritura antes de que Ti empezara
(Finish(Tk) < Start(Ti)), o los ítems que escribió Tk no se cruzan con los
que leyó Ti y Tk terminó de escribir antes de que Ti empezara a validar
(Start(Ti) < Finish(Tk) < Validation(Ti)). Las transacciones nunca esperan,
no hay rollbacks en cascada porque las escrituras se aplican solo después de
validar, y el costo aparece solo cuando hay conflictos de verdad. Las
aplicaciones usan la misma idea con una columna de versión: leen la fila con
su versión y la actualizan con WHERE version = $1; si el UPDATE no
afectó ninguna fila, alguien la cambió y hay que reintentar.
En el laboratorio
El laboratorio recorre este capítulo con tres terminales de psql: A y B
trabajan, C observa con las dos consultas de
locks.sql, que muestran pg_locks y quién
bloquea a quién (la segunda se limita a la base actual con
current_database(); la primera muestra los locks de todo el servidor). Los
pasos son los mismos que hacen los scripts de esta semana, pero a mano:
ustedes deciden cuándo corre cada sentencia y tienen tiempo de mirar. Para el
deadlock, SET deadlock_timeout = '10s'; en A y B da diez segundos para
dibujar el waits-for graph desde C antes de que una de las dos aborte. Si
trabajan sobre la base chasqui en vez de chasqui_w14, los ctid, los xid
y los xmax serán otros.
El código de la semana y make test
Dentro del contenedor, en code/week-14, make crea la base de datos
chasqui_w14 y make test la vuelve a crear y corre las pruebas:
$ make test
chasqui-load chasqui_w14
Base de datos chasqui_w14 lista.
...
✔ orden cruzado: B tiene el deadlock_timeout más corto y es la víctima
✔ orden cruzado: con los timeouts al revés, la víctima es A
✔ upgrade: las dos tienen FOR SHARE sobre 501 y las dos quieren escribirla
✔ locks de una lectura, una escritura, una espera y un lock de tabla
✔ la matriz de conflictos medida es la de la documentación de PostgreSQL
...
✔ REPEATABLE READ: las dos hacen commit y el viaje queda con 91,70 kg
✔ SERIALIZABLE: una de las dos recibe 40001 y la carga queda bien
...
ℹ tests 21
ℹ pass 21
ℹ fail 0
...| Archivo | Qué muestra |
|---|---|
sessions.mjs |
Abrir sesiones con nombre, lanzar una sentencia que va a esperar, saber cuándo está esperando de verdad, y mostrar pg_locks con psql |
locks.mjs |
Los locks de una lectura y de una escritura, una espera, ROW EXCLUSIVE contra SHARE, y la matriz de conflictos (matrix) |
deadlock.mjs |
Los dos deadlocks (orden cruzado y upgrade), con el waits-for graph y el error 40P01 |
waitsfor.mjs |
findCycle sobre una lista de aristas, y las aristas a partir de pg_blocking_pids |
mvcc.mjs |
xmin, xmax y ctid desde dos sesiones (versions), y VACUUM con y sin un snapshot abierto (vacuum) |
skew.mjs |
El write skew del viaje 12 en cuatro variantes: rr, serializable, rc-lock y rr-lock |
locks.sql |
Las consultas para observar desde una tercera terminal de psql |
*.test.mjs |
Las afirmaciones de este capítulo, contra la base |
Cada script se corre solo, por ejemplo PGDATABASE=chasqui_w14 node skew.mjs serializable, y deja los datos como estaban. Para coordinar dos
sesiones sin sleep, sessions.mjs lanza la sentencia que va a esperar sin
await y, desde la sesión observadora, consulta pg_stat_activity hasta que
wait_event_type es Lock y pg_blocking_pids no está vacío. Recién
entonces sigue con el paso siguiente. Cada sesión tiene un
statement_timeout de 20 s como red de seguridad. Las pruebas abren varias
sesiones sobre las mismas filas, así que los archivos se corren uno después
de otro (--test-concurrency=1).
Resumen
- Un lock S permite leer y uno X permite escribir; S es compatible solo con S. Si el lock pedido no es compatible con los concedidos, la transacción espera. Tener locks no basta para la serializabilidad: hace falta un protocolo.
- 2PL: una fase de crecimiento y una de contracción. Garantiza conflict serializability, con el orden de los lock points. Strict 2PL guarda los X hasta el final (cascadeless); rigorous 2PL guarda todos (orden de commits). Los upgrades van en la fase de crecimiento.
- El lock manager es una hash table de ítems con una cola FIFO de pedidos por ítem; un pedido se concede si es compatible y nadie espera antes, para evitar starvation.
- 2PL provoca deadlocks. Se previenen con un orden fijo, con wait-die (la vieja espera, la joven muere) o wound-wait (la vieja hiere, la joven espera), conservando el timestamp al reiniciar; o con timeouts. Se detectan con el waits-for graph: hay deadlock si y solo si hay un ciclo, y se elige una víctima.
- PostgreSQL busca el ciclo después de
deadlock_timeout(1 s) de espera, y la sesión que lo encuentra aborta con40P01. Los locks de fila están en la tupla (xmax); enpg_locks, una espera por una fila es unShareLocksobre el xid de quien la tiene (más un locktuplesi la que espera no tenía ya un lock sobre esa fila). - Granularidad múltiple: IS, IX, S, SIX y X; se bloquea de la raíz hacia
las hojas. En PostgreSQL,
ROW EXCLUSIVEcumple el papel de IX,ACCESS SHAREde IS ySHAREde S. - Un phantom es un conflicto sobre un predicado, no sobre una fila. Se evita con locks de tabla, index locking (next-key locking) o predicate locking.
- MVCC: cada escritura crea una versión y cada lectura elige la suya;
los lectores no esperan. Snapshot isolation: cada transacción lee su
snapshot y, si dos concurrentes escriben lo mismo, solo una hace commit
(PostgreSQL: first updater wins,
40001). - En PostgreSQL, cada tupla tiene
xminyxmax; un snapshot esxmin:xmax:xip;READ COMMITTEDtoma uno por sentencia yREPEATABLE READ, uno por transacción.VACUUMquita las versiones que ningún snapshot ve, y no puede con las que ve una transacción abierta; también congela tuplas por el wraparound. - Write skew: dos transacciones leen lo mismo y escriben filas distintas;
SI deja pasar las dos aunque no hay orden serial equivalente.
SERIALIZABLE(SSI, conSIReadLock) aborta una con40001, a veces de más;SELECT ... FOR UPDATEsobre una fila que represente la regla materializa el conflicto. - (Opcional) Timestamp ordering fija el orden por timestamps y aborta en vez de esperar; la regla de Thomas ignora escrituras obsoletas. La validación deja trabajar y revisa al final.
Ejercicios
- Para cada transacción, digan si cumple 2PL, strict 2PL o rigorous 2PL (o
ninguna), y marquen su lock point.
(a)
lock-X(A) lock-S(B) r(B) w(A) unlock(B) commit unlock(A). (b)lock-S(A) r(A) lock-X(B) unlock(A) w(B) unlock(B) commit. (c)lock-S(A) r(A) unlock(A) lock-S(B) r(B) unlock(B) commit. (d)lock-S(A) lock-X(B) r(A) w(B) commit unlock(A) unlock(B). - Muestren que
S = r1(A) w2(A) r3(B) w1(B)es conflict serializable y den su orden serial equivalente. Después muestren que no hay forma de agregarlelockyunlocka las tres transacciones, cumpliendo 2PL, que permita ese schedule. (Pista: ¿cuándo tiene que soltar T1 su lock sobre A y cuándo tiene que tener ya el de B?) - Construyan un schedule de tres transacciones que cumplan 2PL, pero no strict 2PL, en el que el abort de T1 obligue a abortar a T2 y el de T2, a T3. Agreguen los locks explícitamente. ¿Qué cambia si las tres siguen strict 2PL?
- Tres transacciones tienen timestamps T1 = 4, T2 = 9 y T3 = 14. T1 tiene un lock S sobre el envío 502 y T3 tiene un lock X sobre el envío 503. Ocurre, en este orden: T2 pide X sobre 502; T3 pide X sobre 502; T1 pide S sobre 503. Para wait-die y para wound-wait, digan qué pasa en cada paso (quién espera, quién hace rollback) y cómo queda el waits-for graph.
- Estado de un lock manager con colas FIFO: T1 tiene S sobre A y espera X
sobre C; T2 tiene X sobre B y espera X sobre A; T3 tiene S sobre C y espera X sobre
B; T4 tiene S sobre A y espera S sobre C. Dibujen el waits-for graph y
compruébenlo con
findCycle. ¿Hay deadlock? ¿Qué transacciones están en él? Si la víctima es la de número mayor del ciclo, ¿en qué orden terminan las demás? (Cuidado con T4: ¿por qué espera, si S es compatible con S?) - Una transacción lee todas las filas de
agencyy cambia la ciudad de la agencia 5; otra, al mismo tiempo, lee la agencia 7. Con multiple granularity locking (base, tabla, fila), ¿qué locks pide cada una? ¿Puede la segunda avanzar? ¿Y si quisiera escribir la agencia 7? ¿Qué modo de tabla de PostgreSQL elegirían conLOCK TABLEpara la primera, si quisieran el equivalente exacto de SIX? Compruébenlo con la matriz denode locks.mjs matrix. - En
chasqui_w14, abran dos sesiones depsql. En A:BEGIN;ySELECT * FROM agency WHERE agency_id = 5 FOR KEY SHARE;. En B, pruebenUPDATE agency SET city = city WHERE agency_id = 5;, despuésUPDATE agency SET name = name || '!' WHERE agency_id = 5;y despuésDELETE FROM agency WHERE agency_id = 5;(conSET lock_timeout = '2s';para no esperar demasiado). ¿Cuáles esperan? Relaciónenlo con los cuatro modos de lock de fila y con las claves foráneas derouteyshipment. - Con
mvcc.mjs versionscomo guía, hagan a mano en dos sesiones: A abre una transacciónREPEATABLE READy lee el envío 501 conctid,xminyxmax; B actualiza el precio y hace commit (fuera de una transacción explícita). A vuelve a leer. ¿Qué versión ve A y por qué, según la regla de visibilidad y supg_current_snapshot()? ¿Qué pasa si ahora A intentaUPDATE shipment SET price = price + 1 WHERE shipment_id = 501? ¿Y si A estuviera enREAD COMMITTED? - Corran
node skew.mjs rc-lockynode skew.mjs rr-lock. En los dos, B espera el lock del viaje hasta el commit de A. ¿Por qué enREAD COMMITTEDB ve los 48,20 kg y enREPEATABLE READno? ¿En qué momento tomó B su snapshot en cada caso? ¿Por qué elFOR UPDATEde B sobre el viaje no falla con40001, si A tuvo un lock sobre esa fila? - Modifiquen el schedule de
skew.mjs serializablepara que las dos sesiones asignen envíos a viajes distintos (por ejemplo, 12 y 15, que usan el mismo vehículo pero son viajes diferentes). ¿Alguna recibe40001? Expliquen el resultado con losSIReadLockde la tablashipment. Creen un índice sobreshipment (trip_id)enchasqui_w14, haganANALYZEy repitan: ¿cambian losSIReadLocky el resultado? - Con timestamp ordering y TS(T1) = 1, TS(T2) = 2, sigan R-timestamp(A) y
W-timestamp(A) en
r1(A) r2(A) w2(A) w1(A): ¿qué operación se rechaza y por qué? ¿Cambia algo con la regla de Thomas? Repitan conr1(A) w2(A) w1(A): ¿qué hace cada versión del protocolo, qué schedule resulta con la regla de Thomas y a qué orden serial es view equivalente? - (Desafío) Escriban un script en Node.js, con
sessions.mjs, que arme un deadlock de tres sesiones (A espera a B, B espera a C, C espera a A) sobre los envíos 501, 502 y 503. Muestren el waits-for graph conpg_blocking_pidsyfindCycleantes de que PostgreSQL lo resuelva, y lean elDETAILdel error: ¿cuántas líneas tiene? Fijen losdeadlock_timeoutpara que la víctima sea C, y escriban una prueba que lo verifique.