
Apuntes · Capítulo 16Transacciones y distribuidos
Bases de datos distribuidas, NoSQL y cierre del curso
Bases de datos distribuidas, NoSQL y cierre del curso
Durante quince semanas Chasqui vivió en un solo servidor. Una sola máquina
guardaba las 12 000 filas de shipment, un solo buffer pool decidía qué
páginas estaban en memoria, un solo lock manager ordenaba a las
transacciones y un solo WAL permitía recuperarse de una caída. En la semana
15 apareció por primera vez una segunda máquina: el servidor de respaldo
que recibe el log del primario y lo aplica. Esa máquina es el punto de
partida de este capítulo.
Chasqui crece. Tiene agencias en Lima, Arequipa, Cusco e Iquitos, millones de eventos de seguimiento y empleados que no pueden quedarse sin sistema si se cae un servidor. Repartir la base de datos en varias máquinas sirve para tres cosas distintas, y conviene no mezclarlas:
- Capacidad. Los datos o la carga no caben en una máquina: se reparten las filas (particionamiento) para que cada servidor guarde y procese una parte.
- Disponibilidad. Si una máquina cae, otra sigue atendiendo: se guardan copias de los mismos datos en varios servidores (replicación).
- Latencia. Los datos de Iquitos, cerca de Iquitos: una consulta que cruza el país tarda decenas de milisegundos solo en ir y volver.
Cada una tiene un precio. Particionar obliga a coordinar las transacciones que tocan varias particiones; replicar obliga a decidir qué pasa cuando las copias no coinciden. El capítulo recorre las dos cosas con la misma pregunta de siempre: ¿qué garantías siguen en pie? En la primera parte veremos las arquitecturas de servidores de bases de datos, el particionamiento (y cómo lo hace PostgreSQL dentro de un servidor), la replicación, las transacciones distribuidas con two-phase commit (2PC), una mirada breve a consensus y el teorema CAP. En la segunda, los sistemas NoSQL y MapReduce, que nacieron justamente de renunciar a algunas de esas garantías, y el cierre del curso.
Todo lo que se puede correr, se corre. El particionamiento se prueba en
chasqui_w16; la replicación y 2PC necesitan algo que el servidor del curso
no tiene configurado (max_prepared_transactions está en 0, y no vamos a
reiniciarlo), así que el código de la semana levanta su propio cluster
desechable de PostgreSQL dentro del contenedor, con un primario y una
réplica, y lo borra al terminar.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “De una máquina a muchas” y “Definiciones”, de “Particionamiento”. Sesión B: “Por qué aparecieron”, de “NoSQL”, y “El recorrido”, de “Cierre del curso”.
- En clase. Sesión A: “Arquitecturas de servidores de bases de datos”, “Particionamiento”, “Replicación”, “Transacciones distribuidas”, “Consensus, en breve” y “CAP y modelos de consistencia”. Sesión B: “NoSQL”, “MapReduce” y “Cierre del curso”.
- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 20.1–20.5, 21.2–21.4, 23.1–23.2 y, en breve, 23.8; para NoSQL y MapReduce, 10.2–10.3. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-16, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
Arquitecturas de servidores de bases de datos
De una máquina a muchas
Silberschatz (cap. 20) ordena las arquitecturas por cuánto comparten las máquinas entre sí.
- Centralizada. Un DBMS corre en una sola computadora, con uno o varios núcleos que comparten memoria y disco. Es lo que usamos todo el semestre, aunque el servidor tenga muchos procesos: PostgreSQL lanza un proceso por conexión, pero todos comparten el buffer pool (en memoria compartida) y el mismo WAL.
- Cliente-servidor. La aplicación (el cliente, como los programas de Node.js de la semana 5) manda consultas por la red al servidor, que hace todo el trabajo de la base de datos. Sigue siendo un solo servidor.
- Sistema paralelo. Muchas máquinas o procesadores conectados por una red rápida, dentro de un mismo centro de datos, que trabajan juntos en las mismas consultas. El objetivo es rendimiento.
- Sistema distribuido. Varios sitios (sites), posiblemente en ciudades distintas, cada uno con su propio DBMS, conectados por una red más lenta y menos confiable. El objetivo suele ser disponibilidad, latencia o autonomía de cada sitio.
La frontera entre paralelo y distribuido no es la tecnología sino la red: dentro de un centro de datos, un mensaje tarda microsegundos y casi nunca se pierde; entre Lima e Iquitos tarda decenas de milisegundos y un corte de fibra deja a una ciudad aislada.
Cómo se mide un sistema paralelo
Dos medidas (sec. 20.4):
- Speedup. El mismo problema, en un sistema N veces más grande. Si T_S es el tiempo en el sistema chico y T_L en el grande, el speedup es T_S / T_L. Es lineal si vale N: con el doble de máquinas, la misma consulta tarda la mitad.
- Scaleup. Un problema N veces más grande en un sistema N veces más grande. El scaleup es T_S / T_L y es lineal si vale 1: con el doble de envíos y el doble de máquinas, la consulta tarda lo mismo.
Casi nunca se llega a lo lineal. Hay un costo de arranque (iniciar procesos en muchas máquinas), hay interferencia (todos compiten por algún recurso compartido) y hay skew: si una máquina recibe más trabajo que las demás, todas esperan a la más lenta. El skew vuelve más abajo, con números.
Qué se comparte
Las arquitecturas paralelas se distinguen por qué comparten los procesadores:
| Arquitectura | Qué comparten | Lo bueno | Lo malo |
|---|---|---|---|
| Memoria compartida (shared memory) | Memoria y discos | Comunicación barata: escribir en memoria | El bus de memoria y las cachés no escalan más allá de unas decenas de núcleos |
| Disco compartido (shared disk) | Solo los discos (una red de almacenamiento) | Si un nodo cae, otro ve los mismos datos | El acceso al almacenamiento se vuelve el cuello de botella; hay que coordinar las cachés de los nodos |
| Sin nada compartido (shared nothing) | Nada: cada nodo tiene su CPU, memoria y discos | Escala a miles de nodos | Mandar datos de un nodo a otro es caro; cada consulta que cruza nodos paga red |
Un servidor de PostgreSQL es, por dentro, de memoria compartida. Los sistemas que reparten tablas en cientos de máquinas son shared nothing: cada nodo es un servidor completo con su parte de los datos. Silberschatz menciona también la arquitectura jerárquica, que combina las otras (nodos shared memory conectados entre sí sin compartir nada), que es en la práctica lo que hay en un centro de datos moderno.
Idea clave. En shared nothing, lo caro es mover datos por la red. Casi todo el diseño de un sistema distribuido (cómo se particiona, dónde se hace el join, cuándo se replica) busca que cada consulta se resuelva con los datos que ya están en un nodo.
Bases de datos distribuidas: homogéneas y heterogéneas
En un sistema distribuido (sec. 20.5), cada sitio tiene su propio DBMS y atiende transacciones locales (solo tocan datos de ese sitio) y participa en transacciones globales (tocan datos de varios sitios). Se distinguen dos situaciones:
- Homogénea. Todos los sitios corren el mismo software, conocen a los
demás y cooperan: comparten un esquema global y aceptan un protocolo común
para las transacciones globales. Es el caso de un sistema que reparte
shipmenten cuatro servidores de PostgreSQL. - Heterogénea. Los sitios pueden tener esquemas distintos y software distinto, y no fueron diseñados para trabajar juntos. Pasa cuando Chasqui compra otra empresa de encomiendas que tiene su propia base de datos, con otro motor y otros nombres de columnas. Se puede construir una capa que traduzca las consultas, pero las transacciones globales son mucho más difíciles, porque no todos los sitios entienden el mismo protocolo de commit.
Un sitio que guarda datos que se consultan desde lejos puede querer autonomía: seguir funcionando aunque los demás no respondan, y decidir qué datos comparte. La autonomía choca con las garantías globales; esa tensión es el tema de todo el capítulo.
Particionamiento
Definiciones
Particionar una relación r es repartir sus tuplas en n fragmentos r₁, …, rₙ disjuntos cuya unión es r. Cada fragmento se guarda en un nodo distinto (o, dentro de un solo servidor, en un archivo distinto). Es lo que Silberschatz llama particionamiento horizontal: se reparten filas, no columnas. Hay tres maneras clásicas de decidir a qué partición va cada tupla (sec. 21.2):
- Round-robin. La i-ésima tupla que llega va a la partición i mod n. Reparte parejo, sin importar los valores.
- Hash. Se elige un atributo de particionamiento (o varios) y una función hash h con valores en 0, …, n − 1. La tupla t va a la partición h(t[A]).
- Rango. Se elige un atributo A y un vector de particionamiento [v₀, v₁, …, vₙ₋₂], ordenado. Una tupla con t[A] < v₀ va a la partición 0; con vᵢ ≤ t[A] < vᵢ₊₁, a la partición i + 1; con t[A] ≥ vₙ₋₂, a la última.
PostgreSQL agrega un cuarto esquema, lista: cada partición declara explícitamente qué valores del atributo le tocan (por ejemplo, qué agencias de origen). Es útil cuando el atributo tiene pocos valores y el reparto natural no es un rango, como las zonas del país.
Para que una consulta que no conoce los fragmentos siga funcionando, el sistema tiene que poder reconstruir r = r₁ ∪ ⋯ ∪ rₙ: los fragmentos son disjuntos, así que la unión no pierde ni duplica nada. Lo que cambia es el costo de cada consulta.
Qué consulta atiende cada esquema
Pensemos en shipment repartida en cuatro servidores y en tres tipos de
acceso:
| Acceso | Round-robin | Hash de shipment_id |
Rango de created_at |
|---|---|---|---|
| Leer toda la tabla | Los cuatro, en paralelo, con la misma carga: lo mejor | Los cuatro, en paralelo, con carga pareja | Los cuatro; la carga depende de cuántos envíos hay por rango |
Punto: shipment_id = 501 |
Los cuatro (no se sabe dónde está) | Uno: h(501) | Los cuatro (el atributo no es el de particionamiento) |
Punto: created_at = ... |
Los cuatro | Los cuatro | Uno |
| Rango: los envíos de marzo | Los cuatro | Los cuatro: el hash desordena los valores | Uno (o pocos) |
La regla es simple: una consulta va a un solo nodo si su condición fija el valor (o el rango, en el caso de rango) del atributo de particionamiento. Todas las demás van a todos los nodos. Que vayan a todos no es malo por sí mismo (para leer toda la tabla es lo mejor, porque los cuatro trabajan en paralelo), pero una consulta que devuelve una sola fila y ocupa a los cuatro servidores desperdicia tres. Si el sistema atiende miles de consultas pequeñas por segundo, ese desperdicio es todo el costo.
Particionar para los joins
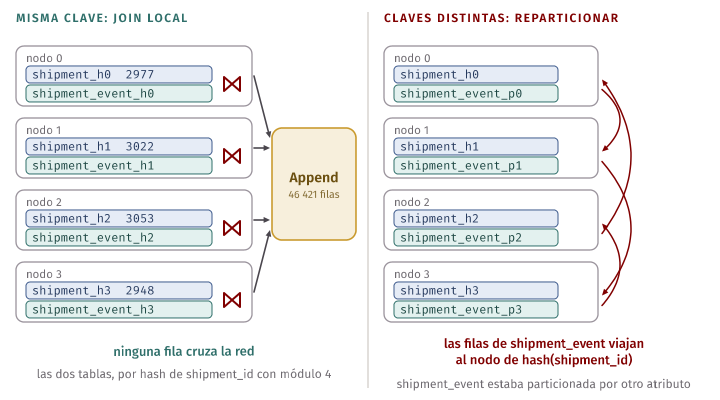
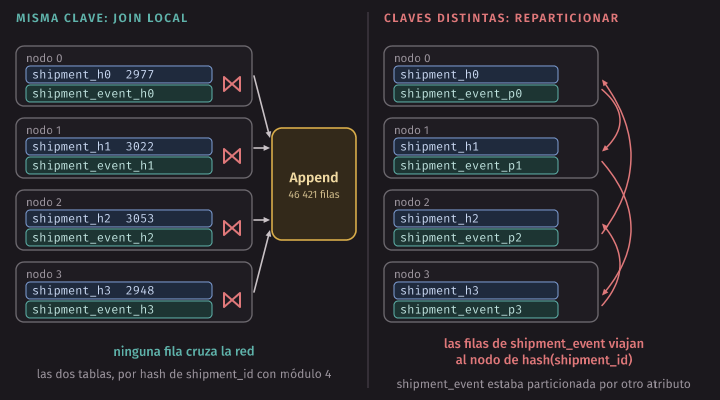
El join es donde más se nota el particionamiento. Si shipment está
particionada por hash de shipment_id y shipment_event también, con la
misma función y el mismo número de particiones, entonces los eventos del
envío 501 están en el mismo nodo que el envío 501. El join
shipment ⋈ shipment_event sobre shipment_id se resuelve en cada nodo con
sus propios datos, y el resultado es la unión de los cuatro joins locales.
Ninguna fila cruza la red.
Si las dos relaciones están particionadas por atributos distintos, hay que
reparticionar una (o las dos) antes del join: cada nodo manda cada tupla
al nodo que le corresponde según el hash del atributo de join. Es el
equivalente distribuido de la fase de particionamiento del hash join de la
semana 11, solo que las particiones viajan por la red en vez de ir al disco.
Una tercera opción, buena cuando una relación es chica (como agency, con 29
filas), es replicarla en todos los nodos: así el join con ella siempre es
local.
Idea clave. Particionar dos tablas por la misma clave (co-partitioning) hace locales los joins sobre esa clave. Por eso el atributo de particionamiento se elige mirando las consultas más frecuentes, no la estructura de la tabla.
Skew
Particionar sirve si cada partición recibe más o menos el mismo trabajo. Si una recibe mucho más, el sistema entero va a la velocidad de esa partición. Silberschatz (sec. 21.3) distingue dos formas de desbalance:
- Data skew (sesgo en la distribución de los datos): una partición
guarda muchas más tuplas que las demás. Puede venir de que muchas tuplas
tienen el mismo valor del atributo (attribute-value skew: todos los envíos
que salen de Lima van a la partición de Lima) o de un vector de rangos mal
elegido (partition skew: si los rangos de
created_atson de tres meses, pero casi todos los envíos son de los últimos dos). - Execution skew (sesgo de ejecución): los datos están parejos, pero el trabajo no. Con particiones por mes, las consultas y las inserciones de hoy van todas a la partición del mes actual. Las otras cinco descansan.
Los remedios:
- Vectores de rango balanceados. Elegir los límites mirando la
distribución real: ordenar la relación (o una muestra) y cortar cada N/n
tuplas, o usar un histograma equi-depth como los de
pg_stats(semana 12). Así cada rango tiene más o menos el mismo número de tuplas. - Nodos virtuales (virtual nodes). En vez de 4 particiones para 4 servidores, se crean muchas más (por ejemplo, 64), pequeñas, y se reparten entre los servidores con una tabla que dice qué partición virtual está en qué servidor. Si un servidor queda sobrecargado, se le quitan particiones virtuales y se pasan a otro, sin reparticionar todo.
- Reparticionamiento dinámico. Partir una partición que creció demasiado (como hace un B+ tree con un nodo lleno) y mover una mitad a otro servidor.
- Consistent hashing. Con h(k) mod n, agregar un servidor cambia n y casi todas las claves cambian de lugar. Consistent hashing pone servidores y claves en un mismo círculo de valores de hash; cada clave pertenece al primer servidor que encuentra avanzando por el círculo. Si se agrega un servidor, solo se mueven las claves del tramo que le toca, más o menos 1/n del total.
Particionamiento declarativo en PostgreSQL
PostgreSQL particiona una tabla dentro de un mismo servidor: la tabla
particionada no guarda filas, solo dice cómo repartirlas; cada partición es
una tabla común, con su archivo, sus índices y sus estadísticas. Sirve para
tablas grandes en las que casi todas las consultas filtran por el atributo
de particionamiento, y para borrar datos viejos de golpe: quitar los envíos
de enero es DROP TABLE (o ALTER TABLE ... DETACH PARTITION) de una
partición, no un DELETE de millones de filas que deja tuplas muertas para
VACUUM.
Repartir las particiones en servidores distintos se llama sharding, y
PostgreSQL no lo hace solo; lo hacen extensiones y sistemas construidos
encima. Pero las ideas de la sección anterior (qué consulta va a qué
partición, co-partitioning para los joins, skew) se ven igual dentro de un
servidor, y se pueden medir con EXPLAIN.
El archivo partitions.sql crea tres
copias particionadas de shipment en chasqui_w16. La primera, por rango
de created_at, con una partición por mes:
CREATE TABLE shipment_by_month (
  LIKE shipment INCLUDING DEFAULTS INCLUDING CONSTRAINTS,
  PRIMARY KEY (shipment_id, created_at)
) PARTITION BY RANGE (created_at);

CREATE TABLE shipment_2026_01 PARTITION OF shipment_by_month
  FOR VALUES FROM ('2026-01-01') TO ('2026-02-01');
-- ... una por mes, hasta junio ...
CREATE TABLE shipment_month_default PARTITION OF shipment_by_month DEFAULT;

INSERT INTO shipment_by_month SELECT * FROM shipment;
Tres detalles. Primero, el rango FROM ... TO ... incluye el límite inferior
y excluye el superior, igual que el vector de particionamiento del libro: el
1 de febrero a medianoche va a la partición de febrero. Segundo, la clave
primaria es (shipment_id, created_at) y no solo shipment_id. PostgreSQL
no tiene índices globales: cada partición tiene su propio índice, y solo
puede garantizar unicidad si los valores repetidos caerían necesariamente en
la misma partición. Si se intenta con shipment_id sola:
ERROR:  unique constraint on partitioned table must include all partitioning columns
DETAIL:  PRIMARY KEY constraint on table "t_bad" lacks column "created_at" which is part of the partition key.
Tercero, la partición DEFAULT recibe las filas que no caen en ningún
rango. Sin ella, un envío de julio no se podría insertar hasta crear su
partición.
El INSERT de abajo lee de shipment y deja cada fila en su mes. La columna
de sistema tableoid dice en qué tabla física está cada fila
(pruning.sql, consulta by_month):
SELECT tableoid::regclass AS partition, count(*) AS n
FROM shipment_by_month
GROUP BY tableoid
ORDER BY tableoid::regclass::text;
partition | n
------------------+------
shipment_2026_01 | 1813
shipment_2026_02 | 1938
shipment_2026_03 | 2149
shipment_2026_04 | 2054
shipment_2026_05 | 2157
shipment_2026_06 | 1889
(6 rows)La partición DEFAULT no aparece porque está vacía: todos los envíos de los
datos de ejemplo son de enero a junio de 2026. Los límites, como los guarda
el catálogo (consulta bounds), ya muestran la zona horaria de la base
(America/Lima, −05):
       partition        |                                  bound
------------------------+--------------------------------------------------------------------------
 shipment_2026_01       | FOR VALUES FROM ('2026-01-01 00:00:00-05') TO ('2026-02-01 00:00:00-05')
 shipment_2026_02       | FOR VALUES FROM ('2026-02-01 00:00:00-05') TO ('2026-03-01 00:00:00-05')
 ...
 shipment_2026_06       | FOR VALUES FROM ('2026-06-01 00:00:00-05') TO ('2026-07-01 00:00:00-05')
 shipment_month_default | DEFAULT
(7 rows)
Partition pruning
El planificador sabe qué valores hay en cada partición, así que puede
descartar las que no pueden tener filas que cumplan el WHERE. Eso se llama
partition pruning. Los envíos de marzo (consulta prune_march):
EXPLAIN (COSTS OFF)
SELECT count(*)
FROM shipment_by_month
WHERE created_at >= '2026-03-01' AND created_at < '2026-04-01';
QUERY PLAN
----------------------------------------------------------------------------
Aggregate
-> Seq Scan on shipment_2026_03 shipment_by_month
Filter: ((created_at >= '2026-03-01 00:00:00-05'::timestamp with time zone) AND (created_at < '2026-04-01 00:00:00-05'::timestamp with time zone))
(3 rows)Una sola partición: 2149 filas en vez de 12 000. El Filter sigue ahí
porque el planificador no aprovecha que todas las filas de esa partición
cumplen la condición; la evalúa igual. Si la condición no menciona
created_at (consulta no_prune, WHERE sender_id = 777), no hay nada que
descartar:
                             QUERY PLAN
--------------------------------------------------------------------
 Aggregate
   ->  Append
         ->  Seq Scan on shipment_2026_01 shipment_by_month_1
               Filter: (sender_id = 777)
         ->  Seq Scan on shipment_2026_02 shipment_by_month_2
               Filter: (sender_id = 777)
         ...
         ->  Seq Scan on shipment_month_default shipment_by_month_7
               Filter: (sender_id = 777)
(16 rows)
El nodo Append es la unión r₁ ∪ ⋯ ∪ r₇: lee cada partición, una
después de otra, y entrega sus filas. Es exactamente la tabla de la sección
anterior, en un plan: la condición sobre el atributo de particionamiento va
a una partición; cualquier otra, a todas.
La segunda copia, shipment_by_hash, está particionada por hash de
shipment_id en cuatro particiones (FOR VALUES WITH (MODULUS 4, REMAINDER 0), y así hasta el resto 3). El reparto es parejo (consulta by_hash):
  partition  |  n
-------------+------
 shipment_h0 | 2977
 shipment_h1 | 3022
 shipment_h2 | 3053
 shipment_h3 | 2948
(4 rows)
Con hash, la igualdad poda y el rango no (consultas hash_eq y
hash_range):
                            QUERY PLAN
-------------------------------------------------------------------
 Index Scan using shipment_h0_pkey on shipment_h0 shipment_by_hash
   Index Cond: (shipment_id = 501)
(2 rows)
QUERY PLAN
--------------------------------------------------------------------------------------
Aggregate
-> Append
-> Index Only Scan using shipment_h0_pkey on shipment_h0 shipment_by_hash_1
Index Cond: ((shipment_id >= 500) AND (shipment_id <= 510))
-> Index Only Scan using shipment_h1_pkey on shipment_h1 shipment_by_hash_2
Index Cond: ((shipment_id >= 500) AND (shipment_id <= 510))
-> Index Only Scan using shipment_h2_pkey on shipment_h2 shipment_by_hash_3
Index Cond: ((shipment_id >= 500) AND (shipment_id <= 510))
-> Index Only Scan using shipment_h3_pkey on shipment_h3 shipment_by_hash_4
Index Cond: ((shipment_id >= 500) AND (shipment_id <= 510))
(10 rows)Los once envíos entre 500 y 510 están repartidos en las cuatro particiones, porque el hash desordena los valores a propósito. Cada partición tiene su propio índice de la clave primaria; dentro de cada una, el índice sí sirve para el rango.
Pruning en la ejecución
A veces el valor no se conoce al planificar. Con un parámetro ($1) y un
plan genérico, el planificador no puede saber qué meses hacen falta; pero el
ejecutor sí lo sabe al empezar, y descarta las particiones en ese momento
(consulta prune_runtime):
SET plan_cache_mode = force_generic_plan;
PREPARE since_day(timestamptz) AS
  SELECT count(*) FROM shipment_by_month WHERE created_at >= $1;
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
EXECUTE since_day('2026-06-15');
QUERY PLAN
-----------------------------------------------------------------------------------------------
Aggregate (actual rows=1.00 loops=1)
Buffers: shared hit=24
-> Append (actual rows=854.00 loops=1)
Buffers: shared hit=24
Subplans Removed: 5
-> Seq Scan on shipment_2026_06 shipment_by_month_1 (actual rows=854.00 loops=1)
Filter: (created_at >= $1)
Rows Removed by Filter: 1035
Buffers: shared hit=24
-> Seq Scan on shipment_month_default shipment_by_month_2 (actual rows=0.00 loops=1)
Filter: (created_at >= $1)
Planning:
Buffers: shared hit=35
(13 rows)Subplans Removed: 5 son los cinco meses anteriores a junio, quitados al
iniciar la ejecución. Quedan junio (854 de sus 1889 filas son del 15 en
adelante, lo mismo que da SELECT count(*) FROM shipment WHERE created_at >= '2026-06-15') y la partición DEFAULT, que podría tener fechas posteriores.
plan_cache_mode = force_generic_plan obliga a usar el plan genérico; sin
eso, PostgreSQL planifica las primeras cinco ejecuciones con el valor real
y poda en la planificación.
En PostgreSQL. El pruning se apaga con
SET enable_partition_pruning = off, útil para comparar planes. Sin pruning, una tabla con cientos de particiones paga la planificación de cientos de scans aunque solo use uno; y aun con pruning, muchas particiones cuestan memoria y tiempo de planificación. La documentación advierte que no conviene crear miles de particiones pequeñas sin necesidad.
El join partición contra partición
La tercera idea de la sección de definiciones, co-partitioning, también se
ve en un plan. shipment_event_by_hash está particionada por hash de
shipment_id con el mismo módulo 4. Con enable_partitionwise_join (viene
apagado, porque planificar join por join cuesta más), el planificador hace
el join partición contra partición (consulta partitionwise):
SET enable_partitionwise_join = on;
EXPLAIN (COSTS OFF)
SELECT s.status, count(*)
FROM shipment_by_hash s
  JOIN shipment_event_by_hash e ON e.shipment_id = s.shipment_id
GROUP BY s.status;
QUERY PLAN
--------------------------------------------------------------
HashAggregate
Group Key: s.status
-> Append
-> Hash Join
Hash Cond: (e_1.shipment_id = s_1.shipment_id)
-> Seq Scan on shipment_event_h0 e_1
-> Hash
-> Seq Scan on shipment_h0 s_1
-> Hash Join
Hash Cond: (e_2.shipment_id = s_2.shipment_id)
-> Seq Scan on shipment_event_h1 e_2
-> Hash
-> Seq Scan on shipment_h1 s_2
...
(23 rows)Cuatro hash joins pequeños, cada uno con una partición de shipment como
build y la partición correspondiente de shipment_event como probe, y un
Append que junta los resultados. Si cada partición estuviera en otro
servidor, cada servidor haría su join sin mandar nada a los demás. El
resultado es el mismo que el del join normal: 46 421 filas, una por evento.
Las zonas: skew en los datos y en la ejecución
La tercera copia, shipment_by_zone, está particionada por lista de
agencias de origen, en cuatro zonas que harían de cuatro servidores:
CREATE TABLE shipment_lima PARTITION OF shipment_by_zone
  FOR VALUES IN (1, 2, 3);
CREATE TABLE shipment_norte PARTITION OF shipment_by_zone
  FOR VALUES IN (7, 8, 9, 10, 11, 12, 22);
CREATE TABLE shipment_sur PARTITION OF shipment_by_zone
  FOR VALUES IN (4, 5, 6, 13, 17, 18, 19, 20, 21, 28);
CREATE TABLE shipment_centro_oriente PARTITION OF shipment_by_zone
  FOR VALUES IN (14, 15, 16, 23, 24, 25, 26, 27, 29);
La consulta by_zone cuenta las filas y el porcentaje de cada una:
        partition        |  n   | pct
-------------------------+------+------
 shipment_lima           | 3965 | 33.0
 shipment_sur            | 3147 | 26.2
 shipment_norte          | 2685 | 22.4
 shipment_centro_oriente | 2203 | 18.4
(4 rows)
Lima tiene 3 de las 29 agencias y un tercio de los envíos: attribute-value
skew. El servidor de Lima tendría casi el doble de trabajo que el de
centro-oriente, y una consulta que lee todo esperaría a Lima. Con un hash de
shipment_id el reparto sería parejo (las cifras de arriba), pero se
perdería lo que hacía atractiva la lista: que los envíos de una zona estén
en su servidor.
El execution skew se ve insertando envíos nuevos en la tabla por meses. La
consulta insert_skew inserta 50 envíos nuevos, con fechas de fines de
junio (lo más reciente de los datos), dentro de una transacción, cuenta en qué partición quedaron y
hace ROLLBACK:
    partition     | n
------------------+----
 shipment_2026_06 | 50
(1 row)
Todos en junio. Con particiones por mes en servidores distintos, el servidor de junio recibiría todas las escrituras del día, y el de enero ninguna. Particionar por fecha es excelente para consultar y borrar por fecha, y malo para repartir la carga de escritura.
Una fila que no cae en ninguna lista falla, porque shipment_by_zone no
tiene partición DEFAULT (consulta no_partition, con una agencia 30 que no
existe):
ERROR:  no partition of relation "shipment_by_zone" found for row
DETAIL:  Partition key of the failing row contains (origin_agency_id) = (30).
El código del error es 23514, el mismo de una restricción CHECK: en el
fondo, cada partición tiene una restricción implícita sobre sus valores.
Error común. Particionar una tabla esperando que todas las consultas se aceleren. Solo se aceleran las que filtran por el atributo de particionamiento; las demás leen todas las particiones y pagan además la planificación de cada una. Una tabla de 12 000 filas no gana nada; el particionamiento empieza a valer la pena con tablas que no caben en memoria o que se borran por períodos.
Replicación
Copias de los mismos datos
Replicar es guardar copias de cada partición en varios nodos (sec. 21.4). Con n copias, la partición sobrevive a la caída de n − 1 nodos, y las lecturas se pueden repartir entre las copias. El precio aparece en las escrituras: cada cambio tiene que llegar a todas las copias, y mientras no llega, las copias no coinciden.
La forma más común es primary-backup (también se dice primary-replica): una copia es la principal y recibe todas las escrituras; las demás son réplicas que aplican los cambios en el mismo orden. Las lecturas pueden ir a la principal o a las réplicas. Si la principal cae, una réplica se promueve a principal (failover). La alternativa, que varias copias acepten escrituras (multi-primary), evita depender de una sola máquina pero obliga a resolver conflictos cuando dos copias aceptan cambios contradictorios sobre la misma fila.
¿Cómo llegan los cambios a las réplicas? La manera natural, después de la semana 15, es mandar el log. La principal ya escribe cada cambio en su WAL antes de aplicarlo; la réplica recibe ese mismo WAL y lo aplica con el mismo código que usa la recuperación después de una caída. Una réplica es, literalmente, un servidor en recuperación permanente.
Síncrona o asíncrona
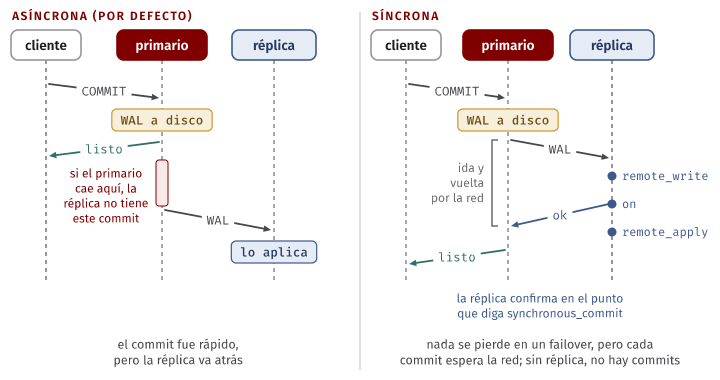
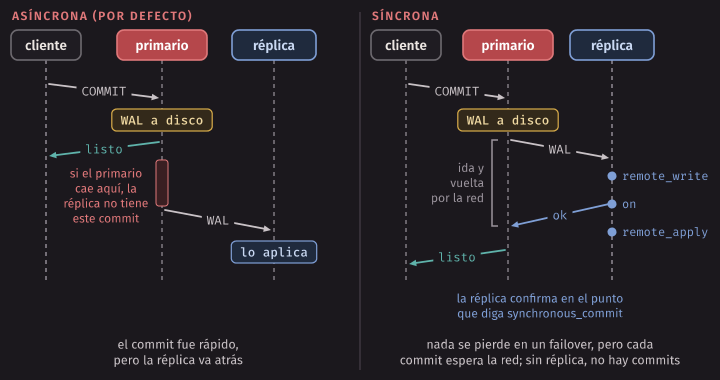
La pregunta clave es cuándo responde el commit:
- Síncrona. El commit espera a que la réplica confirme que recibió (o escribió, o aplicó) el registro de commit. Si la principal cae justo después, la réplica tiene todo lo confirmado: no se pierde nada al hacer failover. Cada commit paga un viaje de ida y vuelta por la red; si la réplica está en otra ciudad, son decenas de milisegundos por commit. Como PostgreSQL deja de confirmar commits si la réplica no responde (lo vemos más abajo), es el two-very-safe de la semana 15; el two-safe seguiría sin ella, como one-safe.
- Asíncrona. El commit responde apenas el WAL está en el disco de la principal; la réplica lo recibe un poco después (milisegundos, si todo va bien). Los commits son rápidos, pero si la principal cae, los últimos commits que no llegaron a la réplica se pierden al hacer failover. Es el one-safe. Además, una lectura en la réplica puede ver datos viejos: el empleado que registra un envío en la principal y lo busca enseguida en una réplica puede no encontrarlo.
No hay una opción correcta: es un intercambio entre durabilidad y latencia. Muchos sistemas usan una réplica síncrona cercana (en el mismo centro de datos) y otras asíncronas lejanas.
Error común. Tomar una réplica como un backup. Una réplica copia todo, también los errores: un
DELETE FROM shipmentsinWHEREllega a la réplica en milisegundos. Para deshacer un error humano hacen falta un backup y el point-in-time recovery de la semana 15, que permiten volver al instante anterior alDELETE.
Streaming replication en PostgreSQL
PostgreSQL implementa primary-backup mandando el WAL por una conexión (streaming replication). La réplica es un hot standby: aplica el WAL y, al mismo tiempo, acepta consultas de solo lectura. Por defecto es asíncrona.
El código de la semana lo arma así (es lo que hace make cluster, dentro
del contenedor): crea un cluster con initdb y lo arranca en el puerto
5416; copia ese cluster con pg_basebackup -R, que hace un backup físico y
deja configurada la conexión con el primario; y arranca la copia en el
puerto 5417 con cluster_name=replica1. Desde el primario, la vista
pg_stat_replication muestra a la réplica:
$ psql -h /tmp -p 5416 -U postgres \
    -c "SELECT application_name, client_addr, state, sync_state, sent_lsn, replay_lsn FROM pg_stat_replication"
 application_name | client_addr |   state   | sync_state | sent_lsn  | replay_lsn
------------------+-------------+-----------+------------+-----------+------------
 replica1         |             | streaming | async      | 0/4000000 | 0/4000000
(1 row)
client_addr está vacío porque la réplica se conecta por el socket de
/tmp, no por la red. sent_lsn es hasta dónde el primario le mandó el
WAL y replay_lsn hasta dónde la réplica lo aplicó: los LSN de la semana
15, ahora usados para medir cuánto va atrás una réplica. En la réplica:
$ psql -h /tmp -p 5417 -U postgres -c "SELECT pg_is_in_recovery(), pg_last_wal_replay_lsn()" -c "CREATE TABLE x (a integer)"
 pg_is_in_recovery | pg_last_wal_replay_lsn
-------------------+------------------------
 t                 | 0/4000000
(1 row)

ERROR:  cannot execute CREATE TABLE in a read-only transaction
Está en recovery y rechaza las escrituras con el error 25006. Se puede
leer en ella cualquier base del cluster: psql -h /tmp -p 5417 -U postgres -d oriente -c "SELECT * FROM trip" muestra el viaje 7001 (Cusco - Iquitos,
940 kg reservados de 1000) que twopc-setup.sql insertó en el primario,
sin que nadie se lo mandara aparte a la réplica.
Para hacerla síncrona, el primario tiene que nombrarla en
synchronous_standby_names:
$ psql -h /tmp -p 5416 -U postgres -c "ALTER SYSTEM SET synchronous_standby_names = 'replica1'" -c "SELECT pg_reload_conf()"
$ psql -h /tmp -p 5416 -U postgres -c "SELECT application_name, state, sync_state FROM pg_stat_replication"
 application_name |   state   | sync_state
------------------+-----------+------------
 replica1         | streaming | sync
(1 row)
Ahora detengamos la réplica (pg_ctl -D /tmp/w16-replica -m fast stop) e
insertemos una fila en el primario. El INSERT no termina: queda esperando
la confirmación de una réplica que no está. Desde otra sesión:
 pid  | wait_event_type | wait_event | state  |                       query
------+-----------------+------------+--------+----------------------------------------------------
 7840 | IPC             | SyncRep    | active | INSERT INTO replica_demo VALUES (1, 'sin réplica')
(1 row)
Y la fila no se ve todavía: un SELECT * FROM replica_demo desde esa otra
sesión devuelve (0 rows). Si se cancela la espera con
pg_cancel_backend(7840), la sesión que hacía el INSERT recibe esto:
WARNING:  canceling wait for synchronous replication due to user request
DETAIL:  The transaction has already committed locally, but might not have been replicated to the standby.
INSERT 0 1
Es un WARNING, no un ERROR: el registro de commit ya estaba en el WAL
del primario, así que la transacción hizo commit y la fila aparece en
replica_demo. Lo que no se cumplió es la promesa de la replicación
síncrona: si el primario cayera ahora, esa fila no estaría en la réplica.
Este ejemplo muestra el costo de la versión síncrona: sin réplica, el
primario deja de aceptar commits. Por eso se suele configurar con dos o más
réplicas candidatas (synchronous_standby_names = 'ANY 1 (r1, r2)'), para
que la caída de una no detenga todo.
En PostgreSQL.
synchronous_commitdecide hasta dónde espera el commit cuando hay réplicas síncronas:remote_write(la réplica recibió y escribió el WAL, sinfsync),on(lo escribió en su disco, el valor por defecto) oremote_apply(además lo aplicó, y una lectura en la réplica ya ve el cambio). Conlocalsolo espera a su propio disco, y conoffni a eso. Un detalle que encontramos al armar la demostración: la réplica no arranca si sumax_prepared_transactionses menor que el del primario (FATAL: recovery aborted because of insufficient parameter settings), porque tiene que poder reproducir las transacciones preparadas que vienen en el WAL.
La consistencia de las réplicas
Con replicación asíncrona y lecturas en las réplicas, dos lecturas seguidas del mismo usuario pueden ir a réplicas distintas y ver primero un dato nuevo y después uno viejo. Los sistemas ofrecen garantías intermedias, más débiles que “todas las copias son una sola”:
- Read your writes: un usuario siempre ve sus propias escrituras (por ejemplo, mandando sus lecturas a la principal durante unos segundos después de escribir).
- Monotonic reads: un usuario nunca ve un dato más viejo que uno que ya vio (por ejemplo, leyendo siempre de la misma réplica).
- Eventual consistency: si dejan de llegar escrituras, todas las copias terminan iguales. No dice cuándo.
Volveremos a esto con CAP y con los key-value stores.
Transacciones distribuidas
El problema
Supongamos que Chasqui particionó sus datos por región. El servidor del sur guarda los envíos que se registran en Cusco; el del oriente guarda los viajes que salen hacia Iquitos y cuánta carga llevan. Registrar un envío de Cusco a Iquitos es una transacción que inserta el envío en el sur y descuenta capacidad del viaje en el oriente. Las dos partes hacen commit o ninguna: un envío registrado en un viaje que no le reservó espacio, o un espacio reservado para un envío que no existe, son exactamente los estados inconsistentes que la atomicidad prohíbe.
Cada servidor tiene su propio log, su propio lock manager y su propia recuperación. Cada uno sabe hacer commit de su parte de forma atómica y durable (semana 15). Lo que falta es un protocolo que los ponga de acuerdo.
Silberschatz (sec. 23.1) describe la estructura así: en cada sitio hay un transaction manager, que administra el log y la concurrencia de las transacciones que tocan datos de ese sitio, y un transaction coordinator, que inicia las transacciones que nacen en ese sitio, las reparte en subtransacciones para los sitios que corresponda y coordina su terminación. El coordinador de una transacción global T es el del sitio donde empezó; los demás sitios que tocan datos de T son sus participantes.
Un sistema distribuido puede fallar de maneras que un servidor solo no conoce:
- la caída de un sitio;
- la pérdida de un mensaje (la red lo descarta o llega dañado);
- la caída de un enlace de comunicación;
- la partición de la red: los sitios quedan divididos en grupos que se comunican adentro, pero no entre sí.
Desde un sitio, todas se ven igual: alguien no responde. No se puede distinguir un sitio caído de uno lento o de uno al otro lado de una partición. Los protocolos se diseñan con timeouts y con un supuesto: los sitios que caen se detienen (no mandan mensajes falsos) y vuelven con su almacenamiento estable intacto.
Two-phase commit
El protocolo de commit más usado es two-phase commit (2PC, sec. 23.2). Sea T una transacción iniciada en el sitio Sᵢ, con coordinador Cᵢ. Cuando T terminó su trabajo en todos los sitios, Cᵢ empieza el protocolo.
Fase 1 (votación).
- Cᵢ agrega
<prepare T>a su log, lo fuerza a almacenamiento estable y manda el mensajeprepare Ta todos los participantes. - Cada participante decide si puede hacer commit de su parte. Si no puede
(violó una restricción, se quedó sin espacio, eligió a T como víctima de
un deadlock), agrega
<no T>a su log y respondeabort T. Si puede, agrega<ready T>a su log, fuerza el log con todos los registros de T y respondeready T.
Fase 2 (decisión).
- Si Cᵢ recibió
ready Tde todos, T hace commit: Cᵢ agrega<commit T>a su log y lo fuerza. Si recibió algúnabort T, o si algún participante no respondió antes del timeout, T aborta: agrega<abort T>. El instante en que el registro de la decisión llega al almacenamiento estable del coordinador es el instante de la decisión; después de eso, ya no hay vuelta atrás. - Cᵢ manda la decisión (
commit Toabort T) a todos los participantes. Cada uno la anota en su log, hace commit o abort de su parte, libera sus locks y responde con un acknowledgment. - Cuando Cᵢ recibió todos los acknowledgments, agrega
<end T>a su log y puede olvidarse de T.
En el tiempo, para el envío de Cusco a Iquitos, con el coordinador en el sur y dos participantes:
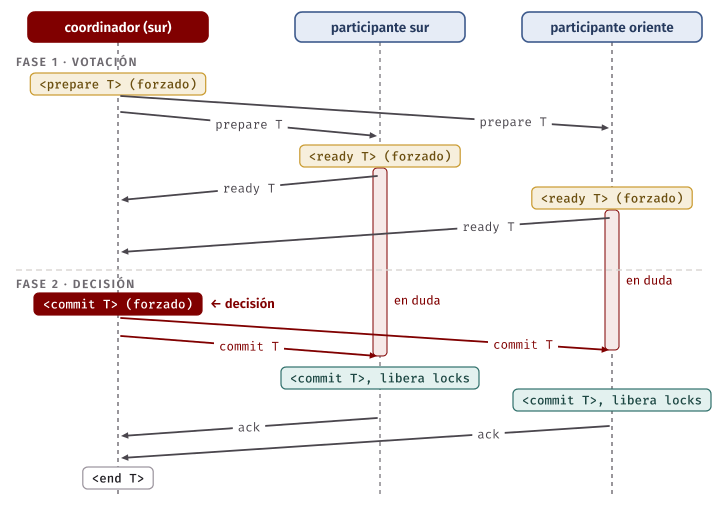
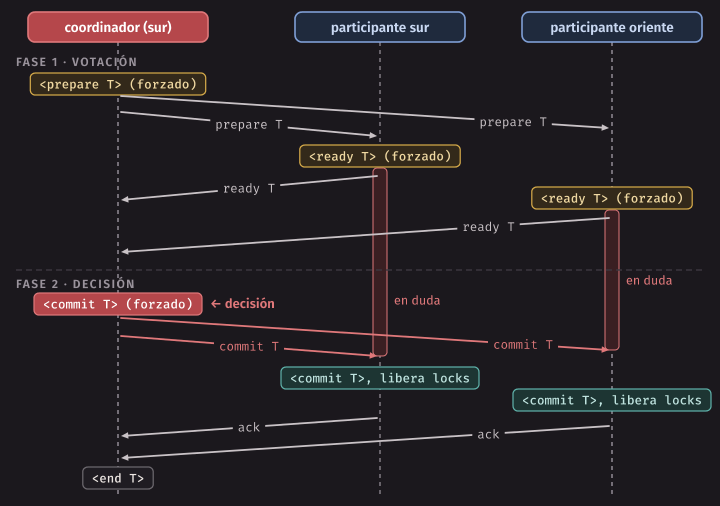
El punto central es lo que promete un participante al responder ready T:
desde ese momento ya no puede abortar por su cuenta. Prometió que, pase
lo que pase (incluso si cae y vuelve), podrá hacer commit si el coordinador
lo decide. Por eso tiene que forzar a disco todos los registros de T antes
de responder: si cayera sin ellos, no podría cumplir. Y por eso mismo tiene
que conservar los locks de T: si los soltara, otra transacción podría
cambiar los datos y el commit prometido ya no sería posible. Entre ready T
y la decisión, el participante está en duda (in doubt): no sabe si T
hará commit o abort, y no puede averiguarlo solo.
Idea clave. En 2PC, cualquier participante puede vetar la transacción mientras no haya dicho
ready. Después de decirlo, perdió el voto: solo el coordinador decide, y la decisión es el registro<commit T>o<abort T>en el log del coordinador.
¿Cuántos mensajes y escrituras forzadas cuesta? Con n participantes, 4n
mensajes (prepare, voto, decisión y ack para cada uno) y, en el camino del
commit, dos escrituras forzadas en cada participante (<ready T> y <commit T>) y en el coordinador. Cada escritura forzada es un fsync; cada mensaje,
un viaje por la red. Comparado con un commit local, que es un solo fsync,
2PC es caro, y es una de las razones para particionar de modo que la mayoría
de las transacciones toquen un solo sitio.
Cuando algo falla
Lo interesante de 2PC es qué pasa con cada fallo (sec. 23.2).
Cae un participante Sₖ. Si cae antes de responder ready T, el
coordinador no recibe su voto, vence el timeout y aborta T. Cuando Sₖ
vuelve, revisa su log para cada transacción T:
- Hay
<commit T>: hace redo(T). - Hay
<abort T>: hace undo(T). - Hay
<ready T>pero ni commit ni abort: está en duda. Tiene que preguntarle al coordinador (o a otros participantes) qué se decidió, y mientras tanto mantener los locks de T. Para recuperar rápido esos locks, Silberschatz sugiere escribir<ready T, L>, con L la lista de locks de T. - No hay ningún registro de control de T: Sₖ cayó antes de votar, el coordinador no pudo haber decidido commit, y se hace undo(T).
Cae el coordinador. Los participantes que siguen activos intentan decidir entre ellos:
- Si alguno tiene
<commit T>, T hizo commit: todos hacen commit. - Si alguno tiene
<abort T>, T abortó: todos abortan. - Si alguno no tiene
<ready T>, ese participante no votó que sí, así que el coordinador no pudo haber decidido commit: se puede abortar. - Si todos tienen
<ready T>y ninguno tiene la decisión, no se puede decidir. El coordinador pudo haber escrito<commit T>justo antes de caer, o<abort T>, o nada. Si los participantes eligieran abortar y el coordinador hubiera decidido commit (y ya se lo hubiera dicho a un participante que después cayó), la transacción quedaría con commit en un sitio y abort en otro. Así que esperan a que el coordinador vuelva.
Ese último caso es el problema de bloqueo de 2PC. Mientras esperan, los participantes mantienen los locks de T: cualquier otra transacción que quiera esos datos también espera. Un viaje entero del oriente puede quedar inaccesible porque se cayó una máquina en el sur. La caída del coordinador no es un problema de rendimiento: es un problema de disponibilidad.
Partición de la red. Si el coordinador y todos los participantes quedan del mismo lado, la partición no afecta a T. Si quedan separados, cada lado ve a los del otro como caídos: los que están con el coordinador siguen el protocolo como si los otros hubieran caído, y los que quedaron lejos se comportan como si hubiera caído el coordinador, con el mismo riesgo de bloqueo.
Presumed abort
En la versión básica, una transacción que aborta paga casi lo mismo que una que hace commit: escrituras forzadas y acknowledgments. La variante presumed abort (CS186, nota 16) parte de una observación: si el coordinador no tiene ningún registro de T, la respuesta a “¿qué pasó con T?” puede ser siempre “abort”. Con esa regla:
- el coordinador no necesita forzar
<abort T>(si cae antes de escribirlo y alguien pregunta, no encuentra nada y responde abort); - los participantes tampoco fuerzan
<abort T>ni mandan acknowledgment de un abort; - el coordinador puede olvidar una transacción abortada de inmediato.
Solo el commit queda con todas sus escrituras forzadas. Como en un sistema sano casi todas las transacciones hacen commit, el ahorro parece pequeño, pero los abortos tienden a llegar en ráfagas (un servidor sobrecargado, un deadlock que se repite) y justo ahí es cuando no conviene agregar trabajo.
Error común. Confundir 2PL con 2PC. Two-phase locking (semana 14) decide en qué orden se ven las transacciones dentro de un servidor: es control de concurrencia. Two-phase commit decide si una transacción repartida en varios servidores hace commit en todos o en ninguno: es atomicidad. Solo comparten el “dos fases”. Un sistema distribuido suele usar los dos a la vez: cada participante aplica strict 2PL a su parte (los locks se sueltan recién con la decisión de la fase 2), y 2PC hace que la decisión sea la misma en todos.
2PC en PostgreSQL: PREPARE TRANSACTION
PostgreSQL ofrece las dos fases del participante como sentencias:
- Fase 1:
PREPARE TRANSACTION 'gid'prepara la transacción actual. Si todo está bien, escribe en el WAL el equivalente de<ready T>y la separa de la sesión; si algo falla (por ejemplo, una restricción diferida que recién se verifica aquí), la transacción aborta y el participante vota que no. - Fase 2:
COMMIT PREPARED 'gid'oROLLBACK PREPARED 'gid', desde cualquier sesión conectada a la misma base de datos.
El coordinador no lo pone PostgreSQL: es la aplicación o un gestor de
transacciones externo, que tiene que guardar en algún lugar durable su
propia decisión. La documentación lo dice sin rodeos: PREPARE TRANSACTION
no está pensado para que lo use una aplicación cualquiera ni una sesión
interactiva, sino un gestor externo de transacciones.
En el servidor del curso no funciona:
$ psql -d chasqui_w16 -c "BEGIN" -c "PREPARE TRANSACTION 'demo'"
BEGIN
ERROR:  prepared transactions are disabled
HINT:  Set "max_prepared_transactions" to a nonzero value.
Viene desactivado (max_prepared_transactions = 0) a propósito: una
transacción preparada y olvidada retiene sus locks indefinidamente, impide
que VACUUM limpie las versiones que ella todavía podría necesitar y
sobrevive a los reinicios. Cambiar ese parámetro exige reiniciar el
servidor. Por eso las demostraciones corren en el cluster desechable, que
make cluster arranca con max_prepared_transactions=10.
El archivo prepared.sql hace las dos fases a
mano en la base oriente del cluster, que tiene la tabla trip con el
viaje 7001 (Cusco - Iquitos, 1000 kg de capacidad, 940 reservados):
$ psql -h /tmp -p 5416 -U postgres -d oriente -f prepared.sql
BEGIN
UPDATE 1
PREPARE TRANSACTION
       gid        | database |  owner   | xid
------------------+----------+----------+-----
 manual-1@oriente | oriente  | postgres | 762
(1 row)

   locktype    | relation  | transactionid |       mode       | granted | pid
---------------+-----------+---------------+------------------+---------+-----
 relation      | trip      |               | RowExclusiveLock | t       |
 relation      | trip_pkey |               | RowExclusiveLock | t       |
 transactionid |           |           762 | ExclusiveLock    | t       |
(3 rows)

 booked_kg
-----------
    940.00
(1 row)

COMMIT PREPARED
 booked_kg
-----------
    945.00
(1 row)

UPDATE 1
El UPDATE final devuelve los 5 kg, para que el archivo se pueda volver a
correr. Después de PREPARE TRANSACTION, la sesión ya no está dentro de una
transacción, pero la transacción 762 existe: aparece en pg_prepared_xacts y sus locks siguen
en pg_locks, con pid vacío porque ningún proceso la tiene. Son los locks
de la semana 14: RowExclusiveLock sobre la tabla y su índice (el papel de
IX) y el ExclusiveLock sobre su propio transactionid, que es lo que
espera cualquiera que quiera la fila modificada. Hasta el COMMIT PREPARED,
ninguna otra transacción ve el cambio (por eso se ven 940 kg y no 945).
¿Sobrevive de verdad una transacción preparada a una caída? Preparemos una
y detengamos el primario del cluster desechable en modo immediate, como en
el laboratorio de la semana 15 (pg_ctl -D /tmp/w16-primary -m immediate stop; nunca el servidor del curso). Al arrancar, el log del servidor dice:
LOG:  database system was not properly shut down; automatic recovery in progress
LOG:  redo starts at 0/3000028
LOG:  invalid record length at 0/402B1D8: expected at least 24, got 0
LOG:  redo done at 0/402B0A8 system usage: CPU: user: 0.00 s, system: 0.00 s, elapsed: 0.00 s
LOG:  recovering prepared transaction 797 from shared memory
Y pg_prepared_xacts la sigue mostrando, con sus locks. La línea recovering prepared transaction es la promesa del <ready T> cumplida: el redo
reconstruyó la transacción preparada desde el WAL, y el participante sigue
en duda, esperando la fase 2. La línea invalid record length no es un
error: es como el redo encuentra el final del WAL.
En PostgreSQL. El
gides único en todo el servidor, no por base de datos, y puede tener hasta 200 bytes. Lo descubrimos al probar el coordinador de abajo: con las basessuryorienteen el mismo cluster, preparar las dos partes con el mismogiddatransaction identifier "chasqui-1" is already in useen la segunda. Por eso cada participante prepara su parte con el gid global más su nombre (chasqui-1@sur,chasqui-1@oriente), como el branch qualifier del estándar XA. En servidores distintos bastaría el gid global. Tampoco se puede preparar una transacción que usó tablas temporales, cursoresWITH HOLDoLISTEN/NOTIFY.
Un coordinador en Node.js
El archivo twopc.mjs es un coordinador
pequeño. Los participantes son dos bases del cluster desechable, sur (la
tabla shipment) y oriente (la tabla trip), creadas por
twopc-setup.sql; su log de decisiones es
la tabla decision de una tercera base, coordinador. Lo esencial de
run(gid, work):
for (const name of names) await clients[name].query('BEGIN');
try {
  await work(clients);           // el INSERT en sur y el UPDATE en oriente
} catch (err) {
  for (const name of names) await clients[name].query('ROLLBACK');
  return 'abort';                // nadie votó: presumed abort, sin log
}

// Fase 1: cada participante fuerza su <ready T>.
for (const name of names) {
  try {
    await clients[name].query(`PREPARE TRANSACTION ${gidLiteral(clients[name], branchGid(gid, name))}`);
    prepared.push(name);
  } catch (err) {
    allReady = false;            // votó que no: su parte ya abortó
    break;
  }
}
// ... si alguno votó que no: ROLLBACK PREPARED en los que sí, y 'abort'.

// La decisión: este INSERT en autocommit es el <commit T> forzado.
await this.log.query('INSERT INTO decision (gid, outcome) VALUES ($1, $2)', [gid, 'commit']);

// Fase 2.
await this.finish(gid, 'commit', names);   // COMMIT PREPARED en cada uno
Tres decisiones de diseño. Primero, la decisión de commit es una fila en
otra base de datos de PostgreSQL, insertada en autocommit: cuando el
INSERT responde, su commit ya está en el WAL de esa base, forzado a disco.
Ese es el <commit T>. Segundo, con presumed abort no se anota nada para
los abortos: la tabla decision solo admite outcome = 'commit'. Tercero,
PREPARE TRANSACTION no acepta parámetros ($1): el gid tiene que ir como
literal dentro del texto de la sentencia. Es el único lugar del curso donde
se arma una sentencia con un valor adentro, y por eso gidLiteral lo valida
con una lista blanca de caracteres ([a-z0-9-]) y además lo escapa con
client.escapeLiteral. Un gid como chasqui-x'; DROP TABLE trip; -- se
rechaza antes de llegar a la base (hay una prueba de eso).
La función recover() es la recuperación del coordinador: busca en cada
participante las transacciones en duda (pg_prepared_xacts) y, para cada
una, mira el log: si hay una fila de commit, COMMIT PREPARED; si no hay
nada, ROLLBACK PREPARED. Esa es toda la regla de presumed abort.
El participante oriente vota con un constraint trigger diferido: la
capacidad del viaje se verifica al final de la transacción, es decir, en
PREPARE TRANSACTION. Así el voto “no” llega en la fase 1, cuando sur ya
votó que sí, que es el caso interesante.
twopc-demo.mjs recorre cuatro
escenarios y muestra cada paso. El viaje empieza con 940 kg de 1000:
$ node twopc-demo.mjs
  estado: 1 envíos en sur; viaje 7001 con 940.00 kg de 1000

1. Envío de 35 kg
  sur: ready
  oriente: ready
  decisión: commit (en el log del coordinador)
  sur: commit prepared
  oriente: commit prepared
  end
  resultado: commit
  estado: 2 envíos en sur; viaje 7001 con 975.00 kg de 1000

2. Envío de 40 kg (ya no cabe)
  sur: ready
  oriente: no (el viaje 7001 no tiene capacidad: 1015.00 kg de 1000)
  sur: rollback prepared
  decisión: abort (sin log, presumed abort)
  resultado: abort
  estado: 2 envíos en sur; viaje 7001 con 975.00 kg de 1000
El primer envío es el camino feliz. En el segundo, sur ya había preparado
su INSERT cuando oriente votó que no: el coordinador le manda ROLLBACK PREPARED y el envío no queda registrado. Ningún sitio quedó con media
transacción. El tercer escenario es el del bloqueo:
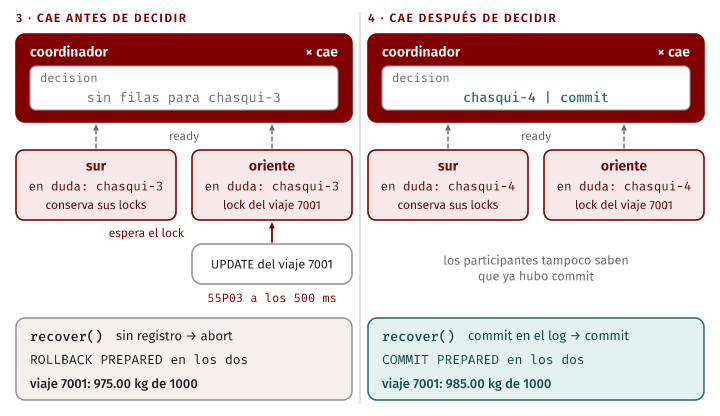
3. Envío de 10 kg, el coordinador cae después de la fase 1
  sur: ready
  oriente: ready
  el coordinador cayó (prepared)
  en duda: {"sur":["chasqui-3"],"oriente":["chasqui-3"]}
  otra transacción sobre el viaje 7001: 55P03 canceling statement due to lock timeout
  recuperación de chasqui-3: sin registro → abort
  sur: rollback prepared
  oriente: rollback prepared
  recuperación: {"chasqui-3":"abort"}
  estado: 2 envíos en sur; viaje 7001 con 975.00 kg de 1000
Los dos participantes dijeron ready y el coordinador “cayó” antes de
escribir la decisión. Las dos partes quedan en duda. Otra transacción que
quiere actualizar el viaje 7001 espera el lock de la transacción preparada;
como la demostración le puso lock_timeout = '500ms', a los 500 ms recibe
el error 55P03. Sin ese timeout, esperaría hasta que alguien termine la
transacción preparada: ese es el bloqueo de 2PC, en vivo. Cuando el
coordinador vuelve, recover() no encuentra la decisión en su log y aborta
las dos partes. El cuarto escenario es la caída justo después de decidir:
4. Envío de 10 kg, el coordinador cae después de decidir
  sur: ready
  oriente: ready
  decisión: commit (en el log del coordinador)
  el coordinador cayó (decided)
  en duda: {"sur":["chasqui-4"],"oriente":["chasqui-4"]}
  recuperación de chasqui-4: commit en el log → commit
  sur: commit prepared
  oriente: commit prepared
  end
  recuperación: {"chasqui-4":"commit"}
  estado: 3 envíos en sur; viaje 7001 con 985.00 kg de 1000
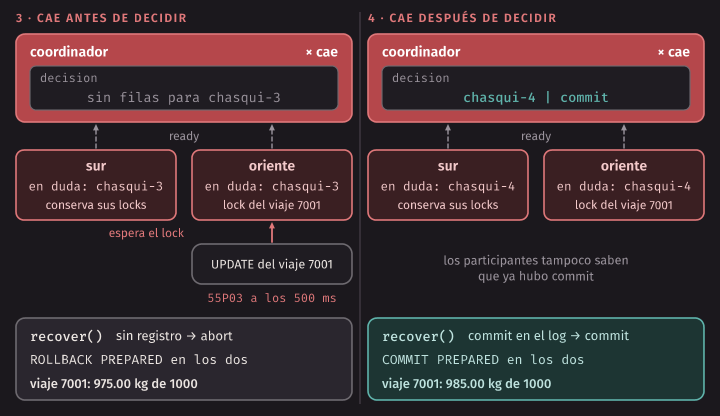
La transacción ya había hecho commit (la decisión estaba en el log), aunque ningún participante lo sabía. La recuperación termina la fase 2 y los 10 kg quedan reservados: 985 kg.
Idea clave. En el escenario 3, la respuesta de la recuperación fue abort porque el log no decía nada. En el 4, fue commit porque el log lo decía. La diferencia entre los dos es una sola fila escrita en el log del coordinador: el instante de la decisión.
Consensus, en breve
El bloqueo de 2PC viene de que la decisión vive en una sola máquina, el coordinador. Si esa máquina cae, nadie más la conoce. La solución moderna es no depender de una sola máquina: guardar la decisión (y en general, cualquier dato importante) en un grupo de máquinas que se ponen de acuerdo.
El problema de consensus (sec. 23.8) es justamente ese: un grupo de servidores tiene que acordar un valor (o, mejor, una secuencia de valores: un log replicado) de modo que (1) todos los que deciden, deciden lo mismo; (2) el valor decidido fue propuesto por alguno; y (3) el grupo sigue decidiendo aunque algunos servidores caigan o la red pierda mensajes. Los protocolos más conocidos son Paxos y Raft.
La idea central es la mayoría. Un valor se considera decidido cuando lo aceptó una mayoría del grupo. Dos mayorías siempre comparten al menos un servidor, así que dos grupos de servidores no pueden decidir cosas distintas. Con 2f + 1 servidores, el sistema sigue funcionando mientras estén activos f + 1, es decir, tolera f caídas: con 3 servidores tolera 1; con 5, tolera 2. Si la red se parte, solo el lado con mayoría sigue decidiendo; el otro espera.
En Raft, el grupo elige un líder; el líder recibe los pedidos, los agrega a su log y los manda a los demás; una entrada está confirmada cuando la tiene una mayoría. Si el líder cae, los demás eligen otro, y las reglas de la elección garantizan que el nuevo líder tenga todas las entradas confirmadas. Es replicación del log, como la de PostgreSQL, pero con una regla precisa para cambiar de principal sin perder nada y sin que haya dos principales a la vez.
¿Cómo arregla esto 2PC? Si el coordinador es un grupo replicado con
consensus, y cada participante también, la decisión <commit T> se escribe
en el log replicado del coordinador. Que caiga una máquina del grupo no
importa: otra del mismo grupo conoce la decisión y la fase 2 sigue. Así
funcionan sistemas como Spanner de Google y CockroachDB: 2PC entre
particiones, consensus dentro de cada partición. El protocolo de commit
sigue siendo 2PC; lo que cambió es que ningún “sitio” del protocolo es una
sola máquina.
CAP y modelos de consistencia
El teorema CAP
Volvamos a la replicación. Chasqui tiene una copia de los datos en Lima y otra en Iquitos, y se corta la fibra entre las dos ciudades: una partición de la red. Un empleado en Iquitos quiere registrar un envío. El sistema tiene dos opciones:
- Aceptarlo en Iquitos. El sistema sigue disponible en los dos lados, pero las dos copias divergen: si en Lima alguien reserva el mismo espacio del mismo viaje, el viaje queda sobrecargado, y hay que reconciliar cuando vuelva la red.
- Rechazarlo (o esperar) en Iquitos, porque no puede confirmar con Lima. Los datos se mantienen como si hubiera una sola copia, pero Iquitos deja de atender escrituras.
El teorema CAP lo formaliza: durante una partición de la red (P), un sistema replicado no puede ser a la vez Consistente (en el sentido de linearizable: toda lectura ve la última escritura confirmada, como si hubiera una sola copia) y Available (todo pedido a un nodo que funciona recibe respuesta). Tiene que elegir. Lo que CAP no dice es que siempre haya que renunciar a algo: sin partición, un sistema puede ser consistente y disponible a la vez. Pero incluso sin partición paga un precio por la consistencia: cada escritura tiene que esperar la confirmación de otras copias, y eso es latencia (es la replicación síncrona de arriba).
PostgreSQL con una réplica síncrona eligió C: sin la réplica, el primario deja de confirmar commits, como vimos. Con una réplica asíncrona, la réplica eligió A para las lecturas: responde siempre, aunque sea con datos viejos.
Error común. Creer que la “C” de CAP es la “C” de ACID. La de ACID (consistency) es que cada transacción lleve la base de un estado que cumple las restricciones a otro que también las cumple: claves,
CHECK, claves foráneas, reglas del negocio. La de CAP es que todas las réplicas respondan como si hubiera una sola copia. Son propiedades distintas; un sistema puede tener una sin la otra.
Linearizable, serializable y strict serializable
La página de Jepsen sobre modelos de consistencia ordena los nombres que aparecen en este tema. Tres de ellos importan aquí:
- Serializable habla de transacciones: el resultado es igual al de alguna ejecución en serie de las transacciones. Es lo que estudiamos en las semanas 13 y 14. No dice nada del tiempo real: una transacción que empezó después de que otra terminó podría quedar “antes” en el orden serial, y seguiría siendo serializable.
- Linearizable habla de un objeto (una fila, una clave) y del tiempo real: cada operación parece ocurrir en un instante entre su inicio y su fin, y si una escritura terminó antes de que empiece una lectura, la lectura la ve. Es la “C” de CAP.
- Strict serializable son las dos cosas: transacciones serializables, y el orden serial respeta el tiempo real. Es lo que esperaría un usuario que no piensa en réplicas: si mi transacción terminó, la tuya, que empezó después, la ve.
Con una réplica asíncrona se ve la diferencia. Una transacción de solo lectura en la réplica lee un snapshot consistente (un estado que existió de verdad en el primario), pero puede no ver una transacción que ya terminó en el primario hace unos milisegundos: el resultado es serializable, pero no respeta el tiempo real.
✂️ NoSQL
Por qué aparecieron
A mediados de los años 2000, empresas como Google, Amazon y Facebook tenían aplicaciones web con millones de usuarios y una forma de carga muy particular: muchísimas operaciones simples, casi todas leer o escribir un dato por su clave (el carrito de un cliente, el perfil de un usuario), y la necesidad de crecer agregando máquinas baratas en lugar de comprar un servidor más grande. Las bases relacionales de entonces escalaban poco en shared nothing, sobre todo por las transacciones distribuidas y los joins entre particiones. Los sistemas que construyeron para eso se agruparon después bajo el nombre NoSQL: renunciaron a los joins, a las transacciones entre muchas filas y, a veces, a la consistencia fuerte, a cambio de particionar y replicar fácilmente (sec. 10.2).
Hay cuatro familias.
Key-value stores
Un key-value store guarda pares (clave, valor), donde el valor es una secuencia de bytes que el sistema no interpreta. La interfaz es mínima:
get(clave)devuelve el valor;put(clave, valor)lo guarda o lo reemplaza;delete(clave)lo borra.
En Chasqui, un caso natural es el estado de un envío por su código de
seguimiento: la página que consultan los clientes millones de veces al día
hace un get y nada más. No hay WHERE sobre otros atributos, no hay join.
Con esa interfaz, particionar es fácil (por hash o por rango de la clave,
con las técnicas de la primera parte del capítulo) y replicar también.
Los diseños inspirados en Dynamo, de Amazon, guardan cada clave en N réplicas y dejan que la aplicación elija dos números: una escritura espera W confirmaciones antes de responder, y una lectura consulta R réplicas y se queda con la versión más nueva. Si
R + W > N,
todo conjunto de R réplicas que se lean comparte al menos una con todo conjunto de W réplicas que se escribieron: toda lectura encuentra la última escritura confirmada. Con N = 3:
- W = 2, R = 1: R + W = 3, no es mayor que 3. La escritura llegó a dos réplicas; la lectura puede ir justo a la tercera y ver el valor viejo.
- W = 2, R = 2: R + W = 4 > 3. Las dos réplicas leídas incluyen al menos una de las dos escritas.
- W = 3, R = 1: también suma 4. Las lecturas son rápidas (una réplica), pero una escritura no puede terminar si cualquiera de las tres réplicas está caída: subir W compra lecturas baratas y consistentes con escrituras más lentas y menos disponibles.
- W = 1, R = 1: lo más rápido y disponible, y lo menos consistente: eventual consistency.
Además, si 2W > N, dos escrituras concurrentes no pueden confirmarse ambas en conjuntos de réplicas disjuntos. Esa condición es la misma idea de mayoría de consensus, aplicada a cada operación.
Document stores
Un document store guarda en cada valor un documento, normalmente
JSON, con estructura anidada, y a diferencia del key-value store el sistema
sí lo entiende: se puede consultar por los campos de adentro e indexarlos.
El envío 501, con su lista de eventos adentro en vez de una tabla
shipment_event aparte, se vería así. Lo armamos en PostgreSQL con las
funciones jsonb de la semana 8 (documents.sql,
consulta document_501; aquí se omiten los eventos 2 y 3):
{
    "events": [
        {
            "seq": 1,
            "kind": "received",
            "agency": "Huánuco - Centro"
        },
        ...
        {
            "seq": 4,
            "kind": "delivered",
            "agency": "Pucallpa - Centro"
        }
    ],
    "origin": "Huánuco - Centro",
    "status": "delivered",
    "weight_kg": 1.30,
    "destination": "Pucallpa - Centro",
    "shipment_id": 501
}
(El orden de las claves es el que jsonb guarda internamente: por longitud
y luego alfabético, no el de jsonb_build_object.) La ventaja es clara: la
página de seguimiento del envío 501 lee un documento, de un solo
nodo, sin joins. Particionar por shipment_id deja cada envío entero en su
partición.
El precio también es claro. El nombre de la agencia está copiado en cada
evento y en el origen o el destino. Si la agencia 1 cambia de nombre, ¿cuántos
documentos hay que reescribir? (consulta docs_to_rewrite):
 documents | copies
-----------+--------
      3531 |   7002
(1 row)
3531 documentos con 7002 copias del nombre, solo contando los eventos. Es
la anomalía de actualización que la normalización evitaba en la semana 7.
En el modelo relacional, el nombre está en una fila de agency y se cambia
una vez. Un document store bien diseñado guarda adentro lo que se lee junto
y casi no cambia (los eventos de un envío), y guarda aparte, por referencia,
lo que cambia o se comparte (las agencias), aceptando que leer el nombre
cueste otra búsqueda.
En PostgreSQL.
jsonb(semana 8) permite tener las dos cosas en la misma base: tablas normalizadas para lo que se comparte y documentos para lo que es naturalmente anidado o variable, con índices GIN sobre los documentos y transacciones ACID sobre todo.
Wide-column stores y bases de grafos
Dos familias más, en una línea cada una. Los wide-column stores
(Bigtable de Google, HBase, Cassandra) guardan filas identificadas por una
clave, ordenadas por esa clave y particionadas por rangos; cada fila tiene
columnas agrupadas en familias (column families), y distintas filas pueden
tener columnas distintas. Las bases de datos de grafos (como Neo4j)
guardan nodos y aristas con propiedades, y están pensadas para consultas
que recorren caminos de longitud variable (“¿por qué agencias puede pasar un
envío de Tumbes a Puerto Maldonado con a lo más dos transbordos?”), que en
SQL requieren WITH RECURSIVE (semana 5).
Error común. Decir que NoSQL “no tiene esquema” o “no tiene transacciones”. El esquema existe igual: el código que lee el documento espera que haya un campo
eventscon una lista de objetos conseq. Lo que cambia es dónde se verifica: no al escribir (schema-on-write, comoCREATE TABLE), sino al leer (schema-on-read), en el código de cada aplicación. Y muchos sistemas garantizan atomicidad al menos por documento o por clave; varios ya ofrecen transacciones entre varios documentos.
✂️ MapReduce
El modelo
Los sistemas de la sección anterior guardan datos. Para procesar cientos de terabytes (por ejemplo, años de eventos de seguimiento en archivos), Google propuso en 2004 MapReduce (sec. 10.3), un modelo en el que el programador escribe dos funciones y el sistema se encarga de repartir el trabajo en miles de máquinas:
map(clave, valor): recibe un registro de la entrada y emite cero o más pares intermedios (k, v).reduce(k, lista de valores): recibe una clave intermedia con todos los valores que se emitieron para ella y produce el resultado para esa clave.
Entre las dos está el shuffle, que hace el sistema: junta todos los pares con la misma clave, aunque vengan de máquinas distintas, y los manda al mismo reducer, normalmente al reducer hash(k) mod R. Es un reparticionamiento por hash de la clave, exactamente como el del join distribuido.
El ejemplo de clase: contar las entregas por ciudad de destino a partir de los archivos con los eventos de seguimiento, donde cada línea trae el evento y la ciudad de la agencia donde ocurrió.
map(evento):
    si evento.kind = 'delivered':
        emit(evento.city, 1)

reduce(ciudad, unos):
    return suma(unos)
Es un GROUP BY con count(*):
SELECT a.city, count(*)
FROM shipment_event e JOIN agency a ON a.agency_id = e.agency_id
WHERE e.kind = 'delivered'
GROUP BY a.city;
Y la correspondencia con el álgebra relacional es directa: map es una
selección y una proyección (σ y Π) sobre cada registro, el shuffle es el
agrupamiento por la clave y reduce es la función de agregación (γ).
Un combiner es un reduce local que corre en la máquina del map,
antes del shuffle: en vez de mandar mil pares (Lima, 1), manda uno
(Lima, 1000). Solo es correcto si la función es asociativa y conmutativa,
como la suma; para el promedio hay que mandar (suma, cuenta) y dividir al
final.
El ejemplo en Node.js
mapreduce.mjs implementa el modelo en un
solo proceso, para ver sus fases: parte la entrada en 4 splits, aplica map
(y el combiner, si se pide), reparte los pares entre 3 reducers por hash de
la clave y reduce. La entrada son los 46 421 eventos de chasqui_w16:
$ PGDATABASE=chasqui_w16 node mapreduce.mjs
46421 eventos

sin combiner: 11115 pares emitidos por map, 11115 enviados en el shuffle (1373 + 7407 + 2335)
  Lima       3632
  Arequipa   806
  Chiclayo   601
  Ica        599
  Cusco      506

con combiner: 11115 pares emitidos por map, 100 enviados en el shuffle (24 + 48 + 28)
  Lima       3632
  Arequipa   806
  Chiclayo   601
  Ica        599
  Cusco      506

GROUP BY en PostgreSQL:
  Lima       3632
  Arequipa   806
  Chiclayo   601
  Ica        599
  Cusco      506
Tres cosas para mirar. El resultado coincide con el GROUP BY (la prueba
compara las ciudades una por una, no solo las cinco primeras). El combiner
baja el tráfico del shuffle de 11 115 pares a 100: a lo más un par por
ciudad y por split, y hay 25 ciudades de destino con entregas en cada uno de
los 4 splits. Y sin combiner, el reducer que recibe a Lima recibe 7407 de los
11 115 pares: el skew de la primera parte del capítulo reaparece aquí, porque
el shuffle es un particionamiento por hash y Lima es una sola clave con
muchísimos valores. Un hash reparte bien muchas claves distintas; no puede
partir una sola clave.
Tolerancia a fallos
Con miles de máquinas, alguna cae en cada trabajo largo. MapReduce lo
resuelve sin transacciones: la entrada está en un sistema de archivos
distribuido y replicado, y cada map escribe sus pares intermedios en el
disco local de su máquina. Si un worker cae, el sistema vuelve a ejecutar
sus tareas en otra máquina. Funciona porque map y reduce son funciones
deterministas sin efectos laterales: ejecutarlas dos veces da lo mismo.
Escribir todo a disco entre las fases es lento, pero hace que la
recuperación sea trivial.
Más allá de MapReduce
Escribir cada consulta como un par map/reduce (o una cadena de varios)
resultó incómodo. Spark (sec. 10.4) mantiene los datos intermedios en
memoria y ofrece operadores relacionales (select, join, group by) sobre
DataFrames, con un optimizador que reordena las operaciones. Hive y Spark
SQL aceptan SQL directamente. La historia termina donde empezó el curso:
álgebra relacional, un lenguaje declarativo y un optimizador que elige el
plan.
Cierre del curso
El recorrido
El curso fue, de principio a fin, la historia de una base de datos de encomiendas.
- Parte 1 (semanas 1–5): el modelo relacional y SQL. Relaciones como
conjuntos de tuplas, claves e integridad referencial; el álgebra
relacional como el lenguaje de fondo; SQL con sus multiconjuntos, sus
NULLy su lógica de tres valores; joins externos, vistas, agregación y subconsultas; SQL desde Node.js con consultas parametrizadas y transacciones; funciones, triggers,WITH RECURSIVEy window functions. - Parte 2 (semanas 6–8): diseño. El modelo E-R y su traducción a tablas;
dependencias funcionales, clausuras, claves candidatas, BCNF y 3NF;
jsonbcuando lo anidado tiene sentido. - Parte 3 (semanas 9–12): el motor por dentro. Páginas con slots, heap
files y el buffer pool; B+ trees, hash e índices en PostgreSQL; el costo en
bloques, el external merge sort y los algoritmos de join; el optimizador,
las estadísticas y
EXPLAIN.quipuimplementó el almacenamiento y los índices en P3 y los operadores en P4. - Parte 4 (semanas 13–16): transacciones. ACID, schedules y conflict
serializability; 2PL, deadlocks, granularidad múltiple, MVCC y snapshot
isolation; WAL, ARIES y backups; y, esta semana, lo que cambia al
distribuir: particionamiento, replicación, 2PC y consensus.
quipuimplementó el lock manager y el log en P5.
Si miran atrás, las ideas se repiten. El log de la semana 15 es lo que se manda a las réplicas. El hash join de la semana 11 es el reparticionamiento de un join distribuido y el shuffle de MapReduce. El histograma de la semana 12 sirve para elegir los rangos de las particiones. Strict 2PL de la semana 14 es lo que cada participante de 2PC aplica a su parte. Un sistema distribuido no es otra disciplina: es la misma, con una red en el medio.
Lo que no vimos
Quedan temas grandes para cursos posteriores o para leer por su cuenta:
column stores y analítica (Silberschatz, cap. 11); procesamiento de streams
(datos que llegan sin parar); las bases de datos de grafos en serio;
seguridad, autenticación y control de acceso (GRANT, roles, row-level
security); y la administración de PostgreSQL en producción: monitoreo,
VACUUM y su ajuste, backups automáticos, actualizaciones de versión,
connection poolers.
Repaso para el examen final
El final cubre todo el curso, con énfasis en las partes 3 y 4 (ver
exams/README.md). Los ejercicios típicos son:
insertar en un B+ tree y contar splits y altura; estimar el costo de un join
o de un ordenamiento externo en bloques; estimar una selectividad con un
histograma; leer un plan con EXPLAIN ANALYZE; decidir si un schedule es
serializable por conflictos con su grafo de precedencia; aplicar 2PL y
detectar un deadlock; decir qué anomalía permite cada nivel de aislamiento;
y recuperar una base de datos con ARIES a partir de un log. El
final de práctica tiene el formato del examen
real: resuélvanlo en papel, con el reloj corriendo, antes de mirar sus
apuntes.
En el laboratorio
El laboratorio de esta semana es la presentación de P5: cada equipo muestra
su lock manager y su log de quipu con cuatro escenarios (locks
compartidos y cola de espera, lock upgrade, un deadlock detectado con el
waits-for graph y una caída con recuperación), corre las pruebas de P3, P4 y
P5 en el contenedor y responde preguntas sobre su código. Las indicaciones
están en la guía de la semana y en
projects/README.md.
El código de este capítulo se puede seguir en casa con el mismo contenedor:
make cluster arranca el cluster desechable, y desde ahí se pueden repetir
a mano las sesiones de psql de arriba. Al terminar, make cluster-rm lo
borra.
El código de la semana y make test
Dentro del contenedor, en code/week-16, make crea chasqui_w16 y le
carga las tablas particionadas; make cluster crea el cluster desechable en
/tmp/w16-primary (puerto 5416) y su réplica en /tmp/w16-replica (puerto
5417), con las bases sur, oriente y coordinador. make test hace las
dos cosas, corre las pruebas y borra el cluster al final, aunque alguna
prueba falle:
$ make test
chasqui-load chasqui_w16
Base de datos chasqui_w16 lista.
psql -X -q -v ON_ERROR_STOP=1 -d chasqui_w16 -f partitions.sql
...
Cluster listo: primario en el puerto 5416, réplica en el 5417.
PGDATABASE=chasqui_w16 node --test --test-concurrency=1 --test-reporter=spec; \
  status=$?; make -s cluster-rm; exit $status
✔ un conteo de palabras pequeño
✔ entregas por ciudad: igual que GROUP BY, con y sin combiner
✔ por mes: seis particiones con todos los envíos, la DEFAULT vacía
...
✔ síncrona: sin la réplica, el commit espera; al cancelarlo ya hizo commit local
✔ commit: los dos votan que sí y los dos hacen commit
✔ voto no en la fase 1: oriente no tiene capacidad y sur hace rollback prepared
...
✔ una transacción preparada sobrevive a una caída del servidor
ℹ tests 23
ℹ pass 23
ℹ fail 0
...| Archivo | Qué muestra |
|---|---|
partitions.sql |
Tres copias particionadas de shipment (por mes, por hash y por zona) y shipment_event por hash |
pruning.sql |
Filas por partición, partition pruning en la planificación y en la ejecución, join por particiones, skew |
documents.sql |
El envío 501 como documento JSON y cuántas copias del nombre de una agencia habría |
twopc-setup.sql |
Las bases sur, oriente y coordinador del cluster desechable |
prepared.sql |
PREPARE TRANSACTION y COMMIT PREPARED a mano, con los locks de la transacción preparada |
twopc.mjs |
El coordinador de 2PC con presumed abort y su recuperación |
twopc-demo.mjs |
Los cuatro escenarios, paso a paso |
mapreduce.mjs |
MapReduce de juguete: entregas por ciudad, con y sin combiner |
partitions.test.mjs |
Las cifras y los planes de pruning.sql y documents.sql |
replication.test.mjs |
Streaming replication: réplica de solo lectura, un DELETE que se replica, la espera síncrona |
twopc.test.mjs |
El coordinador (commit, voto no, fallo antes de la fase 1, las dos caídas, gid inválido), prepared.sql y una caída con una transacción preparada |
mapreduce.test.mjs |
mapReduce contra el GROUP BY |
Como en semanas anteriores, las consultas de los .sql empiezan con una
línea -- name: ..., y sqlfile.mjs las
separa para que las pruebas corran el mismo texto. Los archivos de prueba se
corren uno después de otro (--test-concurrency=1): replication.test.mjs
detiene la réplica y twopc.test.mjs reinicia el primario del cluster
desechable. Ninguna prueba toca el servidor del curso más allá de
chasqui_w16. Si un make cluster se interrumpe a la mitad, make cluster-rm deja todo limpio.
Resumen
- Distribuir sirve para tres cosas: capacidad (particionar), disponibilidad (replicar) y latencia (datos cerca de quien los usa). Las arquitecturas paralelas comparten memoria, disco o nada; shared nothing es la que escala más, y lo caro en ella es mover datos por la red. Un sistema distribuido es homogéneo si todos los sitios corren el mismo software y cooperan, y heterogéneo si no.
- Particionamiento: round-robin reparte parejo, pero toda consulta va a todas las particiones; hash sirve para igualdad sobre la clave; rango sirve para rangos. Una consulta va a una sola partición solo si fija el atributo de particionamiento. Particionar dos tablas por la misma clave hace locales los joins sobre esa clave.
- Skew: de datos (Lima tiene un tercio de los envíos) o de ejecución (todas las inserciones caen en el mes actual). Remedios: rangos elegidos con histogramas, nodos virtuales, reparticionamiento dinámico, consistent hashing.
- En PostgreSQL,
PARTITION BY RANGE,LISToHASHdivide una tabla dentro de un servidor; repartir las particiones en servidores es sharding. La clave primaria debe incluir la clave de particionamiento. Partition pruning descarta particiones al planificar o al ejecutar (Subplans Removed);enable_partitionwise_joinhace el join partición contra partición. - Replicación: primary-backup manda el log a las réplicas. Síncrona: el
commit espera a la réplica (no se pierde nada, cada commit es más lento,
y sin réplica no hay commits). Asíncrona: rápida, pero la réplica va atrás
y un failover puede perder los últimos commits. En PostgreSQL, streaming
replication a un hot standby, asíncrona salvo que se configure
synchronous_standby_names. Una réplica no es un backup. - 2PC: fase 1, el coordinador pide votos y cada participante que puede
fuerza
<ready T>y ya no puede abortar solo; fase 2, el coordinador fuerza<commit T>o<abort T>(el instante de la decisión) y la comunica. Si el coordinador cae con todos en ready, los participantes quedan bloqueados, con sus locks. Presumed abort: sin registro, la respuesta es abort, y los abortos no se fuerzan. - En PostgreSQL,
PREPARE TRANSACTIONes la fase 1 yCOMMIT PREPAREDoROLLBACK PREPAREDla fase 2; el coordinador es externo. Viene apagado (max_prepared_transactions = 0); una transacción preparada sobrevive a una caída y conserva sus locks; el gid es único en todo el servidor. - 2PL ordena las transacciones dentro de un servidor; 2PC hace atómica una transacción entre servidores. Se usan juntos.
- Consensus (Paxos, Raft): un grupo de 2f + 1 servidores acuerda un log replicado y tolera f caídas. 2PC sobre grupos con consensus ya no se bloquea por la caída de una máquina.
- CAP: durante una partición de la red, hay que elegir entre disponibilidad y consistencia linearizable. La “C” de CAP no es la de ACID. Serializable habla de transacciones; linearizable, de un objeto y del tiempo real; strict serializable, de las dos cosas.
- ✂️ NoSQL: key-value stores (
get/put, quórum con R + W > N), document stores (documentos JSON anidados, con la anomalía de las copias), wide-column stores y bases de grafos. Tienen esquema, solo que en el código que lee (schema-on-read). - ✂️ MapReduce:
mapemite pares, el shuffle los agrupa por clave (un reparticionamiento por hash) yreducelos agrega: unGROUP BY. El combiner reduce el tráfico; una clave muy frecuente sobrecarga a su reducer. Los fallos se resuelven volviendo a ejecutar tareas.
Ejercicios
- Chasqui reparte
shipmenten cuatro servidores. Para cada esquema (hash deshipment_id, rango decreated_atpor trimestre, lista por zona de la agencia de origen), digan a cuántos servidores va cada una de estas consultas y dónde aparece el skew: (a) el envío 501; (b) los envíos de marzo; (c) los envíos del cliente 777; (d) los envíos que salieron de Cusco en junio; (e) el total de envíos por estado. - En
chasqui_w16, escriban unEXPLAIN (COSTS OFF)sobreshipment_by_zoneque lea soloshipment_sury otro que lea dos particiones. ¿PodaWHERE origin_agency_id IN (6, 29)? ¿YWHERE origin_agency_id + 0 = 6? Expliquen la diferencia. - Con
shipment_by_month, comparenEXPLAINdeWHERE created_at >= '2026-06-15'y deWHERE created_at >= now() - interval '200 days'. ¿En cuál poda el planificador y en cuál el ejecutor? ¿Por quénow()no se puede evaluar al planificar un plan que se guarda? BusquenSubplans RemovedconEXPLAIN ANALYZE. - Calculen un vector de particionamiento por rango de
shipment_idpara tres particiones con la misma cantidad de envíos enchasqui_w16(usenntileopercentile_disc). Después hagan lo mismo conweight_kgy comparen: ¿por qué los cortes deweight_kgno quedan en intervalos iguales? ¿Qué tiene que ver con un histograma equi-depth? - Un key-value store tiene N = 5 réplicas por clave. Den todas las parejas (R, W) con 1 ≤ R, W ≤ 5 que garantizan que una lectura ve la última escritura confirmada. ¿Cuál elegirían si el 95 % de las operaciones son lecturas? ¿Cuántas réplicas pueden estar caídas para que sigan funcionando las lecturas y para que sigan funcionando las escrituras con esa elección?
- En 2PC, el coordinador recibe
readyde todos los participantes y cae antes de escribir su decisión en el log. ¿En qué estado quedan los participantes? ¿Por qué no pueden abortar por su cuenta? ¿Qué pasa con los locks que tienen? Repitan la pregunta si el coordinador cae después de escribir<commit T>pero antes de mandar ningún mensaje. ¿Cambia algo para los participantes? ¿Y para la recuperación del coordinador? - Un participante de 2PC vuelve después de una caída y encuentra en su log,
para tres transacciones: (a)
<T1 start>, updates de T1 y<ready T1>; (b)<T2 start>y updates de T2; (c)<T3 start>, updates,<ready T3>y<commit T3>. ¿Qué hace con cada una? ¿Para cuál necesita al coordinador? Con presumed abort, si el coordinador no tiene registro de T1, ¿qué responde? - Con el cluster desechable (
make cluster), abran dos sesiones en la baseoriente. En la primera, preparen unUPDATEdel viaje 7001 sin hacerCOMMIT PREPARED. En la segunda, intentenSELECT ... FOR UPDATEdel mismo viaje y, aparte, unSELECTsimple. ¿Cuál espera y cuál no? ¿Por qué? Después,\qen la primera: ¿desaparece la transacción preparada? Termínenla desde la segunda sesión. - Modifiquen
twopc-demo.mjs(o escriban una prueba) para que el coordinador caiga entre los dosPREPARE TRANSACTION:surya votó que sí yorientetodavía no recibió el prepare. ¿En qué estado queda cada participante? ¿Qué hacerecover()? ¿Hay bloqueo enoriente? (Pista: si la conexión del coordinador se corta, ¿qué hace PostgreSQL con una transacción que no llegó aPREPARE TRANSACTION?) - ✂️ Escriban
mapyreducepara calcular el peso total enviado por ruta (agencia de origen y de destino) a partir de los envíos de Chasqui, y la consulta SQL equivalente. Pruébenlo conmapReducedemapreduce.mjssobreSELECT origin_agency_id, dest_agency_id, weight_kg FROM shipment. ¿Sirvereducecomo combiner? ¿Y si lo que se pide es el peso promedio por ruta? - ✂️ Diseñen el documento de un cliente de Chasqui para un document store, para una aplicación de celular que muestra “mis envíos”. ¿Qué guardan adentro y qué por referencia? ¿Qué pasa cuando un envío cambia de estado, y cuántos documentos hay que tocar? Comparen con guardar un documento por envío.
- (Desafío) Agreguen a
Coordinatorun modo en el que la fase 1 manda losPREPARE TRANSACTIONa todos los participantes en paralelo (Promise.allSettled) en vez de uno después de otro. ¿Qué gana en latencia con n participantes? ¿Qué cambia en el manejo de un voto “no”? Escriban una prueba con el escenario del viaje lleno.