
Apuntes · Capítulo 13Transacciones y distribuidos
Transacciones: ACID, serializabilidad y aislamiento
Transacciones: ACID, serializabilidad y aislamiento
Desde la semana 9 abrimos el motor por dentro: cómo guarda una tabla en páginas, cómo la indexa, cómo ejecuta y optimiza una consulta. En todo ese tramo hubo una simplificación que nunca dijimos en voz alta: una sola consulta a la vez, y una computadora que nunca se apaga. En Chasqui no es así. A las ocho de la mañana hay empleados en treinta agencias registrando envíos, un proceso que asigna paquetes a los viajes del día y clientes consultando el estado de su encomienda desde el celular. Y de vez en cuando se va la luz.
Esta semana empieza la cuarta parte del curso, la de transacciones y sistemas distribuidos. La pregunta que la guía es: ¿qué le promete el DBMS a un programa cuando hay muchos programas a la vez y las cosas fallan? La respuesta tiene nombre, la transacción, y cuatro propiedades, ACID. Hoy vemos qué significan con precisión y cómo se razona sobre ellas; las semanas 14 y 15 muestran cómo las implementa un motor (locks y MVCC para el aislamiento, el log para la atomicidad y la durabilidad).
El capítulo tiene dos partes. En la primera definimos transacción, el modelo
simple de lecturas y escrituras del libro, los estados por los que pasa una
transacción y la idea central de hoy: un schedule concurrente es
correcto si equivale a algún schedule serial. Vamos a aprender a decidirlo
con un grafo de precedencia. En la segunda parte agregamos los abortos
(schedules recuperables y sin rollback en cascada) y bajamos a SQL: los
niveles de aislamiento del estándar, las anomalías que permite cada uno,
lo que hace PostgreSQL en cada nivel y cómo una aplicación debe reintentar
una transacción que el motor aborta. Todos los schedules de dos sesiones del
capítulo son corridas reales de dos psql sobre la misma base de datos.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “Qué es una transacción” y “Una carrera en Chasqui”. Sesión B: “Schedules recuperables” y “Las tres anomalías del estándar”.
- En clase. Sesión A: “Un modelo simple”, “Ejecuciones concurrentes”, “Schedules”, “Conflict serializability” y “View serializability”. Sesión B: “Recuperabilidad”, “Niveles de aislamiento en SQL”, “Lo que hace PostgreSQL”, “Cómo se implementa el aislamiento”, “Transacciones en SQL” y “Reintentar”.
- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 17.1–17.10. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-13, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
Qué es una transacción
Registrar un envío
Cuando una agencia de Chasqui recibe un paquete, la aplicación hace varias
cosas en la base de datos: inserta la fila del envío en shipment, inserta
su primer evento (received) en shipment_event y, si ya hay un viaje para
esa ruta, le asigna el trip_id. Son tres o cuatro sentencias, pero para la
empresa es una sola operación. Dos cosas no pueden pasar:
- Que se haga una parte y no el resto. Un envío sin su evento
receivedno aparece en el seguimiento; un evento sin envío viola la clave foránea. Si el servidor se cae entre la segunda y la tercera sentencia, al volver no debe quedar nada a medias. - Que otro empleado vea el envío a medias. Si el proceso que arma la carga del viaje cuenta los paquetes justo entre dos sentencias, puede contar un envío que todavía no tiene peso confirmado, o contar dos veces uno que se está moviendo de viaje.
Silberschatz (sec. 17.1) define una transacción como una unidad de
ejecución de un programa que accede a datos y posiblemente los actualiza.
En SQL se delimita con BEGIN y COMMIT (la semana 4 la presentamos en una
frase y la semana 5 la usamos desde Node.js): lo que hay entre ambas se
aplica entero o no se aplica, y se comporta como si nadie más estuviera
usando la base.
ACID
El DBMS promete cuatro propiedades para cada transacción. La sigla ACID viene de sus nombres en inglés:
- Atomicidad (atomicity). O se reflejan en la base de datos todas las operaciones de la transacción, o ninguna. Si algo falla a mitad de camino, el DBMS deshace lo que ya hizo.
- Consistencia (consistency). Si la base de datos estaba en un estado
correcto y la transacción se ejecuta sola, la deja en un estado correcto.
“Correcto” quiere decir que cumple las restricciones declaradas (claves,
CHECK, claves foráneas) y también las reglas del negocio que no están declaradas en ninguna parte. - Aislamiento (isolation). Aunque varias transacciones se ejecuten a la vez, cada una se comporta como si estuviera sola: para cada par Ti, Tj, a Ti le parece que Tj terminó antes de que ella empezara o que empezó después de que ella terminó.
- Durabilidad (durability). Cuando una transacción hace commit, sus cambios sobreviven a cualquier fallo posterior, aunque el servidor se apague un milisegundo después.
Lo importante no es la sigla sino quién garantiza cada propiedad:
| Propiedad | Quién la garantiza | Semana |
|---|---|---|
| Atomicidad | El sistema de recuperación, con el log (deshace lo incompleto) | 15 |
| Consistencia | El programador, que escribe transacciones correctas; las restricciones del esquema lo ayudan | 4 |
| Aislamiento | El control de concurrencia (locks, MVCC) | 14 |
| Durabilidad | El sistema de recuperación, con el log en almacenamiento estable | 15 |
La consistencia es la rara del grupo: el DBMS no sabe qué es “correcto” para Chasqui más allá de lo que se declaró. Si una transacción le cobra a un cliente dos veces el mismo envío, la base queda “consistente” según las restricciones y mal para el negocio. Las otras tres son trabajo del motor, y juntas permiten que la consistencia de cada transacción por separado se convierta en consistencia del sistema entero: si cada transacción, sola, deja la base bien, y el DBMS garantiza atomicidad, aislamiento y durabilidad, entonces la base queda bien aunque haya miles de transacciones a la vez y caídas en medio.
Idea clave. Una transacción es la unidad de correctitud: el programador razona sobre ella como si se ejecutara sola y completa, y el DBMS se encarga de que eso sea verdad aunque no lo sea físicamente.
Un modelo simple
Lecturas, escrituras y la copia local
Para razonar sobre transacciones el libro (sec. 17.2) usa un modelo muy pequeño. La base de datos es un conjunto de ítems (data items) con nombre: A, B, Q. En Chasqui un ítem puede ser la fila del envío 501 o el precio de ese envío; el modelo no dice qué tamaño tiene un ítem. Una transacción solo tiene dos operaciones sobre la base:
read(X)copia el valor del ítem X de la base de datos a una variable local X, en la memoria de la transacción.write(X)copia el valor de la variable local X al ítem X de la base de datos.
Todo lo demás (sumar, comparar, decidir) ocurre en la memoria de la transacción y la base no lo ve. Un ejemplo: pasar 5 soles del precio del envío 501 (ítem A) al del envío 502 (ítem B), porque el recargo de embalaje se cargó al envío equivocado:
T1:  read(A)
     A := A − 5
     write(A)
     read(B)
     B := B + 5
     write(B)
Con esto las cuatro propiedades se ven concretas:
- Consistencia: la suma A + B no cambia. Es una regla del negocio que ninguna restricción del esquema expresa; la cumple el programa.
- Atomicidad: si el sistema falla después de
write(A)y antes dewrite(B), la base queda con 5 soles menos en total. Es un estado inconsistente que tiene que existir durante un rato mientras T1 corre; lo que no puede pasar es que quede visible después de un fallo. El DBMS lo logra guardando en un log los valores viejos de lo que escribe, para poder deshacerlo (semana 15). - Durabilidad: si T1 hizo commit y se informó al usuario, los dos
writetienen que sobrevivir. Basta con que, antes de confirmar, se haya escrito en disco información suficiente para rehacerlos (otra vez el log). - Aislamiento: si entre
write(A)ywrite(B)otra transacción lee A y B y suma, ve 5 soles de menos. Ejecutar las transacciones una después de otra lo evitaría, pero, como veremos, cuesta demasiado.
Un detalle del modelo que importa: write(X) no escribe en el disco. Escribe
en la base de datos, que en la práctica es una página del buffer pool
(semana 9). Esa página llega al disco más tarde, cuando el buffer manager lo
decide. Por eso la durabilidad no es automática: el commit no puede esperar a
que todas las páginas sucias lleguen al disco, y tampoco puede confiar en que
lleguen.
Almacenamiento volátil, no volátil y estable
El libro (sec. 17.3) distingue tres tipos de almacenamiento según qué sobrevive:
- Volátil: la memoria principal y las cachés. No sobrevive a una caída del sistema.
- No volátil: discos, SSD, cinta. Sobrevive a una caída del sistema, pero se pierde si falla el propio dispositivo.
- Estable (stable storage): la información nunca se pierde. Es una idealización; no existe un dispositivo así. Se aproxima guardando varias copias en medios no volátiles con modos de falla independientes: varios discos (RAID, semana 9), y mejor aún, varios sitios lejos unos de otros.
El log de la semana 15 vive en almacenamiento estable. Hoy basta con la idea: la durabilidad que promete el DBMS es tan buena como la aproximación al almacenamiento estable que tenga. Un servidor con un solo disco pierde lo que tenía confirmado si ese disco se quema.
Los estados de una transacción
Una transacción no siempre termina bien. El libro (sec. 17.4) la describe con cinco estados:
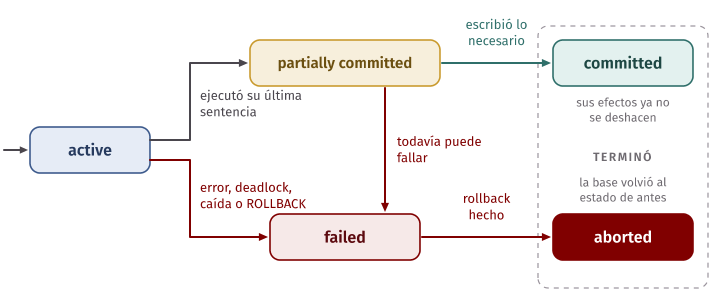
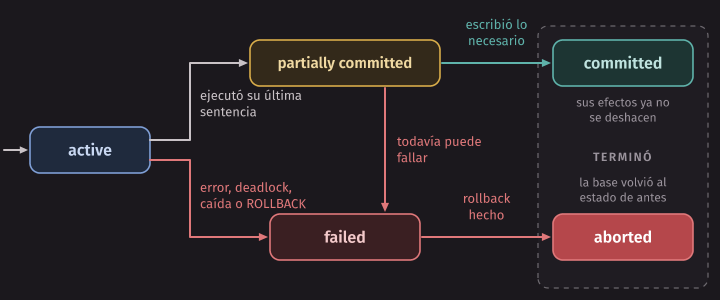
- Active: el estado inicial; la transacción se está ejecutando.
- Partially committed: ya ejecutó su última sentencia, pero todavía puede fallar: sus escrituras pueden estar solo en memoria.
- Failed: descubrió que no puede seguir normalmente (una restricción
violada, un deadlock, una caída, o el programa pidió
ROLLBACK). - Aborted: se hizo rollback y la base volvió al estado de antes de la transacción.
- Committed: terminó con éxito y se escribió lo necesario para que sus cambios sobrevivan.
Se dice que una transacción terminó si hizo commit o abortó. Una vez que hizo commit, sus efectos no se pueden deshacer con un rollback: si estuvieron mal, la única forma de corregirlos es otra transacción, una transacción de compensación (por ejemplo, un reembolso).
Después de abortar, el sistema tiene dos opciones: reiniciar la transacción, si el problema fue externo a ella (un deadlock, una caída), o matarla, si fue un error de su propia lógica o de los datos de entrada. Reiniciar es exactamente lo que vamos a hacer al final del capítulo cuando PostgreSQL aborta una transacción por un conflicto de serialización.
Error común. Hacer en medio de una transacción algo que el DBMS no puede deshacer: mandar el SMS “su encomienda fue registrada”, imprimir la boleta, llamar a la API de pagos. Si después la transacción aborta, la base vuelve atrás, pero el SMS ya salió. El libro llama a esto escrituras externas observables (observable external writes): se hacen después del commit.
Ejecuciones concurrentes
Por qué no ejecutar una transacción después de otra
Lo más simple para garantizar el aislamiento sería ejecutar las transacciones de a una: la siguiente empieza cuando la anterior terminó. El libro (sec. 17.5) da dos razones para no hacerlo:
- Más throughput y más uso de los recursos. Una transacción hace entrada/salida (leer una página del disco) y cálculo. Mientras una espera al disco, otra puede usar la CPU, y una tercera puede estar leyendo de otro disco. Con muchas transacciones a la vez el sistema termina más transacciones por segundo.
- Menos tiempo de espera. Una consulta que cuenta los envíos del año tarda segundos; si las transacciones cortas tuvieran que esperar a que termine, un empleado esperaría segundos para registrar un paquete.
Es la misma razón por la que en Sistemas Operativos se usan procesos e hilos, y trae el mismo problema: condiciones de carrera. Allá se resuelven con mutex y semáforos alrededor de secciones críticas que el programador marca. Aquí la idea es distinta: el programador no marca nada, escribe cada transacción como si estuviera sola, y el DBMS restringe el intercalado de las operaciones para que el resultado sea el de alguna ejecución sin intercalar. La parte del DBMS que hace eso es el control de concurrencia (concurrency control).
Una carrera en Chasqui
Dos empleados atienden al mismo cliente por el envío 501, que cuesta 50 soles. La empleada A le cobra 5 soles de embalaje; el empleado B le aplica un descuento de 10 soles. Cada uno, en su programa, lee el precio, calcula y escribe:
T1 (A):  read(P)   P := P + 5    write(P)
T2 (B):  read(P)   P := P − 10   write(P)
Si se ejecutan una después de otra, el precio final es 45 en cualquier orden. Pero si las dos leen antes de que alguna escriba:
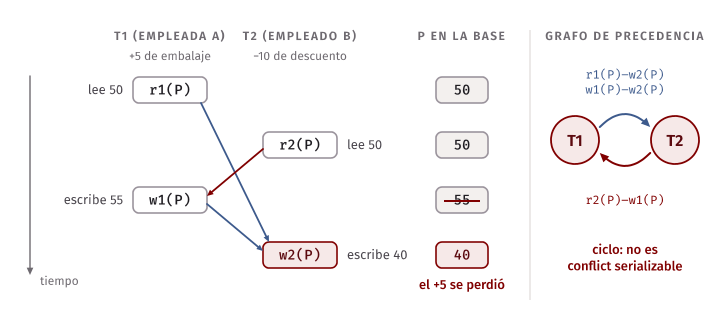
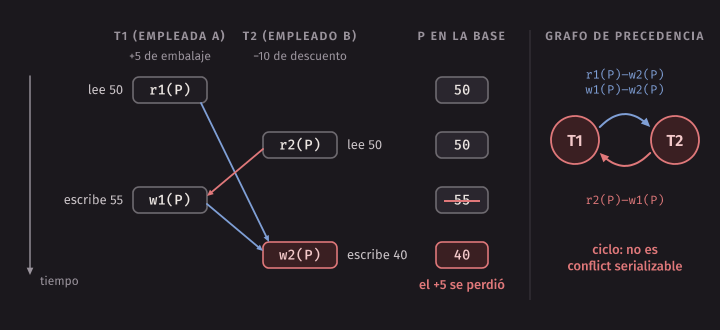
El precio final es 40: el embalaje se perdió. Cada transacción, sola, era correcta; el intercalado no. Esta anomalía se llama lost update y la vamos a reproducir en PostgreSQL más adelante, con salida real. Antes necesitamos un lenguaje para hablar de intercalados.
Schedules
Definición y notación
Un schedule es una secuencia de las operaciones de un conjunto de transacciones que contiene todas las operaciones de cada una y respeta el orden en que aparecen dentro de cada transacción. Es el orden cronológico en que el sistema las ejecutó. El libro escribe los schedules en columnas, una por transacción; nosotros, como CS186, los escribimos en una línea:
| Notación | Significa |
|---|---|
r1(A) |
T1 lee el ítem A |
w2(B) |
T2 escribe el ítem B |
c1 |
T1 hace commit |
a2 |
T2 aborta |
El lost update de arriba es r1(P) r2(P) w1(P) w2(P). Lo que cada
transacción calcula entre una lectura y una escritura no aparece en el
schedule. Esto no es un descuido de la notación: el DBMS tampoco lo ve. Solo
ve sentencias que leen y escriben filas.
Hasta la sección de recuperabilidad vamos a suponer que todas las
transacciones hacen commit, y vamos a omitir los c.
Schedules seriales
Un schedule es serial si las operaciones de cada transacción aparecen juntas, sin operaciones de otras en medio: una transacción completa, después otra completa. Con n transacciones hay n! schedules seriales distintos (con tres transacciones, seis). Para T1 y T2 del embalaje:
serial T1, T2:   r1(P) w1(P) r2(P) w2(P)     → 50 + 5 − 10 = 45
serial T2, T1:   r2(P) w2(P) r1(P) w1(P)     → 50 − 10 + 5 = 45
Aquí los dos dan lo mismo, pero no tiene por qué ser así. Si T2 fuera “10 % de descuento” en vez de “10 soles”, T1, T2 da 49.50 y T2, T1 da 50; los dos son resultados correctos, porque cada uno corresponde a que una transacción llegó primero. El DBMS no promete un orden; promete que el resultado es el de alguno.
Todo schedule serial preserva la consistencia: si cada transacción, sola, lleva la base de un estado correcto a otro correcto, una serie de ellas también. Los schedules no seriales son el problema.
Serializabilidad
Un schedule es serializable si es equivalente a algún schedule serial de las mismas transacciones. La definición deja abierta la palabra “equivalente”, y de ella depende todo:
- La más natural sería “deja la base en el mismo estado”. Pero para saberlo habría que entender lo que cada transacción calcula, y el DBMS no lo ve.
- Las definiciones que se usan miran solo el orden de las lecturas y escrituras. La más usada es la equivalencia por conflictos; una más amplia, la equivalencia de vistas.
Error común. Creer que “serializable” significa “se ejecutó en serie” o “se ejecutó en el orden en que llegaron”. Un schedule serializable puede intercalar todo lo que quiera; solo tiene que ser equivalente a algún orden serial, que no tiene por qué ser el de llegada. Si la empleada A empezó primero pero el resultado es el de “B, después A”, el schedule sigue siendo serializable.
Conflict serializability
Operaciones en conflicto
Sean I y J dos operaciones consecutivas de un schedule, de transacciones distintas Ti y Tj. Si I y J son sobre ítems distintos, se pueden intercambiar sin que nadie note la diferencia. Si son sobre el mismo ítem Q, depende:
| I | J | ¿Importa el orden? |
|---|---|---|
read(Q) |
read(Q) |
No: las dos leen el mismo valor en cualquier orden |
read(Q) |
write(Q) |
Sí: si I va primero, Ti lee el valor viejo; si no, el que escribió Tj |
write(Q) |
read(Q) |
Sí, por la misma razón |
write(Q) |
write(Q) |
Sí: cambia cuál valor queda para la siguiente lectura o al final |
Definición. Dos operaciones están en conflicto si son de
transacciones distintas, son sobre el mismo ítem, y al menos una de ellas es
una escritura. Los pares en conflicto son r-w, w-r y w-w. Dos lecturas
nunca entran en conflicto, y dos operaciones de la misma transacción
tampoco: su orden lo fija la transacción y no se puede cambiar.
Intercambiar operaciones vecinas
Definición. Si un schedule S se puede transformar en un schedule S’ con una serie de intercambios de operaciones consecutivas que no están en conflicto, S y S’ son equivalentes por conflictos (conflict equivalent). Un schedule es conflict serializable si es equivalente por conflictos a algún schedule serial.
Un ejemplo pequeño. T1 lee y escribe A y después B; T2 hace lo mismo:
S = r1(A) w1(A) r2(A) w2(A) r1(B) w1(B) r2(B) w2(B)w2(A) y r1(B) no están en conflicto (ítems distintos): se intercambian.
Después r2(A) y r1(B), también. Siguiendo así, las operaciones de T1
sobre B “pasan” por delante de las de T2 sobre A:
   r1(A) w1(A) r2(A) w2(A) r1(B) w1(B) r2(B) w2(B)
→  r1(A) w1(A) r2(A) r1(B) w2(A) w1(B) r2(B) w2(B)
→  r1(A) w1(A) r1(B) r2(A) w2(A) w1(B) r2(B) w2(B)
→  ...
→  r1(A) w1(A) r1(B) w1(B) r2(A) w2(A) r2(B) w2(B)   (serial T1, T2)
S es conflict serializable. El método funciona, pero buscar a mano la serie de intercambios es tedioso y, cuando no existe, no hay cómo probarlo intentando. Hace falta algo mejor.
El grafo de precedencia
Definición. El grafo de precedencia (precedence graph; CS186 lo llama grafo de dependencias) de un schedule S tiene un nodo por cada transacción y una arista Ti → Tj si hay una operación de Ti y una de Tj, en ese orden en S, que están en conflicto. Es decir, si ocurre alguna de estas:
- Ti hace
write(Q)antes de que Tj hagaread(Q); - Ti hace
read(Q)antes de que Tj hagawrite(Q); - Ti hace
write(Q)antes de que Tj hagawrite(Q).
Una arista Ti → Tj dice: “en cualquier schedule serial equivalente, Ti tiene que ir antes que Tj”, porque los intercambios no pueden cambiar el orden de dos operaciones en conflicto.
Teorema. Un schedule es conflict serializable si y solo si su grafo de precedencia no tiene ciclos. Si no los tiene, cualquier orden topológico del grafo (una lista de los nodos en la que cada arista va de izquierda a derecha) da un schedule serial equivalente.
La intuición de la ida: si hay un ciclo T1 → T2 → T1, T1 tendría que ir antes que T2 y T2 antes que T1 en el mismo orden serial; imposible. La de la vuelta: si no hay ciclo, tomamos la transacción sin aristas de entrada (siempre hay una en un grafo acíclico); ninguna de sus operaciones está en conflicto con una operación anterior de otra, así que se pueden llevar todas al principio con intercambios; se repite con el resto.
Buscar ciclos en un grafo con n nodos es un recorrido en profundidad, de
orden n² en el peor caso (o n + e con e aristas). Es barato, y es lo que hace
precedence.mjs.
Un ejemplo resuelto
A es la fila del envío 501 y B la del viaje 12. Tres transacciones:
S = r1(A) r2(B) w1(A) r3(A) w2(B) r3(B) w3(A) r1(B)Método: para cada ítem, listar sus operaciones en orden y buscar los pares en conflicto.
- Sobre A:
r1(A) w1(A) r3(A) w3(A). Pares en conflicto entre transacciones distintas:r1(A)–w3(A),w1(A)–r3(A)yw1(A)–w3(A). Los tres dan T1 → T3. - Sobre B:
r2(B) w2(B) r3(B) r1(B).w2(B)–r3(B)da T2 → T3 yw2(B)–r1(B)da T2 → T1.r2(B)no está en conflicto conr3(B)ni conr1(B): son lecturas. Yr3(B)–r1(B)tampoco: dos lecturas.
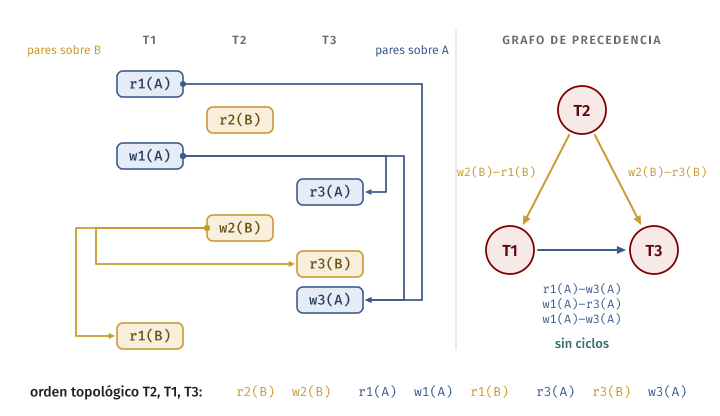
No hay ciclo. El único orden topológico es T2, T1, T3 (T2 es la única sin
aristas de entrada; quitada T2, la única es T1). graph.mjs hace lo mismo:
$ node graph.mjs "r1(A) r2(B) w1(A) r3(A) w2(B) r3(B) w3(A) r1(B)"
schedule: r1(A) r2(B) w1(A) r3(A) w2(B) r3(B) w3(A) r1(B)

conflictos:
  r1(A)–w3(A)  T1 → T3
  w1(A)–r3(A)  T1 → T3
  w1(A)–w3(A)  T1 → T3
  w2(B)–r3(B)  T2 → T3
  w2(B)–r1(B)  T2 → T1

aristas:
  T1 → T3  (r1(A)–w3(A), w1(A)–r3(A), w1(A)–w3(A))
  T2 → T1  (w2(B)–r1(B))
  T2 → T3  (w2(B)–r3(B))

conflict serializable; orden serial equivalente: T2, T1, T3
  r2(B) w2(B) r1(A) w1(A) r1(B) r3(A) r3(B) w3(A)
Una comprobación que conviene hacer siempre: en el schedule serial, cada
lectura tiene que ver lo mismo que en S. En S, r1(B) lee el B que escribió
T2 (w2(B) va antes) y en el serial también. r3(A) lee el A de T1 en los
dos, y r3(B) el B de T2 en los dos. r1(A) y r2(B) leen valores
iniciales en los dos. Y la última escritura de A es de T3 en ambos.
Fíjense en que T1 fue la primera en empezar y en el orden serial va segunda.
Otro ejemplo, más pequeño, del mismo fenómeno: en r1(B) r2(A) w2(A) r1(A),
T1 empieza primero, pero lee el A que escribió T2; el único orden serial
equivalente es T2, T1.
El lost update tiene un ciclo
S' = r1(A) r2(A) w1(A) w2(A)Es el embalaje y el descuento sobre el precio del envío 501. r1(A)–w2(A) da
T1 → T2; r2(A)–w1(A) da T2 → T1. Hay un ciclo:
$ node graph.mjs "r1(A) r2(A) w1(A) w2(A)"
...
aristas:
  T1 → T2  (r1(A)–w2(A), w1(A)–w2(A))
  T2 → T1  (r2(A)–w1(A))

no es conflict serializable; ciclo: T1 → T2 → T1
El grafo explica la anomalía: T2 leyó A antes de que T1 lo escribiera (así que T2 “va antes” que T1), pero escribió después (así que “va después”). No hay un orden serial que respete las dos cosas, y el efecto visible es que la escritura de T1 se pierde.
El grafo no mira los valores
A y B son los precios de los envíos 501 y 502. T1 pasa 5 soles de A a B (como en la sección del modelo simple) y T2 pasa 2 soles de B a A:
r1(A) w1(A) r2(B) w2(B) r1(B) w1(B) r2(A) w2(A)Sigamos los valores con A = 50 y B = 45: T1 deja A = 45; T2 deja B = 43; T1 lee 43 y deja B = 48; T2 lee 45 y deja A = 47. Final: A = 47, B = 48. Los dos órdenes seriales dan lo mismo, porque las sumas y restas conmutan y cada lectura ve el último valor escrito. El resultado es correcto.
Pero el grafo tiene T1 → T2 por A (w1(A)–r2(A)) y T2 → T1 por B
(w2(B)–r1(B)): ciclo. No es conflict serializable. El libro (sec.
17.6) muestra un ejemplo del mismo tipo para insistir en que la
equivalencia por conflictos es una condición suficiente, no necesaria,
para que el resultado sea correcto. El DBMS no puede saber que las
operaciones conmutan; solo ve lecturas y escrituras, así que un control de
concurrencia basado en conflictos rechazaría este schedule igual.
Error común. Decidir si un schedule es serializable “probando con números”. Que con ciertos valores el resultado coincida con un orden serial no dice nada sobre la conflict serializability, que no depende de los valores. Y al revés: un schedule conflict serializable da un resultado serial con cualquier valor inicial y cualquier cálculo.
Por qué conflictos y no otra cosa
La equivalencia por conflictos tiene tres virtudes que explican por qué es la que usan los sistemas:
- Solo depende del orden de lecturas y escrituras, que es lo que el DBMS ve.
- Se decide en tiempo polinomial con el grafo.
- Se puede garantizar por construcción, sin mirar el schedule completo: two-phase locking (semana 14) produce solo schedules cuyo grafo es acíclico. El grafo es una herramienta para razonar, no algo que el DBMS construya mientras ejecuta.
View serializability
La equivalencia por conflictos rechaza algunos schedules que intuitivamente son correctos. El caso típico tiene escrituras ciegas (blind writes): escrituras de un ítem que la transacción no leyó antes.
S'' = r1(A) w2(A) w1(A) w3(A)r1(A)–w2(A) da T1 → T2 y w2(A)–w1(A) da T2 → T1: ciclo, no es conflict
serializable. Pero miren qué ve cada uno. T1 lee el valor inicial de A. Nadie
lee lo que escribieron T2 ni T1, porque T3 sobrescribe A al final. En el
schedule serial T1, T2, T3 pasa exactamente lo mismo: T1 lee el valor
inicial y la última escritura es de T3. El valor que escribió T2 no lo ve
nadie, ni en S” ni en el serial.
Definición. Dos schedules S y S’ de las mismas transacciones son equivalentes en vistas (view equivalent) si:
- Para cada ítem Q, si Ti lee el valor inicial de Q en S, también lo lee en S’.
- Para cada ítem Q, si Ti lee en S un valor de Q que escribió Tj, en S’ Ti lee el valor de Q escrito por la misma escritura de Tj.
- Para cada ítem Q, la transacción que hace la última escritura de Q en S es la misma en S’.
Un schedule es view serializable si es equivalente en vistas a algún schedule serial. Las condiciones 1 y 2 garantizan que cada transacción lee lo mismo, y por lo tanto calcula lo mismo; la 3, que el estado final es el mismo.
Todo schedule conflict serializable es view serializable, pero no al revés, como muestra S”. Y todo schedule view serializable que no es conflict serializable tiene escrituras ciegas (la de T2 en S”).
¿Por qué los sistemas no usan esta noción, que acepta más schedules? Porque
decidir si un schedule es view serializable es un problema NP-completo.
No se conoce un algoritmo que no sea, en esencia, probar los n! órdenes
seriales. Además, las escrituras ciegas son raras en la práctica: casi toda
sentencia UPDATE lee la fila antes de escribirla. Los sistemas reales se
quedan con conflictos.
En PostgreSQL. Ningún DBMS comercial construye grafos de precedencia ni prueba view serializability. Lo que hacen es más barato: impedir de antemano los patrones que podrían formar un ciclo (locks), o detectarlos de forma aproximada y abortar a alguien (el
SERIALIZABLEde PostgreSQL). La teoría de hoy sirve para decir qué schedules son correctos; las técnicas de la semana 14 son la forma de producir solo esos.
Recuperabilidad
Hasta aquí supusimos que todas las transacciones hacen commit. Con abortos aparece un problema que la serializabilidad no ve.
Schedules recuperables
La empleada A (T1) cambia el precio del envío 501 a 60. Antes de que haga commit, el empleado B (T2) lee ese precio para emitir la boleta, la imprime y hace commit. Después T1 aborta (el cliente se arrepintió del servicio extra):
w1(A) r2(A) c2 a1Para deshacer T1 hay que deshacer también lo que dependía de ella: T2 leyó un valor que, después del rollback, nunca existió. Pero T2 ya hizo commit y, por la durabilidad, ya no se puede deshacer. La boleta tiene un precio falso y no hay forma de corregirlo dentro del DBMS. Y sin embargo el schedule es serializable: su grafo tiene una sola arista, T1 → T2.
Definición. Tj lee de Ti (reads from) si Tj lee un ítem Q y la última escritura de Q antes de esa lectura es de Ti (y Ti no abortó antes de la lectura). Un schedule es recuperable (recoverable) si, para cada par Ti, Tj tal que Tj lee de Ti, el commit de Ti aparece antes que el commit de Tj.
w1(A) r2(A) c2 a1 no es recuperable: T2 lee de T1 y hace commit antes que
T1. Si T2 hubiera esperado, w1(A) r2(A) c1 c2 sí sería recuperable: cuando
T2 confirma, T1 ya confirmó y lo que T2 leyó es definitivo. Un DBMS debe
producir solo schedules recuperables; de lo contrario no puede
garantizar a la vez atomicidad y durabilidad.
Rollback en cascada
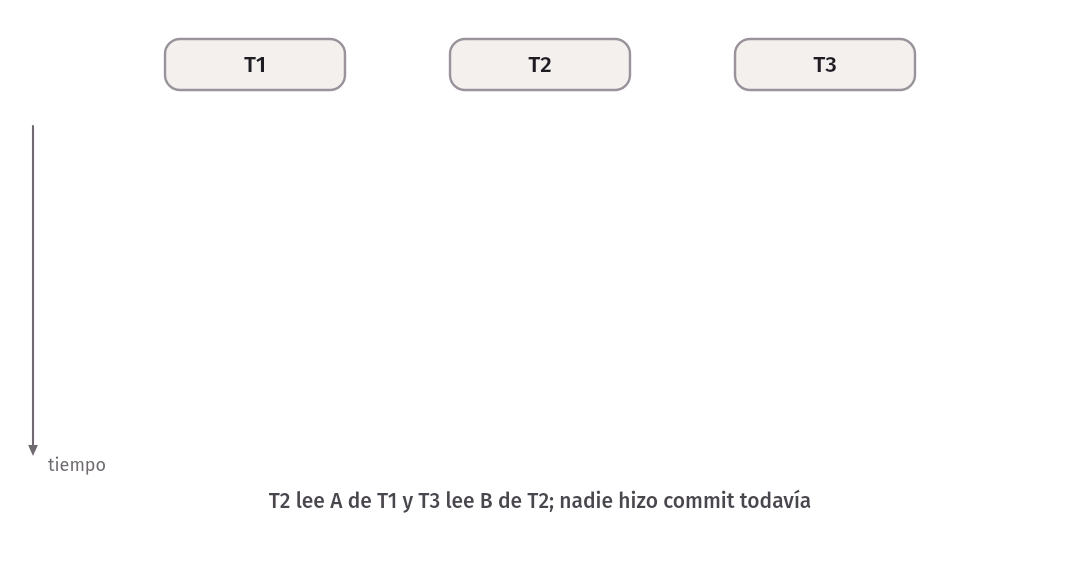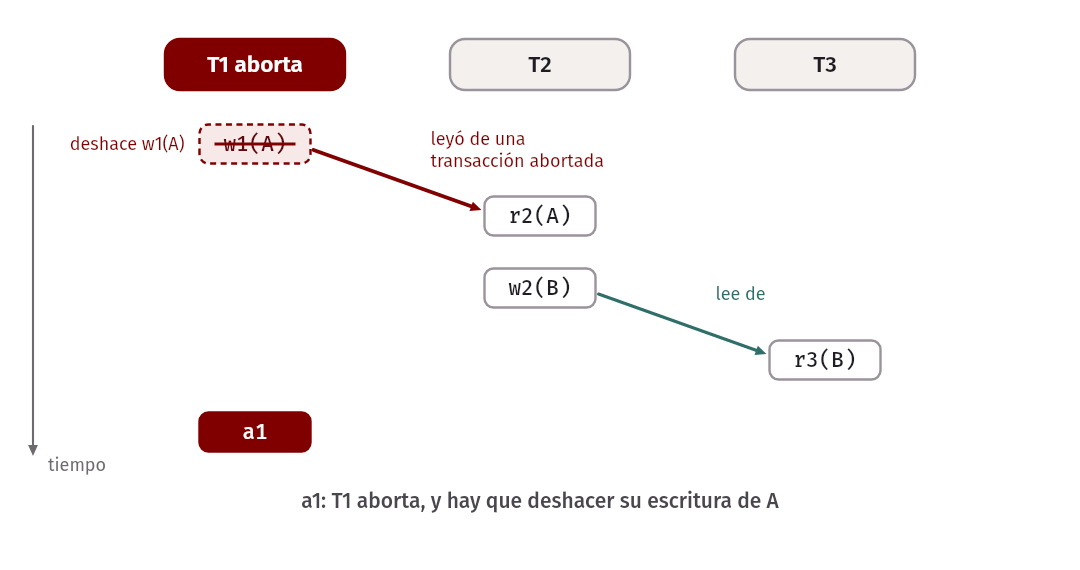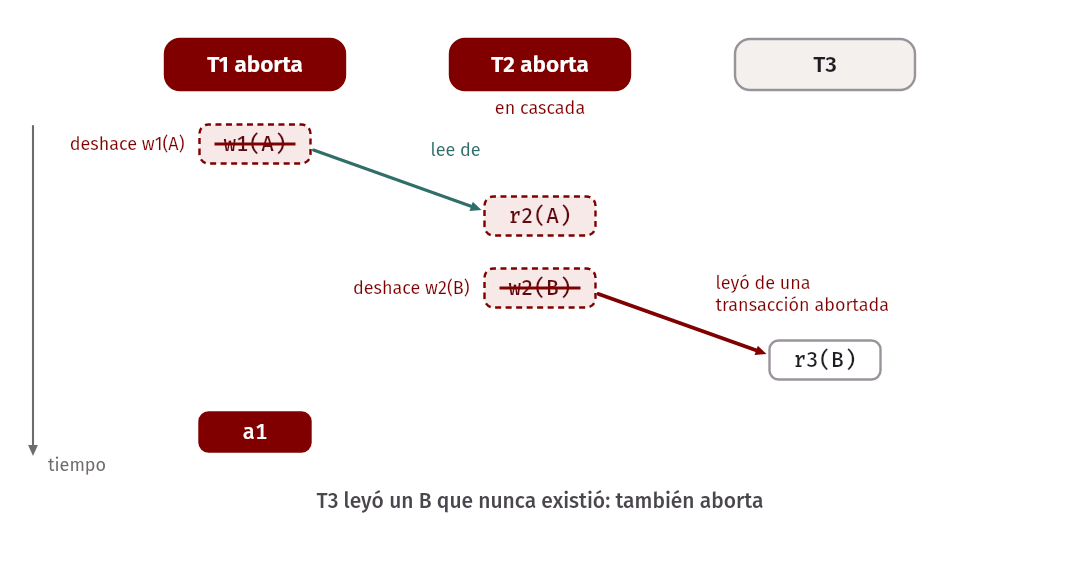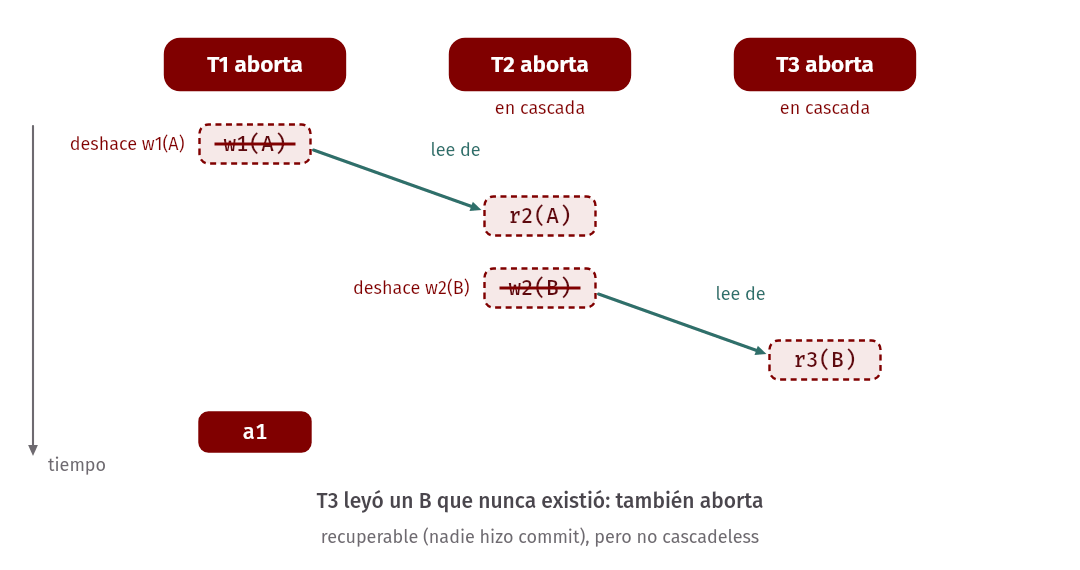
Que el schedule sea recuperable no quiere decir que sea barato. T1 escribe A, T2 lee A y escribe B, T3 lee B, y entonces T1 aborta:
w1(A) r2(A) w2(B) r3(B) a1Es recuperable (nadie hizo commit todavía), pero el rollback de T1 obliga a abortar T2, porque leyó de T1, y T3, porque leyó de T2. Un solo fallo deshace una cadena de transacciones. Es el rollback en cascada (cascading rollback), y puede deshacer mucho trabajo.
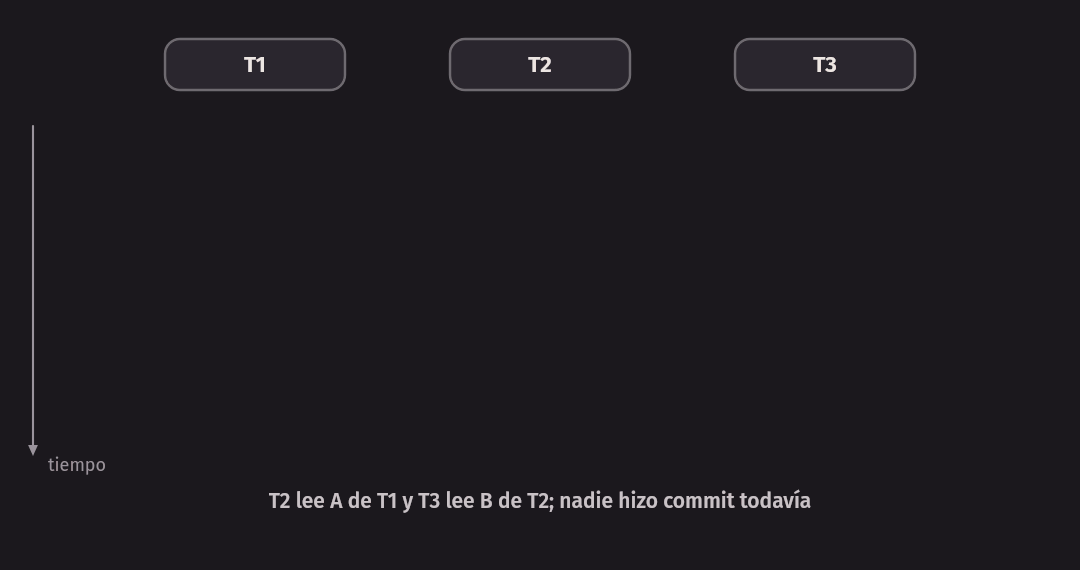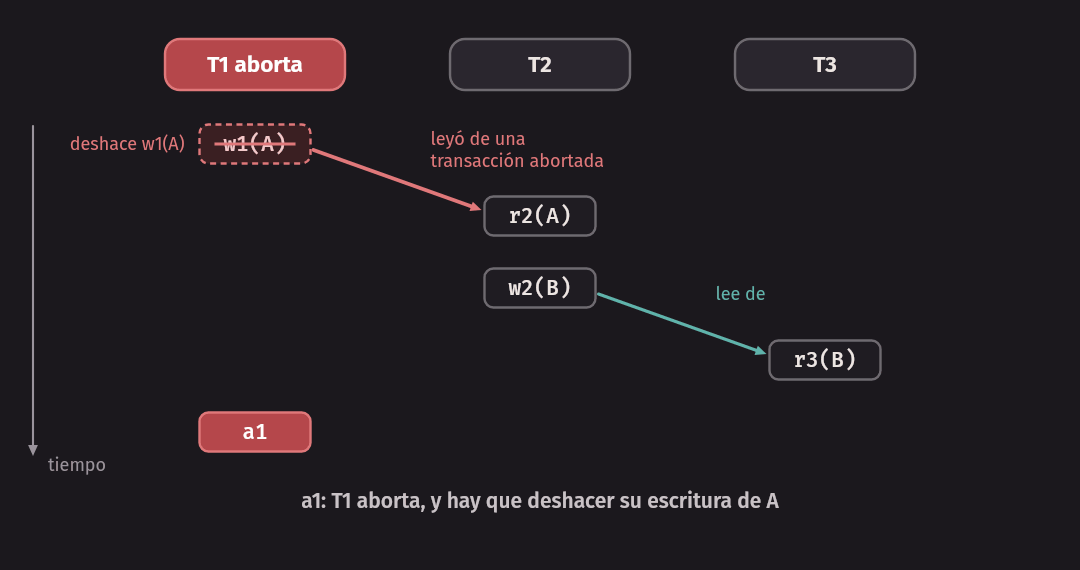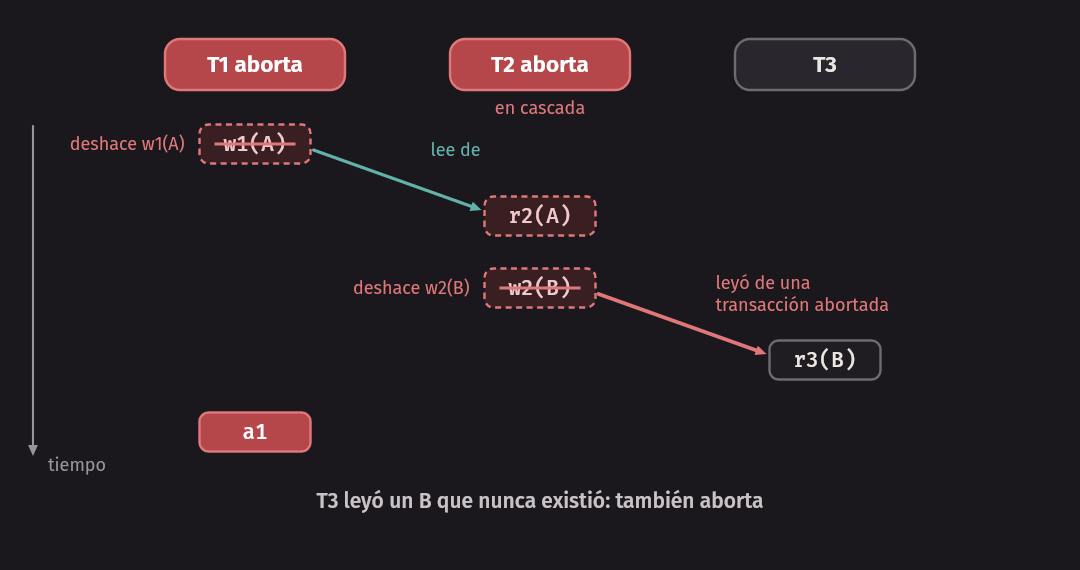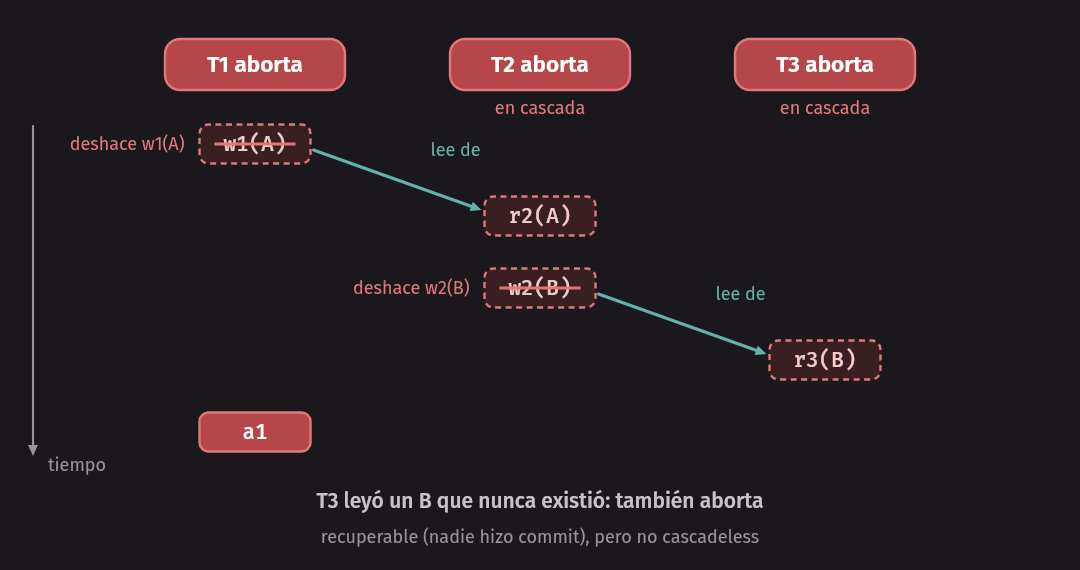
graph.mjs lo muestra junto con el grafo cuando el schedule tiene commits o
aborts:
$ node graph.mjs "w1(A) r2(A) c2 a1"
...
recuperable: no; T2 lee A de T1 (w1(A) … r2(A)) y hace commit antes que T1
cascadeless: no; T2 lee A de T1 (w1(A) … r2(A)) antes del commit de T1
$ node graph.mjs "w1(A) r2(A) a1"
...
recuperable: sí
cascadeless: no; T2 lee A de T1 (w1(A) … r2(A)) antes del commit de T1
Schedules cascadeless
Definición. Un schedule es cascadeless si, para cada par Ti, Tj tal que Tj lee de Ti, el commit de Ti aparece antes de la lectura de Tj. Dicho de otro modo: solo se leen datos que ya hicieron commit.
En un schedule cascadeless un abort nunca arrastra a otra transacción, porque nadie leyó lo que la transacción abortada escribió. Y todo schedule cascadeless es recuperable: si el commit de Ti va antes que la lectura de Tj, va antes que el commit de Tj, que viene después de la lectura.
w1(A) c1 r2(A) w2(B) c2 r3(B) c3     cascadeless (y recuperable)
w1(A) r2(A) c1 c2                    recuperable, no cascadeless
w1(A) r2(A) c2 a1                    ni recuperable ni cascadeless
Leer “solo datos que hicieron commit” es, justamente, no tener dirty reads, la primera anomalía de los niveles de aislamiento. Por eso la sección siguiente empieza por ahí.
Idea clave. Serializabilidad y recuperabilidad son ejes distintos. La primera mira el orden de las lecturas y escrituras; la segunda, dónde caen los commits respecto de esas lecturas. Un control de concurrencia tiene que dar las dos. La semana 14 muestra que strict 2PL las da juntas: serializable y cascadeless.
Niveles de aislamiento en SQL
Serializable no es gratis
Garantizar serializabilidad tiene un costo: más esperas (con locks) o más transacciones abortadas (con otras técnicas). Muchas aplicaciones aceptan algo menos a cambio de más concurrencia: un reporte del total de envíos del mes no necesita ver un estado exactamente serial, porque un envío de más o de menos no cambia la decisión que se toma con él. El estándar SQL permite elegir, transacción por transacción, un nivel de aislamiento (isolation level) más débil que serializable.
Hay una condición previa importante. Según el libro (sec. 17.8), ningún nivel permite dirty writes: una transacción no puede escribir un ítem que otra escribió y todavía no confirmó. Sin esa regla no se podría deshacer una transacción sin deshacer también la escritura de otra. Lo que cambia de un nivel a otro es qué se puede leer.
Las tres anomalías del estándar
El estándar SQL define sus niveles por las anomalías (el estándar las llama fenómenos) que permiten:
- Dirty read: T1 lee un valor que escribió T2 y T2 todavía no hizo commit. Si T2 aborta, T1 leyó algo que nunca existió. Es la boleta de la sección anterior.
- Non-repeatable read: T1 lee una fila; T2 la modifica y hace commit; T1 la vuelve a leer y ve otro valor. Ninguno de los dos valores es “sucio”, pero T1 no ve un estado único de la base.
- Phantom: T1 lee las filas que cumplen una condición (los envíos del viaje 5708); T2 inserta (o borra, o modifica) una fila que la cumple y hace commit; T1 repite la consulta y aparece una fila nueva. No cambió ninguna fila que T1 leyó: apareció una que no existía.
La diferencia entre las dos últimas es la que hay entre bloquear filas y
bloquear condiciones. Para evitar un non-repeatable read basta con proteger
las filas que T1 leyó. Para evitar un phantom eso no sirve: la fila de T2 no
existía cuando T1 leyó. El conflicto es sobre el predicado trip_id = 5708, no sobre una fila. El libro (sec. 17.10) lo llama el fenómeno phantom
y lo resuelve en el capítulo siguiente con locks sobre el índice o sobre el
predicado (semana 14).
Los cuatro niveles
Del más fuerte al más débil:
| Nivel | Dirty read | Non-repeatable read | Phantom |
|---|---|---|---|
SERIALIZABLE |
no | no | no |
REPEATABLE READ |
no | no | posible |
READ COMMITTED |
no | posible | posible |
READ UNCOMMITTED |
posible | posible | posible |
Dos cosas que se suelen leer mal en esta tabla:
- “Posible” quiere decir que el estándar permite que ocurra, no que
tenga que ocurrir. Un DBMS cumple con
READ UNCOMMITTEDaunque nunca muestre un dirty read. Cada motor elige qué hace en cada nivel, y elige distinto. SERIALIZABLEes más que “ninguna de las tres anomalías”. El estándar exige que la ejecución sea serializable; evitar las tres anomalías no alcanza, como muestran las dos que siguen.
Lost update y write skew
Berenson y sus coautores (1995) mostraron que las tres anomalías del estándar no cubren todo lo que puede salir mal. Dos que vamos a ver en PostgreSQL:
- Lost update: dos transacciones leen la misma fila, calculan un valor
nuevo cada una y lo escriben; la segunda escritura borra la primera. Es
r1(A) r2(A) w1(A) w2(A). No hay dirty read (nadie leyó algo sin commit) y T1 no lee dos veces, así que tampoco hay non-repeatable read; y sin embargo el resultado no es serial. - Write skew: dos transacciones leen lo mismo, verifican una regla con
lo que leyeron y escriben filas distintas. Cada una, sola, respeta la
regla; juntas la rompen. Ninguna escribe lo que escribió la otra, así que
ni siquiera hay un conflicto
w-w. En el grafo, el ciclo sale de dos aristasr-w:r1(B) w2(B)da T1 → T2 yr2(A) w1(A)da T2 → T1.
Lo que hace PostgreSQL
La tabla de PostgreSQL
La documentación de PostgreSQL (Transaction Isolation) tiene su propia versión de la tabla, con una columna más, serialization anomaly (cualquier resultado que no corresponde a ningún orden serial):
| Nivel | Dirty read | Non-repeatable read | Phantom | Serialization anomaly |
|---|---|---|---|---|
READ UNCOMMITTED |
permitido, pero no en PostgreSQL | posible | posible | posible |
READ COMMITTED |
no | posible | posible | posible |
REPEATABLE READ |
no | no | permitido, pero no en PostgreSQL | posible |
SERIALIZABLE |
no | no | no | no |
En resumen:
READ UNCOMMITTEDse comporta comoREAD COMMITTED. PostgreSQL nunca muestra datos sin commit.READ COMMITTED, el nivel por defecto, toma una foto nueva de los datos (un snapshot) al empezar cada sentencia. Cada sentencia ve lo que había hecho commit cuando ella empezó.REPEATABLE READtoma un solo snapshot para toda la transacción. Por eso no hay non-repeatable reads ni phantoms, aunque el estándar los permitiría. Es lo que la literatura llama snapshot isolation. Si dos transacciones escriben la misma fila, la segunda recibe un error.SERIALIZABLEes snapshot isolation más una detección de los patrones de lecturas y escrituras que pueden formar un ciclo: serializable snapshot isolation (SSI). Cuando detecta uno, aborta una transacción con un error.
Cómo se toma un snapshot y por qué leer de él no espera a nadie es el tema de MVCC en la semana 14. Hoy lo usamos como caja negra y miramos el comportamiento.
Cómo leer las salidas
Cada ejemplo que sigue es un escenario de
scenarios.mjs corrido con
psql2.mjs, que abre dos procesos psql
sobre chasqui_w13, A y B, y les manda las sentencias en el orden del
schedule. Lo que aparece debajo de cada sentencia es la salida de ese psql,
tal cual. Las únicas líneas que agrega el script son las que empiezan con
--: cuando una sentencia queda esperando un lock, el script lo marca con
-- B espera, sigue con la otra sesión, y la salida de la sentencia que
esperaba aparece después de -- B continúa, en el momento en que pudo
seguir. Antes de empezar, el script pone el precio del envío 501 en 50.00 y
el del 502 en 45.00, para que las cuentas sean fáciles, y al terminar los
devuelve a sus valores (50.25 y 45.26).
Lo mismo se hace a mano con dos terminales; es el laboratorio. Para correr un escenario:
$ PGDATABASE=chasqui_w13 node psql2.mjs lost-update rccon los niveles ru, rc, rr y sr. make test corre los mismos
escenarios con dos clientes de pg y comprueba lo que se observa en cada
nivel.
Sin dirty reads
B cambia el precio a 0 sin hacer commit. A, en READ UNCOMMITTED, lo lee:
B=# BEGIN;
BEGIN
B=# UPDATE shipment SET price = 0 WHERE shipment_id = 501;
UPDATE 1
A=# BEGIN ISOLATION LEVEL READ UNCOMMITTED;
BEGIN
A=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 50.00
(1 row)
B=# ROLLBACK;
ROLLBACK
A=# COMMIT;
COMMIT
A ve 50.00, el último valor confirmado. PostgreSQL acepta la sintaxis del
nivel (y SHOW transaction_isolation dice read uncommitted), pero se
comporta como READ COMMITTED. Fíjense también en que A no esperó: B
tiene la fila bloqueada para escribir, pero A lee la versión anterior. En un
sistema con locks y sin versiones, A tendría que esperar el commit o el
rollback de B. Es el primer adelanto de MVCC.
READ COMMITTED: una foto por sentencia
A lee dos veces el precio del envío 501 en la misma transacción; entre las dos lecturas, B lo sube 10 soles (en autocommit, así que hace commit en seguida):
A=# BEGIN ISOLATION LEVEL READ COMMITTED;
BEGIN
A=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 50.00
(1 row)
B=# UPDATE shipment SET price = price + 10 WHERE shipment_id = 501;
UPDATE 1
A=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 60.00
(1 row)
A=# COMMIT;
COMMIT
Un non-repeatable read: cada SELECT toma su propio snapshot, y el
segundo ya ve el commit de B. Lo mismo pasa con un predicado. A cuenta los
envíos del viaje 5708 y B inserta uno nuevo para ese viaje:
A=# BEGIN ISOLATION LEVEL READ COMMITTED;
BEGIN
A=# SELECT count(*), sum(weight_kg) FROM shipment WHERE trip_id = 5708;
 count |  sum
-------+--------
     6 | 166.60
(1 row)
B=# INSERT INTO shipment (shipment_id, sender_id, recipient_id, origin_agency_id, dest_agency_id, trip_id, weight_kg, price, status, created_at) VALUES (12001, 1078, 96, 25, 27, 5708, 10, 30, 'registered', now());
INSERT 0 1
A=# SELECT count(*), sum(weight_kg) FROM shipment WHERE trip_id = 5708;
 count |  sum
-------+--------
     7 | 176.60
(1 row)
A=# COMMIT;
COMMIT
Un phantom: la fila 12001 no existía cuando A contó por primera vez. Si A estaba decidiendo con la primera cuenta si le cabía otro paquete al vehículo, decidió con datos que ya no valen.
READ COMMITTED es el nivel por defecto de PostgreSQL (y de Oracle y SQL
Server), y para la mayoría de las sentencias sueltas es suficiente: cada
sentencia, sola, ve un estado consistente de la base. Los problemas aparecen
cuando una transacción decide con lo que leyó en una sentencia y actúa en
otra.
REPEATABLE READ: una foto para toda la transacción
Los mismos dos escenarios en REPEATABLE READ:
A=# BEGIN ISOLATION LEVEL REPEATABLE READ;
BEGIN
A=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 50.00
(1 row)
B=# UPDATE shipment SET price = price + 10 WHERE shipment_id = 501;
UPDATE 1
A=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 50.00
(1 row)
A=# COMMIT;
COMMIT
A=# BEGIN ISOLATION LEVEL REPEATABLE READ;
BEGIN
A=# SELECT count(*), sum(weight_kg) FROM shipment WHERE trip_id = 5708;
count | sum
-------+--------
6 | 166.60
(1 row)
B=# INSERT INTO shipment (shipment_id, sender_id, recipient_id, origin_agency_id, dest_agency_id, trip_id, weight_kg, price, status, created_at) VALUES (12001, 1078, 96, 25, 27, 5708, 10, 30, 'registered', now());
INSERT 0 1
A=# SELECT count(*), sum(weight_kg) FROM shipment WHERE trip_id = 5708;
count | sum
-------+--------
6 | 166.60
(1 row)
A=# COMMIT;
COMMITA ve siempre la misma foto: ni el cambio de precio ni el envío nuevo, aunque
los dos hicieron commit. El estándar habría permitido el phantom en este
nivel; PostgreSQL no lo produce, porque su REPEATABLE READ no protege
filas sino que lee todo de un snapshot fijo. Y B no esperó en ningún caso:
A solo lee.
En PostgreSQL. El snapshot de
REPEATABLE READno se toma en elBEGIN, sino en la primera consulta de la transacción. Si B cambia el precio entre elBEGINde A y su primerSELECT, A lo ve; si lo cambia después, ya no:A=# BEGIN ISOLATION LEVEL REPEATABLE READ; BEGIN B=# UPDATE shipment SET price = price + 10 WHERE shipment_id = 501; UPDATE 1 A=# SELECT price FROM shipment WHERE shipment_id = 501; price ------- 60.00 (1 row) B=# UPDATE shipment SET price = price + 10 WHERE shipment_id = 501; UPDATE 1 A=# SELECT price FROM shipment WHERE shipment_id = 501; price ------- 60.00 (1 row) A=# COMMIT; COMMITEs el escenario
snapshot-start. Para un orden serial da igual: A queda “después” del primerUPDATEy “antes” del segundo.
El lost update en tres niveles
Ahora el embalaje y el descuento, tal como los escribiría una aplicación:
cada empleado lee el precio con SELECT, calcula en el programa y escribe el
valor calculado con UPDATE. Primero en READ COMMITTED:
A=# BEGIN ISOLATION LEVEL READ COMMITTED;
BEGIN
B=# BEGIN ISOLATION LEVEL READ COMMITTED;
BEGIN
A=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 50.00
(1 row)
B=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 50.00
(1 row)
A=# UPDATE shipment SET price = 55 WHERE shipment_id = 501;
UPDATE 1
B=# UPDATE shipment SET price = 40 WHERE shipment_id = 501;
-- B espera
A=# COMMIT;
COMMIT
-- B continúa
UPDATE 1
B=# COMMIT;
COMMIT
A=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 40.00
(1 row)
El precio final es 40.00 y el embalaje se perdió. Escrito como schedule:
r1(A) r2(A) w1(A) c1 w2(A) c2Es el S' de antes, con el ciclo T1 → T2 → T1. Noten lo que hizo y lo que no
hizo PostgreSQL. B sí esperó: su UPDATE necesitaba el lock de la fila,
que tenía A, y solo siguió cuando A hizo commit. Eso evita el dirty write.
Pero el lock llegó tarde: B ya había leído 50 y su UPDATE escribe un valor
fijo calculado con ese 50. El DBMS no tiene cómo saber que el 40 salió de una
lectura vieja.
En REPEATABLE READ, el mismo schedule:
A=# BEGIN ISOLATION LEVEL REPEATABLE READ;
BEGIN
B=# BEGIN ISOLATION LEVEL REPEATABLE READ;
BEGIN
A=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 50.00
(1 row)
B=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 50.00
(1 row)
A=# UPDATE shipment SET price = 55 WHERE shipment_id = 501;
UPDATE 1
B=# UPDATE shipment SET price = 40 WHERE shipment_id = 501;
-- B espera
A=# COMMIT;
COMMIT
-- B continúa
ERROR:  could not serialize access due to concurrent update
B=# COMMIT;
ROLLBACK
A=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 55.00
(1 row)
B espera igual que antes, pero cuando A hace commit, PostgreSQL ve que la
fila que B quiere modificar fue cambiada por una transacción que confirmó
después del snapshot de B. B estaría escribiendo sobre algo que no
puede ver. En vez de dejarlo, aborta la transacción de B. Es la regla de
snapshot isolation: de dos transacciones concurrentes que escriben la misma
fila, solo una puede confirmar (en PostgreSQL, la primera que la actualiza).
El COMMIT de B responde ROLLBACK: la transacción ya estaba abortada y lo
único que se puede hacer con ella es terminarla.
Con \set VERBOSITY verbose (o node psql2.mjs lost-update rr --verbose)
psql muestra el código del error, el SQLSTATE:
-- B continúa
ERROR:  40001: could not serialize access due to concurrent update
LOCATION:  ExecUpdate, nodeModifyTable.c:2602
40001 es serialization_failure. Es el código que una aplicación tiene que
reconocer para reintentar. En SERIALIZABLE el resultado es el mismo, con
el mismo mensaje y en la misma sentencia (el UPDATE, no el COMMIT):
B=# UPDATE shipment SET price = 40 WHERE shipment_id = 501;
-- B espera
A=# COMMIT;
COMMIT
-- B continúa
ERROR:  could not serialize access due to concurrent update
B=# COMMIT;
ROLLBACK
Idea clave. Los niveles fuertes de PostgreSQL no bloquean más: abortan. Leer nunca espera, en ningún nivel. Lo que cambia al subir de nivel es cuántas transacciones terminan en
40001. Por eso una aplicación que usaREPEATABLE READoSERIALIZABLEtiene que estar preparada para reintentar.
Dos arreglos sin cambiar de nivel
El lost update de READ COMMITTED tiene dos arreglos que no abortan a nadie.
Una sola sentencia. Si el cálculo se hace en el UPDATE, no hay lectura
vieja:
A=# BEGIN ISOLATION LEVEL READ COMMITTED;
BEGIN
B=# BEGIN ISOLATION LEVEL READ COMMITTED;
BEGIN
A=# UPDATE shipment SET price = price + 5 WHERE shipment_id = 501;
UPDATE 1
B=# UPDATE shipment SET price = price - 10 WHERE shipment_id = 501;
-- B espera
A=# COMMIT;
COMMIT
-- B continúa
UPDATE 1
B=# COMMIT;
COMMIT
A=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 45.00
(1 row)
45.00 = 50 + 5 − 10. B espera el lock de la fila y, cuando A confirma,
PostgreSQL vuelve a leer la versión confirmada de la fila (55.00),
comprueba otra vez la condición del WHERE sobre ella y aplica price - 10
a ese valor. Es una regla especial de READ COMMITTED para UPDATE,
DELETE y SELECT ... FOR UPDATE.
Error común. Pensar que
READ COMMITTEDsiempre pierde actualizaciones.UPDATE shipment SET price = price + 5 WHERE shipment_id = 501es seguro en ese nivel. El lost update aparece cuando la aplicación lee con unSELECT, calcula en JavaScript y escribe un valor fijo conUPDATE. Y al revés: el mismoUPDATEde una sola sentencia enREPEATABLE READno relee, sino que falla con40001(lo compruebaanomalies.test.mjs), porque releer rompería el snapshot fijo.
Leer con lock. Cuando el cálculo no cabe en una sentencia (hay que
consultar una tarifa, llamar a una función de la aplicación), la lectura
puede tomar el lock de la fila con SELECT ... FOR UPDATE:
A=# BEGIN ISOLATION LEVEL READ COMMITTED;
BEGIN
B=# BEGIN ISOLATION LEVEL READ COMMITTED;
BEGIN
A=# SELECT price FROM shipment WHERE shipment_id = 501 FOR UPDATE;
 price
-------
 50.00
(1 row)
B=# SELECT price FROM shipment WHERE shipment_id = 501 FOR UPDATE;
-- B espera
A=# UPDATE shipment SET price = 55 WHERE shipment_id = 501;
UPDATE 1
A=# COMMIT;
COMMIT
-- B continúa
 price
-------
 55.00
(1 row)
B=# UPDATE shipment SET price = 45 WHERE shipment_id = 501;
UPDATE 1
B=# COMMIT;
COMMIT
A=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 45.00
(1 row)
Ahora B espera en la lectura, y cuando sigue lee 55.00, el valor que dejó
A. El schedule pasó a ser r1(A) w1(A) c1 r2(A) w2(A) c2: serial. Es un lock
explícito pedido por la aplicación; la semana 14 explica qué es y por qué
puede producir deadlocks.
Resumen de los arreglos del lost update:
| Arreglo | ¿Bloquea? | ¿Aborta? |
|---|---|---|
SELECT ... FOR UPDATE en READ COMMITTED |
sí, la lectura de B espera | no |
REPEATABLE READ o SERIALIZABLE |
sí, el UPDATE de B espera |
sí, B recibe 40001 |
Una sola sentencia UPDATE ... SET price = price + 5 en READ COMMITTED |
sí, el UPDATE de B espera |
no |
Write skew
Una regla de la promoción de Chasqui: si un cliente tiene dos envíos, el 501
(50 soles) y el 502 (45 soles), puede recibir descuentos mientras entre los
dos pague al menos 90 soles. La empleada A y el empleado B atienden al
cliente en ventanillas distintas. Cada uno revisa la suma, ve 95 y le
descuenta 5 soles a un envío distinto. Cada uno, solo, respeta la regla. En
REPEATABLE READ:
A=# BEGIN ISOLATION LEVEL REPEATABLE READ;
BEGIN
B=# BEGIN ISOLATION LEVEL REPEATABLE READ;
BEGIN
A=# SELECT sum(price) FROM shipment WHERE shipment_id IN (501, 502);
  sum
-------
 95.00
(1 row)
B=# SELECT sum(price) FROM shipment WHERE shipment_id IN (501, 502);
  sum
-------
 95.00
(1 row)
A=# UPDATE shipment SET price = price - 5 WHERE shipment_id = 501;
UPDATE 1
B=# UPDATE shipment SET price = price - 5 WHERE shipment_id = 502;
UPDATE 1
A=# COMMIT;
COMMIT
B=# COMMIT;
COMMIT
A=# SELECT sum(price) FROM shipment WHERE shipment_id IN (501, 502);
  sum
-------
 85.00
(1 row)
La suma quedó en 85: la regla se rompió y nadie recibió un error. Nadie
esperó tampoco: A y B escriben filas distintas, así que no hay ningún
conflicto w-w que snapshot isolation pueda detectar. Con A = envío 501 y B
= envío 502, el schedule es
r1(A) r1(B) r2(A) r2(B) w1(A) w2(B) c1 c2y el grafo tiene T1 → T2 (r1(B)–w2(B)) y T2 → T1 (r2(A)–w1(A)): ciclo. En
ningún orden serial pasa esto: la segunda transacción vería la suma en 90 y
no descontaría.
En SERIALIZABLE, el mismo schedule:
A=# BEGIN ISOLATION LEVEL SERIALIZABLE;
BEGIN
B=# BEGIN ISOLATION LEVEL SERIALIZABLE;
BEGIN
A=# SELECT sum(price) FROM shipment WHERE shipment_id IN (501, 502);
  sum
-------
 95.00
(1 row)
B=# SELECT sum(price) FROM shipment WHERE shipment_id IN (501, 502);
  sum
-------
 95.00
(1 row)
A=# UPDATE shipment SET price = price - 5 WHERE shipment_id = 501;
UPDATE 1
B=# UPDATE shipment SET price = price - 5 WHERE shipment_id = 502;
UPDATE 1
A=# COMMIT;
COMMIT
B=# COMMIT;
ERROR:  could not serialize access due to read/write dependencies among transactions
DETAIL:  Reason code: Canceled on identification as a pivot, during commit attempt.
HINT:  The transaction might succeed if retried.
A=# SELECT sum(price) FROM shipment WHERE shipment_id IN (501, 502);
  sum
-------
 90.00
(1 row)
Esta vez el error llega en el COMMIT de B, y el mensaje es otro: read/write
dependencies among transactions. PostgreSQL registró qué leyó cada
transacción y encontró dos dependencias lectura-escritura que, juntas, pueden
cerrar un ciclo. La suma queda en 90, el resultado de “A, después nada”: B
tendrá que reintentar, y al reintentar verá 90 y no descontará. El código es
otra vez 40001, y el HINT lo dice: la transacción podría tener éxito si se
reintenta.
Error común. Creer que
REPEATABLE READen PostgreSQL permite phantoms (no los permite: el snapshot es fijo) y, por eso, que equivale aSERIALIZABLE. Tampoco: permite write skew. La semana 14 vuelve sobre esto con un ejemplo más peligroso, la capacidad de un vehículo.
SERIALIZABLE, en breve
Lo que hace PostgreSQL en SERIALIZABLE (Cahill, Röhm y Fekete, 2008; en
PostgreSQL desde la versión 9.1) se resume en tres ideas, que la semana 14
desarrolla:
- Todo lo de
REPEATABLE READ: un snapshot fijo y “la primera que actualiza gana” para las escrituras de la misma fila. - Además, cada lectura deja una marca que no bloquea a nadie (en
pg_locksaparece comoSIReadLock). Con esas marcas el motor detecta las dependenciasr-wentre transacciones concurrentes: T1 leyó algo que T2 escribió después. - Si una transacción tiene una dependencia
r-wde entrada y otra de salida (es un “pivot”), puede haber un ciclo, y el motor aborta a alguien con40001. La detección es conservadora: a veces aborta transacciones que en realidad no formaban un ciclo. Nunca deja pasar uno.
El resultado es lo que pide el estándar: todo schedule que llega a commit es serializable. El precio es que la aplicación tiene que reintentar.
Cómo se implementa el aislamiento
El libro (sec. 17.9) presenta tres familias de técnicas. Las vemos completas en la semana 14; hoy, una idea de cada una para ubicar lo que vimos:
- Locks. Antes de leer o escribir un ítem, la transacción pide permiso:
un lock compartido para leer, uno exclusivo para escribir. Con two-phase
locking (pedir todos los locks antes de soltar cualquiera) los schedules
son conflict serializable. Lo vimos en acción: el
UPDATEde B esperó el lock de la fila. Los locks pueden ser de fila, de página o de tabla, y para los phantoms hacen falta locks sobre predicados o sobre rangos del índice. - Timestamps. Cada transacción recibe un timestamp al empezar y el sistema obliga a que el resultado sea el del orden serial por timestamps: si una operación llega “tarde” (Ti quiere leer algo que ya escribió una transacción más nueva), Ti aborta y se reinicia.
- Varias versiones y snapshot isolation. Cada escritura crea una versión
nueva del ítem; cada transacción lee de un snapshot, la versión que había
confirmada cuando empezó. Los lectores nunca esperan a los escritores. Es
lo que hace PostgreSQL, y explica todo lo que vimos: A leyó 50.00 mientras
B tenía la fila bloqueada,
REPEATABLE READsiempre lee la misma foto, y hace falta abortar cuando dos escriben la misma fila.
| Lo que vimos | Técnica |
|---|---|
| A lee mientras B tiene la fila bloqueada, sin esperar | varias versiones |
El UPDATE de B espera al de A |
lock de fila |
40001 due to concurrent update |
snapshot isolation (la primera que actualiza gana) |
40001 read/write dependencies |
SSI sobre snapshot isolation |
Transacciones en SQL
BEGIN, COMMIT, ROLLBACK y autocommit
El libro (sec. 17.10) dice que en SQL estándar una transacción empieza sola
con la primera sentencia y termina con COMMIT o ROLLBACK. En la práctica,
casi todos los clientes trabajan en autocommit: cada sentencia suelta es
su propia transacción y hace commit al terminar. Así trabajan psql y pg
(lo vimos en las semanas 4 y 5). Para agrupar sentencias hay que abrir la
transacción explícitamente:
| Sentencia | Qué hace |
|---|---|
BEGIN o START TRANSACTION |
Abre una transacción (START TRANSACTION es la forma del estándar) |
COMMIT |
La confirma |
ROLLBACK |
La deshace |
BEGIN ISOLATION LEVEL SERIALIZABLE |
La abre con un nivel distinto del por defecto |
SET TRANSACTION ISOLATION LEVEL ... |
Cambia el nivel de la transacción actual; tiene que ser lo primero que se ejecuta en ella |
SAVEPOINT nombre / ROLLBACK TO SAVEPOINT nombre |
Marca un punto y deshace hasta él, sin terminar la transacción |
El nivel se elige por transacción. El nivel por defecto lo da el parámetro
default_transaction_isolation; en PostgreSQL es READ COMMITTED. Las
consultas de esta sección están en
examples.sql:
SHOW transaction_isolation;
 transaction_isolation
-----------------------
 read committed
(1 row)
SET TRANSACTION llega tarde si la transacción ya hizo una consulta,
porque el snapshot ya se tomó:
BEGIN;
BEGIN
SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 50.25
(1 row)

SET TRANSACTION ISOLATION LEVEL SERIALIZABLE;
psql:examples.sql:15: ERROR:  SET TRANSACTION ISOLATION LEVEL must be called before any query
ROLLBACK;
ROLLBACK
Una transacción con un error queda abortada
En PostgreSQL, si una sentencia falla dentro de una transacción, toda la
transacción pasa al estado failed. El precio no puede ser negativo (hay un
CHECK):
BEGIN;
BEGIN
UPDATE shipment SET price = price + 5 WHERE shipment_id = 501;
UPDATE 1
UPDATE shipment SET price = -1 WHERE shipment_id = 502;
psql:examples.sql:22: ERROR:  new row for relation "shipment" violates check constraint "shipment_price_check"
DETAIL:  Failing row contains (502, 364, 966, 1, 15, 4945, 0.90, 1695.00, -1.00, delivered, 2026-05-29 22:27:00-05, 2026-05-30 22:15:00-05).
SELECT price FROM shipment WHERE shipment_id = 501;
psql:examples.sql:23: ERROR:  current transaction is aborted, commands ignored until end of transaction block
COMMIT;
ROLLBACK
SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 50.25
(1 row)
Después del error, el motor ignora todo hasta el final de la transacción
(SQLSTATE 25P02), y el COMMIT responde ROLLBACK: el primer UPDATE,
que no tenía nada de malo, también se deshizo. Es la atomicidad: la
transacción entera o nada. Otros motores deshacen solo la sentencia que
falló y dejan seguir; PostgreSQL no.
Savepoints
Para deshacer solo una parte, un savepoint marca un punto dentro de la transacción:
BEGIN;
BEGIN
UPDATE shipment SET price = price + 5 WHERE shipment_id = 501;
UPDATE 1
SAVEPOINT before_discount;
SAVEPOINT
UPDATE shipment SET price = -1 WHERE shipment_id = 502;
psql:examples.sql:31: ERROR:  new row for relation "shipment" violates check constraint "shipment_price_check"
DETAIL:  Failing row contains (502, 364, 966, 1, 15, 4945, 0.90, 1695.00, -1.00, delivered, 2026-05-29 22:27:00-05, 2026-05-30 22:15:00-05).
ROLLBACK TO SAVEPOINT before_discount;
ROLLBACK
SELECT shipment_id, price FROM shipment WHERE shipment_id IN (501, 502) ORDER BY shipment_id;
 shipment_id | price
-------------+-------
         501 | 55.25
         502 | 45.26
(2 rows)

ROLLBACK;
ROLLBACK
ROLLBACK TO SAVEPOINT deshizo el UPDATE que falló y sacó a la
transacción del estado de error; el primer UPDATE (55.25) sigue ahí. El
ROLLBACK final deshace todo, como siempre. Un savepoint no es una
transacción anidada: no hace commit de nada; solo da un punto al que volver.
En PostgreSQL.
psqltiene la variableON_ERROR_ROLLBACK: con\set ON_ERROR_ROLLBACK interactive, pone un savepoint implícito antes de cada sentencia, de modo que un error de tipeo no aborte toda la transacción que están probando a mano. Es una ayuda depsql, no del servidor: desde Node.js no existe.
Reintentar
Qué errores se reintentan
Una transacción que recibe 40001 no tiene nada de malo: perdió una carrera.
Si se ejecuta otra vez desde el principio, con un snapshot nuevo, lo más
probable es que pase. La documentación de PostgreSQL
(Serialization Failure Handling)
recomienda reintentar dos códigos:
| SQLSTATE | Nombre | Cuándo aparece |
|---|---|---|
40001 |
serialization_failure |
REPEATABLE READ o SERIALIZABLE: escritura concurrente de la misma fila, o dependencias que pueden formar un ciclo |
40P01 |
deadlock_detected |
En cualquier nivel: dos transacciones se esperan mutuamente y el motor aborta una (semana 14) |
Un error de otro tipo (una restricción violada, un error de sintaxis) no se arregla reintentando: se informa.
Lo que se reintenta es la transacción completa, no la sentencia que
falló. La transacción leyó datos de un snapshot que ya no vale y decidió con
ellos; repetir solo el UPDATE escribiría otra vez un valor calculado con la
lectura vieja. Así se ve en psql: B recibe 40001, hace ROLLBACK, abre
otra transacción, vuelve a leer y vuelve a calcular (escenario retry):
A=# BEGIN ISOLATION LEVEL SERIALIZABLE;
BEGIN
B=# BEGIN ISOLATION LEVEL SERIALIZABLE;
BEGIN
A=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 50.00
(1 row)
B=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 50.00
(1 row)
A=# UPDATE shipment SET price = 55 WHERE shipment_id = 501;
UPDATE 1
B=# UPDATE shipment SET price = 40 WHERE shipment_id = 501;
-- B espera
A=# COMMIT;
COMMIT
-- B continúa
ERROR:  could not serialize access due to concurrent update
B=# ROLLBACK;
ROLLBACK
B=# BEGIN ISOLATION LEVEL SERIALIZABLE;
BEGIN
B=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 55.00
(1 row)
B=# UPDATE shipment SET price = 45 WHERE shipment_id = 501;
UPDATE 1
B=# COMMIT;
COMMIT
A=# SELECT price FROM shipment WHERE shipment_id = 501;
 price
-------
 45.00
(1 row)
El resultado, 45.00, es el del orden serial “A, después B”.
Reintentos en Node.js
En una aplicación el reintento lo hace el programa, no la persona. La forma general es un ciclo alrededor de la transacción entera, sobre un solo cliente tomado del pool. Lo esencial cabe en pocas líneas:
for (let attempt = 1; ; attempt++) {
  try {
    await client.query('BEGIN ISOLATION LEVEL SERIALIZABLE');
    // ... todas las lecturas, los cálculos y las escrituras ...
    await client.query('COMMIT');
    break;
  } catch (err) {
    await client.query('ROLLBACK');
    if (!['40001', '40P01'].includes(err.code) || attempt === MAX_ATTEMPTS) throw err;
    // esperar unos milisegundos al azar antes de volver a intentar
  }
}
Cuatro detalles que no son opcionales:
- Todo va dentro del ciclo, también las lecturas. Si el
SELECTdel precio quedara fuera, el reintento escribiría con el valor viejo. - El
ROLLBACKva ante cualquier error, se reintente o no. Si no, el cliente vuelve al pool con una transacción abortada y la próxima consulta de cualquier otra parte del programa recibe current transaction is aborted. - Un límite de intentos y una espera al azar. Si dos procesos chocan, y los dos reintentan en el mismo instante, vuelven a chocar; un poco de azar los separa.
- Lo que no se puede deshacer (el SMS, la llamada a la API de pagos) va después del ciclo, cuando ya hubo commit. Si va adentro, se repite en cada intento.
Y lo de la semana 5 sigue valiendo: la transacción vive en una conexión.
pool.query('BEGIN') seguido de más pool.query no abre ninguna
transacción para lo que sigue, porque cada llamada puede ir por una conexión
distinta (wrong-transaction.mjs).
El cliente se toma con pool.connect(), se usa para todo y se devuelve con
client.release() en un finally, como en
deliver.mjs. En el laboratorio ustedes
empaquetan este ciclo en una función withTransaction(pool, fn) y la ponen
a prueba con dos procesos que suben el mismo precio a la vez.
En PostgreSQL. Reintentar no es una mala señal sino el diseño. Con
SERIALIZABLEy poca contención, los reintentos son raros; con mucha contención sobre las mismas filas (todos actualizando el mismo contador), pueden ser muchos, y entonces conviene rediseñar: una sola sentenciaUPDATE ... SET x = x + 1, oSELECT ... FOR UPDATEenREAD COMMITTED.
En el laboratorio
El laboratorio reproduce a mano, con dos terminales, los escenarios de este
capítulo: abren dos psql sobre la misma base, les ponen prompts distintos
(\set PROMPT1 'A=%# ' y \set PROMPT1 'B=%# ') y ejecutan el
non-repeatable read, la ausencia de dirty reads, el lost update y sus tres
arreglos, y el lost update en SERIALIZABLE. Antes de cada paso escriban el
schedule que esperan (r1(A) r2(A) ...) y dibujen su grafo de precedencia.
Al final escriben en Node.js una transacción con reintentos y la corren desde
dos procesos a la vez, primero en SERIALIZABLE y después en READ COMMITTED, para medir cuántas actualizaciones se pierden.
Si trabajan sobre chasqui en vez de chasqui_w13, el precio del envío 501
es 50.25 y no 50.00: las cuentas cambian en los centavos. Y devuelvan los
precios a su valor original al terminar.
El código de la semana y make test
Dentro del contenedor, en code/week-13, make crea la base de datos
chasqui_w13 y make test la vuelve a crear y corre las pruebas:
$ make test
chasqui-load chasqui_w13
Base de datos chasqui_w13 lista.
PGDATABASE=chasqui_w13 node --test --test-concurrency=1 --test-reporter=spec
✔ ru: no hay dirty reads
✔ ru: non-repeatable read sí
...
✔ rr: lost update no, 40001
✔ rr: write skew sí
...
✔ sr: write skew no, 40001 en el COMMIT
✔ rc: UPDATE ... SET price = price + 5 espera y relee: no se pierde nada
✔ rr: el mismo UPDATE de una sola sentencia recibe 40001
...
✔ el ejemplo resuelto: T2 → T1, T1 → T3, T2 → T3; orden T2, T1, T3
...
✔ la boleta: T2 lee el precio que escribió T1 y hace commit antes de que T1 aborte
...
ℹ tests 45
ℹ pass 45
ℹ fail 0| Archivo | Qué hace |
|---|---|
precedence.mjs |
Lee un schedule ("r1(A) w2(A) c1"), lista los conflictos, arma el grafo de precedencia, devuelve un orden serial equivalente o un ciclo, y decide si el schedule es recuperable y cascadeless |
graph.mjs |
Muestra todo eso para un schedule dado en la línea de comandos |
scenarios.mjs |
Los schedules de dos sesiones del capítulo, parametrizados por nivel de aislamiento |
sessions.mjs |
Ejecuta un escenario paso a paso con dos clientes de pg o con dos procesos psql, y detecta qué sentencia espera un lock |
psql2.mjs |
Muestra la salida de los dos psql de un escenario, como en este capítulo |
examples.sql |
Transacciones en una sola sesión: nivel por defecto, SET TRANSACTION, transacción abortada, savepoints |
precedence.test.mjs |
Los schedules del capítulo: grafos, órdenes, ciclos, recuperabilidad |
anomalies.test.mjs |
Cada anomalía en cada nivel, contra PostgreSQL: qué leyó cada sesión, quién esperó y quién recibió 40001 |
examples.test.mjs |
Lo que muestra examples.sql |
Un detalle de sessions.mjs que vale la pena leer: para saber si una
sentencia terminó o está esperando un lock, no adivina con tiempos. Una
tercera conexión le pregunta a PostgreSQL pg_blocking_pids(pid), la lista
de procesos que bloquean a esa sesión. Si no está vacía, la sesión espera, y
el escenario sigue con la otra. Las pruebas de anomalies.test.mjs cambian
los mismos envíos, así que los archivos se corren uno después del otro
(--test-concurrency=1), y cada escenario devuelve los precios a su valor
original al terminar.
precedence.mjs trabaja con el grafo de precedencia, que se construye a
partir de un schedule ya ejecutado. El proyecto P5
(projects/p5-transacciones) pide
otra cosa: un lock manager que decide, operación por operación, quién puede
seguir y quién espera.
Resumen
- Una transacción es una unidad de ejecución que se aplica entera o no se aplica y se comporta como si estuviera sola. ACID: la atomicidad y la durabilidad las da el sistema de recuperación con el log (semana 15); el aislamiento, el control de concurrencia (semana 14); la consistencia, el programador, con ayuda de las restricciones.
- En el modelo simple, una transacción solo hace
read(X)ywrite(X); lo que calcula no lo ve el DBMS. Estados: active, partially committed, failed, aborted, committed. El almacenamiento estable es una idealización que se aproxima con copias independientes. - Las transacciones se ejecutan a la vez por throughput y tiempo de espera. Un schedule es el orden en que se intercalan sus operaciones; uno serial no intercala. Un schedule es serializable si equivale a algún serial, no necesariamente al del orden de llegada.
- Dos operaciones están en conflicto si son de transacciones distintas, sobre el mismo ítem, y al menos una escribe. Un schedule es conflict serializable si y solo si su grafo de precedencia no tiene ciclos; un orden topológico da el serial equivalente. El grafo no mira los valores: es una condición suficiente, no necesaria.
- View serializability acepta además schedules con escrituras ciegas, pero decidirla es NP-completo; los sistemas usan conflictos.
- Un schedule es recuperable si quien lee de Ti hace commit después de Ti, y cascadeless si solo lee datos ya confirmados. Cascadeless implica recuperable y evita el rollback en cascada.
- El estándar SQL define
READ UNCOMMITTED,READ COMMITTED,REPEATABLE READySERIALIZABLEpor las anomalías que permiten: dirty read, non-repeatable read y phantom. Ningún nivel permite dirty writes. Lost update y write skew no están en la lista del estándar. - En PostgreSQL:
READ UNCOMMITTED=READ COMMITTED(snapshot por sentencia);REPEATABLE READes snapshot isolation (sin non-repeatable reads ni phantoms, sin lost update, con write skew);SERIALIZABLEes SSI. Los niveles fuertes no bloquean más: abortan con40001. - El lost update de
READ COMMITTEDse evita con una sola sentenciaUPDATE ... SET x = x + 5o conSELECT ... FOR UPDATE. El write skew solo se evita conSERIALIZABLE(o con locks explícitos, semana 14). - Una transacción que recibe
40001o40P01se reintenta completa, conROLLBACKprimero, en un solo cliente del pool, con un límite de intentos y espera al azar. Lo que no se puede deshacer va después del commit.
Ejercicios
- Para cada propiedad ACID, den un ejemplo con Chasqui de lo que saldría mal si el DBMS no la garantizara, distinto de los del capítulo. Digan qué componente del DBMS la garantiza.
- Dibujen el grafo de precedencia de
r1(A) w1(A) r2(A) r3(B) w2(B) w3(A) r1(B)y decidan si es conflict serializable. Si lo es, den todos los órdenes seriales equivalentes; si no, el ciclo. Comprueben connode graph.mjs. - Transformen
r1(A) r2(B) w1(A) w2(B) r1(B) w1(B)en un schedule serial con intercambios de operaciones vecinas que no estén en conflicto, escribiendo cada paso. ¿A qué orden serial llegan? ¿Podían llegar al otro? - Escriban un schedule de tres transacciones con dos ítems cuyo grafo tenga el ciclo T1 → T2 → T3 → T1 y ninguna otra arista. ¿Cuál es el schedule más corto que lo logra?
- Den un schedule de dos transacciones que no sea conflict serializable pero que, con cualquier valor inicial, deje la base igual que algún orden serial. ¿Qué tienen de especial las operaciones de las transacciones? ¿Es view serializable?
- Clasifiquen cada schedule como (a) no recuperable, (b) recuperable pero no
cascadeless o (c) cascadeless, y justifiquen con la relación “lee de”:
w1(A) w2(B) r1(B) c1 r2(A) c2;w1(A) r2(A) w2(A) c1 c2;w1(A) w1(B) r2(A) a1 c2;r1(A) w2(A) c2 w1(B) c1. Comprueben congraph.mjs. - En
chasqui_w13, con dospsql, repitan el escenario del phantom con unDELETEen vez de unINSERT: A cuenta los envíos del viaje 5708, B borra en autocommit el envío 12001 (insértenlo antes, con elINSERTdel capítulo), y A vuelve a contar. Háganlo enREAD COMMITTEDy enREPEATABLE READ. ¿Es un non-repeatable read o un phantom? ¿Y si B, en vez de borrarlo, le cambia eltrip_id? - Agreguen a
scenarios.mjsun escenariolost-update-for-update-rr: el lost update conSELECT ... FOR UPDATEenREPEATABLE READ. Antes de correrlo, predigan si B espera, si recibe40001y en qué sentencia. Córranlo conpsql2.mjsy escriban una prueba enanomalies.test.mjs. - La función
deliverShipmentde la semana 5 (deliver.mjs) calcula el número del evento nuevo conSELECT max(seq) + 1. ¿Qué pasa si dos llamadas para el mismo envío en tránsito corren a la vez enREAD COMMITTED? Escriban el schedule y razonen qué hace elUPDATE ... WHERE status = 'in_transit'de la segunda. Comprueben su respuesta con dospsql. - Un reporte calcula, en una transacción, el total facturado por agencia
(
sum(price)agrupado pororigin_agency_id) y después el total general (sum(price)). EnREAD COMMITTED, ¿puede el total general no coincidir con la suma de los totales por agencia? Construyan un schedule con dos sesiones que lo muestre. ¿Qué nivel usarían para el reporte, y por qué no hace faltaSERIALIZABLE? - Agreguen a
precedence.mjsuna funciónviewSerializable(schedule)que pruebe todos los órdenes seriales y devuelva uno equivalente en vistas onull, usando las tres condiciones de la definición. Pruébenla conr1(A) w2(A) w1(A) w3(A). ¿Cuántos órdenes prueba con 8 transacciones? - (Más difícil.) Una transacción en
SERIALIZABLEde PostgreSQL solo lee (no escribe nada). ¿Puede recibir40001? Busquen en la documentación de PostgreSQL la opciónREAD ONLY DEFERRABLEy expliquen qué garantiza y qué cuesta.