
Apuntes · Capítulo 12Almacenamiento, índices y consultas
Optimización de consultas: equivalencias, estadísticas y elección de planes
Optimización de consultas: equivalencias, estadísticas y elección de planes
La semana pasada vimos cómo se ejecuta cada operador. Una selección puede ser
un sequential scan o una búsqueda en un índice. Un join puede ser nested
loop, block nested loop, index nested loop, merge join o hash join. Cada
algoritmo tiene una fórmula de costo en transferencias de bloques y seeks.
Con los datos de referencia de chasqui_big, el mismo customer ⋈ shipment
costaba entre 6,6·10⁹ transferencias con nested loop y 35 000 con un hash
join que entra en memoria. Pero en la semana 11 el plan lo elegíamos
nosotros: decíamos “con block nested loop, customer afuera” y contábamos.
Una consulta SQL no dice nada de eso. Dice qué filas quiere, no cómo encontrarlas. Entre la consulta y su ejecución hay un componente del DBMS que toma esas decisiones: el optimizador de consultas (query optimizer). Para una consulta de tres o cuatro tablas hay miles de planes que devuelven exactamente el mismo resultado. Sus costos pueden ser muy distintos, y elegir mal es la diferencia entre una consulta que tarda milisegundos y una que no termina. Este capítulo es sobre cómo el optimizador encuentra un plan bueno sin probarlos todos.
El trabajo tiene tres partes: generar alternativas equivalentes con las
reglas del álgebra relacional, estimar el costo de cada una (y para eso,
el tamaño de cada resultado intermedio: la estimación de cardinalidades,
cardinality estimation, la parte más frágil de todas) y elegir sin
revisar todas, con programación dinámica y heurísticas. La Sesión A cubre las dos primeras partes; la Sesión B, la tercera y cómo
se ve todo esto en PostgreSQL: pg_stats, ANALYZE, CREATE STATISTICS y
la lectura de EXPLAIN ANALYZE, que es lo que van a usar cada vez que una
consulta de verdad esté lenta.
Esta semana se publica también P4, en el que construyen operadores con
iteradores en quipu y comparan sus planes con los de EXPLAIN
(projects/p4-consultas). Lo que
viene aquí les sirve para leer esos planes; P4 no les pide escribir un
optimizador.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “Del SQL al plan” y “Qué significa que dos expresiones sean equivalentes”. Sesión B: “El costo de un plan” y “La forma de un plan”, de “Leer EXPLAIN”.
- En clase. Sesión A: “Reglas de equivalencia”, “Estadísticas del catálogo”, “Estimar el tamaño de una selección”, “Estimar el tamaño de un join” y “Cuando falla la independencia”. Sesión B: “Elegir el plan”, “Leer EXPLAIN” y “Arreglar un plan”.
- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 16.1–16.4; las 16.5 y 16.6, opcionales. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-12, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
Todos los ejemplos corren sobre chasqui_w12, la base de la semana: make
la crea con los datos de ejemplo (12 000 envíos, 1800 clientes, 29
agencias) y hace VACUUM (ANALYZE). Los planes se muestran con
max_parallel_workers_per_gather = 0, como en la semana 9, para que no
aparezcan nodos de ejecución en paralelo; los .sql lo fijan al comenzar.
En los planes con EXPLAIN ANALYZE omitimos casi siempre las líneas de
Buffers y los tiempos de planificación y de ejecución, salvo cuando se
comentan; los archivos de code/week-12 muestran la salida completa.
Del SQL al plan
Lo que hace el optimizador
Recordemos el recorrido de una consulta de la semana 11 (sec. 15.1). El parser revisa la sintaxis y traduce la consulta a una expresión de álgebra relacional. El optimizador convierte esa expresión en un plan de evaluación (evaluation plan): un árbol de operadores en el que cada nodo dice qué algoritmo usar y cómo pasan las tuplas de un nodo al siguiente (pipeline o materialización). El motor de ejecución corre el plan.
Silberschatz (sec. 16.1) separa el trabajo del optimizador en tres pasos: generar expresiones lógicamente equivalentes, anotarlas con algoritmos concretos para obtener planes, y estimar el costo de cada plan para quedarse con el más barato. En la práctica se hacen juntos (generar todas las expresiones primero sería demasiado), pero la separación sirve para pensar.
Idea clave. Para el optimizador, “costo” es siempre una estimación. No ejecuta los planes para compararlos: los costea con fórmulas como las de la semana 11 y con estadísticas de las tablas. Si las estadísticas o las fórmulas se equivocan, el optimizador elige con confianza un plan malo. Casi todos los problemas de rendimiento que van a diagnosticar con
EXPLAIN ANALYZEson errores de estimación, no de algoritmo.
Un ejemplo: la misma consulta, dos árboles
La consulta que nos acompaña toda la Sesión A: los envíos de clientes de Arequipa con destino en una agencia de la región Cusco.
SELECT c.first_name, c.last_name, s.shipment_id, a.name
FROM customer c, shipment s, agency a
WHERE c.customer_id = s.sender_id
  AND s.dest_agency_id = a.agency_id
  AND c.city = 'Arequipa'
  AND a.region = 'Cusco';
La traducción directa del SQL al álgebra relacional es un producto cartesiano de las tres tablas, una selección con todas las condiciones y una proyección:
Π first_name, last_name, shipment_id, name (
  σ customer_id = sender_id ∧ dest_agency_id = agency_id ∧ city = 'Arequipa' ∧ region = 'Cusco' (
    customer × shipment × agency))
Si un DBMS evaluara esa expresión tal cual, el producto tendría
1800 × 12 000 × 29 = 626 400 000 tuplas. PostgreSQL puede mostrarnos el plan
de ese producto (equivalences.sql,
consulta cross_product; solo EXPLAIN, sin ejecutarlo):
                                 QUERY PLAN
-----------------------------------------------------------------------------
 Nested Loop  (cost=0.00..7830988.86 rows=626400000 width=156)
   ->  Nested Loop  (cost=0.00..690.86 rows=52200 width=89)
         ->  Seq Scan on customer c  (cost=0.00..37.00 rows=1800 width=51)
         ->  Materialize  (cost=0.00..1.44 rows=29 width=38)
               ->  Seq Scan on agency a  (cost=0.00..1.29 rows=29 width=38)
   ->  Materialize  (cost=0.00..328.00 rows=12000 width=67)
         ->  Seq Scan on shipment s  (cost=0.00..268.00 rows=12000 width=67)
(7 rows)
Y este es el plan que elige para la consulta con las condiciones
(consulta where_form):
                                  QUERY PLAN
-------------------------------------------------------------------------------
 Hash Join  (cost=43.99..345.34 rows=20 width=43)
   Hash Cond: (s.dest_agency_id = a.agency_id)
   ->  Hash Join  (cost=42.61..342.19 rows=593 width=29)
         Hash Cond: (s.sender_id = c.customer_id)
         ->  Seq Scan on shipment s  (cost=0.00..268.00 rows=12000 width=12)
         ->  Hash  (cost=41.50..41.50 rows=89 width=25)
               ->  Seq Scan on customer c  (cost=0.00..41.50 rows=89 width=25)
                     Filter: (city = 'Arequipa'::text)
   ->  Hash  (cost=1.36..1.36 rows=1 width=22)
         ->  Seq Scan on agency a  (cost=0.00..1.36 rows=1 width=22)
               Filter: (region = 'Cusco'::text)
(11 rows)
Todavía no sabemos leer todos los números (lo hacemos en la Sesión B), pero
se ve lo esencial. No hay producto cartesiano: hay dos hash joins. El filtro
por ciudad está pegado al scan de customer y el filtro por región al scan
de agency, es decir, se aplican antes de los joins. El costo total
estimado es 345, contra 7 830 989 del producto: más de veinte mil veces
menos. Para pasar del primer árbol al segundo, el optimizador aplicó las
reglas de equivalencia de la sección siguiente.
Que la consulta esté escrita con comas en el FROM o con JOIN ... ON no
cambia nada. La consulta join_form es la misma escrita con JOIN, y su
plan es idéntico línea por línea (las pruebas lo comprueban). El optimizador
no trabaja sobre el texto: trabaja sobre la expresión.
Reglas de equivalencia
Qué significa que dos expresiones sean equivalentes
Dos expresiones de álgebra relacional son equivalentes si, en toda instancia válida de la base de datos, generan el mismo conjunto de tuplas. No basta con que den lo mismo con los datos de hoy: una regla de equivalencia tiene que valer para cualquier contenido de las tablas que cumpla el esquema. El orden de las tuplas no importa (una relación no tiene orden) y, como el libro, tratamos los atributos por nombre, así que el orden de las columnas tampoco.
SQL trabaja con multiconjuntos (bags), no con conjuntos: una consulta puede devolver filas repetidas. Las reglas que vamos a ver valen también para multiconjuntos, con la versión de multiconjunto de cada operador (la proyección que no elimina duplicados, la unión que suma las repeticiones).
Una regla de equivalencia dice que dos formas de expresión son equivalentes, y permite reemplazar una por la otra en cualquier parte de un árbol. El optimizador no las usa como pruebas: las usa como movimientos para generar alternativas.
Las reglas
Notación: θ, θ₁, θ₂ son predicados; L, L₁, L₂ son listas de atributos; E, E₁, E₂, E₃ son expresiones. La lista sigue la sec. 16.2.1 del libro.
 1. Cascada de selecciones        σ θ₁ ∧ θ₂ (E) = σ θ₁ (σ θ₂ (E))
 2. Conmutatividad de σ           σ θ₁ (σ θ₂ (E)) = σ θ₂ (σ θ₁ (E))
 3. Cascada de proyecciones       Π L₁ (Π L₂ (... Π Lₙ (E) ...)) = Π L₁ (E)       si L₁ ⊆ L₂ ⊆ ... ⊆ Lₙ
 4. Selección sobre producto      σ θ (E₁ × E₂) = E₁ ⋈θ E₂
                                  σ θ₁ (E₁ ⋈θ₂ E₂) = E₁ ⋈θ₁ ∧ θ₂ E₂
 5. Conmutatividad del join       E₁ ⋈θ E₂ = E₂ ⋈θ E₁
 6. Asociatividad del join        (E₁ ⋈ E₂) ⋈ E₃ = E₁ ⋈ (E₂ ⋈ E₃)
                                  (E₁ ⋈θ₁ E₂) ⋈θ₂ ∧ θ₃ E₃ = E₁ ⋈θ₁ ∧ θ₃ (E₂ ⋈θ₂ E₃)   si θ₂ usa solo E₂ y E₃
 7. Bajar σ por un join           σ θ₀ (E₁ ⋈θ E₂) = (σ θ₀ (E₁)) ⋈θ E₂               si θ₀ usa solo E₁
                                  σ θ₁ ∧ θ₂ (E₁ ⋈θ E₂) = (σ θ₁ (E₁)) ⋈θ (σ θ₂ (E₂))  si θ₁ usa solo E₁ y θ₂ solo E₂
 8. Bajar Π por un join           Π L₁ ∪ L₂ (E₁ ⋈θ E₂) = (Π L₁ (E₁)) ⋈θ (Π L₂ (E₂))  si θ usa solo L₁ ∪ L₂
 9. ∪ y ∩ son conmutativas        E₁ ∪ E₂ = E₂ ∪ E₁
10. ∪ y ∩ son asociativas         (E₁ ∪ E₂) ∪ E₃ = E₁ ∪ (E₂ ∪ E₃)
11. σ se distribuye sobre ∪ ∩ −   σ θ (E₁ ∪ E₂) = σ θ (E₁) ∪ σ θ (E₂)                 (igual con ∩ y −)
                                  σ θ (E₁ − E₂) = σ θ (E₁) − E₂                       (igual con ∩; no con ∪)
12. Π se distribuye sobre ∪       Π L (E₁ ∪ E₂) = (Π L (E₁)) ∪ (Π L (E₂))
Algunos comentarios:
- La 1 y la 2 permiten partir el
WHEREen pedazos y moverlos por separado. La 4 es la definición del theta join, y convierte un producto con condición en un join. - La 5 vale con atributos por nombre; si importa el orden de las columnas, hace falta una proyección que las reordene.
- En la 6 con theta joins, la condición θ₂ tiene que usar solo atributos de E₂ y E₃: si mencionara uno de E₁, no se podría evaluar dentro de E₂ ⋈ E₃, que todavía no tiene a E₁.
- La 7 es la más rentable de todas: achica las entradas del join antes de hacerlo.
- En la 8, si θ usa otros atributos (L₃ de E₁, L₄ de E₂), hay que conservarlos hasta el join y proyectar después: Π L₁ ∪ L₂ ((Π L₁ ∪ L₃ (E₁)) ⋈θ (Π L₂ ∪ L₄ (E₂))).
- La diferencia no es conmutativa ni asociativa. La segunda línea de la 11 dice que, con − y con ∩, basta filtrar el lado izquierdo: lo que se resta (o se intersecta) de más no estaba en el resultado. Con ∪ no vale: σ θ (E₁) ∪ E₂ dejaría pasar las tuplas de E₂ que no cumplen θ.
- La 12 no vale para la diferencia: dos tuplas distintas de E₁ y E₂ pueden coincidir después de proyectar, y entonces Π(E₁ − E₂) y Π(E₁) − Π(E₂) dan cosas distintas.
Hay reglas parecidas para la agregación (una selección sobre los atributos de agrupamiento puede bajar por debajo del γ) y para los outer joins, que tienen sus propias trampas.
La trampa del outer join
Un left outer join E₁ ⟕θ E₂ conserva todas las tuplas de E₁, y rellena
con nulos las que no tienen pareja en E₂. Bajar una selección sobre los
atributos de E₁ (el lado que se conserva) es válido, como en la regla 7.
Bajar una selección sobre los atributos de E₂ no lo es.
En Chasqui: agencias y sus rutas de más de 800 km. Con la condición en el
ON (consulta outer_on de equivalences.sql), la condición solo decide
qué rutas se pegan a cada agencia; las agencias sin rutas largas siguen
apareciendo, con NULL en las columnas de route:
SELECT count(*) AS rows_on
FROM agency a
  LEFT JOIN route r ON r.origin_agency_id = a.agency_id AND r.distance_km > 800;
rows_on
---------
33
(1 row)Con la condición en el WHERE (consulta outer_where), se aplica
después del outer join. En las filas rellenadas, r.distance_km es
NULL, la comparación NULL > 800 es unknown y el WHERE solo deja
pasar las filas en que la condición es true:
 rows_where
------------
         10
(1 row)
Las dos consultas no son equivalentes. La primera es
agency ⟕ (σ distance_km > 800 (route)); la segunda es
σ distance_km > 800 (agency ⟕ route), que no deja ninguna fila rellenada
con nulos y es, por lo tanto, igual a un inner join. PostgreSQL lo sabe:
cuando la condición del WHERE sobre el lado de los nulos es estricta
(da unknown si su entrada es NULL), reemplaza el outer join por un
inner join (consulta outer_where_plan):
                              QUERY PLAN
----------------------------------------------------------------------
 Hash Join  (cost=1.65..4.18 rows=10 width=22)
   Hash Cond: (r.origin_agency_id = a.agency_id)
   ->  Seq Scan on route r  (cost=0.00..2.50 rows=10 width=8)
         Filter: (distance_km > 800)
   ->  Hash  (cost=1.29..1.29 rows=29 width=22)
         ->  Seq Scan on agency a  (cost=0.00..1.29 rows=29 width=22)
(6 rows)
El nodo dice Hash Join, no Hash Left Join. Una vez que es un inner
join, ya puede bajar la selección al scan de route con la regla 7.
Error común. Pensar que “mover la condición del
WHEREalON” es una optimización inofensiva. En un inner join lo es (regla 4). En un outer join cambia el resultado. La semántica deNULLde la semana 3 es la que decide: elWHEREdescarta lo que es unknown.
Aplicar las reglas al ejemplo
Volvamos a la consulta de Arequipa y Cusco. Escribimos c, s y a por
las tablas, y llamamos θ_cs a customer_id = sender_id, θ_sa a
dest_agency_id = agency_id.
Paso 0. La traducción directa:
Π ... ( σ θ_cs ∧ θ_sa ∧ city = 'Arequipa' ∧ region = 'Cusco' ( (c × s) × a ) )Paso 1. Cascada de selecciones (regla 1) para separar las cuatro condiciones, y conmutatividad (regla 2) para ordenarlas como convenga:
Π ... ( σ θ_sa ( σ region = 'Cusco' ( σ θ_cs ( σ city = 'Arequipa' ( (c × s) × a ) ) ) ) )Paso 2. city = 'Arequipa' usa solo atributos de c, y
region = 'Cusco' solo de a. Las bajamos hasta sus tablas (regla 7, que
vale igual para el producto, que es un join con θ = true):
Π ... ( σ θ_sa ( σ θ_cs ( (σ city = 'Arequipa' (c) × s) × σ region = 'Cusco' (a) ) ) )Paso 3. θ_cs usa atributos de c y de s: baja hasta el producto
interno y lo convierte en join (regla 4). θ_sa queda sobre el producto
externo y también lo convierte en join:
Π ... ( (σ city = 'Arequipa' (c) ⋈θ_cs s) ⋈θ_sa σ region = 'Cusco' (a) )Paso 4. Bajar proyecciones (regla 8): de customer solo hacen falta
customer_id, first_name y last_name; de shipment, shipment_id,
sender_id y dest_agency_id; de agency, agency_id y name. En el
plan de PostgreSQL se ve en la columna width: el scan de shipment del
producto devolvía filas de 67 bytes; el del plan bueno, de 12.
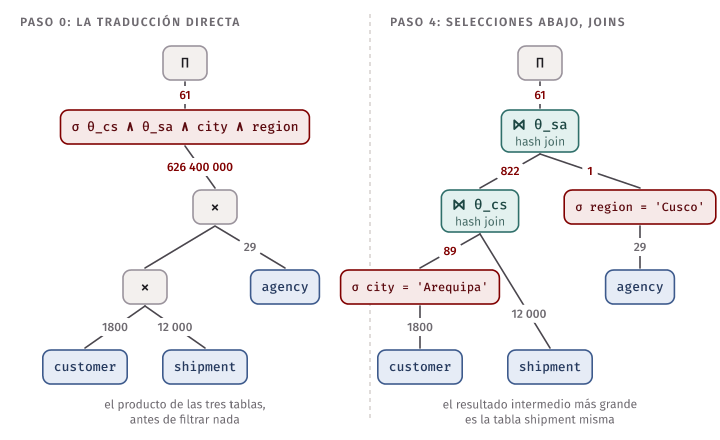
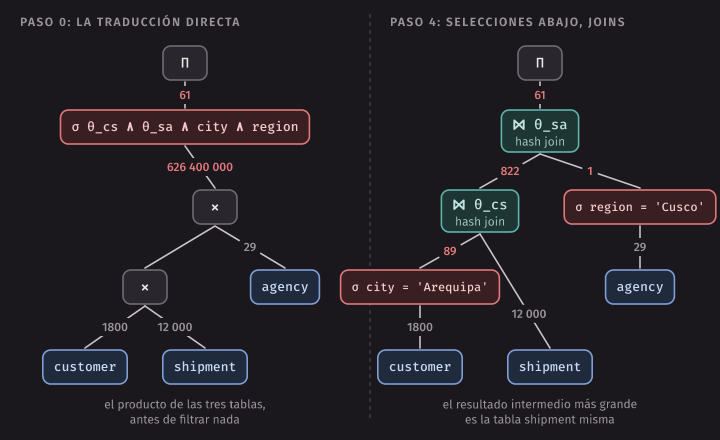
El árbol del paso 4 es el plan de PostgreSQL. La diferencia de tamaño de los
resultados intermedios es enorme (consultas sizes_late y sizes_early):
| Árbol | Resultado intermedio | Tuplas |
|---|---|---|
| Paso 0 | c × s × a |
626 400 000 |
| Filtros al final, con joins | c ⋈ s ⋈ a |
12 000 |
| Paso 4 | σ city = 'Arequipa' (c) |
89 |
| Paso 4 | σ region = 'Cusco' (a) |
1 |
| Paso 4 | σ(c) ⋈ s |
822 |
| Paso 4 | resultado final | 61 |
La fila del medio es instructiva: aun sin producto cartesiano, hacer los
joins primero y filtrar al final obliga a armar las 12 000 tuplas de
c ⋈ s ⋈ a para quedarse con 61.
Enumerar expresiones equivalentes
Un optimizador podría generar todas las expresiones equivalentes a una consulta: tomar la expresión, aplicar cada regla en cada nodo donde se pueda, agregar lo que salga y repetir hasta que no aparezca nada nuevo. El libro describe este procedimiento (sec. 16.2) y dos ideas que lo hacen viable en espacio: cuando una regla cambia un nodo, el resto del árbol se comparte entre la expresión vieja y la nueva en vez de copiarse, y las subexpresiones iguales se detectan y se guardan una sola vez. Los optimizadores del estilo Volcano/Cascades (SQL Server, por ejemplo) trabajan así, con una estructura llamada memo.
Aun así, el número de expresiones crece muy rápido. Solo con las reglas 5 y 6 (conmutar y asociar joins), el número de árboles de join distintos para n relaciones es
(2(n − 1))! / (n − 1)!| n | Órdenes de join |
|---|---|
| 3 | 12 |
| 5 | 1680 |
| 7 | 665 280 |
| 10 | ≈ 1,76·10¹⁰ |
Para n = 3, por ejemplo: 4! / 2! = 12. Son los 3 pares que se pueden unir primero, por 2 formas de ordenar ese par, por 2 formas de ordenarlo con la tercera relación. Para 10 tablas, que no es una consulta rara en un sistema real, son diecisiete mil millones de árboles. Ningún optimizador los prueba todos. La Sesión B explica cómo se encuentra el mejor sin enumerarlos.
Idea clave. Las reglas de equivalencia generan el espacio de búsqueda; el costo decide dentro de él. Algunas reglas casi siempre convienen (bajar selecciones, cambiar productos por joins) y se aplican sin costear: son heurísticas. Otras, como el orden de los joins, dependen de los datos: ahí hace falta estimar.
Estadísticas del catálogo
Para costear un plan hace falta saber cuántas tuplas entran a cada
operador. En la semana 11 los números los dábamos nosotros (“customer
tiene 200 000 tuplas en 2000 páginas”). El optimizador los saca del
catálogo, el diccionario de datos de la semana 9, donde el DBMS guarda
estadísticas de cada tabla y de cada columna.
Lo que guarda el catálogo
Silberschatz (sec. 16.3.1) usa esta notación para una relación r:
- n_r: número de tuplas de r.
- b_r: número de bloques que ocupa r.
- l_r: tamaño de una tupla de r, en bytes.
- f_r: factor de bloqueo (blocking factor), cuántas tuplas caben en un bloque. Si las tuplas de r están juntas en su archivo, b_r = ⌈n_r / f_r⌉.
- V(A, r): número de valores distintos del atributo A en r. Es igual al tamaño de Π_A(r). Si A es una clave de r, V(A, r) = n_r. Con una lista de atributos, V(A₁…Aₙ, r) es el número de combinaciones distintas.
En PostgreSQL, n_r y b_r están en pg_class como reltuples y relpages
(stats.sql, consulta sizes):
 relname  |  n_r  | b_r
----------+-------+-----
 agency   |    29 |   1
 customer |  1800 |  19
 shipment | 12000 | 148
 trip     |  5914 |  44
 vehicle  |    24 |   1
(5 rows)
shipment tiene 12 000 tuplas en 148 páginas: f_r ≈ 81 tuplas por
página, como vimos en la semana 9.
Estos números no se mantienen al día en cada INSERT: costaría
demasiado. Los recalcula ANALYZE (y también VACUUM y CREATE INDEX),
que el usuario corre a mano o que el autovacuum corre solo cuando cambió
suficiente parte de la tabla. Entre una corrida y otra, las estadísticas
pueden estar viejas; volvemos a eso más adelante.
Histogramas
V(A, r) dice cuántos valores hay, pero no cómo se reparten. La suposición
más simple es que se reparten de manera uniforme, y casi nunca es
cierta. En Chasqui, el 92,6 % de los envíos está delivered; el 0,55 %,
in_transit. Con V(status, shipment) = 4 y uniformidad, cada estado tendría
el 25 %.
Un histograma (histogram) describe la distribución con más detalle: divide el rango de valores del atributo en buckets y cuenta cuántas tuplas caen en cada uno. Hay dos formas:
- Equi-width: todos los buckets cubren un rango del mismo ancho; se guarda cuántas tuplas tiene cada uno.
- Equi-depth: todos los buckets tienen la misma cantidad de tuplas; se guardan los límites de cada uno. Donde hay muchos valores, los buckets son angostos; donde hay pocos, anchos.
Un ejemplo con weight_kg, el peso de los envíos, que va de 0,10 kg a
148,30 kg. Un histograma equi-width de 10 buckets de 15 kg (consulta
weight_equiwidth):
 bucket | from_kg | to_kg | count
--------+---------+-------+-------
      1 |       0 |    15 |  6411
      2 |      15 |    30 |  2253
      3 |      30 |    45 |   367
      4 |      45 |    60 |   515
      5 |      60 |    75 |   650
      6 |      75 |    90 |   585
      7 |      90 |   105 |   534
      8 |     105 |   120 |   372
      9 |     120 |   135 |   230
     10 |     135 |   150 |    83
(10 rows)
Más de la mitad de los envíos pesa menos de 15 kg. Un histograma equi-width
gasta 9 de sus 10 buckets en la parte menos poblada, y dentro del primero
no distingue un paquete de 1 kg de uno de 14. Un histograma equi-depth de
100 buckets tiene 120 tuplas por bucket: en la zona de 0 a 15 kg hay más de
50 buckets, cada uno de unos pocos cientos de gramos. Los primeros límites
del histograma que guarda PostgreSQL para weight_kg (consulta
weight_bounds):
                         first_bounds
---------------------------------------------------------------
 {0.20,0.60,1.20,1.40,2.00,2.20,2.50,3.40,3.70,3.90,4.20,4.40}
(1 row)
Por eso los sistemas reales usan equi-depth. Un histograma ocupa poco (unos cientos de valores por columna) y se guarda en el catálogo.
En PostgreSQL. Las estadísticas por columna están en la tabla del sistema
pg_statistic, y se leen cómodamente en la vistapg_stats, una fila por columna:
null_frac: fracción de filas en que la columna esNULL.n_distinct: V(A, r). Si es positivo, es el número de valores distintos. Si es negativo, es menos la fracción de filas: −1 quiere decir “todos distintos” (una clave) y −0,5 “tantos valores como la mitad de las filas”. Se usa la forma negativa cuando el número de valores crece con la tabla.most_common_valsymost_common_freqs: los valores más comunes (MCV, most common values) y la fracción exacta de filas de cada uno.histogram_bounds: los límites de un histograma equi-depth de los valores que no están en la lista de MCV. Condefault_statistics_target= 100 hay hasta 100 MCV y 101 límites.correlation: cuánto se parece el orden físico de las filas en el archivo al orden de los valores, de −1 a 1. Cerca de ±1, un index scan por rango lee páginas casi en orden; cerca de 0, salta por todo el archivo.
Algunas columnas de shipment (consulta columns):
   attname   |  null_frac  |  n_distinct  | n_mcv | n_bounds | correlation
-------------+-------------+--------------+-------+----------+-------------
 created_at  |           0 |       -0.977 |   100 |      101 |      -0.001
 sender_id   |           0 |  -0.14316666 |   100 |      101 |       0.020
 shipment_id |           0 |           -1 |       |      101 |       1.000
 status      |           0 |            4 |     4 |          |       0.857
 trip_id     | 0.041666668 |  -0.40633333 |   100 |      101 |       0.000
 weight_kg   |           0 | -0.110416666 |   100 |      101 |       0.010
(6 rows)
Se lee así:
shipment_ides la clave:n_distinct = -1, sin MCV (ningún valor se repite) ycorrelation = 1, porque los envíos se cargaron en orden deshipment_id.statustiene 4 valores, todos en la lista de MCV y ninguno en el histograma: con la lista alcanza.sender_idtiene 0,143 × 12 000 ≈ 1718 valores distintos: hay clientes que nunca enviaron nada.trip_idesNULLen el 4,2 % de los envíos (los que se quedaron sin viaje).- En
weight_kg, el mínimo de la tabla es 0,10 kg, pero el histograma empieza en 0,20: 0,10 kg es uno de los valores más comunes, y está en la lista de MCV y no en el histograma.
Y los MCV de status (consulta status_mcv):
              most_common_vals              |            most_common_freqs
--------------------------------------------+------------------------------------------
 {delivered,registered,returned,in_transit} | {0.92625,0.041666668,0.026583333,0.0055}
(1 row)
ANALYZE trabaja con una muestra
ANALYZE no lee toda la tabla: toma una muestra aleatoria de
300 × default_statistics_target filas, 30 000 con el valor de fábrica. En
chasqui_w12, shipment tiene 12 000 filas, así que la muestra es la tabla
entera y las estadísticas son exactas: por eso, en este capítulo, las
estimaciones de una sola columna salen casi perfectas. En chasqui_big, con
2 millones de envíos, ya no. Lo que estima PostgreSQL ahí (solo
EXPLAIN, sin cambiar nada) frente a lo que hay:
                            QUERY PLAN
------------------------------------------------------------------
 Seq Scan on shipment  (cost=0.00..49817.00 rows=229435 width=68)
   Filter: (status = 'in_transit'::text)
(2 rows)

   status   |  count
------------+---------
 registered |  222556
 returned   |  221985
 in_transit |  222334
 delivered  | 1345125
(4 rows)
229 435 estimadas, 222 334 reales: un error del 3 %, que viene de la
muestra. Con n_distinct el error es mayor, porque contar valores
distintos a partir de una muestra es difícil: en chasqui_big, pg_stats
dice 183 076 remitentes distintos y count(DISTINCT sender_id) da 201 789.
Si se corre ANALYZE otra vez, la muestra es otra y los números cambian un
poco. Para una columna importante se puede pedir una muestra más grande con
ALTER TABLE ... ALTER COLUMN ... SET STATISTICS 1000.
Error común. Tratar las estimaciones como exactas. Son aproximaciones calculadas sobre una muestra, con supuestos (uniformidad, independencia) que los datos reales no cumplen, y que envejecen desde el momento en que se calculan.
Estimar el tamaño de una selección
La selectividad (selectivity) de un predicado θ sobre r es la fracción de tuplas de r que lo cumplen. El tamaño estimado de σ_θ(r) es n_r por la selectividad. Silberschatz (sec. 16.3.2) da las fórmulas en número de tuplas; aquí las escribimos en fracciones, que es como las usa PostgreSQL, y al lado ponemos lo que hace PostgreSQL de verdad.
Igualdad
El libro. Si los valores de A están repartidos de manera uniforme,
σ_{A = a}(r) tiene n_r / V(A, r) tuplas: selectividad 1 / V(A, r). Si hay
un histograma, se usa el bucket que contiene a a y se supone uniformidad
solo dentro de ese bucket.
PostgreSQL. Si a está en la lista de MCV, la selectividad es su
frecuencia, sin suponer nada. status = 'in_transit' (consulta eq_mcv):
                         QUERY PLAN
------------------------------------------------------------
 Seq Scan on shipment  (cost=0.00..298.00 rows=66 width=67)
   Filter: (status = 'in_transit'::text)
(2 rows)
0,0055 × 12 000 = 66, exacto. Con la fórmula uniforme del libro habrían sido 12 000 / 4 = 3000.
Si a no está en la lista, PostgreSQL reparte lo que no cubre la lista
por igual entre los valores que no están en ella:
sel(A = a) = (1 − null_frac − Σ most_common_freqs) / (V(A, r) − #MCV)Para sender_id = 7 (consultas sender_stats y eq_other):
 n_distinct  | distinct_values | n_mcv | mcv_total | seven_in_mcv
-------------+-----------------+-------+-----------+--------------
 -0.14316666 |            1718 |   100 |    0.2889 | f
(1 row)

                        QUERY PLAN
-----------------------------------------------------------
 Seq Scan on shipment  (cost=0.00..298.00 rows=5 width=67)
   Filter: (sender_id = 7)
(2 rows)
(1 − 0 − 0,2889) / (1718 − 100) = 0,000 44, por 12 000 = 5,3: estima 5. El cliente 7 tiene 6 envíos. Los 100 remitentes más activos se llevan el 29 % de los envíos; la uniformidad se supone solo para el resto, que es mucho más parejo.
Comparaciones
El libro. Para σ_{A ≤ v}(r), si se conocen el mínimo y el máximo de A y los valores son uniformes:
0                                  si v < min(A, r)
n_r                                si v ≥ max(A, r)
n_r · (v − min(A, r)) / (max(A, r) − min(A, r))   en otro caso
Para weight_kg < 5 (consulta weight_uniform):
 min  |  max   | uniform_rows
------+--------+--------------
 0.10 | 148.30 |          397
(1 row)
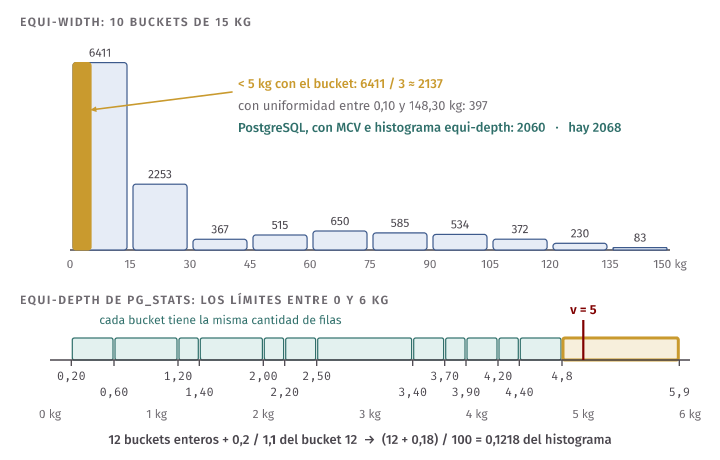
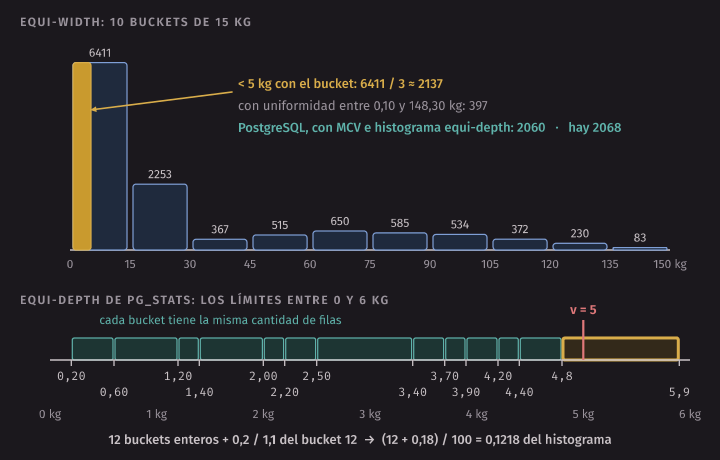
397 filas. Con el histograma equi-width de arriba: el primer bucket tiene 6411 envíos en 15 kg, y 5 kg es un tercio del bucket: 2137 filas. ¿Cuántas hay?
PostgreSQL. Junta las dos fuentes de información. Primero suma, sin
suponer nada, las frecuencias de los MCV que cumplen el predicado. Después,
para el resto de las filas no nulas, mira en qué bucket del histograma cae
v y supone uniformidad solo dentro de ese bucket (interpolación
lineal):
fracción del histograma bajo v = (i + (v − b_i) / (b_{i+1} − b_i)) / número de buckets
sel(A < v) = Σ freq de los MCV < v  +  (1 − null_frac − Σ freq de todos los MCV) · fracción
donde b_i ≤ v < b_{i+1} son los límites del bucket i (contando desde 0).
Para weight_kg < 5:
- 25 de los 100 MCV son menores que 5; sus frecuencias suman 0,0985. Todos los MCV suman 0,3955, así que el histograma describe el 60,45 % restante.
- 5 cae en el bucket 12, entre 4,8 y 5,9. La fracción del histograma por debajo de 5 es (12 + 0,2 / 1,1) / 100 = 0,1218.
- Una corrección pequeña: el histograma estima ”≤ v”, y para ”< v”
PostgreSQL resta la fracción que estima igual a
v, 1 / (1325 − 100) = 0,0008 (weight_kgtiene 1325 valores distintos). - 0,0985 + 0,6045 × (0,1218 − 0,0008) = 0,1716, por 12 000 = 2060.
EXPLAIN dice exactamente eso (consulta range_weight):
                          QUERY PLAN
--------------------------------------------------------------
 Seq Scan on shipment  (cost=0.00..298.00 rows=2060 width=67)
   Filter: (weight_kg < '5'::numeric)
(2 rows)
Hay 2068. La fórmula uniforme del libro se quedaba corta 5 veces; el histograma de 100 buckets erra en 8 filas.
Para no hacer esta cuenta a mano cada vez, selectivity.mjs
lee pg_stats, la hace, y la compara con EXPLAIN y con la consulta real:
$ PGDATABASE=chasqui_w12 node selectivity.mjs shipment created_at '>=' 2026-06-01
shipment.created_at >= 2026-06-01
  selectividad estimada  0.157552
  filas (pg_stats)       1891
  filas (EXPLAIN)        1891
  filas reales           1889
Las pruebas de selectivity.test.mjs revisan diez predicados sobre tres
tablas, con números y con fechas: en todos, la cuenta del script coincide
con la de EXPLAIN. Explicamos el código al final del capítulo.
En PostgreSQL. Si no hay estadísticas, el planificador usa selectividades fijas: 0,5 % para una igualdad y un tercio para una desigualdad. Pasa con una tabla que nunca se analizó y, lo que es más frecuente, con una expresión: PostgreSQL tiene estadísticas de
last_name, pero no delower(last_name). Conlower(last_name) = 'quispe flores'estima 9 clientes de 1800, el 0,5 % (consultalower_no_indexdeplans.sql). Enchasqui_big, el mismo predicado estima 1009 filas de 201 800, y hay 3080. La Sesión B muestra cómo darle estadísticas a una expresión.
Conjunciones, disyunciones y negaciones
Para predicados compuestos, el libro supone que las condiciones son independientes: saber que una tupla cumple θ₁ no cambia la probabilidad de que cumpla θ₂. Con s₁, s₂ las selectividades:
| Predicado | Selectividad |
|---|---|
| θ₁ ∧ θ₂ | s₁ · s₂ |
| θ₁ ∨ θ₂ | 1 − (1 − s₁)(1 − s₂) = s₁ + s₂ − s₁ · s₂ |
| ¬θ | 1 − s (menos la fracción de nulos, si la hay) |
(El libro las escribe con tamaños: n_r · (s₁ · s₂ · … · sₙ) / n_rⁿ para la conjunción, con s_i el número de tuplas que cumplen θ_i. Es lo mismo.)
La negación necesita cuidado con NULL. Si A tiene nulos, A <> v no los
devuelve: NULL <> 'delivered' es unknown. Por eso el tamaño de
σ_{¬θ}(r) es n_r menos lo que cumple θ menos los nulos, no solo n_r
menos lo que cumple θ.
En Chasqui, status y weight_kg no tienen relación, y el supuesto
funciona (consultas and_independent, or_independent y not_eq):
 Seq Scan on shipment  (cost=0.00..328.00 rows=55 width=67) (actual time=0.103..1.161 rows=45.00 loops=1)
   Filter: ((weight_kg < '5'::numeric) AND (status = 'returned'::text))

 Seq Scan on shipment  (cost=0.00..328.00 rows=2324 width=67) (actual time=0.003..0.873 rows=2342.00 loops=1)
   Filter: ((status = 'returned'::text) OR (weight_kg < '5'::numeric))

 Seq Scan on shipment  (cost=0.00..298.00 rows=885 width=67)
   Filter: (status <> 'delivered'::text)
(Son las primeras líneas de cada plan; rows después de cost es la
estimación y rows dentro de actual es lo real.)
- Conjunción: 0,026 58 × 0,1716 × 12 000 = 54,7 → 55. Hay 45.
- Disyunción: 0,026 58 + 0,1716 − 0,026 58 × 0,1716 = 0,1937 → 2324. Hay 2342.
- Negación: 1 − 0,926 25 − 0 (sin nulos) = 0,073 75 → 885, exacto.
Cuando las columnas sí tienen relación, el producto se equivoca, y mucho. Es el tema de la sección “Cuando falla la independencia”.
Estimar el tamaño de un join
Los casos del libro
Sean r(R) y s(S) dos relaciones (sec. 16.3.3):
- Si R ∩ S = ∅, r ⋈ s es el producto cartesiano: n_r · n_s tuplas.
- Si R ∩ S es una clave de R, cada tupla de s se une con a lo más una de r: el join tiene a lo más n_s tuplas.
- Si además R ∩ S es una clave foránea de S que referencia a R (y no admite nulos), cada tupla de s se une con exactamente una de r: el join tiene n_s tuplas.
- En el caso general, con R ∩ S = {A} y ninguno de los dos una clave, se supone que cada valor aparece con la misma frecuencia. Una tupla t de r se une con n_s / V(A, s) tuplas de s, y el join tiene n_r · n_s / V(A, s). Al revés da n_r · n_s / V(A, r). Si los dos números difieren, es porque hay valores que están en una relación y no en la otra, y el menor es el más preciso:
tamaño(r ⋈ s) ≈ n_r · n_s / max(V(A, r), V(A, s))En Chasqui, customer ⋈ shipment por customer_id = sender_id:
customer_id es la clave de customer y sender_id es una clave foránea
NOT NULL. El join tiene exactamente n_shipment = 12 000 tuplas, que es lo
que daba sizes_late. La fórmula general da lo mismo:
1800 × 12 000 / max(1800, 1718) = 12 000.
Si sender_id aceptara nulos, las tuplas con NULL no se unirían con
nadie (NULL = customer_id es unknown), y habría que restar la fracción
de nulos. Es lo que pasa con trip_id: shipment ⋈ trip tiene
(1 − 0,0417) × 12 000 tuplas.
Con un filtro antes del join
Lo interesante es el join después de una selección. Para
σ city = 'Arequipa' (customer) ⋈ shipment (consulta join_fk de
stats.sql):
 Hash Join  (cost=42.61..342.19 rows=593 width=19) (actual time=0.394..1.481 rows=822.00 loops=1)
   Hash Cond: (s.sender_id = c.customer_id)
   ->  Seq Scan on shipment s  (cost=0.00..268.00 rows=12000 width=12) (actual time=0.002..0.430 rows=12000.00 loops=1)
   ->  Hash  (cost=41.50..41.50 rows=89 width=19) (actual time=0.387..0.387 rows=89.00 loops=1)
         Buckets: 1024  Batches: 1  Memory Usage: 13kB
         ->  Seq Scan on customer c  (cost=0.00..41.50 rows=89 width=19) (actual time=0.090..0.375 rows=89.00 loops=1)
               Filter: (city = 'Arequipa'::text)
               Rows Removed by Filter: 1711
El scan de customer estima 89 clientes de Arequipa, y son 89 (es un MCV
de customer.city). El join estima 593:
89 × 12 000 / max(1800, 1718) = 593,3Es la fórmula general: los 89 clientes son el 4,9 % de los 1800, y si todos los clientes enviaran lo mismo, les tocaría el 4,9 % de los 12 000 envíos. El join devuelve 822. Los clientes de Arequipa envían más que el promedio: Arequipa tiene dos agencias y en los datos los remitentes salen de su ciudad. La selectividad del join está bien; lo que falla es el supuesto de que todos los clientes son iguales.
Fíjense en el detalle: PostgreSQL usa V(customer_id, customer) = 1800 de la tabla completa, no los 89 que quedan después del filtro. La selectividad del join (1 / 1800) se calcula con las estadísticas de las tablas base, y se multiplica por el tamaño estimado de cada entrada.
El último join, con σ region = 'Cusco' (agency), estima
593 × 1 / 29 = 20 (una agencia de 29), y hay 61. Los envíos solo viajan
por rutas, y desde Arequipa hay rutas a pocas ciudades, entre ellas Cusco:
el destino de un envío depende de su origen. El estimador supone que el
destino es cualquiera de las 29 agencias con la misma probabilidad.
Idea clave. Los errores de estimación se multiplican a lo largo del plan. Un factor de 1,4 en el primer join y uno de 3 en el segundo dan un factor de 4 en el resultado. Con 5 o 6 joins y errores de 10 veces en cada uno, el optimizador está eligiendo a ciegas. Leis et al. (2015) midieron esto en PostgreSQL y en sistemas comerciales: los errores crecen exponencialmente con el número de joins.
Un ejemplo resuelto a escala de chasqui_big
Con números supuestos de una escala como la de chasqui_big: customer
tiene 200 000 tuplas y V(city, customer) = 50; shipment, 2·10⁶. Con
uniformidad, σ city = 'Arequipa' (customer) tiene 200 000 / 50 = 4000
tuplas. Su join con shipment (clave foránea hacia la clave) tiene
4000 × 2·10⁶ / 200 000 = 40 000: diez envíos por cliente, el promedio. Si los
clientes de Arequipa envían el doble, son 80 000, y el optimizador lo sabe
recién cuando ejecuta.
Otras operaciones
El libro también estima (secs. 16.3.4 y 16.3.5) la proyección con
eliminación de duplicados Π_A(r) en V(A, r) tuplas y la agregación
Gγ_F(r) en V(G, r), una por grupo; para unión, intersección y diferencia
usa cotas (n_r + n_s, min(n_r, n_s), n_r); un outer join r ⟕ s, como el
tamaño de r ⋈ s más n_r (una cota superior: lo exacto es el join más las
tuplas de r sin pareja). Para seguir estimando hacia arriba hace falta
también V(A, ·) de cada resultado: si la selección fija A = a, vale 1; en
general, min(V(A, r), n{σ(r)}). Para varios atributos, el libro usa
min(V(A₁, r) · V(A₂, r) · …, n_r): otra vez independencia, y se ve en un
GROUP BY sobre dos columnas en la sección siguiente.
Cuando falla la independencia
Columnas que dependen una de otra
El supuesto de independencia es cómodo porque solo necesita estadísticas
de cada columna por separado. Pero en datos reales las columnas de una
misma tabla suelen estar relacionadas. Cuatro casos en Chasqui
(correlated.sql):
Un envío entregado siempre tiene fecha de entrega (consulta
delivered_null):
 Seq Scan on shipment  (cost=0.00..298.00 rows=820 width=67) (actual time=0.764..0.766 rows=0.00 loops=1)
   Filter: ((delivered_at IS NULL) AND (status = 'delivered'::text))
   Rows Removed by Filter: 12000
El 92,6 % está delivered y el 7,4 % no tiene delivered_at: el producto
da 0,926 × 0,074 × 12 000 = 820. No hay ninguno.
Un envío registrado todavía no tiene viaje (consulta
registered_null): estima 21 (0,0417 × 0,0417 × 12 000) y hay 500. Se
queda corto 24 veces.
La región depende de la ciudad. Es una dependencia funcional,
city → region, como las de la semana 6. En agency la relación es obvia,
pero agency tiene 29 filas, y con tan pocas filas el error no se ve:
para city = 'Cusco' AND region = 'Cusco' el planificador estima 1 y hay 1,
y para Lima estima 1 y hay 3; ninguna estimación baja de 1. Para verlo con
más filas, correlated.sql arma shipment_origin, una tabla con la ciudad
y la región de la agencia de origen de cada uno de los 12 000 envíos
(desnormalizada a propósito: es justo lo que la semana 6 enseñó a evitar, y
por eso tiene una dependencia funcional entre dos columnas que no son clave).
Consulta city_region_before:
 Seq Scan on shipment_origin  (cost=0.00..308.00 rows=31 width=18) (actual time=0.006..0.492 rows=610.00 loops=1)
   Filter: ((origin_city = 'Cusco'::text) AND (origin_region = 'Cusco'::text))
   Rows Removed by Filter: 11390
610 envíos salen de Cusco: el 5,1 %. El planificador multiplica 5,1 % de ciudad por 5,1 % de región y obtiene 31. Pero si la ciudad es Cusco, la región es Cusco con probabilidad 1: la segunda condición no filtra nada. El error es de 20 veces. En general: con 40 ciudades y 25 regiones repartidas de manera uniforme, el producto da 1/40 × 1/25 = 1/1000, lo real es 1/40, y el estimador se queda corto 25 veces, que es el número de regiones.
Origen y destino de un envío (consultas od_before y
od_groups_before). Hay 28 agencias de origen y 28 de destino, pero solo
120 rutas: la mayoría de los pares no tiene envíos y unos pocos tienen
muchos.
 Seq Scan on shipment  (cost=0.00..328.00 rows=8 width=67) (actual time=0.009..0.555 rows=92.00 loops=1)
   Filter: ((origin_agency_id = 6) AND (dest_agency_id = 28))

 HashAggregate  (cost=358.00..365.84 rows=784 width=16) (actual time=1.651..1.664 rows=120.00 loops=1)
   Group Key: origin_agency_id, dest_agency_id
De Cusco (6) a Puerto Maldonado (28) estima 8 envíos y hay 92. Y para el
GROUP BY origin_agency_id, dest_agency_id estima 28 × 28 = 784 grupos: la
fórmula del libro, min(V(A₁) · V(A₂), n_r). Hay 120.
Por qué importa
En estas consultas de una tabla el error no cambia nada: el plan es un
sequential scan de todas formas. Importa cuando el resultado entra a un
join. Si el optimizador cree que σ(shipment) tiene 8 filas, un nested
loop con 8 iteraciones sobre un índice le parece barato; con 92 sigue
pasando, con 9200 ya no. Y el error se multiplica en cada join que viene
después. En la Sesión B vemos un plan que cambia por un error así.
CREATE STATISTICS
PostgreSQL no puede adivinar qué columnas están relacionadas; hay que
decírselo. CREATE STATISTICS declara estadísticas extendidas sobre
un grupo de columnas de una tabla, y ANALYZE las calcula. Hay tres tipos,
y cada uno arregla un caso distinto:
dependencies: grados de dependencia funcional entre columnas. Para cada par A → B, la fracción de filas en que el valor de A determina el de B. Sirve para condiciones de igualdadA = x AND B = y.ndistinct: el número de combinaciones distintas de las columnas, V(A₁A₂, r). Sirve paraGROUP BYyDISTINCTsobre varias columnas.mcv: una lista de las combinaciones más comunes con sus frecuencias. Es la más precisa para condiciones sobre varias columnas, y la más cara de guardar.
Para city → region (consultas city_region_dep y city_region_after):
CREATE STATISTICS shipment_origin_dep (dependencies)
  ON origin_city, origin_region FROM shipment_origin;
ANALYZE shipment_origin;
dependencies
------------------------------------------
{"2 => 3": 1.000000, "3 => 2": 0.884583}
(1 row)Las columnas se identifican por número (2 es origin_city, 3 es
origin_region). 2 => 3 vale 1: la ciudad determina la región en todas
las filas. 3 => 2 vale 0,88: la región casi determina la ciudad, salvo en
Puno (Puno y Juliaca) y Áncash (Chimbote y Huaraz). Con un grado f para
A → B, PostgreSQL estima
sel(A = a ∧ B = b) = sel(A = a) · (f + (1 − f) · sel(B = b))Con f = 1 queda sel(A = a): la segunda condición no filtra. El plan nuevo:
 Seq Scan on shipment_origin  (cost=0.00..308.00 rows=610 width=18) (actual time=0.005..0.449 rows=610.00 loops=1)
   Filter: ((origin_city = 'Cusco'::text) AND (origin_region = 'Cusco'::text))
610 estimadas, 610 reales.
Con origen y destino, en cambio, dependencies casi no ayuda (consultas
od_dep y od_with_dep):
               dependencies
------------------------------------------
 {"4 => 5": 0.018000, "5 => 4": 0.019667}
(1 row)

 Seq Scan on shipment  (cost=0.00..328.00 rows=11 width=67)
   Filter: ((origin_agency_id = 6) AND (dest_agency_id = 28))
El origen no determina el destino: de Cusco salen envíos a varias agencias.
El grado de dependencia es 0,018 y la estimación pasa de 8 a 11. Lo que
hace falta aquí es la lista de pares comunes y el número de pares
distintos (consultas od_ndistinct, od_with_mcv y od_groups_after):
CREATE STATISTICS shipment_od (mcv, ndistinct)
  ON origin_agency_id, dest_agency_id FROM shipment;
ANALYZE shipment;
n_distinct
---------------
{"4, 5": 120}
(1 row)
Seq Scan on shipment (cost=0.00..328.00 rows=92 width=67)
Filter: ((origin_agency_id = 6) AND (dest_agency_id = 28))
HashAggregate (cost=358.00..359.20 rows=120 width=16)
Group Key: origin_agency_id, dest_agency_id92 envíos y 120 grupos, exactos. (En chasqui_w12 las estadísticas
extendidas también se calculan sobre la tabla entera; en chasqui_big
serían de una muestra.)
En PostgreSQL. Las estadísticas extendidas solo se usan para columnas de una misma tabla: no ayudan con la correlación entre una columna de
customery otra deshipment, que es lo que hacía fallar la estimación del join de Arequipa. Tampoco hay que crearlas para todo: cuestan tiempo deANALYZEy de planificación. Se crean cuando unEXPLAIN ANALYZEmuestra un error grande en una condición sobre columnas relacionadas. Se ven enpg_stats_exty se borran conDROP STATISTICS.
Estadísticas viejas
El otro gran motivo de malas estimaciones es más simple: las estadísticas
no corresponden a los datos de ahora. Pasa después de una carga masiva, de
un DELETE grande o en una tabla recién creada.
stale.sql crea una copia de shipment con el
autovacuum apagado, la llena con los 12 000 envíos y la consulta antes de
ANALYZE. El catálogo dice que nunca se analizó:
 relpages | reltuples
----------+-----------
        0 |        -1
(1 row)
Sin reltuples, el planificador mira el tamaño real del archivo (148
páginas) y estima cuántas filas caben por el ancho de las columnas
(consulta rows_before):
                             QUERY PLAN
--------------------------------------------------------------------
 Seq Scan on shipment_copy  (cost=0.00..230.88 rows=8288 width=116)
(1 row)
8288 filas: no es tan malo. Lo grave es la selectividad. Sin pg_stats,
status = 'delivered' recibe el 0,5 % por defecto: 8288 × 0,005 = 41
filas, cuando son 11 115. El join con customer (consulta join_before):
 Hash Join  (cost=252.11..303.02 rows=41 width=19) (actual time=2.256..3.200 rows=11115.00 loops=1)
   Hash Cond: (c.customer_id = s.sender_id)
   ->  Seq Scan on customer c  (cost=0.00..37.00 rows=1800 width=19) (actual time=0.061..0.170 rows=1800.00 loops=1)
   ->  Hash  (cost=251.60..251.60 rows=41 width=8) (actual time=2.184..2.184 rows=11115.00 loops=1)
         Buckets: 16384 (originally 1024)  Batches: 1 (originally 1)  Memory Usage: 563kB
         ->  Seq Scan on shipment_copy s  (cost=0.00..251.60 rows=41 width=8) (actual time=0.006..1.219 rows=11115.00 loops=1)
               Filter: (status = 'delivered'::text)
               Rows Removed by Filter: 885
La hash table de un hash join se construye con la entrada que se cree más
pequeña (semana 11). El optimizador eligió shipment_copy, porque creía
que tenía 41 filas. Tenía 11 115: la hash table se dimensionó para 1024
buckets y tuvo que crecer a 16 384 mientras se llenaba
(Buckets: 16384 (originally 1024)). Con una tabla más grande y poco
work_mem, ese error también puede convertir un hash join de una pasada en
uno de varios batches en disco.
Después de ANALYZE shipment_copy (consulta join_after):
 Hash Join  (cost=59.50..386.74 rows=11115 width=19) (actual time=0.251..2.670 rows=11115.00 loops=1)
   Hash Cond: (s.sender_id = c.customer_id)
   ->  Seq Scan on shipment_copy s  (cost=0.00..298.00 rows=11115 width=8) (actual time=0.005..1.252 rows=11115.00 loops=1)
         Filter: (status = 'delivered'::text)
   ->  Hash  (cost=37.00..37.00 rows=1800 width=19) (actual time=0.244..0.244 rows=1800.00 loops=1)
         Buckets: 2048  Batches: 1  Memory Usage: 109kB
(Las líneas principales.) La estimación es exacta y la hash table se
construye con customer, las 1800 filas, con la memoria justa.
En PostgreSQL. El autovacuum corre
ANALYZEsobre una tabla cuando cambiaron más deautovacuum_analyze_threshold+autovacuum_analyze_scale_factor×reltuplesfilas desde la última vez: 50 + 0,1 × n_r con los valores de fábrica. Después de una carga masiva, no esperen al autovacuum: corranANALYZEen la misma sesión que cargó los datos, antes de las consultas. Es lo que hacedata.sqlde Chasqui en su última línea.
Elegir el plan
El costo de un plan
Un plan es un árbol de operadores, cada uno con su algoritmo. Su costo es la suma de los costos de sus operadores, y el costo de cada operador depende del tamaño de sus entradas, que es lo que estimamos en la Sesión A. Con eso, un optimizador basado en costos (cost-based) explora planes equivalentes y se queda con el de menor costo estimado (sec. 16.4).
Elegir el mejor algoritmo para cada operador por separado no alcanza.
Silberschatz da el ejemplo: un merge join puede costar más que un hash join
para el mismo join, pero deja su resultado ordenado por la clave del
join, y si el operador siguiente es un GROUP BY o un ORDER BY sobre esa
clave, o otro merge join, ese orden le ahorra un ordenamiento. El plan más
barato puede usar, en un nodo, un algoritmo que no era el más barato para
ese nodo.
Programación dinámica
El problema más difícil es el orden de los joins. La observación que lo resuelve: el mejor plan para unir un conjunto S de relaciones se arma con el mejor plan de un subconjunto S₁ y el mejor plan del resto S − S₁. No hace falta considerar los demás planes de S₁: si hubiera uno mejor para juntar con el resto, sería mejor también para S₁ solo. Es el principio de optimalidad de la programación dinámica, y permite guardar un solo plan por subconjunto.
El algoritmo del libro (sec. 16.4), escrito en JavaScript:
// bestPlan: Map de "conjunto de relaciones" a { plan, cost }
function findBestPlan(S) {
  if (bestPlan.has(key(S))) return bestPlan.get(key(S));
  let best = { plan: null, cost: Infinity };
  if (S.length === 1) {
    best = bestAccessPath(S[0]); // sequential scan o un índice
  } else {
    for (const S1 of nonEmptyProperSubsets(S)) {
      const p1 = findBestPlan(S1);
      const p2 = findBestPlan(minus(S, S1));
      for (const alg of joinAlgorithms) { // nested loop, hash, merge...
        const cost = p1.cost + p2.cost + joinCost(alg, p1, p2);
        if (cost < best.cost) best = { plan: [alg, p1.plan, p2.plan], cost };
      }
    }
  }
  bestPlan.set(key(S), best);
  return best;
}
Cuánto trabajo hace:
- Hay 2ⁿ subconjuntos de n relaciones, y se guarda un plan para cada uno: para 7 tablas son 128 planes guardados, frente a 665 280 árboles posibles.
- Para cada subconjunto S de k relaciones se prueban sus 2ᵏ − 2 divisiones en S₁ y S − S₁. Sumando sobre todos los subconjuntos, el tiempo es O(3ⁿ). Para n = 10, 3¹⁰ ≈ 59 000, frente a los 1,76·10¹⁰ órdenes de join.
Left-deep trees y System R
En un left-deep tree, la entrada derecha (la de adentro) de cada join es una tabla base, no el resultado de otro join:
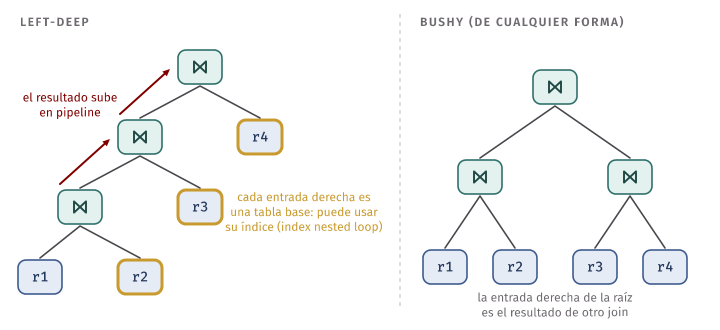
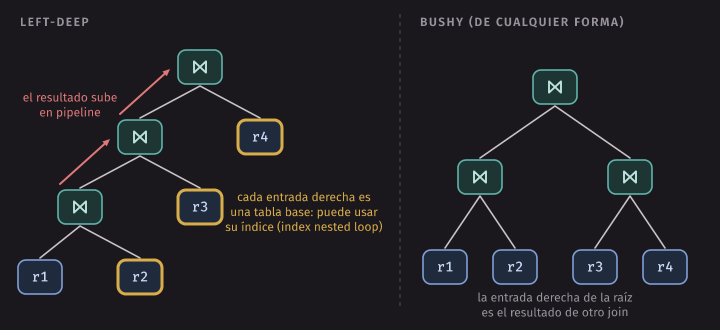
El optimizador de System R (IBM, años 70; el artículo de P. Selinger et al. de 1979), que es la base de casi todos los optimizadores comerciales, solo considera left-deep trees. Hay dos razones:
- Pipeline e index nested loop. El resultado de cada join pasa como entrada de afuera al siguiente sin escribirse a disco, y la entrada de adentro, al ser una tabla base, puede tener un índice que permite un index nested loop join (semana 11).
- Menos trabajo. Para un conjunto S, la única división que se prueba es “S menos una relación, y esa relación”: k divisiones en vez de 2ᵏ − 2. El tiempo baja a O(n · 2ⁿ). Hay n! órdenes left-deep: 7! = 5040 para siete tablas, todos cubiertos por la programación dinámica sin enumerarlos.
System R agrega una idea más: los órdenes interesantes (interesting
orders). Un orden de las tuplas es interesante si sirve más arriba en el
plan: el orden de una clave de join que se usa después, o el de un
GROUP BY o un ORDER BY. Para cada subconjunto, en vez de un solo mejor
plan, se guarda el mejor plan para cada orden interesante que pueda
producir, además del mejor sin orden. El ejemplo de la sección anterior (el
merge join que pierde localmente y gana en el plan completo) queda cubierto,
y como los órdenes interesantes suelen ser pocos, el costo no cambia mucho.
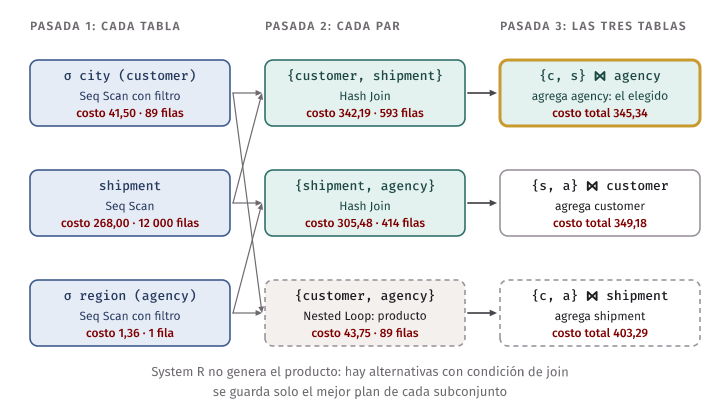
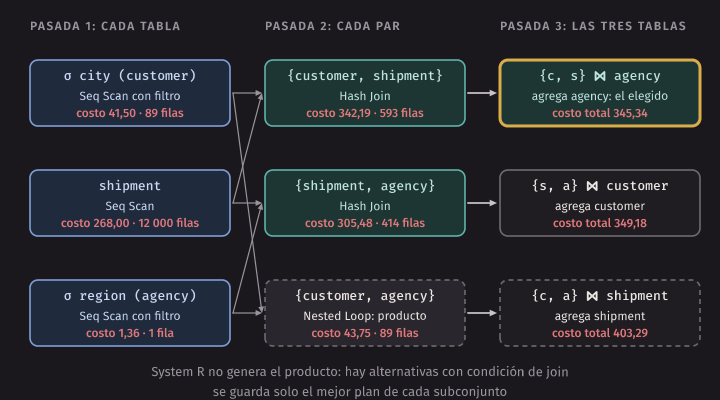
CS186 lo describe en pasadas: la pasada 1 encuentra el mejor acceso a cada tabla; la pasada 2, el mejor plan para cada par de tablas; la pasada k, para cada conjunto de k tablas, el mejor plan que agrega una tabla al mejor plan de k − 1. Para no generar productos cartesianos, en cada pasada solo se agregan tablas que tienen una condición de join con las que ya están, salvo que no haya otra opción.
Las pasadas con los costos de PostgreSQL
Hagamos las pasadas para la consulta de Arequipa y Cusco, con los costos que
calcula PostgreSQL (plans.sql, consultas
dp_*). Las unidades de cost= las explicamos en la sección siguiente; por
ahora basta con que son comparables entre sí.
Pasada 1. No hay índices sobre city ni sobre region, y shipment
se lee entera: el mejor acceso a cada tabla es un sequential scan:
| Tabla | Plan | Costo | Filas estimadas |
|---|---|---|---|
σ city = 'Arequipa' (customer) |
Seq Scan con filtro | 41,50 | 89 |
shipment |
Seq Scan | 268,00 | 12 000 |
σ region = 'Cusco' (agency) |
Seq Scan con filtro | 1,36 | 1 |
Pasada 2. Los pares. customer y shipment tienen una condición de
join, y shipment y agency otra. customer y agency no: unirlas es un
producto cartesiano.
| Par | Mejor plan | Costo | Filas estimadas |
|---|---|---|---|
| {customer, shipment} | Hash Join, hash table con los 89 clientes | 342,19 | 593 |
| {shipment, agency} | Hash Join, hash table con la agencia | 305,48 | 414 |
| {customer, agency} | Nested Loop, sin condición (producto) | 43,75 | 89 |
(Son la primera línea de los planes dp_cs, dp_sa y dp_ca; por
ejemplo, Hash Join (cost=42.61..342.19 rows=593 width=118).) System R no
generaría el tercer par, porque hay alternativas sin producto cartesiano.
Pasada 3. Tres formas de llegar a {customer, shipment, agency}: agregar
agency al mejor plan de {customer, shipment}, agregar customer al de
{shipment, agency}, o agregar shipment al producto {customer, agency}.
Las dos últimas se pueden forzar escribiendo los JOIN en ese orden (con
join_collapse_limit = 1, que se explica más abajo; consultas dp_sa_c y
dp_ca_s):
| Plan | Costo total |
|---|---|
| ({customer, shipment}) ⋈ agency | 345,34 |
| ({shipment, agency}) ⋈ customer | 349,18 |
| ({customer, agency}) ⋈ shipment | 403,29 |
El primero es el que eligió PostgreSQL al principio del capítulo. Los costos
están cerca porque las tres tablas son chicas y el costo lo domina leer
shipment, que se lee una vez en los tres planes. Noten que el
producto cartesiano aquí no es un desastre: agency filtrada tiene una
sola fila. La heurística de evitarlos es buena casi siempre, no siempre.
Heurísticas
Los optimizadores reales no costean todo. Aplican reglas que casi siempre convienen, sin costearlas (sec. 16.4):
- Aplicar las selecciones lo antes posible. Achican todo lo que viene después. (Hay excepciones: si la selección es cara de evaluar y la tabla se va a filtrar mucho por un join, puede convenir esperar.)
- Aplicar las proyecciones lo antes posible. Tuplas más angostas, más tuplas por página.
- Evitar productos cartesianos si hay otra forma.
- Unir primero las relaciones con los resultados más pequeños, para que los resultados intermedios sean chicos.
- Solo left-deep trees, como System R.
Muchos optimizadores combinan las dos cosas: primero un paso heurístico que reescribe la expresión (bajar selecciones y proyecciones, simplificar), y después la búsqueda basada en costos sobre el orden de los joins y los algoritmos.
Subconsultas anidadas
Una subconsulta correlacionada, leída al pie de la letra, se evalúa una vez
por cada tupla de la consulta de afuera: es un nested loop disfrazado. La
sec. 16.4 del libro explica cómo los optimizadores la decorrelacionan:
la reescriben como un join, o como un semi join (r ⋉ s: las tuplas de r
que tienen al menos una pareja en s, sin repetirlas). EXISTS e IN se
convierten en semi joins; NOT EXISTS, en anti joins (las tuplas de r
sin pareja en s).
En Chasqui, los clientes de Cusco que tienen algún envío devuelto (consulta
exists_semijoin de equivalences.sql):
SELECT c.customer_id, c.last_name
FROM customer c
WHERE c.city = 'Cusco'
  AND EXISTS (SELECT 1 FROM shipment s
              WHERE s.sender_id = c.customer_id AND s.status = 'returned');
QUERY PLAN
-------------------------------------------------------------------------
Hash Right Semi Join (cost=41.95..341.42 rows=6 width=19)
Hash Cond: (s.sender_id = c.customer_id)
-> Seq Scan on shipment s (cost=0.00..298.00 rows=319 width=4)
Filter: (status = 'returned'::text)
-> Hash (cost=41.50..41.50 rows=36 width=19)
-> Seq Scan on customer c (cost=0.00..41.50 rows=36 width=19)
Filter: (city = 'Cusco'::text)
(7 rows)No hay subconsulta en el plan: hay un hash semi join. La hash table se arma con los 36 clientes de Cusco, y cada envío devuelto busca a su remitente en ella. (Right quiere decir que lo que se devuelve sin repetir es el lado de la hash table, el derecho.)
El optimizador de PostgreSQL
PostgreSQL sigue este esquema, con algunas diferencias:
- Usa programación dinámica sobre los subconjuntos de tablas, y considera también bushy trees, no solo left-deep. Guarda, para cada subconjunto, los planes más baratos para cada orden útil (sus pathkeys, el equivalente de los órdenes interesantes).
- Cuando el
FROMtienegeqo_threshold(12) o más elementos, la programación dinámica se vuelve demasiado cara y cambia a GEQO, un optimizador genético que busca un buen orden de joins al azar guiado por el costo, sin garantía de encontrar el mejor. join_collapse_limit(8) es cuántosJOINexplícitos puede reordenar a la vez;from_collapse_limit(8), cuántas tablas puede traer de una subconsulta delFROMa la consulta de afuera. Por encima de esos límites, respeta el orden en que la consulta está escrita.
Los parámetros, como los ve pg_settings (consulta settings):
           name            | setting
---------------------------+---------
 cpu_index_tuple_cost      | 0.005
 cpu_operator_cost         | 0.0025
 cpu_tuple_cost            | 0.01
 default_statistics_target | 100
 from_collapse_limit       | 8
 geqo_threshold            | 12
 join_collapse_limit       | 8
 random_page_cost          | 4
 seq_page_cost             | 1
(9 rows)
El modelo de costo de PostgreSQL está en unidades de una página leída en
secuencia (seq_page_cost = 1). Una página leída al azar cuesta
random_page_cost = 4; procesar una tupla, cpu_tuple_cost = 0,01;
evaluar un operador (una comparación del WHERE), cpu_operator_cost =
0,0025. Con eso se puede verificar a mano el costo de un sequential scan:
Seq Scan on shipment:        148 páginas × 1 + 12 000 tuplas × 0,01                      = 268,00
... WHERE status = 'x':      268 + 12 000 × 0,0025 (una comparación por tupla)          = 298,00
... WHERE a = x AND b = y:  268 + 12 000 × 0,0025 × 2                                  = 328,00
Seq Scan on customer:        19 × 1 + 1800 × 0,01                                       =  37,00
Son los números que aparecen en los planes de este capítulo. A diferencia
del modelo del libro, que cuenta solo transferencias y seeks, PostgreSQL
también cobra la CPU. Y random_page_cost = 4 supone un disco magnético con
caché: en un SSD es común bajarlo a 1,1 o 1,5, y entonces los index scans
salen más baratos.
Error común. Leer
cost=como milisegundos. Son unidades arbitrarias (“páginas secuenciales equivalentes”), que solo sirven para comparar planes de la misma consulta en el mismo servidor. Un plan con costo 500 no tarda el doble que uno de costo 250 de otra consulta.
Leer EXPLAIN
La forma de un plan
EXPLAIN muestra el plan elegido sin ejecutarlo. Es un árbol: cada línea
que empieza con -> es un nodo, y sus hijos están debajo con más sangría.
Se lee de adentro hacia afuera: los nodos más a la derecha (las hojas,
casi siempre scans) son los primeros que producen tuplas, y el de arriba
devuelve el resultado.
Cada nodo tiene cuatro números estimados:
Hash Join (cost=42.61..342.19 rows=593 width=19)cost=42.61..342.19: costo de inicio (antes de devolver la primera tupla) y costo total (hasta devolver la última). El costo de inicio de un hash join incluye construir la hash table entera, por eso no es 0. El de un sequential scan es 0.rows=593: filas que se estima que devuelve el nodo, después de sus filtros.width=19: ancho promedio de una fila, en bytes.
Debajo de cada nodo vienen sus detalles: Filter: es una condición que se
evalúa sobre cada tupla leída, Index Cond: una que el índice usa para
buscar, Hash Cond: la condición de un hash join.
EXPLAIN ANALYZE
EXPLAIN ANALYZE ejecuta la consulta y agrega, en cada nodo, lo que
pasó de verdad:
Hash Join (cost=42.61..342.19 rows=593 width=19) (actual time=0.394..1.481 rows=822.00 loops=1)actual time=0.394..1.481: milisegundos hasta la primera tupla y hasta la última.rows=822.00: filas que devolvió el nodo por iteración (PostgreSQL 18 las muestra con dos decimales, porque son un promedio).loops=1: cuántas veces se ejecutó el nodo.
Y al final, Planning Time (lo que tardó el optimizador) y Execution Time (lo que tardó la ejecución). En PostgreSQL 18, EXPLAIN ANALYZE
incluye Buffers: sin pedirlo: shared hit son páginas que encontró en el
buffer pool y read las que pidió al sistema operativo (que pueden venir de
su caché, como vimos en la semana 9). Index Searches, también nuevo en la
versión 18, es cuántas búsquedas hizo un index scan en el índice.
Como ejecuta la sentencia, con un UPDATE o un DELETE el cambio se hace
de verdad. Para mirar el plan sin cambiar nada, se envuelve en una
transacción que se deshace (consulta explain_update):
BEGIN;
EXPLAIN ANALYZE UPDATE customer SET phone = NULL WHERE customer_id = 5;
ROLLBACK;
Update on customer (cost=0.28..8.29 rows=0 width=0) (actual time=0.076..0.076 rows=0.00 loops=1)
-> Index Scan using customer_pkey on customer (cost=0.28..8.29 rows=1 width=38) (actual time=0.004..0.004 rows=1.00 loops=1)
Index Cond: (customer_id = 5)
Index Searches: 1El ROLLBACK deshace el cambio, pero deja una versión muerta de la fila en
la página (semana 9), que el VACUUM del final de plans.sql limpia.
Loops: lo que hay que multiplicar
En un nested loop, el nodo de adentro se ejecuta una vez por cada fila
del de afuera, y sus rows y actual time son por iteración.
Los eventos de los envíos de la agencia 1 (Lima - La Victoria) a la 4
(Arequipa - Centro) (consulta nested_loop):
 Nested Loop  (cost=0.29..1129.05 rows=298 width=16) (actual time=0.014..0.810 rows=467.00 loops=1)
   ->  Seq Scan on shipment s  (cost=0.00..328.00 rows=77 width=4) (actual time=0.008..0.462 rows=117.00 loops=1)
         Filter: ((origin_agency_id = 1) AND (dest_agency_id = 4))
         Rows Removed by Filter: 11883
   ->  Index Scan using shipment_event_pkey on shipment_event e  (cost=0.29..10.36 rows=4 width=16) (actual time=0.002..0.003 rows=3.99 loops=117)
         Index Cond: (shipment_id = s.shipment_id)
Index Searches: 117- El scan de afuera devuelve 117 envíos, y el index scan de adentro corre
117 veces (
loops=117). - Cada iteración devuelve en promedio 3,99 eventos: en total,
3,99 × 117 = 467, que es lo que devuelve el
Nested Loop. - Cada iteración tarda unos 0,003 ms: en total, unos 0,35 ms de los 0,81 del join.
- El costo estimado del nodo de adentro (10,36) también es por iteración: el optimizador lo multiplicó por las 77 iteraciones que esperaba.
Y una señal de estimación: el scan de afuera esperaba 77 envíos y hubo 117. Es otra vez el par origen–destino de la Sesión A, más moderado en este par de agencias. Aquí no cambia el plan; con un error de 100 veces, sí.
Error común. Leer
rows=3.99del nodo de adentro como “devolvió 4 filas” oactual time=0.002..0.003como “tardó 3 microsegundos”. Hay que multiplicar porloops. Un nodo conactual time=0.020..0.025 rows=2 loops=5000aporta 10 000 filas y unos 125 ms.
La señal más útil: estimado contra real
Lo primero que se mira en un EXPLAIN ANALYZE es, nodo por nodo, la
diferencia entre rows estimadas y rows reales (por loops). Una
diferencia de 10 veces o más en un nodo de abajo casi siempre explica
una mala decisión de arriba: un nested loop elegido porque el lado de afuera
“tenía 20 filas” y tuvo 40 000, una hash table construida con el lado
grande como en stale.sql, un sort que no entró en work_mem. Se busca el
nodo más bajo donde empieza la diferencia: los de arriba heredan el
error.
Después se pregunta por qué está mal esa estimación. Las causas de este capítulo son casi todas:
| Síntoma | Causa probable | Arreglo |
|---|---|---|
| Error grande en una tabla recién cargada | estadísticas viejas o ausentes | ANALYZE |
| Error en una condición sobre dos columnas de la misma tabla | correlación | CREATE STATISTICS |
| 0,5 % o un tercio exactos | condición sobre una expresión sin estadísticas | índice sobre la expresión, o reescribir |
| Error moderado en columnas con muchos valores | muestra chica | SET STATISTICS más alto |
| Error en un join entre columnas de tablas distintas | uniformidad o correlación entre tablas | a veces ninguno; reescribir |
Arreglar un plan
Una condición que el índice no puede usar
Un índice sobre created_at sirve para buscar valores de created_at. No
sirve para buscar valores de created_at::date: el índice no está ordenado
por esa expresión, y el optimizador no sabe que el día de una fecha está en
un rango de fechas. Con un índice en created_at (consulta date_cast):
 Seq Scan on shipment  (cost=0.00..328.00 rows=60 width=67) (actual time=0.016..1.122 rows=73.00 loops=1)
   Filter: ((created_at)::date = '2026-03-02'::date)
   Rows Removed by Filter: 11927
Sequential scan de las 148 páginas, y la estimación es el 0,5 % por defecto
(12 000 × 0,005 = 60): no hay estadísticas de la expresión. Reescrita como
rango sobre la columna (consulta date_range):
SELECT * FROM shipment
WHERE created_at >= '2026-03-02' AND created_at < '2026-03-03';
Bitmap Heap Scan on shipment (cost=5.04..131.54 rows=74 width=67) (actual time=0.028..0.046 rows=73.00 loops=1)
Recheck Cond: ((created_at >= '2026-03-02 00:00:00-05'::timestamp with time zone) AND (created_at < '2026-03-03 00:00:00-05'::timestamp with time zone))
Heap Blocks: exact=55
Buffers: shared hit=55 read=2
-> Bitmap Index Scan on shipment_created_at_idx (cost=0.00..5.03 rows=74 width=0) (actual time=0.021..0.021 rows=73.00 loops=1)
Index Cond: ((created_at >= '2026-03-02 00:00:00-05'::timestamp with time zone) AND (created_at < '2026-03-03 00:00:00-05'::timestamp with time zone))
Index Searches: 1
Buffers: shared read=2Usa el índice (un bitmap scan, semana 10), lee 57 páginas en vez de 148, y la estimación sale del histograma: 74 contra 73. A una condición que el índice puede usar se le llama a veces sargable (de search argument).
¿Y un índice sobre la expresión created_at::date? No se puede:
ERROR: functions in index expression must be marked IMMUTABLEcreated_at es timestamptz, y qué día es un instante depende de la zona
horaria de la sesión: el mismo envío puede ser del 2 de marzo en Lima y del
3 en Madrid. Una expresión de índice tiene que dar siempre lo mismo para la
misma fila (ser IMMUTABLE), y esta no. El rango sí es correcto: las
constantes '2026-03-02' se interpretan en la zona de la sesión, que en
Chasqui es America/Lima.
Un índice sobre una expresión
Con lower(last_name) sí se puede, porque lower es IMMUTABLE. Es el
caso de una búsqueda que no distingue mayúsculas (en Chasqui, last_name
guarda los dos apellidos):
CREATE INDEX customer_lower_last_name_idx ON customer (lower(last_name));Antes del índice, sequential scan y el 0,5 % por defecto (consulta
lower_no_index); con el índice recién creado, lo usa pero sigue estimando
9 (consulta lower_index):
                        QUERY PLAN
----------------------------------------------------------
 Seq Scan on customer  (cost=0.00..46.00 rows=9 width=51)
   Filter: (lower(last_name) = 'quispe flores'::text)
(2 rows)

                                        QUERY PLAN
-------------------------------------------------------------------------------------------
 Bitmap Heap Scan on customer  (cost=4.35..20.91 rows=9 width=51)
   Recheck Cond: (lower(last_name) = 'quispe flores'::text)
   ->  Bitmap Index Scan on customer_lower_last_name_idx  (cost=0.00..4.34 rows=9 width=0)
         Index Cond: (lower(last_name) = 'quispe flores'::text)
(4 rows)
Lo interesante pasa después de ANALYZE customer (consulta
lower_index_analyzed):
 Index Scan using customer_lower_last_name_idx on customer  (cost=0.28..8.29 rows=1 width=51) (actual time=0.017..0.017 rows=1.00 loops=1)
   Index Cond: (lower(last_name) = 'quispe flores'::text)
   Index Searches: 1
Estima 1 y hay 1. ANALYZE calcula estadísticas de las expresiones
indexadas, como si fueran columnas: se ven en pg_stats con el nombre
del índice en tablename. Un índice sobre una expresión arregla dos cosas a
la vez: el acceso y la estimación.
En PostgreSQL. Para tener estadísticas de una expresión sin crear un índice (que cuesta en cada escritura), desde la versión 14 se puede declarar
CREATE STATISTICS ... ON (lower(last_name)) FROM customer.
Forzar un orden de joins
Una consulta con cuatro tablas y un filtro muy selectivo: los envíos que
viajaron en el vehículo de placa K2U-314, uno de los 24 (consulta
join_order_free):
SELECT c.last_name, s.shipment_id, t.departure_at
FROM customer c
  JOIN shipment s ON s.sender_id = c.customer_id
  JOIN trip t ON t.trip_id = s.trip_id
  JOIN vehicle v ON v.vehicle_id = t.vehicle_id
WHERE v.plate = 'K2U-314';
Hash Join (cost=185.29..504.38 rows=500 width=27) (actual time=0.847..2.065 rows=138.00 loops=1)
Hash Cond: (s.sender_id = c.customer_id)
-> Hash Join (cost=125.79..443.57 rows=500 width=16) (actual time=0.579..1.779 rows=138.00 loops=1)
Hash Cond: (s.trip_id = t.trip_id)
-> Seq Scan on shipment s (cost=0.00..268.00 rows=12000 width=12) (actual time=0.003..0.483 rows=12000.00 loops=1)
-> Hash (cost=122.71..122.71 rows=246 width=12) (actual time=0.562..0.563 rows=91.00 loops=1)
-> Hash Join (cost=1.31..122.71 rows=246 width=12) (actual time=0.019..0.553 rows=91.00 loops=1)
Hash Cond: (t.vehicle_id = v.vehicle_id)
-> Seq Scan on trip t (cost=0.00..103.14 rows=5914 width=16) (actual time=0.004..0.230 rows=5914.00 loops=1)
-> Hash (cost=1.30..1.30 rows=1 width=4) (actual time=0.005..0.005 rows=1.00 loops=1)
-> Seq Scan on vehicle v (cost=0.00..1.30 rows=1 width=4) (actual time=0.003..0.004 rows=1.00 loops=1)
Filter: (plate = 'K2U-314'::text)
-> Hash (cost=37.00..37.00 rows=1800 width=19) (actual time=0.261..0.261 rows=1800.00 loops=1)
-> Seq Scan on customer c (cost=0.00..37.00 rows=1800 width=19) (actual time=0.005..0.115 rows=1800.00 loops=1)(Sin las líneas de Buffers y de memoria.) El primer join es
trip ⋈ vehicle: empieza por el filtro selectivo, como dice la heurística.
De ahí salen 91 viajes (estimaba 5914 / 24 = 246: uniformidad otra vez),
que filtran los 12 000 envíos a 138, y recién entonces se une customer.
Con SET join_collapse_limit = 1, PostgreSQL deja de reordenar los JOIN
explícitos y los hace en el orden escrito:
((customer ⋈ shipment) ⋈ trip) ⋈ vehicle (consulta join_order_forced):
 Hash Join  (cost=237.88..606.04 rows=500 width=27) (actual time=1.051..4.816 rows=138.00 loops=1)
   Hash Cond: (t.vehicle_id = v.vehicle_id)
   ->  Hash Join  (cost=236.56..567.67 rows=12000 width=31) (actual time=1.013..4.336 rows=11500.00 loops=1)
         Hash Cond: (s.trip_id = t.trip_id)
         ->  Hash Join  (cost=59.50..359.08 rows=12000 width=23) (actual time=0.233..2.192 rows=12000.00 loops=1)
               Hash Cond: (s.sender_id = c.customer_id)
               ->  Seq Scan on shipment s  (cost=0.00..268.00 rows=12000 width=12) (actual time=0.002..0.447 rows=12000.00 loops=1)
               ->  Hash  (cost=37.00..37.00 rows=1800 width=19) (actual time=0.230..0.230 rows=1800.00 loops=1)
                     ->  Seq Scan on customer c  (cost=0.00..37.00 rows=1800 width=19) (actual time=0.001..0.101 rows=1800.00 loops=1)
         ->  Hash  (cost=103.14..103.14 rows=5914 width=16) (actual time=0.755..0.755 rows=5914.00 loops=1)
               ->  Seq Scan on trip t  (cost=0.00..103.14 rows=5914 width=16) (actual time=0.002..0.295 rows=5914.00 loops=1)
   ->  Hash  (cost=1.30..1.30 rows=1 width=4) (actual time=0.007..0.008 rows=1.00 loops=1)
         ->  Seq Scan on vehicle v  (cost=0.00..1.30 rows=1 width=4) (actual time=0.005..0.005 rows=1.00 loops=1)
               Filter: (plate = 'K2U-314'::text)
Los resultados intermedios son de 12 000 y 11 500 tuplas, y el filtro por placa llega al final. Mismo resultado (138 filas), costo 606 contra 504, 4,8 ms contra 2,1. La diferencia crece con el tamaño de las tablas.
Con join_collapse_limit = 1 el optimizador no busca un orden. Eso se usa
cuando una consulta tiene tantas tablas que planificarla cuesta más que
ejecutarla y quien la escribe sabe cuál es el orden bueno. Fuera de eso, no
conviene: el orden escrito queda fijo, y los datos cambian.
Idea clave. Forzar el plan (
join_collapse_limit, o los parámetrosenable_hashjoin,enable_seqscan, etc. puestos enoff) sirve para diagnosticar: ver cuánto costaría y cuánto tardaría la alternativa. Para arreglar, casi siempre es mejor darle al optimizador la información que le falta (estadísticas, un índice, una consulta reescrita), y dejar que elija.
✂️ Vistas materializadas
Una vista materializada guarda el resultado de una consulta como una tabla (sec. 16.5). Una consulta que la usa no recalcula nada; a cambio, hay que mantenerla cuando cambian las tablas de las que depende. El libro describe el mantenimiento incremental: calcular solo el cambio del resultado a partir del cambio de las entradas (para un join, el join de las tuplas nuevas con la otra relación), y cómo el optimizador puede usar una vista materializada para responder una consulta que no la menciona.
PostgreSQL tiene CREATE MATERIALIZED VIEW y REFRESH MATERIALIZED VIEW,
que recalcula todo desde cero: no hay mantenimiento incremental ni el
optimizador reemplaza consultas por la vista. Sirve para reportes que se
pueden permitir datos de hace un rato.
En el laboratorio
El laboratorio repite el recorrido del capítulo en chasqui_big, donde las
tablas son más grandes y las estadísticas salen de una muestra: leer pg_stats de status, created_at y sender_id; estimar a
mano una igualdad y un rango con el histograma y comparar con EXPLAIN;
ver qué pasa con una copia recién cargada antes y después de ANALYZE;
probar CREATE STATISTICS; reescribir created_at::date y
lower(last_name); y forzar un orden malo de joins. Todo lo que crea
(índices, la copia, estadísticas extendidas) cambia esa base: háganlo en su
propio contenedor. Guarden los planes en EXPLAIN (ANALYZE, FORMAT JSON):
en P4 los van a comparar con los planes de quipu.
El código de la semana y make test
Dentro del contenedor, en code/week-12, make crea chasqui_w12 y hace
VACUUM (ANALYZE), y make test la vuelve a crear y corre las pruebas.
(El VACUUM es porque la carga a veces deja páginas vacías al final del
archivo, que cambiarían los costos de los planes.)
$ make test
chasqui-load chasqui_w12
...
✔ stats.sql: tamaños y estadísticas del catálogo
✔ equivalences.sql: el optimizador baja los filtros y arma joins
...
✔ compare: shipment.created_at >= 2026-06-01 da lo mismo que EXPLAIN
...
ℹ tests 29
ℹ pass 29
ℹ fail 0| Archivo | Qué muestra |
|---|---|
stats.sql |
pg_class y pg_stats; selectividad de igualdades, rangos, ∧, ∨, ¬ y de un join por clave foránea |
equivalences.sql |
El producto cartesiano frente al plan con joins; tamaños intermedios; semi join; la trampa del outer join |
correlated.sql |
Columnas correlacionadas y CREATE STATISTICS con dependencies, mcv y ndistinct |
stale.sql |
Una tabla sin ANALYZE y el mismo join antes y después |
plans.sql |
Pasadas de la programación dinámica, orden de joins, loops, EXPLAIN ANALYZE de un UPDATE, reescrituras e índice sobre una expresión |
selectivity.mjs |
Estimación de la selectividad de un predicado a partir de pg_stats, comparada con EXPLAIN y con lo real |
sqlfile.mjs |
Lee los .sql y los corre en orden para las pruebas |
*.test.mjs |
Las cifras de este capítulo y las funciones de selectivity.mjs |
Las consultas de los .sql que revisan las pruebas están marcadas con una
línea -- name: .... examples.test.mjs corre cada archivo completo y en
orden, igual que psql -f, y revisa las cifras que cita el capítulo:
filas estimadas y reales, costos y forma de los planes. Los archivos crean
índices, tablas y estadísticas y los borran al terminar; por eso las pruebas
corren una después de otra (--test-concurrency=1).
selectivity.mjs
selectivity.mjs tiene dos partes. La
primera son funciones puras, sin base de datos, que reciben las
estadísticas como un objeto:
const stats = {
  nullFrac: 0.1,
  mcv: [{ value: 5, freq: 0.2 }, { value: 35, freq: 0.1 }],
  histogram: [0, 10, 20, 30, 40],
};
inequalitySelectivity(stats, '<', 25); // 0.2 + 0.6 × 0.625 = 0.575
histogramFraction(bounds, v) busca con búsqueda binaria el bucket que
contiene a v e interpola dentro de él; inequalitySelectivity(stats, op, v, distinct) suma los MCV que cumplen la condición y le agrega la fracción
del histograma por la parte de las filas que el histograma describe (con
distinct, hace además la corrección de PostgreSQL entre < y <=; sin
él, es la cuenta del libro); equalitySelectivity es la de la igualdad. En
el ejemplo, el 5 cuenta entero (0,2), y 25 está a la mitad del tercer
bucket: el histograma aporta 2,5 de 4 buckets del 60 % de filas que
describe. Las pruebas usan estadísticas inventadas como esta, que se pueden
calcular a mano.
La segunda parte lee las estadísticas de verdad. loadStats lee la fila de
pg_stats y convierte los MCV y los límites del histograma a números (las
fechas, a segundos desde 1970). histogram_bounds es de tipo anyarray, que
no se puede convertir directamente: se pasa a texto y del texto al arreglo
del tipo de la columna (histogram_bounds::text::timestamptz[]). compare
hace la estimación y la compara con EXPLAIN y con un count(*). El valor
va siempre como parámetro ($1). Los nombres de tabla y de columna no
pueden ir como parámetros: se escapan con client.escapeIdentifier, y el
operador se elige de una lista fija. Una prueba comprueba que un valor como
2026-01-01' OR true -- no cambia la consulta, sino que falla como fecha
inválida.
Resumen
- El optimizador transforma la expresión de álgebra relacional de una consulta en planes equivalentes, estima el costo de cada uno con estadísticas y elige el más barato. El costo es una estimación.
- Las reglas de equivalencia (cascada y conmutatividad de selecciones, selección sobre producto como join, conmutatividad y asociatividad del join, bajar selecciones y proyecciones) generan las alternativas. En la consulta de Arequipa y Cusco, bajar las selecciones lleva de un producto de 626 400 000 tuplas a resultados intermedios de 89, 822 y 61. Con outer joins, una selección sobre el lado de los nulos no baja como si nada.
- Hay (2(n − 1))! / (n − 1)! órdenes de join: 665 280 para 7 tablas.
- El catálogo guarda n_r, b_r, V(A, r) e histogramas. Equi-depth describe
mejor que equi-width. En PostgreSQL:
reltuples,relpagesypg_stats(null_frac,n_distinct, MCV,histogram_boundsde lo que no es MCV,correlation), calculados porANALYZEsobre una muestra de 30 000 filas. - Selectividad: igualdad 1 / V(A, r) o la frecuencia del MCV; rango por interpolación en el histograma; ∧ como producto, ∨ como 1 − ∏(1 − s_i), ¬ como 1 − s menos los nulos. Sin estadísticas, PostgreSQL usa 0,5 % para la igualdad y un tercio para una desigualdad.
- Join por clave foránea: n_s tuplas. En general, n_r · n_s / max(V(A, r), V(A, s)). Los errores se multiplican en cada join.
- El supuesto de independencia falla con columnas relacionadas (20
veces en city → region, 24 en
registeredsin viaje).CREATE STATISTICScondependenciesarregla las dependencias funcionales;mcv, las combinaciones frecuentes;ndistinct, losGROUP BY. Las estadísticas viejas se arreglan conANALYZE. - La programación dinámica guarda el mejor plan de cada uno de los 2ⁿ
subconjuntos: O(3ⁿ), u O(n · 2ⁿ) con left-deep trees como System R, que
además guarda planes para los órdenes interesantes. Las heurísticas
bajan selecciones y proyecciones y evitan productos cartesianos. Las
subconsultas con
EXISTSse convierten en semi joins. - PostgreSQL usa programación dinámica hasta
geqo_threshold= 12 tablas y GEQO desde ahí; reordena hastajoin_collapse_limit= 8 joins.cost=está en páginas secuenciales:seq_page_cost= 1,random_page_cost= 4,cpu_tuple_cost= 0,01. EXPLAIN ANALYZEejecuta la consulta y muestraactual time,rowsyloopspor nodo (en el lado de adentro de un nested loop, por iteración) yBuffers. La señal más útil es una diferencia de 10 veces entre filas estimadas y reales en un nodo bajo.- Arreglos comunes:
ANALYZE,CREATE STATISTICS, reescribir condiciones sobre expresiones como rangos sobre la columna, índices sobre expresiones (que además traen estadísticas), y forzar un orden solo para diagnosticar.
Ejercicios
- Escriban en álgebra relacional “nombre de los clientes de Arequipa con
envíos a agencias de la región Cusco” como un producto cartesiano
seguido de una selección y una proyección. Apliquen reglas de
equivalencia, una por paso y diciendo cuál, hasta llegar a un árbol con
las selecciones abajo, joins en vez de productos y las proyecciones
bajadas. ¿Qué atributos de
shipmenthay que conservar hasta el último join? - Demuestren con un contraejemplo de dos tuplas que
Π_A(E₁ − E₂) ≠ Π_A(E₁) − Π_A(E₂). Después, en Chasqui, escriban dos
consultas con
EXCEPTsobrecustomeryshipmentque muestren la diferencia. - ¿Es cierto que σ_θ(E₁ ⟕ E₂) = σ_θ(E₁) ⟕ E₂ cuando θ usa solo atributos de
E₁? ¿Y cuando usa solo atributos de E₂? Justifiquen con la semántica de
NULLy compruébenlo con dos consultas sobreagencyyroute. customertiene 200 000 tuplas, V(city) = 50 y V(last_name) = 5000. Estimen cuántas tuplas devuelvecity = 'Arequipa' AND last_name = 'Quispe'con el supuesto de independencia, y cuántas concity = 'Arequipa' OR last_name = 'Quispe'. ¿En qué caso el supuesto sería peligroso? Den un ejemplo de dos columnas de Chasqui en que lo sea.shipmenttiene 2·10⁶ tuplas ytriptiene 50 000;trip_ides clave detripy el 2 % de los envíos tienetrip_idnulo. Estimen el tamaño deshipment ⋈ trip. Si además se filtratrippordeparture_aten un mes de un período de 24 meses con distribución uniforme, ¿cuántas tuplas estiman?- Con los datos de
pg_statsdechasqui_w12, estimen a mano las filas deshipmentconcreated_at < '2026-02-15': identifiquen el bucket, la fracción del histograma y la parte de los MCV. Comparen conEXPLAINy connode selectivity.mjs shipment created_at '<' 2026-02-15. - Para un join de 5 tablas, ¿cuántos órdenes de join hay con árboles de cualquier forma? ¿Y solo left-deep? ¿Cuántos subconjuntos guarda la programación dinámica? Si cada plan de subconjunto tarda 1 µs en costearse, ¿cuánto tarda la programación dinámica de árboles de cualquier forma con 12 tablas, y con 20? ¿Por qué PostgreSQL deja de usarla?
- En un
EXPLAIN ANALYZE, el lado de afuera de unNested Loopestimarows=20y devuelve 40 000, y elIndex Scande adentro muestraactual time=0.010..0.012 rows=3 loops=40000. ¿Cuántas filas y cuánto tiempo aporta en total el nodo de adentro? ¿Qué plan habría elegido probablemente el optimizador con la estimación correcta, y qué harían para corregirla? - Repitan el experimento de
shipment_origincon la agencia de destino: una tabla condest_cityydest_regionde cada envío. Midan conEXPLAIN ANALYZEla estimación dedest_city = 'Juliaca' AND dest_region = 'Puno'antes y después deCREATE STATISTICS ... (dependencies). ¿Qué grados de dependencia salen enpg_stats_ext? ¿Por qué uno es 1 y el otro no? Condest_region = 'Puno'sola, ¿cuántas ciudades hay detrás? Borren la tabla al terminar. - Escriban la consulta “cantidad de envíos por día de marzo de 2026” de
dos formas: con
GROUP BY created_at::datey unWHEREsobrecreated_at::date, y con unWHEREpor rango. Con un índice sobrecreated_at, comparen planes yBuffers. ¿ElGROUP BYtambién impide usar el índice? ¿Por qué? - La consulta de
join_order_freeune cuatro tablas en cadena:customer – shipment – trip – vehicle. ¿Cuántos órdenes left-deep hay sin productos cartesianos? Conjoin_collapse_limit = 1, escriban los que empiezan porvehicleo porcustomery anoten costo y tiempo de cada uno. ¿Coincide el orden por costo con el orden por tiempo? ¿Por qué podría no coincidir? - (Desafío) Agreguen a
selectivity.mjsuna funciónrangeSelectivity(stats, lo, hi, distinct)paralo <= A AND A < hi. PostgreSQL no multiplica las dos selectividades: reconoce el rango y calcula sel(A >= lo) + sel(A < hi) − 1. ¿Por qué esa fórmula es mejor que el producto? Escriban una prueba que compare conEXPLAINpara un rango de fechas deshipment.