
Apuntes · Capítulo 11Almacenamiento, índices y consultas
Procesamiento de consultas: costo, selección, ordenamiento y joins
Procesamiento de consultas: costo, selección, ordenamiento y joins
En la semana 9 vimos cómo PostgreSQL guarda una tabla: un heap file de
páginas de 8 KiB, con slotted pages y un buffer pool que decide qué páginas
están en memoria. En la semana 10 le pusimos índices encima: un B+ tree que,
dada una clave de búsqueda, devuelve los RID de las tuplas que la tienen.
Con esas dos piezas ya se puede responder una consulta. Falta lo que las
une: el código que toma SELECT ... FROM customer JOIN shipment ... y lo
convierte en lecturas de páginas, comparaciones, hash tables y
ordenamientos.
Esta semana abrimos ese código. La pregunta sigue siendo la de la semana 9,
¿cuántas veces hay que ir al disco?, pero ahora la hacemos para cada
operador del álgebra relacional. Una selección se puede resolver leyendo
toda la tabla o bajando por un índice; un join, con al menos cinco
algoritmos distintos; un ORDER BY sobre una tabla que no entra en memoria
necesita un algoritmo de ordenamiento que no es el de Algoritmos. Para cada
uno vamos a dar el algoritmo, su costo en bloques y seeks, y un ejemplo con
números. Después vamos a ver los mismos algoritmos dentro de PostgreSQL con
EXPLAIN ANALYZE, y vamos a comprobar que el motor elige entre ellos con
las mismas cuentas que hacemos en papel.
El capítulo tiene dos partes. En la primera (Sesión A) vemos el recorrido completo de una consulta, las medidas de costo, los algoritmos de selección y el ordenamiento externo. En la segunda (Sesión B) vemos los algoritmos de join, las demás operaciones (eliminación de duplicados, agregación, operaciones de conjuntos) y cómo se ejecuta un plan entero: materializando cada resultado intermedio o pasando las tuplas de un operador al siguiente, con el modelo de iteradores. En el laboratorio implementan ese modelo en Node.js; es el esqueleto del proyecto P4. La semana 12 cierra el tramo con la otra mitad del problema: cómo el optimizador elige uno de todos estos planes.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “El recorrido de una consulta” y “Medidas de costo”. Sesión B: “El ejemplo de la sesión” y “Nested loop join”, de “Algoritmos de join”.
- En clase. Sesión A: “Selección” y “Ordenamiento externo”. Sesión B: “Algoritmos de join”, “Otras operaciones”, “Evaluación de expresiones” y “El modelo de iteradores”.
- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 15.1–15.7. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-11, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
El recorrido de una consulta
Cuatro etapas
Una consulta SQL dice qué se quiere, no cómo obtenerlo. Entre el texto que escriben y las páginas que se leen hay cuatro etapas (sec. 15.1):
- Parsing y traducción. El parser revisa la sintaxis, comprueba que las tablas y columnas existan (consultando el diccionario de datos de la semana 9) y traduce la consulta a una representación interna, que es esencialmente una expresión del álgebra relacional.
- Optimización. Una misma consulta tiene muchas expresiones equivalentes, y cada operación de cada expresión se puede ejecutar con varios algoritmos. El optimizador (query optimizer) elige la combinación que estima más barata.
- Plan de evaluación. El resultado de la optimización es un plan de evaluación (query-evaluation plan, o simplemente plan): un árbol de operadores en el que cada nodo dice qué operación hace y con qué algoritmo. Una operación del álgebra con su algoritmo es una primitiva de evaluación (evaluation primitive).
- Evaluación. El motor de ejecución (query-execution engine) toma el plan, lo ejecuta y devuelve las tuplas.
Un ejemplo con Chasqui. La consulta “cuánto facturan los remitentes de cada ciudad” es
SELECT c.city, sum(s.price)
FROM customer c JOIN shipment s ON s.sender_id = c.customer_id
GROUP BY c.city;
y en álgebra relacional es una agregación sobre un join:
city γ sum(price) ( customer ⋈ customer_id = sender_id shipment )Esa expresión todavía no dice cómo leer customer ni cómo hacer el join.
El plan sí. Este es el que eligió PostgreSQL en chasqui_w11, la base de
datos de esta semana (joins.sql, consulta hash):
                               QUERY PLAN
------------------------------------------------------------------------
 HashAggregate (actual rows=25.00 loops=1)
   Group Key: c.city
   Batches: 1  Memory Usage: 32kB
   Buffers: shared read=167
   ->  Hash Join (actual rows=12000.00 loops=1)
         Hash Cond: (s.sender_id = c.customer_id)
         Buffers: shared read=167
         ->  Seq Scan on shipment s (actual rows=12000.00 loops=1)
               Buffers: shared read=148
         ->  Hash (actual rows=1800.00 loops=1)
               Buckets: 2048  Batches: 1  Memory Usage: 97kB
               Buffers: shared read=19
               ->  Seq Scan on customer c (actual rows=1800.00 loops=1)
                     Buffers: shared read=19
Se lee de abajo hacia arriba y de adentro hacia afuera. Las hojas son dos
sequential scans: uno de las 19 páginas de customer y otro de las 148 de
shipment. Con customer se arma una hash table (nodo Hash); las tuplas
de shipment la consultan en el nodo Hash Join, y el resultado, 12 000
tuplas, sube a un HashAggregate que suma por ciudad y devuelve 25 grupos.
Cada nodo es una primitiva de evaluación: “join con el algoritmo hash join”,
“agregación con hash”, “selección con búsqueda lineal”. Este capítulo es el
catálogo de esas primitivas.
En PostgreSQL. Todos los planes de este capítulo se obtuvieron con
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF, SUMMARY OFF)y conSET max_parallel_workers_per_gather = 0, para que no aparezcan nodos de ejecución paralela.ANALYZEejecuta la consulta de verdad y muestra las filas reales (actual rows);BUFFERSmuestra cuántas páginas tocó cada nodo,hitsi estaban en el buffer pool yreadsi hubo que pedírselas al sistema operativo.COSTS OFFyTIMING OFFquitan las estimaciones y los tiempos, que cambian en cada corrida. Si repiten una consulta, el reparto entrehityreadpuede cambiar (depende de qué haya en la caché), pero la suma no. Las líneasPlanning: Buffersque aparecen a veces son las páginas del catálogo que leyó el planificador; no son parte de la ejecución.
Esta semana tomamos el plan como dado y preguntamos cuánto cuesta ejecutar cada nodo. La semana 12 da vuelta la pregunta: cómo elige el optimizador entre todos los planes posibles sin ejecutar ninguno.
Medidas de costo
Qué se mide
El costo de una consulta se podría medir en tiempo de CPU, en accesos a disco o, en un sistema distribuido, en datos enviados por la red. En un DBMS que trabaja sobre disco, el término que domina es el del disco: una lectura cuesta lo que miles o millones de instrucciones. El libro (sec. 15.2) mide el costo con el modelo de la semana 9:
costo = b · t_T + S · t_Sdonde b es el número de bloques transferidos, S el número de seeks (posicionamientos aleatorios), t_T el tiempo de transferir un bloque y t_S el tiempo de un seek más la latencia rotacional. Con los valores del libro para un disco magnético, t_S = 4 ms y t_T = 0,1 ms; para un SSD, t_S ≈ 90 µs y t_T ≈ 10 µs. Un seek cuesta lo que 40 transferencias en el disco magnético, y lo que 9 en el SSD: en los dos casos leer en orden es mucho más barato que saltar.
Para las fórmulas usamos la notación del libro:
| Símbolo | Significado |
|---|---|
| n_r | número de tuplas de la relación r |
| b_r | número de bloques (páginas) que ocupa r |
| M | páginas de memoria disponibles para el operador |
| h_i | altura del índice i (páginas que se leen para llegar a una hoja) |
| t_T, t_S | tiempo de una transferencia y de un seek |
Tres simplificaciones, todas del libro:
- Se ignora la CPU. En la práctica no es despreciable (el optimizador de PostgreSQL le asigna un costo a cada tupla procesada), pero no cambia el orden entre los algoritmos que vamos a comparar.
- No se cuenta la escritura del resultado final. Es la misma para todos los algoritmos que calculan la misma operación, y muchas veces el resultado no se escribe: se pasa al operador siguiente o al cliente.
- Supuesto pesimista: el buffer pool empieza vacío. Cada página que el algoritmo necesita se lee del disco la primera vez. Si la página ya está en memoria, el costo real es menor. Lo que sí se cuenta es la memoria que el algoritmo tiene para trabajar: las M páginas.
El libro distingue además el tiempo de respuesta del consumo total de recursos: con varios discos en paralelo, un plan puede responder antes usando más recursos. Los optimizadores suelen minimizar el consumo, que no depende de la carga del sistema, y eso es lo que medimos aquí.
Idea clave. El costo de un algoritmo se cuenta en páginas y seeks, no en tuplas. Dos algoritmos que leen la misma cantidad de tuplas pueden diferir en cien veces si uno lee páginas seguidas y el otro salta entre páginas distintas.
Los datos de referencia
Para las cuentas del capítulo usamos números redondos inspirados en
chasqui_big, la versión grande de Chasqui que vieron en la semana 9. Son
supuestos, del mismo estilo que los ejemplos del libro:
| Relación | n (tuplas) | b (páginas) |
|---|---|---|
shipment |
2 000 000 | 33 000 |
customer |
200 000 | 2000 |
Más adelante los comparamos con los números reales. Para medirlos se usan
las columnas relpages y reltuples de pg_class, que ANALYZE
actualiza. En chasqui_w11 (selection.sql, consultas sizes y
memory):
 relname  |  b  |   n
----------+-----+-------
 customer |  19 |  1800
 shipment | 148 | 12000
(2 rows)

 work_mem | block_size |  m
----------+------------+-----
 4MB      | 8192       | 512
(1 row)
La segunda consulta calcula M para PostgreSQL. Cada operador que ordena o
arma una hash table puede usar hasta work_mem de memoria antes de empezar
a escribir en archivos temporales; con el valor por defecto, 4 MB, son 512
páginas de 8 KiB. Ese es el M de las fórmulas.
En la copia de chasqui_big que crea make big (big.sql, consulta
sizes), los números reales son estos:
       relname       |   b   |    n
---------------------+-------+---------
 customer            |  2040 |  201800
 shipment            | 24667 | 2012000
 shipment_sender_idx |  2286 | 2012000
(3 rows)
customer se parece mucho al supuesto. shipment ocupa 24 667 páginas en
vez de 33 000: sus tuplas son algo más chicas de lo que supusimos (unas 82
por página en vez de 61). Al final de la sección de joins rehacemos las
cuentas con estos números.
Selección
La selección σ_θ(r) devuelve las tuplas de r que cumplen la condición θ. Es la operación más simple y la base de todas las demás: casi cualquier plan tiene selecciones en las hojas. El libro (sec. 15.3) numera los algoritmos de A1 a A10. Los costos, con el modelo de arriba, son estos:
| Algoritmo | Condición | Costo |
|---|---|---|
| A1, búsqueda lineal | cualquiera | t_S + b_r · t_T |
| A1, búsqueda lineal | igualdad sobre una clave | en promedio t_S + (b_r / 2) · t_T |
| A2, clustered index | igualdad sobre una clave | (h_i + 1)(t_T + t_S) |
| A3, clustered index | igualdad sobre una no clave | h_i (t_T + t_S) + t_S + b · t_T |
| A4, índice secundario | igualdad sobre una clave | (h_i + 1)(t_T + t_S) |
| A4, índice secundario | igualdad sobre una no clave | (h_i + n)(t_T + t_S) |
| A5, clustered index | comparación | h_i (t_T + t_S) + t_S + b · t_T |
| A6, índice secundario | comparación | (h_i + n)(t_T + t_S) |
En la tabla, b es el número de bloques que contienen tuplas que cumplen la condición y n el número de tuplas que la cumplen. Vamos por partes.
A1: búsqueda lineal
El algoritmo más simple: leer todas las páginas de r, en orden, y quedarse
con las tuplas que cumplen θ. Cuesta un seek (para llegar al primer bloque,
si el archivo está guardado en bloques contiguos) y b_r transferencias.
Sobre shipment:
t_S + b_r · t_T = 4 ms + 33 000 × 0,1 ms = 4 ms + 3300 ms ≈ 3,3 sSi la condición es una igualdad sobre una clave (shipment_id = 4242), se
puede parar en cuanto se encuentra la tupla: en promedio se lee la mitad
del archivo. La búsqueda lineal tiene una ventaja que ningún otro algoritmo
tiene: sirve siempre, con cualquier condición, con o sin índices, con
el archivo ordenado o no. Por eso es el punto de comparación de todos los
demás.
En chasqui_w11, status no tiene índice, y WHERE status = 'returned'
solo se puede resolver así (selection.sql, consulta a1):
                    QUERY PLAN
---------------------------------------------------
 Seq Scan on shipment (actual rows=319.00 loops=1)
   Filter: (status = 'returned'::text)
   Rows Removed by Filter: 11681
   Buffers: shared hit=148
Las 148 páginas, las 12 000 tuplas (319 que pasan y 11 681 que no). Así se
ve A1 en PostgreSQL: un Seq Scan con un Filter.
A2 y A3: con un clustered index
Recuerden de la semana 10 que un clustered index (índice primario en el libro) es uno cuyo orden coincide con el orden físico del archivo. Para una igualdad sobre una clave (A2) se baja por el árbol, h_i páginas, y se lee la única página de datos que tiene la tupla: h_i + 1 lecturas, y cada una puede estar en cualquier parte del disco, así que cada una lleva su seek. Con un B+ tree de altura 3:
(h_i + 1)(t_T + t_S) = 4 × (0,1 + 4) ms = 16,4 msDoscientas veces menos que la búsqueda lineal.
Si la condición es una igualdad sobre una no clave (A3), puede haber varias tuplas, pero como el archivo está ordenado por esa misma clave, están juntas: en b bloques consecutivos. El costo es bajar por el árbol, un seek para llegar al primer bloque y b transferencias seguidas: h_i (t_T + t_S) + t_S + b · t_T.
A4: con un índice secundario
Un índice secundario está ordenado por una clave distinta del orden del archivo. Si la condición es una igualdad sobre una clave candidata, A4 es igual que A2: una tupla, h_i + 1 lecturas. La diferencia aparece con una no clave: las n tuplas que cumplen la condición están repartidas por el archivo, y en el peor caso cada una está en una página distinta. Cada tupla cuesta una lectura aleatoria:
(h_i + n)(t_T + t_S)Con los datos de referencia, un cliente manda en promedio 10 envíos (2·10⁶
envíos entre 200 000 clientes). Para encontrar los envíos de un cliente con
un índice secundario de altura 3 en shipment(sender_id):
(3 + 10) × 4,1 ms = 53,3 msSigue siendo mucho mejor que 3,3 s. Pero la fórmula crece con n, y la de la búsqueda lineal no. ¿Desde cuántas tuplas conviene más leer toda la tabla?
(3 + n) × 4,1 ms > 3304 ms ⇔ n > 802,9Desde unas 800 tuplas (el 0,04 % de la tabla), el índice secundario
pierde. Si la consulta fuera sender_id < 20000 y devolviera 200 000
tuplas, A4 costaría 200 003 × 4,1 ms ≈ 820 s, contra los 3,3 s del
sequential scan. Es la misma cuenta que hicimos en la semana 10 para
explicar por qué un índice no siempre ayuda. En un SSD, con t_S + t_T =
0,1 ms, el punto de equilibrio sube: la búsqueda lineal cuesta 0,09 + 33 000
× 0,01 ≈ 330 ms y el índice pierde desde unas 3300 tuplas.
A5 y A6: comparaciones
Para created_at >= '2026-06-01' o shipment_id < 200:
- A5, con clustered index. Se busca en el índice el primer valor que
cumple (o se empieza por el principio del archivo, si la condición es
<) y desde ahí se lee el archivo en orden: es un rango de bloques contiguos. Cuesta lo mismo que A3: h_i (t_T + t_S) + t_S + b · t_T. - A6, con índice secundario. Se recorren las hojas del índice desde el primer valor que cumple, y por cada entrada se lee la tupla del archivo. Cuesta lo mismo que A4, (h_i + n)(t_T + t_S), y por la misma razón pierde frente a A1 en cuanto n es grande.
Lo que hace PostgreSQL
En PostgreSQL. Las tablas son heap files y todos los índices son secundarios (semana 10): no hay un clustered index en el sentido del libro.
CLUSTERreordena la tabla una vez según un índice, pero las inserciones y actualizaciones posteriores no mantienen ese orden. Lo que PostgreSQL sí sabe es cuán ordenada está la tabla por cada columna: lo guarda en la columnacorrelationdepg_stats.
chasqui_w11 se cargó en orden de shipment_id, así que la tabla está
físicamente ordenada por esa columna. Por sender_id y created_at, en
cambio, el orden es aleatorio (selection.sql, consulta correlation):
   attname   | correlation
-------------+-------------
 created_at  |      -0.001
 sender_id   |       0.020
 shipment_id |       1.000
(3 rows)
Con correlación 1, el índice de la clave primaria se comporta como un
clustered index. Los índices de esta semana tienen altura 2 (make crea
shipment_sender_idx y shipment_created_at_idx, los de la semana 10; la
consulta heights lo muestra con bt_metap, cuyo level cuenta desde las
hojas como nivel 0, así que h_i = level + 1). Una igualdad sobre la clave
primaria (pk_eq, shipment_id = 4242) es un Index Scan que toca
h_i + 1 = 3 páginas (Buffers: shared hit=3). Una comparación sobre la
clave primaria (pk_range, shipment_id < 200), que con correlación 1 es
el A5 del libro, devuelve 199 tuplas tocando solo 5 páginas: las 2 del
índice y 3 del heap, seguidas.
El remitente 53 tiene 10 envíos. Con el índice secundario de sender_id
(a4):
                                 QUERY PLAN
----------------------------------------------------------------------------
 Bitmap Heap Scan on shipment (actual rows=10.00 loops=1)
   Recheck Cond: (sender_id = 53)
   Heap Blocks: exact=10
   Buffers: shared hit=10 read=2
   ->  Bitmap Index Scan on shipment_sender_idx (actual rows=10.00 loops=1)
         Index Cond: (sender_id = 53)
         Index Searches: 1
         Buffers: shared read=2
Exactamente lo que predice A4: h_i = 2 páginas del índice y una página del
heap por tupla (Heap Blocks: exact=10), 12 en total. Las 10 tuplas están
en 10 páginas distintas.
El bitmap scan
El plan anterior no es un Index Scan sino un bitmap scan, en dos
nodos. Es el término medio de PostgreSQL entre A1 y A6:
- El
Bitmap Index Scanrecorre el índice y, en vez de ir al heap por cada entrada, marca en un bitmap en memoria las páginas (y los slots) que tienen tuplas que cumplen. - El
Bitmap Heap Scanrecorre el bitmap en orden de página y lee cada página marcada una sola vez.
Con eso, dos tuplas que están en la misma página cuestan una lectura y no
dos, y las páginas se leen en orden físico, lo que aprovecha el read-ahead.
Si el bitmap no entra en work_mem, se vuelve lossy: guarda solo la
página, no el slot, y entonces el Bitmap Heap Scan tiene que volver a
evaluar la condición sobre cada tupla de la página. Esa es la condición de
la línea Recheck Cond; Heap Blocks: exact=10 dice que aquí el bitmap
fue exacto y no hizo falta.
El bitmap scan no hace milagros cuando la condición devuelve muchas tuplas
repartidas. En chasqui_w11, created_at >= '2026-06-20' devuelve 507
tuplas, apenas el 4 % (range_small):
                                       QUERY PLAN
----------------------------------------------------------------------------------------
 Bitmap Heap Scan on shipment (actual rows=507.00 loops=1)
   Recheck Cond: (created_at >= '2026-06-20 00:00:00-05'::timestamp with time zone)
   Heap Blocks: exact=147
   Buffers: shared hit=147 read=3
   ->  Bitmap Index Scan on shipment_created_at_idx (actual rows=507.00 loops=1)
         Index Cond: (created_at >= '2026-06-20 00:00:00-05'::timestamp with time zone)
         Index Searches: 1
         Buffers: shared read=3
pero, como created_at tiene correlación ≈ 0, esas 507 tuplas están en 147
de las 148 páginas. El bitmap scan lee casi toda la tabla, más el índice.
Con una condición que devuelve el 69 % de las tuplas (range_large,
created_at >= '2026-03-01'), el planificador ya no usa el índice: es un
Seq Scan de las 148 páginas con Rows Removed by Filter: 3751.
Error común. Juzgar un índice por el porcentaje de tuplas que devuelve la condición. Lo que importa es cuántas páginas distintas hay que leer, y eso depende de la correlación. Con
shipment_id < 200, 199 tuplas cuestan 5 páginas; concreated_at >= '2026-06-20', 507 tuplas cuestan 150.
Conjunciones, disyunciones y negaciones
Una condición compuesta se puede resolver de varias formas (sec. 15.3.3):
- A7, conjunción con un índice. Para θ₁ ∧ θ₂ ∧ … se elige la condición θ_i más selectiva que tenga un índice, se resuelve con A2–A6 y las demás se comprueban en memoria sobre cada tupla traída.
- A8, conjunción con un índice compuesto. Si hay un índice sobre
(sender_id, created_at), una condición sobre las dos columnas es una sola búsqueda (semana 10). - A9, conjunción por intersección de identificadores. Se usa un índice por cada condición, cada uno devuelve un conjunto de RID, se intersectan y se leen solo las tuplas de la intersección. Si algunas condiciones no tienen índice, se comprueban después.
- A10, disyunción por unión de identificadores. Para θ₁ ∨ θ₂, si todas las condiciones tienen índice, se unen los conjuntos de RID. Si una sola no tiene índice, no queda más que la búsqueda lineal: las tuplas que cumplen esa condición pueden estar en cualquier parte.
- Negación, ¬θ: casi siempre la cumplen la mayoría de las tuplas, y lo razonable es la búsqueda lineal. Si pocas tuplas cumplen ¬θ y hay un índice, se puede usar.
En PostgreSQL, A9 y A10 son los nodos BitmapAnd y BitmapOr: cada
Bitmap Index Scan arma un bitmap y el nodo los intersecta o los une
página por página. Con una condición sobre sender_id y otra sobre
created_at (conj):
                                                             QUERY PLAN
------------------------------------------------------------------------------------------------------------------------------------
 Bitmap Heap Scan on shipment (actual rows=39.00 loops=1)
   Recheck Cond: ((sender_id >= 100) AND (sender_id <= 140) AND (created_at >= '2026-06-01 00:00:00-05'::timestamp with time zone))
   Heap Blocks: exact=37
   Buffers: shared hit=42 read=5
   ->  BitmapAnd (actual rows=0.00 loops=1)
         Buffers: shared hit=5 read=5
         ->  Bitmap Index Scan on shipment_sender_idx (actual rows=216.00 loops=1)
               Index Cond: ((sender_id >= 100) AND (sender_id <= 140))
               Index Searches: 1
               Buffers: shared hit=2 read=1
         ->  Bitmap Index Scan on shipment_created_at_idx (actual rows=1889.00 loops=1)
               Index Cond: (created_at >= '2026-06-01 00:00:00-05'::timestamp with time zone)
               Index Searches: 1
               Buffers: shared hit=3 read=4
La primera condición sola marca 216 tuplas; la segunda, 1889. La
intersección deja 39 tuplas en 37 páginas, y solo esas se leen del heap.
(El actual rows=0.00 del BitmapAnd no es un error: el nodo produce un
bitmap, no tuplas.)
Cuando una de las condiciones ya es muy selectiva, no vale la pena usar el
segundo índice: es A7. En sender_id = 53 AND status = 'delivered'
(conj_one), el plan es el mismo Bitmap Heap Scan de A4, con una línea
Filter: (status = 'delivered'::text) que comprueba la segunda condición
sobre las 10 tuplas traídas.
Una disyunción en la que las dos condiciones tienen índice es A10 (disj,
sender_id = 53 OR created_at >= '2026-06-25'): un BitmapOr une el
bitmap de los 10 envíos del remitente con el de los 141 de los últimos
días, y el Bitmap Heap Scan lee 86 páginas para devolver 151 tuplas.
Basta con que una de las condiciones de la disyunción no tenga índice para
que la unión de RID ya no sirva: sender_id = 53 OR status = 'returned'
(disj_seq) es un Seq Scan de las 148 páginas con las dos condiciones en
el Filter. La negación sender_id <> 53, que cumplen 11 990 de las
12 000 tuplas, también se resuelve con un Seq Scan (neg).
Error común. Pensar que
OR“suma” índices igual queAND. En una conjunción, una condición sin índice no estorba: se filtra al final. En una disyunción, una condición sin índice obliga a leer toda la tabla, porque cualquier tupla podría cumplirla.
Ordenamiento externo
Para qué se ordena
Ordenar aparece en todas partes dentro de un DBMS (sec. 15.4): para
ORDER BY, para el merge join (que necesita las dos relaciones
ordenadas por la clave del join), para la eliminación de duplicados y
la agregación (con la relación ordenada, las tuplas iguales quedan
juntas) y para construir un B+ tree desde cero (bulk loading, semana 10).
Si la relación entra en memoria, se ordena con cualquier algoritmo interno
(quicksort, por ejemplo). El problema es cuando no entra: shipment ocupa
33 000 páginas y tenemos M = 512. Ordenar una relación que está en disco y
no entra en memoria es ordenamiento externo (external sort), y el
algoritmo clásico es el external merge sort.
El algoritmo
Tiene dos fases. Sea M el número de páginas de memoria.
Fase 1: crear runs ordenados. Se leen M páginas de la relación, se ordenan en memoria y se escriben a disco como un run (una secuencia ordenada). Se repite con las M páginas siguientes, hasta terminar. Quedan ⌈b_r / M⌉ runs, cada uno de M páginas (salvo el último).
Fase 2: fusionar los runs. Si hay N runs y N < M, se puede reservar una página de memoria para cada run y una para la salida, y fusionarlos todos a la vez, como en el paso de merge del merge sort, pero con N entradas en vez de dos:
leer la primera página de cada run
repetir:
    elegir la menor tupla entre las primeras de cada run (en orden)
    escribirla en la página de salida; si se llena, escribirla a disco
    quitarla de su página de entrada; si esa página se vacía,
        leer la siguiente página del mismo run
hasta que se acaben todos los runs
Si hay más runs que páginas (N ≥ M), no se pueden fusionar todos a la vez. Se fusionan de a M − 1 (M − 1 páginas de entrada y una de salida): cada grupo de M − 1 runs produce un run M − 1 veces más largo. Eso es una pasada de fusión. Se hacen tantas pasadas como haga falta hasta que quede un solo run.
Un ejemplo pequeño
Tomemos una relación de 12 páginas con una tupla por página (los precios 24, 19, 31, 33, 14, 16, 21, 3, 2, 7, 14, 9) y M = 3.
Fase 1. Se leen de a 3 páginas y se ordenan: quedan ⌈12 / 3⌉ = 4 runs, R0 a R3.
Fase 2. Con M = 3 se fusionan de a M − 1 = 2 runs. Primera pasada: R0 con R1 y R2 con R3, que dan R4 y R5. Segunda pasada: R4 con R5, que da R6.
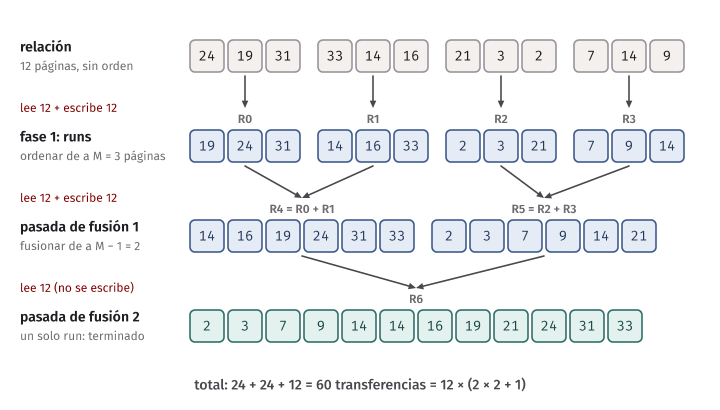
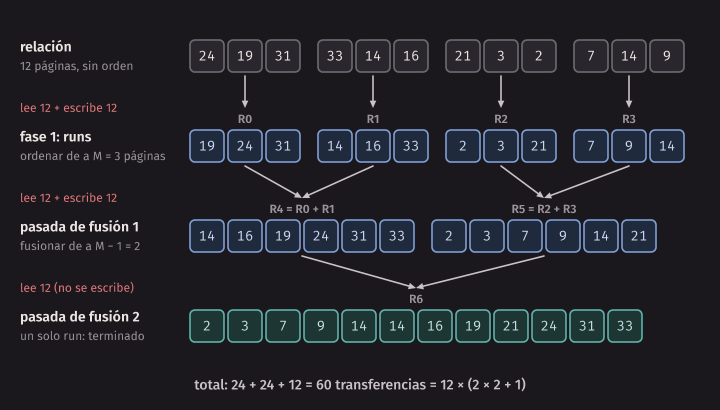
Hicieron falta dos pasadas de fusión: ⌈log₂(12 / 3)⌉ = ⌈log₂ 4⌉ = 2.
El costo
Cada pasada (la de creación de runs y cada pasada de fusión) lee y escribe la relación entera. Con ⌈b_r / M⌉ runs iniciales y fusiones de M − 1 vías, el número de pasadas de fusión es
⌈log_{M−1}(b_r / M)⌉La creación de runs cuesta 2 b_r transferencias (leer y escribir); cada pasada de fusión, otras 2 b_r. La escritura de la última pasada no se cuenta (es el resultado final; ver la sección de medidas de costo). En total:
transferencias = b_r (2 ⌈log_{M−1}(b_r / M)⌉ + 1)En el ejemplo pequeño: 12 × (2 × 2 + 1) = 60. Contando a mano: 24 de la fase 1, 24 de la primera pasada y 12 de la lectura de la segunda.
Los seeks dependen de cuántas páginas de buffer se le dan a cada run. Si se le da una sola, cada página leída de un run está en otro lugar del disco que la anterior, y cada lectura es un seek. Por eso, en la práctica, a cada run se le da un bloque de b_b páginas de buffer: se lee de a b_b páginas con un seek. Entonces se fusionan ⌊M / b_b⌋ − 1 runs a la vez (en vez de M − 1) y el libro da:
pasadas      = ⌈log_{⌊M/b_b⌋−1}(b_r / M)⌉
transferencias = b_r (2 · pasadas + 1)
seeks        = 2 ⌈b_r / M⌉ + ⌈b_r / b_b⌉ (2 · pasadas − 1)
Los 2 ⌈b_r / M⌉ seeks son los de la fase 1 (leer y escribir cada run). En la fusión hay un seek por cada bloque de b_b páginas leído o escrito, salvo la escritura de la última pasada. Un b_b más grande baja los seeks, pero fusiona menos runs a la vez y puede agregar pasadas.
Ejemplo resuelto: ordenar shipment
Ordenar shipment por created_at, con b_r = 33 000 y work_mem = 4 MB,
es decir M = 512 páginas de 8 KiB, con b_b = 1:
- Runs: ⌈33 000 / 512⌉ = 65 (64 de 512 páginas y uno de 232).
- Pasadas de fusión: ⌈log₅₁₁ 65⌉ = 1. Con 511 vías se fusionan los 65 runs de una vez.
- Transferencias: 33 000 × (2 × 1 + 1) = 99 000.
Con muy poca memoria, M = 20:
- Runs: ⌈33 000 / 20⌉ = 1650.
- Pasadas: ⌈log₁₉ 1650⌉ = 3, porque 19² = 361 < 1650 ≤ 19³ = 6859.
- Transferencias: 33 000 × (2 × 3 + 1) = 231 000.
Con M = 102, que usaremos en los joins: ⌈33 000 / 102⌉ = 324 runs, ⌈log₁₀₁ 324⌉ = 2 pasadas y 33 000 × 5 = 165 000 transferencias.
| M | runs | pasadas de fusión | transferencias |
|---|---|---|---|
| 20 | 1650 | 3 | 231 000 |
| 102 | 324 | 2 | 165 000 |
| 512 | 65 | 1 | 99 000 |
| ≥ 33 000 | 1 | 0 | 33 000 |
La tabla muestra algo que vale la pena recordar: con poca memoria, la memoria extra vale mucho; con bastante, casi nada. Con dos pasadas (una para crear runs y una de fusión) se ordena cualquier relación de hasta M (M − 1) ≈ M² páginas: con M = 512, unas 260 000 páginas, 2 GiB. Por eso casi cualquier tabla se ordena en una o dos pasadas de fusión.
Error común. Aplicar log₂ a la fusión, como en el merge sort de Algoritmos. La base del logaritmo es M − 1 (o ⌊M / b_b⌋ − 1): el número de runs que se fusionan a la vez. Con log₂, ordenar
shipmentcon M = 512 parecería necesitar ⌈log₂ 65⌉ = 7 pasadas; en realidad necesita una.
El ordenamiento externo en PostgreSQL
price no tiene índice, así que ORDER BY price obliga a ordenar. Con
work_mem = 4 MB, las 148 páginas de shipment de chasqui_w11 entran en
memoria y el plan dice Sort Method: quicksort Memory: 1413kB (sort.sql,
consulta in_memory). Con SET work_mem = '64kB', M = 8 páginas, ya no
entran (external):
                        QUERY PLAN
-----------------------------------------------------------
 Sort (actual rows=12000.00 loops=1)
   Sort Key: price
   Sort Method: external merge  Disk: 1000kB
   Buffers: shared hit=148, temp read=246 written=271
   ->  Seq Scan on shipment (actual rows=12000.00 loops=1)
         Buffers: shared hit=148
external merge es el external merge sort, y temp read y temp written
cuentan las páginas leídas y escritas en archivos temporales, que es donde
viven los runs. Para ver los runs y las pasadas, PostgreSQL tiene el
parámetro trace_sort, que escribe en el log (y, con client_min_messages = log, también en psql) cada paso del ordenamiento (traced; omitimos
los tiempos de CPU al final de cada línea y 23 líneas iguales de runs):
LOG:  begin tuple sort: nkeys = 1, workMem = 64, randomAccess = f
LOG:  worker -1 switching to external sort with 6 tapes
LOG:  worker -1 finished writing run 1 to tape 1
LOG:  worker -1 finished writing run 2 to tape 2
...
LOG:  worker -1 finished writing run 25 to tape 1
LOG:  performsort of worker -1 starting
LOG:  worker -1 finished writing run 26 to tape 2
LOG:  worker -1 using 56 KB of memory for tape buffers
LOG:  starting merge pass of 26 input runs on 6 tapes, 2 KB of memory for each input tape
LOG:  starting merge pass of 5 input runs on 5 tapes, 9 KB of memory for each input tape
LOG:  performsort of worker -1 done (except 5-way final merge)
LOG:  external sort of worker -1 ended, 125 disk blocks used
La fase 1 escribió 26 runs. Después hay una pasada que fusiona los 26 runs en 5, y una fusión final de 5 vías. Son dos pasadas de fusión, lo mismo que da la fórmula con M = 8: ⌈log₇(148 / 8)⌉ = ⌈log₇ 19⌉ = 2. Tres detalles separan a PostgreSQL del algoritmo del libro:
- Los runs no son de M páginas exactas: PostgreSQL llena
work_memcon tuplas en su formato de memoria, que no ocupa lo mismo que en la página. Por eso son 26 runs y no ⌈148 / 8⌉ = 19. - Los runs se reparten en tapes (un nombre que viene de cuando los runs se guardaban en cintas) y la fusión es de a lo sumo 6 vías.
- La última fusión,
except 5-way final merge, no se escribe: el Sort entrega las tuplas a medida que las fusiona. Es exactamente la escritura final que el libro no cuenta.
Por último, si la consulta tiene LIMIT, PostgreSQL no ordena todo: guarda
en un heap las k menores tuplas vistas hasta el momento. Con LIMIT 10
(top_n, también con work_mem = 64 kB), el plan dice Sort Method: top-N heapsort Memory: 26kB: diez tuplas entran en memoria y no hay archivos
temporales.
Algoritmos de join
El join es la operación más importante y la más cara de casi cualquier consulta. El libro (sec. 15.5) presenta cinco algoritmos. Los vamos a costear todos sobre el mismo ejemplo.
El ejemplo de la sesión
Queremos calcular customer ⋈ shipment con la condición customer_id = sender_id (un equi-join: la condición es una igualdad). Con los datos de
referencia:
| Relación | n | b | |
|---|---|---|---|
| r | customer |
200 000 | 2000 |
| s | shipment |
2 000 000 | 33 000 |
y M = 102 páginas de memoria (un número chico a propósito, para que los algoritmos se diferencien). Contamos sobre todo transferencias de bloques; los seeks los damos cuando cambian la conclusión. Como siempre, no se cuenta la escritura del resultado.
r es la relación de afuera (outer) y s la de adentro (inner), en el
sentido de los dos for anidados que vienen ahora.
Nested loop join
El algoritmo más simple: por cada tupla de r, recorrer s entera y combinar las parejas que cumplen la condición θ.
para cada tupla t_r en r:
    para cada tupla t_s en s:
        si (t_r, t_s) cumple θ:
            agregar t_r · t_s al resultado
No necesita índices, ni que la condición sea una igualdad: sirve para cualquier θ. Es la versión directa del producto cartesiano seguido de una selección.
Costo. En el peor caso, solo hay una página de memoria para cada relación. Por cada una de las n_r tuplas de r se lee s entera: n_r · b_s transferencias, más las b_r de leer r una vez. Los seeks son n_r (uno por cada recorrido de s) más b_r (uno por cada página de r, porque entre una página de r y la siguiente se recorrió s):
transferencias = n_r · b_s + b_r
seeks          = n_r + b_r
En el ejemplo: 200 000 × 33 000 + 2000 ≈ 6,6·10⁹ transferencias. A 0,1 ms cada una, son 660 000 s: más de 7 días. Si en cambio la relación más chica entra entera en memoria, se lee una vez cada relación: b_r + b_s transferencias y 2 seeks.
El nested loop join tal cual solo tiene sentido cuando una de las dos relaciones es diminuta o cabe en memoria. Su problema es leer s una vez por cada tupla de r. Los dos algoritmos que siguen atacan eso.
Block nested loop join
La idea: en vez de recorrer s una vez por tupla de r, recorrerla una vez por bloque de r. Si r tiene 100 tuplas en una página, cada página de s se compara con las 100 de golpe.
para cada bloque B_r de r:
    para cada bloque B_s de s:
        para cada tupla t_r en B_r:
            para cada tupla t_s en B_s:
                si (t_r, t_s) cumple θ:
                    agregar t_r · t_s al resultado
Con M páginas de memoria se hace mejor todavía: se usan M − 2 páginas para un bloque grande de r, una página para leer s y una para el resultado. Entonces s se recorre ⌈b_r / (M − 2)⌉ veces:
transferencias = ⌈b_r / (M − 2)⌉ · b_s + b_r
seeks          = 2 ⌈b_r / (M − 2)⌉
En el ejemplo, con customer afuera: ⌈2000 / 100⌉ = 20 bloques, así que
20 × 33 000 + 2000 = 662 000 transferencias, 2 × 20 = 40 seeksEn tiempo, 662 000 × 0,1 ms + 40 × 4 ms ≈ 66 s. Diez mil veces menos que el nested loop join.
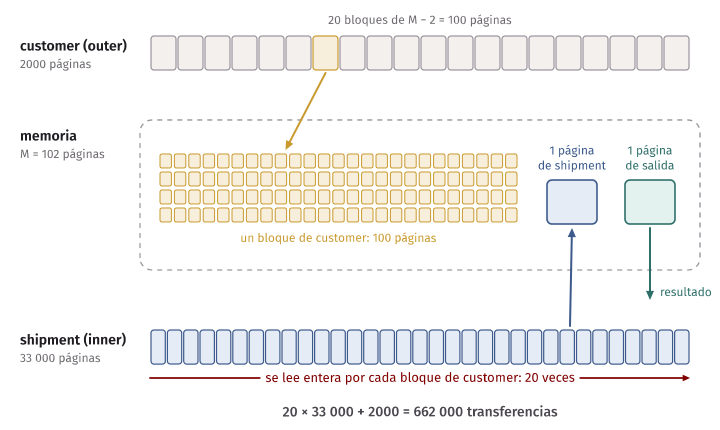
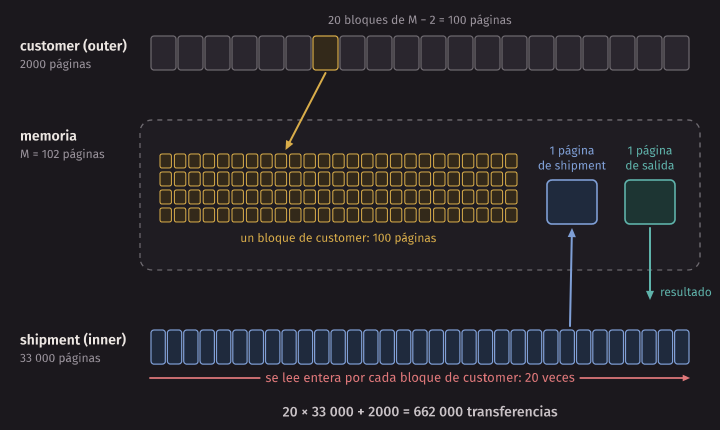
¿Qué relación va afuera? Con shipment afuera, ⌈33 000 / 100⌉ = 330
bloques: 330 × 2000 + 33 000 = 693 000 transferencias. Es peor. El término
dominante es (número de bloques del outer) × (páginas del inner), y conviene
que la relación de afuera sea la más chica en páginas, para que el
inner se recorra menos veces.
Mejor caso. Si la relación de afuera entra entera en memoria (M ≥ b_r +
2), s se recorre una sola vez: b_r + b_s = 35 000 transferencias. Para eso,
con customer afuera, hacen falta 2002 páginas, unos 16 MB.
El libro menciona dos mejoras más: parar el recorrido del inner en cuanto se encuentra la pareja, si la condición es una igualdad sobre una clave del inner, y recorrer el inner alternadamente hacia adelante y hacia atrás, para reusar las páginas que quedaron en el buffer.
Idea clave. Lo que se repite en un nested loop es el recorrido del inner. Hay dos formas de abaratarlo: recorrerlo menos veces (block nested loop, con bloques grandes del outer) o no recorrerlo entero (index nested loop, con un índice).
Index nested loop join
Si s tiene un índice sobre el atributo del join, para cada tupla de r se puede buscar en el índice las tuplas de s que hacen pareja, en vez de recorrer s:
para cada tupla t_r en r:
    buscar en el índice de s las tuplas t_s con t_s.sender_id = t_r.customer_id
    para cada una:
        agregar t_r · t_s al resultado
Cada búsqueda es una selección sobre s con A2–A6. Si c es el costo de una búsqueda:
costo = b_r (t_T + t_S) + n_r · cEl primer término es leer r (en el peor caso, cada página de r con su seek, porque entre una y otra se fue a leer el índice). El segundo, una búsqueda por tupla de r.
En el ejemplo, cada búsqueda en shipment(sender_id) baja un B+ tree de
altura 3 y lee unos 10 envíos en páginas distintas: unas 13 páginas. Para
las 200 000 tuplas de customer:
2000 + 200 000 × 13 = 2 602 000 transferencias, todas aleatoriasMucho peor que el block nested loop. El index nested loop no gana cuando hay que juntar las relaciones enteras.
Pero cambiemos la consulta: solo interesan los clientes de una ciudad
pequeña, con 200 clientes. Ahora r, después de filtrar, tiene 200 tuplas, y
el costo es leer customer (2000 páginas) más 200 búsquedas:
2000 + 200 × (3 + 10) = 4600 transferenciasNo se lee el resto de shipment: de sus 33 000 páginas y las de su índice
solo se tocan unas 2600. Con 10 000 clientes (una ciudad grande), serían 2000 + 10 000 × 13 =
132 000 transferencias, todas aleatorias, y los algoritmos que leen
shipment entera vuelven a ganar.
Error común. Elegir el algoritmo de join por la cantidad de tuplas y no por la de páginas, o suponer que un algoritmo es siempre el mejor. Con un filtro muy selectivo en el outer, el index nested loop lee una fracción mínima de la tabla de adentro; sin filtro, es el peor de los tres que usan índices o memoria.
Merge join
Si las dos relaciones están ordenadas por el atributo del join, se pueden recorrer a la vez, como en el paso de merge del merge sort: se avanza en la que tiene el valor menor, y cuando los valores coinciden se combinan.
p_r = primera tupla de r;  p_s = primera tupla de s
mientras p_r y p_s no se acaben:
    si p_r.customer_id < p_s.sender_id: avanzar p_r
    si p_r.customer_id > p_s.sender_id: avanzar p_s
    si son iguales (valor v):
        S_s = todas las tuplas de s con sender_id = v   (avanzando p_s)
        para cada tupla de r con customer_id = v        (avanzando p_r):
            combinarla con cada tupla de S_s
El conjunto S_s (las tuplas de s con el mismo valor del atributo del join)
tiene que caber en memoria: aquí, los envíos de un mismo remitente, que
son a lo sumo unas decenas. Del lado de customer el atributo es una
clave, así que cada grupo se combina con una sola tupla de customer. Si
los grupos con el mismo valor fueran enormes en las dos relaciones, habría
que combinarlos con un block nested loop.
Merge join solo sirve para equi-joins y natural joins.
Costo. Si las dos relaciones ya están ordenadas, cada página se lee una vez:
transferencias = b_r + b_s
seeks          = ⌈b_r / b_b⌉ + ⌈b_s / b_b⌉
con b_b páginas de buffer por relación. Si no están ordenadas, hay que sumar el external merge sort de cada una y la escritura del resultado ordenado, porque aquí el resultado del sort no es el final: se escribe y el merge lo vuelve a leer. En el ejemplo, con M = 102:
customer: ⌈2000 / 102⌉ = 20 runs, 1 pasada: 2000 × 3 = 6000 transferencias, más 2000 de escribir el resultado ordenado: 8000.shipment: 324 runs, 2 pasadas: 33 000 × 5 = 165 000, más 33 000 de escribirlo: 198 000.- El merge: 2000 + 33 000 = 35 000.
En total, ≈ 241 000 transferencias. Más que el block nested loop con M
= 102, por el costo de ordenar shipment. El merge join es atractivo
cuando las entradas ya vienen ordenadas: porque hay un índice que las
entrega en orden, porque son el resultado de otro merge join o porque la
consulta igual pide ORDER BY sobre la clave del join.
Ojo con “ya vienen ordenadas por un índice”: si el índice es secundario, recorrerlo entrega las tuplas en orden de clave, pero cada una está en otra página del heap, y eso es una lectura aleatoria por tupla. El libro describe para ese caso el hybrid merge join: fusionar con las hojas del índice (que sí están ordenadas) y después ordenar el resultado por dirección física para leer el heap en orden de página, la misma idea del bitmap scan.
Hash join
El hash join usa una función hash para repartir las dos relaciones en particiones de tal forma que solo haya que combinar cada partición de r con la partición correspondiente de s. Funciona solo para equi-joins.
Sea h una función hash que lleva los valores del atributo del join a {0, 1, …, n_h − 1}. Si t_r y t_s hacen pareja, tienen el mismo valor del atributo y, por lo tanto, el mismo h. Entonces las tuplas de r en la partición r_i solo pueden hacer pareja con las tuplas de s en la partición s_i. El join se descompone en n_h joins chicos.
Una de las dos relaciones es la de construcción (build input) y la otra
la de prueba (probe input). Se elige como build la más chica; aquí,
customer. (El libro llama s a la de construcción. Lo que importa es que
sea la más chica, no la letra.)
# fase de particionamiento
para cada tupla t de build:  escribir t en la partición build_{h(t.customer_id)}
para cada tupla t de probe:  escribir t en la partición probe_{h(t.sender_id)}

# fase de build y probe
para i = 0 .. n_h − 1:
    leer build_i y armar en memoria una hash table con otra función h2
    para cada tupla t_p de probe_i:
        buscar en la hash table las tuplas con el mismo valor
        combinar t_p con cada una
Para que funcione, cada partición de build tiene que entrar en memoria como hash table. Por eso n_h se elige como ⌈b_build / M⌉ multiplicado por un factor de holgura (el libro usa f ≈ 1,2), porque la función hash no reparte perfectamente. Las particiones de probe, en cambio, no necesitan entrar: se leen de a una página.
Costo. El particionamiento lee las dos relaciones y las escribe particionadas: 2 (b_r + b_s). La fase de build y probe vuelve a leer cada partición una vez: b_r + b_s. Como cada partición puede tener una página parcialmente llena, el libro agrega hasta 2 n_h páginas por relación:
transferencias = 3 (b_r + b_s) + 4 n_h
seeks          = 2 (⌈b_r / b_b⌉ + ⌈b_s / b_b⌉) + 2 n_h
En el ejemplo, con M = 102: n_h = ⌈2000 / 102⌉ × 1,2 = 20 × 1,2 = 24, que redondeamos a 25 particiones de unas 80 páginas cada una (entran en las 102 de memoria). Entonces:
3 × (2000 + 33 000) + 4 × 25 = 105 100 transferenciasEl mejor de todos los que vimos con M = 102. Si la relación de construcción
entra entera en memoria (M ≥ b_build + 2), no hace falta particionar: se
arma la hash table con customer y se recorre shipment una vez, b_r +
b_s = 35 000 transferencias.
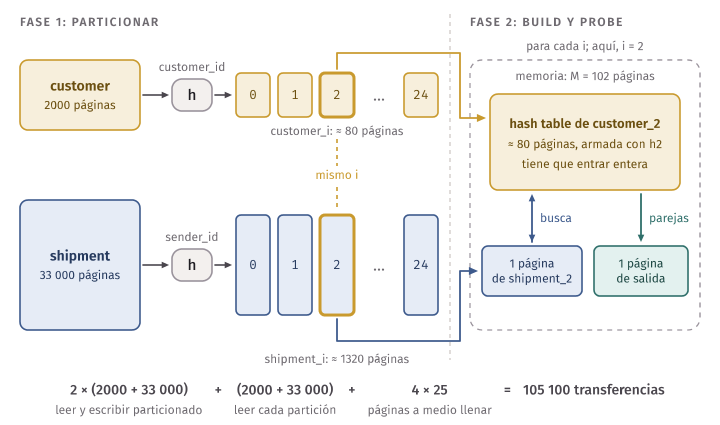
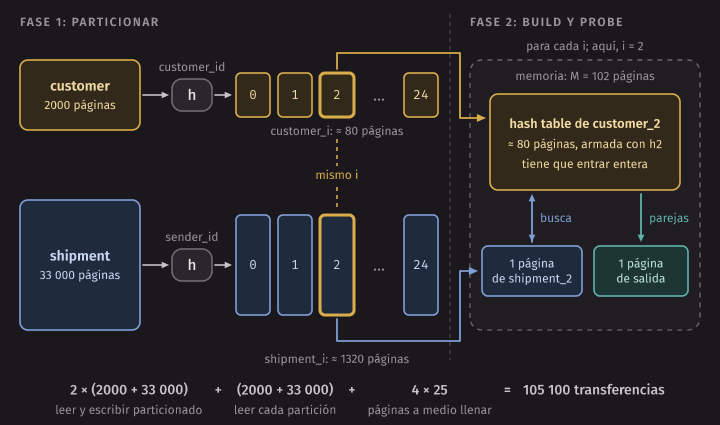
¿Cuánta memoria hace falta? Para particionar en una sola pasada hacen falta n_h + 1 páginas (una por partición de salida y una de entrada), así que n_h < M. Y cada partición de build, de b_build / n_h páginas, tiene que entrar en M. Juntando las dos condiciones, alcanza aproximadamente con
M > √b_buildCon customer, √2000 ≈ 45: M = 102 alcanza de sobra.
Particionamiento recursivo. Si M ≤ √b_build, no se puede particionar en
una pasada en particiones que entren en memoria. Se particiona en tantas
particiones como se pueda (M − 1) y después cada partición se vuelve a
particionar con otra función hash, hasta que entren. Con M = 40, por
ejemplo, customer necesitaría ⌈2000 / 40⌉ × 1,2 = 60 particiones, y solo
hay 39 páginas para ellas: hace falta una segunda pasada. El libro da el
costo con particionamiento recursivo como
2 (b_r + b_s) ⌈log_{⌊M/b_b⌋−1}(b_build) − 1⌉ + b_r + b_s.
Overflow y sesgo. Si demasiadas tuplas caen en la misma partición (un hash malo, o un valor muy repetido), esa partición no entra en memoria: es un overflow. Se resuelve volviendo a particionar esa partición (overflow resolution) o eligiendo desde el inicio más particiones y juntando las chicas (overflow avoidance). Si el sesgo es un solo valor repetido, ninguna función hash lo separa.
Hybrid hash join. Cuando M es bastante más grande que √b_build, sobra memoria durante el particionamiento. El hybrid hash join la usa para guardar la partición 0 de build en memoria, ya como hash table, en vez de escribirla. Las tuplas de probe que caen en la partición 0 se combinan en el momento, sin escribirse. Se ahorra escribir y volver a leer las particiones 0 de las dos relaciones.
Comparación
Con el ejemplo de la sesión (b_r = 2000, b_s = 33 000) y M = 102:
| Algoritmo | Transferencias |
|---|---|
| Nested loop join | ≈ 6,6·10⁹ |
Block nested loop join (customer afuera) |
662 000 |
Index nested loop join (todo customer) |
≈ 2,6·10⁶, aleatorias |
| Merge join (ordenando las dos) | ≈ 241 000 |
| Hash join | ≈ 105 000 |
| Index nested loop join (solo 200 clientes) | ≈ 4600 |
Con M ≥ 2002, block nested loop y hash join cuestan los dos 35 000: la relación chica entra en memoria y cada relación se lee una vez. El mejor algoritmo depende de la memoria, de los índices y de los filtros. Por eso el optimizador no elige con una regla fija, sino calculando el costo de cada alternativa (semana 12).
Estas cuentas están en costs.mjs: una
función por fórmula, y costs.test.mjs
comprueba cada una de las cuentas de este capítulo.
Joins complejos
Dos casos más de la sec. 15.5.6:
- Conjunción θ₁ ∧ θ₂ ∧ …: se hace el join con la condición más conveniente (una igualdad, para poder usar hash o merge) y se comprueban las demás sobre cada pareja.
- Disyunción θ₁ ∨ θ₂: o un nested loop con la condición completa, o la unión de los joins con cada condición por separado.
Una condición que no es una igualdad, como r.distance_km > a.agency_id * 40, no se puede resolver con hash join ni con merge join. Solo queda el
nested loop (o el index nested loop, si hay un índice que sirva para la
desigualdad). En joins.sql, la consulta theta es exactamente ese join,
y PostgreSQL lo resuelve con un Nested Loop y una Join Filter; la
consulta equi_filter tiene una igualdad y una desigualdad, y PostgreSQL
hace un hash join con la igualdad (Hash Cond) y comprueba la desigualdad
en una Join Filter.
Los joins en PostgreSQL
PostgreSQL implementa tres algoritmos de join: Nested Loop (que, con un
índice en el inner, es un index nested loop), Merge Join y Hash
Join. No tiene un block nested loop con bloques de M − 2 páginas del
outer. Lo que sí tiene es el nodo Materialize: guarda las tuplas del
inner la primera vez (en memoria si entran en work_mem, en un archivo
temporal si no), para no recalcularlas en cada vuelta del outer. Es el
nested loop del libro con el inner guardado, no un block nested loop, que
agrupa el outer.
Los parámetros enable_hashjoin, enable_mergejoin y enable_nestloop
desalientan cada algoritmo, para que podamos ver los otros. Volvamos a la
consulta del comienzo en chasqui_w11. El plan que elige el optimizador es
el hash join que ya vimos, con customer (la relación chica) como build y
un solo batch: customer entra entera en memoria y cada tabla se lee una
vez, 19 + 148 = 167 páginas.
Con SET enable_hashjoin = off (joins.sql, consulta merge), estas son
las líneas del plan que importan:
   ->  Merge Join (actual rows=12000.00 loops=1)
         Merge Cond: (c.customer_id = s.sender_id)
         ->  Index Scan using customer_pkey on customer c (actual rows=1800.00 loops=1)
               Buffers: shared hit=22 read=3
         ->  Index Scan using shipment_sender_idx on shipment s (actual rows=12000.00 loops=1)
               Buffers: shared hit=11343 read=13
Un merge join con las dos entradas ordenadas por índices, sin ningún
Sort. Del lado de customer, el índice de la clave primaria tiene
correlación 1 y cuesta 25 páginas. Del lado de shipment, el índice de
sender_id entrega las tuplas en orden, pero cada tupla es una visita a
una página del heap: 11 356 accesos a páginas para leer una tabla de 148.
Es el problema de “ya viene ordenada por un índice secundario” de arriba.
Como todo está en el buffer pool, son hit y la consulta igual es rápida;
con la tabla en disco serían miles de lecturas aleatorias.
Con enable_mergejoin = off también (nestloop), el plan es un Nested Loop con Seq Scan on shipment s afuera y, adentro, estas líneas:
         ->  Memoize (actual rows=1.00 loops=12000)
               Cache Key: s.sender_id
               Hits: 10282  Misses: 1718  Evictions: 0  Overflows: 0  Memory Usage: 191kB
               ->  Index Scan using customer_pkey on customer c (actual rows=1.00 loops=1718)
                     Index Cond: (customer_id = s.sender_id)
                     Buffers: shared hit=5154
Un index nested loop con shipment afuera: por cada uno de los 12 000
envíos se busca su cliente en customer_pkey. Entre los dos hay un nodo
Memoize, una caché de los resultados del inner por valor de la clave: los
12 000 envíos tienen solo 1718 remitentes distintos, así que solo 1718
búsquedas llegan al índice (Misses) y las otras 10 282 se responden desde
la caché (Hits). Cada búsqueda cuesta 3 páginas (h_i + 1 con h_i = 2):
1718 × 3 = 5154.
Y con los tres desalentados (disabled, solo EXPLAIN, sin ejecutar), el
plan es el mismo nested loop, ahora con una línea más:
   ->  Nested Loop
         Disabled: true
enable_* no prohíbe un algoritmo: le suma un costo enorme. Si no queda
otra forma de hacer el join, el planificador usa uno desalentado y lo marca
con Disabled: true.
En PostgreSQL. El hash join de PostgreSQL es un hybrid hash join. La memoria para la hash table es
work_mem×hash_mem_multiplier(por defecto 2, es decir 8 MB). Si la relación de construcción entra, hay un solo batch y no se escribe nada. Si no entra, el nodoHashla reparte enBatches(las particiones del libro, siempre una potencia de 2): el batch 0 se queda en memoria y los demás se escriben en archivos temporales, igual que las tuplas de probe que les corresponden. Si un batch resulta demasiado grande, PostgreSQL duplica el número de batches durante la ejecución: es la overflow resolution del libro.
Para verlo en chasqui_w11 hace falta una relación de construcción más
grande que la memoria. Con SET work_mem = '64kB' y el join de shipment
con shipment_event (batches), la hash table de shipment se parte en 8
batches:
                            QUERY PLAN
-------------------------------------------------------------------
 Hash Join (actual rows=46421.00 loops=1)
   Hash Cond: (e.shipment_id = s.shipment_id)
   Buffers: shared hit=148 read=342, temp read=233 written=233
   ->  Seq Scan on shipment_event e (actual rows=46421.00 loops=1)
         Buffers: shared read=342
   ->  Hash (actual rows=12000.00 loops=1)
         Buckets: 4096  Batches: 8  Memory Usage: 84kB
         Buffers: shared hit=148, temp written=28
         ->  Seq Scan on shipment s (actual rows=12000.00 loops=1)
               Buffers: shared hit=148
Las 233 páginas temporales escritas y vueltas a leer son el costo extra del
particionamiento: 28 del lado de build (el Hash) y el resto del lado de
probe. Son menos páginas que las de las tablas porque en los archivos
temporales solo van las columnas que la consulta necesita
(shipment_id, seq, kind), no la tupla entera.
En la tabla grande
Las cuentas con números redondos predicen que, para el join completo, gana
el hash join, y que para un join selectivo gana el index nested loop.
Comprobémoslo con la copia de chasqui_big de make big (con un índice en
shipment(sender_id), como el de la semana 10) y big.sql. Con work_mem
= 4 MB (consulta hash):
                                QUERY PLAN
--------------------------------------------------------------------------
 HashAggregate (actual rows=26.00 loops=1)
   Group Key: c.city
   Batches: 1  Memory Usage: 40kB
   Buffers: shared read=26707, temp read=4350 written=4350
   ->  Hash Join (actual rows=2012000.00 loops=1)
         Hash Cond: (s.sender_id = c.customer_id)
         Buffers: shared read=26707, temp read=4350 written=4350
         ->  Seq Scan on shipment s (actual rows=2012000.00 loops=1)
               Buffers: shared read=24667
         ->  Hash (actual rows=201800.00 loops=1)
               Buckets: 262144  Batches: 2  Memory Usage: 6664kB
               Buffers: shared read=2040, temp written=426
               ->  Seq Scan on customer c (actual rows=201800.00 loops=1)
                     Buffers: shared read=2040
 Planning:
   Buffers: shared hit=189 read=27
 Planning Time: 0.329 ms
 Execution Time: 698.488 ms
Hash join con customer como build, partido en 2 batches: uno se quedó en
memoria y el otro se escribió (426 páginas temporales del lado de build).
Cada tabla se leyó una vez (2040 + 24 667 = 26 707) y se escribieron y
leyeron 4350 páginas temporales. Con SET work_mem = '256MB'
(hash_big_mem), la hash table de customer entra entera, y el plan es
el mismo con Batches: 1 y sin la línea temp: el caso de b_r + b_s.
Desalentando el hash join y los index scans (merge_sort), queda un merge
join con un Sort debajo de cada entrada. Las dos líneas que importan de
ese plan son las del método de cada sort y la de buffers del merge join:
               Sort Method: external merge  Disk: 43384kB
               Sort Method: external merge  Disk: 4888kB
         Buffers: shared hit=15314 read=11393, temp read=11449 written=11479
Las mismas 26 707 páginas de las tablas, pero 11 479 páginas temporales
escritas en vez de 4350: ordenar cuesta más que particionar. (Si solo se
desalienta el hash join, el planificador usa el índice de sender_id para
entregar shipment en orden, como en chasqui_w11, y el plan toca más de
dos millones de páginas: consulta merge.)
Ahora el join selectivo. La ciudad con menos clientes es Iquitos, con 38
de 201 800 (cities). Con WHERE c.city = 'Iquitos' (selective):
                                      QUERY PLAN
--------------------------------------------------------------------------------------
 Nested Loop (actual rows=370.00 loops=1)
   Buffers: shared hit=2342 read=182
   ->  Seq Scan on customer c (actual rows=38.00 loops=1)
         Filter: (city = 'Iquitos'::text)
         Rows Removed by Filter: 201762
         Buffers: shared hit=2040
   ->  Index Scan using shipment_sender_idx on shipment s (actual rows=9.74 loops=38)
         Index Cond: (sender_id = c.customer_id)
         Index Searches: 38
         Buffers: shared hit=302 read=182
 Planning:
   Buffers: shared hit=8 read=14
 Planning Time: 0.178 ms
 Execution Time: 9.681 ms
Exactamente el index nested loop de la fórmula: leer customer entera
(2040 páginas) y hacer 38 búsquedas en el índice (loops=38), cada una de
unas 3 páginas del índice (bt_metap da altura 3 para este índice, consulta
height) más unos 10 envíos: 484 páginas de shipment y su índice, en vez
de 24 667. En total 2524 páginas y 10 ms, contra 26 707 páginas y 700 ms
del join completo. Con Huaraz, que tiene 7083 clientes (less_selective),
el optimizador vuelve al hash join: 7083 búsquedas costarían más que leer
shipment entera.
En PostgreSQL. Rehagamos las cuentas con los números reales de
chasqui_big, b_customer = 2040, b_shipment = 24 667, y el M por defecto, 512 páginas. Block nested loop: ⌈2040 / 510⌉ = 4 bloques, 4 × 24 667 + 2040 = 100 708 transferencias. Merge join ordenando las dos: 133 535. Hash join sin hybrid: n_h = 5 y 3 × 26 707 + 20 = 80 141. Lo que midió PostgreSQL es todavía menos: 26 707 páginas de las tablas más 2 × 4350 temporales, unas 35 400, porque el hybrid hash join no escribe el batch 0 y porque en los archivos temporales solo van las columnas necesarias. El orden entre los algoritmos es el que predicen las fórmulas.
Otras operaciones
La sec. 15.6 completa el catálogo. Casi todas las operaciones que faltan se resuelven con una de las dos ideas que ya vimos: ordenar (para que las tuplas iguales queden juntas) o hacer hash (para que las tuplas iguales caigan en la misma partición o en la misma entrada de una hash table).
Eliminación de duplicados y proyección
Recuerden que SQL trabaja con multiconjuntos (bags): una consulta puede
devolver tuplas repetidas, y solo DISTINCT, UNION, INTERSECT y
EXCEPT las eliminan. Eliminar duplicados se puede hacer de dos formas:
- Ordenando. Después del sort, las tuplas iguales quedan seguidas y basta con descartar cada tupla igual a la anterior. Mejor aún: los duplicados se pueden descartar durante el external merge sort, al crear los runs y en cada fusión, de modo que los runs se achican pasada a pasada. El costo en el peor caso es el del sort.
- Con hash. Se particiona la relación con una función hash, como en el hash join; cada partición se lee y se arma una hash table en memoria, en la que una tupla se inserta solo si no está ya. El costo es el del particionamiento.
La proyección generalizada π_A(r) se calcula quitando las columnas que
no están en A de cada tupla, que es barato y se hace tupla por tupla. Si la
proyección es con DISTINCT (la proyección del álgebra relacional, que
trabaja con conjuntos), hay que eliminar los duplicados después.
En PostgreSQL, SELECT DISTINCT city FROM customer se resuelve con hash,
con un nodo HashAggregate (other.sql, consulta distinct_hash). Con
SET enable_hashagg = off, ordenando (distinct_sort):
                           QUERY PLAN
----------------------------------------------------------------
 Unique (actual rows=26.00 loops=1)
   ->  Sort (actual rows=1800.00 loops=1)
         Sort Key: city
         Sort Method: quicksort  Memory: 49kB
         ->  Seq Scan on customer (actual rows=1800.00 loops=1)
Unique es el nodo que descarta cada tupla igual a la anterior: 1800
tuplas ordenadas, 26 distintas.
Operaciones de conjuntos
UNION, INTERSECT y EXCEPT se calculan ordenando las dos relaciones y
recorriéndolas a la vez (como en el merge join), o con hash: se particionan
las dos con la misma función y, por cada partición, se arma una hash table
con la partición de r y se recorre la de s:
- r ∪ s: insertar en la hash table las tuplas de s que no estén ya, y al final devolver toda la tabla.
- r ∩ s: devolver las tuplas de s que estén en la tabla.
- r − s: borrar de la tabla las tuplas de s que estén, y al final devolver lo que queda.
En PostgreSQL (intersect y union):
                        QUERY PLAN
----------------------------------------------------------
 HashSetOp Intersect (actual rows=26.00 loops=1)
   ->  Seq Scan on customer (actual rows=1800.00 loops=1)
   ->  Seq Scan on agency (actual rows=29.00 loops=1)
y UNION es un Append de los dos scans (1829 tuplas) seguido de un
HashAggregate que deja 26: literalmente “concatenar y eliminar
duplicados”. UNION ALL, que no elimina duplicados, sería solo el
Append.
Outer join
Un outer join se calcula modificando los algoritmos de join (sec. 15.6.4).
Para r ⟕ s (left outer join), con nested loop: por cada tupla de r, si
después de recorrer s no encontró ninguna pareja, se devuelve la tupla de r
completada con NULL. Con merge join, lo mismo cuando una tupla de r no
tiene pareja en s. Con hash join, depende de cuál sea la relación de
construcción: si r es la de prueba, se completa con NULL cada tupla de r
que no encuentra pareja; si r es la de construcción, se marca cada tupla de
la hash table que encontró pareja y, al terminar la fase de probe, se
devuelven las que quedaron sin marcar.
El segundo caso es el que eligió PostgreSQL para contar los envíos de cada
cliente, incluidos los que no mandaron ninguno (outer_join):
                               QUERY PLAN
------------------------------------------------------------------------
 HashAggregate (actual rows=1800.00 loops=1)
   Group Key: c.customer_id
   Batches: 1  Memory Usage: 217kB
   ->  Hash Right Join (actual rows=12082.00 loops=1)
         Hash Cond: (s.sender_id = c.customer_id)
         ->  Seq Scan on shipment s (actual rows=12000.00 loops=1)
         ->  Hash (actual rows=1800.00 loops=1)
               Buckets: 2048  Batches: 1  Memory Usage: 80kB
               ->  Seq Scan on customer c (actual rows=1800.00 loops=1)
customer es la relación de construcción y es el lado que se preserva:
Hash Right Join quiere decir que se conservan las tuplas del lado
derecho del plan, el de la hash table. Los 12 000 envíos hacen pareja con
algún cliente, y al final se agregan los 82 clientes que no mandaron
ninguno: 12 082 tuplas.
Agregación
GROUP BY con funciones de agregación se implementa como la eliminación
de duplicados: ordenando o con hash, para juntar las tuplas de cada grupo.
La diferencia es que, en vez de descartar las tuplas repetidas, se las
combina. Y no hace falta guardar las tuplas de un grupo: basta un
acumulador por grupo que se actualiza a medida que llegan.
count,sum,minymaxtienen acumuladores obvios.avgguarda la suma y la cantidad, y divide al final.
Con hash, la hash table tiene una entrada por grupo, no por tupla. Por
eso la agregación con hash suele entrar en memoria aunque la relación no
entre: 12 000 envíos, 4 estados, 4 acumuladores (group_hash):
                        QUERY PLAN
-----------------------------------------------------------
 HashAggregate (actual rows=4.00 loops=1)
   Group Key: status
   Batches: 1  Memory Usage: 32kB
   ->  Seq Scan on shipment (actual rows=12000.00 loops=1)
Ordenando (group_sort, con enable_hashagg = off), el plan es un
Sort de las 12 000 tuplas y encima un GroupAggregate, que recorre la
entrada ordenada y emite un grupo cada vez que cambia status. El
resultado de los dos planes es el mismo (group_result):
   status   | count | avg_price
------------+-------+-----------
 delivered  | 11115 |     60.45
 in_transit |    66 |     70.33
 registered |   500 |     58.52
 returned   |   319 |     63.61
(4 rows)
La agregación con hash es uno de los operadores de
P4 (HashAggregate).
Evaluación de expresiones
Hasta aquí costeamos cada operador por separado. Un plan tiene varios, y la salida de uno es la entrada del siguiente. Hay dos formas de pasar esas tuplas de un operador a otro (sec. 15.7).
Materialización
La forma más simple: evaluar los operadores de abajo hacia arriba, y que cada uno escriba su resultado completo en una relación temporal en disco, que el operador de arriba lee después. Es la materialización (materialized evaluation).
Funciona con cualquier operador, pero cuesta: al costo de cada operador hay que sumarle el de escribir su resultado y el de volver a leerlo. Si un resultado intermedio tiene b páginas, son 2b transferencias más (b para escribir, b para leer). Con doble buffering (dos buffers de salida: uno se llena mientras el otro se escribe) la CPU y el disco trabajan en paralelo y baja el tiempo, pero no las transferencias.
Pipelining
La alternativa: que las tuplas pasen de un operador al siguiente a
medida que se producen, sin escribirse. En el plan σ_θ(customer) ⋈ shipment, la selección puede entregar cada cliente que cumple θ
directamente al join, sin escribir una relación temporal con los clientes
filtrados. Es el pipelining (pipelined evaluation). Ahorra las
escrituras y lecturas intermedias, y además el plan empieza a entregar
resultados antes de terminar.
Hay dos formas de organizar un pipeline:
- Por demanda (demand-driven, o pull). El operador de arriba le pide una tupla al de abajo cuando la necesita. La raíz del plan pide tuplas hasta que se acaban, y cada pedido se propaga hacia las hojas. Es el modelo de iteradores de la sección siguiente, y el que usan PostgreSQL y casi todos los sistemas.
- Por producción (producer-driven, o push). Cada operador produce tuplas tan rápido como puede y las deja en un buffer para el operador de arriba; si el buffer se llena, espera. Es natural en sistemas paralelos.
No todo operador puede trabajar en pipeline. Un operador bloqueante (blocking operator) necesita leer toda su entrada antes de producir la primera tupla de salida:
- El sort: la primera tupla ordenada puede ser la última que llega.
- La fase de construcción del hash join: hasta no tener toda la relación de construcción en la hash table, no se puede saber si una tupla de probe tiene pareja. La fase de probe, en cambio, sí es pipeline: cada tupla de probe se combina y se entrega en el momento.
- La agregación: un grupo no está completo hasta haber visto todas las
tuplas (salvo que la entrada venga ordenada por la clave del grupo, como
en el
GroupAggregate).
Un plan real mezcla las dos formas: es un conjunto de pipelines separados por operadores bloqueantes, que materializan su entrada (en memoria si entra, en archivos temporales si no). El libro describe también joins diseñados para pipelines, como el double-pipelined hash join, que arma hash tables de las dos entradas a la vez y emite parejas a medida que llegan tuplas de cualquiera de las dos.
Pipelining en PostgreSQL
LIMIT muestra el pipelining por demanda mejor que cualquier explicación.
Para cinco envíos devueltos (other.sql, consulta limit_pipeline):
                      QUERY PLAN
-------------------------------------------------------
 Limit (actual rows=5.00 loops=1)
   Buffers: shared hit=3
   ->  Seq Scan on shipment (actual rows=5.00 loops=1)
         Filter: (status = 'returned'::text)
         Rows Removed by Filter: 141
         Buffers: shared hit=3
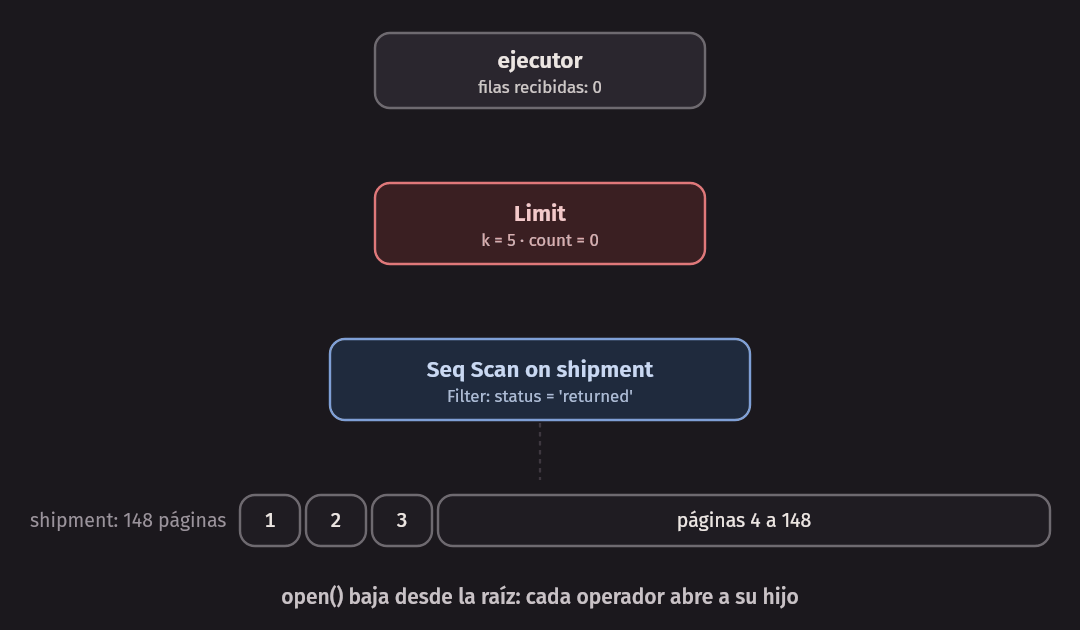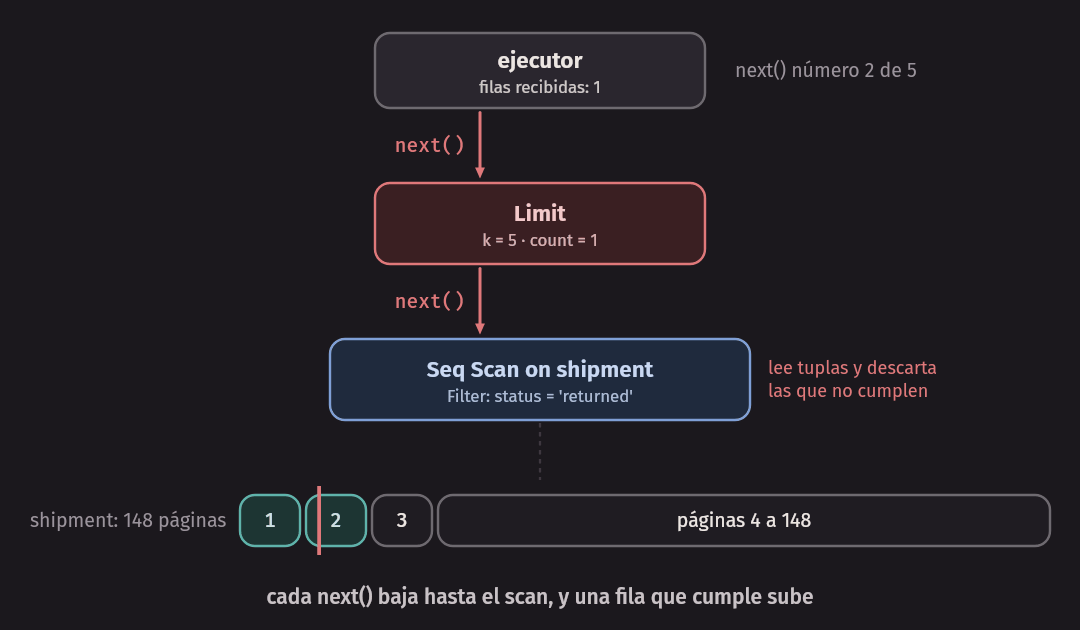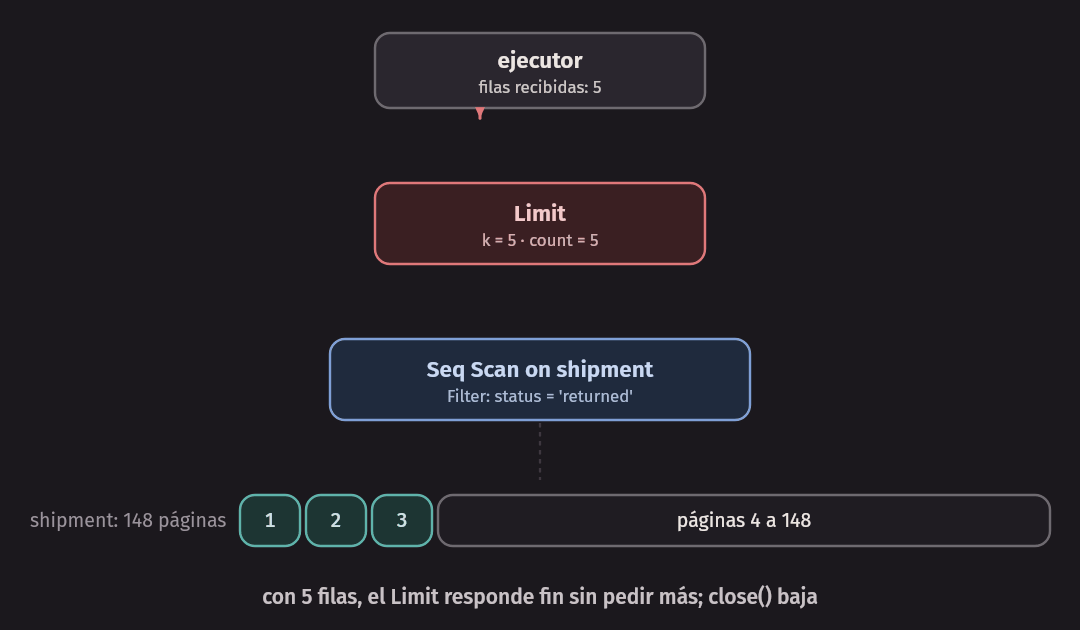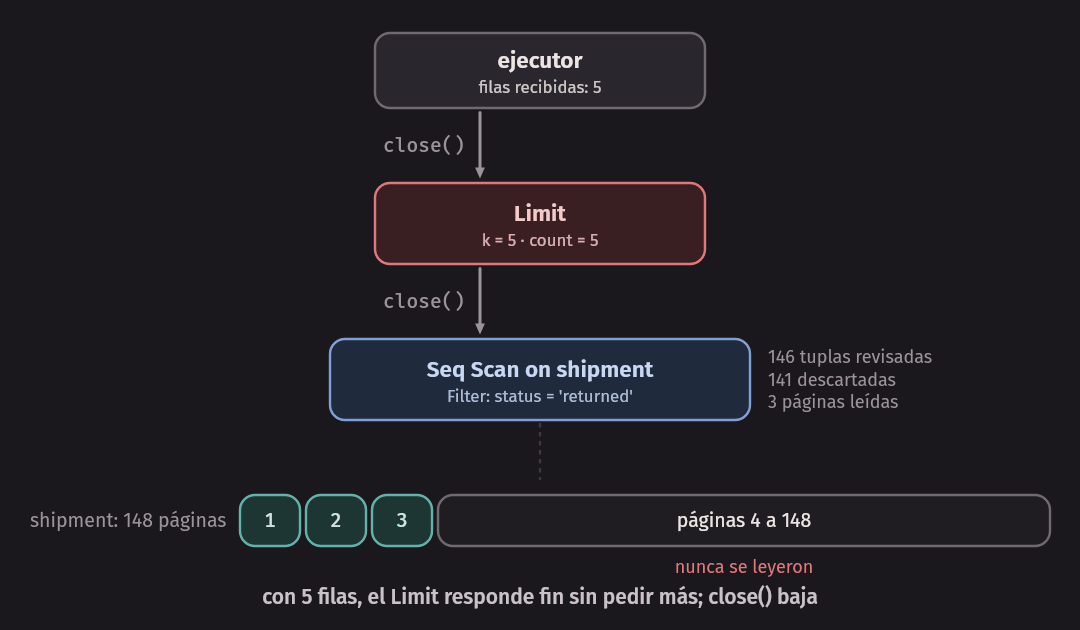
El Seq Scan leyó 3 páginas de 148 y revisó 146 tuplas. Cuando el
Limit tuvo sus cinco filas dejó de pedir, y el scan nunca leyó el resto
de la tabla. Agreguemos un operador bloqueante, ORDER BY price
(limit_blocking):
                          QUERY PLAN
---------------------------------------------------------------
 Limit (actual rows=5.00 loops=1)
   Buffers: shared hit=151
   ->  Sort (actual rows=5.00 loops=1)
         Sort Key: price
         Sort Method: top-N heapsort  Memory: 26kB
         Buffers: shared hit=151
         ->  Seq Scan on shipment (actual rows=319.00 loops=1)
               Filter: (status = 'returned'::text)
               Rows Removed by Filter: 11681
               Buffers: shared hit=148
El Sort le entregó 5 filas al Limit, pero antes tuvo que pedirle al
scan las 319 que cumplen la condición: las 148 páginas.
En PostgreSQL. Un CTE con
MATERIALIZEDse evalúa aparte y su resultado se guarda en un tuplestore (el nodoCTE Scanlo lee). Pero PostgreSQL lo llena a pedido: conLIMIT 5encima, el CTE también se detiene en las 5 primeras tuplas (cte_materialized: 3 páginas leídas).MATERIALIZEDimpide que el optimizador mezcle el CTE con la consulta de afuera; no obliga a calcularlo entero antes de empezar.
El modelo de iteradores
open, next, close
El pipelining por demanda se implementa con el modelo de iteradores (sec. 15.7.2), también llamado modelo Volcano por el sistema de investigación que lo popularizó. Cada operador es un objeto con tres operaciones:
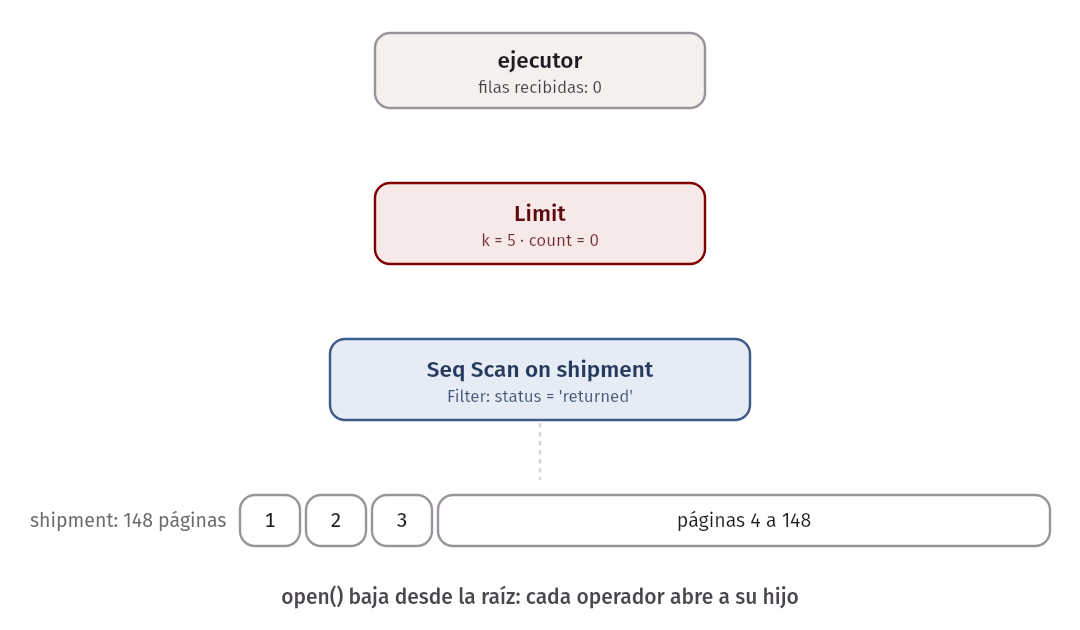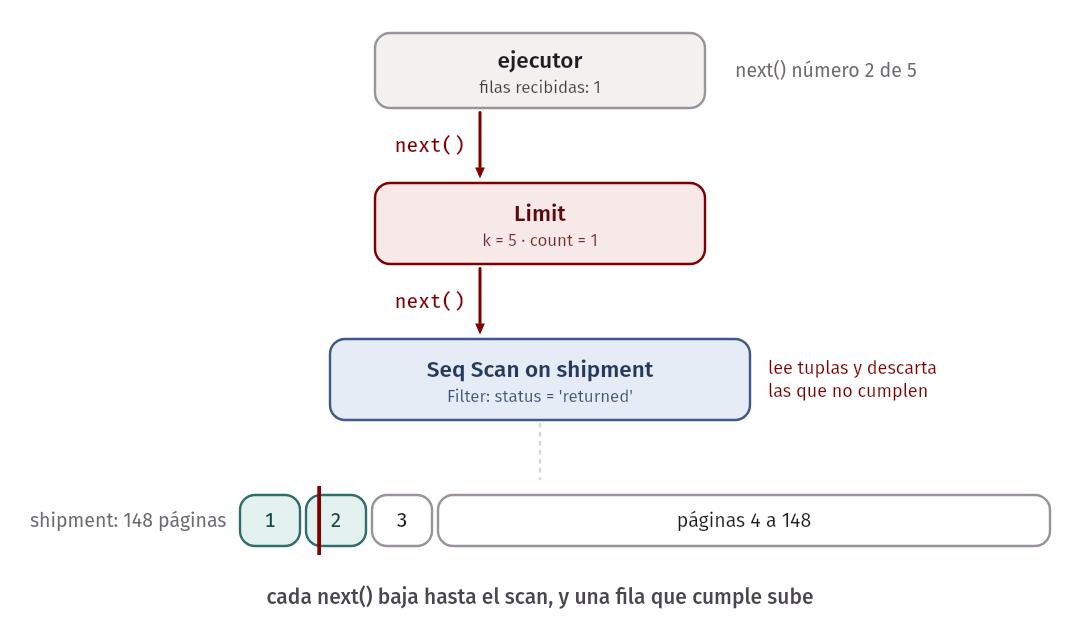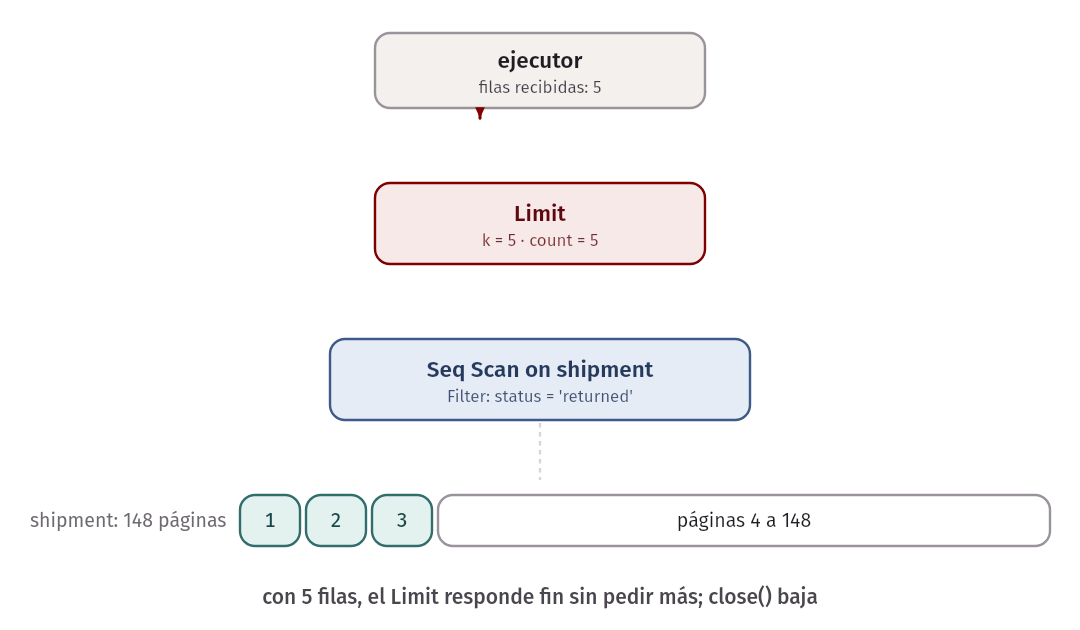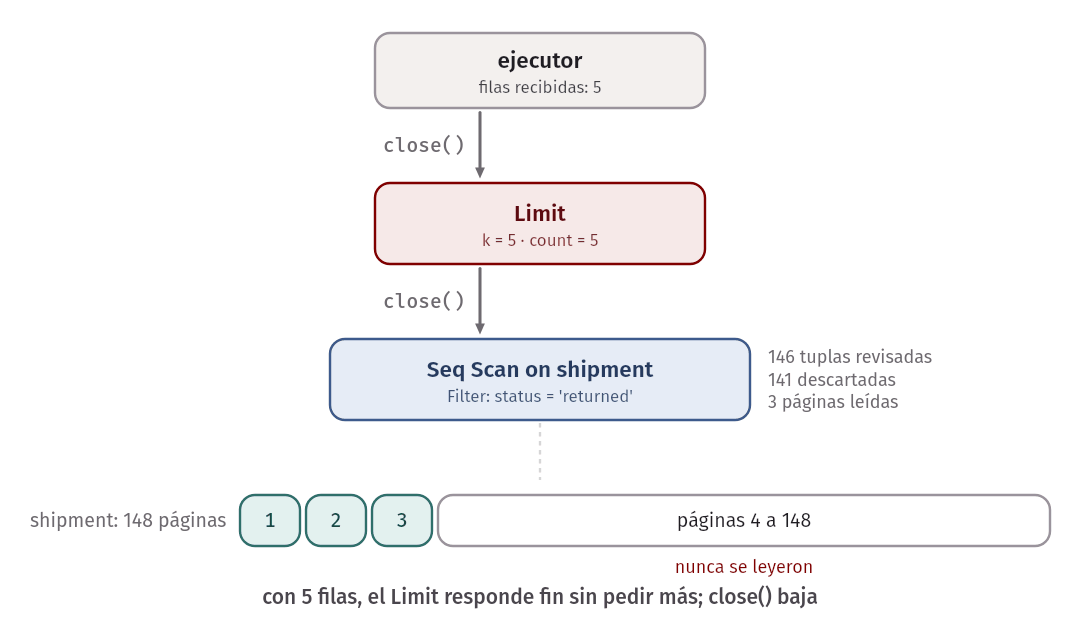
open(): prepara el operador y abre a sus hijos. Un scan abre el archivo; un sort lee toda su entrada y la ordena (es bloqueante: hace el trabajo aquí); un hash join arma la hash table con la relación de construcción.next(): devuelve la siguiente tupla de la salida, o una marca de fin (en nuestro código,null). Para producirla, el operador llama anext()de sus hijos tantas veces como necesite. Entre una llamada y la siguiente, el operador guarda su estado: en qué página va el scan, qué tupla del outer está procesando el nested loop.close(): libera lo que usó (buffers, hash tables, archivos temporales) y cierra a sus hijos.
Un plan es un árbol de iteradores. Para ejecutarlo se abre la raíz, se
le pide next() hasta que devuelva fin, y se la cierra. Cada next() de
la raíz se propaga hacia abajo solo lo necesario.
Un sort en memoria, en pseudocódigo, muestra dónde trabaja un operador bloqueante:
Sort.open():
    hijo.open()
    T = todas las tuplas de hijo (llamando a hijo.next() hasta el fin)
    ordenar T;  pos = 0

Sort.next():
    si pos = |T|: devolver fin
    pos = pos + 1;  devolver T[pos − 1]
Todo el trabajo está en open(); next() solo entrega. Un operador que
trabaja en pipeline, como una selección, es al revés: open() solo abre a
su hijo, y cada next() pide tuplas al hijo hasta tener una para
devolver.
Las ventajas del modelo son que cada operador se escribe sin saber qué hay
arriba ni abajo (solo conoce la interfaz de sus hijos), que los operadores
se combinan libremente, y que el pipelining sale gratis. El costo es una
llamada a next() por tupla y por operador, que en sistemas con los datos
en memoria pesa. Por eso algunos sistemas modernos devuelven un lote de
tuplas por llamada (vectorización); las notas de la clase #14 de CMU lo
comparan con el modelo de materialización y el de iteradores.
Un iterador en Node.js
En code/week-11/iterators.mjs está la
interfaz que vamos a usar, con un operador ya escrito: SeqScan, que lee
las filas de una tabla con pool.query y las entrega una por una. Como
hablar con PostgreSQL es asíncrono, open() es async; next() y
close() no lo son. run(plan) ejecuta un plan completo: abre la raíz,
pide next() hasta recibir null y la cierra.
Para ver un operador completo que no es del laboratorio,
limit.mjs tiene un Limit:
// Las primeras k filas de child. Cuando ya tiene k, no le pide más.
export class Limit {
  constructor(child, k) {
    this.child = child;
    this.k = k;
  }

  async open() {
    await this.child.open();
    this.count = 0;
  }

  next() {
    if (this.count >= this.k) return null;
    const row = this.child.next();
    if (row !== null) this.count++;
    return row;
  }

  close() {
    this.child.close();
  }
}
El estado entre llamadas es this.count. limit.mjs también tiene un
Counter, que deja pasar las filas de su hijo sin cambiarlas y cuenta las
llamadas a open, next y close. Con los dos se puede ver cuánto
trabajo hace cada operador. pipeline.mjs
pone un Limit(5) encima de un SeqScan de shipment:
$ PGDATABASE=chasqui_w11 node pipeline.mjs
filas del plan: 1, 2, 3, 4, 5
llamadas al SeqScan: { opens: 1, nexts: 5, rows: 5, closes: 1 }
filas que SeqScan.open() trajo de PostgreSQL: 12000
values: entrega {"id":1}
raíz: recibe {"id":1}
values: entrega {"id":2}
raíz: recibe {"id":2}
values: cerrado
El Limit le pidió al scan exactamente 5 filas. Pero nuestro SeqScan,
para simplificar, trae toda la tabla en open(): 12 000 filas. Un
scan de verdad, como el de PostgreSQL o el que escriben en P3, lee una
página a la vez dentro de next(), y por eso el Seq Scan de PostgreSQL
del ejemplo anterior leyó solo 3 páginas.
Error común. Confundir “pipeline” con “no usa memoria”. El hash join trabaja en pipeline del lado de probe, pero en
open()lee toda la relación de construcción y la guarda en memoria. Lo que el pipeline ahorra es escribir y releer los resultados intermedios, no la memoria de trabajo de cada operador.
Iteradores con generadores
JavaScript tiene el modelo de iteradores dentro del lenguaje: una función
generadora (function*) devuelve un objeto con un método next(), y cada
llamada ejecuta el cuerpo hasta el siguiente yield. Un for...of es un
consumidor que llama a next() hasta que se acaba. La segunda parte de
pipeline.mjs usa dos generadores de limit.mjs: values(rows, log), que
entrega las filas de un arreglo y anota en log cada una (y, en un bloque
finally, que lo cerraron), y limit:
export function* limit(input, k) {
  if (k <= 0) return;
  let count = 0;
  for (const row of input) {
    yield row;
    if (++count === k) return;
  }
}
El log de arriba muestra el orden en que trabajan: values produce una
fila, la raíz la recibe, y recién entonces values produce la siguiente.
Nunca produce la tercera. Cuando limit termina, el for...of cierra
automáticamente el generador de values (llama a su método return()), y
el bloque finally corre: hace el papel de close(). El estado que en la
clase Limit había que guardar a mano en this.count, aquí es una
variable local que el generador conserva entre llamadas.
El laboratorio
En el laboratorio completan en iterators.mjs los operadores que faltan:
Filter(child, predicate): las filas dechildpara las quepredicate(row)es verdadero.Project(child, columns): de cada fila, solo las columnas pedidas, en ese orden.NestedLoopJoin(outer, inner, predicate): por cada fila del outer, recorrer el inner y devolver las combinaciones ({ ...o, ...i }) que cumplenpredicate(o, i).HashJoin(build, probe, buildKey, probeKey): enopen(), leer todobuildy armar unMapde clave a filas; ennext(), recorrerprobey devolver las combinaciones con la misma clave.
iterators.test.mjs arma con ellos el join de los clientes de una ciudad
con sus envíos y compara el resultado con la misma consulta en PostgreSQL.
El NestedLoopJoin tiene una decisión de diseño que deben tomar y
explicar en un comentario: cómo “volver a empezar” el inner por cada fila
del outer. Una opción es cerrarlo y abrirlo de nuevo, que es lo que hace
el nested loop del libro (con nuestro SeqScan, cada open() es una
consulta a PostgreSQL). Otra es guardar sus filas en memoria la primera
vez, como el nodo Materialize de PostgreSQL: es el mejor caso del nested
loop del libro, cuando la relación de adentro cabe en memoria. Cada una tiene un costo
distinto en lecturas y en memoria; usen las fórmulas de este capítulo para
justificar la suya.
Estos operadores son el esqueleto de P4,
donde los van a escribir sobre las páginas de quipu (P3) en vez de sobre
pg, y van a agregar un block nested loop con bloques de verdad, un index
nested loop, un hash join (particionar en disco queda como bonus), el external sort y la
agregación con hash.
El código de la semana y make test
Dentro del contenedor, en code/week-11, make crea la base de datos
chasqui_w11, hace VACUUM (FREEZE, ANALYZE) para que las tablas queden
con el tamaño de este capítulo (148 páginas shipment y 19 customer),
crea los dos índices de la semana 10 e instala pageinspect. make test
la vuelve a crear y corre las pruebas. Mientras no hayan hecho el
laboratorio, tres pruebas fallan a propósito: la de Filter y
Project, la de NestedLoopJoin y la de HashJoin.
$ make test
chasqui-load chasqui_w11
Base de datos chasqui_w11 lista.
...
✔ SeqScan devuelve todas las agencias (9.096542ms)
✖ Filter y Project (0.989083ms)
✖ NestedLoopJoin: los envíos de los clientes de una ciudad (0.57225ms)
✖ HashJoin da el mismo resultado que NestedLoopJoin (0.123459ms)
✔ Limit(2) sobre Values: dos filas y dos llamadas a next() (0.831042ms)
...
ℹ tests 41
ℹ pass 38
ℹ fail 3
...
Esa corrida es con make big hecho: la prueba de big.test.mjs corre solo
si existe chasqui_w11_big. Sin la copia, aparece como saltada (skipped 1) y pasan 37. Cuando terminen el laboratorio, pasan todas las demás.
| Archivo | Qué muestra |
|---|---|
selection.sql |
Tamaños, M, alturas de los índices, correlación y los algoritmos de selección: A1, igualdad y rango sobre la clave primaria, A4, bitmap scan, BitmapAnd, BitmapOr, negación |
sort.sql |
Quicksort, external merge, top-N heapsort y trace_sort |
joins.sql |
Hash join, merge join y nested loop con enable_*, Disabled: true, batches con work_mem chico, join selectivo, theta join |
other.sql |
DISTINCT, GROUP BY con hash y con sort, operaciones de conjuntos, outer join, pipelining con LIMIT, CTE materializado |
big.sql |
Los joins sobre la copia de chasqui_big |
costs.mjs |
Las fórmulas de costo del capítulo |
iterators.mjs |
La interfaz de iteradores, SeqScan y los operadores del laboratorio |
limit.mjs |
Values, Limit y Counter como clases, y values y limit como generadores |
pipeline.mjs |
Un Limit sobre un SeqScan, con las llamadas contadas |
*.test.mjs |
Los planes de los .sql, las cuentas de costs.mjs, los iteradores y Limit |
Para el laboratorio, joins.sql, sort.sql y big.sql tienen consultas
de cada paso de la guía; big.sql se corre sobre la copia que crea make big, porque necesita el índice en shipment(sender_id). Si cambian un
parámetro con SET, recuerden RESET ALL antes de la consulta siguiente.
Como en las semanas anteriores, las consultas de los .sql empiezan con
una línea -- name: ..., y sqlfile.mjs
las separa para que las pruebas corran el mismo texto. Las pruebas de los
planes no miran el reparto entre hit y read, que depende de la caché,
sino la suma.
Resumen
- Una consulta pasa por parsing y traducción al álgebra relacional, optimización y evaluación. El plan es un árbol de operadores, cada uno con su algoritmo.
- El costo se mide en transferencias de bloques y seeks:
b · t_T + S · t_S. Se ignora la CPU y la escritura del resultado final, y
se supone que el buffer pool empieza vacío. M es la memoria del operador;
en PostgreSQL,
work_mem/ 8 KiB. - Selección: A1 (búsqueda lineal, t_S + b_r · t_T) sirve siempre. Con
un clustered index, igualdad (h_i + 1)(t_T + t_S) y rangos con lectura
secuencial. Con un índice secundario, una lectura aleatoria por tupla,
(h_i + n)(t_T + t_S): pierde frente a A1 desde unas 800 tuplas en
shipment. Conjunciones con un índice, con índice compuesto o intersectando RID; disyunciones solo si todas las condiciones tienen índice. - PostgreSQL no tiene clustered index: todos los índices son secundarios y
correlationdice cuán ordenada está la tabla. El bitmap scan lee las páginas marcadas en orden físico, una vez cada una;BitmapAndyBitmapOrson A9 y A10. - External merge sort: ⌈b_r / M⌉ runs, fusiones de M − 1 vías, ⌈log_{M−1}(b_r / M)⌉ pasadas de fusión y b_r (2 · pasadas + 1) transferencias. Con dos pasadas se ordenan hasta ≈ M² páginas. La base del logaritmo es M − 1, no 2.
- Joins sobre
customer ⋈ shipmentcon M = 102: nested loop ≈ 6,6·10⁹; block nested loop 662 000 (la relación chica afuera); merge join ≈ 241 000 ordenando; hash join ≈ 105 000. Con la relación chica en memoria, block nested loop y hash join cuestan b_r + b_s. El index nested loop gana cuando el outer es pequeño después de filtrar. - El hash join necesita M > √b_build para no particionar de forma
recursiva y solo sirve para equi-joins. PostgreSQL usa un hybrid hash
join con
Batches. - Eliminación de duplicados, operaciones de conjuntos y agregación se hacen ordenando o con hash. La agregación con hash guarda un acumulador por grupo.
- Materialización escribe cada resultado intermedio; pipelining pasa las tuplas sin escribirlas. Sort, la construcción del hash join y la agregación son bloqueantes.
- El modelo de iteradores (
open,next,close) implementa el pipelining por demanda: la raíz pide tuplas y cada operador pide a sus hijos solo lo necesario. ConLIMIT, PostgreSQL lee 3 páginas en vez de 148.
Ejercicios
- Una relación ocupa 50 000 páginas y hay M = 101 páginas de memoria.
¿Cuántos runs genera la primera fase del external merge sort? ¿Cuántas
pasadas de fusión hacen falta y cuántas transferencias de bloques en
total (sin la escritura final)? Repitan con M = 1001. Comprueben con
externalSortdecosts.mjs. - Con b_r = 400, b_s = 10 000 y M = 42, calculen el costo de block nested loop join en transferencias con r afuera y con s afuera. ¿Cuál conviene y por qué? ¿Cuántas páginas de memoria harían falta para que costara b_r + b_s?
- Para la misma pareja, calculen el costo de hash join usando r como build, sin particionamiento recursivo. ¿Qué condición debe cumplir M para que no haga falta particionar de forma recursiva? ¿La cumple M = 42? ¿Y M = 15?
- En
chasqui_w11,SELECT * FROM shipment WHERE sender_id = 98devuelve 10 envíos. Calculen con t_S = 4 ms y t_T = 0,1 ms el costo de A1 sobre las 148 páginas y el de A4 con el índice de altura 2. ¿Desde cuántas tuplas encontradas dejaría de convenir A4 en esta tabla? Comparen con el plan deEXPLAIN (ANALYZE, BUFFERS). - En el plan
Sort(HashJoin(SeqScan(customer), Filter(SeqScan(shipment)))), ¿qué operadores pueden trabajar en pipeline y cuáles son bloqueantes? Escriban en pseudocódigo elopen()y elnext()de un operadorDistinctque suponga la entrada ordenada (como elUniquede PostgreSQL). ¿Es bloqueante? - Con
selection.sqla la mano, escriban una conjunción sobresender_idycreated_aten la que PostgreSQL no useBitmapAndsino un solo índice y unFilter, y otra en la que sí lo use. ¿Qué cambia entre las dos? Expliquen con A7 y A9. - Ejecuten en
chasqui_w11SELECT * FROM shipment ORDER BY weight_kgconwork_memen 64 kB, 128 kB y 256 kB, contrace_sortactivado. Anoten cuántos runs y cuántas pasadas de fusión hace cada uno, y compárenlos con la fórmula. ¿Desde quéwork_memdeja de ser un external merge? - Un hash join tiene como build una relación de 10 000 páginas y M = 50. ¿Hace falta particionamiento recursivo? ¿Cuántas pasadas de particionamiento hacen falta, si cada pasada divide en M − 1 particiones? ¿Qué pasaría si el 30 % de las tuplas de build tuvieran el mismo valor del atributo del join?
- En la copia grande (
make big), cambien el filtro del join selectivo debig.sqlporWHERE c.customer_id < xy busquen, conEXPLAIN, el valor de x en el que PostgreSQL deja el nested loop y pasa al hash join (entre 1000 y 5000). Usen la fórmula del index nested loop y la del hash join con los números reales para estimar ese punto, y comparen. - Con
limit.mjs, escriban un operadorSkip(child, k)que descarte las primeras k filas (elOFFSETde SQL) y una prueba conCounterque muestre cuántas veces llama anext()del hijo un planLimit(Skip(Values(rows), 3), 2). ¿Es bloqueanteSkip? - (Desafío) Agreguen a
costs.mjsuna función para el hybrid hash join: si la partición 0 de build ocupa m páginas en memoria, ¿cuántas transferencias se ahorran respecto a 3 (b_r + b_s) + 4 n_h? Calculen el ahorro para el ejemplo de la sesión con M = 1000 y escriban una prueba.