
Apuntes · Capítulo 10Almacenamiento, índices y consultas
Índices: B+ trees, hashing e índices en PostgreSQL
Índices: B+ trees, hashing e índices en PostgreSQL
La semana pasada vimos dónde vive una tabla: un heap file, una secuencia de
páginas de 8 KiB con slots, que el motor lee a través del buffer pool. Con
eso ya podemos contestar cualquier consulta. Para encontrar el envío 5000 o
los envíos del cliente 42, basta un sequential scan: leer todas las páginas y
quedarse con las filas que cumplen la condición. En chasqui_w09 eso son 148
páginas; en chasqui_big, 24 667. Si la consulta devuelve una sola fila,
casi todo ese trabajo se desperdicia.
Esta semana estudiamos la estructura que evita ese desperdicio: el índice.
La idea es la del índice de un libro. Para saber en qué páginas se habla de
clave foránea no leemos el libro entero: buscamos el término en una lista
ordenada al final y vamos directo a las páginas que indica. Un índice de base
de datos es lo mismo, con una diferencia importante: el libro no cambia,
pero la tabla sí. Cada INSERT, UPDATE o DELETE tiene que mantener al
día todos los índices de la tabla. Un índice no es gratis; se paga en
espacio y en escrituras, y la pregunta de diseño es siempre si lo que ahorra
en lecturas compensa lo que cuesta.
En la primera parte vemos los índices ordenados del libro y llegamos al
B+ tree, la estructura que usan casi todos los motores relacionales:
cómo es, cómo se busca, se inserta y se borra, y qué altura tiene para dos
millones de filas. En la segunda vemos los índices hash y los índices de
PostgreSQL en la práctica: tipos, orden de las columnas, covering indexes,
índices parciales y sobre expresiones, cuándo un índice empeora las cosas y
cuánto cuesta mantenerlo; como tema opcional, los LSM trees. Todo lo
medimos con EXPLAIN (ANALYZE, BUFFERS) y pageinspect.
El B+ tree es también el corazón de P3: quipu necesita uno guardado en
páginas. En el laboratorio de esta semana escriben uno en memoria, con
objetos de JavaScript, para entender el algoritmo antes de llevarlo a disco.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “Qué es un índice” y “Por qué un árbol”, de “B+ trees”. Sesión B: “Hashing estático”, de “Índices hash”.
- En clase. Sesión A: “Índices ordenados”, “B+ trees”, “Búsqueda en un B+ tree”, “Fan-out y altura”, “Inserción en un B+ tree” y “Borrado en un B+ tree”. Sesión B: “Claves que se repiten”, “Bulk loading”, “Índices hash”, “Acceso con varias claves”, “Índices en PostgreSQL”, “Cuándo un índice no ayuda” y “Lo que cuesta mantener un índice”.
- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 14.1–14.7 y 24.5; “LSM trees” de este capítulo, opcional. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-10, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
Qué es un índice
Clave de búsqueda y entradas
Silberschatz (sec. 14.1) define un índice a partir de dos palabras:
- La clave de búsqueda (search key) es el atributo, o el conjunto de
atributos, por el que se busca. No tiene nada que ver con las claves de la
semana 1: una clave de búsqueda puede repetirse.
sender_ides una buena clave de búsqueda para “los envíos del cliente 42”, aunque un cliente tenga muchos envíos. - Una entrada del índice (index entry) es un par (valor de la clave,
puntero). El puntero dice dónde está la tupla: es el record id de la
semana 9, (página, slot), que en PostgreSQL se llama
ctid.
Un índice es un archivo de entradas organizado para que, dado un valor de la clave de búsqueda, se encuentren rápido los punteros a las tuplas que lo tienen. El archivo de datos, el heap file, no cambia: el índice es una estructura auxiliar al lado de la tabla. Por eso se puede crear y borrar un índice sin tocar los datos, y una tabla puede tener varios.
Hay dos familias. En un índice ordenado las entradas se guardan ordenadas por la clave. En un índice hash se reparten en buckets con una función de hash. La primera parte del capítulo es sobre la primera familia; la segunda parte empieza con la otra.
Cómo se evalúa un índice
Ninguna técnica de indexación es la mejor para todo. El libro propone comparar con estos criterios:
| Criterio | Pregunta |
|---|---|
| Tipos de acceso | ¿Sirve para igualdad (sender_id = 42)? ¿Para rangos (created_at BETWEEN ...)? |
| Tiempo de acceso | ¿Cuántas páginas hay que leer para encontrar lo que se busca? |
| Tiempo de inserción | ¿Cuánto trabajo extra cuesta un INSERT: encontrar el lugar y actualizar la estructura? |
| Tiempo de borrado | Lo mismo para un DELETE |
| Espacio | ¿Cuántas páginas ocupa el índice? |
Las respuestas se cuentan, como la semana pasada, en páginas leídas y escritas, no en comparaciones. Comparar claves en memoria cuesta nanosegundos; traer una página que no está en el buffer pool cuesta microsegundos o milisegundos.
Un primer ejemplo
shipment no tiene un índice sobre sender_id: PostgreSQL crea índices
para la clave primaria y para las restricciones UNIQUE, pero no para las
claves foráneas. Buscar los envíos del cliente 42 en chasqui_w10 es un
sequential scan (indexes.sql, consulta
sender_seq):
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT * FROM shipment WHERE sender_id = 42;
QUERY PLAN
--------------------------------------------------
Seq Scan on shipment (actual rows=51.00 loops=1)
Filter: (sender_id = 42)
Rows Removed by Filter: 11949
Buffers: shared hit=148
(4 rows)Las 148 páginas de la tabla, para quedarse con 51 de 12 000 filas. Creamos un índice, dentro de una transacción para no dejarlo creado:
BEGIN;
CREATE INDEX shipment_sender_idx ON shipment (sender_id);
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT * FROM shipment WHERE sender_id = 42;
QUERY PLAN
----------------------------------------------------------------------------
Bitmap Heap Scan on shipment (actual rows=51.00 loops=1)
Recheck Cond: (sender_id = 42)
Heap Blocks: exact=45
Buffers: shared hit=45 read=2
-> Bitmap Index Scan on shipment_sender_idx (actual rows=51.00 loops=1)
Index Cond: (sender_id = 42)
Index Searches: 1
Buffers: shared read=2Ahora el plan tiene dos nodos. Abajo, el Bitmap Index Scan recorre el
índice: 2 páginas para encontrar los 51 punteros. Arriba, el Bitmap Heap
Scan visita las páginas de la tabla a las que apuntan: 45 páginas
distintas (Heap Blocks: exact=45), porque los 51 envíos del cliente 42
están repartidos por todo el heap file. En total, 47 páginas en vez de 148.
Ese reparto, una página por cada fila o casi, es la marca de un índice
secundario, el primer concepto de la sección siguiente. Al final del
capítulo vamos a ver qué es exactamente un bitmap scan y por qué el planner
lo prefiere aquí.
Índices ordenados
De agrupamiento y secundarios
Un archivo de datos puede estar guardado en algún orden o en ninguno. La semana pasada vimos el archivo secuencial: los registros ordenados por una clave. Silberschatz (sec. 14.2) distingue los índices según su relación con ese orden:
- Un índice de agrupamiento (clustering index) es un índice cuya clave
de búsqueda define el orden del archivo. Si el archivo está ordenado por
shipment_idy el índice es sobreshipment_id, las tuplas con claves cercanas están en las mismas páginas. El libro también lo llama índice primario (primary index). - Un índice secundario (secondary index o nonclustering index) es un índice cuya clave de búsqueda define un orden distinto del orden del archivo. Las tuplas con claves cercanas pueden estar en páginas lejanas.
Un archivo secuencial con un índice de agrupamiento sobre su clave de orden se llama archivo secuencial indexado (index-sequential file). Una tabla puede tener a lo más un índice de agrupamiento, porque solo puede estar ordenada de una forma, y tantos índices secundarios como se quiera.
Error común. Creer que el índice primario es el índice sobre la clave primaria. En el libro, primario quiere decir de agrupamiento: el que sigue el orden físico del archivo, sobre cualquier clave de búsqueda. Un índice sobre la clave primaria puede ser secundario, y en PostgreSQL siempre lo es, como veremos enseguida. Para evitar la confusión, en el curso decimos de agrupamiento (o clustered index) y secundario.
La diferencia importa por el costo. Con un índice de agrupamiento, los 51 envíos de un cliente estarían en una o dos páginas seguidas. Con uno secundario, como acabamos de ver, pueden estar en 45 páginas distintas, y cada una puede costar un seek. En un rango grande la diferencia es enorme: con agrupamiento, leer el 10 % de la tabla cuesta leer el 10 % de sus páginas en orden; sin agrupamiento, puede costar una lectura al azar por cada fila.
Densos y dispersos
Un índice ordenado puede tener una entrada por cada valor de la clave o menos:
- En un índice denso (dense index) hay una entrada por cada valor de la clave de búsqueda que aparece en el archivo. Si el índice es de agrupamiento, la entrada apunta a la primera tupla con ese valor y las demás están a continuación; si es secundario, la entrada tiene que llevar los punteros a todas las tuplas con ese valor.
- En un índice disperso (sparse index) hay entradas solo para algunos valores, típicamente una por página del archivo: la clave de la primera tupla de la página. Para buscar el valor k se encuentra la última entrada con clave ≤ k y se recorre el archivo desde la página a la que apunta.
Un índice disperso solo funciona si el archivo está ordenado por la clave: si no, saber que la página 7 empieza con el envío 574 no dice nada sobre dónde está el envío 600. Por eso un índice secundario tiene que ser denso. Los índices dispersos son de agrupamiento.
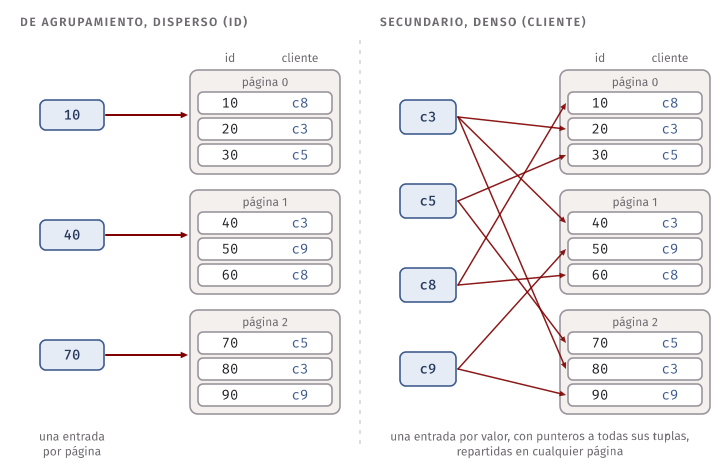
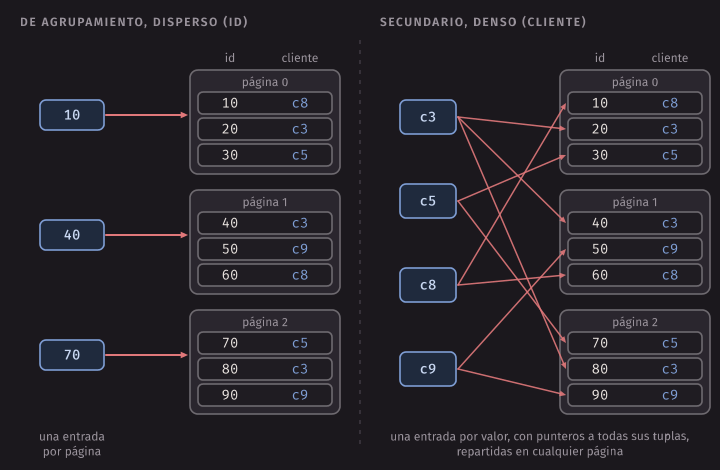
Un ejemplo con números de chasqui_big. shipment tiene 2 012 000 filas en
24 667 páginas, unas 82 filas por página (lo medimos la semana 9). Si la
tabla estuviera ordenada por shipment_id, un índice denso tendría
2 012 000 entradas y uno disperso, 24 667: ochenta veces menos. El disperso
encuentra la página correcta y lee esa página entera; el denso apunta a la
fila exacta. Silberschatz resume la regla práctica: un índice disperso con
una entrada por página es un buen compromiso, porque lo caro es traer la
página, y una vez en memoria recorrerla es casi gratis.
Índices de varios niveles
Un índice denso de 2 012 000 entradas también es grande. Si cada página del índice guarda unas 400 entradas, ocupa unas 5000 páginas. Buscar en él con búsqueda binaria cuesta ⌈log₂ 5000⌉ = 13 lecturas, y cada una puede ser un seek.
La solución del libro es tratar al índice como un archivo secuencial más y ponerle un índice disperso encima. El índice de afuera tiene una entrada por cada página del índice de adentro: 5000 entradas, que caben en unas 13 páginas. Ese índice de 13 páginas también se puede indexar, con una sola página. Ahora una búsqueda lee 3 páginas: una de cada nivel, de arriba hacia abajo. Es un índice de varios niveles (multilevel index), y es exactamente la forma de un B+ tree. Lo que le falta a esta versión es una manera de mantenerse al día cuando se inserta y se borra; de eso se trata la sección 14.3.
Actualizar un índice ordenado
Al insertar una tupla con clave k, un índice denso agrega la entrada de k si no estaba (o el puntero, si es secundario); uno disperso con una entrada por página solo cambia si la tupla abre una página nueva o pasa a ser la primera de su página. Al borrar es al revés. En los dos casos, “agregar una entrada en su lugar” en un archivo ordenado obliga a correr las demás entradas o a usar páginas de overflow, y con el tiempo el índice se degrada. El B+ tree resuelve eso.
Claves de búsqueda que se repiten
En un índice secundario sobre una clave que se repite, como sender_id, un
valor puede tener muchos punteros. El libro menciona dos formas de
guardarlos: una entrada por valor que apunta a un bucket (una lista) de
punteros, o una entrada por cada tupla. La segunda se vuelve elegante con un
truco que vamos a ver en la sección de B+ trees: agregar el record id a la
clave para que no se repita.
En PostgreSQL: todos los índices son secundarios
PostgreSQL guarda toda tabla como un heap file, sin orden. Los registros nuevos van donde haya espacio (el free space map de la semana 9). Por eso en PostgreSQL todos los índices son secundarios, incluido el de la clave primaria. No hay un clustered index en el sentido del libro.
La estadística correlation de pg_stats mide cuánto se parece el orden
físico de las filas al orden de una columna: 1 es el mismo orden, −1 el
orden inverso, 0 ningún parecido (indexes.sql,
consulta correlation):
   attname   |  correlation
-------------+---------------
 created_at  | -0.0012399433
 shipment_id |             1
(2 rows)
En chasqui_w10 las filas se cargaron en orden de shipment_id, así que
para esa columna el heap está ordenado (aunque nadie lo garantiza). En
cambio created_at no tiene ninguna relación con el orden físico: los
datos de ejemplo no se insertaron por fecha. El planner usa este número
para estimar cuántas páginas distintas va a tocar un index scan (semana 12).
PostgreSQL tiene un comando CLUSTER, que reordena físicamente la tabla
según un índice. Lo probamos dentro de una transacción, con un índice en
created_at:
BEGIN;
CREATE INDEX shipment_created_idx ON shipment (created_at);
CLUSTER shipment USING shipment_created_idx;
ANALYZE shipment;
attname | correlation
-------------+---------------
created_at | 1
shipment_id | -0.0012399433
(2 rows)Ahora el heap está ordenado por fecha y ya no por shipment_id. Pero el
orden no se mantiene. Actualizamos uno de cada diez envíos sin cambiar nada
(UPDATE shipment SET price = price WHERE shipment_id % 10 = 0, 1200
filas) y volvemos a medir:
   attname   |  correlation
-------------+---------------
 created_at  |     0.8181597
 shipment_id | -0.0010882025
(2 rows)
Cada UPDATE escribe una versión nueva de la fila (semana 9) donde hay
espacio, al final del archivo, y la correlación baja de 1 a 0,82. Hicimos
ROLLBACK al final, así que la tabla quedó como estaba.
Error común. Creer que
CLUSTER shipment USING shipment_created_idxdeja un clustered index permanente. Reordena la tabla una vez; las inserciones y actualizaciones posteriores no respetan ese orden, y para recuperarlo hay que volver a correrCLUSTER, que además bloquea la tabla mientras la reescribe. La documentación lo dice así: “clustering is a one-time operation”. Otros motores sí tienen índices de agrupamiento de verdad: en MySQL (InnoDB) la tabla misma es un B+ tree ordenado por la clave primaria.
B+ trees
Por qué un árbol
Un índice de varios niveles tiene buenas lecturas, pero se degrada con las inserciones. Queremos una estructura con pocos niveles, que se mantenga balanceada sola (todas las búsquedas cuestan lo mismo, sin reorganizaciones) y que permita recorrer un rango en orden sin volver a la raíz. El B+ tree cumple las tres. Cada nodo es una página y tiene cientos de hijos, no dos como un árbol binario de búsqueda; esa cantidad de hijos se llama fan-out, y es lo que lo hace bajo.
La estructura
Un B+ tree tiene un parámetro n: el máximo de punteros de un nodo. El libro lo fija para que un nodo llene una página. Un nodo tiene hasta n − 1 claves K₁ < K₂ < … < K₍ₙ₋₁₎ y hasta n punteros P₁, …, Pₙ:
┌────┬────┬────┬────┬─────┬────────┬────┐
│ P1 │ K1 │ P2 │ K2 │ ... │ K(n-1) │ Pn │
└────┴────┴────┴────┴─────┴────────┴────┘
Hay dos clases de nodos:
- En una hoja, cada Pᵢ (con i < n) apunta a la tupla con clave Kᵢ: es un record id. El último puntero, Pₙ, apunta a la hoja siguiente. Las hojas forman así una lista enlazada en orden de clave. Las hojas juntas son un índice denso: toda clave del archivo está en alguna hoja.
- En un nodo interno, los punteros apuntan a nodos hijos. Si un nodo interno tiene m punteros, P₁ apunta al subárbol con las claves menores que K₁; Pᵢ, para 1 < i < m, al subárbol con las claves ≥ Kᵢ₋₁ y < Kᵢ; y Pₘ, al subárbol con las claves ≥ Kₘ₋₁. Los nodos internos son un índice disperso sobre las hojas.
Y la regla que lo mantiene balanceado, la ocupación mínima:
| Nodo | Mínimo | Máximo |
|---|---|---|
| Hoja | ⌈(n − 1)/2⌉ claves | n − 1 claves |
| Nodo interno (no raíz) | ⌈n/2⌉ punteros | n punteros |
| Raíz interna | 2 punteros | n punteros |
| Raíz hoja (el árbol tiene un solo nodo) | 0 claves | n − 1 claves |
Todo nodo salvo la raíz está al menos medio lleno, y todas las hojas están a la misma profundidad. Esa es la definición de balanceado que importa aquí: el camino de la raíz a cualquier hoja tiene la misma longitud, la altura del árbol.
Con n = 4, que es el que usamos en los ejemplos de la clase, una hoja tiene entre 2 y 3 claves y un nodo interno entre 2 y 4 hijos. En un índice real, n está en los cientos. Este es un B+ tree con n = 4 y diez claves, que vamos a construir en la sección de inserción. La primera línea es la raíz, la segunda los nodos internos y la tercera las hojas:
[35]
[15 25] [45]
[5 10] [15 20] [25 30] [35 40] [45 50]
Dibujado con sus punteros, el mismo árbol se ve así:
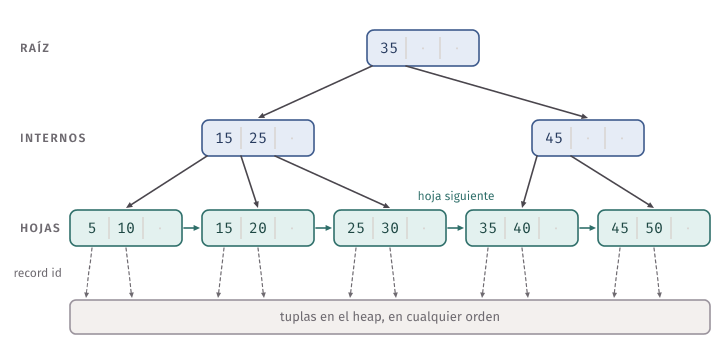
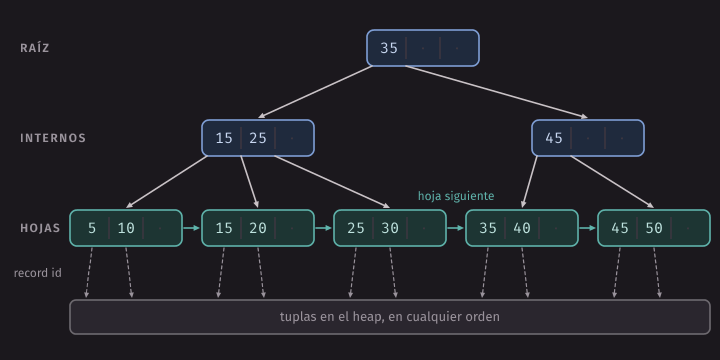
La raíz dice: las claves menores que 35 están a la izquierda, las ≥ 35 a la derecha. El nodo [15 25] tiene tres hijos: < 15, de 15 a 24, ≥ 25. Las hojas, de izquierda a derecha, están enlazadas: [5 10] → [15 20] → … → [45 50].
Idea clave. En un B+ tree todas las claves están en las hojas. Las claves de los nodos internos son copias que sirven de separadores. Esa es la diferencia con el B-tree original (sec. 14.4 del libro), que guarda cada clave una sola vez, en el nivel que le toque, con su puntero a la tupla. El B+ tree repite algunas claves, pero sus nodos internos son más chicos (no llevan record ids), tienen más fan-out, y un rango se recorre siguiendo las hojas.
Cómo es un B-tree de PostgreSQL por dentro
PostgreSQL llama B-tree a su índice por defecto, pero es un B+ tree: los
datos están en las hojas y las hojas están enlazadas. Con pageinspect lo
podemos abrir. La clave primaria de shipment en chasqui_w10 (consultas
pk_meta y pk_pages):
 root | level
------+-------
    3 |     1
(1 row)
type | level | pages | items | avg_items | avg_free
------+-------+-------+-------+-----------+----------
r | 1 | 1 | 33 | 33 | 7496
l | 0 | 33 | 12032 | 365 | 856
(2 rows)La página 0 del índice es una metapágina que dice dónde está la raíz: la
página 3. level cuenta desde 0 en las hojas, así que la raíz está en el
nivel 1 y el árbol tiene altura 2: una raíz (r) con 33 punteros y 33
hojas (l). Las 12 032 entradas de las hojas son las 12 000 claves más una
high key por cada hoja salvo la última, la cota superior de la hoja. En
la raíz (root_items en el archivo), cada entrada es (clave, página hija);
la primera no tiene clave, es el P₁ del libro, “todo lo menor que la
siguiente clave”, y apunta a la hoja 1. La siguiente tiene la clave 367 y
apunta a la hoja 2. Y la hoja 1 (leaf_items):
 itemoffset | ctid  | itemlen |          data           | htid
------------+-------+---------+-------------------------+-------
          1 | (4,1) |      16 | 6f 01 00 00 00 00 00 00 |
          2 | (0,1) |      16 | 01 00 00 00 00 00 00 00 | (0,1)
          3 | (0,2) |      16 | 02 00 00 00 00 00 00 00 | (0,2)
          4 | (0,3) |      16 | 03 00 00 00 00 00 00 00 | (0,3)
(4 rows)
La primera entrada es la high key: 6f 01 00 00 en little-endian es
0x016f = 367, y en esta hoja solo hay claves menores que 367 (en la high
key, el campo ctid no es un puntero; los cuatro bytes finales de data
son relleno para alinear a 8). Después
vienen las entradas (clave, record id) del libro: el envío 1 está en la
página 0 del heap, slot 1; el 2 en el slot 2; y así. Cada entrada ocupa 16
bytes: 8 de encabezado (con el ctid), 4 de la clave integer y 4 de
relleno. Las hojas están enlazadas en las dos direcciones: bt_page_stats
muestra btpo_prev y btpo_next de cada página.
En PostgreSQL. El B-tree de PostgreSQL sigue el diseño de Lehman y Yao (1981): cada página tiene un enlace a su hermana derecha y una high key. Si una búsqueda llega a una hoja justo después de que otro proceso la dividió, la high key le avisa que la clave que busca se movió a la derecha, y sigue el enlace. Así las búsquedas no necesitan bloquear el camino desde la raíz. El libro trata la concurrencia en índices en el capítulo 18; aquí basta saber por qué existe la high key.
Búsqueda en un B+ tree
Igualdad
Para buscar la clave v, se empieza en la raíz y se baja un nivel por vez:
- En el nodo actual, se busca la clave más chica Kᵢ que sea mayor que v.
- Si existe, se baja por el puntero que está a su izquierda, Pᵢ; si no (v es mayor o igual que todas las claves), se baja por el último puntero no nulo.
- Al llegar a una hoja, se busca v entre sus claves. Si está, su puntero lleva a la tupla; si no, la clave no existe.
Dentro de cada nodo, la búsqueda del paso 1 es una búsqueda binaria: el nodo ya está en memoria, y con 400 claves bastan 9 comparaciones. En el ejemplo de arriba, buscar 30: en la raíz [35], 35 > 30, se baja a la izquierda; en [15 25], ninguna clave es mayor que 30, se baja por el último puntero; en la hoja [25 30] está el 30. Tres nodos, uno por nivel.
Si la clave puede repetirse, la regla cambia: hay que bajar por la izquierda de la primera clave ≥ v, porque después de un split puede haber copias de v en la hoja de la izquierda, y en la hoja avanzar por los enlaces mientras siga apareciendo v. La sección 14.3.5 del libro evita ese caso haciendo única la clave, como veremos.
Rangos
Para lo ≤ clave ≤ hi, se busca lo como arriba y, desde esa hoja, se
avanza por las hojas siguientes, devolviendo claves hasta encontrar una
mayor que hi. No se vuelve a la raíz. Un rango que devuelve r entradas
lee h páginas para bajar y, como mucho, ⌈r / (entradas por hoja)⌉ + 1
hojas. Esto es lo que un índice hash no puede hacer, como veremos.
El costo
Una búsqueda por igualdad sobre una clave única lee una página por
nivel, h páginas del índice, más la página del heap donde está la
tupla. En chasqui_w10, con altura 2 (pk_lookup):
 Index Scan using shipment_pkey on shipment (actual rows=1.00 loops=1)
   Index Cond: (shipment_id = 5000)
   Index Searches: 1
   Buffers: shared hit=3
Tres páginas: la raíz, la hoja y la página del heap. (La metapágina, que
dice dónde está la raíz, se guarda aparte en la memoria de la sesión y no
cuenta). Index Searches: 1, una línea que aparece desde PostgreSQL 18,
dice cuántas veces se bajó desde la raíz.
Fan-out y altura
El cálculo
¿Qué altura tiene un B+ tree de N claves? Si cada nodo tiene f hijos, el nivel 1 tiene 1 nodo, el nivel 2 tiene f, el nivel 3 tiene f², y las hojas, en el nivel h, son f^(h−1) y guardan unas f^h claves. Para guardar N claves hace falta f^h ≥ N, es decir:
h = ⌈log_f N⌉La base del logaritmo es el fan-out. El mejor caso es con nodos llenos (f = n); el peor, con nodos a la mitad (f = ⌈n/2⌉). Silberschatz da la cota del peor caso: un camino de la raíz a una hoja no tiene más de ⌈log₍⌈ₙ/₂⌉₎ N⌉ nodos.
Hagamos la cuenta para chasqui_big, que tiene unos 2 millones de envíos,
con un índice sobre shipment_id. Supongamos que la clave es un bigint
(8 bytes) y el puntero también ocupa 8 bytes. Con páginas de 8 KiB, una
página guarda unos 8192 / 16 ≈ 500 pares (clave, puntero), así que
n ≈ 500.
- Mejor caso (nodos llenos, fan-out 500): ⌈log₅₀₀ 2·10⁶⌉ = ⌈2,33⌉ = 3.
- Peor caso (nodos a la mitad, fan-out 250): ⌈log₂₅₀ 2·10⁶⌉ = ⌈2,63⌉ = 3.
En los dos casos, 3 niveles. Encontrar un envío cuesta 3 lecturas del índice más 1 del heap. Un árbol binario de búsqueda balanceado con los mismos 2 millones de claves necesitaría ⌈log₂ 2·10⁶⌉ = 21 niveles, siete veces más lecturas. Y hay algo mejor todavía: la raíz es una sola página y el segundo nivel tiene entre 2·10⁶ / 500² ≈ 8 y 2·10⁶ / 250² ≈ 32 páginas. Esas páginas se usan en cada búsqueda, así que casi siempre están en el buffer pool. En la práctica, una búsqueda lee de disco 1 o 2 páginas.
Error común. Calcular la altura con log₂, como si fuera un árbol binario, o con el número de páginas de la tabla en vez del número de claves. La base es el fan-out, y es justamente lo que hace bajo a un B+ tree: con fan-out 500, cada nivel multiplica por 500 lo que se puede indexar. Un cuarto nivel alcanzaría para 500⁴ ≈ 6·10¹⁰ claves.
La altura real
En chasqui_big, shipment_id es integer, no bigint, y una entrada de
PostgreSQL no ocupa exactamente 16 bytes. Medimos en vez de suponer
(big.sql, sobre una copia de chasqui_big):
    relname    | relpages | reltuples |  size
---------------+----------+-----------+--------
 shipment      |    24667 |   2012000 | 193 MB
 shipment_pkey |     5519 |   2012000 | 43 MB
(2 rows)
root | level
------+-------
412 | 2
(1 row) type | level | pages | items | avg_items
------+-------+-------+---------+-----------
r | 2 | 1 | 19 | 19
i | 1 | 19 | 5516 | 290
l | 0 | 5498 | 2017497 | 367
(3 rows)level 2 quiere decir altura 3, como predijo la cuenta: una raíz con 19
hijos, 19 nodos internos (i) y 5498 hojas. El segundo nivel tiene 19
páginas, dentro del rango de 8 a 32 que calculamos. ¿De dónde salen 367
entradas por hoja? Cada entrada ocupa 16 bytes más 4 del line pointer de la
slotted page (semana 9), 20 en total. Una página de 8192 bytes, menos 24 de
encabezado y 16 de un área especial con los enlaces, tiene lugar para unas
407 entradas. Pero CREATE INDEX llena las hojas solo hasta el 90 % (el
fill factor del índice) y deja el resto para inserciones futuras: el
90 % de 407 son 366 claves, más la high key. Los nodos internos se llenan
menos todavía, alrededor del 70 %: 290 entradas en promedio.
Una búsqueda (pk_lookup de big.sql):
 Index Scan using shipment_pkey on shipment (actual rows=1.00 loops=1)
   Index Cond: (shipment_id = 1500000)
   Index Searches: 1
   Buffers: shared hit=3 read=1 written=1
Cuatro páginas: tres del índice y una del heap. Tres estaban en el buffer
pool (hit=3; entre ellas la raíz y el nodo interno, que se usan en toda
búsqueda) y solo una se leyó (read=1). Es lo que anunciaba el
cálculo: 2 millones de filas, 193 MB, y encontrar una cuesta una lectura.
Inserción en un B+ tree
Las reglas
Para insertar la entrada (k, p), donde p es el record id de la tupla nueva:
- Se busca, como en una búsqueda por igualdad, la hoja donde debería estar k, y se recuerda el camino desde la raíz.
- Si la hoja tiene menos de n − 1 claves, se inserta (k, p) en su lugar, en orden. Listo.
- Si la hoja está llena, se divide (split). Se juntan sus n − 1 entradas con la nueva (n en total); las primeras ⌈n/2⌉ se quedan en la hoja y las demás pasan a una hoja nueva, que se engancha en la lista a la derecha de la vieja. La primera clave de la hoja nueva se copia al padre, con un puntero a la hoja nueva.
- Si el padre tiene espacio, se inserta ahí y se termina. Si no, también se divide, pero distinto: con sus n + 1 punteros, los primeros ⌈(n + 1)/2⌉ se quedan, los demás pasan a un nodo nuevo, y la clave del medio sube al abuelo. En un nodo interno la clave que sube no se copia: ya no queda en ninguno de los dos nodos.
- Si se divide la raíz, se crea una raíz nueva con dos hijos. El árbol crece hacia arriba, por la raíz, y por eso todas las hojas siguen a la misma profundidad.
La asimetría entre los pasos 3 y 4 es la que más cuesta recordar, y tiene una razón. En una hoja, la clave tiene que seguir ahí, porque las hojas son el índice denso: si se fuera al padre, la tupla dejaría de estar indexada. En un nodo interno, la clave es solo un separador; con dos nodos y un separador en el padre ya está todo dicho, y dejarla también abajo sería redundante.
Un ejemplo paso a paso
Construyamos un árbol con n = 4 (hojas de hasta 3 claves, nodos internos
de hasta 4 hijos) insertando 10, 20, 5, 15, 25, 30, 35, 40, 45 y 50. Es el
mismo ejemplo del laboratorio, con tres claves más para llegar a un split
de un nodo interno. Los dibujos están en el formato del método toString()
del laboratorio: una línea por nivel, empezando por la raíz.
Las tres primeras claves entran en la raíz, que todavía es una hoja:
[5 10 20]+15. La hoja está llena. Con la clave nueva quedan 5, 10, 15, 20: las ⌈4/2⌉ = 2 primeras se quedan, las otras dos van a una hoja nueva, y la primera de ellas, 15, se copia a un padre que todavía no existe. Se crea una raíz nueva:
[15]
[5 10] [15 20]
+25 cabe en la hoja [15 20]. +30 la llena: quedan [15 20] y [25 30], y el 25 se copia a la raíz, que tiene espacio:
[15 25]
[5 10] [15 20] [25 30]
+35 entra en la última hoja; +40 la divide en [25 30] y [35 40], y el 35 se copia a la raíz, que queda llena con tres claves y cuatro hijos:
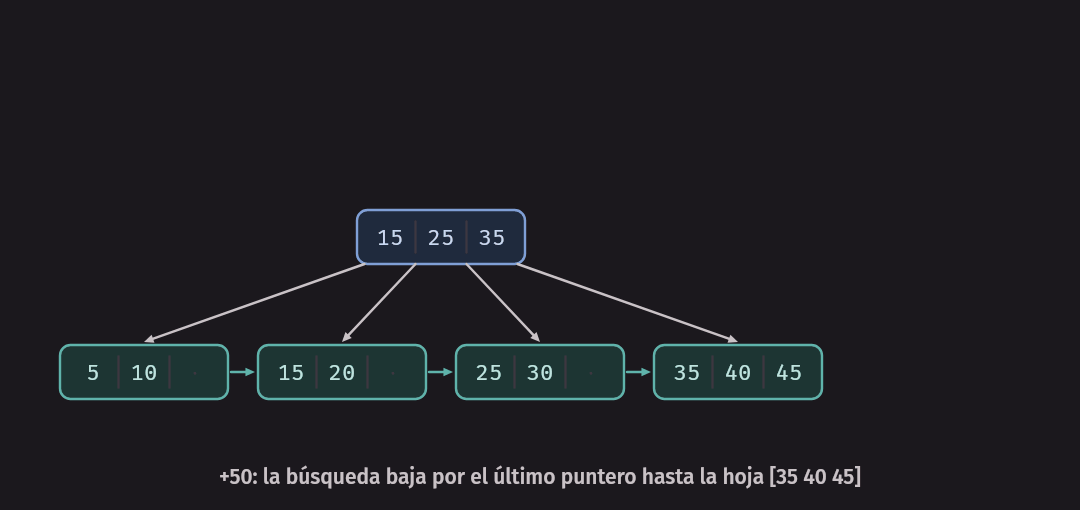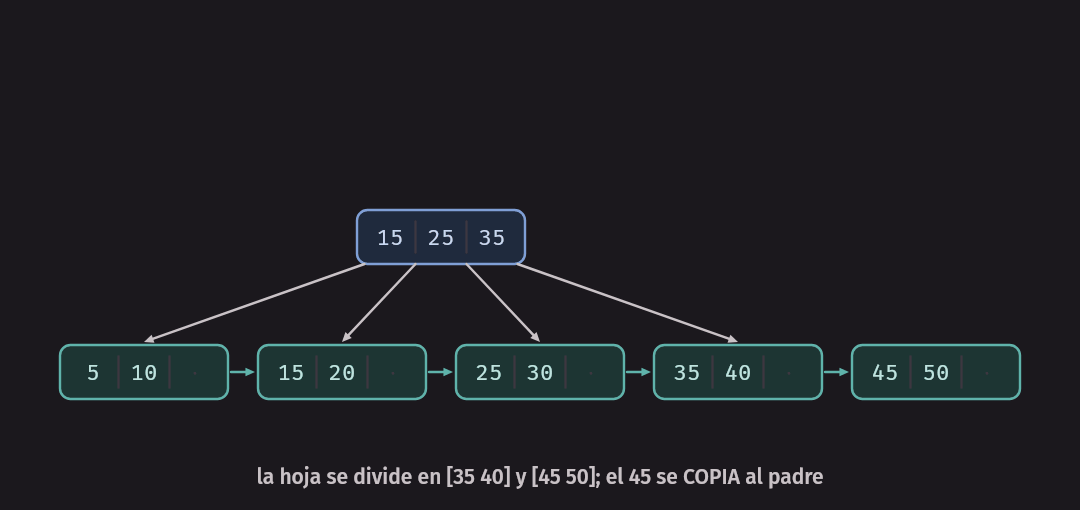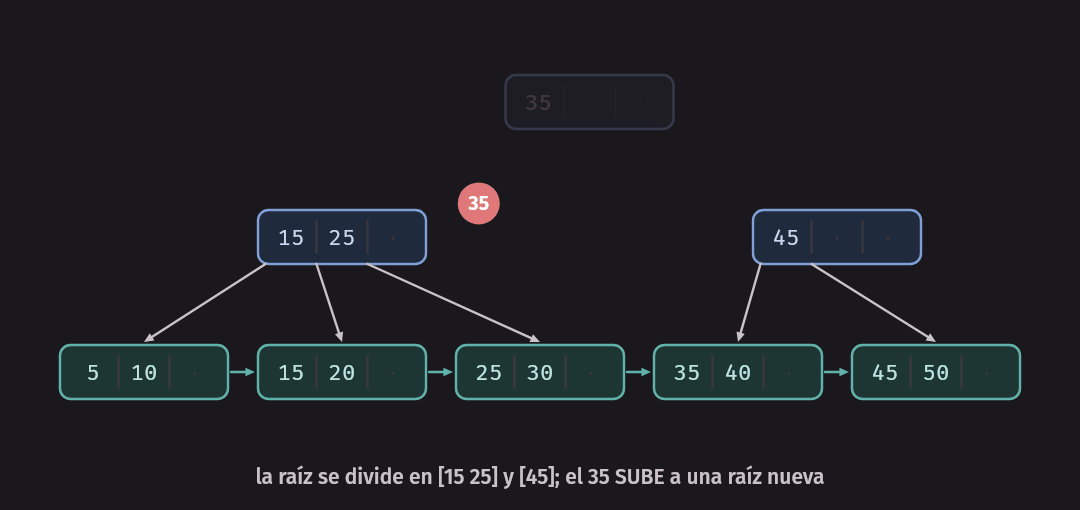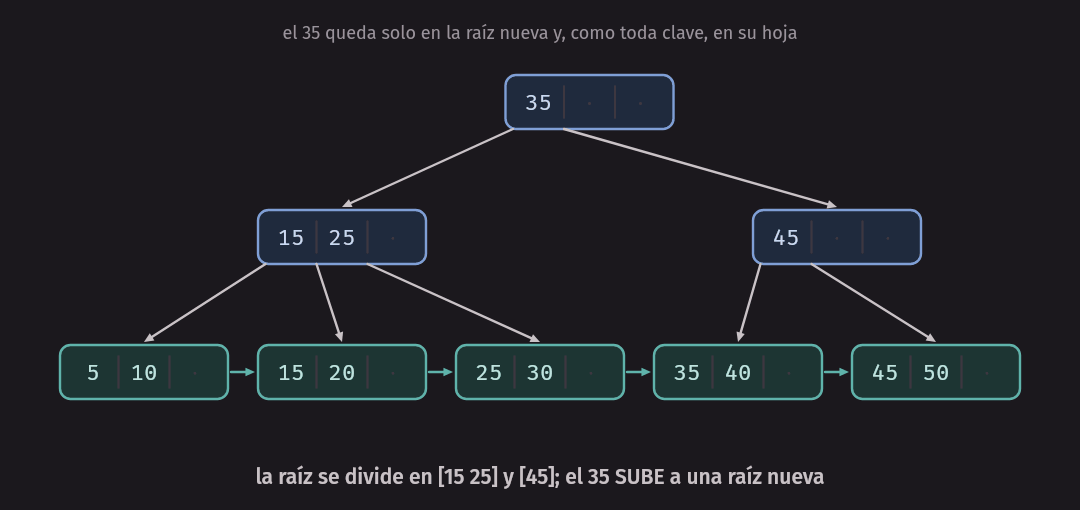
[15 25 35]
[5 10] [15 20] [25 30] [35 40]
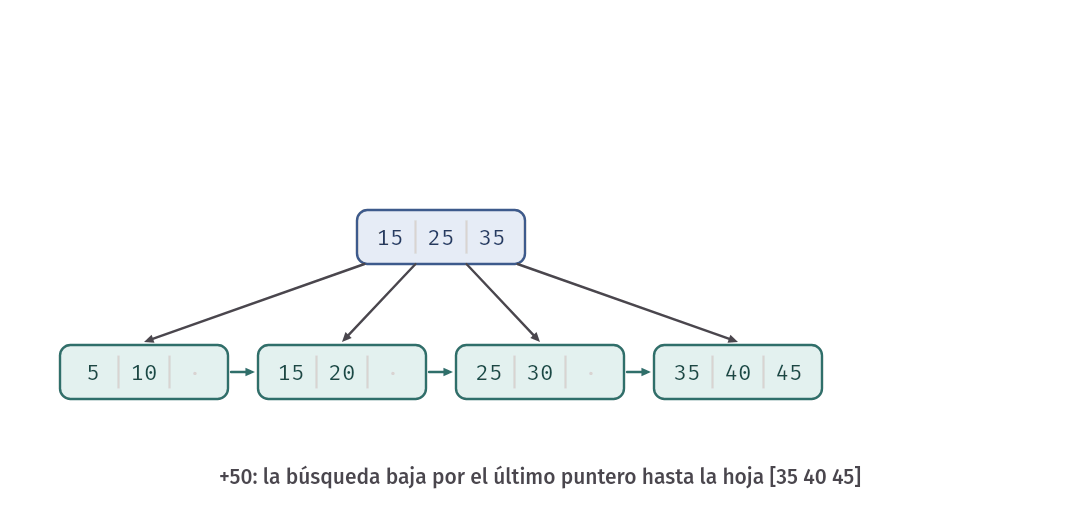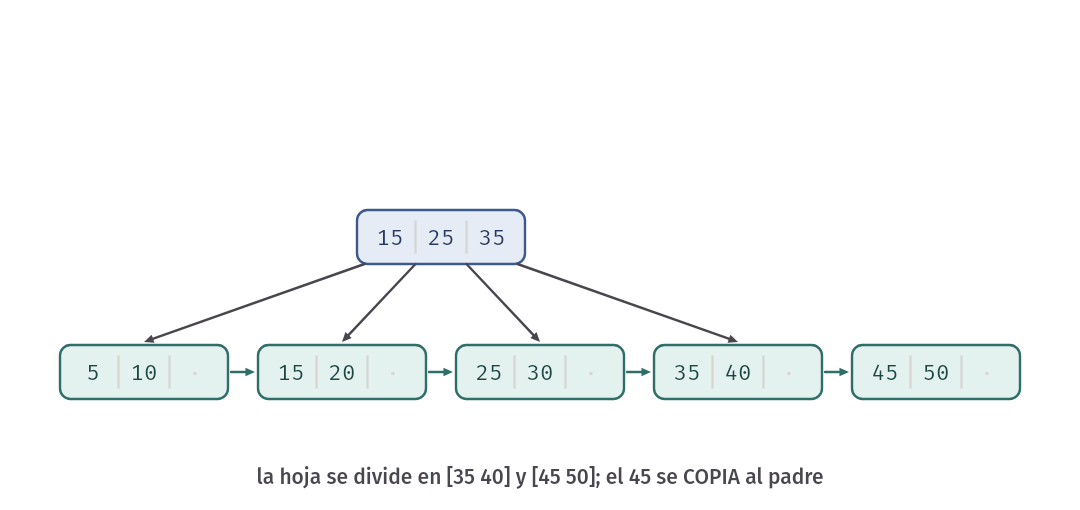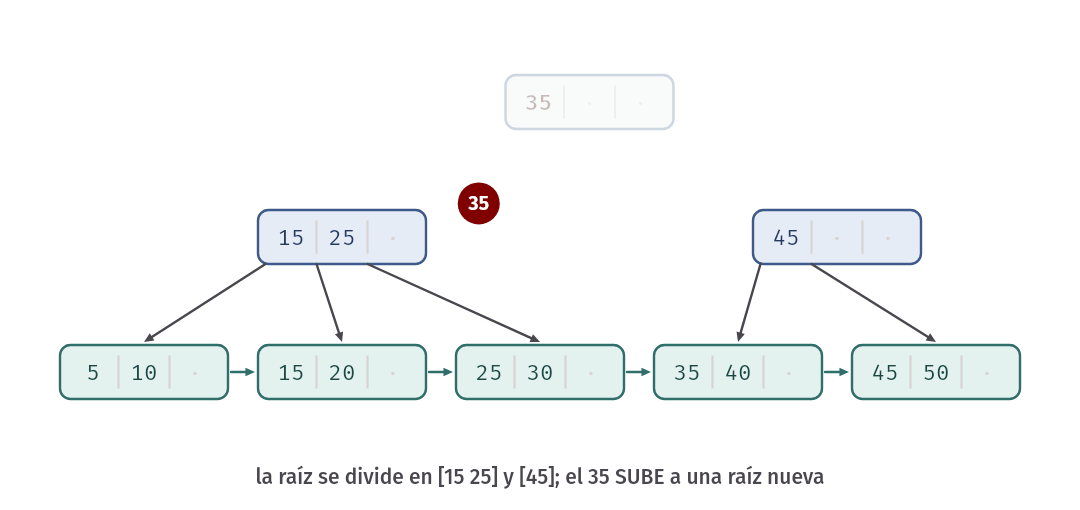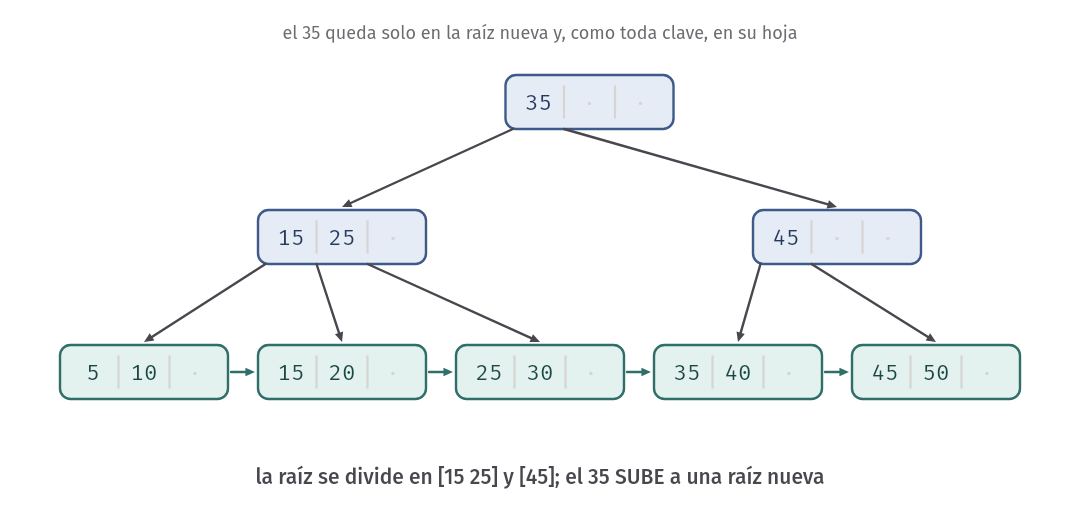
+45 entra en [35 40]. +50 la llena: se divide en [35 40] y [45 50], y hay que insertar 45 en la raíz. La raíz tendría ahora cuatro claves, 15, 25, 35 y 45, y cinco punteros. Se divide: los ⌈5/2⌉ = 3 primeros punteros (con las claves 15 y 25) se quedan, los dos últimos (con la clave 45) van a un nodo nuevo, y la clave del medio, 35, sube a una raíz nueva. Fíjense que 35 ya no está en ninguno de los dos nodos internos:
[35]
[15 25] [45]
[5 10] [15 20] [25 30] [35 40] [45 50]
El árbol pasó de altura 2 a altura 3 por la raíz. Las cinco hojas siguen a la misma profundidad y enlazadas en orden.
Error común. Copiar la clave del medio también en el split de un nodo interno, o subirla sin copiar en el split de una hoja. En una hoja la clave se copia (la primera de la hoja nueva queda en la hoja y en el padre); en un nodo interno, sube (queda solo en el padre). Una forma de comprobarlo: después de una inserción, toda clave tiene que seguir estando en alguna hoja.
El costo de una inserción
Una inserción lee las h páginas del camino y, sin splits, escribe una: la hoja. Un split escribe tres (las dos mitades y el padre) y puede subir hasta la raíz, pero son raros: una hoja de 400 lugares se divide una vez cada unas 200 inserciones. En promedio, h lecturas y poco más de una escritura.
Hay un caso que vale la pena mirar. Si las claves llegan en orden, como
shipment_id en Chasqui, todas las inserciones van a la última hoja, que se
llena y se divide una y otra vez. Con la regla del libro, cada hoja vieja
queda a la mitad para siempre, porque nunca más llega una clave a ella.
PostgreSQL detecta ese caso: cuando se divide la hoja de más a la derecha,
deja la hoja vieja llena hasta el fill factor y no a la mitad.
Borrado en un B+ tree
Las reglas
Para borrar la entrada (k, p):
- Se busca la hoja y se quita la entrada.
- Si la hoja sigue con al menos ⌈(n − 1)/2⌉ claves, listo. Si no, quedó
con underflow y hay dos opciones, según un hermano vecino (el de la
izquierda o el de la derecha, con el mismo padre):
- Si las entradas de la hoja y las del hermano caben juntas en un nodo, se fusionan (coalesce): todo pasa al nodo de la izquierda, el de la derecha se libera, y se borra del padre la clave separadora y el puntero al nodo liberado. Esto es un borrado en el padre, que puede dejarlo con underflow a él.
- Si no caben, se redistribuye: se pasa una entrada del hermano a la hoja (la última del hermano de la izquierda o la primera del de la derecha) y se actualiza la clave separadora del padre.
- En un nodo interno con underflow se hace lo mismo con sus punteros, con una diferencia que es el espejo de la inserción: al fusionar, la clave separadora del padre baja al nodo fusionado; al redistribuir, la clave separadora baja y una clave del hermano sube a reemplazarla.
- Si la raíz queda con un solo hijo, se borra y ese hijo pasa a ser la raíz. El árbol se achica por la raíz, igual que crece.
Un ejemplo
Partimos del árbol de diez claves de la sección anterior, con n = 4: una hoja necesita al menos ⌈3/2⌉ = 2 claves y un nodo interno al menos 2 hijos.
[35]
[15 25] [45]
[5 10] [15 20] [25 30] [35 40] [45 50]
−20: fusión de hojas. La hoja [15 20] queda con [15], una clave: hay underflow. Su hermano izquierdo, [5 10], tiene dos; juntas son tres claves, que caben en una hoja. Se fusionan en [5 10 15] y se borra del padre la clave 15 con su puntero. El padre queda [25] con dos hijos, que es el mínimo, y no hay que seguir:
[35]
[25] [45]
[5 10 15] [25 30] [35 40] [45 50]
−50: fusión que llega a la raíz. La hoja [45 50] queda [45]. Su único hermano, [35 40], tiene dos claves: juntas son tres, se fusionan en [35 40 45] y se borra del padre la clave 45. Ese padre era [45] con dos hijos; ahora tiene un hijo y ninguna clave: underflow en un nodo interno. Su hermano [25] tiene dos hijos; juntos son tres punteros, que caben en un nodo de hasta cuatro. Se fusionan, y la clave que los separaba en la raíz, 35, baja al nodo fusionado, que queda [25 35] con tres hijos. La raíz pierde su única clave y se queda con un hijo, así que se borra: el árbol baja a altura 2.
[25 35]
[5 10 15] [25 30] [35 40 45]
−30: redistribución. La hoja [25 30] queda [25]. Su hermano izquierdo, [5 10 15], tiene tres claves: juntas serían cuatro, que no caben en una hoja de tres. Entonces se redistribuye: el 15 pasa del hermano a la hoja, que queda [15 25], y la clave separadora del padre cambia de 25 a 15, la nueva primera clave de la hoja.
[15 35]
[5 10] [15 25] [35 40 45]
Comprueben el invariante: a la izquierda del 15, claves menores que 15; entre 15 y 35, claves de 15 a 34; a la derecha del 35, claves ≥ 35. Las claves de los nodos internos no tienen por qué estar en las hojas: si ahora se borra el 35, la hoja queda [40 45], sin underflow, y el 35 sigue en la raíz. Ya no está en ninguna hoja, pero sigue separando bien, que es lo único que se le pide a un separador.
Lo que hacen los motores
Las fusiones y redistribuciones mantienen la ocupación mínima, pero cuestan
escrituras y complican la concurrencia. Muchos motores no las hacen en cada
borrado. PostgreSQL, en particular, nunca fusiona ni redistribuye páginas
medio vacías: un DELETE solo marca la tupla del heap, y VACUUM después
quita las entradas del índice que apuntan a tuplas muertas. Si una página
del índice queda completamente vacía, VACUUM la saca del árbol y la
recicla para un split futuro; si queda medio vacía, se queda así. Un índice
con muchas páginas casi vacías está hinchado (bloated), y la forma de
compactarlo es reconstruirlo con REINDEX. La justificación es práctica:
en una tabla que crece, las páginas medio vacías se vuelven a llenar con
las inserciones siguientes.
Claves que se repiten
Hacer única la clave
¿Cómo indexar sender_id, que se repite? La sección 14.3.5 del libro
propone no tratar el caso aparte: hacer única la clave de búsqueda
agregándole el record id. El índice sobre sender_id se convierte en un
índice sobre el par (sender_id, record id), que no se repite nunca. Todos
los algoritmos de arriba funcionan sin cambios, porque suponen claves
únicas. Una búsqueda de sender_id = 42 es en realidad un rango: todos los
pares de (42, −∞) a (42, +∞). Y borrar una tupla es borrar exactamente un
par, sin recorrer una lista de punteros iguales.
PostgreSQL hace eso desde la versión 12: el ctid del heap es una columna
más de la clave, la última, que desempata entre valores iguales. Desde la
versión 13 hace además una deduplicación (deduplication): guarda el
valor una sola vez, seguido de la lista ordenada de sus ctid, en lo que
llama una posting list. Lógicamente sigue siendo un índice sobre (valor,
ctid); físicamente ocupa mucho menos. En chasqui_w10, con el índice
sobre sender_id creado (consultas sender_pages y posting_list):
 type | pages | items
------+-------+-------
 r    |     1 |    15
 l    |    15 |  1732
(2 rows)
itemoffset | itemlen | htid | tids
------------+---------+---------+-------------------------------------------------------------------------------------
1 | 16 | |
2 | 64 | (22,34) | {"(22,34)","(26,43)","(52,57)","(85,28)","(87,30)","(99,21)","(102,11)","(122,46)"}
3 | 32 | (55,74) | {"(55,74)","(61,15)"}
(3 rows)Las 15 hojas tienen 1732 entradas: los 1718 clientes distintos que envían
algo, más 14 high keys. No hay una entrada por envío sino una por cliente.
La segunda entrada es la del cliente 1: 64 bytes con los 8 ctid de sus
envíos, en orden de página. Son exactamente los que devuelve
SELECT ctid FROM shipment WHERE sender_id = 1 (consulta sender_1).
En chasqui_big, donde cada cliente tiene unos 10 envíos, la diferencia es
grande (big.sql, sender_sizes):
           relname           | relpages | size
-----------------------------+----------+-------
 shipment_sender_idx         |     2286 | 18 MB
 shipment_sender_nodedup_idx |     5527 | 43 MB
(2 rows)
El mismo índice, con la deduplicación apagada (WITH (deduplicate_items = off)), ocupa 2,4 veces más: lo mismo que la clave primaria, una entrada por
fila.
Bulk loading
Construir un índice de una vez
Insertar 2 millones de entradas una por una, en orden aleatorio de clave, cuesta una lectura al azar por inserción si el índice no entra en memoria, y deja las hojas, en promedio, a unos dos tercios de su capacidad.
El bulk loading (sec. 14.4) lo hace al revés:
- Se arman todas las entradas (clave, record id) y se ordenan por clave, con el ordenamiento externo que veremos la semana 11 si no entran en memoria.
- Se llenan las hojas de izquierda a derecha con las entradas ordenadas, cada una hasta el fill factor, y se escriben una sola vez, en orden.
- Se construye el nivel de arriba con la primera clave de cada hoja, de la misma forma, y así hasta que un nivel entra en un solo nodo, que es la raíz.
El árbol se construye de abajo hacia arriba, cada página se escribe una
vez y las escrituras son secuenciales. Es lo que hace CREATE INDEX en
PostgreSQL.
Medido
En big.sql cargamos los 2 012 000 envíos en
dos tablas iguales. En la primera, el índice sobre sender_id se crea
después de cargar; en la segunda, antes, así que recibe 2 012 000
inserciones en orden aleatorio de sender_id. Sin deduplicación, para
comparar solo el llenado de las hojas. Los tiempos de una corrida (cambian
de una máquina a otra):
| Cargar la tabla | Crear el índice | Total | |
|---|---|---|---|
| Índice al final (bulk loading) | 1,3 s | 1,0 s | 2,3 s |
| Índice desde antes | 4,6 s (con el índice) | — | 4,6 s |
Y la forma de los dos índices (bulk_vs_incr):
    build    | leaves | avg_items | avg_free
-------------+--------+-----------+----------
 bulk        |   5498 |       367 |      802
 incremental |   6899 |       293 |     2295
(2 rows)
El índice construido de una vez tiene las hojas llenas al 90 %, como
dijimos. El otro tiene un 25 % más de hojas, con 293 entradas en promedio
en vez de 367: es la ocupación típica de un B+ tree que crece con
inserciones al azar, alrededor del 70 %. La regla práctica que sale de aquí:
para cargar muchos datos, primero se cargan y después se crean los índices.
Es lo que hace pg_dump: el script que produce crea los índices al final.
Índices hash
Hashing estático
La segunda familia de índices no ordena nada. Un índice hash (sec. 14.5) tiene B buckets, cada uno una página, y una función de hash h que lleva cada valor de la clave a un número de bucket entre 0 y B − 1. La entrada (k, record id) se guarda en el bucket h(k). Para buscar k se calcula h(k) y se lee ese bucket: una lectura, sin importar el tamaño de la tabla, si el bucket no hizo overflow.
Una buena función de hash cumple dos cosas:
- Es uniforme: reparte los valores posibles de la clave de forma pareja entre los buckets.
- Es aleatoria: los valores que de verdad aparecen también quedan repartidos, aunque se parezcan entre sí (DNI consecutivos, nombres que empiezan igual). Una función como “la primera letra del apellido” es uniforme sobre el alfabeto, pero con apellidos peruanos llenaría el bucket de la Q.
Un bucket hace overflow porque hay más entradas que lugar en B buckets, o por sesgo (skew): muchas entradas con el mismo valor, o una función que reparte mal. Un bucket con overflow se encadena con páginas de overflow, y buscar en una cadena de tres páginas cuesta tres lecturas. El problema de fondo del hashing estático es que B se fija al crear el índice: si la tabla crece diez veces, las cadenas se alargan; si se elige B pensando en el futuro, hoy se desperdicia espacio; y cambiar B obliga a reconstruir el índice entero.
Extendable hashing
El hashing dinámico cambia el número de buckets a medida que crece el índice. La primera técnica, extendable hashing (sec. 24.5; también se escribe extendible), funciona así:
- La función de hash produce un número de 32 bits, pero solo se usan sus primeros i bits, donde i es la profundidad global (global depth).
- Un directorio de 2^i entradas dice a qué bucket ir para cada combinación de i bits.
- Varias entradas del directorio pueden apuntar al mismo bucket. Cada bucket j tiene su profundidad local iⱼ ≤ i: todas sus claves comparten los primeros iⱼ bits, y lo apuntan 2^(i − iⱼ) entradas del directorio.
Buscar es leer el directorio (casi siempre en memoria) y un bucket. La gracia está en la inserción. Si el bucket de la clave tiene lugar, se inserta y listo. Si está lleno:
- Si iⱼ < i, el bucket se divide en dos de profundidad iⱼ + 1, sus entradas se reparten según el bit siguiente, y se reasignan los punteros del directorio que lo apuntaban (la mitad a cada bucket). El directorio no crece.
- Si iⱼ = i, no hay forma de distinguir sus claves con los bits que usa el directorio, así que primero se duplica el directorio: i crece en 1, y cada entrada vieja pasa a ser dos entradas nuevas que apuntan al mismo bucket. Ahora iⱼ < i, y se divide como en el caso anterior.
Después de dividir se vuelve a intentar la inserción: si todas las claves fueron al mismo lado, el bucket sigue lleno y hay que dividir otra vez. Si todas las claves tienen el mismo hash (un valor muy repetido), dividir no sirve: hace falta un bucket de overflow.
Un ejemplo con los DNI de Chasqui
Usemos la función de hash que PostgreSQL aplica a un character(8),
hashbpchar, sobre los DNI de los primeros clientes, con buckets de 2
entradas para que se llenen rápido (indexes.sql,
consulta dni_bits):
 customer_id |   dni    |      h      |               bits
-------------+----------+-------------+----------------------------------
           1 | 61830975 |   292428428 | 00010001011011100001101010001100
           2 | 17232205 | -1757271257 | 10010111010000100010101100100111
           3 | 36948162 |  -309584369 | 11101101100011000001111000001111
           4 | 15433383 |   621095809 | 00100101000001010010101110000001
           5 | 23448138 | -2013037940 | 10001000000000110111101010001100
           6 | 75503630 |  1591562236 | 01011110110111010100111111111100
           7 | 24986841 | -1005250091 | 11000100000101010001100111010101
           8 | 36581411 |  1096976409 | 01000001011000101000100000011001
           9 | 58728634 | -1185145636 | 10111001010111000001110011011100
          10 | 52821692 | -1956579850 | 10001011011000001111010111110110
(10 rows)
Solo importan los primeros bits de la última columna. Los insertamos en
orden con exthash.mjs, una implementación
en memoria que sigue el libro; exthash-demo.mjs
muestra el directorio después de cada paso
(PGDATABASE=chasqui_w10 node exthash-demo.mjs 10). En cada línea, a la
izquierda la entrada del directorio, entre corchetes los bits que comparten
las claves del bucket (tantos como su profundidad local) y después las
claves.
Al principio i = 0: el directorio tiene una entrada y hay un bucket. Los
dos primeros DNI entran en él. El tercero, 36948162, lo encuentra lleno, con
iⱼ = i = 0: se duplica el directorio (i = 1) y el bucket se divide
según el primer bit: 61830975 empieza con 0 y queda en el bucket [0];
17232205 y 36948162 empiezan con 1 y van al [1]. 15433383 (bits 0010...) entra en el bucket 0. 23448138 (1000...) va al
bucket 1, que está lleno con iⱼ = i = 1: se duplica el directorio
(i = 2) y se divide el bucket 1 en 10 y 11. El bucket 0 no se tocó:
lo apuntan ahora dos entradas, 00 y 01, y sigue con profundidad local 1:
profundidad global 2
00 -> [0] 61830975 15433383
01 -> [0] (igual que 00)
10 -> [10] 17232205 23448138
11 -> [11] 36948162
75503630 (0101...) va al bucket [0], lleno, pero ahora iⱼ = 1 < i =
2: se divide sin duplicar el directorio. 61830975 (00...) y 15433383
(00...) quedan en [00]; el bucket [01] recibe al recién llegado.
Después entran sin problemas 24986841 (11...) y 36581411 (01...):
profundidad global 2
00 -> [00] 61830975 15433383
01 -> [01] 75503630 36581411
10 -> [10] 17232205 23448138
11 -> [11] 36948162 24986841
Los cuatro buckets están llenos. 58728634 (101...) va al [10], con
iⱼ = i = 2: se duplica el directorio a 8 entradas y el bucket se divide
según el tercer bit. 17232205 (100...) y 23448138 (100...) quedan en
[100]; 58728634, en [101]. Los otros tres buckets no se movieron; cada
uno tiene ahora dos entradas del directorio:
profundidad global 3
000 -> [00] 61830975 15433383
001 -> [00] (igual que 000)
010 -> [01] 75503630 36581411
011 -> [01] (igual que 010)
100 -> [100] 17232205 23448138
101 -> [101] 58728634
110 -> [11] 36948162 24986841
111 -> [11] (igual que 110)
Cinco buckets y un directorio de 8 entradas. Lo importante es lo que no pasó: en ningún momento se recalculó el bucket de todas las claves, solo el de las del bucket que se dividía. Eso es lo que hace barato crecer. El costo está en el directorio: con datos sesgados, un solo bucket que se llena una y otra vez lo duplica muchas veces. Inserten el décimo DNI con la demo y vean qué pasa (es el ejercicio 6).
Linear hashing
El linear hashing (CMU 15-445, clase #07) prescinde del directorio. Los buckets están numerados 0, 1, 2, … y un puntero de división (split pointer) s indica cuál es el próximo bucket que se va a dividir. Con N buckets al inicio de una ronda se usan dos funciones: h₀(k) = h(k) mod N y h₁(k) = h(k) mod 2N.
- Para buscar k: se calcula b = h₀(k); si b < s, ese bucket ya se dividió en esta ronda, y se usa b = h₁(k).
- Cuando cualquier bucket hace overflow (o cuando la ocupación pasa de un umbral), se divide el bucket s, no necesariamente el que hizo overflow: sus entradas se reparten con h₁ entre el bucket s y un bucket nuevo al final, el s + N, y s avanza en 1. El bucket que hizo overflow resuelve su problema por ahora con una página de overflow.
- Cuando s llega a N, todos los buckets de la ronda se dividieron: hay 2N buckets, s vuelve a 0 y empieza una ronda nueva con N = 2N.
El índice crece un bucket por vez, de forma pareja, sin duplicar nada de golpe. A cambio, por un tiempo hay cadenas de overflow en buckets que todavía no les tocó dividirse.
Hash frente a B+ tree
| Índice hash | B+ tree | |
|---|---|---|
Igualdad (dni = '61830975') |
≈ 1 lectura del bucket (más overflow) | h lecturas (3 o 4, casi todas en el buffer pool) |
Rango (created_at BETWEEN ...) |
No sirve | Baja una vez y recorre hojas |
ORDER BY, MIN, MAX |
No sirve | Sale en orden |
| Datos muy repetidos o con sesgo | Cadenas de overflow largas | Sin problema |
Como los niveles altos de un B+ tree casi siempre están en memoria, la
ventaja del hash en igualdad es de una o dos lecturas, y el B+ tree sirve
para todo lo demás. Por eso casi todos los índices de una base de datos
relacional son B+ trees. Los índices hash brillan en otro lado: en las tablas hash en
memoria que usa el motor para ejecutar un hash join o un GROUP BY (semana
11), donde no hay rangos y todo está en memoria.
Índices hash en PostgreSQL
PostgreSQL tiene índices hash (USING hash). Según su documentación, cada
entrada guarda solo los 4 bytes del hash, no el valor (por eso toda búsqueda
tiene que comprobar la fila en el heap), las páginas llenas se
encadenan con páginas de overflow, y el índice crece agregando buckets de
a uno, dividiendo un bucket existente, en la línea del linear hashing.
También tiene limitaciones fuertes (indexes.sql,
sección 9):
CREATE INDEX customer_dni_hash ON customer USING hash (dni);
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT first_name, last_name FROM customer WHERE dni = '61830975';
Index Scan using customer_dni_hash on customer (actual rows=1.00 loops=1)
Index Cond: (dni = '61830975'::bpchar)
Index Searches: 1
Buffers: shared hit=3Tres páginas: la metapágina del índice (que dice cuántos buckets hay), el
bucket y la página del heap. La metapágina queda guardada en la memoria de
la sesión, como la del B-tree, así que las búsquedas siguientes leen 2. Para
un rango, el planner ignora el índice hash y usa el B-tree de la
restricción UNIQUE (dni_range):
 Index Scan using customer_dni_key on customer
   Index Cond: ((dni >= '61830900'::bpchar) AND (dni <= '61830999'::bpchar))
Y no admite ni UNIQUE ni varias columnas:
CREATE UNIQUE INDEX customer_dni_hash ON customer USING hash (dni);
CREATE INDEX customer_dni_city_hash ON customer USING hash (dni, city);
ERROR: access method "hash" does not support unique indexes
ERROR: access method "hash" does not support multicolumn indexesEn chasqui_big, con 201 800 clientes (big.sql,
sección 9), el índice hash sobre dni no es más chico que el B-tree, porque
un character(8) ocupa casi lo mismo que su hash. Una búsqueda, ya
guardada la metapágina, lee 2 páginas (bucket y heap); con el B-tree, de
altura 3, lee 4 (dni_hash_again y dni_btree):
      relname      | relpages |  size
-------------------+----------+---------
 customer_dni_hash |      842 | 6736 kB
 customer_dni_key  |      782 | 6256 kB
(2 rows)
Dos páginas menos por búsqueda, en un B-tree cuyos dos primeros niveles están casi siempre en memoria, rara vez justifican un índice que no sirve para nada más. El hash gana espacio cuando la clave es larga (una URL, un UUID en texto), porque guarda 4 bytes en vez del valor. En el resto de los casos, el B-tree.
Acceso con varias claves
Dos índices de una columna
Una consulta como esta filtra por dos columnas:
SELECT count(*) FROM shipment
WHERE origin_agency_id = 12
  AND created_at >= '2026-04-01' AND created_at < '2026-04-08';
Si hay un índice sobre cada columna, el libro (sec. 14.6) describe tres
estrategias: usar el índice de origin_agency_id y filtrar la fecha en
cada tupla; usar el de created_at y filtrar la agencia; o usar los dos,
sacar de cada uno el conjunto de record ids y quedarse con la
intersección, para leer solo las tuplas que cumplen las dos
condiciones. PostgreSQL hace la tercera con un BitmapAnd
(big.sql, bitmap_and). De aquí en adelante,
en los planes largos de big.sql dejo solo las líneas que importan; el
plan completo sale al correr el archivo:
 Aggregate (actual rows=1.00 loops=1)
   Buffers: shared hit=1644 read=1331
   ->  Bitmap Heap Scan on shipment (actual rows=2837.00 loops=1)
         Heap Blocks: exact=2686
         ->  BitmapAnd (actual rows=0.00 loops=1)
               Buffers: shared read=289
               ->  Bitmap Index Scan on shipment_origin_idx (actual rows=67161.00 loops=1)
                     Index Cond: (origin_agency_id = 12)
                     Buffers: shared read=59
               ->  Bitmap Index Scan on shipment_created_idx (actual rows=82775.00 loops=1)
                     Buffers: shared read=230
Cada Bitmap Index Scan arma un bitmap: un bit por cada tupla (o por
cada página) del heap, prendido si la tupla cumple la condición. El de la
agencia tiene 67 161 bits prendidos; el de la semana, 82 775. El BitmapAnd
hace el AND bit a bit y deja 2837 tuplas en 2686 páginas, que el Bitmap
Heap Scan lee en orden de página. Es mejor que cualquiera de los dos
índices solos, pero todavía cuesta casi 3000 páginas. (El rows=0.00 del
BitmapAnd no es un error: un bitmap no se cuenta en filas.)
Índices compuestos
La alternativa es un índice sobre las dos columnas, un índice compuesto
(composite index). Su clave de búsqueda es el par (origin_agency_id,
created_at) y sus entradas están ordenadas lexicográficamente: primero
por agencia y, dentro de cada agencia, por fecha. Es como una guía
telefónica, ordenada por apellido y, dentro del apellido, por nombre:
(12, 2026-03-31 23:58) (12, 2026-04-01 00:07) ... (12, 2026-04-30 23:50) (12, 2026-05-01 00:02) ... (13, ...)
                       └──────────── origin_agency_id = 12 y abril ───────────┘
Todas las entradas de la agencia 12 en abril están juntas: se baja una
vez al primer (12, 2026-04-01) y se recorren las hojas hasta la primera
entrada de mayo. Con el índice en (origin_agency_id, created_at) y la
consulta de un mes entero (origin_created de big.sql):
 Aggregate (actual rows=1.00 loops=1)
   Buffers: shared hit=1 read=48
   ->  Index Only Scan using shipment_origin_created_idx on shipment (actual rows=11838.00 loops=1)
         Heap Fetches: 0
         Index Searches: 1
         Buffers: shared hit=1 read=48
49 páginas para 11 838 envíos, sin tocar el heap (es un index-only scan, que
explicamos enseguida). Ahora con las columnas al revés, (created_at, origin_agency_id) (created_origin):
 Aggregate (actual rows=1.00 loops=1)
   Buffers: shared hit=10 read=1370
   ->  Index Only Scan using shipment_created_origin_idx on shipment (actual rows=11838.00 loops=1)
         Heap Fetches: 0
         Index Searches: 1
         Buffers: shared hit=10 read=1370
1380 páginas, 28 veces más, para el mismo resultado. En este índice las entradas están ordenadas por fecha; las de la agencia 12 en abril están mezcladas con las de las otras 27 agencias en el mismo mes. El índice tiene que recorrer todo abril y descartar las entradas de las demás agencias. La regla, que Winand explica en Concatenated Keys:
Idea clave. En un índice compuesto, las columnas que se comparan con igualdad van primero y la que se compara con un rango va después. El índice sirve para cualquier prefijo de sus columnas: el de
(origin_agency_id, created_at)sirve paraorigin_agency_id = 12solo, pero no, en principio, paracreated_atsolo.
Skip scan
¿Y si la consulta filtra solo por created_at y el único índice es el de
(origin_agency_id, created_at)? Antes de PostgreSQL 18, el índice casi no
servía: había que recorrerlo entero. PostgreSQL 18 agrega el skip scan:
el índice se trata como 28 índices chicos, uno por agencia, y se hace una
búsqueda en cada uno (skip_scan de big.sql, una hora del 1 de abril):
 Aggregate (actual rows=1.00 loops=1)
   Buffers: shared hit=38 read=56
   ->  Index Only Scan using shipment_origin_created_idx on shipment (actual rows=471.00 loops=1)
         Heap Fetches: 0
         Index Searches: 30
         Buffers: shared hit=38 read=56
Index Searches: 30: el índice bajó desde la raíz unas treinta veces, más o
menos una por agencia (algunas se resuelven en la misma hoja que la
anterior, otras necesitan una bajada extra). Con 94 páginas sigue siendo
mucho mejor que un sequential scan. El skip scan conviene cuando la primera
columna tiene pocos valores distintos; con una columna como sender_id
(200 000 valores) serían 200 000 búsquedas.
Index-only scans y covering indexes
En los planes de arriba aparece un nodo nuevo, Index Only Scan: la
consulta se respondió solo con el índice, sin leer el heap. Es posible
cuando todas las columnas que la consulta necesita están en el índice:
count(*) con condiciones sobre origin_agency_id y created_at no
necesita nada más. Un índice que contiene todas las columnas de una
consulta se llama covering index para esa consulta.
Para hacer un índice covering sin cambiar su orden, PostgreSQL permite
agregar columnas que no son parte de la clave con INCLUDE. Las columnas
incluidas se guardan solo en las hojas; no sirven para buscar, pero sí para
contestar. En chasqui_w10 (indexes.sql,
sección 10):
CREATE INDEX shipment_sender_status_idx ON shipment (sender_id) INCLUDE (status);
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT sender_id, status FROM shipment WHERE sender_id = 42;
Index Only Scan using shipment_sender_status_idx on shipment (actual rows=51.00 loops=1)
Index Cond: (sender_id = 42)
Heap Fetches: 0
Index Searches: 1
Buffers: shared hit=1 read=23 páginas, contra las 47 del índice sin INCLUDE de la primera sección.
Hay una condición escondida. En PostgreSQL, el índice no sabe si una
entrada apunta a una versión de la fila que la transacción actual puede ver
(eso es MVCC, semana 14). Solo lo puede asegurar si la página del heap está
marcada como toda visible en el visibility map, un mapa de dos bits
por página que mantiene VACUUM. Si la página no está marcada, el index-only
scan tiene que ir al heap a mirar: eso cuenta Heap Fetches. Actualizamos
los 51 envíos del cliente 42 (sin hacer commit) y repetimos la consulta:
 Index Only Scan using shipment_sender_status_idx on shipment (actual rows=51.00 loops=1)
   Heap Fetches: 101
   Buffers: shared hit=50
Siguen siendo 51 filas, pero el índice tiene ahora dos entradas por envío,
la de la versión vieja y la de la nueva (casi ningún UPDATE pudo ser HOT,
semana 9, porque las páginas estaban llenas), y casi todas apuntan a
páginas que dejaron de ser todas visibles: 101 visitas al heap. Un
index-only scan rinde solo si VACUUM (o el autovacuum) pasa seguido.
Índices en PostgreSQL
Crear y borrar
La sintaxis (sec. 14.7 y la documentación de
CREATE INDEX):
CREATE [UNIQUE] INDEX [CONCURRENTLY] nombre
  ON tabla [USING método] (columna o (expresión) [ASC | DESC], ...)
  [INCLUDE (columnas)]
  [WITH (parámetro = valor)]
  [WHERE condición];

DROP INDEX [CONCURRENTLY] nombre;
CREATE UNIQUE INDEXademás rechaza valores repetidos. Es lo que PostgreSQL crea para cadaPRIMARY KEYy cadaUNIQUE(shipment_pkey,customer_dni_key).- PostgreSQL no crea índices para las claves foráneas: en
shipment,sender_id,recipient_id,origin_agency_id,dest_agency_idytrip_idno tienen índice. Buscar los envíos de un cliente es un sequential scan, y borrar un cliente obliga a recorrershipmentpara comprobar que nadie lo referencia. CREATE INDEXbloquea las escrituras sobre la tabla mientras construye el índice.CREATE INDEX CONCURRENTLYno las bloquea, a cambio de recorrer la tabla dos veces; no se puede usar dentro de una transacción.WITH (fillfactor = 70)deja más espacio libre en cada hoja (el valor por defecto en un B-tree es 90) para que los splits tarden más.
Los tipos de índice
USING elige el método de acceso. PostgreSQL trae seis
(Index Types):
| Método | Qué es | Para qué sirve |
|---|---|---|
btree (por defecto) |
El B+ tree de este capítulo | =, <, <=, >, >=, BETWEEN, IN, IS NULL, LIKE 'abc%' (con la collation C o la clase de operadores text_pattern_ops), ORDER BY |
hash |
Hashing con buckets de a uno | Solo = |
gin |
Índice invertido: para cada elemento, la lista de filas que lo contienen | Valores con partes: jsonb (semana 8), arreglos, texto completo |
brin |
Un resumen (mínimo y máximo) por cada rango de páginas | Tablas enormes con una columna que sigue el orden físico |
gist, spgist |
Árboles balanceados generales, extensibles | Datos geométricos, rangos, búsqueda del vecino más cercano |
El GIN ya lo usamos en la semana 8 para details @> '{"fragile": true}'. La
idea es la de un índice invertido de un buscador: en vez de una entrada por
fila, una entrada por cada elemento (cada clave o valor del documento),
con la lista de las filas que lo contienen.
BRIN: un índice disperso
El BRIN (block range index) es el pariente más cercano que tiene
PostgreSQL al índice disperso del libro. Divide la tabla en rangos de 128
páginas y guarda, para cada rango, el mínimo y el máximo de la columna. Para
una condición, descarta los rangos cuyo intervalo no la puede cumplir y lee
los demás enteros. Como el índice disperso, solo funciona si la tabla está
ordenada por la columna, o casi. En chasqui_big, sobre shipment_id
(correlación 1) y sobre created_at (correlación 0) (big.sql, sección 8):
        relname        | relpages | size
-----------------------+----------+-------
 shipment_pkey         |     5519 | 43 MB
 shipment_created_brin |        3 | 24 kB
 shipment_id_brin      |        3 | 24 kB
(3 rows)
Tres páginas frente a 5519: un BRIN es diminuto. Sus resúmenes cuentan por
qué uno sirve y el otro no (brin_items y brin_items_created):
 blknum |       value
--------+--------------------
      0 | {1 .. 10396}
    128 | {10397 .. 108821}
    256 | {108822 .. 119263}
    384 | {119264 .. 129708}
(4 rows)
Cada rango de 128 páginas tiene envíos con shipment_id en un intervalo
angosto y propio. El mismo resumen para created_at (brin_items_created)
dice, para el primer rango, {2026-01-05 00:00:00-05 .. 2026-06-26 23:54:00-05}, y algo parecido para los demás: envíos de todo el
semestre en cada rango. Para
shipment_id BETWEEN 1000000 AND 1009999, el BRIN marca 2 rangos, 256
páginas (Heap Blocks: lossy=256), y lee 264 páginas en total. Para un día
de created_at, todos los rangos pueden tener filas de ese día: el BRIN
no descarta nada. En chasqui_w10, con rangos de 4 páginas
(indexes.sql, sección 11, con el
sequential scan desactivado para obligar a usarlo):
   ->  Bitmap Heap Scan on shipment (actual rows=72.00 loops=1)
         Rows Removed by Index Recheck: 11928
         Heap Blocks: lossy=148
Las 148 páginas, para 72 filas. Después de CLUSTER shipment USING shipment_created_idx (la tabla queda ordenada por fecha), el mismo BRIN:
   ->  Bitmap Heap Scan on shipment (actual rows=72.00 loops=1)
         Rows Removed by Index Recheck: 253
         Heap Blocks: lossy=4
Cuatro páginas. El BRIN es ideal para una tabla que solo crece y se consulta por la fecha de inserción, como un log de eventos; nuestros datos de ejemplo no se cargaron en orden de fecha.
Índices parciales
Un índice parcial indexa solo las filas que cumplen una condición
(WHERE en CREATE INDEX). Los envíos sin entregar son 885 de 12 000, y
son los que más se consultan (dónde están, cuáles se atrasaron):
CREATE INDEX shipment_pending_idx ON shipment (origin_agency_id)
  WHERE delivered_at IS NULL;
relname | relpages | entries
----------------------+----------+---------
shipment_origin_idx | 13 | 12000
shipment_pending_idx | 2 | 885
(2 rows)Dos páginas en vez de 13, y un índice que no se toca cuando se inserta o se
actualiza un envío entregado. El planner lo usa solo si puede probar que la
condición de la consulta implica la del índice: WHERE origin_agency_id = 1 AND delivered_at IS NULL lo usa (108 filas, consulta pending);
WHERE origin_agency_id = 1 AND status = 'in_transit' no, aunque en
nuestros datos todo envío en tránsito esté sin entregar, porque eso es un
hecho de los datos y no algo que se deduzca de las condiciones.
Índices sobre expresiones
Un índice puede ordenar el resultado de una expresión en vez de una
columna. Un índice sobre last_name no sirve para una búsqueda sin
mayúsculas (indexes.sql, sección 8):
                        QUERY PLAN
-----------------------------------------------------------
 Seq Scan on customer
   Filter: (lower(last_name) = 'villanueva ramírez'::text)
(2 rows)
porque el índice está ordenado por last_name, y el orden de
lower(last_name) puede ser otro. Con CREATE INDEX customer_lower_last_name_idx ON customer (lower(last_name)), sí:
   ->  Bitmap Index Scan on customer_lower_last_name_idx (actual rows=6.00 loops=1)
         Index Cond: (lower(last_name) = 'villanueva ramírez'::text)
La expresión de la consulta tiene que ser la misma del índice. En la
semana 8 hicimos lo mismo con details #>> '{insurance,insurer}'.
Cuándo un índice no ayuda
La cuenta
Un índice secundario encuentra rápido los record ids, pero después hay que
ir a buscar cada tupla al heap, y con un índice secundario cada una puede
estar en una página distinta. Con el modelo de costo de la semana 9
(t_S ≈ 4 ms, t_T ≈ 0,1 ms en un disco magnético; t_S ≈ 90 µs, t_T ≈ 10 µs
en un SSD), y con la shipment de chasqui_big (24 667 páginas, 2 012 000
filas):
- Sequential scan: un seek y 24 667 transferencias. Disco: 4 + 24 667 × 0,1 ≈ 2471 ms. SSD: 0,09 + 24 667 × 0,01 ≈ 247 ms.
- Índice secundario que devuelve el 10 % de las filas (201 200), cada una en una página al azar: 201 200 × (t_S + t_T). Disco: 201 200 × 4,1 ms ≈ 825 s, casi 14 minutos. SSD: 201 200 × 0,1 ms ≈ 20 s.
El índice es 334 veces más lento que leer la tabla entera en el disco, y 81 veces en el SSD. El punto de equilibrio está donde las dos cuentas coinciden: 2471 / 4,1 ≈ 600 filas en el disco, el 0,03 % de la tabla; 247 / 0,1 ≈ 2470 filas en el SSD, el 0,12 %. Un índice secundario solo gana cuando la condición es muy selectiva, o cuando evita un ordenamiento.
Error común. Creer que un índice siempre ayuda. Ayuda cuando la condición deja pasar pocas filas, cuando la consulta se responde solo con el índice o cuando evita un
ORDER BY. En los demás casos, el planner no lo usa, y lo único que hace el índice es ocupar espacio y encarecer cada escritura.
El bitmap scan
PostgreSQL tiene una estrategia intermedia, que ya vimos varias veces: el
bitmap scan. Primero recorre el índice y arma un bitmap con las páginas
del heap que tienen filas que sirven; después lee esas páginas en orden
físico, cada una una sola vez. Con muchas filas por página, nunca lee más
páginas que la tabla, y las lee en orden, como un sequential scan con
huecos. Si el bitmap no entra en memoria (work_mem), se vuelve lossy:
guarda páginas en vez de filas y hay que volver a comprobar la condición
en cada fila de la página (Recheck Cond).
Medido
En big.sql creamos un índice sobre created_at
y pedimos rangos cada vez más anchos. Como created_at no sigue el orden
físico, es el peor caso para un índice secundario:
| Rango | Filas | % de la tabla | Plan elegido | Páginas del heap | Tiempo |
|---|---|---|---|---|---|
| 10 minutos | 74 | 0,004 % | Bitmap scan | 73 | 0,5 ms |
| 1 día | 11 934 | 0,6 % | Bitmap scan | 9489 | 15 ms |
| 1 mes (marzo) | 367 202 | 18 % | Bitmap scan | 24 667 (todas) | 108 ms |
| 3 meses (febrero a abril) | 1 052 486 | 52 % | Sequential scan | 24 667 | — |
Para un mes, el bitmap scan ya lee todas las páginas de la tabla: casi
todas tienen algún envío de marzo. Para tres meses, el planner pasa al
sequential scan. Y si obligamos a usar un index scan común (SET enable_seqscan = off; SET enable_bitmapscan = off), que va al heap en el
orden del índice, para el mismo mes (month_index_scan):
 Aggregate (actual time=553.920..553.921 rows=1.00 loops=1)
   Buffers: shared hit=240559 read=127631 written=13
   ->  Index Scan using shipment_created_idx on shipment (actual time=0.028..496.077 rows=367202.00 loops=1)
 Execution Time: 571.043 ms
368 190 accesos a páginas para una tabla de 24 667: casi uno por fila.
Con todo en memoria tardó 571 ms, tres veces lo que el sequential scan del
mismo mes (month_seq_scan, 180 ms); si las 127 631 lecturas fueran a un
disco magnético, serían casi nueve minutos. El planner nunca elige ese
plan: estima la selectividad con las estadísticas (semana 12) y compara el
costo de las tres estrategias. Los enable_* son herramientas de
diagnóstico; no se dejan apagados.
Lo que cuesta mantener un índice
Cada índice de una tabla se actualiza en cada INSERT, en cada DELETE
(con VACUUM) y en cada UPDATE que no sea HOT. En
big.sql insertamos los mismos 512 000 envíos
en tres tablas vacías: una sin índices, una con la clave primaria y una con
la clave primaria y tres índices más (sender_id, recipient_id,
created_at). EXPLAIN (ANALYZE, WAL) cuenta también lo que se escribió en
el log (el WAL, semana 15):
| Índices | Tiempo | Registros de WAL | Bytes de WAL |
|---|---|---|---|
| 0 | 286 ms | 512 002 | 65 MB |
| 1 (clave primaria) | 468 ms | 1 025 405 | 99 MB |
| 4 | 2455 ms | 2 577 921 | 227 MB |
Con cuatro índices, la misma carga tarda 8,6 veces más y escribe 3,5
veces más WAL: un registro por fila en el heap y uno por fila en cada
índice. La clave primaria es barata porque shipment_id llega en orden y
todo va a la última hoja; los otros tres reciben claves al azar, con splits
por todo el árbol.
Hay un costo más, menos visible. Un UPDATE que no cambia ninguna columna
indexada puede ser HOT (semana 9) y no tocar los índices; basta un índice
sobre la columna que se actualiza para que deje de serlo. Indexar status,
que cambia en cada etapa de un envío, hace que cada cambio de estado
escriba en todos los índices de shipment.
Idea clave. Un índice se justifica por las consultas que acelera, y se paga en cada escritura y en espacio. Antes de crear uno, hay que saber qué consultas lo van a usar (con
EXPLAIN) y cuántas escrituras recibe la tabla. Un índice que ninguna consulta usa es puro costo; PostgreSQL cuenta cuántas veces se usó cada uno enpg_stat_user_indexes.idx_scan.
LSM trees (opcional)
El B+ tree está optimizado para leer, pero cada inserción con clave al azar escribe una hoja al azar. Los LSM trees (log-structured merge trees, sec. 14.8) invierten la apuesta:
- Las escrituras van a una estructura ordenada en memoria, la memtable (y a un log secuencial, para no perderlas).
- Cuando la memtable se llena, se escribe al disco de una vez, en orden, como un run ordenado e inmutable (en RocksDB, una SSTable).
- En segundo plano, los runs se fusionan (compaction) en runs más grandes, como el merge de un ordenamiento externo, y se descartan las versiones viejas.
Una lectura busca en la memtable y en varios runs, del más nuevo al más viejo; un bloom filter por run (sec. 24.1) contesta “seguro no está” o “puede estar” con pocos bits por clave y evita leer runs en vano. El compromiso se describe con dos palabras: write amplification (cuántas veces se reescribe cada dato: en un B+ tree, una página entera por cada cambio; en un LSM, en cada compaction) y read amplification (cuántas estructuras mira una lectura: h páginas en un B+ tree, varios runs en un LSM). Los LSM trees son la base de RocksDB, LevelDB y Cassandra. PostgreSQL no los usa.
En el laboratorio
En la primera parte completan bptree.mjs,
un B+ tree en memoria con la representación de este capítulo: cada nodo
tiene sus keys ordenadas; un nodo interno tiene children (uno más que
claves: children[i] tiene las claves menores que keys[i]); una hoja
tiene values y next. order es el n del libro: una hoja guarda hasta
n − 1 claves y se divide al llegar a n. La clase ya trae upperBound
(búsqueda binaria en un nodo), height() y toString(), que dibuja el
árbol como en los ejemplos de este capítulo. Ustedes escriben search,
insert (con las reglas de split; con orden 4 y las claves 10, 20, 5, 15,
25, 30, 35 tiene que salir el árbol de altura 2 del ejemplo), el generador
*range(lo, hi) y una prueba de los invariantes (hojas a la misma
profundidad, ocupación mínima). Las pruebas están en
bptree.test.mjs; make lab corre solo
esas, sin la base de datos. Este árbol es el algoritmo del índice de P3; lo
que P3 agrega es guardarlo en páginas del buffer pool.
En la segunda parte repiten, sobre chasqui_big, las mediciones de este
capítulo con otros datos: sender_id con otro cliente, la altura de
shipment_pkey, el orden de las columnas con dest_agency_id y un índice
que no ayuda sobre weight_kg. Como chasqui_big se usa también en las
semanas 11 y 12, borren con DROP INDEX los índices que creen, o trabajen
sobre una copia, como hace make big.
El código de la semana y make test
make crea chasqui_w10, instala pageinspect y corre VACUUM (ANALYZE): el visibility map al día (para los index-only scans) y las
estadísticas fijas (para que los planes sean siempre los mismos). make test hace lo mismo y corre todas las pruebas, una después de otra:
✖ un árbol vacío no encuentra nada (1.218167ms)
...
✔ la clave primaria: Index Scan de 3 páginas, altura 2 (7.277041ms)
...
ℹ tests 18
ℹ pass 13
ℹ fail 5
Las cinco que fallan son las de bptree.test.mjs, y siguen fallando hasta
que completen el laboratorio; las otras 13 tienen que pasar desde el
principio.
| Archivo | Qué muestra |
|---|---|
indexes.sql |
Los ejemplos sobre chasqui_w10: la forma de shipment_pkey con pageinspect, sender_id con y sin índice, posting lists, índices compuestos y skip scan, parcial, sobre una expresión, hash, covering, CLUSTER y BRIN |
big.sql |
Las mediciones sobre 2 millones de envíos: altura real, deduplicación, bulk loading, selectividad, BitmapAnd, orden de columnas, BRIN, hash y el costo de escribir con índices |
exthash.mjs |
Extendable hashing en memoria, con directorio, profundidades y splits |
exthash-demo.mjs |
El ejemplo de los DNI, paso a paso, con el hash de PostgreSQL |
bptree.mjs |
El B+ tree del laboratorio, por completar |
*.test.mjs |
Las cifras de este capítulo contra chasqui_w10, los invariantes del extendable hashing y las pruebas del laboratorio |
Las consultas de los .sql empiezan con -- name: ..., como en las
semanas 5 y 9, y sqlfile.mjs las separa
para que las pruebas corran el mismo texto. Los índices de indexes.sql se
crean dentro de BEGIN ... ROLLBACK, pero un UPDATE deshecho igual deja
páginas que ya no son todas visibles: para ver los mismos números del
apunte, corran make antes de psql -d chasqui_w10 -f indexes.sql.
make big corre big.sql sobre chasqui_w10_big, una copia de
chasqui_big que make clean borra.
Resumen
- Un índice es una estructura auxiliar de entradas (clave de búsqueda, record id), que se evalúa por tipos de acceso, tiempo de acceso, de inserción y de borrado, y espacio, contados en páginas.
- Un índice de agrupamiento sigue el orden físico del archivo; uno
secundario, no, y cada tupla puede costar una página. Un índice
disperso necesita el archivo ordenado; un secundario tiene que ser
denso. En PostgreSQL todo índice es secundario, y
CLUSTERordena la tabla una sola vez. - Un B+ tree es un índice de varios niveles balanceado: nodos de una página, todos salvo la raíz al menos medio llenos, hojas a la misma profundidad y enlazadas, todas las claves en las hojas.
- Buscar cuesta una página por nivel, y la altura es ⌈log_f N⌉ con f
el fan-out: 3 niveles para 2 millones de claves, como confirma
bt_metapenchasqui_big. - Al insertar, el split de una hoja copia su primera clave nueva al
padre; el de un nodo interno sube la clave del medio. Al borrar, se
fusiona o se redistribuye. El árbol crece y se achica por la raíz.
PostgreSQL no fusiona:
VACUUMrecicla las páginas vacías. - Una clave repetida se hace única con el record id; PostgreSQL además
deduplica. Bulk loading (ordenar y construir de abajo hacia
arriba) es lo que hace
CREATE INDEX. - Un índice hash da igualdad en una lectura, sin rangos ni orden. Extendable hashing duplica un directorio; linear hashing divide buckets en orden con un puntero.
- En un índice compuesto, igualdad primero y rango después; PostgreSQL
18 tiene skip scan. Un covering index (
INCLUDE) permite un index-only scan si el visibility map está al día. Hay índices hash, GIN, BRIN, GiST, parciales y sobre expresiones; las claves foráneas no se indexan solas. - Un índice secundario solo gana con condiciones muy selectivas (unas 600 filas de 2 millones en disco, según el modelo de costo); el bitmap scan lee las páginas en orden. Cada índice encarece cada escritura.
Ejercicios
- Un B+ tree tiene fan-out n = 300 e indexa 20 millones de claves. Calculen su altura en el mejor y en el peor caso. ¿Cuántas páginas del segundo nivel tiene, como mucho? Si la raíz y el segundo nivel están en el buffer pool, ¿cuántas lecturas a disco cuesta una búsqueda por igualdad sobre una clave única?
- En un B+ tree vacío con n = 4, inserten en orden 8, 3, 12, 1, 6, 9,
15, 4, 7 y 5. Dibujen el árbol después de cada split e indiquen qué
claves se copiaron (split de hoja) y cuáles subieron (split de nodo
interno). Si ya hicieron el laboratorio, comprueben con
toString(). - Del árbol final del ejemplo de inserción (
[35],[15 25] [45], …), borren 40 y después 35. Indiquen en cada paso si hay underflow, si se fusiona o se redistribuye, y cómo queda el árbol. customerenchasqui_bigtiene 201 800 filas en 2040 páginas. Supongan que está ordenada porcustomer_idy que una página de índice guarda 400 entradas. ¿Cuántas páginas tiene un índice denso sobrecustomer_id? ¿Y uno disperso con una entrada por página? ¿Cuántos niveles necesita cada uno para que el de más arriba ocupe una sola página?- Expliquen por qué un índice disperso sobre
created_atno sirve enshipmentdechasqui_w10. ¿Qué devuelvecorrelationpara esa columna? ¿Qué tendría que pasar para que un BRIN sobrecreated_atayudara, sin usarCLUSTER? - Antes de correr
node exthash-demo.mjs 10, predigan qué pasa al insertar el décimo DNI (52821692, bits1000...): ¿se duplica el directorio? ¿Cuántas veces? ¿Cuántas entradas del directorio apuntan después al bucket[00]? Comprueben con la demo. - Linear hashing con h(k) = k, N = 2 buckets iniciales, buckets de 2 entradas, y una división cada vez que una inserción cae en un bucket lleno. Inserten 4, 7, 10, 3, 8, 5 y 12. Muestren después de cada paso los buckets, las páginas de overflow y el puntero de división.
- En
chasqui_w10, la consultaSELECT count(*) FROM shipment WHERE dest_agency_id = 3 AND created_at >= '2026-02-01' AND created_at < '2026-02-08';hace un sequential scan. Propongan un índice, créenlo dentro de una transacción, y comparen conEXPLAIN (ANALYZE, BUFFERS)cuántas páginas se leen con él y con el índice de columnas en el orden contrario. ¿Alguno da un index-only scan? ¿Por qué? - Creen un índice parcial sobre
shipment (created_at) WHERE status = 'registered'. Escriban una consulta que lo use y otra, parecida, que no pueda usarlo. Comparen su tamaño con el de un índice sobrecreated_atde toda la tabla. - Con el modelo de costo del SSD (t_S = 90 µs, t_T = 10 µs), una consulta
sobre
shipmentdechasqui_bigdevuelve el 1 % de las filas usando un índice secundario, cada fila en una página distinta. Comparen su costo con el de un sequential scan. ¿Y con un bitmap scan que, por tener 82 filas por página, lee como mucho todas las páginas una vez? ¿Qué fracción de las páginas esperan que toque ese bitmap scan si las filas están repartidas al azar? - En
chasqui_big, encuentren el rango decreated_atmás angosto para el que el planner elige un sequential scan en vez de un bitmap scan, con un índice sobrecreated_at, empezando el 1 de marzo (prueben con anchos de 8, 10, 12 y 14 semanas). Relacionen el resultado con la tabla de la sección Cuándo un índice no ayuda. Borren el índice al terminar. - (Desafío) Agreguen a la clase del laboratorio un método estático
BPlusTree.fromSorted(entries, order, fill)que construya el árbol con bulk loading: llenar hojas hasta una fracciónfilly armar los niveles de abajo hacia arriba. Escriban pruebas que comparen, para 100 000 claves, la altura y el número de hojas con las de un árbol construido coninserten orden aleatorio, y que revisen los invariantes.