
Apuntes · Capítulo 9Almacenamiento, índices y consultas
Almacenamiento físico, páginas y buffer pool
Almacenamiento físico, páginas y buffer pool
Durante ocho semanas usamos PostgreSQL desde arriba. Escribimos un esquema,
cargamos datos, hicimos consultas, pusimos restricciones y triggers, y
llamamos al DBMS desde Node.js. Nunca nos preguntamos dónde están las 12 000
filas de shipment ni qué hace el motor para encontrarlas. El modelo
relacional lo prometía así: una relación es un conjunto de tuplas, y el
usuario no tiene por qué saber cómo están guardadas. Desde esta semana hasta
la semana 12 cambiamos de lado. Vamos a abrir el motor y ver cómo guarda una
tabla en un archivo, cómo la lee, cómo la indexa y cómo ejecuta una consulta
sobre ella.
La pregunta que guía todo este tramo es una sola: ¿cuántas veces hay que ir al disco? Un DBMS existe porque los datos no entran en memoria o porque tienen que sobrevivir a un apagón, y en los dos casos viven en un dispositivo que es miles de veces más lento que la memoria principal. Casi todas las técnicas que vamos a ver (páginas con slots, buffer pool, índices, algoritmos de join, optimizador) existen para reducir ese número.
El capítulo tiene dos partes. En la primera bajamos hasta el hardware: la
jerarquía de almacenamiento, cómo funciona un disco magnético y por qué
importa tanto leer en orden, qué cambia con la memoria flash y los SSD, y el
modelo de costo en bloques que vamos a usar hasta la semana 12. En la segunda
subimos un nivel: cómo se guarda un registro de longitud fija o variable,
cómo se organizan los registros en una página con slots (slotted page), cómo
se organizan las páginas en un archivo, y qué hace el buffer pool, la parte
del motor que decide qué páginas están en memoria. Todo el tiempo lo
comparamos con lo que PostgreSQL hace de verdad. Lo vamos a ver con
pageinspect y pg_buffercache, dos extensiones que muestran los bytes de
una página y el contenido del buffer pool.
Esta semana también se publica P3, en la que construyen quipu, un motor de
almacenamiento pequeño en Node.js. Lo que viene en este capítulo es la teoría
de ese proyecto; el diseño de sus páginas les toca a ustedes.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “La jerarquía de almacenamiento”. Sesión B: “La arquitectura de almacenamiento” y “Para qué sirve”, de “El buffer pool”.
- En clase. Sesión A: “Discos magnéticos”, “Memoria flash y SSD” y “Acceso a bloques”. Sesión B: “De la tabla al archivo”, “Registros”, “Slotted pages”, “Organización de archivos”, “El diccionario de datos”, “El buffer pool” y “¿Por qué no basta el sistema operativo?”.
- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 12.1–12.4, 12.6 y 13.1–13.5; la 12.5 (RAID), complementaria, y la 13.6, opcional. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-09, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
La jerarquía de almacenamiento
Del registro de la CPU a la cinta
Una computadora tiene varios lugares donde guardar datos. Silberschatz (sec. 12.1) los ordena por velocidad y por costo por byte:
| Medio | Tiempo de acceso (orden de magnitud) | ¿Volátil? |
|---|---|---|
| Registros y caché de la CPU | 1 a 10 ns | sí |
| Memoria principal (RAM) | 100 ns | sí |
| Memoria flash (SSD) | 10 a 100 µs | no |
| Disco magnético | 5 a 10 ms | no |
| Cinta magnética, discos ópticos | segundos a minutos | no |
Son órdenes de magnitud, no mediciones: cada generación de hardware mueve los números, pero no cambia mucho la distancia entre un nivel y el siguiente. Hacia abajo, cada nivel es más lento, más barato por byte y más grande.
El libro agrupa los niveles en tres:
- Almacenamiento primario (primary storage): caché y memoria principal. La CPU trabaja directamente sobre él.
- Almacenamiento secundario (secondary storage, también online): flash y disco magnético. Es no volátil y está siempre conectado; para usar un dato hay que copiarlo antes a memoria.
- Almacenamiento terciario (tertiary storage, offline): cinta y discos ópticos, para archivos históricos y copias de respaldo.
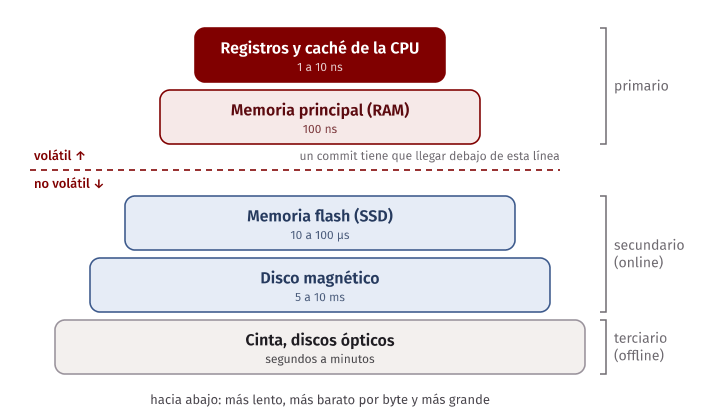
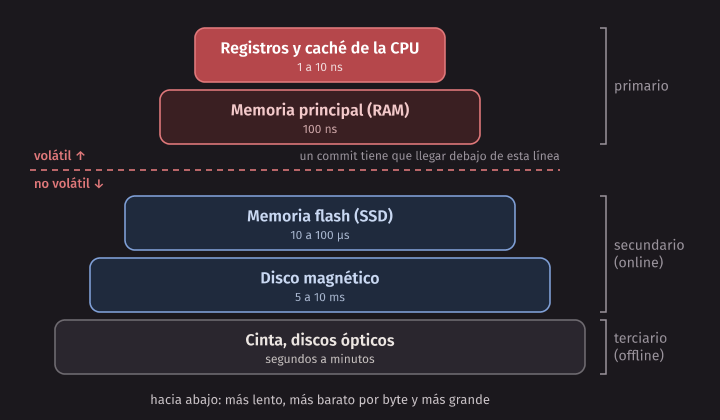
La línea que importa para una base de datos es la que separa lo volátil de lo no volátil. Lo que está en memoria se pierde con un corte de luz o con un crash del sistema operativo. Un DBMS promete durabilidad (la D de ACID): cuando dice “commit”, el cambio sobrevive aunque se apague la máquina un milisegundo después. Esa promesa solo se cumple escribiendo en un medio no volátil, y ese medio es lento.
Idea clave. La memoria principal es unas 100 000 veces más rápida que un disco magnético para leer un dato al azar, y entre 100 y 1000 veces más rápida que un SSD. Con esa diferencia, el tiempo de las operaciones en memoria casi no cuenta: lo que decide cuánto tarda una consulta es cuántas veces va al disco. Por eso, desde hoy, el costo de un algoritmo se mide en bloques leídos y escritos, no en comparaciones ni en tuplas.
El bloque: la unidad de transferencia
El disco no entrega “una fila” ni “un byte”. Entrega un bloque (block), una secuencia de bytes contiguos de tamaño fijo: el sistema operativo y el DBMS leen y escriben bloques enteros. Si el motor necesita una sola fila de 60 bytes, igual trae el bloque completo donde está.
El bloque del DBMS (la página, page) suele ser un múltiplo del sector del disco o de la página del sistema operativo. Cada sistema elige su tamaño:
- PostgreSQL usa páginas de 8 KiB (8192 bytes). Se decide al compilar el servidor y no se puede cambiar después.
quipu, el motor de P3, usa páginas de 4 KiB.- Otros motores usan 4, 16 o 32 KiB, y algunos dejan elegir al crear la base.
chasqui_w09=# SHOW block_size;
 block_size
------------
 8192
(1 row)
Una página más grande trae más datos en cada lectura, lo que conviene si los datos se leen en orden. Pero también trae más bytes que no se van a usar cuando solo se busca una fila, y ocupa más memoria. No hay un tamaño perfecto.
Interfaces y almacenamiento en red
La sección 12.2 del libro presenta cómo se conectan los discos a la computadora. SATA y SAS vienen de la época de los discos magnéticos: mandan los pedidos al dispositivo de uno en uno, o con una cola corta. NVMe se diseñó para SSD: usa el bus PCIe directamente y permite miles de pedidos en vuelo a la vez, que es lo que un SSD necesita para rendir.
El almacenamiento también puede estar en otra máquina: en una SAN (storage area network) un servidor lee bloques de discos remotos como si fueran locales; en un NAS (network attached storage) comparte archivos con un protocolo como NFS; el almacenamiento en la nube agrega el viaje por la red a cada acceso. El modelo de costo es el mismo; solo cambian los números.
Discos magnéticos
Cómo está hecho un disco
Un disco magnético (sec. 12.3) es una pila de platos (platters) que giran juntos sobre un eje, a velocidad constante: 5400, 7200, 10 000 o 15 000 revoluciones por minuto (RPM). Cada cara de un plato está dividida en pistas (tracks), anillos concéntricos, y cada pista en sectores (sectors), la unidad mínima que el disco lee o escribe: 512 bytes en los discos antiguos y 4096 en los actuales. Las pistas que están a la misma distancia del centro en todos los platos forman un cilindro (cylinder).
Una cabeza de lectura y escritura (read-write head) por cara flota a una fracción de micra de la superficie. Todas las cabezas van montadas en un mismo brazo (arm) y se mueven juntas: en un momento dado, todas están sobre el mismo cilindro.
Para leer un sector, el disco hace tres cosas, una después de la otra:
- Seek: mueve el brazo hasta la pista correcta. Es un movimiento mecánico, y es lo más lento. El tiempo de búsqueda promedio (average seek time) de un disco actual está entre 4 y 10 ms.
- Latencia rotacional (rotational latency): espera a que el sector pase por debajo de la cabeza. En promedio es media vuelta.
- Transferencia (transfer): lee los bytes mientras el sector pasa. La tasa de transferencia (data-transfer rate) está entre 50 y 200 MB/s.
El tiempo de acceso (access time) es la suma del seek y la latencia rotacional: el tiempo que pasa desde el pedido hasta que empieza a llegar el primer byte. Como en el curso de Sistemas Operativos.
Un ejemplo con números
Tomemos un disco de 7200 RPM, con seek promedio de 4 ms y transferencia de 200 MB/s, y bloques de 4 KiB.
- Una vuelta dura 60 s / 7200 = 8,33 ms. La latencia rotacional promedio es media vuelta: 4,17 ms.
- Transferir 4 KiB a 200 MB/s toma 4096 / (200 × 10⁶) s = 0,02 ms.
- Una lectura de un bloque al azar cuesta 4 + 4,17 + 0,02 ≈ 8,2 ms. El disco hace unas 1000 / 8,2 ≈ 120 lecturas aleatorias por segundo.
Ahora leamos 120 bloques. Si están repartidos al azar, cada uno paga su seek y su latencia rotacional:
120 × 8,2 ms ≈ 984 msSi están uno detrás de otro en la misma pista (o en pistas vecinas), se paga un solo posicionamiento y después todo es transferencia:
8,17 ms + 120 × 0,02 ms ≈ 10,6 msCasi cien veces menos. La cuenta muestra lo más importante de este capítulo: en un disco magnético casi todo el costo está en posicionarse, no en leer. Leer un bloque más, si es el siguiente, es casi gratis.
Idea clave. El acceso secuencial (sequential access) pide bloques consecutivos; el acceso aleatorio (random access) pide bloques que están en cualquier parte. En un disco magnético, el secuencial puede ser dos órdenes de magnitud más rápido. Buena parte del diseño de un DBMS consiste en convertir accesos aleatorios en secuenciales: guardar juntos los datos que se leen juntos, ordenar los pedidos, leer de más por adelantado.
Fallos y MTTF
Un disco es un aparato mecánico y se malogra. El fabricante publica su tiempo medio hasta el fallo (mean time to failure, MTTF), por ejemplo 1 000 000 de horas. No quiere decir que un disco dure 114 años: quiere decir que, con 1000 discos nuevos, se espera que falle uno cada 1000 horas, es decir, cada mes y medio. Por eso los datos importantes no viven en un solo disco (RAID, más abajo, y replicación).
Memoria flash y SSD
Lo que cambia sin partes móviles
Un SSD (solid-state drive) guarda los datos en memoria flash NAND (sec. 12.4). No tiene brazo ni platos: no hay seek ni latencia rotacional. Leer una página de 4 KiB al azar toma del orden de decenas de microsegundos, cien veces menos que un disco magnético, y un SSD NVMe atiende cientos de miles de lecturas aleatorias por segundo (IOPS, I/O operations per second) cuando tiene muchos pedidos en vuelo.
Pero la flash tiene sus propias reglas, y son raras:
- Se lee y se escribe por páginas de flash (típicamente 4 KiB).
- No se puede sobrescribir una página: primero hay que borrarla (erase), y el borrado se hace por bloques de borrado (erase blocks) mucho más grandes, de cientos de KiB a unos pocos MiB, que agrupan muchas páginas. Borrar toma milisegundos.
- Cada bloque aguanta un número limitado de borrados (de miles a cientos de miles, según la tecnología). Después se desgasta y deja de guardar datos.
¿Cómo se “actualiza” entonces una página? El SSD escribe la versión nueva en otra página que ya esté borrada y marca la vieja como inválida. Para que el sistema operativo siga viendo la dirección de siempre, el SSD tiene una capa de traducción (flash translation layer, FTL) que mapea cada dirección lógica a su página física actual. La FTL también hace:
- Recolección de basura (garbage collection): cuando faltan bloques borrados, elige un bloque con muchas páginas inválidas, copia las válidas a otro lado y lo borra entero.
- Nivelación de desgaste (wear leveling): reparte las escrituras para que todos los bloques se gasten parejo.
Esas copias internas hacen que el SSD escriba más bytes de los que le pidieron. La razón entre lo que se escribe físicamente en la flash y lo que pidió el sistema se llama amplificación de escritura (write amplification). Si para guardar 1 GB el SSD termina escribiendo 3 GB, la amplificación es 3: el disco rinde menos y se desgasta tres veces más rápido. Las escrituras pequeñas y aleatorias son las que más la suben; las grandes y secuenciales, las que menos.
Idea clave. En un SSD la brecha entre secuencial y aleatorio es mucho menor que en un disco magnético, pero no desaparece. Lo secuencial sigue siendo más barato: aprovecha mejor el paralelismo interno del SSD, deja trabajar al read-ahead y produce menos amplificación de escritura.
Valores de referencia
Algunos órdenes de magnitud para tener en la cabeza. No son mediciones de nuestras máquinas: son valores típicos, como los del libro, para razonar.
| Operación | Tiempo aproximado |
|---|---|
| Leer de la caché L1 de la CPU | 1 ns |
| Leer de la memoria principal | 100 ns |
| Leer 4 KiB al azar de un SSD NVMe | 10 a 100 µs |
| Leer 4 KiB al azar de un disco magnético | 5 a 10 ms |
| Ida y vuelta por la red dentro de un centro de datos | 0,5 ms |
Una forma de recordarlo: si leer de memoria tomara un segundo, leer de un SSD tomaría entre un par de minutos y un cuarto de hora, y leer de un disco magnético, entre medio día y más de un día.
Acceso a bloques
Lo que se hace para ir menos al disco
La sección 12.6 del libro reúne las técnicas para que el acceso a bloques sea más rápido. Las conocen de Sistemas Operativos; lo nuevo es que un DBMS las puede aplicar mejor porque sabe qué va a pedir:
- Buffering: guardar en memoria bloques ya leídos, por si se vuelven a pedir. Es el buffer pool de la segunda parte del capítulo.
- Lectura anticipada (read-ahead, prefetching): cuando se lee un bloque, traer también los siguientes, porque es probable que se pidan. El sistema operativo lo adivina mirando el patrón de accesos; el DBMS no necesita adivinar, porque cuando empieza un sequential scan sabe que va a leer toda la tabla.
- Planificación (scheduling) de los pedidos: atender los pedidos pendientes en el orden en que el brazo pasa por las pistas, como el algoritmo del ascensor (elevator algorithm). Hoy la hacen el controlador del disco y el planificador de E/S del sistema operativo.
- Organización del archivo: guardar en bloques contiguos lo que se lee en secuencia. Un archivo que creció a pedazos queda fragmentado y pierde esa ventaja.
- Buffers de escritura no volátiles: una memoria con batería o flash en el controlador recibe la escritura, contesta “listo” de inmediato y la manda al disco después, en el mejor orden. Si se corta la luz, los datos siguen ahí.
- El log en un disco aparte: las escrituras que el DBMS necesita hacer ya (las del log de transacciones, semana 15) son secuenciales. Si van a un disco propio, el brazo no se mueve y cada escritura es rápida.
El modelo de costo
Para comparar algoritmos sin depender de un disco en particular, Silberschatz usa un modelo con dos números, que vamos a usar en las semanas 10 a 12 (se presenta formalmente en la sec. 15.2):
- t_T: el tiempo de transferir un bloque.
- t_S: el tiempo de un seek más la latencia rotacional, es decir, de posicionarse en un bloque cualquiera.
Una operación que transfiere b bloques y hace S posicionamientos cuesta:
costo = b · t_T + S · t_SLos valores que usa el libro son, para un disco magnético, t_S ≈ 4 ms y t_T ≈ 0,1 ms (bloques de 4 KiB); para un SSD, t_S ≈ 90 µs y t_T ≈ 10 µs. El modelo deja fuera el tiempo de CPU y la diferencia entre leer y escribir, y supone que nada está en memoria. Es tosco, pero ordena bien los algoritmos.
Con el modelo, leer los 148 bloques de shipment de chasqui_w09 en orden
(un seek y 148 transferencias) cuesta 4 + 148 × 0,1 = 18,8 ms en el disco
magnético del libro. Leer 148 bloques al azar cuesta 148 × (4 + 0,1) =
606,8 ms, unas 32 veces más. En el SSD del libro, las mismas cuentas dan
0,09 + 148 × 0,01 = 1,57 ms y 148 × 0,1 = 14,8 ms: la razón baja a unas 9
veces.
Error común. Medir el costo de una consulta en tuplas leídas. Leer 1000 tuplas que están en 15 páginas seguidas cuesta un seek y 15 transferencias; leer 1000 tuplas repartidas en 1000 páginas distintas cuesta hasta 1000 seeks. La misma cantidad de tuplas puede costar cien veces más según dónde estén. Lo que cuenta son los bloques y los seeks.
RAID en un párrafo
La sección 12.5 (complementaria) repasa RAID, que ya vieron en Sistemas Operativos. Varios discos se combinan para ganar ancho de banda con striping (repartir los bloques de un archivo entre varios discos, para leerlos en paralelo) o para tolerar fallos con redundancia: mirroring (cada bloque en dos discos, RAID 1) o paridad (un bloque de paridad por cada grupo de bloques, RAID 5). Para una base de datos con muchas escrituras pequeñas, RAID 1 (con striping: RAID 10) suele ser mejor que RAID 5. En RAID 5, escribir un solo bloque cuesta cuatro operaciones de E/S: leer el bloque viejo, leer la paridad vieja, escribir el bloque nuevo y escribir la paridad nueva (la paridad nueva se calcula con las dos lecturas). En RAID 1 cuesta dos escrituras, que se hacen en paralelo.
De la tabla al archivo
La arquitectura de almacenamiento
Con el hardware claro, subimos un nivel. Silberschatz (sec. 13.1) describe cómo un DBMS típico usa el disco:
- Cada relación se guarda en un archivo (file) del sistema operativo, o en varios.
- Un archivo es una secuencia de bloques (páginas) de tamaño fijo.
- Cada página guarda varios registros (records): la representación física de las tuplas.
- El buffer manager es la única puerta entre las páginas del disco y el
resto del motor. El código que ejecuta una consulta nunca lee el archivo
directamente: le pide al buffer manager “la página 7 de
shipment” y recibe un puntero a esa página en memoria.
Los registros son el nivel más bajo que conoce el resto del motor. Una tupla es un concepto lógico; un registro es la secuencia de bytes que la representa dentro de una página.
Dónde está una tabla de PostgreSQL
En PostgreSQL, cada tabla tiene su archivo dentro del directorio de datos del servidor:
chasqui_w09=# SELECT pg_relation_filepath('agency') AS path;
       path
------------------
 base/54184/54185
(1 row)
base es el directorio de las bases de datos, 54184 es el OID de la base
chasqui_w09 y 54185 es el relfilenode de agency, el número que le
da nombre al archivo. Cada vez que corran make, la base se vuelve a crear y
los números cambian. El archivo existe de verdad; con ls dentro del
contenedor se ven el de shipment y dos más:
-rw------- 1 postgres postgres 1212416 Nov  1 18:44 base/56475/56565
-rw------- 1 postgres postgres   24576 Nov  1 18:44 base/56475/56565_fsm
-rw------- 1 postgres postgres    8192 Nov  1 18:44 base/56475/56565_vm
(Esa corrida se hizo después de otro make; por eso los números son otros.)
El primer archivo es el principal (main fork), con las filas. _fsm es el
free space map, que veremos con los heap files, y _vm es el visibility
map, que usa VACUUM y que veremos con MVCC en la semana 14. Si una tabla
pasa de 1 GiB, PostgreSQL la parte en varios archivos de 1 GiB (56565,
56565.1, …).
El tamaño de cada tabla, en bytes y en páginas, lo dan pg_relation_size y
el catálogo. Es la consulta sizes de
pages.sql:
SELECT relname,
       pg_relation_size(oid) AS bytes,
       pg_relation_size(oid) / current_setting('block_size')::int AS pages,
       relpages,
       reltuples::bigint AS reltuples,
       round(reltuples / relpages) AS rows_per_page
FROM pg_class
WHERE relnamespace = 'public'::regnamespace AND relkind = 'r'
ORDER BY pages DESC;
relname | bytes | pages | relpages | reltuples | rows_per_page
----------------+---------+-------+----------+-----------+---------------
shipment_event | 2801664 | 342 | 342 | 46421 | 136
shipment | 1212416 | 148 | 148 | 12000 | 81
trip | 360448 | 44 | 44 | 5914 | 134
customer | 155648 | 19 | 19 | 1800 | 95
vehicle | 8192 | 1 | 1 | 24 | 24
route | 8192 | 1 | 1 | 120 | 120
agency | 8192 | 1 | 1 | 29 | 29
(7 rows)Todos los tamaños son múltiplos de 8192: un archivo de tabla tiene siempre
un número entero de páginas. pg_relation_size mide el archivo en este
momento; relpages y reltuples son estadísticas del catálogo que
actualizan VACUUM y ANALYZE, y que usa el optimizador (semana 12). Aquí
coinciden porque make corrió VACUUM justo después de cargar los datos.
En una página de shipment caben 81 filas; en una de shipment_event, que
tiene filas más cortas, 136.
En PostgreSQL. Si miran los tamaños inmediatamente después de
chasqui-load, sin elVACUUMdelMakefile, verán números más grandes. En una de nuestras corridas,tripmedía 64 páginas pero sus filas ocupaban solo 44, yshipmentmedía 200 con filas en 148:pages | pages_con_filas -------+----------------- 64 | 44 (1 row) pages | pages_con_filas -------+----------------- 200 | 148 (1 row)Al cargar con
COPY, PostgreSQL agrega páginas al archivo de a varias a la vez, para no pedirle espacio al sistema operativo por cada página. Las que sobran al final quedan en ceros (una página en ceros tieneloweryupperen 0).VACUUMcorta las páginas vacías del final del archivo, y el autovacuum lo hace solo poco después de la carga. Por eso los tamaños cambian solos si uno no espera.
Registros
Registros de longitud fija
Empecemos por el caso más simple (sec. 13.2.1): todos los atributos tienen
tamaño fijo. Supongamos que guardamos route con este formato propio:
| Atributo | Tipo en el registro | Bytes |
|---|---|---|
route_id |
entero | 4 |
origin_agency_id |
entero | 4 |
dest_agency_id |
entero | 4 |
distance_km |
entero | 4 |
base_fare |
número de punto fijo de 8 bytes | 8 |
Cada registro ocupa 24 bytes. En un bloque de 4 KiB caben ⌊4096 / 24⌋ = 170 registros, y sobran 16 bytes. El registro i (desde 0) empieza en el byte i × 24 del bloque: encontrarlo es una multiplicación.
Hay dos problemas.
Un registro que cruza el límite de un bloque. Si el tamaño del registro no divide al tamaño del bloque, el registro 171 empezaría en el byte 4080 y terminaría en el bloque siguiente. Leerlo costaría dos bloques. La solución es no permitirlo: en cada bloque se guardan solo registros completos, y los bytes que sobran al final (16, en el ejemplo) se pierden.
Borrar deja un hueco. Si se borra el registro 3, ¿qué se hace con su espacio? Hay tres opciones:
- Mover todos los registros siguientes un lugar hacia atrás. Mantiene los registros juntos, pero mover muchos registros es caro.
- Mover el último registro al hueco. Es una sola copia, pero cambia la posición de ese registro.
- Dejar el hueco y anotarlo en una lista de libres (free list). Al inicio del archivo, un encabezado guarda la dirección del primer registro borrado; cada registro borrado guarda en sus propios bytes la dirección del siguiente borrado. Una inserción toma el primer hueco de la lista; si no hay, agrega al final.
La opción 3 es la más usada, porque los registros que no se borran nunca se mueven. Fíjense en esto: mover un registro es un problema si otras partes del motor (un índice, por ejemplo) guardan su dirección. Esa idea vuelve con las slotted pages.
Registros de longitud variable
En una tabla real casi nada tiene tamaño fijo: text, varchar, numeric,
los arreglos. Y cualquier atributo puede ser NULL. El libro (sec. 13.2.2)
propone un formato en dos partes:
- Una parte inicial de tamaño fijo:
- Para cada atributo de longitud variable, un par (offset, longitud) que dice dónde empiezan sus bytes dentro del registro y cuántos son. Con 2 bytes para cada número, el par ocupa 4 bytes.
- Los atributos de tamaño fijo, directamente.
- Un bitmap de nulos (null bitmap): un bit por atributo, en 1 si es
NULL.
- Los bytes de los atributos variables, uno detrás de otro.
Apliquémoslo a la primera fila de customer:
 ctid  | customer_id |   dni    | first_name |    last_name    |   phone   |   city
-------+-------------+----------+------------+-----------------+-----------+----------
 (0,1) |           1 | 61830975 | Wilmer     | Chávez Ríos     | 909975104 | Ayacucho
 (0,2) |           2 | 17232205 | Piero      | García Castillo | 946039842 | Puno
 (0,3) |           3 | 36948162 | Milagros   | Ramos Herrera   |           | Lima
(3 rows)
En nuestro formato, customer_id (entero de 4 bytes) y dni (siempre 8
caracteres, 8 bytes) son de tamaño fijo; first_name, last_name, phone
y city son variables. El registro queda así (los textos en UTF-8: á e í
ocupan 2 bytes cada una, así que Chávez Ríos son 13 bytes):
| Bytes | Contenido |
|---|---|
| 0–3 | (29, 6): first_name |
| 4–7 | (35, 13): last_name |
| 8–11 | (48, 9): phone |
| 12–15 | (57, 8): city |
| 16–19 | customer_id = 1 |
| 20–27 | dni = 61830975 |
| 28 | bitmap de nulos: 000000 (seis bits; ninguno es NULL) |
| 29–34 | Wilmer |
| 35–47 | Chávez Ríos |
| 48–56 | 909975104 |
| 57–64 | Ayacucho |
En total, 65 bytes. Para la tercera fila, que tiene phone en NULL, el bit
de phone en el bitmap queda en 1 y su par puede quedar como (offset, 0): no
se guarda ningún byte para él.
Con este formato, encontrar el atributo k es directo: si es fijo, está en una posición conocida; si es variable, su par dice dónde está. Ningún atributo obliga a recorrer los anteriores.
Cómo lo hace PostgreSQL
PostgreSQL usa un formato distinto. Una fila en una página (una heap
tuple) tiene un encabezado de 23 bytes, el bitmap de nulos si hace falta
y relleno hasta un múltiplo de 8; el campo t_hoff dice dónde empiezan los
datos. Después vienen los atributos en el orden de la tabla, cada uno
alineado según su tipo, y cada atributo de longitud variable lleva su propia
longitud delante (en PostgreSQL se llaman varlena). No hay tabla de
offsets.
El diccionario de datos dice qué atributos tienen longitud fija. Es la
consulta attributes de pages.sql:
 attnum |   attname   |   type    | attlen | attalign | attnotnull
--------+-------------+-----------+--------+----------+------------
      1 | customer_id | integer   |      4 | i        | t
      2 | dni         | character |     -1 | i        | t
      3 | first_name  | text      |     -1 | i        | t
      4 | last_name   | text      |     -1 | i        | t
      5 | phone       | text      |     -1 | i        | f
      6 | city        | text      |     -1 | i        | t
(6 rows)
attlen = -1 quiere decir varlena. Fíjense en dni: aunque es char(8),
PostgreSQL lo guarda como varlena, igual que un text. En el formato del
libro lo tratamos como fijo; en PostgreSQL no lo es (un char(n) puede tener
n caracteres de varios bytes cada uno). attalign = i es alineación a 4
bytes.
Ahora los bytes de verdad. heap_page_items, de la extensión pageinspect,
muestra cada tupla de una página con su encabezado y sus datos (t_data):
 lp | lp_len | t_hoff |  t_bits  |                                                    t_data
----+--------+--------+----------+--------------------------------------------------------------------------------------------------------------
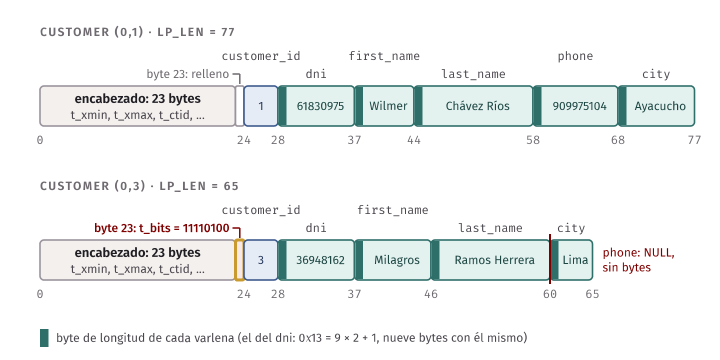
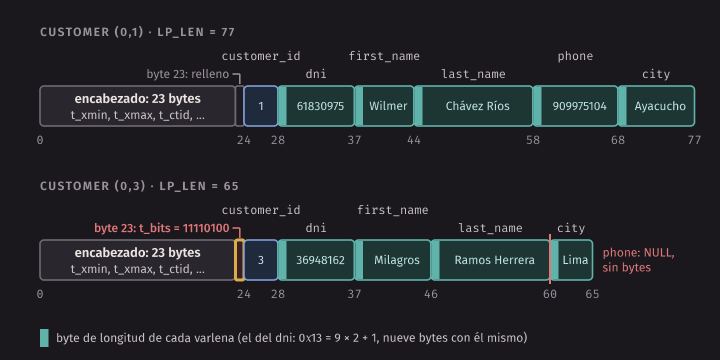
  1 |     77 |     24 |          | \x010000001336313833303937350f57696c6d65721d4368c3a176657a2052c3ad6f731539303939373531303413417961637563686f
  2 |     75 |     24 |          | \x020000001331373233323230350d506965726f2347617263c3ad612043617374696c6c6f153934363033393834320b50756e6f
  3 |     65 |     24 | 11110100 | \x03000000133336393438313632134d696c6167726f731d52616d6f7320486572726572610b4c696d61
(3 rows)
Leamos la primera fila byte por byte:
| Bytes (hex) | Qué es |
|---|---|
01000000 |
customer_id = 1, entero de 4 bytes en little-endian (el byte menos significativo primero) |
13 |
encabezado de varlena corto: 0x13 = 19 = 9 × 2 + 1. El bit bajo en 1 dice “encabezado de 1 byte”; el resto, 9, es la longitud total con el encabezado |
3631383330393735 |
61830975, los 8 bytes del dni |
0f |
0x0f = 7 × 2 + 1: longitud 7, es decir, 6 bytes de texto |
57696c6d6572 |
Wilmer |
1d |
0x1d = 14 × 2 + 1: 13 bytes de texto |
4368c3a176657a2052c3ad6f73 |
Chávez Ríos (c3a1 es á, c3ad es í) |
15 … |
phone: 0x15 = 10 × 2 + 1, 9 bytes, 909975104 |
13 … |
city: 9 en total, 8 bytes, Ayacucho |
Los datos ocupan 4 + 9 + 7 + 14 + 10 + 9 = 53 bytes, y con los 24 del
encabezado dan los 77 de lp_len. La tercera fila tiene t_bits = 11110100: es el bitmap de nulos, un bit por atributo empezando por el
primero, con 1 si el atributo no es NULL (al revés que en el libro).
El quinto bit, el de phone, está en 0, y en los datos no hay nada para
phone: después de Ramos Herrera viene directamente 0b4c696d61,
Lima. Los dos últimos bits sobran (solo hay seis atributos). El bitmap
cabe en el byte 23, que de otro modo sería relleno, así que t_hoff sigue
siendo 24.
¿Y la alineación? Un entero de 4 bytes va en un offset múltiplo de 4. Un
varlena con encabezado de 1 byte no se alinea, para no perder espacio. Un
varlena con encabezado de 4 bytes (textos de más de 126 bytes) sí se alinea a
4. En customer el único entero va primero, así que no hay relleno.
En PostgreSQL. Sin tabla de offsets, para llegar al atributo k hay que recorrer los k − 1 anteriores, porque cada varlena dice su longitud recién cuando se llega a él. PostgreSQL guarda en caché los offsets de los atributos de tamaño fijo que están antes del primer varlena o
NULL, y recorre el resto. Es una decisión distinta de la del libro: ahorra los bytes de los pares a cambio de un poco de CPU por fila. El orden de las columnas también importa: unsmallintseguido de unbigintdeja 6 bytes de relleno entre los dos.
pgpage.mjs tiene una función
decodeTuple(data, tuple, columns) que hace esta lectura en Node.js para
columnas int4 y text cortas, y
pgpage.test.mjs comprueba que devuelve
lo mismo que un SELECT para todas las filas de la página 0 de customer,
con y sin NULL.
Registros grandes
¿Qué pasa con un atributo que no entra en una página, como un documento de
1 MB? El registro no puede cruzar páginas como si nada, así que los valores
grandes se guardan en otro lugar y el registro guarda solo una referencia
a ellos. El libro menciona los tipos blob y clob del estándar, que se
guardan en archivos o estructuras aparte.
En PostgreSQL. Se llama TOAST (The Oversized-Attribute Storage Technique). Cuando una fila pasa de unos 2 KB, PostgreSQL primero intenta comprimir sus atributos varlena más grandes y, si no basta, los parte en trozos que guarda en una tabla aparte, la tabla TOAST de la relación. En la fila queda un puntero de 18 bytes. Cada tabla con columnas varlena tiene su tabla TOAST (
pg_class.reltoastrelid), aunque esté vacía, como las de Chasqui, donde ninguna fila se acerca a ese tamaño.
Slotted pages
La estructura
Con registros de longitud variable, ¿cómo se organizan dentro de una página? El problema es que borrar un registro deja un hueco de tamaño arbitrario y que, si movemos registros para juntar el espacio libre, cambian de posición. La solución estándar es la slotted page (página con slots, sec. 13.2.2):
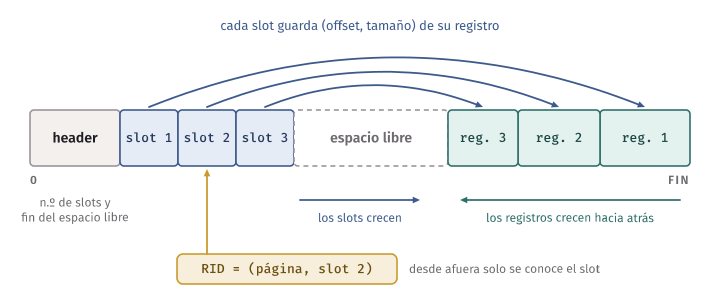
- Un encabezado (header) con, al menos, el número de slots y dónde termina el espacio libre.
- Un arreglo de slots que crece desde el inicio de la página. Cada slot guarda el offset y el tamaño de un registro.
- Los registros, que se guardan desde el final de la página hacia atrás.
- El espacio libre queda en el medio, en un solo pedazo contiguo.
Las operaciones:
- Insertar: si hay espacio para el registro y para un slot más, se copia el registro justo antes del último registro, se agrega un slot al final del arreglo y se actualizan el número de slots y el fin del espacio libre.
- Borrar: el slot se marca como libre (el libro pone su tamaño en −1). El espacio del registro se puede recuperar compactando: se mueven los registros que estaban antes de él para que el espacio libre vuelva a ser contiguo, y se corrigen los offsets en sus slots.
- Buscar: el slot dice dónde está el registro.
El record id
Un registro se identifica por su record id (RID): el par (número de página, número de slot). Los índices, por ejemplo, guardan RIDs.
La propiedad clave es esta: mover un registro dentro de su página no cambia su RID. Cuando se compacta la página, el registro cambia de offset, pero el slot sigue siendo el mismo, y lo único que cambia es el offset guardado en el slot. Nadie fuera de la página se entera. Es el mismo truco de la opción 3 de los registros fijos, mejorado: hay una indirección (el slot) entre la dirección que se publica y la posición física.
Idea clave. El slot es un nivel de indirección. Afuera de la página se usa (página, slot); adentro, el slot dice el offset. Así la página puede reorganizarse por dentro, compactar o hacer crecer un registro, sin invalidar ningún puntero externo.
Una consecuencia: un slot libre no se puede quitar del arreglo si hay slots ocupados después, porque eso cambiaría los números de los siguientes. El slot queda marcado como libre y una inserción posterior lo puede reutilizar.
La página de agency por dentro
PostgreSQL usa exactamente esta estructura. La documentación (Database Page Layout) describe una página de 8 KiB así:
| Parte | Tamaño | Qué guarda |
|---|---|---|
PageHeaderData |
24 bytes | LSN, checksum, banderas, pd_lower, pd_upper, pd_special, versión, pd_prune_xid |
ItemIdData |
4 bytes por slot | offset, banderas y longitud de cada tupla: los line pointers |
| Espacio libre | variable | entre pd_lower y pd_upper |
| Tuplas | variable | crecen desde el final |
| Espacio especial | variable | datos propios de los índices; vacío en una tabla |
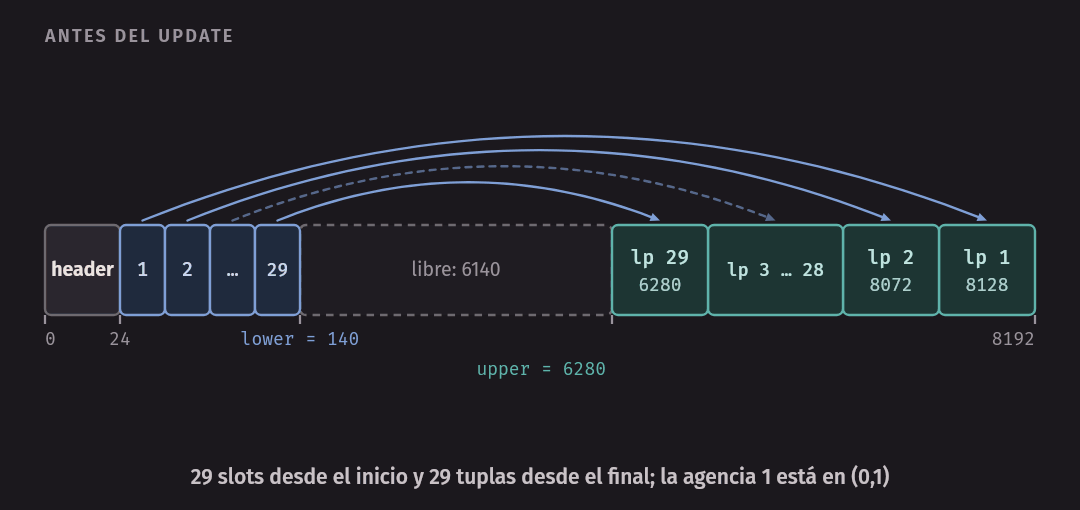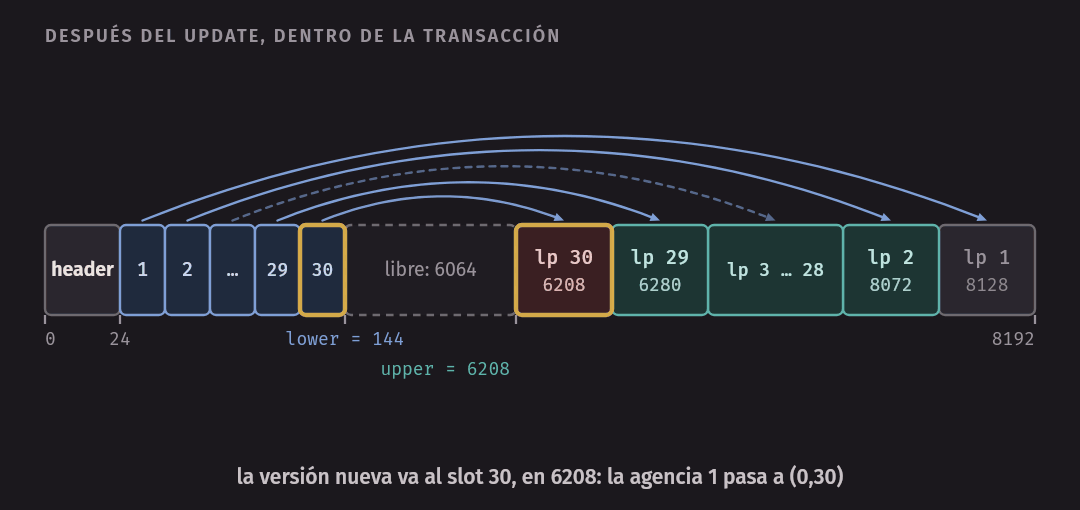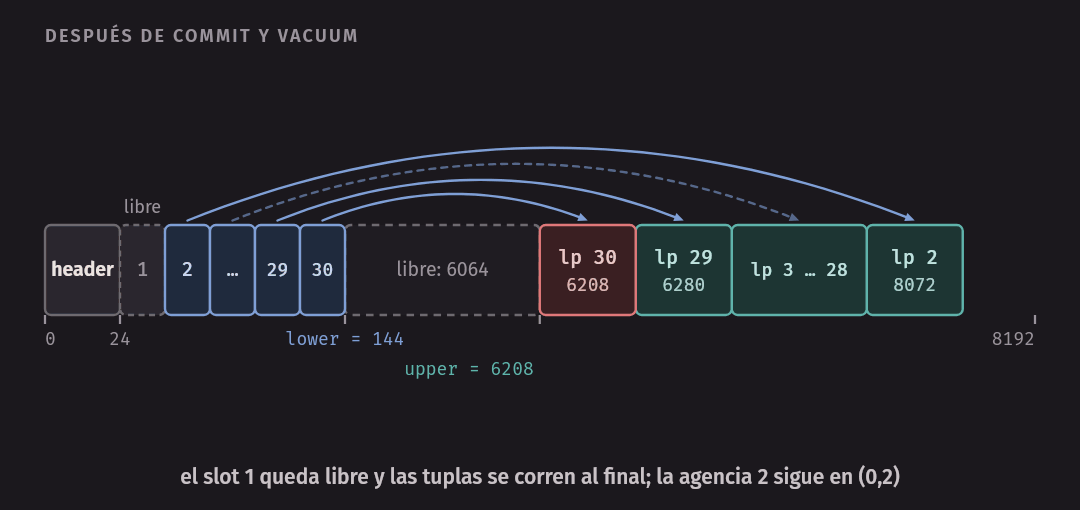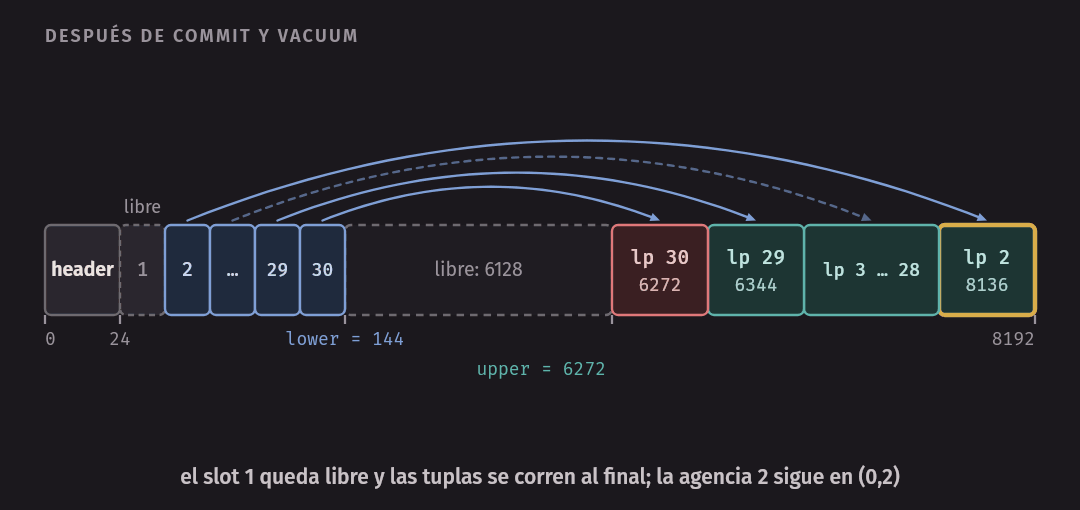
pd_lower es el fin del arreglo de slots y pd_upper el inicio de la
primera tupla: el espacio libre es upper - lower. agency tiene 29 filas en
una sola página. Primero el encabezado, con page_header:
SELECT lower, upper, special, pagesize, upper - lower AS free
FROM page_header(get_raw_page('agency', 0));
lower | upper | special | pagesize | free
-------+-------+---------+----------+------
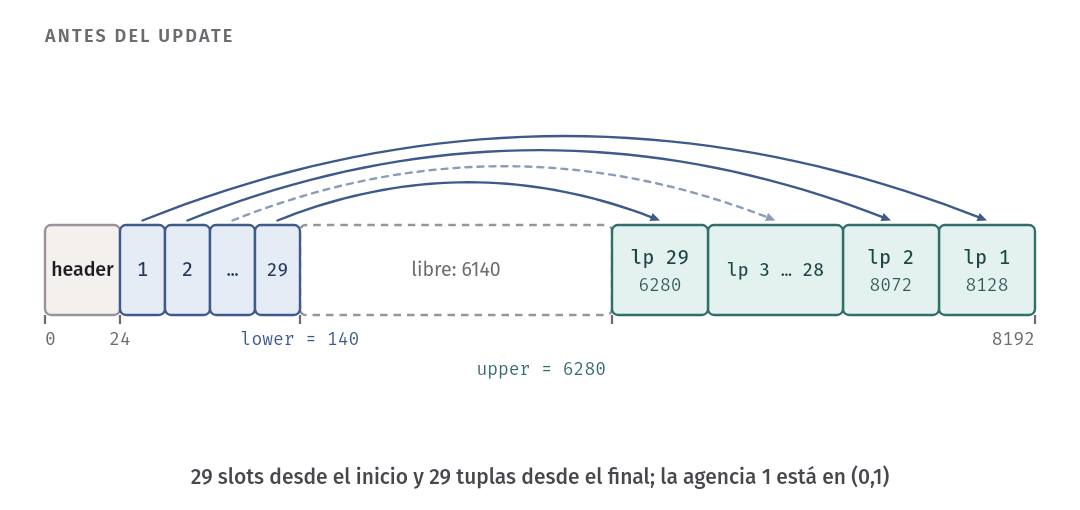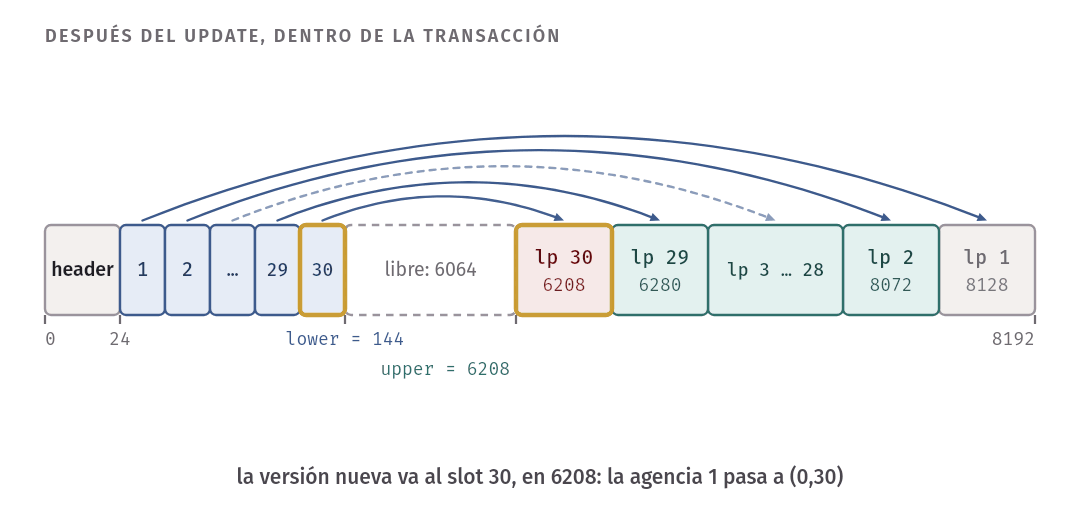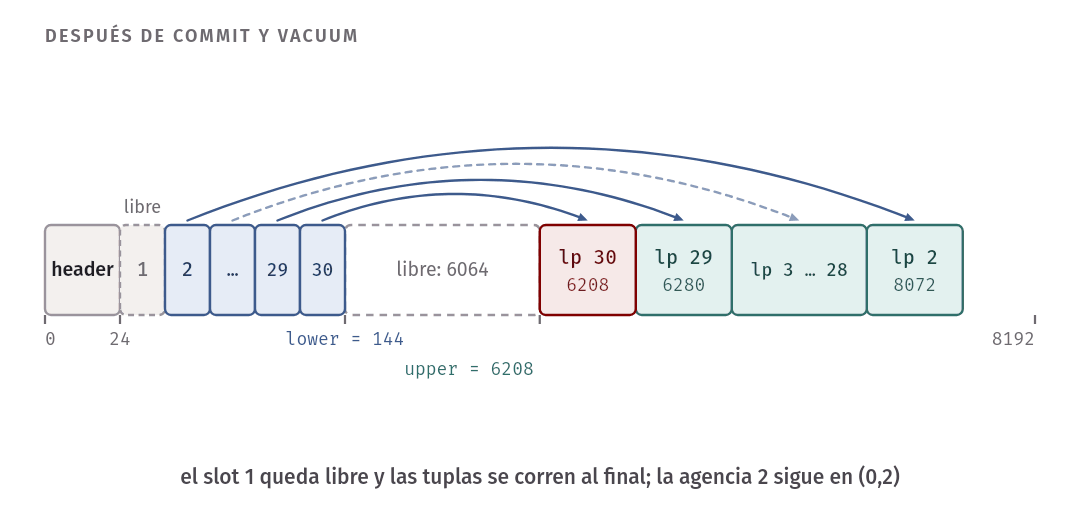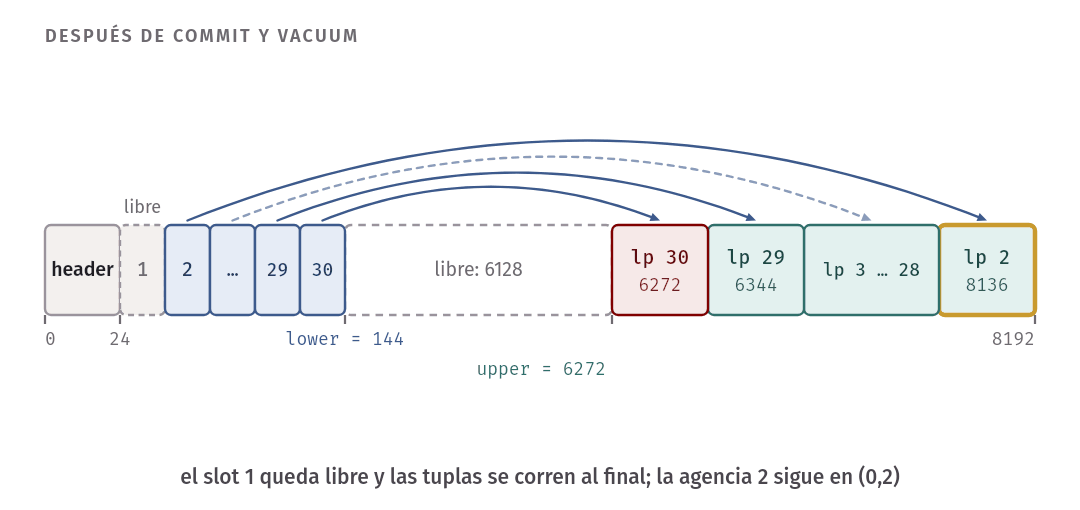
140 | 6280 | 8192 | 8192 | 6140
(1 row)La cuenta cierra: 24 bytes de encabezado más 29 slots de 4 bytes dan 24 +
116 = 140 = lower. Las tuplas empiezan en el byte 6280 y llegan hasta el
8192 (special = 8192 quiere decir que no hay espacio especial). Quedan 6140
bytes libres, el 75 % de la página.
Ahora los slots, con heap_page_items (en PostgreSQL, el slot se llama
line pointer o item, y su número lp):
SELECT lp, lp_off, lp_flags, lp_len, t_xmin, t_xmax, t_ctid
FROM heap_page_items(get_raw_page('agency', 0))
ORDER BY lp
LIMIT 5;
lp | lp_off | lp_flags | lp_len | t_xmin | t_xmax | t_ctid
----+--------+----------+--------+--------+--------+--------
1 | 8128 | 1 | 57 | 13129 | 0 | (0,1)
2 | 8072 | 1 | 56 | 13129 | 0 | (0,2)
3 | 8016 | 1 | 49 | 13129 | 0 | (0,3)
4 | 7952 | 1 | 64 | 13129 | 0 | (0,4)
5 | 7880 | 1 | 72 | 13129 | 0 | (0,5)
(5 rows) lp | lp_off | lp_len
----+--------+--------
29 | 6280 | 60
28 | 6344 | 85
27 | 6432 | 63
(3 rows)lp_offes el offset de la tupla en la página. La primera tupla está al final (8128) y cada una siguiente está antes que la anterior. La última, la del slot 29, empieza en 6280, que esupper.lp_lenes la longitud de la tupla, con su encabezado.lp_flags = 1(LP_NORMAL) quiere decir que el slot apunta a una tupla. Los otros valores son 0 (LP_UNUSED, slot libre), 2 (LP_REDIRECT) y 3 (LP_DEAD).- ¿Por qué la primera tupla, de 57 bytes, empieza en 8128 y no en 8192 − 57 = 8135? Porque las tuplas empiezan en múltiplos de 8 (la alineación máxima de la máquina): 8135 redondeado hacia abajo es 8128.
t_xmines la transacción que insertó la tupla yt_xmaxla que la borró o reemplazó (0 si ninguna). Sus números dependen de cada corrida.
Por último, el RID. En PostgreSQL se llama ctid y es una columna de
sistema que tiene toda tabla:
SELECT ctid, agency_id, name
FROM agency
ORDER BY agency_id
LIMIT 5;
ctid | agency_id | name
-------+-----------+---------------------------
(0,1) | 1 | Lima - La Victoria
(0,2) | 2 | Lima - Los Olivos
(0,3) | 3 | Lima - Ate
(0,4) | 4 | Arequipa - Centro
(0,5) | 5 | Arequipa - Cerro Colorado
(5 rows)(0,1) es la página 0, slot 1. Es el par (página, slot) del libro.
En PostgreSQL. El campo
t_ctiddel encabezado de una tupla y la columnactidno son lo mismo.ctides dónde está la tupla que se está leyendo.t_ctides dónde está su versión más nueva: si la tupla no se actualizó, apunta a sí misma. Lo vamos a ver con unUPDATEen un momento.
La página leída desde Node.js
pageinspect hace el trabajo de interpretar los bytes, pero no hay magia:
una página es un arreglo de 8192 bytes con un formato fijo.
pgpage.mjs lo interpreta a mano. Recibe la
página tal como la devuelve get_raw_page (el driver pg entrega un
bytea como un Buffer de Node.js) y lee cada campo de su offset: lower
con page.readUInt16LE(12), upper con page.readUInt16LE(14), y así con
los demás campos del encabezado.
Un line pointer son 32 bits que guardan tres campos: 15 bits de offset, 2 de banderas y 15 de longitud. Con 15 bits se llega hasta 32 767, suficiente para cualquier offset dentro de una página de 8 KiB:
const v = page.readUInt32LE(PAGE_HEADER_SIZE + (lp - 1) * LINE_POINTER_SIZE);
return { lp, lp_off: v & 0x7fff, lp_flags: (v >>> 15) & 0x3, lp_len: v >>> 17 };
El script dump.mjs trae una página y la
muestra:
$ PGDATABASE=chasqui_w09 node dump.mjs agency 0
agency, página 0: lower=140 upper=6280 special=8192 slots=29 libre=6140 bytes
  lp=1 off=8128 flags=1 len=57 xmin=14018 xmax=0 ctid=(0,1)
  lp=2 off=8072 flags=1 len=56 xmin=14018 xmax=0 ctid=(0,2)
  lp=3 off=8016 flags=1 len=49 xmin=14018 xmax=0 ctid=(0,3)
  lp=4 off=7952 flags=1 len=64 xmin=14018 xmax=0 ctid=(0,4)
  ...
  lp=28 off=6344 flags=1 len=85 xmin=14018 xmax=0 ctid=(0,28)
  lp=29 off=6280 flags=1 len=60 xmin=14018 xmax=0 ctid=(0,29)
Los números son los de pageinspect (salvo xmin, que es de otra carga).
Las pruebas de pgpage.test.mjs lo comprueban campo por campo, para varias
páginas de agency, customer, shipment y shipment_event.
Un UPDATE no sobrescribe en el lugar
Hagamos un experimento: cambiar el nombre de la agencia 1 y mirar la página
antes y después. Es update.sql, que se corre
una sola vez sobre la base recién creada:
 ctid  | agency_id |        name
-------+-----------+--------------------
 (0,1) |         1 | Lima - La Victoria
(1 row)

BEGIN
UPDATE 1
  ctid  | agency_id |            name
--------+-----------+-----------------------------
 (0,30) |         1 | Lima - La Victoria (centro)
(1 row)
El ctid de la fila cambió de (0,1) a (0,30). El UPDATE no
sobrescribió la tupla: escribió una tupla nueva en un slot nuevo. Dentro
de la misma transacción, la página tiene las dos versiones:
 lp | lp_off | lp_flags | lp_len | t_xmin | t_xmax | t_ctid
----+--------+----------+--------+--------+--------+--------
  1 |   8128 |        1 |     57 |  13129 |  13231 | (0,30)
  2 |   8072 |        1 |     56 |  13129 |      0 | (0,2)
 29 |   6280 |        1 |     60 |  13129 |      0 | (0,29)
 30 |   6208 |        1 |     66 |  13231 |      0 | (0,30)
(4 rows)

 lower | upper | free
-------+-------+------
   144 |  6208 | 6064
(1 row)- La tupla vieja (slot 1) sigue en su lugar, con
t_xmax = 13231: la transacción que la reemplazó. Sut_ctidapunta a(0,30), la versión nueva. - La tupla nueva (slot 30) tiene
t_xmin = 13231y 66 bytes (9 más, por el' (centro)'). Se copió justo antes de la que estaba más cerca del inicio: 6280 − 66 = 6214, redondeado a 6208. lowersubió 4 bytes (un slot más) yupperbajó 72 (la tupla con su alineación).
Hacemos COMMIT. La tupla vieja ya no la necesita nadie, pero sigue ahí
ocupando 57 bytes. Quien la limpia es VACUUM (que no puede correr dentro de
una transacción):
COMMIT
VACUUM
 lp | lp_off | lp_flags | lp_len | t_xmin | t_xmax | t_ctid
----+--------+----------+--------+--------+--------+--------
  1 |      0 |        0 |      0 |        |        |
  2 |   8136 |        1 |     56 |  13129 |      0 | (0,2)
 29 |   6344 |        1 |     60 |  13129 |      0 | (0,29)
 30 |   6272 |        1 |     66 |  13231 |      0 | (0,30)
(4 rows)

 lower | upper | free
-------+-------+------
   144 |  6272 | 6128
(1 row)

  ctid  | agency_id |            name
--------+-----------+-----------------------------
 (0,30) |         1 | Lima - La Victoria (centro)
 (0,2)  |         2 | Lima - Los Olivos
(2 rows)
Aquí está la slotted page entera en un ejemplo:
- El slot 1 quedó libre (
lp_flags = 0). No desapareció del arreglo:lowersigue en 144, porque quitarlo cambiaría el número de todos los slots siguientes. Una inserción futura lo puede reutilizar. - La página se compactó: las tuplas se corrieron hacia el final para ocupar el hueco. La del slot 2 pasó del offset 8072 al 8136; la del 29, de 6280 a 6344; la del 30, de 6208 a 6272.
- Y sin embargo el
ctidde la agencia 2 sigue siendo(0,2). El registro se movió y su RID no cambió. - El espacio libre volvió a ser contiguo: 6128 bytes, 64 más que antes del
VACUUM(los 57 de la tupla vieja, con su alineación).
¿Por qué PostgreSQL trabaja así, con versiones, en vez de sobrescribir? Para
que una transacción que empezó antes del UPDATE pueda seguir viendo el
nombre viejo mientras la otra escribe el nuevo. Se llama MVCC y es el tema de
la semana 14. Hoy basta con lo que se ve en la página: un UPDATE en
PostgreSQL es, físicamente, un INSERT de la versión nueva más una marca en
la vieja. Por eso, si se actualizan todas las filas de una tabla, la tabla
llega a ocupar casi el doble. VACUUM deja ese espacio disponible para filas
nuevas, pero no lo devuelve al sistema operativo (salvo las páginas vacías del
final del archivo); solo VACUUM FULL, que reescribe la tabla, la achica.
En PostgreSQL. El
UPDATEcambióname, que tiene un índiceUNIQUE. Si cambia una columna que no está en ningún índice y la versión nueva cabe en la misma página, PostgreSQL hace un HOT update (heap-only tuple): no agrega nada a los índices, y al limpiar deja el slot viejo comoLP_REDIRECT(lp_flags = 2) apuntando al nuevo. Prueben concityen el ejercicio 6.
En PostgreSQL. Si miran
heap_page_itemsjusto después dechasqui-load, sin elVACUUM (FREEZE)delMakefile, verán que las 29 tuplas deagencyya tienent_xmaxdistinto de 0, igual a sut_xmin. No están borradas. Al cargarrouteyshipment, cada verificación de clave foránea bloquea la fila referenciada deagency(un lock de fila, semana 14), y ese lock se anota ent_xmaxcon una bandera que dice “solo lock”.heap_tuple_infomask_flagslo muestra:lp | t_xmin | t_xmax | raw_flags | combined_flags ----+--------+--------+----------------------------------------------------------------------------------------------------+---------------- 1 | 12062 | 12062 | {HEAP_HASVARWIDTH,HEAP_XMAX_KEYSHR_LOCK,HEAP_XMAX_LOCK_ONLY,HEAP_XMIN_COMMITTED,HEAP_XMAX_INVALID} | {} 2 | 12062 | 12062 | {HEAP_HASVARWIDTH,HEAP_XMAX_KEYSHR_LOCK,HEAP_XMAX_LOCK_ONLY,HEAP_XMIN_COMMITTED,HEAP_XMAX_INVALID} | {} 3 | 12062 | 12062 | {HEAP_HASVARWIDTH,HEAP_XMAX_KEYSHR_LOCK,HEAP_XMAX_LOCK_ONLY,HEAP_XMIN_COMMITTED,HEAP_XMAX_INVALID} | {} (3 rows)
VACUUM (FREEZE)limpia esas marcas y dejat_xmaxen 0. Así, en el experimento, la única tupla cont_xmaxes la que reemplazó elUPDATE.
Lo que esto tiene que ver con P3
En P3 van a escribir su propia
slotted page para quipu, con páginas de 4 KiB en vez de 8 KiB. El
enunciado fija dos cosas: que los primeros 8 bytes del encabezado quedan
reservados para el pageLSN que usarán en P5 (el mismo papel que pd_lsn
en PostgreSQL, como veremos en la semana 15) y que compact() junta el
espacio libre sin cambiar los números de slot, igual que el VACUUM de
arriba. El resto del formato lo deciden ustedes y lo documentan en su
README, con un diagrama de los bytes. Antes de escribir código, conviene
responder en papel:
- ¿Qué más necesita el encabezado, además de los 8 bytes reservados? ¿De qué tamaño es cada campo, si la página mide 4096 bytes?
- ¿Cómo distinguen un slot libre de uno ocupado?
- Cuando
insertencuentra un slot libre en el medio del arreglo, ¿lo reutiliza o agrega uno nuevo al final? - ¿Qué devuelve
freeSpace()si el registro nuevo necesita además un slot nuevo? - ¿Qué hace
update(slot, bytes)si el registro nuevo es más grande que el viejo pero sí cabe en el espacio libre?
pgpage.mjs les sirve de referencia para la lectura de un formato binario
con Buffer (readUInt16LE, subarray), pero el formato de PostgreSQL no
es el de quipu y su API es otra: es un lector de solo lectura, sin
insert ni delete.
Organización de archivos
Heap files
Ya sabemos guardar registros en una página. ¿En qué página va cada registro? La sección 13.3 del libro presenta varias organizaciones. La más simple es el heap file: cualquier registro puede ir en cualquier página donde haya espacio. No hay orden. Es lo que usa PostgreSQL para todas sus tablas, y lo que van a construir en P3.
Insertar en un heap file requiere encontrar una página con espacio suficiente.
Recorrer todo el archivo en cada inserción sería absurdo: con las 24 667
páginas de shipment en chasqui_big, serían 24 667 lecturas por cada
INSERT. La solución es llevar aparte la
cuenta del espacio libre:
- Una lista de páginas con espacio (una lista enlazada de páginas no llenas, por ejemplo, con la cabeza en una página de encabezado del archivo).
- Un free space map: un arreglo con una entrada por página que dice, aproximadamente, cuánto espacio libre tiene. El libro propone una entrada de pocos bits por página; un bloque del mapa cubre miles de páginas, y se puede organizar en dos niveles para buscar rápido.
El mapa no tiene que ser exacto. Si dice que una página tiene espacio y no es así, el motor la lee, ve que no entra, corrige el mapa y prueba con otra. Lo importante es que casi siempre acierte.
En PostgreSQL. El free space map es el archivo
_fsm. Guarda un byte por página: el espacio libre en unidades de 8192 / 256 = 32 bytes, redondeado hacia abajo. Se ve con la extensiónpg_freespacemap:chasqui_w09=# SELECT blkno, avail FROM pg_freespace('agency'); blkno | avail -------+------- 0 | 6112 (1 row)La página tiene 6140 bytes libres; el mapa dice 6112, el múltiplo de 32 inmediatamente menor. En
shipmentcasi todas las páginas están llenas:pages | min | max | avg -------+-----+------+----- 148 | 0 | 1856 | 63 (1 row)Por encima de ese arreglo, el archivo guarda un árbol en el que cada nodo interno tiene el máximo de sus hijos: con eso se encuentra en pocos pasos una página con al menos n bytes libres. El mapa se actualiza con
VACUUMy cuando una inserción descubre que una página está llena.
Archivos secuenciales
Un archivo secuencial (sequential file, sec. 13.3.1) guarda los registros
ordenados por una clave de búsqueda (search key), uno o varios atributos.
Por ejemplo, shipment ordenado por created_at. Así, una consulta que pide
los envíos de una semana lee páginas consecutivas: acceso secuencial.
El costo es mantener el orden. Borrar es fácil (con slots o una lista de libres). Insertar no: el registro nuevo tiene que ir en su lugar.
- Si en la página que le toca hay espacio, se pone ahí.
- Si no, se pone en un bloque de overflow y se enlaza desde su posición.
Con el tiempo, las cadenas de overflow crecen y el archivo deja de estar en orden físico. Hay que reorganizarlo cada cierto tiempo, en un momento de poca carga. Por eso el orden por una clave casi siempre se consigue con un índice (semana 10) y no con el archivo mismo.
En PostgreSQL. Las tablas son heap files, sin orden. El comando
CLUSTER shipment USING ...reescribe la tabla ordenada según un índice, pero el orden no se mantiene: las inserciones posteriores van donde haya espacio. Es una reorganización hecha a mano.
Archivos multitabla y particionamiento
Normalmente cada relación tiene su archivo. Una organización de archivo
multitabla en clústeres (multitable clustering file organization) guarda en
un mismo bloque registros de varias relaciones que se suelen leer
juntos. En Chasqui, por ejemplo, se podría guardar cada envío de shipment
seguido de sus eventos de shipment_event: la consulta “el envío 1250 con su
historial” leería un solo bloque. A cambio, leer solo shipment cuesta más,
porque sus filas están mezcladas con las de otra tabla. PostgreSQL no lo
ofrece; algunos motores comerciales sí.
El particionamiento de tablas (table partitioning) hace lo contrario:
parte una relación grande en varias relaciones más chicas según el valor de
un atributo. Por ejemplo, shipment en una partición por mes de
created_at. Una consulta sobre enero lee solo la partición de enero, y
borrar los envíos de hace cinco años es borrar una partición entera.
PostgreSQL lo soporta (CREATE TABLE ... PARTITION BY RANGE (...)); cada
partición es una tabla con su propio archivo.
Row store y column store
Todo lo anterior supone que un registro guarda una fila completa: es un
row store. La sección 13.6 (opcional) presenta la alternativa: un
column store guarda cada columna en su propio archivo. Para calcular
avg(price) sobre 2 millones de envíos, un column store lee solo la columna
price, y los valores de una misma columna se comprimen muy bien porque se
parecen entre sí. Para leer o modificar un envío completo, en cambio, tiene
que ir a doce lugares. Los row stores son mejores para sistemas
transaccionales (muchas operaciones pequeñas sobre filas completas); los
column stores, para análisis sobre muchas filas y pocas columnas.
PostgreSQL es un row store.
El diccionario de datos
Un DBMS necesita guardar información sobre sus propios datos: qué relaciones hay, qué atributos tiene cada una y de qué tipo, qué índices existen, qué usuarios y permisos hay, y estadísticas como el número de páginas. Es el diccionario de datos (data dictionary) o catálogo del sistema (sec. 13.4). La solución habitual, y la de PostgreSQL, es guardarlo en tablas del propio sistema, con la misma estructura de archivos que cualquier otra tabla. Así el motor usa su propio código para leer sus metadatos.
Ya usamos varias tablas del catálogo:
pg_class: una fila por relación (tabla, índice, vista, secuencia), con surelfilenode,relpagesyreltuples.pg_attribute: una fila por atributo, con su tipo,attleny alineación.pg_index: una fila por índice, con la tabla a la que pertenece y las columnas que indexa.
      index       |  tabla   | indkey | indisunique | indisprimary
------------------+----------+--------+-------------+--------------
 customer_pkey    | customer | 1      | t           | t
 customer_dni_key | customer | 2      | t           | f
(2 rows)

  oid  |     relname      | relfilenode | relkind | relpages
-------+------------------+-------------+---------+----------
 56489 | customer         |       56489 | r       |       19
 56501 | customer_pkey    |       56501 | i       |        7
 56503 | customer_dni_key |       56503 | i       |       11
(3 rows)
indkey dice qué columnas indexa cada índice, por su número de atributo
(attnum): 1 es customer_id y 2 es dni. Cada índice es también una
relación de pg_class, con su propio archivo y sus propias páginas.
Hay un problema de huevo y gallina: para leer pg_class hay que saber dónde
está el archivo de pg_class, y eso está en… pg_class. Los motores lo
resuelven guardando la ubicación de unas pocas tablas del catálogo en un lugar
fijo, conocido de antemano. PostgreSQL tiene además una caché en memoria del
catálogo, porque cada consulta necesita consultarlo muchas veces.
El buffer pool
Para qué sirve
Una consulta no trabaja sobre el disco: trabaja sobre páginas en memoria. Lo que decide qué páginas están en memoria en cada momento es el buffer manager (sec. 13.5), y la memoria que administra se llama buffer pool. Su objetivo es el de toda esta parte del curso: que la mayor cantidad posible de pedidos de páginas se atiendan sin ir al disco.
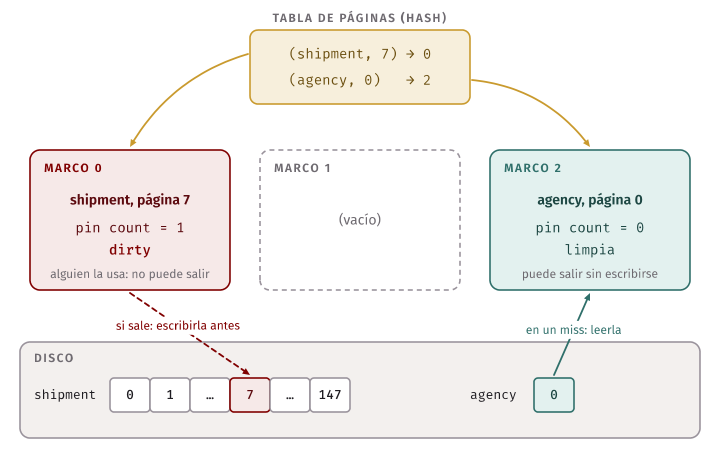
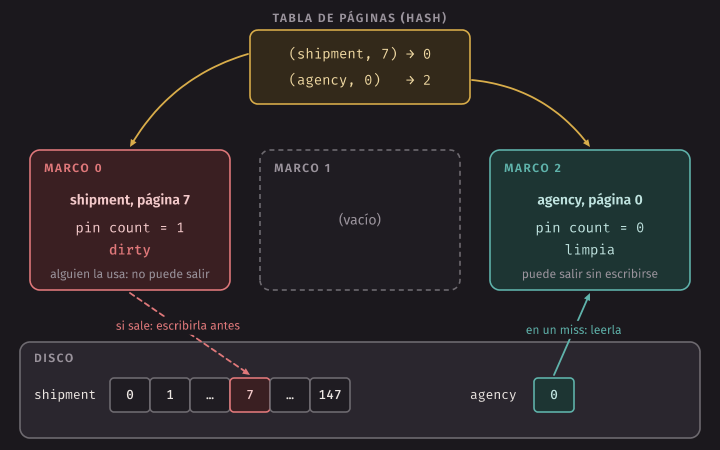
El buffer pool es un arreglo de marcos (frames), cada uno del tamaño de una página. Junto a él, el buffer manager mantiene:
- Una tabla de páginas (page table): una tabla hash que dice, para cada página que está en memoria, en qué marco está. Ojo: no es la tabla de páginas del sistema operativo, aunque la idea se parezca.
- Para cada marco, su descriptor: qué página tiene (archivo y número de página), el pin count, la bandera dirty y lo que necesite la política de reemplazo (la última vez que se usó, un bit de referencia o un contador).
Pin, unpin y páginas sucias
El resto del motor usa el buffer manager con tres operaciones:
- Pedir una página (fetch o pin). El buffer manager busca la página
en la tabla de páginas.
- Si está (un hit), sube su pin count en 1 y devuelve un puntero al marco.
- Si no está (un miss), elige un marco para usar: uno vacío, o si no hay, uno cuyo pin count sea 0, según la política de reemplazo. Si la página de ese marco está sucia, primero la escribe en el disco. Después lee la página pedida en el marco, actualiza la tabla de páginas, pone el pin count en 1 y devuelve el puntero.
- Soltar la página (unpin) cuando ya no se usa: el pin count baja en
- Quien la soltó dice además si la modificó; en ese caso el marco se marca como dirty (sucio).
- Escribir una página (flush) al disco, si está sucia, sin sacarla del buffer pool. Se usa en los checkpoints y cuando lo exige el protocolo de recuperación.
El pin count cuenta cuántos usuarios tiene la página en este momento: dos consultas que leen la misma página la tienen fijada (pinned) las dos. Mientras sea mayor que 0, la página no se puede desalojar, porque alguien tiene un puntero a ese marco y lo está usando. Si todas las páginas del pool están fijadas y llega un miss, el buffer manager no tiene a quién desalojar: es un error del código que olvidó soltar páginas.
La bandera dirty dice que la copia en memoria es más nueva que la del disco. Una página limpia se puede desalojar sin más; una sucia hay que escribirla antes de reutilizar su marco.
Error común. Creer que unpin quiere decir “escribir a disco”. Unpin solo dice “ya no la estoy usando” (y, si corresponde, “la cambié”). La página se queda en memoria, sucia, hasta que se la desaloja, hasta el siguiente checkpoint o hasta que el protocolo de recuperación pide escribirla. Una página puede cambiar mil veces y escribirse a disco una sola vez: esa es buena parte de la gracia del buffer pool.
El libro menciona además que, mientras un proceso lee o escribe los bytes de una página, tiene que tener un lock sobre el marco (compartido para leer, exclusivo para escribir), para que otro no la modifique a medias. En los motores reales se llaman latches: son muy breves, duran lo que dura la copia de unos bytes, y no tienen nada que ver con los locks de las transacciones de la semana 14.
Políticas de reemplazo
Cuando hay que desalojar, ¿cuál página sale? Lo ideal sería sacar la que se va a volver a pedir más tarde, pero eso exige conocer el futuro. Las políticas reales usan el pasado:
- LRU (least recently used): sale la página que se usó hace más tiempo. Se basa en que lo que se usó hace poco probablemente se vuelva a usar.
- Clock: una aproximación de LRU más barata, que conocen de Sistemas Operativos. Cada marco tiene un bit de referencia que se pone en 1 cuando se usa la página. Una manecilla (clock hand) recorre los marcos en círculo: si el bit del marco está en 1, lo pone en 0 y avanza (la página tiene una “segunda oportunidad”); si está en 0 y la página no está fijada, ese marco es la víctima.
- MRU (most recently used): sale la página que se usó más recientemente. Parece absurdo, pero es la mejor opción para ciertos patrones de acceso, como vamos a ver.
- Toss-immediate: el libro también menciona sacar una página apenas se termina de usar, cuando el motor sabe que no la va a volver a pedir.
LRU exacto tiene un costo: hay que mover la página al frente de una lista en cada acceso, incluidos los hits, y esa lista es compartida por todos los procesos. Clock solo pone un bit en 1 en cada hit; el trabajo de verdad lo hace la manecilla, y solo cuando hay un miss.
Una cadena de referencias
replacement.mjs simula las tres
políticas. Recibe una cadena de referencias (los números de página que
pide el motor, en orden) y la cantidad de marcos, y cuenta hits y misses. No
modela pin counts, ni páginas sucias, ni disco: solo la decisión de a quién
desalojar. replay.mjs muestra los pasos.
Con 3 marcos y la cadena 1 2 3 4 1 2 5 1 2 3 4 5, clock hace esto:
$ node replay.mjs clock 3
clock, 3 marcos
  pide  1  miss  [ 1  -  - ]
  pide  2  miss  [ 1  2  - ]
  pide  3  miss  [ 1  2  3 ]
  pide  4  miss  [ 4  2  3 ]  sale 1
  pide  1  miss  [ 4  1  3 ]  sale 2
  pide  2  miss  [ 4  1  2 ]  sale 3
  pide  5  miss  [ 5  1  2 ]  sale 4
  pide  1  hit   [ 5  1  2 ]
  pide  2  hit   [ 5  1  2 ]
  pide  3  miss  [ 5  3  2 ]  sale 1
  pide  4  miss  [ 5  3  4 ]  sale 2
  pide  5  hit   [ 5  3  4 ]
hits=3 misses=9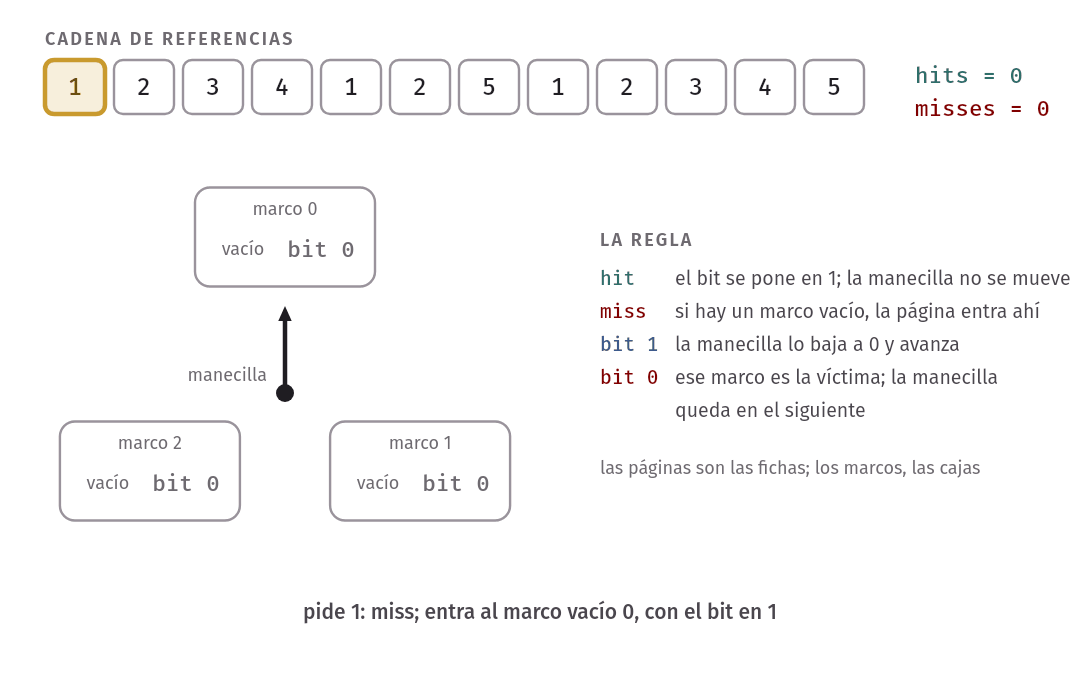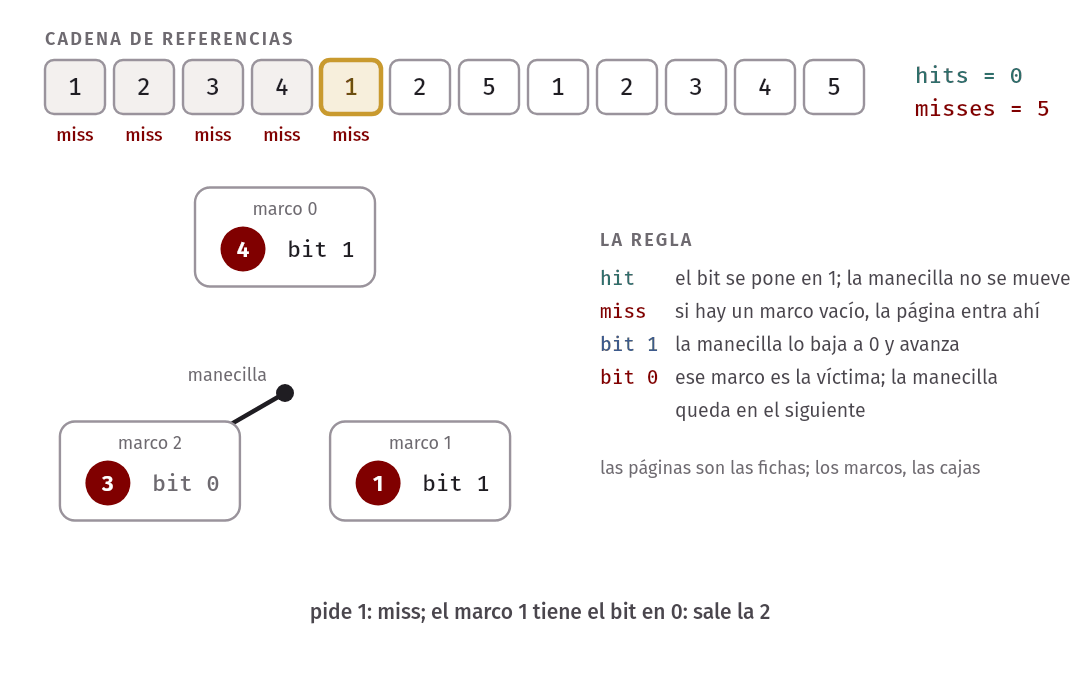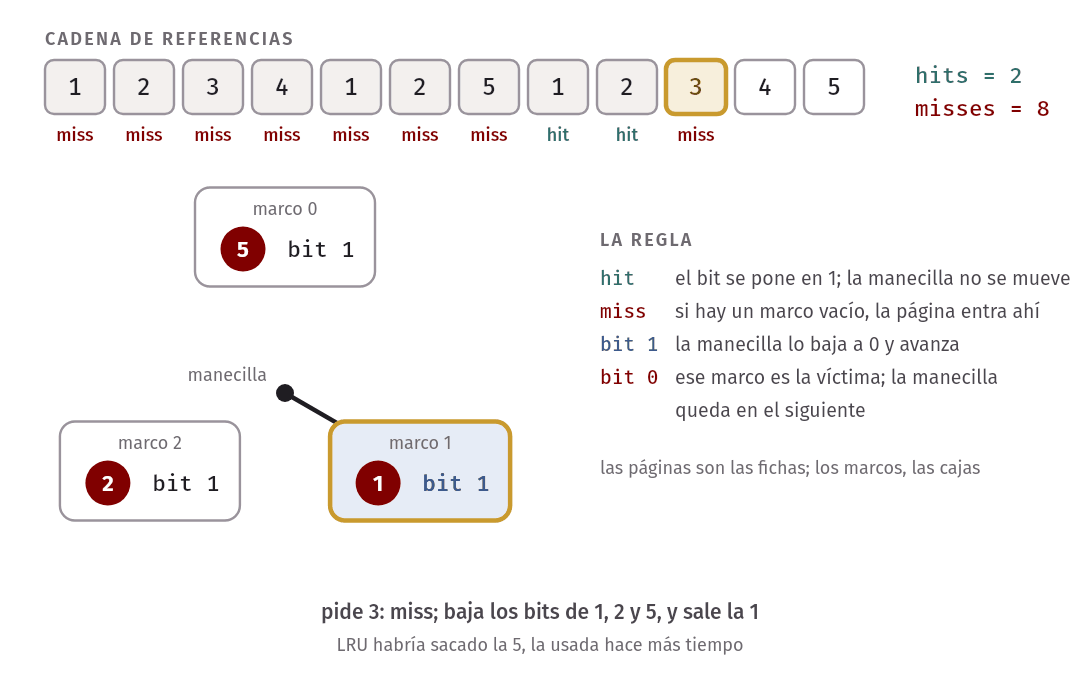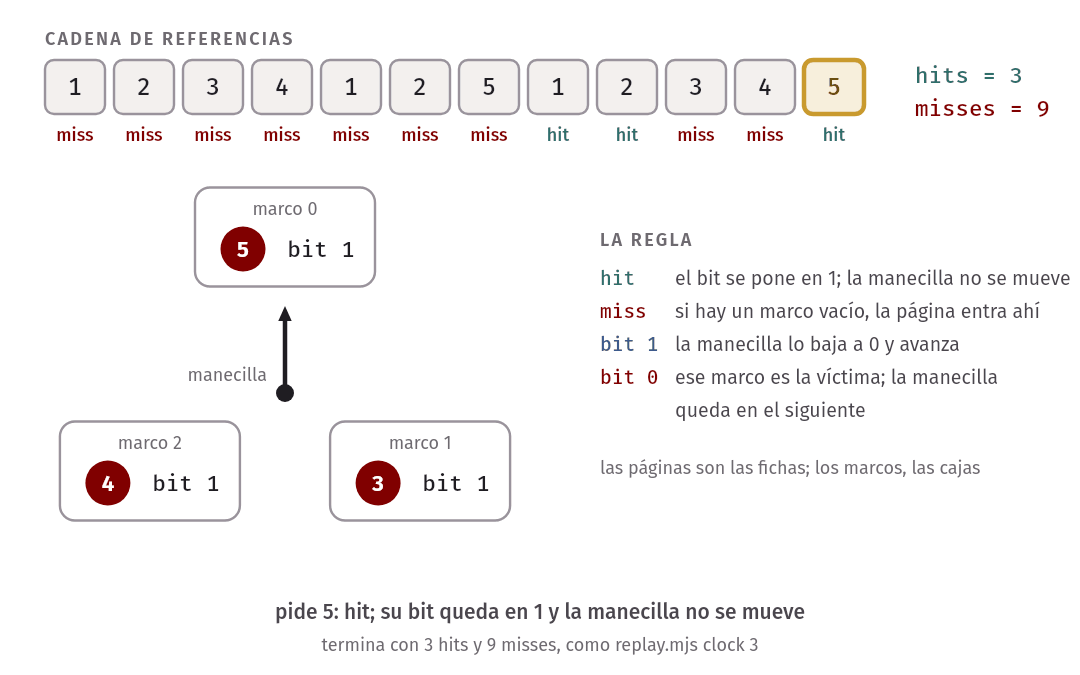
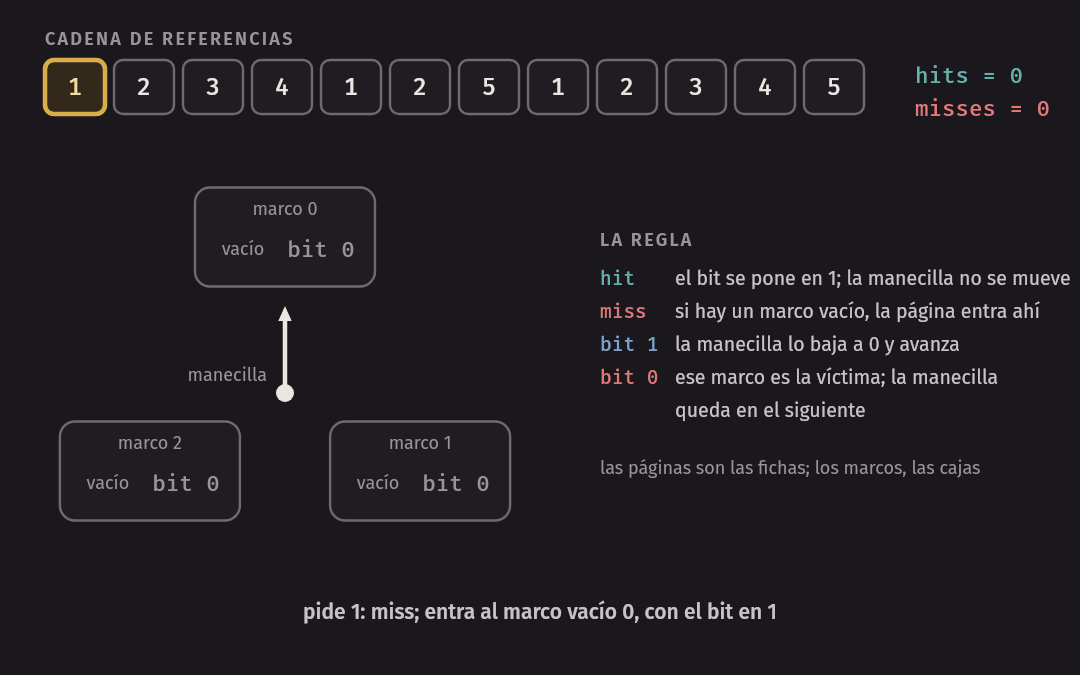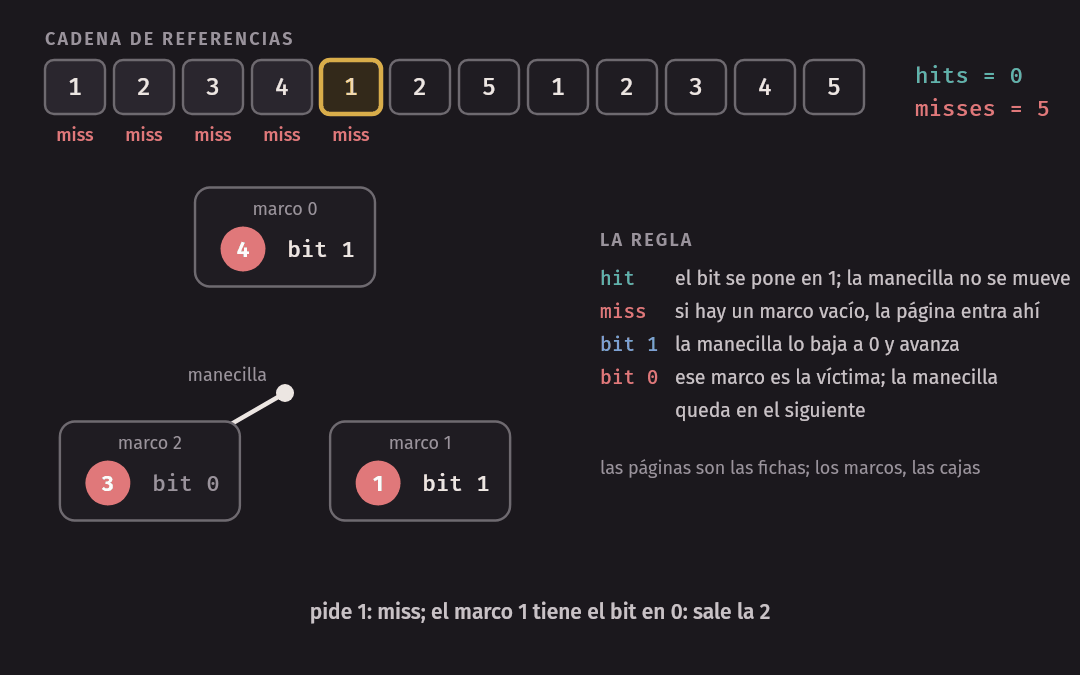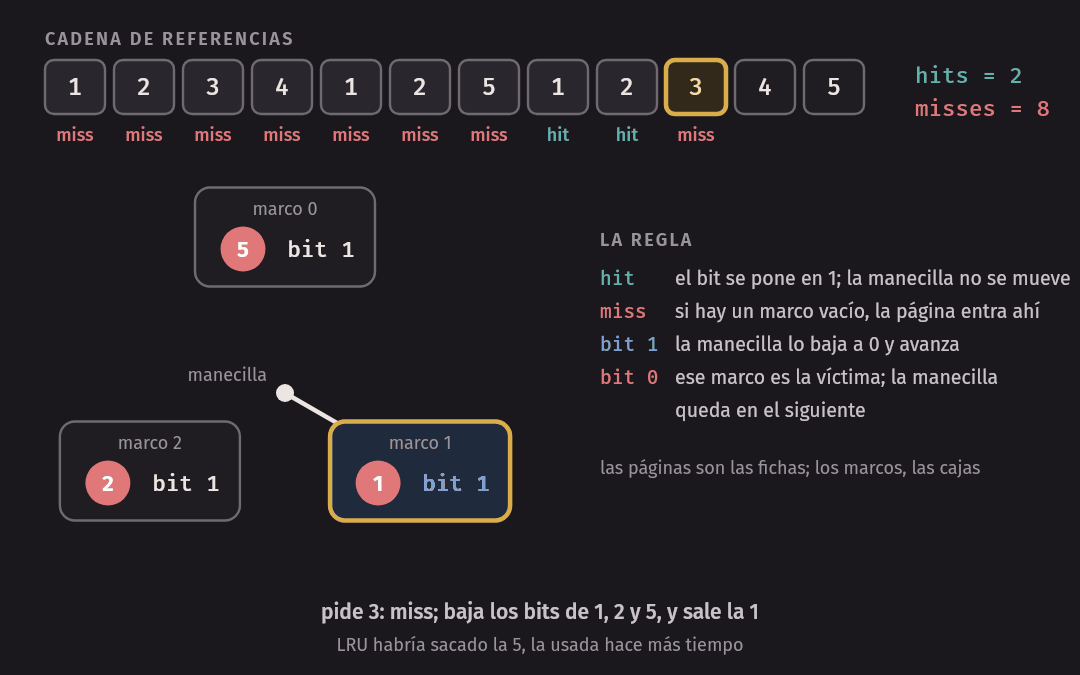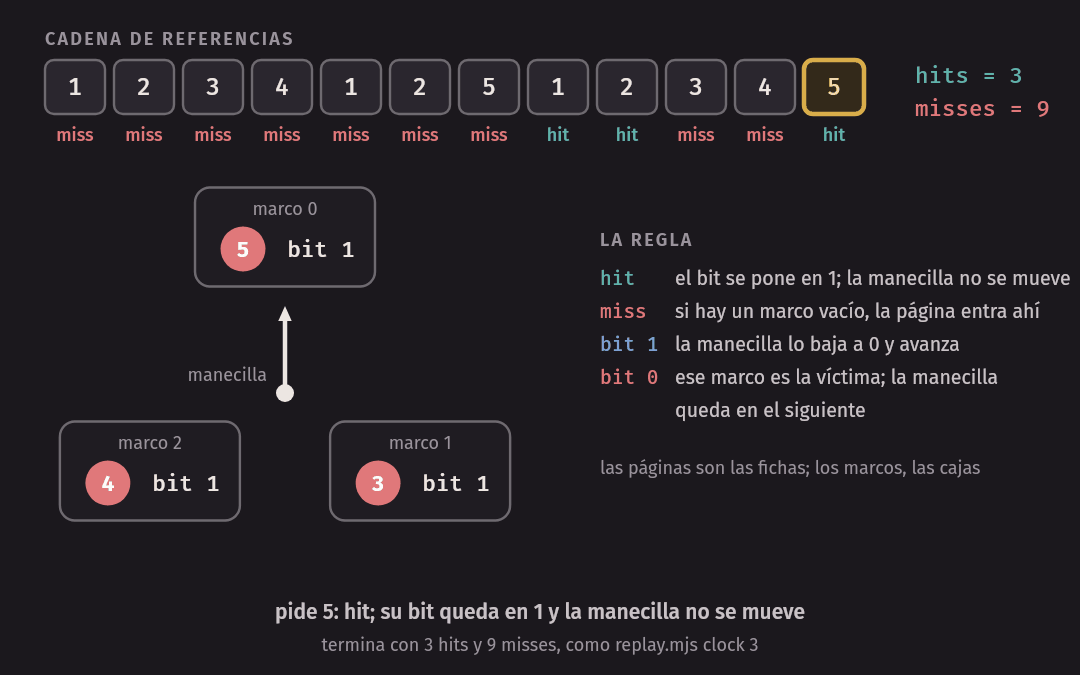
Sigamos el paso en que se pide la página 3. Los marcos tienen 5, 1 y 2, las tres con el bit en 1 (5 se acaba de cargar; 1 y 2 tuvieron hits). La manecilla está en el marco 1, justo después del último desalojo. Baja el bit de 1, después el de 2, después el de 5, vuelve al marco 1, encuentra su bit en 0 y desaloja la página 1. LRU, en cambio, habría desalojado la 5, que es la que se usó hace más tiempo:
$ node replay.mjs lru 3
...
  pide  3  miss  [ 3  1  2 ]  sale 5
  pide  4  miss  [ 3  4  2 ]  sale 1
  pide  5  miss  [ 3  4  5 ]  sale 2
hits=2 misses=10
Clock no es LRU: es una aproximación, y a veces se equivoca a favor y a veces en contra. En esta cadena le fue mejor (3 hits contra 2). MRU consigue 5 hits.
Sequential flooding
El caso donde LRU falla de verdad es muy común en una base de datos: un sequential scan repetido de una tabla que no entra en el buffer pool. Supongamos una tabla de 4 páginas, un buffer pool de 3 marcos y una consulta que la recorre tres veces (por ejemplo, la tabla de adentro de un nested loop join, semana 11). La cadena es 1 2 3 4 1 2 3 4 1 2 3 4.
Con LRU, cuando se pide la página 4, sale la 1, que es justo la que se va a pedir después. Al pedir la 1, sale la 2, que es la siguiente. Y así: cada página sale un momento antes de que se la pida. Cero hits en 12 pedidos. Clock hace lo mismo. Se llama sequential flooding: el scan “inunda” el buffer pool y lo deja inservible para todos, incluidas las demás consultas, que pierden sus páginas.
MRU, en cambio, sacrifica siempre la página que se acaba de usar, y deja en paz las del principio de la tabla:
$ node replay.mjs mru 3 1 2 3 4 1 2 3 4 1 2 3 4
mru, 3 marcos
  pide  1  miss  [ 1  -  - ]
  pide  2  miss  [ 1  2  - ]
  pide  3  miss  [ 1  2  3 ]
  pide  4  miss  [ 1  2  4 ]  sale 3
  pide  1  hit   [ 1  2  4 ]
  pide  2  hit   [ 1  2  4 ]
  pide  3  miss  [ 1  3  4 ]  sale 2
  pide  4  hit   [ 1  3  4 ]
  pide  1  hit   [ 1  3  4 ]
  pide  2  miss  [ 2  3  4 ]  sale 1
  pide  3  hit   [ 2  3  4 ]
  pide  4  hit   [ 2  3  4 ]
hits=6 misses=6
Seis hits. En general, en un scan repetido de N páginas con B marcos (N mayor que B), LRU no acierta nunca y MRU acierta del orden de B veces en cada vuelta después de la primera.
Idea clave. Ninguna política es la mejor para todo. El sistema operativo tiene que usar una política genérica, porque no sabe qué hace cada programa. Un DBMS sí sabe: cuando empieza un sequential scan sabe que va a recorrer la tabla una vez, y cuando hace un nested loop join sabe qué relación va a recorrer muchas veces. Puede elegir la política según el operador. Es el primer argumento para que el DBMS administre su propia memoria.
El buffer pool de PostgreSQL
El buffer pool de PostgreSQL se llama shared buffers, porque lo
comparten todos los procesos del servidor. Su tamaño es el parámetro
shared_buffers:
 buffers | unit | total
---------+------+--------
 16384   | 8kB  | 128 MB
(1 row)
Son 16 384 marcos de 8 KiB: 128 MB, el valor por defecto. Cada marco tiene un descriptor con, entre otras cosas, el pin count (que PostgreSQL llama refcount), la bandera dirty y un usage count, un contador de 0 a 5. La política es una variante de clock (clock sweep): cada uso de la página sube el contador (hasta 5) y la manecilla, en vez de poner un bit en 0, resta 1. Sale el primer marco que la manecilla encuentra con usage count en 0 y sin pin. Una página muy usada aguanta varias vueltas de la manecilla.
La extensión pg_buffercache
muestra un descriptor por marco. Es la consulta top_relations de
buffers.sql: las relaciones de esta base de
datos con más páginas en el buffer pool, y cuántas están sucias. Se une con
pg_class por relfilenode y se filtra por la base de datos actual, porque
el buffer pool es de todo el servidor:
SELECT c.relname,
       count(*) AS buffers,
       count(*) FILTER (WHERE b.isdirty) AS dirty
FROM pg_buffercache b
  JOIN pg_class c ON b.relfilenode = pg_relation_filenode(c.oid)
WHERE b.reldatabase = (SELECT oid FROM pg_database WHERE datname = current_database())
GROUP BY c.relname
ORDER BY buffers DESC, c.relname
LIMIT 10;
relname | buffers | dirty
--------------------------------+---------+-------
shipment_event | 346 | 346
shipment | 152 | 152
shipment_event_pkey | 129 | 129
pg_proc | 108 | 108
pg_toast_2618 | 68 | 68
pg_attribute | 62 | 62
pg_description | 50 | 50
trip | 48 | 48
pg_statistic | 45 | 45
pg_proc_proname_args_nsp_index | 36 | 36
(10 rows)Lo corrimos un momento después de make, que acababa de cargar los datos:
todas las páginas están sucias. La carga y el VACUUM las escribieron en
memoria, y nadie las ha llevado todavía al disco. Lo harán, sin apuro, el
checkpointer y el background writer, dos procesos de PostgreSQL que
escriben páginas sucias en segundo plano para que, al desalojar, casi
siempre haya marcos limpios. Que shipment tenga 152 buffers y no 148 se
debe a que también están en memoria las páginas de sus archivos _fsm y
_vm. Y el catálogo (pg_proc, pg_attribute, pg_statistic) también
vive en el buffer pool: es una tabla más.
Caché fría y caliente
EXPLAIN (ANALYZE, BUFFERS) dice, para cada nodo del plan, cuántas páginas
encontró en el buffer pool (shared hit) y cuántas tuvo que pedir afuera
(shared read). Primero sacamos del buffer pool las páginas de shipment
con pg_buffercache_evict_relation, que existe desde PostgreSQL 18 (si
alguna está sucia, la escribe antes; por eso buffers_flushed es 152):
 buffers_evicted | buffers_flushed | buffers_skipped
-----------------+-----------------+-----------------
             152 |             152 |               0
(1 row)
Y recorremos la tabla dos veces:
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF)
SELECT count(*) FROM shipment;
QUERY PLAN
-----------------------------------------------------------
Aggregate (actual rows=1.00 loops=1)
Buffers: shared read=148
-> Seq Scan on shipment (actual rows=12000.00 loops=1)
Buffers: shared read=148
Planning:
Buffers: shared hit=27
Planning Time: 0.068 ms
Execution Time: 0.989 ms
(8 rows) QUERY PLAN
-----------------------------------------------------------
Aggregate (actual rows=1.00 loops=1)
Buffers: shared hit=148
-> Seq Scan on shipment (actual rows=12000.00 loops=1)
Buffers: shared hit=148
Planning Time: 0.015 ms
Execution Time: 0.409 ms
(6 rows)La primera vez, las 148 páginas fueron misses (read=148); la segunda, las
148 fueron hits. Es exactamente el número de páginas de la tabla: un
sequential scan lee cada página una vez. Después de los dos scans, las 148
páginas tienen usage count 2, uno por cada scan:
 usagecount | buffers
------------+---------
          2 |     148
(1 row)
Una tabla más grande que la cuarta parte del buffer pool
Ahora lo mismo con chasqui_big, que tiene 2 millones de envíos. Es
big.sql, que no cambia datos:
   bytes   | pretty | pages | relpages | reltuples | rows_per_page
-----------+--------+-------+----------+-----------+---------------
 202072064 | 193 MB | 24667 |    24667 |   2012000 |            82
(1 row)
shipment ocupa 24 667 páginas, 193 MB: más que los 128 MB de todo el
buffer pool. Primero una tabla que sí entra, customer (2040 páginas). De los dos
planes, las líneas del scan:
   Buffers: shared read=2040
   ->  Seq Scan on customer (actual time=0.114..9.618 rows=201800.00 loops=1)
Buffers: shared hit=2040
-> Seq Scan on customer (actual time=0.003..7.468 rows=201800.00 loops=1)Lo esperado: la primera vez todo es read, la segunda todo es hit. Ahora
shipment, dos veces seguidas:
                                   QUERY PLAN
--------------------------------------------------------------------------------
 Aggregate (actual time=170.040..170.041 rows=1.00 loops=1)
   Buffers: shared read=24667
   ->  Seq Scan on shipment (actual time=0.115..97.709 rows=2012000.00 loops=1)
         Buffers: shared read=24667
 Planning:
   Buffers: shared hit=19
 Planning Time: 0.135 ms
 Execution Time: 170.058 ms
(8 rows)
QUERY PLAN
--------------------------------------------------------------------------------
Aggregate (actual time=151.120..151.120 rows=1.00 loops=1)
Buffers: shared hit=94 read=24573
-> Seq Scan on shipment (actual time=0.078..82.713 rows=2012000.00 loops=1)
Buffers: shared hit=94 read=24573
Planning Time: 0.032 ms
Execution Time: 151.134 ms
(6 rows)El segundo scan volvió a leer casi todo: 94 hits y 24 573 reads. Y al
final, de las 24 667 páginas de shipment, solo quedaron 188 en el buffer
pool:
 buffers
---------
     188
(1 row)
No es un accidente. Es la defensa de PostgreSQL contra el sequential
flooding: cuando un sequential scan recorre una tabla de más de un cuarto de
shared_buffers (aquí, 16 384 / 4 = 4096 páginas), no usa el buffer pool
general sino un anillo de buffers (buffer ring) pequeño, que reutiliza
una y otra vez. El scan solo desaloja sus propias páginas y no las de las
demás consultas. customer, con 2040 páginas, está por debajo del límite;
shipment, con 24 667, por encima. Es una forma de toss-immediate: el motor
sabe que un scan grande no va a volver pronto sobre la misma página. Los
anillos también se usan para VACUUM y para las escrituras masivas, como
COPY.
En PostgreSQL. Para PostgreSQL,
readquiere decir “la página no estaba en shared buffers y se la pedí al sistema operativo”, no “la leí del disco”. El sistema operativo tiene su propia caché de páginas, y los datos deshipmentestaban ahí porque se acababan de leer. Se puede comprobar. En PostgreSQL 18, conio_method = worker(el valor por defecto), las lecturas las hacen unos procesos auxiliares (io worker), y Linux lleva en/proc/<pid>/iodos contadores por proceso:rchar, los bytes que el proceso pidió conread, yread_bytes, los que de verdad hubo que traer del dispositivo. Sumados para losio worker, antes y después de otro scan deshipment(conhit=282 read=24385):rchar=1871282623 read_bytes=0 rchar=2071533508 read_bytes=0
rcharsubió 200 250 885 bytes, casi exactamente 24 385 × 8192 = 199 761 920;read_bytesno se movió: ni un byte vino del disco. Una página puede estar dos veces en memoria, en shared buffers y en la caché del sistema operativo (doble buffering). Por esoshared_buffersno se configura con toda la RAM: la documentación sugiere empezar con un 25 % de la memoria en un servidor dedicado y dejar el resto al sistema operativo.
¿Por qué no basta el sistema operativo?
El sistema operativo ya tiene una caché de páginas, read-ahead y un
planificador de E/S. Y tiene mmap, que proyecta un archivo en la memoria
del proceso: el programa lee y escribe el archivo como si fuera un arreglo, y
el sistema operativo trae y lleva las páginas solo. ¿Para qué escribir un
buffer manager propio? El libro (sec. 13.5) y el artículo de Crotty, Leis y
Pavlo dan varias razones:
- El orden de las escrituras. Para recuperarse de un crash (semana 15),
el DBMS escribe primero en el log lo que va a cambiar, y solo después la
página: es la regla del write-ahead logging (WAL). Una página sucia
no puede llegar al disco antes que los registros del log que la
describen. Cada página guarda el número de su último registro de log (en
PostgreSQL,
pd_lsn, los primeros 8 bytes del encabezado; enquipu, los 8 bytes reservados). El buffer manager propio lo revisa antes de escribir. Conmmap, el sistema operativo puede escribir una página sucia cuando quiera, sin preguntar. - El patrón de acceso. El DBMS sabe qué va a pedir: un scan completo, un nested loop join, un recorrido de índice. Puede leer por adelantado exactamente lo que va a necesitar, usar MRU o un anillo donde LRU falla, y fijar las páginas que no deben salir (la raíz de un índice, por ejemplo). El sistema operativo solo ve accesos a memoria y tiene que adivinar.
- Los fallos de página y los errores. Con
mmap, leer una página que no está en memoria produce un fallo de página: el hilo se detiene hasta que llega del disco, sin aviso y sin que el DBMS pueda aprovechar ese tiempo para otra cosa. Y un error de E/S no llega como un valor de retorno sino como una señal (SIGBUS), difícil de manejar en el punto exacto donde ocurrió. - El rendimiento con muchos hilos. El artículo mide que, con dispositivos rápidos, el sistema operativo se vuelve el cuello de botella: el desalojo de páginas proyectadas obliga a sincronizar las tablas de páginas de todos los núcleos (TLB shootdowns) y la estructura que administra las páginas es una sola para todos.
La conclusión del artículo es que mmap parece un atajo, pero termina siendo
más difícil de hacer correcto y más lento que un buffer pool propio.
PostgreSQL tiene su propio buffer pool y, aun así, pasa por la caché del
sistema operativo para leer y escribir: aprovecha su read-ahead y su
planificador, y controla con fsync cuándo los datos llegan de verdad al
disco.
En el laboratorio
El laboratorio recorre lo mismo que este capítulo, dentro del contenedor
(env/run.sh), con los archivos de code/week-09: make para crear
chasqui_w09; psql -d chasqui_w09 -f pages.sql, -f update.sql (una sola
vez; para repetirlo, make otra vez) y -f buffers.sql; psql -d chasqui_big -f big.sql; y PGDATABASE=chasqui_w09 node dump.mjs shipment 0
para comparar lo que lee pgpage.mjs con heap_page_items. Las extensiones
se instalan por base de datos: make las instala en chasqui_w09, y
big.sql instala pg_buffercache en chasqui_big. Si trabajan sobre la
base chasqui en vez de chasqui_w09, los números de páginas pueden ser
otros hasta que corran VACUUM, y verán los t_xmax de “solo lock” que
explicamos arriba.
El código de la semana y make test
Dentro del contenedor, en code/week-09, make crea la base de datos
chasqui_w09 y make test la vuelve a crear y corre las pruebas:
$ make test
chasqui-load chasqui_w09
Base de datos chasqui_w09 lista.
...
✔ shared_buffers son 16384 marcos de 8 KiB (128 MB)
✔ top_relations: lista relaciones de esta base de datos
...
✔ UPDATE deja dos versiones; VACUUM libera el slot viejo y compacta
✔ get_raw_page devuelve un Buffer de 8192 bytes
...
✔ errores claros
ℹ tests 40
ℹ pass 40
ℹ fail 0
...| Archivo | Qué muestra |
|---|---|
pages.sql |
Archivo y tamaño de cada tabla, encabezado y slots de agency, bytes de customer, pg_attribute y free space map |
update.sql |
Un UPDATE deja dos versiones; VACUUM libera el slot y compacta la página sin cambiar los ctid |
buffers.sql |
shared_buffers, pg_buffercache y EXPLAIN (ANALYZE, BUFFERS) con caché fría y caliente |
big.sql |
Tamaños de chasqui_big y el buffer ring de un scan grande |
pgpage.mjs |
Lector de páginas de heap de PostgreSQL: encabezado, line pointers, encabezado de tupla y datos |
dump.mjs |
Muestra una página leída con pgpage.mjs |
replacement.mjs |
Simulador de LRU, MRU y clock sobre una cadena de referencias |
replay.mjs |
Muestra la simulación paso a paso |
*.test.mjs |
Las cifras de este capítulo, pgpage.mjs contra pageinspect y las cadenas de referencias |
Como en la semana 5, las consultas de los .sql empiezan con una línea
-- name: ..., y sqlfile.mjs las separa
para que las pruebas corran el mismo texto. pages.test.mjs necesita la
base recién creada (update.sql cambia la agencia 1), y buffers.test.mjs
solo saca del buffer pool páginas de chasqui_w09. Los archivos se corren
uno después de otro (--test-concurrency=1).
Resumen
- La jerarquía de almacenamiento va de la caché de la CPU a la cinta; la
durabilidad exige escribir bajo la memoria, en flash o en disco. El disco
entrega bloques (8 KiB en PostgreSQL, 4 KiB en
quipu), y el costo se mide en bloques leídos y escritos: b · t_T + S · t_S. - En un disco magnético casi todo el costo es posicionarse (seek y latencia rotacional): leer en orden puede ser cien veces más barato. Un SSD no tiene seek, pero se borra por bloques, necesita una FTL y sufre amplificación de escritura; lo secuencial sigue siendo más barato.
- Una tabla es un archivo, un archivo es una secuencia de páginas, una página guarda registros. Un registro de longitud variable lleva pares (offset, longitud) y un bitmap de nulos; PostgreSQL guarda la longitud delante de cada varlena y el bitmap en el encabezado de la tupla.
- Una slotted page tiene encabezado, un arreglo de slots que crece desde
el inicio y registros que crecen desde el final. El RID es (página,
slot): compactar mueve registros sin cambiar su RID. En PostgreSQL, el RID
es el
ctid, ypageinspectmuestralower,uppery los line pointers. - Un
UPDATEen PostgreSQL escribe una versión nueva y marca la vieja (t_xmax,t_ctid);VACUUMlibera el slot viejo y compacta la página. - Un heap file guarda registros en cualquier página y necesita un free space map para encontrar espacio. Un archivo secuencial mantiene un orden con overflow y reorganización. El particionamiento parte una tabla; el clustering multitabla junta varias.
- El diccionario de datos se guarda en tablas del sistema:
pg_class,pg_attribute,pg_index. - El buffer pool es un arreglo de marcos con una tabla de páginas. Una página con pin no se desaloja; una dirty se escribe antes de salir. Unpin no escribe nada.
- LRU, clock y MRU. Un scan repetido de una tabla más grande que el pool
arruina a LRU (sequential flooding); MRU acierta. PostgreSQL usa clock con
usage count y un buffer ring para los scans de tablas de más de un
cuarto de
shared_buffers. - Un DBMS administra su propio buffer pool porque necesita controlar cuándo
se escribe cada página (WAL), conoce su patrón de acceso y no quiere los
fallos de página ni los errores de
mmap. PostgreSQL pasa además por la caché del sistema operativo: unreadenEXPLAINno siempre es el disco.
Ejercicios
- Un disco gira a 10 000 RPM, tiene seek promedio de 5 ms y transfiere 150 MB/s. Calculen el tiempo de leer 1000 bloques de 8 KiB (a) repartidos al azar y (b) contiguos. ¿Cuántas veces más rápido es el caso (b)? Repitan la cuenta con el modelo t_S, t_T del SSD del libro.
- Con el formato de registro de longitud variable del libro, escriban el
registro de la tercera fila de
customer(la que tienephoneenNULL): los pares, los atributos fijos, el bitmap y los bytes variables. ¿Cuántos bytes ocupa? Comparen con sulp_lenen PostgreSQL (65) y expliquen la diferencia. - Una página de 4 KiB con un encabezado de 16 bytes y slots de 4 bytes
guarda registros de 60 bytes de
agency. ¿Cuántos registros caben? Si se borra el registro del slot 3 y se compacta la página, ¿cambia el RID de los demás registros? ¿Por qué? ¿Cambia la cuenta si, como enquipu, los primeros 8 bytes del encabezado están reservados? - Con
pages.sqlabierto, calculen a mano el espacio libre de la página 0 deshipmentenchasqui_w09a partir del número de tuplas y sus tamaños, sin mirarpage_header. Después verifíquenlo conSELECT lower, upper FROM page_header(get_raw_page('shipment', 0));. ¿Por qué una fila más de 96 bytes no entraría, aunque sobren 84 bytes? - Usen
heap_page_itemspara encontrar la tupla decustomerconcustomer_id = 100: primero suctidcon unSELECT, después su slot en la página que corresponda. Decodifiquen a manot_datay comprueben condecodeTupledepgpage.mjs. - Repitan el experimento de
update.sql, pero cambiandocityen vez dename(cityno tiene índice). ¿Quélp_flagstiene el slot 1 después delVACUUM? ¿A qué apunta? Busquen HOT en la documentación de PostgreSQL y expliquen por qué cambia el resultado. - En
chasqui_w09, actualicen todas las filas deshipmentconUPDATE shipment SET price = price;y midanpg_relation_size('shipment')antes y después, y otra vez después deVACUUM shipment. ¿Por qué la tabla no vuelve a su tamaño original después delVACUUM? ¿Qué haceVACUUM FULL? ¿Cuántas páginas lee ahora un sequential scan (usenEXPLAIN (ANALYZE, BUFFERS))? - Con
replay.mjs, encuentren una cadena de referencias con 3 marcos en la que clock tenga menos hits que LRU. Expliquen paso a paso qué hace la manecilla. - Una tabla ocupa 33 000 páginas y el buffer pool tiene 10 000 marcos. Una
consulta hace dos sequential scans seguidos de la tabla. ¿Cuántas
lecturas a disco hace el segundo scan con LRU? ¿Y con MRU? Razónenlo antes
de comprobarlo con
simulate(..., { trace: false }). ¿Qué haría PostgreSQL con esa tabla, sishared_buffersfueran esos 10 000 marcos? - Corran
big.sqldos veces seguidas y anoten loshityreaddel segundo scan deshipmenten cada corrida. Después corranSELECT count(*) FROM shipment WHERE shipment_id < 1000;conEXPLAIN (ANALYZE, BUFFERS). ¿Usa un índice? ¿Cuántos buffers toca? ¿Por qué tan pocos, comparado con el sequential scan? - ¿Por qué un DBMS necesita poder impedir que una página sucia se escriba
a disco antes de tiempo? ¿Qué le falta a
mmappara garantizarlo? Den un ejemplo concreto con unUPDATEde un envío de Chasqui y un corte de luz en el peor momento. - (Desafío) Agreguen a
replacement.mjsla variante de PostgreSQL: un usage count de 0 a 5 en vez de un bit, que sube en cada uso y que la manecilla resta de a 1. Escriban una prueba con una cadena en la que esa variante proteja una página muy usada que clock con un bit desalojaría.