
Apuntes · Capítulo 8Diseño de bases de datos
Datos semiestructurados: JSON en PostgreSQL
Datos semiestructurados: JSON en PostgreSQL
Las dos semanas anteriores fueron de diseño. Con el modelo E-R decidimos qué entidades y relaciones tiene Chasqui; con las dependencias funcionales y las formas normales, cómo repartir los atributos en tablas sin redundancia. Todo ese trabajo supone algo que hasta ahora no discutimos: que sabemos de antemano qué atributos tiene cada cosa. Un envío tiene peso, precio, estado y fecha de registro, y todos los envíos tienen esos mismos atributos.
Esta semana miramos los datos que no encajan del todo en esa idea. Chasqui
quiere guardar características del paquete que cambian de un cliente a otro:
si es frágil, sus medidas, unas etiquetas libres (“electrónica”,
“perecible”), el seguro que contrató el cliente, instrucciones para el
repartidor. Un envío trae dos de esas cosas; otro, ninguna; otro, cuatro, y
el próximo mes aparecerá una nueva. Se pueden agregar veinte columnas que
casi siempre están en NULL, o se puede guardar cada conjunto de
características como un documento: un valor estructurado, con sus propias
claves, dentro de una sola columna. Eso es un dato semiestructurado, y JSON
es hoy su formato más común.
El capítulo tiene tres partes. En la primera vemos qué es un dato
semiestructurado y qué es JSON, y cómo lo guarda PostgreSQL en sus dos tipos,
json y jsonb. En la segunda, cómo se consulta: los operadores ->,
->>, #>, @> y ?, el lenguaje de caminos SQL/JSON, el paso de JSON a
filas y de filas a JSON, cómo se usa desde Node.js y qué índice acelera esas
consultas. Terminamos con la pregunta de diseño que importa más que la
sintaxis: cuándo una columna jsonb es una buena decisión y cuándo es una
forma de no diseñar. La última parte es un repaso de las partes 1 y 2 para el
examen parcial, que es en la Sesión B de esta semana.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “Datos semiestructurados” y “JSON, el formato”. Sesión B (examen): “El examen” y “Lo que entra”, de “Repaso de las partes 1 y 2”.
- En clase. Sesión A: “
jsonyjsonben PostgreSQL”, “El ejemplo de la semana”, “Navegar un documento”, “Contención y existencia”, “De JSON a filas”, “Cuándo usarjsonby cuándo no” y “Repaso de las partes 1 y 2”. Sesión B: el examen parcial.- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), sec. 8.1 (la parte de JSON); de este capítulo, “SQL/JSON path”, “De filas a JSON”, “Modificar documentos”, “JSON desde Node.js” e “Índices sobre
jsonb” quedan como lectura. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, encode/week-08, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
Datos semiestructurados
Cuando el esquema no alcanza
En el modelo relacional, el esquema va primero. CREATE TABLE shipment
declara las columnas y sus tipos; después, toda fila que entra tiene esas
columnas, con valores de esos tipos o NULL. El esquema es una promesa que
el DBMS hace cumplir, y es lo que permite escribir una consulta sin mirar los
datos: si weight_kg es numeric(7, 2), WHERE weight_kg > 10 tiene
sentido para cualquier fila.
Hay datos para los que esa promesa cuesta. Las características opcionales de un paquete son un ejemplo:
- Son muchas y escasas: hay decenas de características posibles, pero
cada envío trae unas pocas. Con una columna por característica, la mayoría
de las celdas son
NULL. - Cambian con el tiempo: el área comercial inventa una nueva (“requiere cadena de frío”) y no quiere esperar una migración del esquema.
- Son anidadas o multivaluadas: las medidas son un trío (largo, ancho, alto); las etiquetas, una lista de longitud variable; el seguro, un objeto con aseguradora y número de póliza.
Las dos últimas ya las resolvimos con el diseño de la semana 6: una lista de
etiquetas es un atributo multivaluado, y se traduce a una tabla
shipment_tag(shipment_id, tag). Esa sigue siendo, muchas veces, la
respuesta correcta. Pero hay casos en que el costo de mantener una tabla por
cada atributo opcional no se justifica, o en que los datos llegan ya armados
como documentos desde otro sistema (una API, un formulario web, un
dispositivo) y lo que se quiere es guardarlos y consultarlos sin
desarmarlos.
Qué es un dato semiestructurado
Un dato es semiestructurado cuando su estructura viaja con él: cada valor dice qué atributos tiene, con sus nombres, y dos valores del mismo conjunto pueden tener atributos distintos. En lugar de un esquema fijo declarado antes, hay un esquema flexible: la estructura se descubre leyendo el dato. Los modelos semiestructurados permiten además dos cosas que la 1NF prohíbe: atributos multivaluados (una lista o un conjunto como valor) y atributos anidados (un valor que es a su vez un registro con atributos).
El libro (sec. 8.1) presenta varias formas de representar esto: tipos multivaluados como arreglos, conjuntos y mapas de clave a valor, y tipos anidados como JSON y XML. Nos quedamos con JSON, que es el formato con el que hablan hoy casi todas las aplicaciones web y el que PostgreSQL soporta mejor.
Las características de los envíos de Chasqui son un ejemplo: uno trae
fragile y unas medidas, que son un objeto anidado; otro, una lista de
etiquetas y un peso declarado, sin ninguna clave en común con el primero.
La relación con 1NF
En la semana 7 dijimos que la normalización con dependencias funcionales
supone dominios atómicos (sec. 7.8): el valor de cada atributo es
indivisible para la base de datos. Una columna jsonb rompe esa suposición a
propósito: su valor es un documento con partes, y las consultas van a mirar
esas partes. Una tabla con una columna jsonb no está en 1NF en sentido
estricto, y la teoría de las formas normales no dice nada sobre lo que pasa
dentro del documento.
Eso no hace que esté prohibido. Quiere decir que, para lo que va dentro del
documento, la base de datos deja de garantizar lo que garantizaba con
columnas: tipos, NOT NULL, claves foráneas, ausencia de redundancia. La
última sección del capítulo trata justo de cuándo ese precio vale la pena.
JSON, el formato
La gramática
JSON (JavaScript Object Notation) está definido en el RFC 8259 y su gramática completa cabe en una página. Un valor JSON es uno de seis tipos:
| Tipo | Ejemplo | Nota |
|---|---|---|
| objeto | {"l": 32, "w": 27} |
pares clave-valor entre llaves; las claves son textos entre comillas dobles |
| arreglo | ["ropa", "regalo"] |
valores en orden, entre corchetes; pueden ser de tipos distintos |
| string | "Seguros Inti" |
siempre con comillas dobles; acepta Unicode y escapes como \n y \" |
| number | 32, -1.5, 2.5e3 |
un solo tipo numérico; sin NaN ni infinitos, sin ceros a la izquierda |
| boolean | true, false |
en minúsculas |
| null | null |
la ausencia de valor, como valor |
Objetos y arreglos se anidan sin límite. No hay comentarios, ni comillas
simples, ni coma después del último elemento, ni fechas: una fecha se guarda
como string (casi siempre en el formato ISO 8601, "2026-02-15T18:18:00-05:00")
o como número. Esas restricciones son las que hacen que JSON se pueda leer
igual en cualquier lenguaje.
Idea clave. JSON tiene su propio
null, que es un valor: la clave existe y su valor esnull. No es lo mismo que una clave que no está, y no es lo mismo que elNULLde SQL. Más abajo vemos cómo se distinguen los tres casos en PostgreSQL.
Un documento de seguimiento
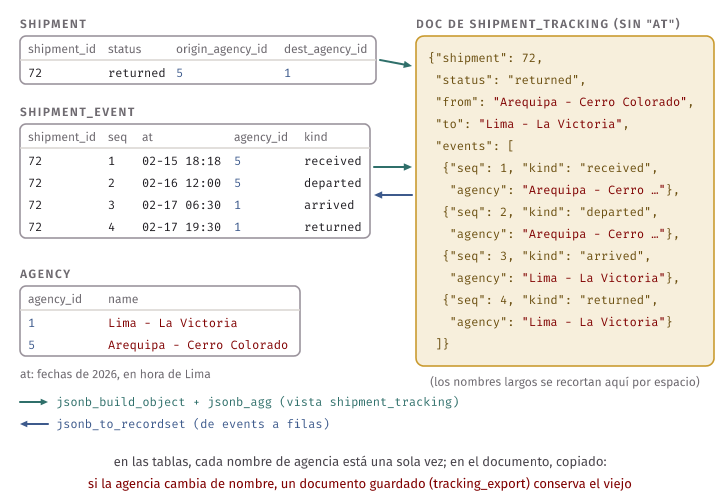
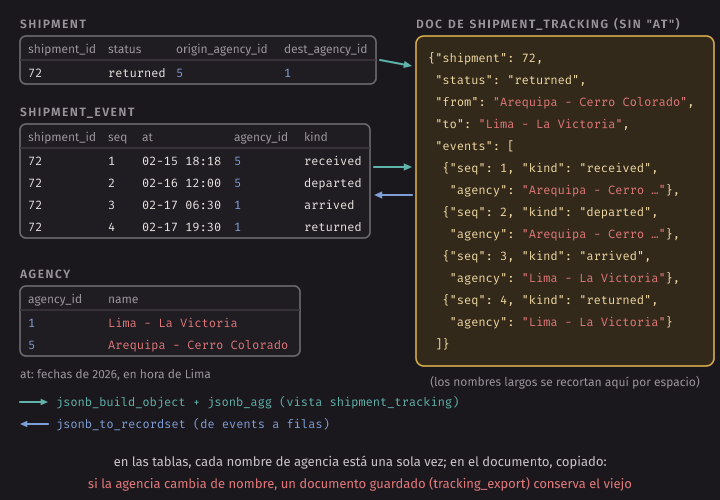
El segundo ejemplo del capítulo es el seguimiento de un envío, como lo mandaría una API a la aplicación del cliente. Es el envío 72, que salió de Arequipa y fue devuelto en Lima:
{
  "shipment": 72,
  "status": "returned",
  "from": "Arequipa - Cerro Colorado",
  "to": "Lima - La Victoria",
  "events": [
    {"seq": 1, "at": "2026-02-15T18:18:00-05:00", "agency": "Arequipa - Cerro Colorado", "kind": "received"},
    {"seq": 2, "at": "2026-02-16T12:00:00-05:00", "agency": "Arequipa - Cerro Colorado", "kind": "departed"},
    {"seq": 3, "at": "2026-02-17T06:30:00-05:00", "agency": "Lima - La Victoria", "kind": "arrived"},
    {"seq": 4, "at": "2026-02-17T19:30:00-05:00", "agency": "Lima - La Victoria", "kind": "returned"}
  ]
}
En el modelo relacional, esto son tres tablas (shipment, shipment_event
y agency) y dos joins. En el documento, todo está junto: el envío con sus
eventos anidados y los nombres de las agencias copiados. Es cómodo para quien
lo recibe, y es exactamente la redundancia que la normalización quitó: si
una agencia cambia de nombre, cada documento guardado conserva el viejo. Un
documento así es una buena salida de la base de datos; como forma de
guardar los datos de los que salió, no. Vamos a construirlo desde las
tablas más abajo.
json y jsonb en PostgreSQL
Dos tipos
PostgreSQL tiene dos tipos para JSON:
jsonguarda el texto tal como llegó, después de comprobar que es JSON válido. Conserva los espacios, el orden de las claves y las claves repetidas. Cada consulta que mira dentro del documento lo vuelve a analizar.jsonbanaliza el texto al guardarlo y lo convierte en un formato binario: sin espacios, con las claves de cada objeto ordenadas y sin claves repetidas (si una clave aparece dos veces, se queda la última). Guardarlo cuesta un poco más; consultarlo, mucho menos. Es el que tiene operadores de contención, igualdad e índices.
La diferencia se ve con un mismo texto convertido a los dos tipos
(examples.sql, consulta json_vs_jsonb):
SELECT '{"b": 1,   "a": 2, "a": 3}'::json  AS as_json,
       '{"b": 1,   "a": 2, "a": 3}'::jsonb AS as_jsonb;
as_json | as_jsonb
----------------------------+------------------
{"b": 1, "a": 2, "a": 3} | {"a": 3, "b": 1}
(1 row)json devolvió el texto con sus tres espacios y las dos "a". jsonb
devolvió un objeto con una sola "a" (la última, con 3), las claves en otro
orden y su propio espaciado. En jsonb el orden de las claves no tiene
significado: no hay que esperar que salgan en el orden en que se
escribieron. (El orden que usa, por cierto, es por longitud de la clave y
después alfabético; es un detalle de la implementación, no algo de lo que una
consulta pueda depender.)
En el curso usamos jsonb. json tiene sentido cuando hay que devolver el
documento exactamente como llegó (por ejemplo, para auditar lo que mandó otro
sistema) o cuando el orden de las claves importa para alguien.
Igualdad y orden
Como jsonb es un valor analizado, se puede comparar. Dos objetos son
iguales si tienen las mismas claves con valores iguales, sin importar el
orden en que se escribieron; dos arreglos, si tienen los mismos elementos en
el mismo orden; dos números, si valen lo mismo:
SELECT '{"a": 1, "b": [1, 2]}'::jsonb = '{"b": [1, 2], "a": 1}'::jsonb AS same_object,
       '[1, 2]'::jsonb = '[2, 1]'::jsonb AS same_array,
       '1.50'::jsonb = '1.5'::jsonb AS same_number;
same_object | same_array | same_number
-------------+------------+-------------
t | f | t
(1 row)json, en cambio, no tiene operador de igualdad: '{"a": 1}'::json = '{"a": 1}'::json da ERROR: operator does not exist: json = json. Tampoco
se puede usar en un GROUP BY, en un DISTINCT ni en un UNIQUE,
por la misma razón: dos textos distintos pueden ser el mismo documento, y el
motor no tiene cómo saberlo sin analizarlos.
Validación al guardar
Los dos tipos rechazan un texto que no es JSON. Un error típico es escribir las claves sin comillas, como en un objeto de JavaScript:
ERROR:  invalid input syntax for type json
LINE 1: SELECT '{fragile: true}'::jsonb
               ^
DETAIL:  Token "fragile" is invalid.
CONTEXT:  JSON data, line 1: {fragile...
Es la única garantía que da el tipo por sí solo: que el valor es JSON
sintácticamente válido. Que tenga ciertas claves, o que fragile sea un
booleano, ya no lo garantiza nadie, salvo que lo declaremos con una
restricción (lo vemos al final).
Los tipos de un valor JSON
jsonb_typeof dice cuál de los seis tipos de JSON tiene un valor:
jsonb_typeof('[1, 2]') es 'array', jsonb_typeof('3.5') es 'number',
jsonb_typeof('null') es 'null' (consulta jsonb_typeof de
examples.sql, con los seis). Para PostgreSQL, todos esos valores son del mismo tipo SQL, jsonb. El tipo
JSON de adentro es un dato más, que se consulta en tiempo de ejecución. Esa
es la diferencia de fondo con una columna: el tipo de weight_kg lo sabe el
motor antes de leer una sola fila; el de details -> 'weight_declared', solo
mirando cada documento.
En PostgreSQL. El estándar SQL incorporó JSON en SQL:2016 con un conjunto de funciones (
JSON_VALUE,JSON_QUERY,JSON_EXISTS,JSON_TABLE,JSON_OBJECT,JSON_ARRAYAGG, …) y un lenguaje de caminos, el SQL/JSON path; un tipo de datosJSONllegó recién en SQL:2023. PostgreSQL tienejsondesde la versión 9.2 yjsonbdesde la 9.4, mucho antes que el estándar, y por eso sus operadores más usados (->,->>,#>,@>,?) son propios de PostgreSQL. El lenguaje de caminos está desde la versión 12 y las funciones del estándar comoJSON_VALUEyJSON_TABLE, desde la 17. En este capítulo marcamos qué es de cada lado.
El ejemplo de la semana: details en shipment
El dataset del curso no tiene una columna JSON. Para los ejemplos, el
Makefile de esta semana carga Chasqui en chasqui_w08 y después corre
json-setup.sql, que hace tres cosas:
- Agrega a
shipmentla columna hipotéticadetails jsonby la llena con características que se deducen del número de envío, para que todos obtengan los mismos resultados. - Crea la vista
shipment_tracking, que arma el documento de seguimiento de cada envío a partir de las tablas. - Copia esos 12 000 documentos en la tabla
tracking_export(export_id, doc jsonb), como si otro sistema los hubiera recibido y guardado tal cual.
La columna se agrega con un ALTER TABLE común:
ALTER TABLE shipment ADD COLUMN details jsonb;Cuatro envíos de muestra:
SELECT shipment_id, details
FROM shipment
WHERE shipment_id IN (1, 2, 5, 12)
ORDER BY shipment_id;
shipment_id | details
-------------+-------------------------------------------------------------------------------------------------------------------------------
1 | {"instructions": "llamar antes de entregar"}
2 | ∅
5 | {"tags": ["alimentos", "perecible"], "instructions": null, "weight_declared": 11}
12 | {"fragile": true, "insurance": {"policy": "POL-12", "insurer": "Seguros Inti"}, "dimensions_cm": {"h": 22, "l": 32, "w": 27}}
(4 rows)(Como en los capítulos anteriores, ∅ es el NULL de SQL: los archivos
.sql de la semana empiezan con \pset null '∅'.) El envío 2 no tiene
details: la columna es NULL. El envío 5 tiene una clave instructions
con el valor JSON null. Para saber qué claves aparecen y cuántas veces,
jsonb_object_keys devuelve las claves de cada documento como filas (se
explica en la sección De JSON a filas):
SELECT k AS key, count(*) AS shipments
FROM shipment, jsonb_object_keys(details) AS k
GROUP BY k
ORDER BY shipments DESC, key;
key | shipments
-----------------+-----------
tags | 6000
fragile | 4000
insurance | 3571
dimensions_cm | 3000
instructions | 3000
weight_declared | 2400
(6 rows)| Clave | Tipo JSON | Significado |
|---|---|---|
fragile |
boolean | el cliente marcó el paquete como frágil (true) o como no frágil (false); si la clave no está, no dijo nada |
dimensions_cm |
objeto {l, w, h} |
largo, ancho y alto en centímetros |
tags |
arreglo de strings | etiquetas libres: electrónica, regalo, perecible, … |
insurance |
objeto {insurer, policy} |
el seguro contratado, para envíos con valor declarado de S/ 1500 o más |
weight_declared |
number | el peso que dijo el cliente en el mostrador, en kilos enteros |
instructions |
string o null |
indicaciones para el repartidor; null si el formulario mandó el campo vacío |
Navegar un documento: ->, ->>, #> y #>>
Un nivel
Dos operadores sacan un valor de un objeto por su clave:
details -> 'clave'devuelve el valor comojsonb.details ->> 'clave'devuelve el valor comotext.
La diferencia es el tipo del resultado (pg_typeof lo confirma: consulta
arrow_types), y de ella dependen todas las operaciones que vienen después.
Con -> se puede seguir navegando, porque el resultado es otra vez jsonb.
Con ->> se llega al final del camino: el texto ya no es JSON. La regla
práctica es usar -> en los pasos intermedios y ->> en el último, cuando
se quiere comparar el valor con un texto o convertirlo a otro tipo.
Un camino
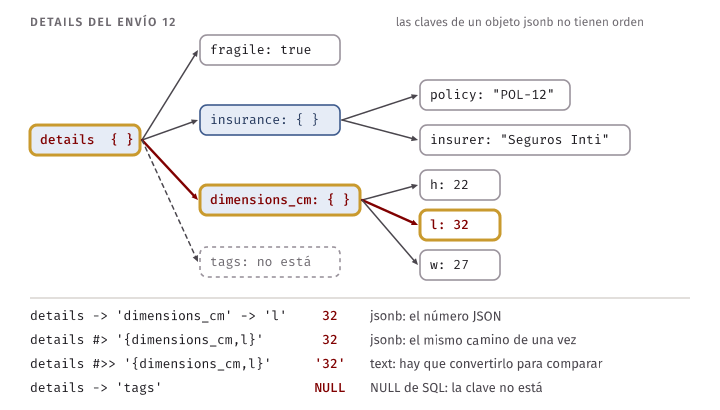
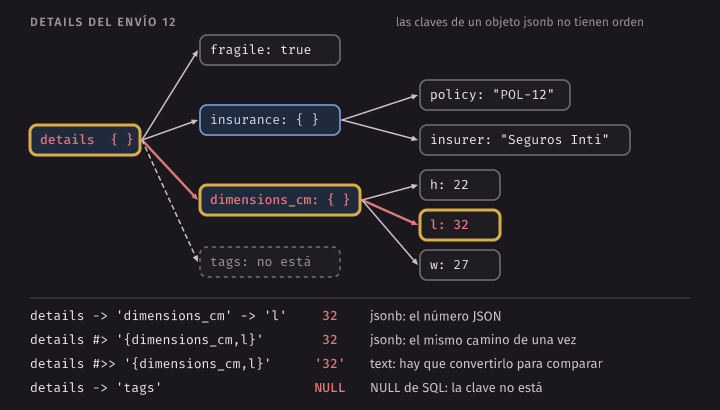
Para bajar varios niveles hay dos formas: encadenar ->, o dar el camino
completo como un arreglo de texto con #> (devuelve jsonb) o #>>
(devuelve text):
SELECT details -> 'dimensions_cm'          AS dims,
       details -> 'dimensions_cm' -> 'l'   AS l_jsonb,
       details #> '{dimensions_cm,l}'      AS l_path,
       details #>> '{dimensions_cm,l}'     AS l_text,
       details ->> 'fragile'               AS fragile_text,
       details -> 'tags'                   AS tags
FROM shipment
WHERE shipment_id = 12;
dims | l_jsonb | l_path | l_text | fragile_text | tags
-----------------------------+---------+--------+--------+--------------+------
{"h": 22, "l": 32, "w": 27} | 32 | 32 | 32 | true | ∅
(1 row)l_jsonb, l_path y l_text se ven igual en psql, pero los dos primeros
son el número JSON 32 (de tipo jsonb) y el tercero es el texto '32'. El
envío 12 no tiene tags: pedir una clave que no está devuelve el NULL de
SQL, sin error. '{dimensions_cm,l}' es la sintaxis de un arreglo de
PostgreSQL (text[]), no JSON.
Arreglos
Con un número entero en lugar de un texto, -> y ->> sacan un elemento de
un arreglo. Los índices empiezan en 0, y un índice negativo cuenta desde
el final:
SELECT details -> 'tags' -> 0  AS first_tag,
       details -> 'tags' ->> 1 AS second_tag,
       details -> 'tags' -> -1 AS last_tag,
       details -> 'tags' -> 5  AS no_tag
FROM shipment
WHERE shipment_id = 5;
first_tag | second_tag | last_tag | no_tag
-------------+------------+-------------+--------
"alimentos" | perecible | "perecible" | ∅
(1 row)Las comillas delatan el tipo: "alimentos" es un string JSON (jsonb);
perecible, sin comillas, es text. Un índice fuera del arreglo devuelve
NULL, igual que una clave que no está.
Error común. Contar desde 1, como en los arreglos de PostgreSQL (
text[]), que empiezan en 1.details -> 'tags' -> 1es el segundo elemento. Dos convenciones en el mismo motor: los arreglos de SQL cuentan desde 1 y los de JSON desde 0, como en JavaScript.
null de JSON y NULL de SQL
Con -> y ->> aparecen tres situaciones distintas: la columna entera es
NULL, el documento no tiene la clave, o la clave está y su valor es el
null de JSON. Los envíos 1, 2, 4 y 5 cubren los cuatro casos para la clave
instructions:
SELECT shipment_id,
       details -> 'instructions'            AS arrow,
       details ->> 'instructions'           AS double_arrow,
       (details -> 'instructions') IS NULL  AS arrow_is_null,
       details ? 'instructions'             AS has_key
FROM shipment
WHERE shipment_id IN (1, 2, 4, 5)
ORDER BY shipment_id;
shipment_id | arrow | double_arrow | arrow_is_null | has_key
-------------+----------------------------+--------------------------+---------------+---------
1 | "llamar antes de entregar" | llamar antes de entregar | f | t
2 | ∅ | ∅ | t | ∅
4 | ∅ | ∅ | t | f
5 | null | ∅ | f | t
(4 rows)Fila por fila:
- 1: la clave está, con un string.
->da el string JSON (con comillas),->>el texto. - 2:
detailsesNULL. Todo operador aplicado aNULLdaNULL, incluido?(que pregunta si la clave existe): el resultado no esfalsesino unknown, como cualquier comparación conNULL(semana 3). - 4: hay documento, pero sin la clave.
->daNULLde SQL;?dafalse. - 5: la clave está y vale
nullde JSON.->devuelve el valor JSONnull, que no esNULLde SQL (IS NULLdaf).->>, en cambio, convierte elnullde JSON enNULLde SQL, y ahí ya no se distingue de los casos 2 y 4.
Idea clave. Para preguntar si una clave existe, se usa
?. Para preguntar si tiene un valor útil,->> ... IS NOT NULL, que descarta a la vez la columnaNULL, la clave ausente y elnullde JSON. Para distinguir elnullde JSON,jsonb_typeof(details -> 'clave') = 'null'.
Comparar valores: el error del texto
weight_declared es el peso, en kilos enteros, que el cliente dijo en el
mostrador. ¿Cuántos envíos declararon más de 9 kilos? La consulta que sale
primero:
SELECT count(*) AS heavy
FROM shipment
WHERE details ->> 'weight_declared' > '9';
heavy
-------
78
(1 row)Y la correcta:
SELECT count(*) AS heavy
FROM shipment
WHERE (details ->> 'weight_declared')::numeric > 9;
heavy
-------
1595
(1 row)La primera compara textos: ->> devuelve text, y '9' es un texto. Los
textos se comparan carácter por carácter, como en un diccionario, así que
'10' > '9' es falso (porque '1' va antes que '9') y '95' > '9' es
verdadero (empiezan igual y '95' es más largo). Los 78 envíos que contó son
los que declararon entre 90 y 99 kilos; los otros 1517 que pesan más de 9
quedaron fuera, sin ningún error. La comparación en sí:
SELECT '10' > '9' AS text_cmp, 10 > 9 AS num_cmp,
       '10'::jsonb > '9'::jsonb AS jsonb_cmp;
text_cmp | num_cmp | jsonb_cmp
----------+---------+-----------
f | t | t
(1 row)La tercera columna muestra que el problema es del texto, no de JSON: dos
números jsonb se comparan como números, y
WHERE details -> 'weight_declared' > '9' (con una sola flecha) también
cuenta 1595. Aun así, conviene convertir con ::numeric o ::integer: la
comparación entre valores jsonb de tipos JSON distintos (un número contra
un string, por ejemplo) sigue un orden fijo entre tipos que casi nunca es lo
que se quiere, y la conversión explícita deja claro en la consulta qué se
está comparando.
Error común. Comparar con
<,>oBETWEENel resultado de->>contra un número escrito entre comillas. La consulta corre y devuelve algo razonable; con suerte, alguien nota que faltan filas. Todo valor que sale de->>y se compara como número o como fecha se convierte antes:(details ->> 'weight_declared')::numeric,(doc ->> 'at')::timestamptz.
La misma conversión sirve con un camino. Los paquetes de más de 50 cm de largo:
SELECT count(*) AS long_packages
FROM shipment
WHERE (details #>> '{dimensions_cm,l}')::integer > 50;
Son 1474.
Convertir con ::
Una conversión que no se puede hacer es un error, no un NULL. Si un
documento trae "l": "cuarenta", la consulta entera falla:
SELECT ('{"l": "cuarenta"}'::jsonb ->> 'l')::integer;ERROR: invalid input syntax for type integer: "cuarenta"Es el costo del esquema flexible: con una columna integer, ese valor nunca
habría entrado; con jsonb, entra, y el error aparece meses después, en la
consulta de otra persona. Por eso más abajo agregamos restricciones CHECK
sobre los tipos de las claves importantes.
Tampoco se puede comparar el texto con un booleano directamente:
details ->> 'fragile' = true da ERROR: operator does not exist: text = boolean. Las dos formas correctas son details ->> 'fragile' = 'true'
(texto con texto) y (details -> 'fragile')::boolean (un jsonb booleano
se puede convertir a boolean).
Contención y existencia: @> y ?
@>: un documento dentro de otro
El operador de contención a @> b (“a contiene a b”) es verdadero si
todo lo que dice b también lo dice a. Los envíos marcados como frágiles:
SELECT count(*) AS fragile
FROM shipment
WHERE details @> '{"fragile": true}';
fragile
---------
2000
(1 row)La definición es recursiva, sobre la estructura de los dos documentos:
- Un objeto contiene a otro si cada clave del segundo está en el primero y su valor en el primero contiene a su valor en el segundo. Las claves de más en el primero no importan.
- Un arreglo contiene a otro si cada elemento del segundo está contenido en algún elemento del primero. El orden y las repeticiones no importan.
- Un escalar (string, número, booleano,
null) contiene solo a un valor igual.
Algunos casos:
SELECT '{"tags": ["ropa", "regalo"], "fragile": true}'::jsonb @> '{"tags": ["regalo"]}' AS sub_array,
       '[1, 2, 3]'::jsonb @> '[3, 1, 1]'                         AS any_order,
       '{"dimensions_cm": {"l": 40, "w": 30}}'::jsonb @> '{"dimensions_cm": {"l": 40}}' AS nested,
       '{"dimensions_cm": {"l": 40, "w": 30}}'::jsonb @> '{"l": 40}' AS not_top_level,
       '{"fragile": true}'::jsonb @> '{}'                        AS empty;
sub_array | any_order | nested | not_top_level | empty
-----------+-----------+--------+---------------+-------
t | t | t | f | t
(1 row)not_top_level es falso porque la contención respeta la estructura: {"l": 40} pide una clave l en el primer nivel, y el primer documento la tiene
dentro de dimensions_cm. empty es verdadero porque el objeto vacío no
pide nada. El operador inverso, <@ (“está contenido en”), da lo mismo con
los lados cambiados.
En PostgreSQL. Hay una excepción a la regla de las estructuras: un arreglo contiene a un escalar si lo tiene como elemento, así que
'["a", "b"]'::jsonb @> '"a"'es verdadero. Es una comodidad para preguntar por un elemento de un arreglo del primer nivel.
?, ?| y ?&
El operador de existencia details ? 'clave' es verdadero si la clave
está en el primer nivel del objeto (con cualquier valor, incluso null).
?| pregunta si está alguna de varias claves y ?&, si están todas; las
claves van en un arreglo de texto:
SELECT count(*) FILTER (WHERE details ? 'insurance')                         AS insured,
       count(*) FILTER (WHERE details ?| ARRAY['insurance', 'fragile'])      AS insured_or_flag,
       count(*) FILTER (WHERE details ?& ARRAY['insurance', 'dimensions_cm']) AS insured_and_dims
FROM shipment;
insured | insured_or_flag | insured_and_dims
---------+-----------------+------------------
3571 | 6386 | 907
(1 row)Sobre un arreglo, ? pregunta si un string es uno de sus elementos:
details -> 'tags' ? 'perecible'.
¿@> o ->>?
Para “los envíos frágiles”, WHERE details @> '{"fragile": true}' y
WHERE details ->> 'fragile' = 'true' cuentan los mismos 2000. La diferencia está en lo que el motor puede hacer con
cada una. @> es un operador sobre el documento entero, y un índice GIN
sobre details lo puede responder sin leer la tabla (lo vemos más abajo).
->> primero saca un texto y después lo compara: para usar un índice haría
falta uno construido sobre esa expresión exacta. Como regla, para filtrar
por igualdad se prefiere @>; para comparar con < o >, o para mostrar
el valor, se usa ->> con su conversión.
Y una advertencia sobre lo que significa “no frágil”:
SELECT details ->> 'fragile' AS fragile, count(*) AS shipments
FROM shipment
GROUP BY details ->> 'fragile'
ORDER BY fragile;
fragile | shipments
---------+-----------
false | 2000
true | 2000
∅ | 8000
(3 rows)Hay tres grupos, no dos. NOT details @> '{"fragile": true}' no da los 2000
que dijeron false: da los que dijeron false más los que no tienen la clave
(salvo los que tienen details en NULL, para los que NOT de unknown sigue
siendo unknown). Es la lógica de tres valores de la semana 3, ahora con un
tercer valor que además se puede escribir de dos maneras.
De JSON a filas
Las consultas de arriba devuelven una fila por envío. Muchas preguntas
necesitan una fila por elemento de un documento: ¿cuántos envíos tienen
cada etiqueta? Para eso hay funciones que devuelven un conjunto de filas, y
se usan en el FROM como una tabla más, con un LATERAL (semana 3) que
les pasa el documento de cada fila.
jsonb_array_elements_text: una fila por elemento
SELECT tag, count(*) AS shipments
FROM shipment
  CROSS JOIN LATERAL jsonb_array_elements_text(details -> 'tags') AS t(tag)
GROUP BY tag
ORDER BY shipments DESC, tag;
tag | shipments
--------------+-----------
regalo | 2400
electrónica | 2352
alimentos | 1200
documentos | 1200
perecible | 1200
ropa | 1200
medicamentos | 48
urgente | 48
(8 rows)jsonb_array_elements_text devuelve cada elemento como text;
jsonb_array_elements, como jsonb. Un envío con dos etiquetas aporta dos
filas; uno sin tags (o con details en NULL) no aporta ninguna, porque
la función devuelve cero filas y el CROSS JOIN lo elimina. Si hiciera falta
conservarlo, se usa LEFT JOIN LATERAL ... ON true.
Esta consulta es, literalmente, la tabla shipment_tag(shipment_id, tag) que
el diseño de la semana 6 habría creado para el atributo multivaluado,
calculada en cada consulta a partir de los documentos.
jsonb_each y jsonb_object_keys: una fila por clave
jsonb_each devuelve un objeto como pares clave-valor (columnas key y
value); jsonb_object_keys, solo las claves, y ya la usamos para contar
las claves de details. En el FROM, una coma seguida de una función que
usa una columna de la tabla anterior es un LATERAL implícito: PostgreSQL lo
permite para funciones sin escribir la palabra.
jsonb_to_recordset: de un arreglo de objetos a una tabla
El arreglo events de un documento de seguimiento es, de hecho, una tabla
con columnas seq, at, agency y kind. jsonb_to_recordset la
reconstruye; las columnas y sus tipos se declaran en el alias:
SELECT ev.*
FROM tracking_export t,
     jsonb_to_recordset(t.doc -> 'events') AS ev(seq integer, at timestamptz, agency text, kind text)
WHERE (t.doc ->> 'shipment')::integer = 72
ORDER BY ev.seq;
seq | at | agency | kind
-----+------------------------+---------------------------+----------
1 | 2026-02-15 18:18:00-05 | Arequipa - Cerro Colorado | received
2 | 2026-02-16 12:00:00-05 | Arequipa - Cerro Colorado | departed
3 | 2026-02-17 06:30:00-05 | Lima - La Victoria | arrived
4 | 2026-02-17 19:30:00-05 | Lima - La Victoria | returned
(4 rows)El string "2026-02-15T18:18:00-05:00" del documento salió como un
timestamptz de verdad, porque así lo declaramos. Si un documento tuviera en
at algo que no es una fecha, la consulta fallaría, como cualquier
conversión. Así se pasa de los documentos que llegaron de otro sistema a
filas que se pueden juntar con las tablas, agrupar y validar.
SQL/JSON path
Un lenguaje de caminos
Los operadores -> y #> siguen un camino fijo. Para preguntas como “algún
elemento del arreglo events cuyo kind sea returned”, hace falta
recorrer y filtrar dentro del documento. Para eso existe el lenguaje de
caminos de SQL/JSON (SQL/JSON path), que es parte del estándar. Un camino
es un texto de tipo jsonpath, con estas piezas:
| Pieza | Significado | Ejemplo |
|---|---|---|
$ |
el documento entero | $ |
.clave |
el valor de una clave | $.dimensions_cm.l |
[n], [*] |
un elemento de un arreglo (desde 0), o todos | $.tags[0], $.events[*] |
? (condición) |
filtro: se queda con los valores que cumplen la condición | $.events[*] ? (@.kind == "returned") |
@ |
dentro de un filtro, el valor que se está probando | @.l > 50 |
$nombre |
una variable, que se pasa aparte | @.l > $min |
Los operadores de comparación dentro de un camino son los de JavaScript
(==, !=, <, >=, …), y los strings van con comillas dobles, porque
el camino entero va entre comillas simples de SQL.
Funciones y operadores
jsonb_path_query(details, '$.tags[*]') devuelve una fila por cada valor
que encuentra el camino: dos para el envío 5 ("alimentos" y "perecible").
Para filtrar filas importan las versiones que devuelven un booleano. Los
paquetes de más de 50 cm de largo, escrito de cuatro maneras:
-- una función
SELECT count(*) AS long_packages FROM shipment
WHERE jsonb_path_exists(details, '$.dimensions_cm ? (@.l > 50)');

-- el operador @? ("¿el camino encuentra algo?")
SELECT count(*) AS long_packages FROM shipment
WHERE details @? '$.dimensions_cm ? (@.l > 50)';

-- el operador @@ ("¿el predicado es verdadero?")
SELECT count(*) AS long_packages FROM shipment
WHERE details @@ '$.dimensions_cm.l > 50';

-- con una variable
SELECT count(*) AS long_packages FROM shipment
WHERE jsonb_path_exists(details, '$.dimensions_cm ? (@.l > $min)', '{"min": 50}');
Las cuatro devuelven 1474, lo mismo que la versión con #>> y ::integer.
Dentro del camino, @.l > 50 compara números de JSON: no hay conversión
que olvidar. El tercer argumento de jsonb_path_exists es un objeto jsonb
con las variables; es la forma de pasarle un valor desde la aplicación sin
armar el texto del camino.
Con un filtro sobre un arreglo de objetos, el lenguaje muestra lo que vale. Los envíos devueltos, y la agencia donde se devolvieron, buscando en los documentos exportados:
SELECT doc ->> 'shipment' AS shipment,
       jsonb_path_query_first(doc, '$.events[*] ? (@.kind == "returned").agency') AS returned_at
FROM tracking_export
WHERE doc @? '$.events[*] ? (@.kind == "returned")'
ORDER BY (doc ->> 'shipment')::integer
LIMIT 5;
shipment | returned_at
----------+----------------------
63 | "Lima - Ate"
72 | "Lima - La Victoria"
134 | "Juliaca - Centro"
144 | "Huánuco - Centro"
146 | "Lima - La Victoria"
(5 rows)El camino se lee de izquierda a derecha: todos los eventos, se queda con los
de kind igual a "returned", y de esos saca agency.
jsonb_path_query_first devuelve el primer valor encontrado (o NULL). Sin
el LIMIT son 319 documentos, los mismos 319 envíos con estado returned.
lax y strict
Un camino se evalúa en uno de dos modos. Por defecto es lax
(tolerante): si una clave no está, el camino simplemente no encuentra nada,
y si se aplica [*] a algo que no es un arreglo, lo trata como un arreglo de
un elemento. En modo strict, esas situaciones son errores:
SELECT jsonb_path_query_array('{"tags": "ropa"}', 'lax $.tags[*]') AS lax_array,
       jsonb_path_query_array('{"a": 1}', 'lax $.tags')            AS lax_missing,
       jsonb_path_exists('{"a": 1}', 'strict $.tags', silent => true) AS strict_silent;
lax_array | lax_missing | strict_silent
-----------+-------------+---------------
["ropa"] | [] | ∅
(1 row)SELECT jsonb_path_query('{"a": 1}', 'strict $.tags');ERROR: JSON object does not contain key "tags"Con silent => true, el error se convierte en NULL (unknown). El modo
lax es cómodo para datos semiestructurados, donde una clave que falta es lo
normal; strict sirve para validar que un documento tiene la forma que se
espera.
Las funciones del estándar
SQL:2016 define funciones con nombres propios, que PostgreSQL tiene desde la
versión 17 y que se escriben igual en otros motores que siguen el estándar.
JSON_VALUE saca un escalar y lo convierte al tipo que se pida;
JSON_QUERY saca un objeto o un arreglo; JSON_EXISTS pregunta si el camino
encuentra algo:
SELECT JSON_VALUE(details, '$.weight_declared' RETURNING integer) AS weight,
       JSON_QUERY(details, '$.tags')                               AS tags,
       JSON_EXISTS(details, '$.insurance')                         AS insured
FROM shipment
WHERE shipment_id = 5;
weight | tags | insured
--------+----------------------------+---------
11 | ["alimentos", "perecible"] | f
(1 row)JSON_VALUE ... RETURNING integer es la versión del estándar de
(details ->> 'weight_declared')::integer. Y JSON_TABLE hace lo que
hicimos con jsonb_to_recordset, pero con caminos para cada columna:
SELECT jt.*
FROM tracking_export t,
     JSON_TABLE(t.doc, '$.events[*]'
       COLUMNS (seq integer PATH '$.seq',
                agency text PATH '$.agency',
                kind text PATH '$.kind')) AS jt
WHERE (t.doc ->> 'shipment')::integer = 72
ORDER BY jt.seq;
Devuelve las mismas cuatro filas que jsonb_to_recordset, sin la columna
at. En el curso usamos sobre todo los operadores de PostgreSQL (->, ->>,
@>), que son los que más van a encontrar en código existente, y los caminos
cuando hace falta filtrar dentro de un arreglo.
De filas a JSON
La otra dirección es igual de importante: armar un documento JSON a partir de tablas normalizadas. Es lo que hace una API cuando responde: la base de datos guarda las tablas, y la respuesta es un documento.
row_to_json y to_jsonb
La forma más directa convierte una fila completa en un objeto, con una clave por columna:
SELECT row_to_json(a) AS as_json, to_jsonb(a) AS as_jsonb
FROM agency a
WHERE agency_id = 13;
as_json | as_jsonb
--------------------------------------------------------------------+---------------------------------------------------------------------------
{"agency_id":13,"name":"Ica - Centro","city":"Ica","region":"Ica"} | {"city": "Ica", "name": "Ica - Centro", "region": "Ica", "agency_id": 13}
(1 row)a es aquí el alias de la tabla usado como valor: la fila entera. Los tipos
se traducen solos: integer y numeric a número, text a string, boolean
a booleano, NULL a null, y timestamptz a un string ISO 8601.
jsonb_build_object
Para elegir las claves y los valores se usa jsonb_build_object, que recibe
pares clave, valor. Su versión json_build_object conserva el orden de los
pares tal como se escribieron; la versión jsonb, como siempre, no:
SELECT json_build_object('name', name, 'city', city, 'agency_id', agency_id)  AS j,
       jsonb_build_object('name', name, 'city', city, 'agency_id', agency_id) AS jb
FROM agency
WHERE agency_id = 13;
j | jb
-------------------------------------------------------------+----------------------------------------------------------
{"name" : "Ica - Centro", "city" : "Ica", "agency_id" : 13} | {"city": "Ica", "name": "Ica - Centro", "agency_id": 13}
(1 row)jsonb_build_array arma un arreglo de la misma forma.
Agregar: jsonb_agg y jsonb_object_agg
jsonb_agg es una función de agregación (semana 3) que junta los valores de
un grupo en un arreglo; acepta un ORDER BY dentro de los paréntesis para
fijar el orden de los elementos. jsonb_object_agg(clave, valor) junta los
pares de un grupo en un objeto:
SELECT jsonb_object_agg(status, n) AS by_status
FROM (SELECT status, count(*) AS n FROM shipment GROUP BY status) AS t;
by_status
----------------------------------------------------------------------------
{"returned": 319, "delivered": 11115, "in_transit": 66, "registered": 500}
(1 row)El seguimiento de un envío en un solo documento
Con las tres piezas se arma el documento de seguimiento. jsonb_agg junta
los eventos de un envío, ordenados por seq, y jsonb_build_object los pone
con el estado:
SELECT jsonb_build_object(
         'shipment', s.shipment_id,
         'status', s.status,
         'events', jsonb_agg(jsonb_build_object('at', e.at, 'kind', e.kind) ORDER BY e.seq))
       AS doc
FROM shipment s
  JOIN shipment_event e ON e.shipment_id = s.shipment_id
WHERE s.shipment_id = 72
GROUP BY s.shipment_id, s.status;
{"events": [{"at": "2026-02-15T18:18:00-05:00", "kind": "received"}, {"at": "2026-02-16T12:00:00-05:00", "kind": "departed"}, {"at": "2026-02-17T06:30:00-05:00", "kind": "arrived"}, {"at": "2026-02-17T19:30:00-05:00", "kind": "returned"}], "status": "returned", "shipment": 72}(Se omitió el encabezado de la columna; jsonb_pretty(...) lo muestra con
sangría.) La fecha salió en hora de Lima porque la base de datos del curso
tiene timezone en America/Lima: la conversión a JSON usa la zona horaria
de la sesión. Es la consulta del ejemplo de la guía de la semana, para un
envío.
La vista shipment_tracking de json-setup.sql
arma el documento completo de cada envío, el del principio del capítulo, con
las agencias de origen y de destino por nombre (dos joins con agency) y los
eventos con su agencia. En lugar de un GROUP BY, arma los eventos con una
subconsulta escalar por envío, que es más fácil de leer cuando hay varios
joins:
'events', (SELECT coalesce(jsonb_agg(jsonb_build_object(
                             'seq', e.seq, 'at', e.at,
                             'agency', a.name, 'kind', e.kind) ORDER BY e.seq), '[]')
           FROM shipment_event e
             JOIN agency a ON a.agency_id = e.agency_id
           WHERE e.shipment_id = s.shipment_id)
La aplicación pide SELECT doc FROM shipment_tracking WHERE shipment_id = $1
y recibe un documento listo para mandar. Los datos siguen guardados una sola
vez, en tablas normalizadas; el documento se calcula cada vez. Por eso la
vista no tiene el problema de la redundancia: si una agencia cambia de
nombre, el próximo documento sale con el nombre nuevo. La tabla
tracking_export, en cambio, es una copia: guarda los documentos de un
momento, y no se entera de los cambios.
jsonb_agg sobre cero filas y sobre un LEFT JOIN
¿Por qué el coalesce(..., '[]') en la vista? Porque jsonb_agg, como
sum y avg, devuelve NULL sobre cero filas, no un arreglo vacío. Y con un
LEFT JOIN el problema cambia de forma. Las rutas que salen de cada agencia,
como arreglo, para Tumbes (una ruta) e Iquitos (ninguna):
SELECT a.name, jsonb_agg(d.name ORDER BY d.name) AS destinations
FROM agency a
  LEFT JOIN route r ON r.origin_agency_id = a.agency_id
  LEFT JOIN agency d ON d.agency_id = r.dest_agency_id
WHERE a.agency_id IN (10, 29)
GROUP BY a.agency_id, a.name
ORDER BY a.name;
name | destinations
------------------+----------------------
Iquitos - Centro | [null]
Tumbes - Centro | ["Piura - Castilla"]
(2 rows)Iquitos no tiene rutas, pero el LEFT JOIN le dejó una fila completada con
NULL, y jsonb_agg —a diferencia de count(columna)— no ignora los
NULL: los agrega como null de JSON. El resultado es un arreglo con un
elemento, [null], que una aplicación va a recorrer como si hubiera un
destino. La corrección filtra los NULL con FILTER (semana 3), y entonces
el grupo de Iquitos queda sin valores y jsonb_agg da NULL; el coalesce
lo cambia por el arreglo vacío:
SELECT a.name,
       coalesce(jsonb_agg(d.name ORDER BY d.name) FILTER (WHERE d.agency_id IS NOT NULL), '[]')
         AS destinations
-- ... el mismo FROM, WHERE, GROUP BY y ORDER BY
name | destinations
------------------+----------------------
Iquitos - Centro | []
Tumbes - Centro | ["Piura - Castilla"]
(2 rows)Error común. Armar una lista con
jsonb_aggsobre unLEFT JOINy recibir[null]para los que no tienen nada. Es el mismo error quecount(*)en lugar decount(columna)con un join externo: la fila deNULLque agrega elLEFT JOINse cuenta como un elemento. Se arregla conFILTER (WHERE ... IS NOT NULL)ycoalesce(..., '[]').
Modificar documentos
||, -, #- y jsonb_set
Un documento jsonb no se modifica “por dentro”: se calcula uno nuevo y se
asigna con UPDATE. Los operadores que lo calculan:
| Expresión | Resultado |
|---|---|
details || '{"fragile": false}' |
une dos objetos; si una clave está en los dos, gana la de la derecha |
details - 'insurance' |
quita una clave del primer nivel |
details #- '{dimensions_cm,h}' |
quita lo que está en un camino |
jsonb_set(details, '{dimensions_cm,l}', '45') |
reemplaza (o agrega) el valor en un camino |
Sobre el envío 12 (examples.sql, consulta
modify_ops), cada uno devuelve el documento completo con un solo cambio:
fragile en false, sin insurance, sin h, o con "l": 45. Para guardar
el cambio, se usa en un UPDATE, como
SET details = jsonb_set(details, '{dimensions_cm,l}', '45')
(modify.sql, que corre todo dentro de una
transacción que termina en ROLLBACK).
El UPDATE reescribe el documento completo, aunque cambie un número. Para
documentos chicos no importa; para documentos de cientos de kilobytes que se
cambian a cada rato, es una razón para no guardarlos como un solo valor.
|| con NULL
Marcar el envío 2 como frágil parece fácil:
UPDATE shipment
SET details = details || '{"fragile": true}'
WHERE shipment_id = 2
RETURNING shipment_id, details;
shipment_id | details
-------------+---------
2 | ∅
(1 row)El UPDATE “funcionó” (una fila), pero details sigue en NULL. El envío 2
no tenía details, y NULL || cualquier cosa es NULL, como toda operación
con NULL (semana 3). La corrección es partir de un objeto vacío:
UPDATE shipment
SET details = coalesce(details, '{}') || '{"fragile": true}'
WHERE shipment_id = 2
RETURNING shipment_id, details;
shipment_id | details
-------------+-------------------
2 | {"fragile": true}
(1 row)JSON desde Node.js
pg entrega objetos
En la semana 5 vimos qué tipo de JavaScript recibe pg para cada tipo de
PostgreSQL. Para json y jsonb, la respuesta es la más cómoda: pg
analiza el texto y entrega un objeto (o un arreglo, un número, …) de
JavaScript. La aplicación no llama a JSON.parse.
tracking.mjs lee el documento de
seguimiento de un envío:
export async function trackingDoc(db, shipmentId) {
  const { rows } = await db.query(
    'SELECT doc FROM shipment_tracking WHERE shipment_id = $1',
    [shipmentId],
  );
  return rows.length === 0 ? null : rows[0].doc;
}
node tracking.mjs 72 imprime con JSON.stringify(doc, null, 2) el mismo
documento del envío 72 que vimos al principio del capítulo; doc.events[3].kind
es 'returned', sin ningún paso intermedio.
Los tipos dentro de un documento
Dentro de un documento, los tipos son los de JSON, no los de PostgreSQL, y
eso cambia lo que llega a JavaScript. Las pruebas de
app.test.mjs lo comprueban:
| Valor | Como columna | Dentro de un jsonb |
|---|---|---|
un numeric como 72.43 |
string ('72.43') |
number (72.43) |
un timestamptz |
Date |
string ('2026-02-15T18:18:00-05:00') |
un integer |
number |
number |
Dos consecuencias. Las fechas que salen de un documento hay que convertirlas
con new Date(...) si se quieren comparar. Y los números de un documento
pasan por el number de JavaScript, que tiene 53 bits de precisión: un
número jsonb como 12345678901234567890, que PostgreSQL guarda exacto,
llega a JavaScript como 12345678901234567000. Para montos, eso casi nunca
importa; para identificadores enormes, sí, y por eso muchas APIs los mandan
como strings.
Mandar JSON como parámetro
Para filtrar con @> desde la aplicación, el patrón va como parámetro.
pg convierte un objeto de JavaScript en su texto JSON, pero convierte un
arreglo de JavaScript en un arreglo de PostgreSQL ({"ropa","regalo"}),
que no es JSON:
Parámetro de pool.query('SELECT $1::jsonb AS j', [...]) |
Resultado |
|---|---|
{ tags: ['ropa'] } (un objeto) |
el objeto { tags: ['ropa'] } |
['ropa', 'regalo'] (un arreglo) |
error 22P02, invalid input syntax for type json |
JSON.stringify(['ropa', 'regalo']) |
el arreglo ['ropa', 'regalo'] |
(Los tres casos son una prueba de app.test.mjs.)
La regla segura es mandar siempre JSON.stringify(valor) y convertir en el
servidor con ::jsonb, como hace shipmentsMatching en tracking.mjs:
export async function shipmentsMatching(db, pattern) {
  const { rows } = await db.query(
    `SELECT shipment_id FROM shipment
     WHERE details @> $1::jsonb
     ORDER BY shipment_id`,
    [JSON.stringify(pattern)],
  );
  return rows.map((r) => r.shipment_id);
}
shipmentsMatching(pool, { tags: ['medicamentos'] }) devuelve los 48 envíos
con esa etiqueta. El documento sigue siendo un valor del parámetro $1:
lo que haya adentro nunca se interpreta como SQL, igual que en la semana 5.
Índices sobre jsonb (adelanto)
Los índices se estudian en la parte 3 del curso (semana 10 en adelante). Por
ahora basta una idea: un índice es una estructura aparte que permite
encontrar las filas que cumplen una condición sin leer la tabla entera.
EXPLAIN (semana 12) muestra qué plan eligió el motor. Todo lo de esta
sección está en indexes.sql, dentro de una
transacción que termina en ROLLBACK.
Sin índice
Sin índices sobre details, buscar los 48 envíos con la etiqueta
medicamentos obliga a leer los 12 000:
EXPLAIN (COSTS OFF)
SELECT count(*) FROM shipment WHERE details @> '{"tags": ["medicamentos"]}';
QUERY PLAN
------------------------------------------------------------------
Aggregate
-> Seq Scan on shipment
Filter: (details @> '{"tags": ["medicamentos"]}'::jsonb)
(3 rows)Seq Scan es un recorrido secuencial: cada fila, una por una, se prueba con
el filtro.
GIN: un índice invertido
Un índice B-tree, el de siempre, ordena valores completos y sirve para =,
< y >. Para un documento, eso sirve de poco: nadie busca “el documento
igual a este”. Lo que se busca es “los documentos que contienen esta
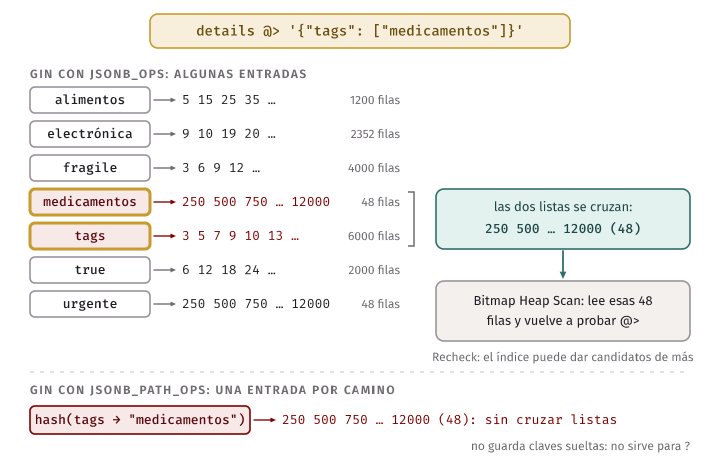
clave, o este valor”. Para eso PostgreSQL tiene el índice GIN
(Generalized Inverted Index), un índice invertido: como el índice
alfabético al final de un libro, guarda cada elemento que aparece (cada
clave, cada valor) con la lista de filas donde aparece. Para responder @>,
busca los elementos del patrón y cruza sus listas.
CREATE INDEX shipment_details_gin ON shipment USING gin (details); QUERY PLAN
----------------------------------------------------------------------------
Aggregate
-> Bitmap Heap Scan on shipment
Recheck Cond: (details @> '{"tags": ["medicamentos"]}'::jsonb)
-> Bitmap Index Scan on shipment_details_gin
Index Cond: (details @> '{"tags": ["medicamentos"]}'::jsonb)
(5 rows)El plan cambió: el Bitmap Index Scan busca en el índice qué filas pueden
cumplir la condición, y el Bitmap Heap Scan lee solo esas filas de la
tabla. El Recheck Cond vuelve a probar la condición sobre cada fila leída,
porque el índice puede devolver candidatos de más. Con la clase de
operadores por defecto (jsonb_ops), el índice también sirve para ?, ?|
y ?& (el plan de details ? 'insurance' es el mismo, con el mismo índice),
y para los operadores de caminos @? y @@. Pero no para ->>:
EXPLAIN (COSTS OFF)
SELECT count(*) FROM shipment WHERE details ->> 'fragile' = 'true';
QUERY PLAN
----------------------------------------------------------------
Aggregate
-> Seq Scan on shipment
Filter: ((details ->> 'fragile'::text) = 'true'::text)
(3 rows)El índice está construido sobre details y entiende operadores sobre
details. details ->> 'fragile' = 'true' es una comparación de dos textos,
y el primero se calcula fila por fila: el índice no tiene cómo responderla.
Es la razón práctica para preferir @> en los filtros por igualdad.
jsonb_path_ops
Hay una segunda clase de operadores para GIN, jsonb_path_ops, que en lugar
de guardar cada clave y cada valor por separado guarda un hash de cada
camino completo hasta un valor (tags → "medicamentos"). El índice queda
más chico y más rápido para @>:
CREATE INDEX shipment_details_path_ops ON shipment USING gin (details jsonb_path_ops);Los tamaños, con pg_relation_size en indexes.sql (cada uno medido
cuando su índice existe):
 gin_size
----------
 440 kB
(1 row)

 path_ops_size
---------------
 304 kB
(1 row)
La contrapartida: como no guarda las claves solas, no puede
responder ?. Con este índice, details ? 'insurance' vuelve al
Seq Scan. Se elige jsonb_path_ops cuando las consultas son casi todas
de contención.
Índices de expresión
Si siempre se filtra por la misma clave, otra opción es un índice B-tree sobre esa expresión. Un índice de expresión se construye sobre el resultado de una expresión, no sobre una columna, y sirve para las consultas que usan esa misma expresión:
CREATE INDEX shipment_insurer_idx ON shipment ((details #>> '{insurance,insurer}'));

EXPLAIN (COSTS OFF)
SELECT count(*) FROM shipment WHERE details #>> '{insurance,insurer}' = 'Seguros Andes';
QUERY PLAN
-------------------------------------------------------------------------------------------------
Aggregate
-> Bitmap Heap Scan on shipment
Recheck Cond: ((details #>> '{insurance,insurer}'::text[]) = 'Seguros Andes'::text)
-> Bitmap Index Scan on shipment_insurer_idx
Index Cond: ((details #>> '{insurance,insurer}'::text[]) = 'Seguros Andes'::text)
(5 rows)A diferencia del GIN, un B-tree sobre una expresión también sirve para <,
> y ORDER BY, si la expresión se convierte al tipo correcto (por ejemplo,
(((details ->> 'weight_declared')::integer))).
En PostgreSQL. Con 12 000 filas, el motor no siempre usa el índice. Para una condición que cumplen muchas filas, leer la tabla entera puede salir más barato que saltar del índice a la tabla, y el optimizador lo decide con estimaciones (semana 12). Además, las estadísticas que PostgreSQL guarda de una columna
jsonbson sobre los documentos enteros, no sobre cada clave, así que sus estimaciones para condiciones como@>son gruesas. Cómo funcionan por dentro un B+ tree y un índice invertido, y cómo se estima el costo de cada plan, es tema de la parte 3.
Cuándo usar jsonb y cuándo no
Lo que se pierde
Un compañero propone guardar dentro de details el remitente, el
destinatario y la agencia de destino, “para no hacer joins”. Vale la pena
hacer la lista de lo que la base de datos deja de garantizar:
-
Integridad referencial. No hay clave foránea dentro de un documento. En
modify.sql, esteUPDATEguarda una agencia que no existe, sin ningún error:UPDATE shipment SET details = details || '{"dest_agency_id": 999}' WHERE shipment_id = 12 RETURNING details ->> 'dest_agency_id' AS dest_agency_id, EXISTS (SELECT 1 FROM agency WHERE agency_id = 999) AS agency_exists;dest_agency_id | agency_exists ----------------+--------------- 999 | f (1 row)Con la columna
dest_agency_id integer NOT NULL REFERENCES agency, el motor lo habría rechazado. -
Tipos y
NOT NULL. Cada documento puede traer la clave con otro tipo, o sin la clave. Ya vimos lo que pasa: una conversión que falla en la consulta de otra persona. -
Las dependencias funcionales y las claves. Si el documento guarda el DNI y el nombre del destinatario, el nombre se repite en cada envío, y
dni → first_name, last_nameya no la hace cumplir ninguna clave. Es la planilla de la semana 7, metida en una columna: las mismas anomalías de actualización, inserción y borrado, sin las herramientas para evitarlas. -
Consultas y optimización. Lo que va en columnas se puede indexar con B-tree, tiene estadísticas y se junta con un join que el optimizador sabe planificar. Lo que va en un documento hay que sacarlo con operadores en cada consulta, y el optimizador estima a ciegas.
Lo que se puede recuperar: CHECK
Parte de eso se recupera con restricciones CHECK sobre el documento. En
modify.sql:
ALTER TABLE shipment
  ADD CONSTRAINT shipment_details_object_ck
  CHECK (details IS NULL OR jsonb_typeof(details) = 'object');

ALTER TABLE shipment
  ADD CONSTRAINT shipment_details_fragile_ck
  CHECK (NOT details ? 'fragile' OR jsonb_typeof(details -> 'fragile') = 'boolean');
La primera obliga a que details, si está, sea un objeto (y no un número o un
arreglo). La segunda, a que fragile, si está, sea un booleano. Un UPDATE
que intenta guardar "fragile": "sí" se rechaza:
ERROR:  new row for relation "shipment" violates check constraint "shipment_details_fragile_ck"
DETAIL:  Failing row contains (12, 407, 608, 9, 1, 5351, 8.50, 1528.00, 72.43, delivered, 2026-06-10 13:33:00-05, 2026-06-13 15:00:00-05, {"fragile": "sí", "insurance": {"policy": "POL-12", "insurer": ...).
Lo que un CHECK no puede hacer es mirar otras filas ni otras tablas: no hay
forma de declarar una clave foránea ni un UNIQUE sobre una clave de un
documento (un índice único sobre una expresión, sí). En cuanto una regla
necesita eso, el dato pide su propia columna.
Una guía para decidir
jsonb es razonable |
Mejor columnas o tablas |
|---|---|
| atributos opcionales, escasos y variables (las características del paquete) | atributos que tiene todo envío (peso, precio, estado) |
| datos que no participan en joins ni en restricciones | cualquier cosa que se referencie (clientes, agencias, viajes) |
| documentos que llegan de otro sistema y se guardan tal cual (la respuesta de una API, un formulario) | datos que la aplicación de Chasqui crea y cambia |
| se leen enteros y se filtran por pocas claves | se agregan, se suman, se ordenan por ellos |
| la estructura cambia más rápido que el esquema | la estructura es estable y conocida |
Un patrón frecuente combina las dos cosas: las columnas de siempre, con sus
tipos y claves foráneas, y una columna jsonb para lo opcional. Si una
clave del documento empieza a usarse en todas las consultas, se “promueve” a
columna con una migración. Y en la otra dirección, un documento JSON es muy
buena salida: la vista shipment_tracking guarda nada y responde con
documentos.
Error común. Usar
jsonbpara no diseñar. “Todavía no sabemos qué campos tiene un envío, guardemos todo endata jsonby después vemos.” El después no llega, y la base de datos termina con un esquema que existe igual, pero que está escrito en el código de la aplicación, sin que nadie lo verifique. El diseño E-R y la normalización no se saltan;jsonbes para lo que queda después de haberlos hecho.
Repaso de las partes 1 y 2
La Sesión B de esta semana es el examen parcial. Esta sección ordena lo visto
en las semanas 1 a 7 y resuelve tres problemas cortos sobre Chasqui. El
material para practicar con el formato del examen es el
parcial de práctica: resuélvanlo en papel,
con dos horas en el reloj, antes de comprobar en psql.
El examen
El examen es en la Sesión B y cubre las semanas 1 a 8 (ver el
sílabo). Los tipos de pregunta están
en exams/README.md: escribir consultas en SQL y en
álgebra relacional sobre un esquema que no es necesariamente el de Chasqui;
leer consultas y código Node.js con pg; diseño (E-R o normalización), y
preguntas cortas. Para estudiar: las Preguntas de repaso de las guías de
las semanas 1 a 8, el parcial de práctica, los ejercicios resueltos de los
autores del libro, capítulos 2 a 7
(db-book.com, Practice Exercises),
y los problemas de exámenes anteriores de Berkeley CS186 sobre diseño
(Note 13, Past Exam Problems
y Practice Questions).
Lo que entra
| Semana | Tema | Lo que se pide en el examen |
|---|---|---|
| 1 | El modelo relacional | relación, esquema, instancia; superclave, clave candidata, primaria y foránea; por qué una relación es un conjunto |
| 2 | Álgebra relacional y SQL básico | escribir y leer expresiones con σ, Π, ρ, ×, ⋈, ∪, −, ∩; pasar de álgebra a SQL; tipos y CREATE TABLE |
| 3 | Conjuntos, NULL, agregación, subconsultas |
lógica de tres valores; NOT IN con NULL; agregados sobre cero filas; GROUP BY y HAVING; EXISTS y la doble negación; γ y ÷ |
| 4 | Joins, vistas, restricciones | joins externos y dónde va cada condición; vistas; CHECK, UNIQUE, claves foráneas y ON DELETE |
| 5 | SQL desde un programa y SQL avanzado | leer código con pg; inyección SQL y consultas parametrizadas; transacciones con un mismo client; funciones, triggers, WITH RECURSIVE y window functions |
| 6 | Modelo E-R | de requisitos a diagrama: cardinalidades, participación, roles, entidades débiles; traducción a tablas |
| 7 | Normalización | dependencias funcionales, clausura, claves, cubierta canónica; descomposición sin pérdida y que preserva dependencias; BCNF y 3NF |
| 8 | JSON | solo leer consultas con ->, ->> y @> |
Problema 1: un LEFT JOIN con un filtro
Para cada agencia, cuántos envíos registró desde el 20 de junio, incluidas
las agencias que no registraron ninguno. Primero, la versión con el filtro
en el WHERE (review.sql):
SELECT a.name, count(s.shipment_id) AS shipments
FROM agency a
  LEFT JOIN shipment s ON s.origin_agency_id = a.agency_id
WHERE s.created_at >= '2026-06-20'
GROUP BY a.agency_id, a.name
ORDER BY shipments, a.name
LIMIT 3;
name | shipments
-----------------------+-----------
Huancavelica - Centro | 1
Pucallpa - Centro | 2
Abancay - Centro | 3
(3 rows)Sin el LIMIT, devuelve 28 filas, y Chasqui tiene 29 agencias. Falta
Iquitos, que no tiene rutas ni envíos. El LEFT JOIN le agregó una fila con
s.* en NULL, y el WHERE la descartó: NULL >= '2026-06-20' es unknown.
Un filtro sobre la tabla de la derecha en el WHERE convierte el LEFT JOIN
en un inner join. El filtro va en el ON:
  LEFT JOIN shipment s ON s.origin_agency_id = a.agency_id
                      AND s.created_at >= '2026-06-20'
-- sin WHERE; lo demás, igual
name | shipments
-----------------------+-----------
Iquitos - Centro | 0
Huancavelica - Centro | 1
Pucallpa - Centro | 2
(3 rows)Y count(s.shipment_id), no count(*): con count(*), Iquitos aparece con
1, porque se cuenta la fila de NULL.
Problema 2: refutar una dependencia funcional
¿Los datos contradicen la dependencia
origin_agency_id, dest_agency_id, weight_kg → price? Una dependencia X → Y se refuta encontrando dos filas iguales en X y distintas en Y; en SQL,
agrupando por X y buscando grupos con más de un valor de Y:
SELECT count(*) AS counterexamples
FROM (SELECT origin_agency_id, dest_agency_id, weight_kg
      FROM shipment
      GROUP BY origin_agency_id, dest_agency_id, weight_kg
      HAVING count(DISTINCT price) > 1) AS t;
counterexamples
-----------------
1083
(1 row)1083 combinaciones de ruta y peso tienen más de un precio: la dependencia es
falsa. (La tarifa de la semana 5 depende también del valor declarado.) Si se
agrega declared_value a la izquierda, la misma consulta devuelve 0. ¿Quiere
decir que origin_agency_id, dest_agency_id, weight_kg, declared_value → price se cumple? Solo que los datos de hoy no la contradicen. Que la
dependencia valga es una afirmación sobre el negocio (que la tarifa es una
función de esos cuatro datos), y se decide leyendo la regla de la tarifa, no
los datos. Es la diferencia entre refutar y demostrar de la semana 7.
Problema 3: avg y los NULL
¿Cuál es el valor declarado promedio de un envío?
SELECT count(*)                          AS shipments,
       count(declared_value)             AS declared,
       round(avg(declared_value), 2)     AS avg_declared,
       round(sum(declared_value) / count(*), 2) AS sum_over_all,
       round(avg(coalesce(declared_value, 0)), 2) AS avg_zero
FROM shipment;
shipments | declared | avg_declared | sum_over_all | avg_zero
-----------+----------+--------------+--------------+----------
12000 | 7136 | 1512.33 | 899.33 | 899.33
(1 row)avg ignora los NULL: es el promedio de los 7136 envíos que declararon un
valor. Dividir la suma entre todas las filas, o tratar el NULL como 0, da
otra respuesta, a otra pregunta: el valor promedio si “no declaró” fuera
“declaró cero”. Cuál es la correcta depende de qué significa el NULL, y eso
lo dice el negocio. Y sobre cero filas, por ejemplo los envíos que salieron
de Iquitos (WHERE origin_agency_id = 29), count da 0 y sum y avg dan
NULL; con un GROUP BY, la misma consulta devuelve cero filas.
Errores frecuentes
Una lista para repasar antes del examen. Cada punto se vio en su semana.
NOT INcon una subconsulta que puede devolverNULL: nunca es verdadero. UsenNOT EXISTS.- El filtro de la tabla de la derecha de un
LEFT JOINen elWHERE(problema 1), ycount(*)donde vacount(columna). = NULLen lugar deIS NULL; olvidar quesumyavgsobre cero filas sonNULL, y que conGROUP BYno hay fila.- Un natural join entre tablas que comparten un atributo que no es la clave
de unión (
name,city). - Filtrar por una window function en el mismo
WHERE: va en una CTE. - Concatenar texto del usuario en una consulta;
pool.query('BEGIN'); unclient.release()que no está en unfinally. - Poner los atributos de una relación muchos a muchos en una de las entidades (la nota de una matrícula en el alumno).
- Deducir una dependencia funcional de los datos, o decir que una tabla está en BCNF sin revisar cada dependencia.
El código de la semana y make test
Dentro del contenedor, en code/week-08, make crea la base de datos
chasqui_w08 y le carga json-setup.sql; make test la vuelve a crear y
corre las pruebas:
$ make test
chasqui-load chasqui_w08
Base de datos chasqui_w08 lista.
psql -X -q -v ON_ERROR_STOP=1 -d chasqui_w08 -f json-setup.sql
PGDATABASE=chasqui_w08 node --test --test-concurrency=1 --test-reporter=spec
✔ trackingDoc devuelve un objeto de JavaScript, no texto
✔ dentro de un jsonb, un número llega como number y una fecha como string
...
✔ avg ignora los NULL; sum y avg sobre cero filas son NULL; count es 0
ℹ tests 44
ℹ pass 44
ℹ fail 0
...| Archivo | Qué muestra |
|---|---|
json-setup.sql |
La columna details, la vista shipment_tracking y la tabla tracking_export |
examples.sql |
Los ejemplos del capítulo: json y jsonb, operadores, de JSON a filas, caminos, de filas a JSON |
modify.sql |
UPDATE de documentos, || con NULL, restricciones CHECK y la clave foránea que no existe |
indexes.sql |
Índices GIN (jsonb_ops y jsonb_path_ops) e índices de expresión, con sus planes |
review.sql |
Los tres problemas de repaso |
tracking.mjs |
Leer un documento desde Node.js y mandar un patrón como parámetro |
json.test.mjs |
Pruebas de examples.sql |
modify.test.mjs |
Pruebas de modify.sql e indexes.sql |
app.test.mjs |
Pruebas de tracking.mjs y de los tipos que entrega pg |
review.test.mjs |
Pruebas de review.sql |
Como en la semana 5, las consultas de los archivos .sql empiezan con una
línea -- name: ..., y sqlfile.mjs las
separa para que las pruebas corran el mismo texto. Para verlas en psql,
basta \i examples.sql. modify.sql e indexes.sql empiezan con BEGIN y
terminan con ROLLBACK, así que se pueden cargar las veces que se quiera.
Resumen
- Un dato semiestructurado lleva su estructura consigo: cada valor dice
qué atributos tiene, y puede tenerlos anidados y multivaluados. Una columna
jsonbrompe la 1NF a propósito. - JSON tiene seis tipos: objeto, arreglo, string, number, boolean y
null. Elnullde JSON es un valor; no es una clave ausente ni elNULLde SQL.jsonguarda el texto tal cual;jsonblo guarda analizado, sin claves repetidas ni orden de claves, con igualdad, contención e índices. ->devuelvejsonb;->>,text;#>y#>>siguen un camino. Lo que no está daNULL. Los arreglos de JSON cuentan desde 0. Lo que sale de->>es texto: para comparar números o fechas se convierte ('10' > '9'es falso).@>pregunta si un documento contiene a otro;?,?|y?&, por claves. Para filtrar por igualdad se prefiere@>.jsonb_array_elements,jsonb_each,jsonb_to_recordsetyJSON_TABLEpasan de JSON a filas. El SQL/JSON path ($.events[*] ? (@.kind == "returned")) filtra dentro del documento, conjsonb_path_exists,@?y@@, en modolaxostrict.to_jsonb,jsonb_build_object,jsonb_aggyjsonb_object_aggarman JSON desde tablas.jsonb_aggsobre cero filas esNULLy sobre unLEFT JOINincluyenull:FILTERycoalesce(..., '[]').NULL || documentoesNULL.pgentregajsonyjsonbcomo objetos; dentro, los números sonnumbery las fechas, strings. Un patrón se manda conJSON.stringifyy$1::jsonb.- Un índice GIN acelera
@>,?,@?y@@, no->>;jsonb_path_opses más chico pero no sirve para?. Un B-tree sobre una expresión sirve para una clave fija. jsonbsirve para atributos opcionales y variables que no participan en joins ni en restricciones. Dentro de un documento no hay claves foráneas, tipos ni dependencias funcionales que el motor haga cumplir. Usarlo para no diseñar es un error.
Ejercicios
- Sin correrlas, digan qué devuelve cada expresión y de qué tipo SQL es el
resultado:
'{"a": {"b": [10, 20]}}'::jsonb -> 'a' -> 'b' -> 1,'{"a": {"b": [10, 20]}}'::jsonb #>> '{a,b,0}','{"a": null}'::jsonb -> 'a','{"a": null}'::jsonb ->> 'a','{"a": null}'::jsonb -> 'b'y'[1, 2]'::jsonb -> 2. Después compruébenlo conpg_typeofenpsql. - Para cada par, digan si
a @> bes verdadero y por qué:{"x": 1, "y": 2}y{"x": 1};{"x": [1, 2, 3]}y{"x": [3]};{"x": [1, 2, 3]}y{"x": 3};[{"k": 1, "v": 2}]y[{"k": 1}];{"x": {"y": 1}}y{"y": 1};{}y{}. - Escriban, sobre
chasqui_w08, tres consultas: los envíos frágiles con@>; los envíos con largo mayor a 50 cm (con la conversión anumeric), y cuántos envíos tienen la etiquetaregalosin la etiquetaelectrónica. Comprueben la segunda conjsonb_path_existsy la tercera conjsonb_array_elements_text. - ¿Cuántos envíos tienen la clave
instructionscon el valornullde JSON? ¿Cuántos tienen la clave con un string? Escriban una consulta que devuelva los dos números en una fila, concount(*) FILTER, y expliquen por quédetails ->> 'instructions' IS NULLno sirve para el primero. - El área comercial quiere saber el peso declarado promedio por etiqueta.
Escriban la consulta con
jsonb_array_elements_textyweight_declared. ¿Qué pasa con los envíos que tienen etiquetas pero no peso declarado? ¿Y con un envío que tiene dos etiquetas, en cuántos promedios cuenta? - Escriban una consulta que devuelva, para un cliente dado (
$1), un documento con su nombre y la lista de sus envíos como remitente, cada uno con su número, estado y precio, ordenados por fecha. Debe devolver una lista vacía (nonullni[null]) para un cliente sin envíos: hay 82 clientes que nunca enviaron nada. Pruébenla desde Node.js conpgy digan de qué tipo llega el precio dentro del documento y de qué tipo llegaría como columna. - Con
tracking_export, encuentren los documentos en los que el último evento no esdeliverednireturned. Escríbanlo una vez con->yjsonb_array_lengthy otra conJSON_TABLE. Comparen el número con los envíosregisteredein_transitde la tablashipment. - Cambien el nombre de la agencia 29 dentro de una transacción
(
BEGIN; UPDATE agency SET name = 'Iquitos - Belén' WHERE agency_id = 29;). Antes delROLLBACK, comparen lo que devuelvenshipment_trackingytracking_exportpara un envío con destino Iquitos. ¿Cuál tiene el nombre nuevo, y por qué? ¿Qué anomalía de la semana 7 es esta? - Creen, dentro de una transacción, el índice GIN con
jsonb_path_opsy miren conEXPLAINestas tres consultas:details @> '{"fragile": true}',details ? 'fragile'ydetails @? '$.tags[*] ? (@ == "urgente")'. ¿Cuáles usan el índice? Repitan con el índice por defecto. Expliquen la diferencia con lo que guarda cada clase de operadores. - Agreguen a
shipmentuna restricciónCHECKque obligue a quedimensions_cm, si está, tenga las tres clavesl,wyhcon números positivos. Pruébenla con unUPDATEque la viole y otro que la cumpla, dentro de una transacción. ¿Qué tendrían que hacer para exigir queinsurance.policyno se repita entre dos envíos? - Un compañero propone reemplazar las tablas
shipment_eventyagencypor una columnaevents jsonbenshipment, con los eventos y el nombre de cada agencia. Den cuatro cosas concretas que la base de datos deja de garantizar o que se vuelven más difíciles (piensen en claves foráneas, en la clave(shipment_id, seq), en las dependencias funcionales y en la consulta “cuántos eventos tuvo cada agencia en marzo”). ¿En qué caso defenderían su propuesta? - Resuelvan el parcial de práctica en dos
horas, en papel. Después creen su esquema y sus datos en una base de
datos propia y comprueben cada respuesta de las partes A y B en
psql.