
Apuntes · Capítulo 7Diseño de bases de datos
Dependencias funcionales y normalización
Dependencias funcionales y normalización
La semana pasada diseñamos el esquema de Chasqui con el modelo E-R: entidades, relaciones, cardinalidades, y una receta para pasar el diagrama a tablas. Esa receta da buenos esquemas cuando el diagrama es bueno, pero no nos dice cómo reconocer un esquema malo ni cómo arreglarlo. Y los esquemas malos existen: la hoja de cálculo que una agencia llevó durante años y que alguien importó tal cual, la tabla “temporal” que se volvió permanente, la columna que se agregó a la tabla equivocada porque era lo más rápido.
Este capítulo da la teoría que falta. Su herramienta es la dependencia funcional (functional dependency): una regla del tipo “el DNI determina el nombre” o “la placa determina la capacidad del vehículo”. Con ella vamos a explicar por qué una tabla que mezcla datos de cosas distintas repite información y produce errores, a decidir cuándo partir una tabla en dos no pierde nada, y a definir las formas normales (normal forms), que son condiciones que un esquema cumple o no cumple y que se pueden verificar con un algoritmo.
En la primera parte vemos las anomalías de un mal diseño, las dependencias funcionales, la descomposición sin pérdida y la forma normal de Boyce-Codd (BCNF), con su algoritmo de descomposición. En la segunda parte formalizamos la teoría: los axiomas de Armstrong, la clausura de un conjunto de atributos, la cubierta canónica, la preservación de dependencias y la tercera forma normal (3NF), con el algoritmo que la construye. Al final, de forma opcional, las dependencias multivaluadas y la 4NF.
Es un capítulo más formal que los anteriores. Las definiciones importan: casi todos los errores en este tema vienen de usar una definición a medias (“BCNF es que no haya dependencias transitivas”, “una clave es lo que no se repite en los datos”). Por eso cada algoritmo está escrito en pseudocódigo, cada ejemplo está resuelto paso a paso y cada resultado está comprobado con código.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “Qué tiene de malo una tabla con todo”. Sesión B: “La clausura F⁺ y los axiomas de Armstrong” y “Clausura de un conjunto de atributos”.
- En clase. Sesión A: “Dependencias funcionales”, “Descomposición sin pérdida” y “Forma normal de Boyce-Codd”. Sesión B: “Teoría de dependencias funcionales”, “Cubierta canónica”, “Preservación de dependencias”, “Tercera forma normal” y “BCNF o 3NF”.
- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 7.1–7.5; la 7.8, complementaria, y la 7.6 (y “Dependencias multivaluadas y 4NF” de este capítulo), opcionales. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-07, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
Qué tiene de malo una tabla con todo
La hoja de viajes
Imaginemos que la oficina de operaciones de Chasqui lleva los viajes en una
hoja de cálculo. Cada fila es un viaje: cuándo sale, por qué ruta, entre qué
agencias, a qué distancia, con qué vehículo. Como en una hoja de cálculo no hay
joins, cada fila copia todo lo que hace falta para leerla sola. Esa hoja,
importada a PostgreSQL, es la tabla trip_sheet, que
trip_sheet.sql construye a partir de los
datos reales con un join de trip, route, agency (dos veces) y vehicle:
trip_sheet(trip_id, departure_at, route_id, origin_agency, origin_city,
           dest_agency, dest_city, distance_km, base_fare,
           plate, kind, capacity_kg)
Tiene 5914 filas, una por viaje, y trip_id es su clave primaria. Estos son
los primeros viajes de la van de placa K2U-314 (algunas columnas omitidas):
SELECT trip_id, route_id, origin_agency, dest_agency, distance_km, plate, kind, capacity_kg
FROM trip_sheet
WHERE plate = 'K2U-314'
ORDER BY trip_id
LIMIT 4;
trip_id | route_id | origin_agency | dest_agency | distance_km | plate | kind | capacity_kg
---------+----------+--------------------+---------------------------+-------------+---------+------+-------------
47 | 116 | Lima - Los Olivos | Lima - Ate | 31 | K2U-314 | van | 1400
126 | 113 | Lima - La Victoria | Lima - Los Olivos | 22 | K2U-314 | van | 1400
153 | 119 | Arequipa - Centro | Arequipa - Cerro Colorado | 18 | K2U-314 | van | 1400
206 | 115 | Lima - Los Olivos | Lima - La Victoria | 22 | K2U-314 | van | 1400
(4 rows)Que K2U-314 es una van de 1400 kg está escrito en cada uno de sus viajes.
¿Cuántas veces se repite cada cosa?
SELECT count(*) AS filas,
       count(DISTINCT route_id) AS rutas,
       count(DISTINCT plate) AS vehiculos
FROM trip_sheet;
filas | rutas | vehiculos
-------+-------+-----------
5914 | 120 | 24
(1 row)Hay 24 vehículos y 120 rutas, pero sus datos aparecen 5914 veces. La redundancia (redundancy) no es solo espacio desperdiciado: es la misma información guardada en muchos lugares, y nada obliga a que esos lugares digan lo mismo.
Tres anomalías
Silberschatz (sec. 7.1) muestra los problemas de un mal diseño con una tabla
que junta instructores y departamentos. En la hoja de viajes son los mismos
tres, y se pueden ver en PostgreSQL. Las sentencias que cambian datos están en
examples.sql entre BEGIN y ROLLBACK.
Anomalía de actualización (update anomaly). La van K2U-314 cambia de
carrocería y ahora carga 1500 kg. Hay que cambiar sus 91 filas; si el programa
cambia solo una, la tabla se contradice:
BEGIN;
UPDATE trip_sheet SET capacity_kg = 1500 WHERE trip_id = 47;
SELECT plate, array_agg(DISTINCT capacity_kg) AS capacidades
FROM trip_sheet
WHERE plate = 'K2U-314'
GROUP BY plate;
ROLLBACK;
plate | capacidades
---------+-------------
K2U-314 | {1400,1500}
(1 row)¿Cuánto carga K2U-314? Depende de qué fila se lea.
Anomalía de inserción (insertion anomaly). Llega un vehículo nuevo que
todavía no hizo ningún viaje. No hay dónde registrarlo: cada fila es un viaje,
y la clave trip_id no puede ser NULL.
INSERT INTO trip_sheet (plate, kind, capacity_kg)
VALUES ('Z9Z-999', 'van', 1200);
ERROR: null value in column "trip_id" of relation "trip_sheet" violates not-null constraint
DETAIL: Failing row contains (null, null, null, null, null, null, null, null, null, Z9Z-999, van, 1200).Lo mismo pasa con una agencia sin viajes. La agencia Iquitos - Centro
existe en agency, pero ningún viaje sale de ella: en la hoja no aparece como
origen, y si mañana cambia de dirección, la hoja no tiene dónde anotarlo.
Anomalía de borrado (deletion anomaly). Chasqui deja de operar la ruta 113 (de Lima - La Victoria a Lima - Los Olivos) y se borran sus viajes. Con ellos desaparece lo único que la hoja sabía de esa ruta: su distancia y su tarifa.
BEGIN;
DELETE FROM trip_sheet WHERE route_id = 113;
SELECT count(DISTINCT route_id) AS rutas,
       count(*) FILTER (WHERE origin_agency = 'Lima - La Victoria'
                          AND dest_agency = 'Lima - Los Olivos') AS viajes_113
FROM trip_sheet;
ROLLBACK;
DELETE 75
rutas | viajes_113
-------+------------
119 | 0
(1 row)Queríamos borrar 75 viajes y borramos también una ruta.
Idea clave. Las tres anomalías tienen la misma causa: la tabla guarda hechos sobre cosas distintas (viajes, rutas, agencias, vehículos) y cada hecho sobre una ruta o un vehículo depende de que exista un viaje que lo lleve. La solución es guardar cada hecho una sola vez, en una tabla cuya clave sea la cosa de la que habla.
Descomponer
La solución que conocen del modelo E-R es partir la tabla: trip, route,
agency, vehicle. A esto se le llama descomposición (decomposition).
Definición. Una descomposición de un esquema de relación R es un conjunto de esquemas {R1, …, Rn} tal que R = R1 ∪ … ∪ Rn. Una instancia r de R se reemplaza por sus proyecciones ri = ΠRi(r).
Partir una tabla es fácil; partirla bien no. Hay que responder tres preguntas, y el resto del capítulo responde cada una con una herramienta formal:
- ¿Se puede recuperar la tabla original a partir de las partes? (Descomposición sin pérdida.)
- ¿Las partes ya no tienen redundancia? (Formas normales: BCNF, 3NF.)
- ¿Las reglas que valían en la tabla original se pueden seguir verificando en las partes, sin hacer joins? (Preservación de dependencias.)
Las tres se responden con dependencias funcionales.
Dependencias funcionales
Definición
Notación, como en Silberschatz (sec. 7.2.1): R es un esquema de relación (un
conjunto de atributos), r una instancia de R, y α, β ⊆ R conjuntos de
atributos. Escribimos los conjuntos de atributos sin llaves cuando no hay
confusión: AB es {A, B} y origin_agency dest_agency es
{origin_agency, dest_agency}. t[α] es la tupla t restringida a los
atributos de α.
Definición. La dependencia funcional α → β se cumple en la instancia r si para todo par de tuplas t1, t2 de r:
si t1[α] = t2[α], entonces t1[β] = t2[β].
La dependencia α → β vale en el esquema R (o es una restricción sobre R) si se cumple en toda instancia válida de R. Se lee “α determina funcionalmente a β”; α es el lado izquierdo o determinante, β el lado derecho.
Dicho en palabras: conocer los valores de α basta para conocer los de β. Es una función en el sentido matemático: a cada valor de α le corresponde un solo valor de β (aunque varios valores de α pueden tener el mismo β).
En la hoja de viajes valen, por las reglas del negocio:
| Dependencia | Por qué |
|---|---|
trip_id → departure_at, route_id, plate |
cada viaje sale una vez, por una ruta, en un vehículo |
route_id → origin_agency, dest_agency, distance_km, base_fare |
cada ruta va de una agencia a otra, con su distancia y su tarifa |
origin_agency, dest_agency → route_id |
hay a lo más una ruta entre dos agencias (UNIQUE en route) |
origin_agency → origin_city |
cada agencia está en una ciudad |
dest_agency → dest_city |
lo mismo, para la agencia de destino |
plate → kind, capacity_kg |
cada placa es de un vehículo |
Llamaremos F a este conjunto de seis dependencias. En Chasqui hay otras
conocidas: en customer, dni → first_name, last_name, city; en vehicle,
plate → kind, capacity_kg, que es la misma de la hoja.
Y no valen, por ejemplo:
origin_city → origin_agency: en Lima hay tres agencias.capacity_kg → plate: dos vehículos pueden cargar lo mismo.route_id → plate: una ruta se recorre con vehículos distintos en días distintos.
Dependencias triviales
Algunas dependencias se cumplen en cualquier instancia de cualquier relación:
trip_id, plate → plate, o AB → A. Si dos tuplas coinciden en α, coinciden
en cualquier parte de α.
Definición. α → β es trivial si β ⊆ α.
Las triviales no dicen nada del negocio; las formas normales las excluyen
siempre. Ojo: trip_id, plate → plate, kind no es trivial (kind no está a
la izquierda), aunque una parte sí lo sea.
Claves y dependencias
En la semana 1 definimos superclave como un conjunto de atributos que distingue las tuplas en toda instancia válida. Con dependencias funcionales, la misma idea se escribe más corto.
Definición. K ⊆ R es superclave de R si K → R vale en R. Es clave candidata si además ningún subconjunto propio de K es superclave.
¿Por qué es lo mismo? Si K → R y dos tuplas coinciden en K, coinciden en todo R: son la misma tupla (una relación es un conjunto, no tiene tuplas repetidas). Al revés, si dos tuplas distintas nunca coinciden en K, la condición “si coinciden en K, coinciden en R” se cumple sin excepción.
En la hoja de viajes, trip_id es superclave: trip_id determina la ruta y el
vehículo, la ruta determina las agencias, las agencias determinan sus
ciudades y el vehículo su tipo y capacidad. Que esa cadena de razonamiento es
correcta y cómo hacerla con un algoritmo es el tema de la Sesión B.
Una dependencia funcional generaliza la idea de clave: dice que α identifica
el valor de β, aunque α no identifique toda la fila. Ese es exactamente el
problema de la hoja: plate identifica kind y capacity_kg sin identificar
el viaje, así que el par (tipo, capacidad) se repite en cada viaje del
vehículo.
De dónde salen las dependencias
Las dependencias funcionales son restricciones, como las claves y los
CHECK. Salen de los requisitos del negocio (“cada agencia está en una sola
ciudad”, “un DNI identifica a una persona”), no de mirar los datos.
Los datos de un momento dado pueden refutar una dependencia (basta un par de filas que coincidan en α y difieran en β) pero nunca demostrarla. Que hoy ningún par de filas la contradiga solo dice que estos datos, hoy, no la contradicen. Un ejemplo real: en la hoja, cada distancia tiene una sola tarifa.
SELECT distance_km
FROM trip_sheet
GROUP BY distance_km
HAVING count(DISTINCT base_fare) > 1;
distance_km
-------------
(0 rows)Ningún contraejemplo, y sin embargo distance_km → base_fare no es una
regla de Chasqui: hoy la tarifa base se calcula a partir de la distancia, pero
el día que haya una promoción en la ruta Lima-Trujillo, dos rutas de la misma
distancia tendrán tarifas distintas. Si la hubiéramos puesto en F, la
normalización nos habría llevado a crear una tabla de tarifas por distancia,
que la promoción rompería. Lo mismo pasa en customer: hoy ningún teléfono se
repite, pero una familia puede compartir un celular.
Error común. Deducir las dependencias funcionales mirando unas filas. Con pocas filas, casi cualquier cosa parece una dependencia: con diez clientes, quizá ningún apellido se repite, y aun así
last_name → dnies falsa. Las dependencias se escriben a partir de lo que dice el negocio; los datos sirven para encontrar errores, en los datos o en lo que creíamos del negocio.
Refutar una dependencia con SQL
La definición se traduce directamente en una consulta. α → β falla si hay un valor de α con más de un valor de β:
SELECT α
FROM r
GROUP BY α
HAVING count(DISTINCT β) > 1;
Cada fila del resultado es un contraejemplo. Para la regla de los vehículos (con dos columnas a la derecha se cuenta el par):
SELECT plate
FROM trip_sheet
GROUP BY plate
HAVING count(DISTINCT (kind, capacity_kg)) > 1;
plate
-------
(0 rows)Y para una que sabemos falsa, origin_city → origin_agency:
SELECT origin_city, count(DISTINCT origin_agency) AS agencias
FROM trip_sheet
GROUP BY origin_city
HAVING count(DISTINCT origin_agency) > 1
ORDER BY origin_city;
origin_city | agencias
-------------+----------
Arequipa | 2
Lima | 3
(2 rows)La misma consulta sirve para descubrir que algo que creíamos una regla no lo
es en los datos. Uno pensaría que un vehículo no puede salir en dos viajes a la
misma hora, es decir, que plate, departure_at → trip_id:
SELECT plate, departure_at, array_agg(trip_id ORDER BY trip_id) AS viajes
FROM trip_sheet
GROUP BY plate, departure_at
HAVING count(DISTINCT trip_id) > 1
ORDER BY departure_at, plate
LIMIT 3;
plate | departure_at | viajes
---------+------------------------+---------
P5Z-632 | 2026-01-05 06:00:00-05 | {1,2}
R7D-433 | 2026-01-05 08:00:00-05 | {24,26}
T8D-416 | 2026-01-05 10:00:00-05 | {37,39}
(3 rows)En total hay 336 pares (placa, hora de salida) con más de un viaje. Frente a
un resultado así hay dos posibilidades, y la base de datos no puede decidir
entre ellas: o la regla no existe (por ejemplo, un vehículo puede cubrir dos
rutas que salen juntas del mismo terminal), o los datos están mal y hay que
corregirlos antes de declarar la restricción. Lo que no se puede hacer es
agregar plate, departure_at → trip_id a F y seguir como si nada. En este
capítulo no la usamos.
En PostgreSQL.
count(DISTINCT y)no cuenta losNULL. Si un grupo tiene los valores'bus'yNULL, cuenta 1 y la consulta de arriba no lo muestra, aunque las dos filas no coincidan eny:SELECT plate FROM (VALUES ('A1A-111', 'bus'), ('A1A-111', NULL)) AS t (plate, kind) GROUP BY plate HAVING count(DISTINCT kind) > 1;plate ------- (0 rows)La teoría del libro supone que no hay
NULL. Si la columna los admite y queremos tratarNULLcomo un valor más (que es lo que haceGROUP BYcon el lado izquierdo: junta todos losNULLen un grupo), hay que sumar uno cuando el grupo tiene algúnNULL:SELECT plate FROM (VALUES ('A1A-111', 'bus'), ('A1A-111', NULL)) AS t (plate, kind) GROUP BY plate HAVING count(DISTINCT kind) + CASE WHEN count(kind) < count(*) THEN 1 ELSE 0 END > 1;plate --------- A1A-111 (1 row)Con varias columnas a la derecha,
count(DISTINCT (kind, capacity_kg))cuenta valores de fila (row values), y PostgreSQL cuenta una fila aunque tenga camposNULL: en ese caso losNULLya se tratan como valores. La hoja de viajes no tieneNULL, así que en el resto del capítulo no nos preocupamos por esto.
Idea clave. Si la consulta devuelve filas, la dependencia es falsa (o los datos están mal). Si no devuelve nada, solo sabemos que los datos de hoy no la contradicen.
Descomposición sin pérdida
Definición
Definición. Una descomposición de R en R1 y R2 es sin pérdida (lossless) si para toda instancia válida r de R:
ΠR1(r) ⋈ ΠR2(r) = r.
Si no, es con pérdida (lossy).
“Válida” quiere decir: que cumple las restricciones de R, entre ellas sus dependencias funcionales. El join es el natural join del álgebra (semana 2), que iguala los atributos comunes R1 ∩ R2.
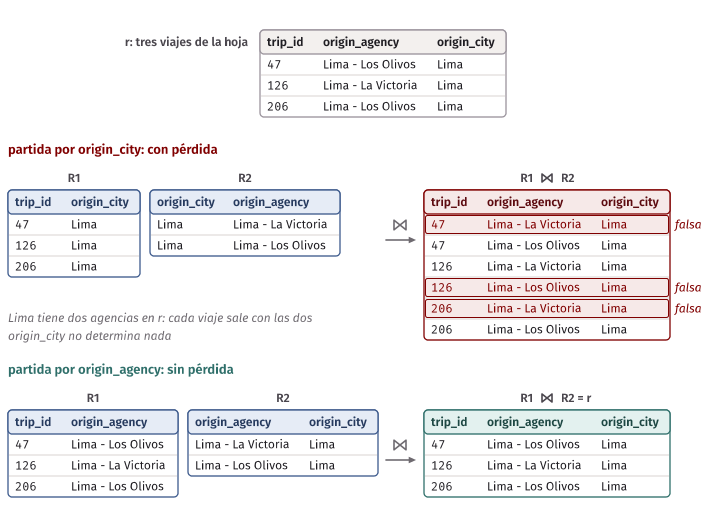
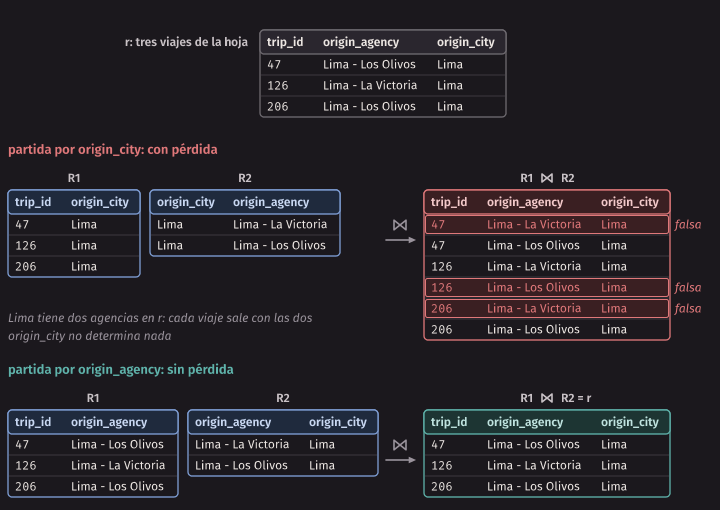
Un detalle que confunde: una descomposición con pérdida no pierde filas, gana filas. Siempre vale
r ⊆ ΠR1(r) ⋈ ΠR2(r),
porque cada tupla t de r deja t[R1] en la primera proyección y t[R2] en la segunda, y esas dos coinciden en los atributos comunes, así que el join las vuelve a juntar en t. Lo que se pierde es información: el join agrega tuplas falsas (spurious tuples) y ya no se sabe cuáles son las verdaderas.
Una descomposición con pérdida, en los datos
Tomemos tres columnas de la hoja, (trip_id, origin_agency, origin_city), y
partámoslas por la ciudad: R1 = (trip_id, origin_city) y
R2 = (origin_city, origin_agency). Luego juntamos las partes y
comparamos con el original en los dos sentidos, con EXCEPT:
WITH original AS (
  SELECT DISTINCT trip_id, origin_agency, origin_city FROM trip_sheet
), r1 AS (
  SELECT DISTINCT trip_id, origin_city FROM trip_sheet
), r2 AS (
  SELECT DISTINCT origin_city, origin_agency FROM trip_sheet
), joined AS (
  SELECT trip_id, origin_agency, origin_city FROM r1 JOIN r2 USING (origin_city)
)
SELECT (SELECT count(*) FROM original) AS original,
       (SELECT count(*) FROM joined) AS reconstruida,
       (SELECT count(*) FROM (TABLE joined EXCEPT TABLE original) AS x) AS de_mas,
       (SELECT count(*) FROM (TABLE original EXCEPT TABLE joined) AS x) AS faltan;
original | reconstruida | de_mas | faltan
----------+--------------+--------+--------
5914 | 11024 | 5110 | 0
(1 row)Tres detalles de la consulta. Las proyecciones llevan DISTINCT porque la
proyección del álgebra es un conjunto y SQL trabaja con multiconjuntos (semana
3): sin DISTINCT, r2 tendría una fila por viaje y el join multiplicaría
todo. El natural join está escrito como JOIN ... USING (origin_city), que
nombra los atributos comunes. Y TABLE joined es la forma corta de SELECT * FROM joined.
El resultado confirma la teoría: no falta ninguna fila y sobran 5110. Las cuentas cuadran: de Lima salen 2330 viajes y hay 3 agencias, de Arequipa 450 y hay 2; cada viaje de esas ciudades aparece con todas las agencias de su ciudad, 2330 × 2 + 450 × 1 = 5110 filas de más. Un viaje cualquiera:
SELECT trip_id, origin_city, origin_agency
FROM r1 JOIN r2 USING (origin_city)      -- r1 y r2 como arriba
WHERE trip_id = 47
ORDER BY origin_agency;
trip_id | origin_city | origin_agency
---------+-------------+--------------------
47 | Lima | Lima - Ate
47 | Lima | Lima - La Victoria
47 | Lima | Lima - Los Olivos
(3 rows)El viaje 47 salió de Lima - Los Olivos, pero en las partes ya no hay forma de
saberlo. Si en cambio partimos por la agencia, R1 =
(trip_id, origin_agency) y R2 = (origin_agency, origin_city),
la misma comparación (consulta lossless de examples.sql) da:
 original | reconstruida | de_mas | faltan
----------+--------------+--------+--------
     5914 |         5914 |      0 |      0
(1 row)
¿Qué distingue las dos particiones? Que origin_agency → origin_city, y
origin_city no determina nada.
El criterio con dependencias
Comparar con los datos de hoy no prueba nada (otra vez: los datos no demuestran, solo refutan). Necesitamos un criterio sobre el esquema.
Teorema (Silberschatz, sec. 7.2.3). Sea F el conjunto de dependencias de R. La descomposición de R en R1 y R2 es sin pérdida si al menos una de estas dependencias está en F+ (las que se deducen de F):
- R1 ∩ R2 → R1
- R1 ∩ R2 → R2
Es decir, si los atributos comunes son superclave de una de las dos partes.
Demostración (para el segundo caso; el primero es simétrico). Ya vimos que r está contenida en el join; falta la otra inclusión. Sea t una tupla del join. Viene de una tupla t1 de ΠR1(r) y una t2 de ΠR2(r) que coinciden en R1 ∩ R2. A su vez, t1 = u1[R1] y t2 = u2[R2] para dos tuplas u1, u2 de r. Como u1 y u2 coinciden en R1 ∩ R2 y R1 ∩ R2 → R2, coinciden en todo R2: u1[R2] = t2. Entonces u1 tiene los valores de t1 en R1 y los de t2 en R2: u1 = t, y t ∈ r. ∎
La condición es suficiente. Si las únicas restricciones sobre R son dependencias funcionales, también es necesaria: cuando ninguna de las dos se cumple, existe una instancia válida en la que el join produce tuplas falsas. (Con otras restricciones, como las dependencias multivaluadas del final del capítulo, puede haber descomposiciones sin pérdida que este criterio no detecta.)
En el ejemplo: con la ciudad, la parte común es {origin_city}, que no
determina ni trip_id ni origin_agency. Con la agencia, la parte común es
{origin_agency}, y origin_agency → origin_agency, origin_city, que es
R2 completo.
Error común. Creer que la garantía protege también datos que no cumplen las dependencias. El teorema habla de instancias válidas. Si en la hoja una agencia aparece con dos ciudades distintas (por un error de tipeo), la partición por
origin_agencytambién inventa filas. El laboratorio de esta semana lo muestra con datos alterados a propósito.
Forma normal de Boyce-Codd
Definición
La descomposición sin pérdida dice cuándo partir es seguro. Falta decir cuándo hay que partir. La respuesta de BCNF es: cuando algo determina otra cosa sin ser superclave.
Definición. Un esquema R con dependencias F está en forma normal de Boyce-Codd (BCNF) si para toda dependencia α → β de F+ con α ⊆ R y β ⊆ R, al menos una de estas se cumple:
- α → β es trivial (β ⊆ α);
- α es superclave de R.
Una base de datos está en BCNF si cada uno de sus esquemas lo está.
Intuición: en BCNF, toda flecha no trivial sale de una superclave. Si un
atributo determina otros sin ser clave, el mismo hecho (“la placa K2U-314
es una van de 1400 kg”) se guarda una vez por cada fila que tenga esa placa, y
eso es redundancia. BCNF dice: ese hecho va en su propia tabla, donde la
placa sí sea clave.
trip_sheet no está en BCNF. Su única clave candidata es {trip_id} (lo
comprobamos en la Sesión B), y estas dependencias de F tienen lados
izquierdos que no son superclave: route_id → …, origin_agency, dest_agency → route_id, origin_agency → origin_city, dest_agency → dest_city y plate → kind, capacity_kg. Solo trip_id → … cumple.
Probar BCNF
La definición habla de F+, que puede ser enorme. Dos atajos (Silberschatz, sec. 7.5.1):
- Para el esquema original R, con F definido sobre R, basta revisar las dependencias de F: si ninguna viola BCNF, ninguna de F+ lo hace.
- Para una parte Ri de una descomposición, el atajo anterior no vale. Hay que mirar F+ restringido a Ri. Una forma de hacerlo: para cada α ⊆ Ri, calcular la clausura α+ (Sesión B) y verificar que α+ ∩ (Ri − α) es vacío (α no determina nada más de Ri) o contiene todo Ri − α (α es superclave de Ri).
El segundo punto tiene trampa. El ejemplo del libro: R(A, B, C, D, E) con F = {A → B, BC → D}, descompuesta en R1(A, B) y R2(A, C, D, E). Ninguna dependencia de F tiene todos sus atributos en R2, así que “mirar solo F” diría que R2 está en BCNF. Pero AC → D está en F+ (de A → B se obtiene AC → BC, y con BC → D, AC → D), sus atributos están en R2 y AC no es superclave de R2 (no determina E). R2 no está en BCNF.
El algoritmo de descomposición
Si R no está en BCNF, hay una dependencia α → β que lo impide. Se parte R en dos: una tabla con α ∪ β, donde α sí es clave, y el resto de R sin los atributos de β.
algoritmo BCNF(R, F)
  resultado := {R}
  mientras haya un Ri en resultado que no esté en BCNF
    sea α → β una dependencia no trivial que se cumple en Ri,
      con α ∩ β = ∅ y α no superclave de Ri
    resultado := (resultado − {Ri}) ∪ {α ∪ β, Ri − β}
  devolver resultado
Por qué funciona:
- Cada paso es sin pérdida. Las dos partes son α ∪ β y Ri − β. Como α ∩ β = ∅, su intersección es exactamente α, y α → α ∪ β. Por el teorema, la partición es sin pérdida. Una cadena de particiones sin pérdida es sin pérdida.
- Termina. Cada paso reemplaza un esquema por dos estrictamente más chicos (α ∪ β ≠ Ri porque α no es superclave, y β no es vacío). Un esquema de dos atributos siempre está en BCNF, así que no se puede partir para siempre.
- El resultado está en BCNF, porque el ciclo solo para cuando todos lo están.
Elegir β tan grande como se pueda ahorra pasos. Una buena elección es β =
(α+ ∩ Ri) − α: todo lo que α determina dentro de
Ri. Es lo que hace fd.mjs.
Error común. Pensar que la descomposición en BCNF es única. Depende del orden en que se eligen las dependencias que violan BCNF, y distintos órdenes pueden dar esquemas distintos, todos en BCNF y sin pérdida. Algunos preservan más dependencias que otros (vuelve en la Sesión B).
Ejemplo resuelto: la hoja de viajes
R = trip_sheet, con las doce columnas, y F las seis dependencias de la
tabla de arriba. La clave candidata es {trip_id}.
Paso 1. route_id → origin_agency, dest_agency, distance_km, base_fare
viola BCNF: route_id no es superclave (no determina trip_id). Tomamos β
como todo lo que route_id determina: route_id determina las dos agencias
y, a través de ellas, las dos ciudades. Entonces:
- Ra =
(route_id, origin_agency, origin_city, dest_agency, dest_city, distance_km, base_fare) - Rb =
(trip_id, departure_at, route_id, plate, kind, capacity_kg)
La parte común es {route_id}, clave de Ra: sin pérdida.
Paso 2. Ra no está en BCNF: origin_agency → origin_city, y
origin_agency no es superclave de Ra. Partimos en
(origin_agency, origin_city) y
(route_id, origin_agency, dest_agency, dest_city, distance_km, base_fare).
Paso 3. Igual con dest_agency → dest_city: queda (dest_agency, dest_city) y (route_id, origin_agency, dest_agency, distance_km, base_fare).
Esta última tabla tiene dos claves candidatas: {route_id} y
{origin_agency, dest_agency}. Las dependencias de F+ que caben
en ella salen de una de las dos, así que está en BCNF. Una tabla con dos
claves no es un problema para BCNF: lo que exige es que todo determinante sea
superclave, no que haya una sola clave.
Paso 4. Rb no está en BCNF por plate → kind, capacity_kg.
Queda (plate, kind, capacity_kg) y (trip_id, departure_at, route_id, plate).
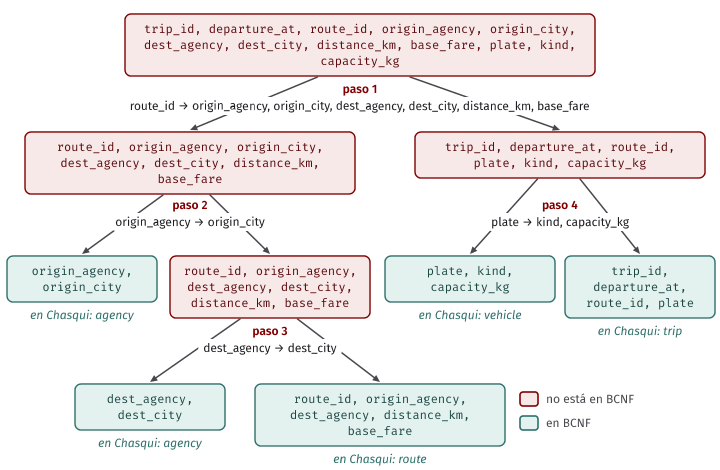
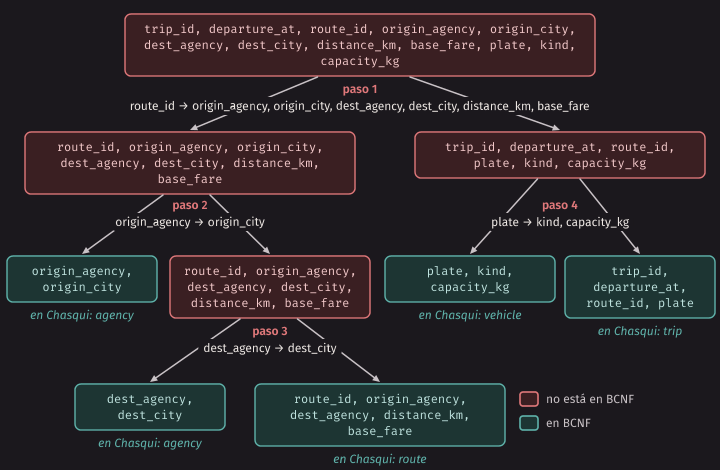
El resultado, cinco esquemas en BCNF:
| Esquema | Clave(s) | En Chasqui |
|---|---|---|
(trip_id, departure_at, route_id, plate) |
trip_id |
trip |
(route_id, origin_agency, dest_agency, distance_km, base_fare) |
route_id; origin_agency, dest_agency |
route |
(origin_agency, origin_city) |
origin_agency |
agency |
(dest_agency, dest_city) |
dest_agency |
agency |
(plate, kind, capacity_kg) |
plate |
vehicle |
Es, casi, el esquema de Chasqui. La diferencia está en las dos tablas de
agencias: para el algoritmo, origin_agency y dest_agency son atributos
distintos, y produce una tabla para cada uno. Nosotros sabemos que son el
mismo tipo de cosa (una agencia) en dos papeles, y las juntamos en una tabla
agency a la que route apunta dos veces. Esa decisión no sale de las
dependencias: sale del modelo E-R de la semana pasada, donde agencia es una
entidad y origen y destino son dos relaciones con ella. Normalización y E-R se
complementan.
Las otras diferencias también son decisiones de diseño, no de normalización:
Chasqui usa claves sustitutas (vehicle_id, agency_id) en vez de la placa o
el nombre, y por eso trip guarda vehicle_id y no plate.
fd.mjs reproduce los cuatro pasos (node examples.mjs, que ordena los
atributos alfabéticamente):
paso 1: route_id → base_fare, dest_agency, dest_city, distance_km, origin_agency, origin_city viola BCNF en (base_fare, capacity_kg, departure_at, dest_agency, dest_city, distance_km, kind, origin_agency, origin_city, plate, route_id, trip_id)
  -> (base_fare, dest_agency, dest_city, distance_km, origin_agency, origin_city, route_id)
  -> (capacity_kg, departure_at, kind, plate, route_id, trip_id)
paso 2: origin_agency → origin_city viola BCNF en (base_fare, dest_agency, dest_city, distance_km, origin_agency, origin_city, route_id)
  -> (origin_agency, origin_city)
  -> (base_fare, dest_agency, dest_city, distance_km, origin_agency, route_id)
paso 3: dest_agency → dest_city viola BCNF en (base_fare, dest_agency, dest_city, distance_km, origin_agency, route_id)
  -> (dest_agency, dest_city)
  -> (base_fare, dest_agency, distance_km, origin_agency, route_id)
paso 4: plate → capacity_kg, kind viola BCNF en (capacity_kg, departure_at, kind, plate, route_id, trip_id)
  -> (capacity_kg, kind, plate)
  -> (departure_at, plate, route_id, trip_id)
La descomposición en SQL
decompose.sql crea las cinco tablas
(temporales) con CREATE TEMP TABLE ... AS SELECT DISTINCT ... y les agrega
sus claves. El ALTER TABLE ... ADD PRIMARY KEY es una prueba en sí misma:
si los datos no cumplieran, por ejemplo, plate → kind, capacity_kg, habría
dos filas con la misma placa en la tabla de vehículos y la clave fallaría.
   tabla   | filas
-----------+-------
 s_origin  |    28
 s_dest    |    28
 s_route   |   120
 s_vehicle |    24
 s_trip    |  5914
(5 rows)
28 agencias de origen y no 29: Iquitos - Centro no tiene viajes de salida,
así que la hoja nunca la tuvo como origen (tampoco como destino: es la
anomalía de inserción de antes). Después se
reconstruye la hoja con joins por los atributos comunes y se compara con la
original en los dos sentidos:
WITH joined AS (
  SELECT trip_id, departure_at, route_id, origin_agency, origin_city, dest_agency,
         dest_city, distance_km, base_fare, plate, kind, capacity_kg
  FROM s_trip
    JOIN s_route USING (route_id)
    JOIN s_origin USING (origin_agency)
    JOIN s_dest USING (dest_agency)
    JOIN s_vehicle USING (plate)
)
SELECT (SELECT count(*) FROM joined) AS reconstruida,
       (SELECT count(*) FROM (TABLE joined EXCEPT TABLE trip_sheet) AS x) AS de_mas,
       (SELECT count(*) FROM (TABLE trip_sheet EXCEPT TABLE joined) AS x) AS faltan;
reconstruida | de_mas | faltan
--------------+--------+--------
5914 | 0 | 0
(1 row)Ni una fila de más ni una de menos, como garantiza el algoritmo.
Primera forma normal y dominios atómicos
Todo lo anterior supone algo que dimos por hecho desde la semana 1: que cada valor es atómico.
Definición (Silberschatz, sec. 7.8). Un dominio es atómico si sus elementos se consideran unidades indivisibles. Un esquema R está en primera forma normal (1NF) si los dominios de todos sus atributos son atómicos.
Una columna cities con 'Lima, Cusco', o una columna phones con una
lista de teléfonos separados por comas, no es atómica: la aplicación la parte
para usarla, y la base de datos no puede hacer cumplir nada sobre sus partes
(ni una clave foránea hacia agency, ni un CHECK sobre cada teléfono). Lo
mismo con códigos que esconden estructura: si el código de un envío fuera
'LIM-2026-000123' y el programa extrajera la agencia de las tres primeras
letras, la agencia estaría guardada dentro de otro valor.
Atómico no es una propiedad del tipo de dato sino del uso. Un DNI es un texto de ocho dígitos; si nadie lo parte, es atómico. Una fecha tiene día, mes y año, pero se usa como una unidad. La teoría de dependencias funcionales supone 1NF: si un valor tiene partes, las dependencias entre esas partes no se ven.
En PostgreSQL. PostgreSQL tiene arreglos (
text[]) yjsonb, que no son atómicos. Tienen usos legítimos (las consultas de la semana 5 devolvieron arreglos conarray_agg), pero guardar en un arreglo algo que se va a buscar, unir o restringir suele ser un error de diseño: una tabla aparte, con una fila por elemento, deja que la base de datos haga su trabajo.
Teoría de dependencias funcionales
En la Sesión A hicimos varios razonamientos “a ojo”: que trip_id determina
todo, que AC → D se deduce de A → B y BC → D, que route_id
determina las ciudades. Esta parte los vuelve exactos.
La clausura F⁺ y los axiomas de Armstrong
Definición. F implica lógicamente a α → β si toda instancia que cumple todas las dependencias de F cumple también α → β. La clausura de F, F+, es el conjunto de todas las dependencias que F implica lógicamente.
F+ incluye a F, a todas las triviales y a todo lo que se deduce. Para deducir, Armstrong (1974) propuso tres reglas. Sean α, β, γ conjuntos de atributos; αγ es α ∪ γ.
- Reflexividad. Si β ⊆ α, entonces α → β.
- Aumento (augmentation). Si α → β, entonces γα → γβ.
- Transitividad. Si α → β y β → γ, entonces α → γ.
Los axiomas son:
- Correctos (sound): todo lo que deducen está en F+. Por ejemplo, el aumento: si dos tuplas coinciden en γα, coinciden en α, luego (por α → β) en β; como también coinciden en γ, coinciden en γβ. La transitividad se demuestra igual, encadenando.
- Completos (complete): todo lo que está en F+ se puede deducir con ellos. Esta demostración es más larga y está en la bibliografía del capítulo 7 del libro.
Juntos dicen que “se deduce con los axiomas” y “está en F+” son lo mismo.
Reglas derivadas
Con los axiomas se demuestran tres reglas más, cómodas en la práctica:
- Unión. Si α → β y α → γ, entonces α → βγ. Demostración. Aumentando α → γ con α: α → αγ. Aumentando α → β con γ: αγ → βγ. Por transitividad, α → βγ.
- Descomposición. Si α → βγ, entonces α → β y α → γ. Demostración. Por reflexividad, βγ → β. Por transitividad con α → βγ, α → β. Lo mismo para γ.
- Pseudotransitividad. Si α → β y γβ → δ, entonces αγ → δ. Demostración. Aumentando α → β con γ: αγ → γβ. Por transitividad con γβ → δ, αγ → δ.
Unión y descomposición dicen que el lado derecho se puede juntar y
separar libremente: plate → kind, capacity_kg es lo mismo que plate → kind
y plate → capacity_kg. El ejemplo AC → D de la Sesión A es
pseudotransitividad con α = A, β = B, γ = C, δ = D.
Error común. Separar el lado izquierdo. De AB → C no se deduce A → C. En la tabla de rutas,
origin_agency, dest_agency → route_id, peroorigin_agencysola no determina la ruta: de Lima - La Victoria salen varias.
Con los axiomas se puede calcular F+: aplicar las reglas a todo lo que se tiene hasta que no aparezca nada nuevo. Es correcto, pero F+ es exponencial en el número de atributos: solo las dependencias triviales con lado derecho no vacío de un esquema de n atributos son 3n − 2n, más de 527 000 para las doce columnas de la hoja de viajes. En la práctica casi nunca hace falta F+ completo: hace falta responder preguntas sobre él, y para eso está la clausura de atributos.
Clausura de un conjunto de atributos
Definición. La clausura de α bajo F, α+, es el conjunto de todos los atributos A tales que α → A está en F+.
Por la regla de unión, α → β está en F+ si y solo si β ⊆ α+. Calcular α+ es fácil:
algoritmo clausura(α, F)
  resultado := α
  repetir
    para cada β → γ en F
      si β ⊆ resultado, entonces resultado := resultado ∪ γ
  hasta que resultado no cambie
  devolver resultado
Por qué es correcto. Cada atributo que entra está justificado: al empezar, α → resultado por reflexividad; si α → resultado y β ⊆ resultado, entonces α → β (reflexividad y transitividad), y con β → γ, α → γ; por unión, α → resultado ∪ γ. Así que nunca agrega algo que no esté en α+. Que agrega todo lo que está en α+ es la parte más fina; el argumento está en el libro (sec. 7.4.2). Termina porque el resultado solo crece y no puede pasar de R.
El ciclo externo da a lo más |R| vueltas (cada una que no termina agrega al menos un atributo) y cada vuelta recorre F: en total, O(|R| · |F|) pruebas de inclusión. Hay versiones lineales en el tamaño de F, que el libro menciona.
Ejemplo del libro (sec. 7.4.2). R = (A, B, C, G, H, I), F = {A → B, A → C, CG → H, CG → I, B → H}. Calculemos (AG)+:
| Paso | Dependencia usada | resultado |
|---|---|---|
| inicio | AG | |
| 1 | A → B | ABG |
| 2 | A → C | ABCG |
| 3 | CG → H (ahora CG ⊆ resultado) | ABCGH |
| 4 | CG → I | ABCGHI |
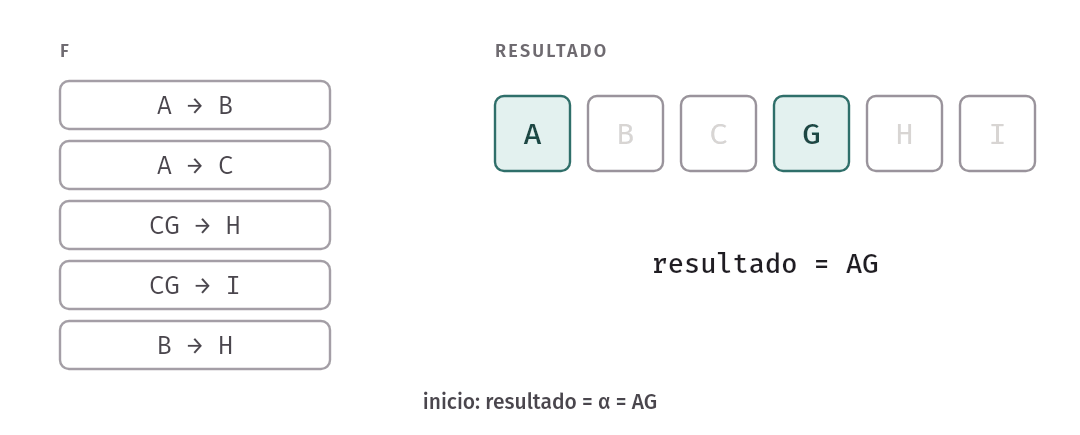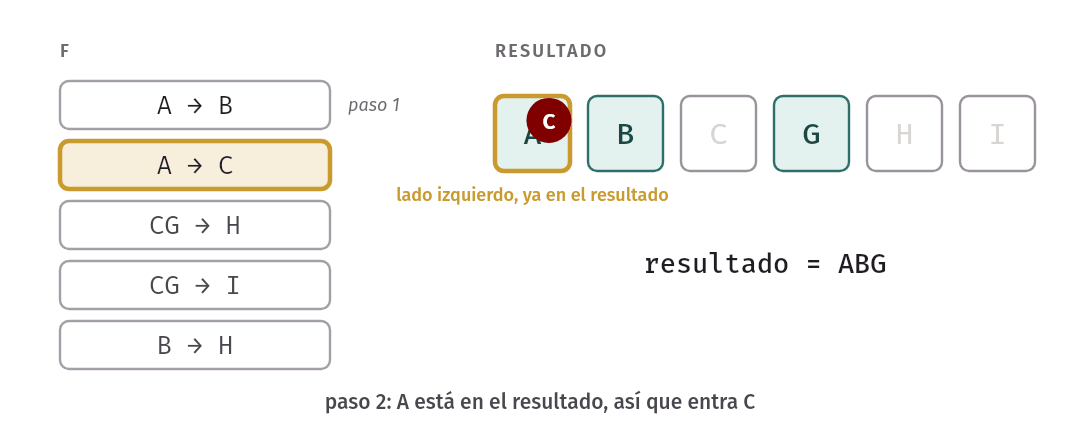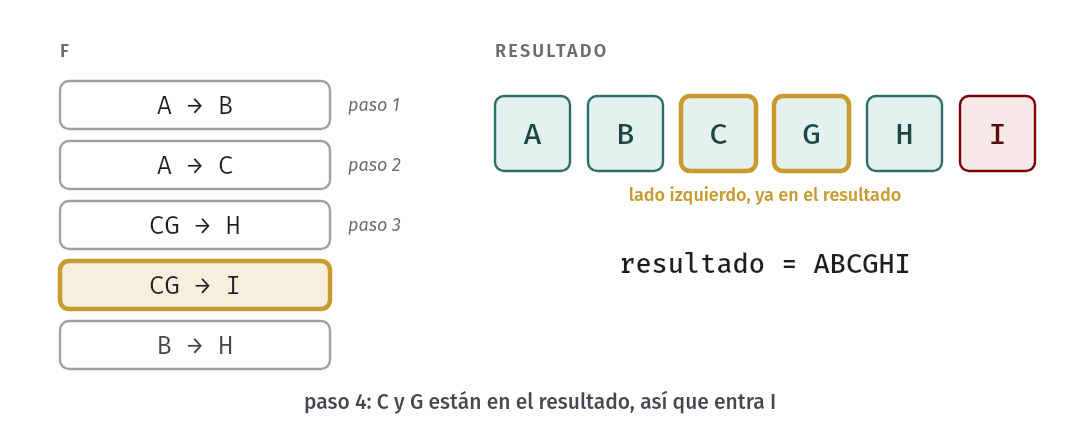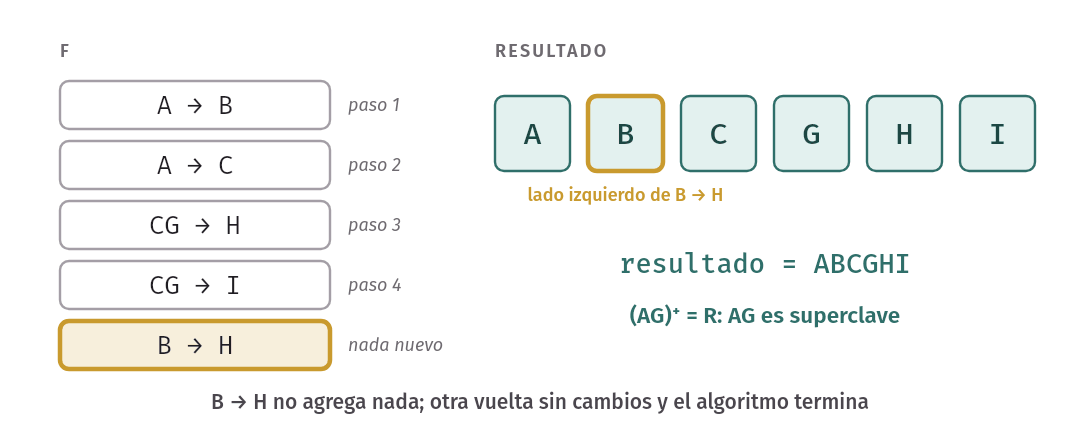
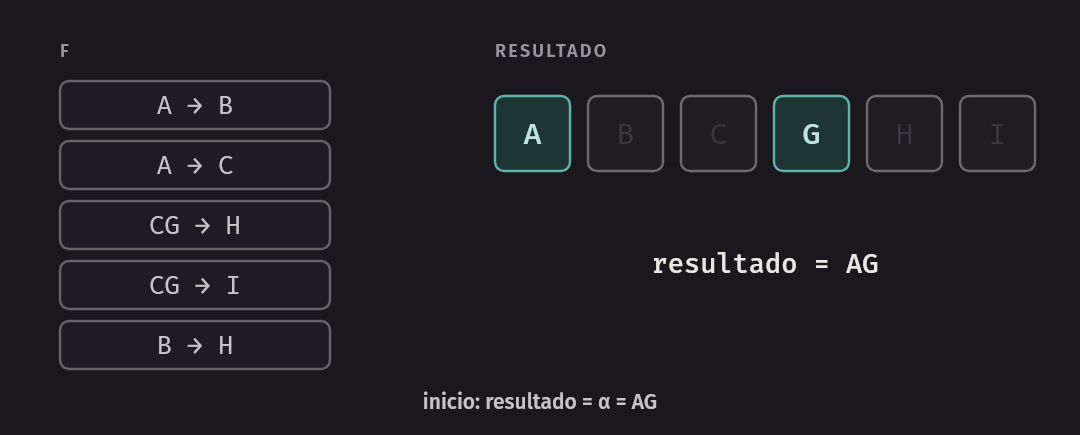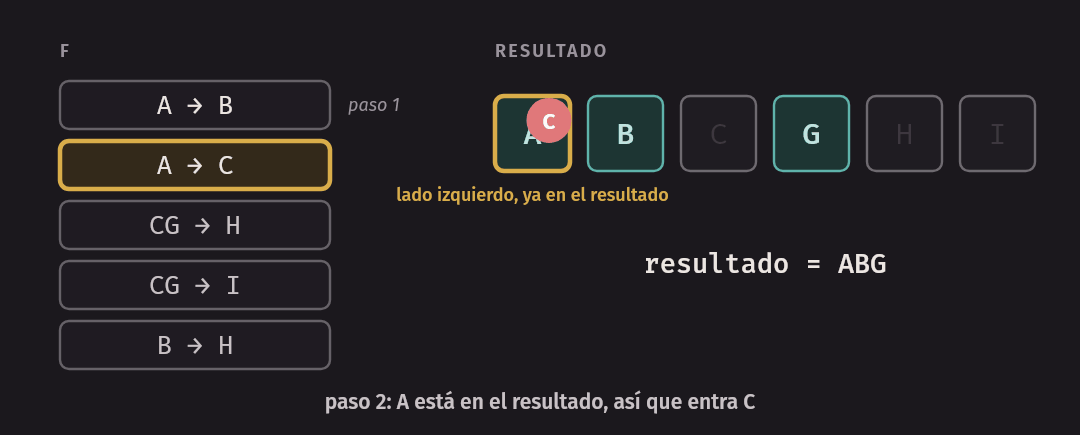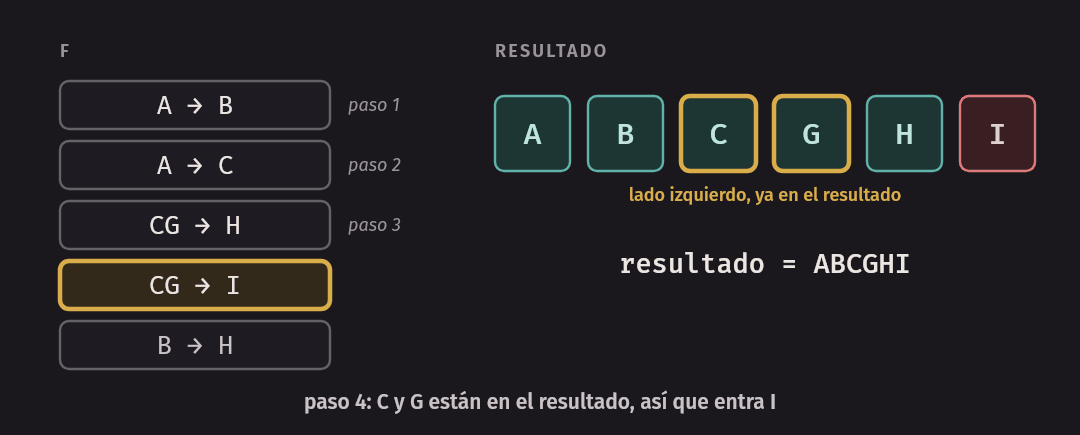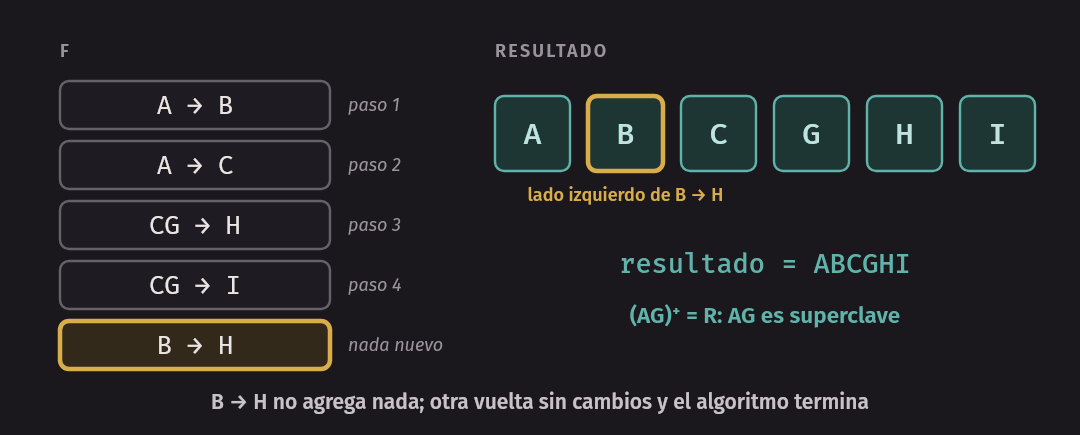
(AG)+ = R: AG es superclave. ¿Es clave candidata? Sus
subconjuntos propios: A+ = ABCH y G+ = G;
ninguno es R. Entonces AG es clave candidata. Así lo imprime node examples.mjs:
{AG}⁺:
  por A → B: {ABG}
  por A → C: {ABCG}
  por CG → H: {ABCGH}
  por CG → I: {ABCGHI}
  = {ABCGHI}
{A}⁺:
  por A → B: {AB}
  por A → C: {ABC}
  por B → H: {ABCH}
  = {ABCH}
claves candidatas: {AG}
En la hoja de viajes. {trip_id}+, con las seis dependencias
de F:
| Paso | Dependencia usada | Se agrega |
|---|---|---|
| inicio | trip_id |
|
| 1 | trip_id → departure_at, route_id, plate |
departure_at, route_id, plate |
| 2 | route_id → origin_agency, dest_agency, distance_km, base_fare |
origin_agency, dest_agency, distance_km, base_fare |
| 3 | origin_agency → origin_city |
origin_city |
| 4 | dest_agency → dest_city |
dest_city |
| 5 | plate → kind, capacity_kg |
kind, capacity_kg |
Las doce columnas: trip_id es superclave, y como tiene un solo atributo, es
clave candidata. En cambio {plate}+ = {plate, kind,
capacity_kg}, y {origin_agency, dest_agency}+ = {origin_agency,
dest_agency, route_id, origin_city, dest_city, distance_km,
base_fare}: el par de agencias determina toda la ruta, pero no el viaje.
Para qué sirve la clausura
Casi todas las preguntas de este capítulo se responden con una clausura:
- ¿Es α superclave de R? Sí, si α+ ⊇ R.
- ¿Está α → β en F+? Sí, si β ⊆ α+. Por ejemplo, en el ejemplo del libro, ¿AG → I? Sí. ¿B → C? B+ = BH, no.
- Calcular F+. Para cada γ ⊆ R, calcular γ+; por cada S ⊆ γ+, γ → S está en F+. Exponencial, pero sistemático.
- Encontrar las claves candidatas (siguiente subsección).
- Probar BCNF en una parte Ri, como vimos en la Sesión A, y probar si una descomposición es sin pérdida: (R1 ∩ R2)+ ⊇ R1 o ⊇ R2.
En la partición por ciudad de la Sesión A: {origin_city}+ =
{origin_city}, que no contiene ni (trip_id, origin_city) ni
(origin_city, origin_agency): con pérdida. En la partición por agencia:
{origin_agency}+ ⊇ {origin_agency, origin_city}: sin
pérdida.
Encontrar las claves candidatas
Una clave candidata es una superclave mínima. El método directo es probar los subconjuntos de R de menor a mayor tamaño, calcular su clausura y quedarse con los que dan R y no contienen una clave ya encontrada. Es exponencial, pero dos observaciones lo acortan mucho:
- Un atributo que no aparece en ningún lado derecho de F está en todas las claves: nada lo determina, así que solo se obtiene si ya estaba.
- Un atributo que aparece solo en lados derechos no está en ninguna clave: si está en una superclave, se puede sacar y la clausura no cambia.
En la hoja de viajes, el único atributo que no aparece a la derecha es
trip_id, y {trip_id}+ ya es R: es la única clave candidata.
En el ejemplo del libro, A y G no aparecen a la derecha, así que toda
clave contiene AG, y como AG ya es superclave, es la única.
Un caso con dos claves, que vamos a usar enseguida:
attention(customer_id, agency_id, executive_id), donde cada cliente tiene
un ejecutivo asignado en cada agencia que usa, y cada ejecutivo trabaja en una
sola agencia:
customer_id, agency_id → executive_idexecutive_id → agency_id
customer_id no aparece a la derecha: está en toda clave. {customer_id}+
= {customer_id}, no basta. Con dos atributos: {customer_id,
agency_id}+ = todo, y {customer_id, executive_id}+
= todo (por executive_id → agency_id). Hay dos claves candidatas:
{customer_id, agency_id} y {customer_id, executive_id}.
Cubierta canónica
Atributos extraños
Un mismo conjunto de reglas se puede escribir de muchas formas. Si alguien escribe para la hoja de viajes, además de las seis dependencias de F:
trip_id → origin_city(que se deduce detrip_id → route_id,route_id → origin_agencyyorigin_agency → origin_city), ytrip_id, plate → capacity_kg(dondetrip_idsobra, porque yaplate → capacity_kg, yplatetambién sobra, porque yatrip_id → plate),
no cambió nada: el conjunto nuevo tiene el mismo F+. Pero cada
dependencia de más es una restricción que la base de datos tendría que
verificar en cada UPDATE, y es ruido para los algoritmos. Queremos el
conjunto más chico equivalente.
Definición. Dos conjuntos de dependencias F y G son equivalentes si F+ = G+.
Sea α → β una dependencia de F.
- A ∈ α es extraño (extraneous) si F implica lógicamente (F − {α → β}) ∪ {(α − A) → β}.
- A ∈ β es extraño si (F − {α → β}) ∪ {α → (β − A)} implica lógicamente a F.
Las dos definiciones se prueban con una clausura, y hay que cuidar con qué conjunto se calcula:
- A la izquierda. A ∈ α es extraño si β ⊆ (α − A)+, calculada con F (el conjunto actual, que todavía incluye α → β).
- A la derecha. A ∈ β es extraño si A ∈ α+, calculada con F’ = (F − {α → β}) ∪ {α → (β − A)}, es decir, sin el atributo que se está probando. Si se calcula con F, A siempre aparece y todo parecería extraño.
Definición. Una cubierta canónica (canonical cover) Fc de F es un conjunto de dependencias tal que:
- Fc es equivalente a F;
- ninguna dependencia de Fc tiene atributos extraños;
- no hay dos dependencias de Fc con el mismo lado izquierdo.
El algoritmo
algoritmo cubierta_canónica(F)
  Fc := F
  repetir
    aplicar la regla de unión: reemplazar α → β1 y α → β2 por α → β1β2
    buscar en Fc una dependencia con un atributo extraño,
      a la izquierda o a la derecha
    si la hay, quitarle ese atributo
      (si el lado derecho queda vacío, quitar la dependencia)
  hasta que Fc no cambie
  devolver Fc
Hay que repetir la unión en cada vuelta: quitar un atributo de la izquierda puede dejar dos dependencias con el mismo lado izquierdo.
Ejemplo del libro (sec. 7.4.3). R = (A, B, C), F = {A → BC, B → C, A → B, AB → C}.
- Unión: A → BC y A → B se juntan en A → BC. Queda {A → BC, B → C, AB → C}.
- ¿C es extraño en A → BC? Con F’ = {A → B, B → C, AB → C}, A+ = ABC, que contiene a C. Sí. Queda {A → B, B → C, AB → C}.
- ¿A es extraño en AB → C? (AB − A)+ = B+ = BC ⊇ {C}. Sí. Queda B → C, que ya estaba: {A → B, B → C}.
- Ninguna de las dos tiene atributos extraños: Fc = {A → B, B → C}.
El libro prueba primero AB → C y después A → BC; el resultado es el
mismo. fd.mjs recorre las dependencias en orden y, en cada una, primero la
izquierda y después la derecha:
  C es extraño a la derecha en A → BC; queda {A → B; B → C; AB → C}
  A es extraño a la izquierda en AB → C; queda {A → B; B → C}
  Fc = {A → B; B → C}
La cubierta canónica no es única. Con F = {A → BC, B → AC,
C → AB} (también del libro), según el orden en que se quiten los
atributos extraños se llega a {A → B, B → C, C → A}, a {A →
C, C → B, B → A} o a otras. fd.mjs, con su orden, llega a una
tercera:
  B es extraño a la derecha en A → BC; queda {A → C; B → AC; C → AB}
  A es extraño a la derecha en B → AC; queda {A → C; B → C; C → AB}
  Fc = {A → C; B → C; C → AB}
Las tres son equivalentes a F y no tienen atributos extraños (las pruebas lo verifican).
En la hoja de viajes, con las dos dependencias de más del principio de la
sección, el algoritmo hace tres pasos: origin_city es extraño a la derecha
de trip_id → departure_at, route_id, plate, origin_city (la unión ya la
había juntado con la primera); en trip_id, plate → capacity_kg, plate es
extraño a la izquierda (trip_id solo ya determina capacity_kg), lo que deja
trip_id → capacity_kg, que la unión junta con la primera; y entonces
capacity_kg es extraño a la derecha. La cubierta canónica que queda son
exactamente las seis dependencias de F: nuestro F ya era canónico.
Preservación de dependencias
Definición
Volvamos a la tercera pregunta de la Sesión A. Después de descomponer, cada
dependencia de F es una regla que alguien tiene que hacer cumplir. Si
todos sus atributos están en una misma tabla, la base de datos la verifica con
una clave (o con un UNIQUE) al insertar en esa tabla. Si no, verificarla
requiere hacer un join en cada modificación.
Definición. Sea {R1, …, Rn} una descomposición de R y F sus dependencias. La restricción de F a Ri, Fi, es el conjunto de dependencias de F+ que solo usan atributos de Ri. La descomposición preserva dependencias (es dependency-preserving) si
(F1 ∪ … ∪ Fn)+ = F+.
Atención a la definición. Basta con que cada dependencia de F tenga todos sus atributos en alguna Ri, y casi siempre se comprueba así. Pero no es necesario: una dependencia puede no caber en ninguna tabla y aun así preservarse, porque se deduce de las que sí caben. Ejemplo: R(A, B, C), F = {A → B, B → C, A → C}, descompuesta en (A, B) y (B, C). A → C no cabe en ninguna, pero F1 ∪ F2 contiene A → B y B → C, que la implican. Si se verifican las dos primeras en sus tablas, la tercera se cumple sola.
Probarla sin calcular F⁺
Calcular cada Fi es exponencial. El libro (sec. 7.4.4) da una prueba que solo usa clausuras. Para cada α → β de F:
resultado := α
repetir
  para cada Ri de la descomposición
    t := (resultado ∩ Ri)⁺ ∩ Ri        -- la clausura se calcula con F
    resultado := resultado ∪ t
hasta que resultado no cambie
α → β se preserva si β ⊆ resultado
La idea: desde α, en cada tabla Ri se deduce lo que se puede deducir mirando solo esa tabla, y se pasa a la siguiente. Si así se llega a β, la dependencia se verifica combinando verificaciones locales.
En el ejemplo de ABC, para A → C: se empieza con {A}; en (A, B), ({A}+ ∩ AB) = AB; en (B, C), ({A, B} ∩ BC)+ ∩ BC = B+ ∩ BC = BC. Resultado ABC ⊇ {C}: se preserva. Si en cambio se descompone en (A, B) y (A, C), es B → C la que se pierde: desde {B}, ninguna tabla agrega nada.
La descomposición en BCNF de la hoja preserva las seis dependencias, y además de la manera fácil: cada una cabe en una tabla. No siempre es así.
BCNF no siempre preserva dependencias
Volvamos a attention(customer_id, agency_id, executive_id), con
customer_id, agency_id → executive_idexecutive_id → agency_id
executive_id no es superclave (no determina customer_id), así que
attention no está en BCNF. El algoritmo la parte por
executive_id → agency_id:
executive_agency(executive_id, agency_id), claveexecutive_id;customer_executive(customer_id, executive_id), clave(customer_id, executive_id).
Es sin pérdida (la parte común executive_id es clave de la primera) y las
dos tablas están en BCNF. Pero customer_id, agency_id → executive_id ya no
cabe en ninguna, y la prueba de arriba confirma que no se deduce de las que
quedan: desde {customer_id, agency_id}, la primera tabla no agrega nada
(agency_id no determina nada) y la segunda tampoco (customer_id solo no
determina nada). Se perdió.
En SQL (attention.sql, todo en una
transacción con ROLLBACK): los ejecutivos 101 y 102 trabajan en Cusco -
Wanchaq (agencia 6) y el 103 en Lima - La Victoria (agencia 1). Le asignamos
al cliente 1 los tres:
INSERT INTO executive_agency VALUES (101, 6), (102, 6), (103, 1);
INSERT INTO customer_executive VALUES (1, 101), (1, 102), (1, 103);
INSERT 0 3
INSERT 0 3Cada tabla acepta sus filas: ninguna clave se repite. Pero ahora el cliente 1 tiene dos ejecutivos en Cusco, y la regla perdida solo se ve con un join:
SELECT ce.customer_id, ea.agency_id,
       array_agg(ce.executive_id ORDER BY ce.executive_id) AS ejecutivos
FROM customer_executive ce
  JOIN executive_agency ea USING (executive_id)
GROUP BY ce.customer_id, ea.agency_id
HAVING count(DISTINCT ce.executive_id) > 1;
customer_id | agency_id | ejecutivos
-------------+-----------+------------
1 | 6 | {101,102}
(1 row)Es la consulta de refutación de la Sesión A, aplicada al join. Para que la
base de datos impidiera este estado, habría que correr esa consulta en cada
INSERT o UPDATE de cualquiera de las dos tablas, con un trigger.
Error común. Creer que BCNF siempre preserva dependencias. No: hay esquemas, como
attention, para los que ninguna descomposición en BCNF preserva todas las dependencias. Aquí la única forma de dejar de violar BCNF es separarexecutive_id → agency_id, y cualquier separación deja acustomer_id, agency_id, executive_iden tablas distintas.
Tercera forma normal
Definición
La 3NF relaja BCNF lo justo para que siempre se pueda preservar dependencias.
Definición. Un esquema R con dependencias F está en tercera forma normal (3NF) si para toda dependencia α → β de F+ con α ⊆ R y β ⊆ R, al menos una de estas se cumple:
- α → β es trivial;
- α es superclave de R;
- cada atributo A de β − α está contenido en alguna clave candidata de R.
La tercera condición es la nueva. Dos detalles: los atributos de β − α pueden estar en claves candidatas distintas, y la clave que contiene a A no tiene que ser la clave primaria. Toda relación en BCNF está en 3NF (las dos primeras condiciones son las de BCNF), pero no al revés.
Como con BCNF, para el esquema original basta revisar las dependencias de F (separando los lados derechos en atributos), no todo F+.
attention está en 3NF: en executive_id → agency_id, executive_id no
es superclave, pero agency_id es parte de la clave candidata
{customer_id, agency_id}. La otra dependencia sale de una superclave.
trip_sheet no está en 3NF: en route_id → base_fare, route_id no es
superclave y base_fare no está en ninguna clave candidata (la única es
{trip_id}). Es el caso clásico que muchos textos llaman dependencia
transitiva: trip_id → route_id → base_fare.
attention en 3NF, en SQL
En 3NF, attention queda como una sola tabla con clave (customer_id, agency_id), y la regla customer_id, agency_id → executive_id es esa clave.
La otra regla, executive_id → agency_id, no es una clave de attention, y
ese es el precio de 3NF: la agencia de cada ejecutivo se repite en cada fila
de cada cliente que atiende. En SQL se puede hacer cumplir igual, con una
tabla executive y una clave foránea compuesta:
CREATE TABLE executive (
  executive_id integer PRIMARY KEY,
  agency_id    integer NOT NULL REFERENCES agency,
  UNIQUE (executive_id, agency_id)
);
CREATE TABLE attention (
  customer_id  integer REFERENCES customer,
  agency_id    integer,
  executive_id integer NOT NULL,
  CONSTRAINT attention_pk PRIMARY KEY (customer_id, agency_id),
  CONSTRAINT attention_executive_fk FOREIGN KEY (executive_id, agency_id)
    REFERENCES executive (executive_id, agency_id)
);
INSERT INTO executive VALUES (101, 6), (102, 6), (103, 1);
INSERT INTO attention VALUES (1, 6, 101), (1, 1, 103);
El UNIQUE (executive_id, agency_id) parece inútil (executive_id ya es
clave), pero hace falta: una clave foránea solo puede apuntar a columnas con
PRIMARY KEY o UNIQUE. Ahora las dos violaciones de antes fallan:
INSERT INTO attention VALUES (1, 6, 102); -- otro ejecutivo para el cliente 1 en CuscoERROR: duplicate key value violates unique constraint "attention_pk"
DETAIL: Key (customer_id, agency_id)=(1, 6) already exists.INSERT INTO attention VALUES (2, 1, 101); -- el ejecutivo 101 en LimaERROR: insert or update on table "attention" violates foreign key constraint "attention_executive_fk"
DETAIL: Key (executive_id, agency_id)=(101, 1) is not present in table "executive".Este diseño no es BCNF (en attention, executive_id → agency_id sigue
saliendo de algo que no es superclave), pero las dos reglas las hace cumplir
el motor, sin triggers.
El algoritmo de síntesis en 3NF
A diferencia del de BCNF, que parte una tabla grande, este sintetiza tablas a partir de las dependencias:
algoritmo 3NF(R, F)
  Fc := una cubierta canónica de F
  resultado := ∅
  para cada α → β en Fc
    agregar el esquema α ∪ β a resultado
  si ningún esquema de resultado contiene una clave candidata de R
    agregar un esquema formado por una clave candidata de R
  quitar los esquemas contenidos en otro esquema de resultado
  devolver resultado
Por qué funciona (Silberschatz, sec. 7.5.3):
- Preserva dependencias, de la manera fácil: cada dependencia de Fc cabe en el esquema que se creó para ella, y Fc es equivalente a F. Quitar un esquema contenido en otro no pierde nada, porque el otro tiene todos sus atributos.
- Es sin pérdida gracias al esquema que contiene una clave candidata. El argumento del libro usa esa tabla como punto de partida: desde una clave K, las dependencias de Fc van agregando, tabla por tabla, el resto de los atributos sin inventar valores. Por eso ese paso no es opcional.
- Cada esquema está en 3NF. Es la parte más larga de la demostración y usa que Fc no tiene atributos extraños.
Ejemplo del libro: cust_banker_branch
Silberschatz (sec. 7.5.2) usa un banco: cust_banker_branch(customer_id, employee_id, branch_name, type), donde un cliente tiene un banquero
(employee_id) por sucursal, con un tipo de atención:
customer_id, employee_id → branch_name, typeemployee_id → branch_namecustomer_id, branch_name → employee_id
Es attention con un atributo más. Las claves candidatas son {customer_id,
employee_id} y {customer_id, branch_name}.
Paso 1, cubierta canónica. En la primera dependencia, branch_name es
extraño a la derecha: sin él, {customer_id, employee_id}+
sigue conteniendo branch_name, por employee_id → branch_name. No hay más
atributos extraños:
customer_id, employee_id → typeemployee_id → branch_namecustomer_id, branch_name → employee_id
Paso 2, un esquema por dependencia. (customer_id, employee_id,
type), (employee_id, branch_name) y (customer_id, branch_name,
employee_id).
Paso 3, la clave. El primer esquema contiene la clave {customer_id,
employee_id}: no hace falta agregar nada.
Paso 4, quitar los contenidos. (employee_id, branch_name) está dentro
de (customer_id, branch_name, employee_id): se quita.
Resultado:
- (
customer_id,employee_id,type) - (
customer_id,branch_name,employee_id)
La segunda tabla está en 3NF pero no en BCNF, por employee_id → branch_name: es attention. La salida de node examples.mjs:
claves candidatas: {branch_name, customer_id} {customer_id, employee_id}
Fc = {customer_id, employee_id → type; employee_id → branch_name; branch_name, customer_id → employee_id}
se quita (branch_name, employee_id), contenido en otro
  (customer_id, employee_id, type)
  (branch_name, customer_id, employee_id)
La hoja de viajes en 3NF. Con Fc = F (las seis
dependencias), el algoritmo crea seis esquemas. Uno de ellos,
(origin_agency, dest_agency, route_id), está contenido en el de
route_id → …, y se quita. Quedan las mismas cinco tablas que dio BCNF; la
primera, (trip_id, departure_at, route_id, plate), contiene la clave
trip_id. Cuando las dependencias son “cada cosa tiene su identificador”,
BCNF y 3NF coinciden.
Cuándo se agrega la clave. Con R(A, B, C) y F = {A → B}, la única clave es AC y el único esquema sintetizado es (A, B), que no la contiene. El algoritmo agrega (A, C). Sin ese esquema, C ni siquiera estaría en la descomposición.
BCNF o 3NF
Tenemos tres objetivos para un diseño:
- BCNF (sin redundancia debida a dependencias funcionales);
- descomposición sin pérdida;
- preservación de dependencias.
El algoritmo de BCNF siempre logra 1 y 2, y a veces 3. La síntesis en 3NF
siempre logra 2 y 3, y 1 a veces. attention muestra que no siempre se pueden
tener los tres. ¿Qué se prefiere?
- Primero BCNF. Si la descomposición en BCNF preserva las dependencias (lo más común, como en la hoja de viajes), no hay nada que pensar.
- 3NF cuando BCNF pierde una dependencia importante. Se acepta la
redundancia que deja 3NF (la agencia del ejecutivo repetida en cada fila de
attention) a cambio de que cada dependencia quede dentro de una sola tabla y se pueda verificar sin joins. - O BCNF y la dependencia perdida con un trigger (semana 5) que haga el join en cada modificación. Es más trabajo y más lento, pero no deja redundancia.
Hay que sumar una consideración práctica: SQL hace cumplir barato las claves
(PRIMARY KEY, UNIQUE) y las claves foráneas, y nada más. Una dependencia
funcional cuyo lado izquierdo es superclave de su tabla la hace cumplir esa
clave. Las demás necesitan un trigger o una aserción (CREATE ASSERTION, que
está en el estándar pero PostgreSQL no implementa), aunque estén dentro de
una sola tabla. Así pasa con executive_id → agency_id en la tabla
attention de 3NF: con solo la clave (customer_id, agency_id), nada impide
guardar (1, 6, 101) y (2, 1, 101), que ponen al ejecutivo 101 en dos
agencias. Por eso, en el diseño de la sección anterior, hizo falta la tabla
executive y la clave foránea compuesta: esa dependencia pasó a ser la clave
de executive, y la clave foránea obliga a attention a copiar el par
correcto. Lo que se logra con 3NF es que verificar una dependencia nunca
requiera un join; que la verifique una clave depende de cómo se armen las
tablas.
Idea clave. BCNF elimina toda redundancia que se pueda explicar con dependencias funcionales, pero puede obligar a verificar reglas con joins. 3NF siempre deja verificar cada regla dentro de una sola tabla, a cambio de algo de redundancia. Las dos son sin pérdida.
Dependencias multivaluadas y 4NF (opcional)
BCNF elimina la redundancia que viene de dependencias funcionales. Hay otra.
Supongamos que cada agencia tiene varios teléfonos y ofrece varios servicios
(embalaje, recojo a domicilio, seguro), y que los teléfonos no tienen nada
que ver con los servicios. Una tabla agency_info(agency_id, phone, service)
que los guarde juntos tiene que poner cada teléfono con cada servicio:
WITH agency_phone (agency_id, phone) AS (
  VALUES (6, '984111222'), (6, '984333444')
), agency_service (agency_id, service) AS (
  VALUES (6, 'embalaje'), (6, 'recojo'), (6, 'seguro')
)
SELECT agency_id, phone, service
FROM agency_phone JOIN agency_service USING (agency_id)
ORDER BY phone, service;
agency_id | phone | service
-----------+-----------+----------
6 | 984111222 | embalaje
6 | 984111222 | recojo
6 | 984111222 | seguro
6 | 984333444 | embalaje
6 | 984333444 | recojo
6 | 984333444 | seguro
(6 rows)Dos teléfonos por tres servicios, seis filas. Agregar un servicio exige
agregar una fila por teléfono; si falta una, la tabla “dice” que ese servicio
no se ofrece por ese teléfono, lo que no significa nada. Sin embargo
agency_info no tiene ninguna dependencia funcional no trivial (una agencia
tiene varios teléfonos y varios servicios), su única clave es la tabla
completa, y está en BCNF.
Definición (Silberschatz, sec. 7.6). La dependencia multivaluada α ↠ β vale en R si en toda instancia válida, para todo par de tuplas t1, t2 con t1[α] = t2[α], existen tuplas t3, t4 en r tales que
- t3[α] = t4[α] = t1[α];
- t3[β] = t1[β] y t3[R − α − β] = t2[R − α − β];
- t4[β] = t2[β] y t4[R − α − β] = t1[R − α − β].
En palabras: para un valor de α, los valores de β y los del resto son
independientes; se combinan todos con todos. En agency_info, agency_id ↠ phone (y, por simetría, agency_id ↠ service). Toda dependencia funcional
es también multivaluada: si α → β, se puede tomar t3 =
t2 y t4 = t1.
Definición. R está en cuarta forma normal (4NF) respecto de un conjunto D de dependencias funcionales y multivaluadas si para toda α ↠ β de D+ con α, β ⊆ R, se cumple alguna de estas: α ↠ β es trivial (β ⊆ α o α ∪ β = R), o α es superclave de R.
agency_info no está en 4NF: agency_id ↠ phone no es trivial y agency_id
no es superclave. La descomposición es la misma idea que en BCNF: separar
α ∪ β, es decir agency_phone(agency_id, phone) y agency_service(agency_id, service), que es lo que habría salido del modelo E-R con dos atributos
multivaluados. Es sin pérdida: una descomposición de R en R1 y
R2 es sin pérdida si y solo si R1 ∩ R2
↠ R1 (o ↠ R2). Aquí la parte común es agency_id,
que no es superclave de ninguna de las dos partes: el criterio con
dependencias funcionales no lo habría detectado.
Toda relación en 4NF está en BCNF. En la práctica, las dependencias multivaluadas aparecen casi siempre así: dos atributos multivaluados independientes metidos en la misma tabla.
El código de la semana y make test
Dentro del contenedor, en code/week-07, make crea la base de datos
chasqui_w07 y le agrega la hoja de viajes; make test la vuelve a crear y
corre las pruebas:
$ make test
chasqui-load chasqui_w07
Base de datos chasqui_w07 lista.
psql -X -q -v ON_ERROR_STOP=1 -d chasqui_w07 -f trip_sheet.sql
PGDATABASE=chasqui_w07 node --test --test-concurrency=1 --test-reporter=spec
✔ attrs y fd arman conjuntos ordenados
✔ libro: {AG}⁺ = ABCGHI, paso a paso
✔ libro: AG es la única clave candidata; A y G solos no son superclave
...
✔ trip_sheet: descomposición en BCNF, cuatro pasos sin pérdida
...
✔ partir por origin_city agrega 5110 filas falsas y no pierde ninguna
✔ partir por origin_agency es sin pérdida
✔ la descomposición en BCNF de trip_sheet: claves y join sin diferencias
...
ℹ tests 35
ℹ pass 35
ℹ fail 0
...| Archivo | Qué contiene |
|---|---|
trip_sheet.sql |
La hoja de viajes, construida con joins de las tablas de Chasqui |
examples.sql |
Las anomalías, las consultas que refutan dependencias, la partición con y sin pérdida y el ejemplo de 4NF |
decompose.sql |
La descomposición en BCNF de la hoja, con sus claves, y la reconstrucción |
attention.sql |
attention en BCNF (pierde una dependencia) y en 3NF (con la clave foránea compuesta) |
fd.mjs |
Los algoritmos del capítulo: clausura, claves, BCNF, cubierta canónica, sin pérdida, preservación y 3NF |
examples.mjs |
Los ejemplos resueltos; node examples.mjs imprime sus trazas |
sqlfile.mjs |
Lee las consultas marcadas -- name: ... de un archivo .sql |
fd.test.mjs |
Pruebas de fd.mjs con cada ejemplo del capítulo |
sql.test.mjs |
Pruebas de los archivos .sql contra los resultados de este capítulo |
fd.mjs representa un conjunto de atributos como un arreglo ordenado de
textos y una dependencia como { lhs, rhs }. Para escribirlas rápido,
fd('route_id -> distance_km base_fare') y fds('A -> B; CG -> H') (con
letras mayúsculas pegadas, cada letra es un atributo, como en el libro):
import { fds, closure, candidateKeys, bcnfDecompose } from './fd.mjs';

const F = fds('A -> B; A -> C; CG -> H; CG -> I; B -> H');
closure('AG', F);                 // [ 'A', 'B', 'C', 'G', 'H', 'I' ]
candidateKeys('ABCGHI', F);       // [ [ 'A', 'G' ] ]
bcnfDecompose('ABCGHI', F).schemas;
Cada función sigue el pseudocódigo de este capítulo, y los comentarios dicen
cuál. Dos detalles de implementación que importan: bcnfViolation prueba los
subconjuntos de la tabla con la clausura (no solo las dependencias de F),
así que funciona en una parte de una descomposición; y todos los recorridos
van en un orden fijo, así que el resultado de bcnfDecompose y de
canonicalCover es siempre el mismo. Los algoritmos que prueban subconjuntos
son exponenciales en el número de atributos; para tablas de una docena de
columnas es instantáneo.
fd.mjs les sirve para comprobar sus cálculos a mano, no para
reemplazarlos: el trabajo difícil de normalizar es escribir F a partir de
los requisitos, y eso ninguna función lo hace.
Resumen
- Una tabla que junta hechos sobre cosas distintas los repite, y la redundancia produce anomalías de actualización (una copia cambia y otra no), de inserción (no hay dónde guardar algo sin lo otro) y de borrado (borrar una cosa borra otra).
- Una dependencia funcional α → β vale en R si en toda instancia
válida, dos tuplas que coinciden en α coinciden en β. Es trivial si
β ⊆ α. K es superclave si K → R. Las dependencias salen de los
requisitos; los datos pueden refutarlas (
GROUP BY α HAVING count(DISTINCT β) > 1), nunca demostrarlas. Ojo:count(DISTINCT ...)ignora losNULL. - Una descomposición en R1, R2 es sin pérdida si el join de las proyecciones devuelve siempre r. Siempre devuelve al menos r; una con pérdida agrega tuplas falsas. Criterio: es sin pérdida si R1 ∩ R2 → R1 o → R2 está en F+.
- BCNF: toda dependencia no trivial de F+ sale de una superclave. En el esquema original basta mirar F; en una parte de una descomposición hay que mirar F+ (con clausuras). El algoritmo de BCNF parte por una dependencia que viola, en α ∪ β y Ri − β; cada paso es sin pérdida. El resultado no es único.
- 1NF: dominios atómicos. La teoría de dependencias la supone.
- Axiomas de Armstrong: reflexividad, aumento y transitividad; correctos y completos. Derivadas: unión, descomposición y pseudotransitividad. El lado derecho se separa; el izquierdo no.
- Clausura α+: se agrega γ cada vez que β → γ y β ⊆ resultado. Sirve para decidir si α es superclave, si α → β está en F+, para encontrar claves candidatas y para probar BCNF y sin pérdida.
- Cubierta canónica: equivalente a F, sin atributos extraños, sin dos lados izquierdos iguales. Atributo extraño a la izquierda: β ⊆ (α − A)+ con F; a la derecha: A ∈ α+ con F’. No es única.
- Preservación de dependencias: (F1 ∪ … ∪ Fn)+
= F+. Que cada dependencia de F quepa en una tabla basta pero
no es necesario. BCNF no siempre la logra (
attention). - 3NF: como BCNF, pero también se acepta α → β si cada atributo de β − α está en alguna clave candidata. La síntesis en 3NF (cubierta canónica, una tabla por dependencia, una con clave si falta, quitar las contenidas) es siempre sin pérdida y preserva dependencias.
- Se prefiere BCNF; se acepta 3NF si BCNF pierde una dependencia importante, o se queda en BCNF y se verifica la perdida con un trigger.
- (Opcional) Una dependencia multivaluada α ↠ β dice que, para cada α, los valores de β y los del resto se combinan todos con todos. 4NF separa esas combinaciones; toda relación en 4NF está en BCNF.
Ejercicios
- En
trip_sheet, den un ejemplo concreto (con valores de Chasqui) de cada anomalía que tenga que ver con las agencias, no con los vehículos ni las rutas. Para la de inserción, usenIquitos - Centro. ¿Cuántas filas habría que cambiar siLima - Atese mudara a otra ciudad? Escriban la consulta que lo cuenta. - Escriban la consulta que refuta
dest_agency → dest_cityentrip_sheety la que refutaroute_id → plate. ¿Qué devuelve cada una? Después, encustomer, pruebenfirst_name, last_name → dniyphone → customer_id. Para cada una digan si los datos la refutan y si, de todas formas, la pondrían en F. - Demuestren con los axiomas de Armstrong (diciendo qué axioma o regla usan en cada paso): a) si α → β y γ → δ, entonces αγ → βδ; b) si α → β y β → γ, entonces α → βγ; c) Construyan una instancia de R(A, B, C) con tres tuplas que cumpla AB → C pero no A → C.
- R(A, B, C, D, E, G) con F = {AB → C, C → D,
D → A, BE → G}. Calculen a mano (AB)+,
(BC)+ y (BE)+. Encuentren todas las claves
candidatas, usando la observación sobre los atributos que no aparecen a la
derecha. Comprueben con
candidateKeysdefd.mjs. - Con el R y el F del ejercicio 4, ¿cuáles dependencias de F violan BCNF? Apliquen el algoritmo de BCNF a mano y digan en cada paso por qué la partición es sin pérdida. ¿El resultado preserva dependencias? Usen la prueba con clausuras para cada dependencia de F. ¿Obtienen lo mismo eligiendo las violaciones en otro orden?
- Calculen una cubierta canónica de F = {A → BC, CD → E, B → D,
E → A, AB → D} mostrando en cada paso qué atributo es extraño y con
qué clausura lo comprobaron. Comparen con
canonicalCover. - En la partición por ciudad de la Sesión A sobraron 5110 filas. Sin
ejecutarla, calculen cuántas sobrarían si se partiera
(trip_id, plate, kind)en(trip_id, kind)y(kind, plate). Usen los conteos de vehículos por tipo y de viajes por tipo (escriban esas dos consultas). Después escriban la consulta de comparación y verifiquen. - Para
attention, prueben que ninguna descomposición de(customer_id, agency_id, executive_id)en dos tablas de dos atributos es a la vez sin pérdida, en BCNF y preservadora de dependencias. (Hay tres formas de elegir los dos atributos de cada tabla.) - En el diseño en 3NF de
attentioncon la clave foránea compuesta, ¿qué pasa si se intenta mover al ejecutivo 101 a la agencia 1 conUPDATE executive SET agency_id = 1 WHERE executive_id = 101? Pruébenlo dentro de una transacción conROLLBACK. ¿Qué acción referencial (semana 4) habría que poner en la clave foránea para que el cambio se propague aattention? ¿Es eso una anomalía de actualización? - Apliquen la síntesis en 3NF a R(A, B, C, D, E) con F = {A → B, B → C, CD → E}. ¿Hace falta agregar un esquema con una clave? ¿Por qué el resultado sería con pérdida sin él? Muéstrenlo con una instancia de dos tuplas.
- Agreguen a
fd.mjsuna funciónproject(F, Ri)que devuelva una cubierta canónica de la restricción de F a Ri (las dependencias de F+ con atributos en Ri), usando la clausura de cada subconjunto de Ri. Pruébenla con el ejemplo R(A, B, C, D, E), F = {A → B, BC → D} y R2 = (A, C, D, E): debe devolver AC → D. Escriban la prueba connode:test. - (Opcional, 4NF) Una agencia tiene varios empleados y varios vehículos
asignados, y cualquier empleado puede usar cualquier vehículo. Escriban la
dependencia multivaluada, digan por qué
agency_staff(agency_id, employee_id, plate)está en BCNF pero no en 4NF, y descompónganla. Si en cambio cada empleado tuviera vehículos asignados solo a él, ¿seguiría valiendo la dependencia multivaluada?