
Apuntes · Capítulo 6Diseño de bases de datos
El modelo entidad-relación
El modelo entidad-relación
Hasta ahora el esquema de Chasqui nos llegó hecho. En la semana 1 lo leímos,
en las semanas 2 a 5 lo consultamos y en P1 lo están endureciendo con
restricciones. Nadie nos dijo de dónde salió: por qué hay una tabla route y
no una columna destination en trip, por qué shipment_event tiene una
clave de dos columnas, por qué el teléfono del cliente es una columna y no una
tabla. Esas decisiones se toman antes de escribir CREATE TABLE, y esta
semana empezamos a estudiar cómo se toman.
La herramienta es el modelo entidad-relación (E-R): las cosas que hay (entidades), sus propiedades (atributos) y los vínculos entre ellas (relaciones). Un diagrama E-R se discute con quien conoce el negocio, que no sabe SQL, y después se traduce a tablas casi de manera mecánica. La semana que viene veremos la otra mitad del diseño, la normalización.
En la primera parte construimos el modelo y lo aplicamos al revés: tomamos el esquema de Chasqui y reconstruimos el diagrama del que pudo salir. En la segunda traducimos un diagrama a tablas, con una biblioteca universitaria como ejemplo, y vemos el E-R extendido y las decisiones de diseño que no tienen una única respuesta.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “El proceso de diseño” y “Entidades y atributos”. Sesión B: “El ejemplo: una biblioteca universitaria” y “Conjuntos de entidades fuertes”, de “De E-R a tablas”.
- En clase. Sesión A: “Relaciones”, “Cardinalidades y participación”, “Claves”, “Atributos redundantes” y “El diagrama E-R de Chasqui”. Sesión B: “De E-R a tablas”, “E-R extendido”, “Decisiones de diseño” y “Otras notaciones”.
- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 6.1–6.10. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-06, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
El proceso de diseño
Silberschatz (sec. 6.1) divide el diseño de una base de datos en fases:
- Requisitos. Entender qué datos necesita la organización y qué preguntas les va a hacer, conversando con los usuarios. El resultado es una especificación en palabras, casi siempre incompleta y ambigua.
- Diseño conceptual. Escribir los requisitos en un modelo de datos: aquí entra el diagrama E-R, todavía sin tablas ni tipos. Se revisa con los usuarios (“¿un envío puede ir en dos viajes?”) y se especifican las operaciones que la base de datos debe soportar.
- Diseño lógico. Traducir el diagrama a tablas con claves primarias, claves foráneas y restricciones.
- Diseño físico. Índices, organización de archivos, particionamiento: la parte 3 del curso.
El libro insiste en dos peligros: la redundancia (el mismo dato en dos lugares, que tarde o temprano dejan de coincidir) y la incompletitud (una parte del negocio que no se puede representar, o solo con trucos). No existe el diagrama de un negocio, sino diagramas mejores o peores para las preguntas que la base de datos debe responder.
En este capítulo hacemos además ingeniería inversa: reconstruir el diagrama E-R del que pudo salir el esquema de Chasqui. Es lo que les toca hacer cuando llegan a una empresa con una base de datos de años y sin documentación.
Entidades y atributos
Conjuntos de entidades
Una entidad (entity) es una cosa del mundo que se distingue de las demás: la agencia de Cusco - Centro, la clienta con DNI 45127788, el envío 1. Un conjunto de entidades (entity set) es un conjunto de entidades del mismo tipo, que comparten las mismas propiedades: todas las agencias, todos los clientes, todos los envíos. Al conjunto de entidades que existen en un momento dado se le llama su extensión, como la instancia de una tabla.
Cada entidad se describe con atributos (attributes): name, city y
region para una agencia. Formalmente, un atributo de un conjunto de
entidades E es una función que asigna a cada entidad de E un valor de un
dominio (el value set del libro): region asigna a cada agencia un texto
de la lista de regiones del Perú. Una entidad queda descrita por el conjunto
de pares (atributo, valor), uno por cada atributo.
La entidad y su representación no son lo mismo: si dos entidades distintas quedan con los mismos valores en todos sus atributos, la base de datos no las puede distinguir. Necesitamos una clave, que vemos más adelante.
Error común. Confundir la relación del modelo E-R (relationship, un vínculo entre entidades) con la relación del modelo relacional (relation, una tabla). En E-R,
sender(un envío tiene como remitente a un cliente) es un rombo; en el esquema relacional, cualquier tabla es una relación, incluidacustomer. En este capítulo, relación es siempre la del modelo E-R; cuando hablemos del modelo relacional diremos tabla o esquema de relación.
Tipos de atributos
Silberschatz (sec. 6.3) clasifica los atributos en tres ejes independientes.
Simples o compuestos. Un atributo simple no se divide en partes que
interesen por separado (weight_kg). Uno compuesto (composite) sí: el
nombre de un cliente tiene nombres y apellidos, y Chasqui quiere ordenar por
apellido. Los compuestos pueden anidarse: una dirección con calle (nombre,
número) y distrito. En el esquema de Chasqui el nombre ya llega partido en
first_name y last_name: es lo que queda de un atributo compuesto
name (first_name, last_name) después de traducirlo a tablas.
Monovaluados o multivaluados. Un atributo monovaluado (single-valued)
tiene un valor por entidad: un envío tiene un peso. Uno multivaluado
(multivalued) tiene un conjunto de valores: si un cliente puede dejar varios
teléfonos, phone es multivaluado y se escribe {phone}. En Chasqui, phone
es monovaluado y opcional; 259 de los 1800 clientes no lo tienen. Que sea uno
u otro no lo decide la tabla sino el negocio: ¿Chasqui quiere guardar el
celular y además el teléfono fijo?
Almacenados o derivados. Un atributo derivado (derived) se calcula a
partir de otros, y se escribe con paréntesis: duration(). La duración de un
viaje se deriva de su salida y su llegada, así que no se guarda; se calcula
al consultar (trip_duration en queries.sql,
con arrival_at - departure_at):
 trip_id |      departure_at      |       arrival_at       | duration
---------+------------------------+------------------------+----------
       1 | 2026-01-05 06:00:00-05 | 2026-01-05 14:30:00-05 | 08:30:00
       2 | 2026-01-05 06:00:00-05 | 2026-01-05 22:45:00-05 | 16:45:00
       3 | 2026-01-05 06:00:00-05 | 2026-01-05 08:15:00-05 | 02:15:00
(3 rows)
Guardar un derivado es guardar dos veces la misma información, con el riesgo de que dejen de coincidir. A veces se hace igual, por rendimiento o porque calcularlo es caro, y entonces alguien (un trigger, la aplicación) tiene que mantenerlo al día.
Un atributo puede ser nulo: el valor no existe (un viaje que todavía no
llegó no tiene arrival_at; hay 14 así) o no se conoce. Ya vimos en la semana
3 lo que cuesta un NULL; en el diagrama, que un atributo admita nulos es una
decisión que se anota.
En la notación del libro, un conjunto de entidades es un rectángulo partido en
dos: arriba el nombre, abajo los atributos, con la clave primaria subrayada.
Los componentes de un compuesto van con sangría debajo de él, los
multivaluados entre llaves y los derivados con paréntesis. En texto no se
puede subrayar, así que en estos apuntes marcamos la clave con PK:
+----------------------+       +-----------------------+
| customer             |       | trip                  |
+----------------------+       +-----------------------+
| customer_id      PK  |       | trip_id           PK  |
| dni                  |       | departure_at          |
| name                 |       | arrival_at            |
|    first_name        |       | duration ()           |
|    last_name         |       +-----------------------+
| {phone}              |
| city                 |
+----------------------+
El {phone} de la izquierda es la versión en la que Chasqui decide guardar
varios teléfonos. Lo traduciremos a tablas en la Sesión B.
Relaciones
Conjuntos de relaciones
Una relación (relationship) es un vínculo entre varias entidades: el envío 1 tiene como remitente al cliente 178, Luis Mamani Chávez. Un conjunto de relaciones (relationship set) es un conjunto de relaciones del mismo tipo.
Definición. Sean E₁, E₂, …, Eₙ conjuntos de entidades (no necesariamente distintos). Un conjunto de relaciones R sobre ellos es un subconjunto de
{(e₁, e₂, …, eₙ) | e₁ ∈ E₁, e₂ ∈ E₂, …, eₙ ∈ Eₙ}
Cada (e₁, …, eₙ) ∈ R es una relación. Se dice que los Eᵢ participan en R, y n es el grado de R.
Dos consecuencias de la definición, que usaremos mucho:
- R es un conjunto: una misma combinación de entidades aparece a lo más
una vez. Si la clienta 7 se lleva el mismo libro dos veces, un conjunto de
relaciones
borrowsentre clientes y libros no lo puede registrar como dos relaciones. Volveremos a esto al diseñar la biblioteca. - Una relación vincula entidades, no valores. En el diagrama no se escribe
“
shipmenttiene un atributosender_id”; se dibuja un rombosenderentreshipmentycustomer. Elsender_idaparecerá recién al traducir a tablas.
En el diagrama, un conjunto de relaciones es un rombo unido con líneas a
los conjuntos de entidades que participan. Casi todas las relaciones son
binarias (grado 2). Las de grado mayor son raras pero existen: en una
clínica, prescribes(doctor, patient, drug) dice qué médico le recetó qué
medicamento a qué paciente, y no se puede partir en tres binarias sin perder
información (lo vemos en la sección de decisiones de diseño).
Roles
Las entidades de una relación cumplen un rol (role): el papel que tienen
en ella. Casi siempre el rol es obvio por el conjunto de entidades y no se
escribe. Deja de serlo cuando el mismo conjunto de entidades participa más de
una vez. Un envío tiene dos clientes, uno que lo manda y otro que lo recibe:
sin roles, un rombo entre shipment y customer no dice cuál es cuál.
Hay dos formas de dibujarlo. Una es usar dos conjuntos de relaciones
distintos, sender y recipient, cada uno entre shipment y customer.
La otra aparece cuando un conjunto de entidades se relaciona consigo
mismo: una relación recursiva. Si pensamos una ruta como un vínculo entre
dos agencias, es un conjunto de relaciones connects entre agency y
agency, y las dos líneas llevan su rol escrito encima, origin y
destination:
                   origin
     +---------+ ---------- < connects >
     | agency  |                  |
     +---------+ -----------------+
                 destination
Sin los roles, el par (Lima, Cusco) no dice si la ruta va de Lima a Cusco o al
revés. En el esquema de Chasqui los roles se ven en los nombres de las
columnas: origin_agency_id y dest_agency_id en route, sender_id y
recipient_id en shipment.
Atributos descriptivos
Un conjunto de relaciones también puede tener atributos, llamados
descriptivos (descriptive attributes). Son datos que no son de ninguno de
los participantes sino del vínculo. Si la ruta fuera la relación connects,
la distancia y la tarifa base serían atributos de la relación: no son de Lima
ni de Cusco, son del par. En el diagrama, los atributos de una relación van en
un rectángulo unido al rombo con una línea punteada.
Un caso más claro es el de un libro y sus autores, que usaremos en la Sesión B: el orden en que aparecen los autores en la tapa (Silberschatz primero, Korth segundo, Sudarshan tercero) no es un dato del libro ni del autor, sino de que ese autor escribió ese libro.
Un atributo descriptivo no sirve para distinguir relaciones: dos relaciones con las mismas entidades son la misma, aunque difieran en sus atributos descriptivos.
Cardinalidades y participación
Cardinalidades de mapeo
La cardinalidad de mapeo (mapping cardinality) de un conjunto de relaciones binario R entre A y B dice con cuántas entidades del otro lado se puede vincular cada entidad. Silberschatz (sec. 6.4) define cuatro casos:
| Cardinalidad | Cada entidad de A se vincula con | Cada entidad de B se vincula con |
|---|---|---|
| uno a uno | a lo más una de B | a lo más una de A |
| uno a muchos de A a B | cualquier número (cero o más) de B | a lo más una de A |
| muchos a uno de A a B | a lo más una de B | cualquier número de A |
| muchos a muchos | cualquier número de B | cualquier número de A |
“Uno a muchos de A a B” y “muchos a uno de B a A” son la misma restricción leída desde los dos lados. En el resto del capítulo decimos siempre desde qué lado leemos.
En Chasqui y en la biblioteca de la Sesión B:
senderes muchos a uno deshipmentacustomer: cada envío tiene a lo más un remitente; un cliente puede mandar muchos envíos.travels_on, entreshipmentytrip, es muchos a uno deshipmentatrip: un envío va en a lo más un viaje; un viaje lleva muchos envíos.writes, entre libros y autores, es muchos a muchos: un libro tiene varios autores y un autor escribe varios libros.- Un ejemplo de uno a uno: en una biblioteca, cada socio tiene a lo más un casillero asignado y cada casillero es de a lo más un socio.
La cardinalidad es una restricción sobre todas las instancias válidas, no
una descripción de los datos de hoy. Se decide con preguntas al negocio:
¿puede un envío partirse en dos viajes? ¿puede un viaje llevar varios envíos?
Los datos solo pueden refutar una cardinalidad, nunca probarla. Si
encontramos un viaje con dos envíos, travels_on no es uno a uno; pero que
los datos de hoy cumplan algo no dice que sea una regla. La consulta
shipments_per_trip cuenta los envíos de cada viaje y toma el mínimo y el
máximo:
 min_shipments | max_shipments
---------------+---------------
             1 |            10
(1 row)
Que ningún viaje lleve más de 10 envíos es un dato de esta instancia, no una
regla de Chasqui. Lo que sí impone el esquema es que un envío no tenga dos
viajes: shipment.trip_id es una sola columna.
Idea clave. Una cardinalidad responde a la pregunta “¿qué puede pasar?”, no a “¿qué pasa hoy?”. Se obtiene de los requisitos y se verifica con quien conoce el negocio. Una consulta sobre los datos sirve para encontrar contraejemplos, no para justificar una restricción.
Participación total y parcial
La cardinalidad dice “a lo más uno” o “muchos”. Falta decir si puede ser cero. La participación de un conjunto de entidades E en R es total si toda entidad de E participa en al menos una relación de R, y parcial si puede haber entidades de E que no participan en ninguna.
En Chasqui:
- La participación de
shipmentensenderes total: no hay envío sin remitente. La decustomerensenderes parcial: hay clientes que nunca mandaron nada (solo recibieron, o se registraron y no volvieron). La consultacustomers_never_sentdequeries.sqllos cuenta:
 never_sent
------------
         82
(1 row)travels_ones parcial de los dos lados. Un envío recién registrado todavía no tiene viaje, y un viaje puede salir sin carga (shipment_trip_participationytrips_without_shipments):
 without_trip | shipments
--------------+-----------
          500 |     12000
(1 row)

 trips_without_shipments
-------------------------
                    1038
(1 row)- La participación de
agencyen el origen de las rutas es parcial: hay una agencia sin ninguna ruta, ni de ida ni de vuelta (agencies_without_routes):
 agency_id |       name
-----------+------------------
        29 | Iquitos - Centro
(1 row)
Tiene sentido: a Iquitos no se llega por carretera.
Con la participación vale lo mismo que con la cardinalidad. Hoy todos los
vehículos tienen viajes (la consulta vehicles_without_trips de
queries.sql da 0). Pero un camión que se acaba de comprar todavía no hizo ningún viaje, así que
la participación de vehicle en uses es parcial. El esquema lo permite: se
puede insertar un vehículo sin viajes (la prueba
queries.test.mjs lo hace dentro de una
transacción que termina en ROLLBACK).
Error común. Leer “uno a muchos” como “al menos uno”. La cardinalidad da un máximo (uno o muchos); la participación da un mínimo (cero o uno). Son dos restricciones distintas y el diagrama anota las dos.
Cómo se dibuja
En la notación de Silberschatz:
- Una línea simple entre el rombo y el rectángulo no restringe nada: cada entidad puede participar en cualquier número de relaciones (lado “muchos”).
- Una flecha que apunta al rectángulo dice “a lo más uno” de ese lado. En
sender, la flecha apunta acustomer: dado un envío, hay a lo más un cliente que lo manda. - Una línea doble entre el rectángulo y el rombo dice que la participación de ese conjunto de entidades es total.
En texto, en estos apuntes, <sender> es el rombo, --- la línea simple,
--> la flecha y === la línea doble (|| si va en vertical); /_\ es la
punta de flecha hueca de la especialización. El remitente de un envío:
+----------+                       +----------+
| shipment | ======== <sender> --> | customer |
+----------+                       +----------+
  total, muchos                      parcial, a lo más uno por envío
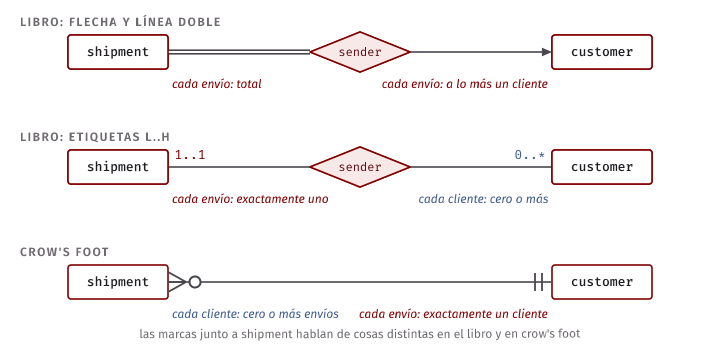
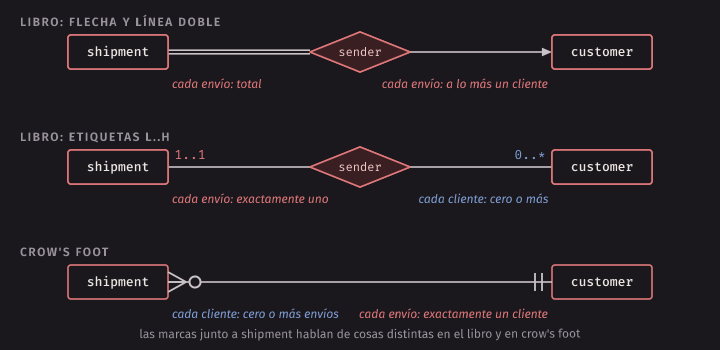
Cada envío participa en exactamente una relación sender (línea doble y
flecha del otro lado); cada cliente, en cero o más.
La notación del libro tiene además una forma más precisa: una etiqueta
l..h sobre la línea, con el mínimo l y el máximo h de relaciones en que
puede participar cada entidad de ese lado. 0..* es parcial y sin máximo;
1..1, total y a lo más una; 1..*, total y sin máximo.
+----------+  1..1                  0..*  +----------+
| shipment | --------- <sender> --------- | customer |
+----------+                              +----------+
Aquí 1..1 está junto a shipment y habla de cada envío: participa en
exactamente un sender. 0..* está junto a customer y habla de cada
cliente: participa en cero o más.
Error común. La etiqueta l..h del libro habla del conjunto de entidades junto al que está. En crow’s foot y en UML es al revés: la marca junto a
customerdice cuántos clientes le tocan a cada envío. El mismo1..1cambia de significado según la notación. Antes de leer un diagrama, averigüen en qué notación está.
Con eso podemos dibujar las cuatro cardinalidades entre A y B:
uno a uno               A <-- <R> --> B
uno a muchos de A a B   A <-- <R> --- B     (flecha hacia A: cada B tiene a lo más un A)
muchos a uno de A a B   A --- <R> --> B     (flecha hacia B: cada A tiene a lo más un B)
muchos a muchos         A --- <R> --- B
En una relación de grado mayor que 2, una flecha hacia E dice que, fijadas las entidades de todos los demás lados, hay a lo más una de E. Silberschatz permite a lo más una flecha en una relación no binaria: con dos flechas, el diagrama se puede leer de dos formas que no son equivalentes, y para evitar la confusión se prohíbe.
La misma relación en crow’s foot
Casi todas las herramientas de diseño (dbdiagram.io, MySQL Workbench, los diagramas que genera un ORM) usan la notación crow’s foot (“pata de gallo”). No hay rombos: una relación binaria es una línea entre dos rectángulos, y en cada extremo van dos marcas. La de afuera, junto al rectángulo, es el máximo; la de adentro, el mínimo:
| Marca en el extremo de B | Mínimo | Máximo | Se lee |
|---|---|---|---|
|| (dos barras) |
1 | 1 | exactamente un B |
o| (círculo y barra) |
0 | 1 | cero o un B |
|< (barra y pata) |
1 | muchos | uno o más B |
o< (círculo y pata) |
0 | muchos | cero o más B |
La marca junto a B dice cuántos B le corresponden a cada A. El remitente, en las dos notaciones:
Silberschatz:   shipment ====== <sender> --> customer
crow's foot:    shipment >o---------------|| customer
Junto a customer, ||: cada envío tiene exactamente un cliente remitente.
Junto a shipment, o< (dibujado >o porque mira hacia la izquierda): cada
cliente tiene cero o más envíos. En crow’s foot, una relación muchos a muchos
no se puede dibujar con atributos ni con más de dos participantes: se dibuja
de una vez la tabla intermedia, que vemos en la Sesión B. Por eso crow’s foot
está más cerca del diseño lógico, y la notación del libro, del conceptual.
Claves
Claves de un conjunto de entidades
Las definiciones de la semana 2 se trasladan tal cual. Un conjunto de atributos K es una superclave de un conjunto de entidades E si en ninguna instancia válida hay dos entidades de E con los mismos valores en K. Una clave candidata es una superclave minimal, y la clave primaria es la candidata que el diseñador elige. Como antes, la clave es una restricción sobre todas las instancias válidas, no una propiedad de los datos de hoy.
En customer, tanto customer_id como dni son claves candidatas; el
esquema eligió customer_id como primaria (un cliente extranjero no tiene
DNI) y declaró dni como UNIQUE.
Claves de un conjunto de relaciones
Una relación se identifica por las entidades que vincula. Sea R un conjunto de
relaciones entre E₁, …, Eₙ, y sea pk(Eᵢ) la clave primaria de Eᵢ. Como R es
un conjunto de tuplas de entidades,
pk(E₁) ∪ pk(E₂) ∪ … ∪ pk(Eₙ)
es una superclave de R. Si dos participantes tienen atributos de clave con
el mismo nombre (dos veces agency_id en la relación recursiva connects),
se renombran con el rol: origin_agency_id, dest_agency_id. Los atributos
descriptivos no forman parte de la clave: dos relaciones con las mismas
entidades son la misma.
Que esa superclave sea además minimal depende de la cardinalidad. Para una relación binaria R entre A y B (sec. 6.5):
| Cardinalidad de R | Clave primaria de R |
|---|---|
| muchos a muchos | pk(A) ∪ pk(B) |
| muchos a uno de A a B | pk(A) |
| uno a muchos de A a B | pk(B) |
| uno a uno | pk(A) o pk(B): las dos son candidatas |
La regla se entiende con un ejemplo. sender es muchos a uno de shipment a
customer: dado un envío, su remitente es uno solo. Entonces shipment_id
basta para identificar la relación; agregarle customer_id no distingue nada
nuevo. En cambio, en writes un libro aparece con varios autores y un
autor con varios libros: hacen falta los dos.
En una relación no binaria sin flechas, la clave es la unión de todas. Con una flecha hacia E, la clave es la unión de las de todos los demás participantes (fijados ellos, E queda determinado).
Entidades débiles
Mírenlo en los datos: los eventos de seguimiento del envío 1
(events_of_shipment_1).
 shipment_id | seq |           at           | agency_id |   kind
-------------+-----+------------------------+-----------+-----------
           1 |   1 | 2026-01-28 19:46:00-05 |         9 | received
           1 |   2 | 2026-02-02 12:00:00-05 |         9 | departed
           1 |   3 | 2026-02-02 16:30:00-05 |         8 | arrived
           1 |   4 | 2026-02-04 18:30:00-05 |         8 | delivered
(4 rows)
¿Qué identifica a un evento? Sus propios atributos no: el evento 1 de cada
envío se llama seq = 1 (seq_is_not_a_key cuenta los eventos con
seq = 1):
 events_with_seq_1
-------------------
             12000
(1 row)
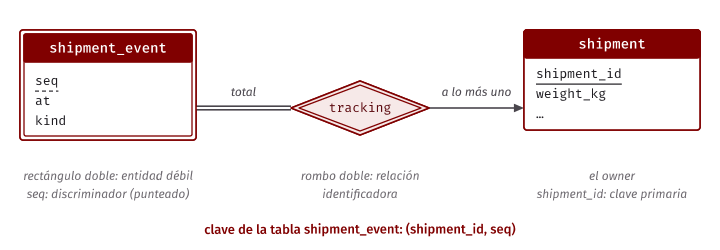
Un evento solo tiene sentido como “el tercer evento del envío 1”. Esto es una entidad débil (weak entity).
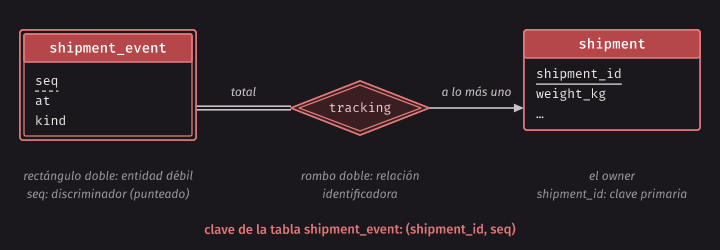
Definición. Un conjunto de entidades débil es uno cuya existencia depende de otro conjunto de entidades, su conjunto identificador (identifying entity set, el owner), y cuyos atributos no bastan para formar una clave primaria. Se vincula con el owner por una relación identificadora (identifying relationship) que es muchos a uno del débil al owner, con participación total del débil. El discriminador (discriminator) es el conjunto de atributos que distingue a las entidades débiles que dependen de un mismo owner. La clave primaria del conjunto débil es la clave primaria del owner más el discriminador.
Para shipment_event: el owner es shipment, la relación identificadora se
puede llamar tracking, el discriminador es seq y la clave primaria es
(shipment_id, seq), que es justo la que declara schema.sql. Un conjunto de
entidades que no es débil se llama fuerte (strong).
En el diagrama, el conjunto débil va en un rectángulo doble, la relación identificadora en un rombo doble, con línea doble del lado del débil y flecha hacia el owner, y el discriminador se subraya con una línea punteada:
Tres detalles que se suelen olvidar:
- El owner no aparece como atributo del débil.
shipment_idno está en el rectángulo deshipment_event: está implícito en la relación identificadora y aparece recién en la tabla. - La participación del débil en la relación identificadora es siempre total:
un evento sin envío no existe. La del owner puede ser total o parcial. En
Chasqui, todo envío tiene al menos su evento
received, pero eso es una regla del negocio, no una consecuencia de queshipment_eventsea débil. - Un conjunto débil también puede participar en otras relaciones, como uno
fuerte. Cada evento ocurre en una agencia: es la relación
happened_at, muchos a uno deshipment_eventaagency, total del lado del evento.
¿Podría shipment_event ser fuerte? Sí: bastaría darle un identificador propio
en todo el sistema, event_id. Entonces el evento tendría una clave propia,
pero seguiría haciendo falta la relación con su envío (en la tabla, la columna
shipment_id) para saber de qué envío es, y el diagrama ya no diría que un
evento no existe sin su envío. Las dos opciones son correctas; la débil dice
más del negocio.
En PostgreSQL. El libro traduce una entidad débil con una clave foránea hacia el owner con
ON DELETE CASCADE: si el owner desaparece, sus entidades débiles también.schema.sqlno lo hace: la clave foránea deshipment_eventno dice nada al borrar, así que se aplica la acción por defecto (NO ACTION) y borrar un envío con eventos falla.ERROR: update or delete on table "shipment" violates foreign key constraint "shipment_event_shipment_id_fkey" on table "shipment_event" DETAIL: Key (shipment_id)=(1) is still referenced from table "shipment_event".Qué debe pasar al borrar cada fila referenciada en Chasqui es una de las decisiones que P1 les pide justificar.
Atributos redundantes
Si traducimos a ciegas cada columna de shipment a un atributo del
conjunto de entidades, el rectángulo queda así:
shipment(shipment_id, sender_id, recipient_id, origin_agency_id,
         dest_agency_id, trip_id, weight_kg, declared_value, price,
         status, created_at, delivered_at)
Silberschatz (sec. 6.6) dice que eso está mal en un diagrama E-R. sender_id
repite lo que ya dice la relación sender: si el diagrama tiene el rombo y
además el atributo, el mismo hecho está dos veces. Lo mismo recipient_id,
origin_agency_id, dest_agency_id y trip_id. En el diagrama, un atributo
que es la clave primaria de otro conjunto de entidades se quita, y queda
la relación. La clave foránea aparece recién al traducir a tablas, y aparece
sola: la traducción la genera a partir de la relación.
Lo que queda en el rectángulo de shipment son sus atributos propios:
shipment_id, weight_kg, declared_value, price, status, created_at
y delivered_at. Igual con trip (salen route_id y vehicle_id), route
(salen las dos agencias) y shipment_event (salen shipment_id, que va en la
relación identificadora, y agency_id).
Con el diagrama limpio aparecen otras redundancias, más sutiles. status
parece un atributo propio, pero casi se deriva del último evento del envío:
SELECT s.status, e.kind AS last_event, count(*) AS shipments
FROM shipment s
  JOIN LATERAL (SELECT kind
                FROM shipment_event e
                WHERE e.shipment_id = s.shipment_id
                ORDER BY seq DESC
                LIMIT 1) AS e ON true
GROUP BY s.status, e.kind
ORDER BY s.status, e.kind;
status | last_event | shipments
------------+------------+-----------
delivered | delivered | 11115
in_transit | arrived | 53
in_transit | departed | 13
registered | received | 500
returned | returned | 319
(5 rows)En los datos de ejemplo, el estado coincide siempre con el último evento
(in_transit cubre dos tipos de evento). Y delivered_at repite el instante
del evento delivered (delivered_at_vs_event):
 delivered_events | different
------------------+-----------
            11115 |         0
(1 row)
En el diagrama, status() y delivered_at() se podrían anotar como
derivados. Guardarlos es una decisión de diseño legítima (la pantalla de la
agencia los lee miles de veces al día, y calcularlos cuesta un join), pero
entonces hay que mantenerlos al día, y eso no lo garantiza ninguna restricción
del esquema de partida.
Hay otra redundancia que ya conocen: un envío tiene agencia de origen y de destino, y su viaje tiene una ruta, que también tiene origen y destino. Son dos caminos en el diagrama que llevan al mismo dato. P1 les pide que el esquema los mantenga de acuerdo; aquí solo nos interesa notar que el diagrama los muestra.
Idea clave. En un diagrama E-R, el vínculo con otra entidad se dibuja como relación, nunca como un atributo con la clave del otro. Un atributo que se puede calcular a partir de otros es derivado. Un diagrama limpio hace visibles las redundancias que una tabla esconde en sus columnas.
El diagrama E-R de Chasqui
Juntando todo, este es el diagrama del que pudo salir schema.sql. Los
atributos de cada conjunto de entidades, con la clave primaria marcada:
| Conjunto de entidades | Atributos |
|---|---|
agency |
agency_id PK, name, city, region |
customer |
customer_id PK, dni, name (first_name, last_name), phone, city |
vehicle |
vehicle_id PK, plate, kind, capacity_kg |
route |
route_id PK, distance_km, base_fare |
trip |
trip_id PK, departure_at, arrival_at, duration() |
shipment |
shipment_id PK, weight_kg, declared_value, price, status, created_at, delivered_at |
shipment_event (débil) |
seq discriminador, at, kind |
Y los conjuntos de relaciones, todos binarios y todos muchos a uno del primer
participante al segundo. La última columna dice dónde quedó cada relación en
schema.sql; la usaremos en la Sesión B:
| Relación | Participantes | Participación | Columna en schema.sql |
|---|---|---|---|
sender |
shipment, customer |
total / parcial | shipment.sender_id |
recipient |
shipment, customer |
total / parcial | shipment.recipient_id |
sent_from |
shipment, agency |
total / parcial | shipment.origin_agency_id |
sent_to |
shipment, agency |
total / parcial | shipment.dest_agency_id |
travels_on |
shipment, trip |
parcial / parcial | shipment.trip_id (admite NULL) |
follows |
trip, route |
total / parcial | trip.route_id |
uses |
trip, vehicle |
total / parcial | trip.vehicle_id |
route_from |
route, agency |
total / parcial | route.origin_agency_id |
route_to |
route, agency |
total / parcial | route.dest_agency_id |
tracking (identificadora) |
shipment_event, shipment |
total / total | shipment_event.shipment_id (parte de la clave) |
happened_at |
shipment_event, agency |
total / parcial | shipment_event.agency_id |
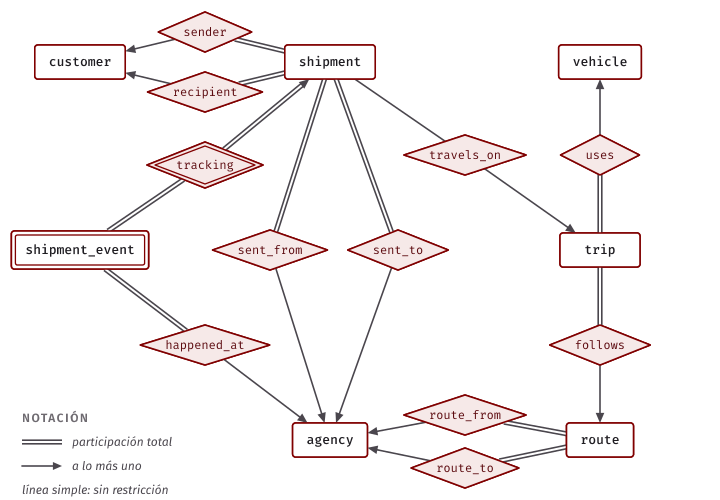
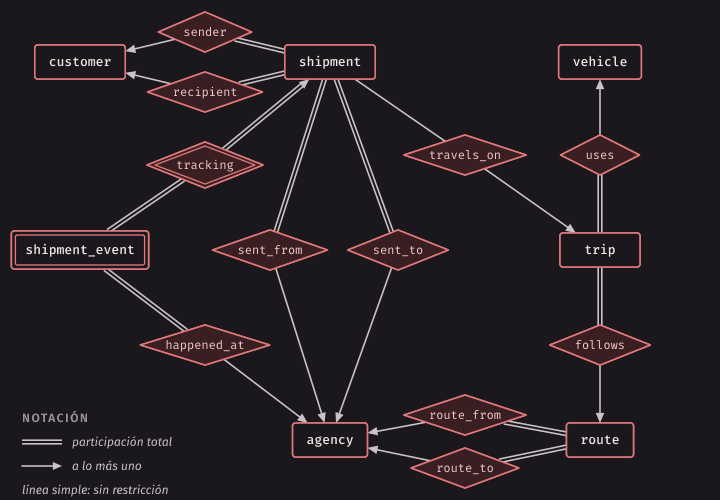
La participación del lado derecho es la que pide el negocio, no la que
muestran los datos. route en follows es parcial porque una ruta nueva no
tiene viajes todavía; shipment en tracking es total porque Chasqui
registra el evento received al recibir el paquete. La columna “total” del
lado izquierdo, en cambio, se puede leer en el esquema: es exactamente la de
las claves foráneas NOT NULL.
Error común. Dibujar una relación por cada clave foránea sin pensar. Funciona en Chasqui porque
schema.sqlestá bien armado, pero el camino correcto es el inverso: primero el diagrama, después las claves foráneas. Al revés, se copian al diagrama los errores del esquema.
¿Ruta es una entidad o una relación?
route podría ser el conjunto de relaciones connects entre agency y
agency, con roles origin y destination y atributos descriptivos
distance_km y base_fare. Sería muchos a muchos (de Lima salen rutas a
muchas agencias y a Cusco llegan rutas de muchas), y su clave sería el par de
agencias. schema.sql deja ver ese par: UNIQUE (origin_agency_id, dest_agency_id) declara que también es clave candidata.
El problema es que trip se relaciona con una ruta: cada viaje sigue una. En
el modelo E-R básico una relación vincula entidades, no relaciones, así que
follows no podría apuntar a connects. Hay dos salidas: tratar connects
como entidad mediante agregación, que vemos en la Sesión B, o hacer de
route un conjunto de entidades con su propio route_id. Chasqui eligió la
segunda, que es la más simple. Cuando algo tiene relaciones propias, tiende a
ser una entidad.
De E-R a tablas
La Sesión B hace el camino de ida: un diagrama se traduce a un esquema relacional, con reglas casi mecánicas (Silberschatz, sec. 6.7). Las estudiamos con un ejemplo completo y nuevo, en el que cada regla aparece por lo menos una vez.
El ejemplo: una biblioteca universitaria
La biblioteca de una facultad nos pasa estos requisitos:
- De cada libro se guarda el ISBN, el título y el año. Todo libro tiene una sola editorial (nombre, ciudad) y al menos un autor; un autor puede tener varios libros. Importa el orden de los autores en la tapa.
- De un libro hay varios ejemplares físicos, numerados 1, 2, 3 dentro de cada libro, con su fecha de adquisición. Si el libro se da de baja, sus ejemplares también.
- Los socios tienen DNI, nombre y apellido, fecha de alta y teléfonos (pueden dejar varios, o ninguno). Cada socio es estudiante (con código y facultad) o docente (con departamento), nunca las dos cosas.
- Hay casilleros numerados, en distintos pisos. A un socio se le asigna a lo más un casillero y un casillero es de a lo más un socio.
- Un socio se lleva un ejemplar en préstamo, con fecha de salida, fecha de vencimiento y fecha de devolución. El mismo socio puede llevarse el mismo ejemplar muchas veces. Un ejemplar no puede estar en dos préstamos sin devolver.
- La biblioteca quiere ver cuántos ejemplares tiene cada libro y cuántos están disponibles.
Los conjuntos de entidades y sus atributos:
| Conjunto de entidades | Atributos |
|---|---|
publisher |
publisher_id PK, name, city |
book |
isbn PK, title, pub_year, copies(), available() |
author |
author_id PK, name (first_name, last_name) |
copy (débil de book) |
copy_no discriminador, acquired_on |
loan |
loan_id PK, loaned_on, due_on, returned_on |
member |
member_id PK, dni, name (first_name, last_name), joined_on, {phone} |
student, teacher (subclases de member) |
student_code, faculty; department |
locker |
locker_no PK, floor |
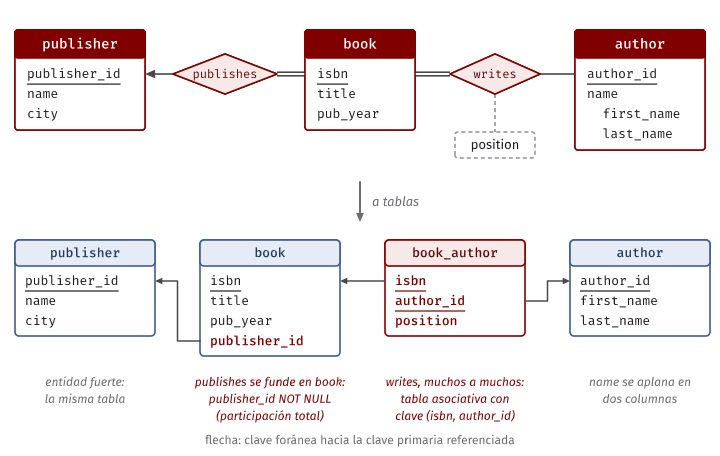
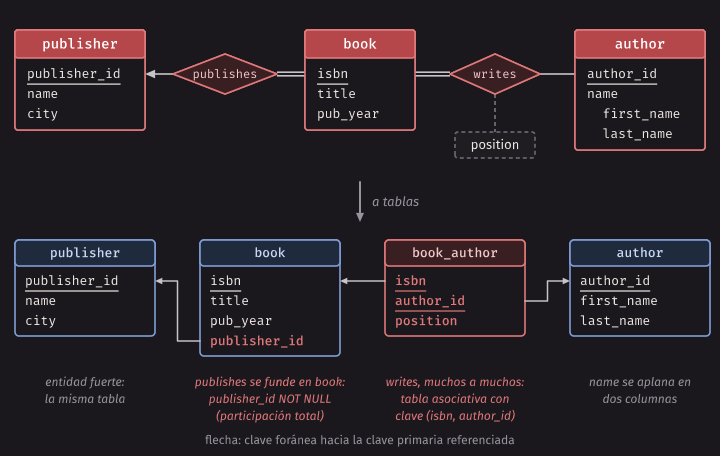
Y las relaciones, en la notación de texto de estos apuntes (las diapositivas tienen el diagrama dibujado):
book   == <publishes> -->   publisher
book   == <writes> -----    author       atributo descriptivo: position
copy   == <<has_copy>> -->  book         relación identificadora
loan   == <loan_of> --->    copy
loan   == <borrows> --->    member
member <-- <assigned> -->   locker       uno a uno, parcial de los dos lados
member se especializa en student y teacher: disjunta y total
copies() y available() son derivados. La especialización de member la
vemos en la sección de E-R extendido; por ahora basta saber que un socio es
estudiante o docente. loan es una entidad y no una relación por el requisito 5, que
discutimos en la sección de decisiones de diseño.
La traducción completa está en
library.sql, en el esquema library de la
base de datos chasqui_w06 (no toca las tablas de Chasqui). Vamos regla por
regla.
Conjuntos de entidades fuertes
Regla. Un conjunto de entidades fuerte E con atributos simples a₁, …, aₙ se traduce en una tabla E(a₁, …, aₙ) con la misma clave primaria.
CREATE TABLE publisher (
  publisher_id integer PRIMARY KEY,
  name         text NOT NULL,
  city         text NOT NULL,
  CONSTRAINT publisher_name_uq UNIQUE (name)
);
Al traducir hay que agregar lo que el diagrama no dice o dice en otro lugar:
los tipos de PostgreSQL, qué atributos son NOT NULL, las otras claves
candidatas (UNIQUE) y los CHECK de dominio.
Atributos compuestos. No se crea una columna para el compuesto, sino una
por cada componente simple (se aplana). name (first_name, last_name) se
vuelve dos columnas:
CREATE TABLE author (
  author_id  integer PRIMARY KEY,
  first_name text NOT NULL,
  last_name  text NOT NULL
);
Si dos compuestos tienen componentes con el mismo nombre (la calle de la
dirección de casa y la del trabajo), se prefijan: home_street,
work_street.
Atributos multivaluados. Una columna no puede guardar un conjunto (la 1NF
de la semana que viene lo exige), así que un multivaluado {phone} de E se
traduce en una tabla aparte, con la clave primaria de E y el atributo. La
clave de la tabla nueva son todas sus columnas, y lleva una clave foránea
hacia E:
CREATE TABLE member_phone (
  member_id integer NOT NULL,
  phone     text NOT NULL,
  CONSTRAINT member_phone_pk PRIMARY KEY (member_id, phone),
  CONSTRAINT member_phone_ck CHECK (phone ~ '^9[0-9]{8}$'),
  CONSTRAINT member_phone_member_fk FOREIGN KEY (member_id) REFERENCES member ON DELETE CASCADE
);
Un socio con dos teléfonos tiene dos filas; uno sin teléfono, ninguna. La
clave (member_id, phone) impide repetir un teléfono del mismo socio. El
libro menciona un caso especial: si un conjunto de entidades no tiene más que
su clave y un atributo multivaluado, se puede omitir su tabla y quedarse solo
con la del multivaluado. El costo: la clave de la entidad, sola, ya no es
clave de ninguna tabla, así que las demás tablas no pueden declarar una clave
foránea hacia esa entidad.
¿Y si los requisitos dijeran “uno o más teléfonos”? (Ana, la socia 3, no
dejó ninguno.) Esa participación mínima
no la puede expresar member_phone: un socio sin filas en ella es válido.
Volvemos a este problema al final de la sección.
Atributos derivados. No se guardan. Si se quieren consultar como si
estuvieran en la tabla, se define una vista. copies() y available() de
book:
CREATE VIEW book_stock AS
SELECT b.isbn, b.title,
       count(c.copy_no) AS copies,
       count(c.copy_no) FILTER (WHERE NOT EXISTS (
         SELECT 1 FROM loan l
         WHERE l.isbn = c.isbn AND l.copy_no = c.copy_no AND l.returned_on IS NULL)) AS available
FROM book b
  LEFT JOIN copy c ON c.isbn = b.isbn
GROUP BY b.isbn, b.title;
isbn | title | copies | available
---------------+--------------------------+--------+-----------
9786120000011 | Los ríos profundos | 2 | 1
9786120000028 | La ciudad y los perros | 1 | 1
9786120000035 | Database System Concepts | 3 | 2
9786120000042 | Trilce | 0 | 0
(4 rows)El LEFT JOIN y count(c.copy_no) (no count(*)) hacen que Trilce, sin
ejemplares, salga con 0: el error común de la semana 4.
Entidades débiles
Regla. Un conjunto de entidades débil A, con owner B, se traduce en una tabla con la clave primaria de B más los atributos de A. Su clave primaria es la de B más el discriminador, y tiene una clave foránea hacia B.
CREATE TABLE copy (
  isbn        text NOT NULL,
  copy_no     integer NOT NULL,
  acquired_on date NOT NULL,
  CONSTRAINT copy_pk PRIMARY KEY (isbn, copy_no),
  CONSTRAINT copy_no_ck CHECK (copy_no >= 1),
  CONSTRAINT copy_book_fk FOREIGN KEY (isbn) REFERENCES book ON DELETE CASCADE
);
La relación identificadora has_copy no tiene tabla propia. Su tabla
sería has_copy(isbn, copy_no), con las mismas columnas que la clave de
copy y una fila por cada fila de copy: no agrega nada. El libro dice que
el esquema de la relación identificadora es redundante y se omite.
ON DELETE CASCADE es la traducción del requisito 2: el ejemplar no existe
sin su libro. Las cuatro consecuencias de la regla, ejecutadas en
library-demo.sql (cada error va
seguido de su SQLSTATE):
INSERT INTO copy VALUES ('9786120000028', 2, '2026-06-01');
INSERT INTO copy VALUES ('9786120000028', 2, '2026-06-02');
INSERT 0 1
psql:library-demo.sql:27: ERROR: duplicate key value violates unique constraint "copy_pk"
DETAIL: Key (isbn, copy_no)=(9786120000028, 2) already exists.
23505El discriminador se repite entre libros (hay un ejemplar 1 de tres libros
distintos) pero no dentro de uno. Borrar La ciudad y los perros borra su
ejemplar; borrar Database System Concepts, que tiene ejemplares prestados,
falla, porque loan sí protege sus filas:
DELETE FROM book WHERE isbn = '9786120000028';
SELECT count(*) AS copies_left FROM copy WHERE isbn = '9786120000028';
DELETE FROM book WHERE isbn = '9786120000035';
DELETE 1
copies_left
-------------
0
(1 row)
psql:library-demo.sql:57: ERROR: update or delete on table "copy" violates foreign key constraint "loan_copy_fk" on table "loan"
DETAIL: Key (isbn, copy_no)=(9786120000035, 1) is still referenced from table "loan".
23503El CASCADE intentó borrar los ejemplares del libro, y el borrado del
ejemplar 1 chocó con la clave foránea de loan, que no tiene ON DELETE. La
sentencia entera falló: ni el libro ni sus ejemplares se borraron.
Conjuntos de relaciones
Regla. Un conjunto de relaciones R entre E₁, …, Eₙ, con atributos descriptivos b₁, …, bₘ, se traduce en una tabla con las claves primarias de los Eᵢ y los bⱼ. Su clave primaria es la de R según la cardinalidad (la tabla de la sección de claves). Por cada Eᵢ hay una clave foránea desde sus columnas hacia Eᵢ.
Para writes, muchos a muchos con el atributo position:
CREATE TABLE book_author (
  isbn      text NOT NULL,
  author_id integer NOT NULL,
  position  integer NOT NULL,
  CONSTRAINT book_author_pk PRIMARY KEY (isbn, author_id),
  CONSTRAINT book_author_position_uq UNIQUE (isbn, position),
  CONSTRAINT book_author_position_ck CHECK (position >= 1),
  CONSTRAINT book_author_book_fk FOREIGN KEY (isbn) REFERENCES book ON DELETE CASCADE,
  CONSTRAINT book_author_author_fk FOREIGN KEY (author_id) REFERENCES author
);
A esta tabla se le dice tabla asociativa (o tabla intermedia). La clave
(isbn, author_id) es la del conjunto de relaciones: el mismo par no se
repite.
psql:library-demo.sql:22: ERROR:  duplicate key value violates unique constraint "book_author_pk"
DETAIL:  Key (isbn, author_id)=(9786120000011, 1) already exists.
23505
UNIQUE (isbn, position) no viene del diagrama sino de un requisito que el
diagrama no dibuja: dos autores de un libro no pueden ocupar el mismo lugar en
la tapa. Las consultas recuperan la relación con dos joins:
SELECT b.title, string_agg(a.last_name, ', ' ORDER BY ba.position) AS authors
FROM library.book b
  JOIN library.book_author ba ON ba.isbn = b.isbn
  JOIN library.author a ON a.author_id = ba.author_id
GROUP BY b.isbn, b.title
ORDER BY b.title;
title | authors
--------------------------+--------------------------------
Database System Concepts | Silberschatz, Korth, Sudarshan
La ciudad y los perros | Vargas Llosa
Los ríos profundos | Arguedas
Trilce | Vallejo
(4 rows)Error común. Modelar un muchos a muchos sin tabla asociativa: una columna
author_ids textenbookcon'3,4,5', o columnasauthor1_id,author2_id,author3_id. En el primer caso no se puede declarar la clave foránea (nada impide'3,4,99') ni hacer un join sin partir el texto; en el segundo, el cuarto autor no tiene dónde ir, buscar “los libros de Korth” obliga a mirar tres columnas, y nada impide poner el mismo autor dos veces.
Fusionar esquemas
Si se aplicara la regla anterior a todas las relaciones, publishes tendría
su tabla publishes(isbn, publisher_id) con clave isbn (es muchos a uno de
book a publisher). Pero esa tabla tiene la misma clave que book, y cada
libro tiene a lo más una fila en ella. Silberschatz (sec. 6.7) propone
combinar las dos:
Regla. Si R es muchos a uno de A a B, la tabla de R se puede fundir con la de A: se agrega a A la clave primaria de B, como clave foránea. Si la participación de A en R es total, la columna es
NOT NULL; si es parcial, admiteNULL. Si R es uno a uno, se funde con cualquiera de los dos lados, y la columna lleva ademásUNIQUE. Los atributos descriptivos de R pasan a A.
publishes es total del lado del libro:
CREATE TABLE book (
  isbn         text PRIMARY KEY,
  title        text NOT NULL,
  pub_year     integer NOT NULL,
  publisher_id integer NOT NULL,
  CONSTRAINT book_isbn_ck CHECK (isbn ~ '^[0-9]{13}$'),
  CONSTRAINT book_publisher_fk FOREIGN KEY (publisher_id) REFERENCES publisher
);
NOT NULL dice “al menos una editorial” y la columna única dice “a lo más
una”. Las dos mitades de “exactamente una”, con dos errores distintos:
psql:library-demo.sql:14: ERROR:  null value in column "publisher_id" of relation "book" violates not-null constraint
DETAIL:  Failing row contains (9786120000059, Paco Yunque, 1951, null).
23502
psql:library-demo.sql:18: ERROR:  insert or update on table "book" violates foreign key constraint "book_publisher_fk"
DETAIL:  Key (publisher_id)=(9) is not present in table "publisher".
23503assigned, uno a uno y parcial de los dos lados, se funde en locker. La
columna admite NULL (un casillero libre) y lleva UNIQUE (un socio no tiene
dos casilleros): member_id integer, con CONSTRAINT locker_member_uq UNIQUE (member_id) y una clave foránea hacia member.
psql:library-demo.sql:31: ERROR:  duplicate key value violates unique constraint "locker_member_uq"
DETAIL:  Key (member_id)=(1) already exists.
23505
Hay dos casilleros libres y no chocan entre sí: un UNIQUE admite varios
NULL, como vimos en la semana 4. Poner locker_no en member también sería correcto;
conviene el lado donde la participación está más cerca de ser total.
Chasqui, al revés. La última columna de la tabla de relaciones de la
Sesión A se lee ahora como la regla de fusión: cada relación muchos a uno de
Chasqui quedó como una clave foránea en la tabla del lado “muchos”, NOT NULL en todas menos shipment.trip_id, que es la única con participación
parcial de ese lado. Ninguna tabla de Chasqui es una tabla asociativa: no hay
relaciones muchos a muchos en el esquema de partida.
Idea clave. Un muchos a muchos siempre tiene tabla propia. Un muchos a uno se funde en el lado “muchos” como clave foránea,
NOT NULLsi la participación de ese lado es total. Un uno a uno, igual, conUNIQUE. Una relación identificadora no tiene tabla.
Las restricciones que la traducción pierde
Las claves foráneas y NOT NULL expresan la participación total del lado
“muchos” de una relación muchos a uno. Hay participaciones totales que no
pueden expresar:
- la del lado “uno” de una relación uno a muchos: “toda editorial tiene al menos un libro”;
- cualquiera de los dos lados de un muchos a muchos: “todo libro tiene al menos un autor”;
- “al menos un valor” en un multivaluado: “todo socio tiene al menos un teléfono”.
En los tres casos la restricción dice que por cada fila de esta tabla tiene que existir una fila en otra, la que la referencia. Una clave foránea va en el sentido contrario: si existe la fila que referencia, la referenciada también. Ninguna de las restricciones de la semana 4 sirve. En SQL estándar se podría escribir con una aserción, que PostgreSQL no implementa (semana 4). Queda un trigger.
Pero un trigger común no sirve. Si se dispara después de insertar el libro, el libro todavía no tiene autores, porque los autores se insertan después y necesitan que el libro exista (su clave foránea). La revisión tiene que esperar al final de la transacción:
CREATE FUNCTION book_has_author() RETURNS trigger
LANGUAGE plpgsql AS $$
DECLARE
  v_isbn text;
BEGIN
  -- El libro insertado (NEW) o el del autor quitado (OLD).
  v_isbn := CASE WHEN TG_TABLE_NAME = 'book' THEN NEW.isbn ELSE OLD.isbn END;
  -- Si el libro ya no existe (se borró con sus autores), no hay nada que revisar.
  IF EXISTS (SELECT 1 FROM library.book WHERE isbn = v_isbn)
     AND NOT EXISTS (SELECT 1 FROM library.book_author WHERE isbn = v_isbn) THEN
    RAISE EXCEPTION 'el libro % no tiene autores', v_isbn
      USING ERRCODE = 'check_violation', CONSTRAINT = 'book_has_author';
  END IF;
  RETURN NULL;
END;
$$;

CREATE CONSTRAINT TRIGGER book_has_author_ins
  AFTER INSERT ON book
  DEFERRABLE INITIALLY DEFERRED
  FOR EACH ROW EXECUTE FUNCTION book_has_author();

CREATE CONSTRAINT TRIGGER book_has_author_del
  AFTER DELETE OR UPDATE OF isbn ON book_author
  DEFERRABLE INITIALLY DEFERRED
  FOR EACH ROW EXECUTE FUNCTION book_has_author();
La regla se puede romper desde dos tablas: al insertar un libro y al quitarle
autores. Por eso hay dos triggers. El IF EXISTS del libro evita
un falso error: borrar un libro borra en cascada sus filas de book_author, y
el trigger del borrado no debe quejarse de un libro que ya no está.
En PostgreSQL.
CREATE CONSTRAINT TRIGGERes una extensión de PostgreSQL: un triggerAFTER ... FOR EACH ROWque, como las restricciones de la semana 4, puede serDEFERRABLE INITIALLY DEFERRED. Diferido, se ejecuta alCOMMIT(o en unSET CONSTRAINTS ... IMMEDIATE), cuando la transacción ya terminó de insertar el libro y sus autores. ConERRCODE = 'check_violation'el error tiene el SQLSTATE 23514 de unCHECK, y conCONSTRAINTel programa ve un nombre enerr.constraint.
Un libro sin autores entra sin quejas, y la transacción falla al hacer commit:
BEGIN;
INSERT INTO library.book VALUES ('9786120000066', 'Poemas humanos', 1939, 3);
COMMIT;
SELECT count(*) FROM library.book WHERE isbn = '9786120000066';
BEGIN
INSERT 0 1
ERROR: el libro 9786120000066 no tiene autores
CONTEXT: PL/pgSQL function library.book_has_author() line 10 at RAISE
count
-------
0
(1 row)El COMMIT fallido deshizo la transacción entera: el libro no quedó. Con su
autor insertado en la misma transacción, la revisión pasa.
Dos advertencias. La revisión no ve lo que otra transacción todavía no confirmó: dos transacciones que le quitan a la vez los dos últimos autores a un libro pueden hacer commit las dos (arreglarlo exige locks, parte 4). Y es cara, así que se declara solo cuando importa: la biblioteca no pide que toda editorial tenga libros, y no lo declaramos.
E-R extendido
El modelo E-R básico se queda corto cuando unas entidades son casos particulares de otras. Silberschatz (sec. 6.8) agrega tres ideas: especialización, generalización y agregación. Para no repetir la biblioteca, usamos el ejemplo de la universidad del libro.
Especialización
En una universidad, todas las personas tienen un identificador y un
nombre. Algunas son estudiantes, con créditos aprobados (tot_cred), y
otras son instructores, con sueldo (salary). La especialización
(specialization) es el proceso de distinguir, dentro de un conjunto de
entidades, subgrupos con atributos o relaciones propios. person es el
conjunto de nivel superior (superclase) y student e instructor son los
de nivel inferior (subclases).
Los de nivel inferior heredan (attribute inheritance) todos los atributos
y todas las relaciones del superior. Un estudiante tiene tot_cred, y además
person_id y name porque es una persona. Si person participa en una
relación (una persona vive en una ciudad), también participan los estudiantes.
Es la misma idea de la herencia en POO: Student extends Person.
En el diagrama del libro, cada subclase se une a la superclase con una línea que termina en una punta de flecha hueca apuntando a la superclase:
                  +---------------+
                  | person        |
                  +---------------+
                  | person_id  PK |
                  | name          |
                  +---------------+
                    /_\       /_\
                     |         |
          +------------+     +--------------+
          | student    |     | instructor   |
          +------------+     +--------------+
          | tot_cred   |     | salary       |
          +------------+     +--------------+
Las subclases no repiten la clave ni los atributos heredados.
Generalización
La generalización (generalization) es el mismo resultado obtenido en
sentido inverso. Si al diseñar aparecen student e instructor por separado,
y se nota que los dos tienen identificador y nombre, se los junta en una
superclase person que lleva lo común. Especialización es de arriba hacia
abajo (se parte de person y se encuentran subgrupos); generalización, de
abajo hacia arriba (se parte de los subgrupos y se encuentra lo común). En el
diagrama no se distinguen, y el libro las trata como la misma construcción.
Restricciones de una especialización
Una especialización se describe con dos restricciones independientes (sec. 6.8):
- Disjunta (disjoint) o con solapamiento (overlapping). Disjunta: una entidad pertenece a lo más a una subclase. Con solapamiento: puede pertenecer a varias. En la universidad hay estudiantes de posgrado que dictan prácticas: son estudiantes e instructores a la vez, así que la especialización es con solapamiento. En la biblioteca, un socio es estudiante o docente, nunca las dos cosas: disjunta.
- Total o parcial. Total: toda entidad de la superclase pertenece a alguna subclase. Parcial: puede haber entidades que no están en ninguna. En la universidad hay personal administrativo que no es estudiante ni instructor: parcial. En la biblioteca todo socio es estudiante o docente: total.
En el diagrama del libro, una especialización con solapamiento se dibuja con
una flecha hueca por cada subclase, como arriba. Si es disjunta, las
líneas de las subclases se juntan en una sola flecha hueca. Si es total,
se escribe la palabra total junto a la flecha. La de la biblioteca es
disjunta y total: una sola flecha hueca con la palabra total (así está
dibujada en las diapositivas).
Una jerarquía puede tener varios niveles (instructor podría especializarse en
profesor principal y jefe de práctica), y un conjunto de entidades puede tener
varias especializaciones según distintos criterios.
Cómo se traduce
Silberschatz (sec. 6.8) da dos métodos, y en la práctica se usa también un
tercero. El código de los tres, con los mismos datos (Carla es estudiante,
Jorge es instructor y Elena es las dos cosas), está en
extended.sql, uno por esquema.
Método 1: una tabla por cada nivel (esquema isa_levels). La superclase
tiene su tabla con sus atributos. Cada subclase tiene una tabla con la clave
primaria de la superclase y sus atributos propios; esa clave es también clave
foránea hacia la superclase.
CREATE TABLE isa_levels.person (
  person_id integer PRIMARY KEY,
  name      text NOT NULL
);

CREATE TABLE isa_levels.student (
  person_id integer PRIMARY KEY,
  tot_cred  integer NOT NULL,
  CONSTRAINT student_tot_cred_ck CHECK (tot_cred >= 0),
  CONSTRAINT student_person_fk FOREIGN KEY (person_id)
    REFERENCES isa_levels.person ON DELETE CASCADE
);
-- instructor, igual, con salary
Sirve para cualquier combinación de restricciones: el solapamiento es una persona con fila en las dos subclases, y lo parcial, una persona sin fila en ninguna. Una subclase no puede existir sin su persona:
psql:extended-demo.sql:11: ERROR:  insert or update on table "student" violates foreign key constraint "student_person_fk"
DETAIL:  Key (person_id)=(9) is not present in table "person".
Para ver a una persona con todos sus datos hace falta un join externo por cada subclase:
SELECT p.person_id, p.name, s.tot_cred, i.salary
FROM isa_levels.person p
  LEFT JOIN isa_levels.student s ON s.person_id = p.person_id
  LEFT JOIN isa_levels.instructor i ON i.person_id = p.person_id
ORDER BY p.person_id;
person_id | name | tot_cred | salary
-----------+------------+----------+---------
1 | Carla Ríos | 120 |
2 | Jorge Paz | | 6500.00
3 | Elena Soto | 48 | 1800.00
(3 rows)Método 2: solo las subclases (esquema isa_leaves). No hay tabla para la
superclase; cada subclase lleva todos los atributos, heredados y propios:
student(person_id, name, tot_cred), instructor(person_id, name, salary).
El libro lo admite solo si la especialización es disjunta y total, y el
ejemplo muestra por qué. Con solapamiento, el nombre de Elena se guarda dos
veces, y nada impide que las dos copias no coincidan:
INSERT INTO isa_leaves.instructor VALUES (1, 'Carla Rios', 2500);
SELECT person_id, name FROM isa_leaves.student
UNION
SELECT person_id, name FROM isa_leaves.instructor
ORDER BY person_id;
INSERT 0 1
person_id | name
-----------+------------
1 | Carla Rios
1 | Carla Ríos
2 | Jorge Paz
3 | Elena Soto
(4 rows)La persona 1 tiene ahora dos nombres. Si la especialización es parcial, una
persona que no es estudiante ni instructor no tiene dónde ir. Y aunque sea
disjunta y total, se pierden dos cosas: una clave foránea no puede apuntar a
“una persona” (tendría que apuntar a dos tablas), y nada impide usar el mismo
person_id en las dos tablas.
Método 3: una sola tabla (esquema isa_single). Este no está en el libro,
pero es muy común (los ORM lo llaman single table inheritance). Una tabla con
los atributos de todos los niveles; los de cada subclase admiten NULL, y una
columna dice a qué subclase pertenece cada fila. Con solapamiento hace falta
un indicador por subclase; si fuera disjunta, bastaría una columna kind. Los
CHECK atan cada indicador a sus columnas:
CREATE TABLE isa_single.person (
  person_id     integer PRIMARY KEY,
  name          text NOT NULL,
  is_student    boolean NOT NULL,
  is_instructor boolean NOT NULL,
  tot_cred      integer CHECK (tot_cred >= 0),
  salary        numeric(8, 2) CHECK (salary > 0),
  CONSTRAINT person_student_ck CHECK (is_student = (tot_cred IS NOT NULL)),
  CONSTRAINT person_instructor_ck CHECK (is_instructor = (salary IS NOT NULL))
);
psql:extended-demo.sql:14: ERROR: new row for relation "person" violates check constraint "person_instructor_ck"
DETAIL: Failing row contains (4, Raúl Vega, f, t, null, null).Listar a todos es un SELECT sin joins, pero la tabla se llena de NULL, y
las relaciones de una sola subclase quedan mal expresadas: una clave foránea
hacia “un instructor” apunta a person y no puede exigir que is_instructor
sea verdadero (salvo con el truco de la clave compuesta que vemos enseguida).
| Método 1: por nivel | Método 2: solo subclases | Método 3: una tabla | |
|---|---|---|---|
| Solapamiento | sí | no (datos repetidos) | sí, con un indicador por subclase |
| Especialización parcial | sí | no | sí |
| Total | con un constraint trigger | sí, por construcción | CHECK (is_student OR is_instructor) |
| Disjunta | con kind y una clave foránea compuesta |
no (el mismo id en dos tablas) | con una columna kind |
NOT NULL en los atributos de una subclase |
sí | sí | con un CHECK por atributo |
| Clave foránea hacia la superclase | sí | no | sí |
| Clave foránea hacia una subclase | sí | sí | no, salvo con una clave compuesta |
| Listar a todos | un join externo por subclase | UNION |
un SELECT |
Disjunta con el método 1. La biblioteca usa el método 1 y necesita que la
especialización sea disjunta. La traducción lo consigue con una columna kind
en member y una clave foránea compuesta desde cada subclase:
-- en member: kind text NOT NULL CHECK (kind IN ('student', 'teacher'))
--            CONSTRAINT member_id_kind_uq UNIQUE (member_id, kind)
CREATE TABLE teacher (
  member_id  integer PRIMARY KEY,
  kind       text NOT NULL DEFAULT 'teacher',
  department text NOT NULL,
  CONSTRAINT teacher_kind_ck CHECK (kind = 'teacher'),
  CONSTRAINT teacher_member_fk FOREIGN KEY (member_id, kind)
    REFERENCES member (member_id, kind) ON DELETE CASCADE
);
Una fila de teacher tiene kind = 'teacher' (lo fija el CHECK) y tiene
que existir en member con ese mismo kind. Como member_id es la clave de
member, un socio tiene un solo kind, así que solo puede tener fila en la
subclase que le corresponde. UNIQUE (member_id, kind) es redundante como
restricción (member_id ya es clave), pero hace falta porque una clave
foránea solo puede apuntar a una clave primaria o a columnas UNIQUE. Rosa es
estudiante:
psql:library-demo.sql:39: ERROR:  insert or update on table "teacher" violates foreign key constraint "teacher_member_fk"
DETAIL:  Key (member_id, kind)=(1, teacher) is not present in table "member".
23503
Esto da la disjunción. La totalidad (todo socio tiene fila en student o en
teacher) es otra vez una restricción de “tiene que existir una fila en otra
tabla”: necesita un constraint trigger diferido, como el de los autores. La
dejamos como ejercicio.
En PostgreSQL.
CREATE TABLE student (...) INHERITS (person)parece hecho para la especialización:studentrecibe las columnas deperson, y unSELECTsobrepersonincluye las filas destudent. Pero la documentación (Inheritance, sección Caveats) advierte que losUNIQUE, las claves primarias y las claves foráneas no se heredan: dos filas, una enpersony otra enstudent, pueden tener el mismoperson_id, y una clave foránea haciapersonno ve las filas destudent. En el curso traducimos la especialización con tablas normales.
Agregación
Volvamos a la universidad. Un instructor guía a un estudiante en un proyecto:
es la relación ternaria proj_guide(instructor, student, project). Al final
del ciclo, cada guía se evalúa, y la evaluación tiene fecha y nota. ¿Con
qué se relaciona una evaluación?
No con el instructor, el estudiante y el proyecto por separado: una relación
cuaternaria eval_for(instructor, student, project, evaluation) permitiría
evaluar una combinación que nunca existió (un instructor que no guió a ese
estudiante en ese proyecto), y repetiría a los tres participantes de cada
guía. Lo que se evalúa es la guía, una relación. Y una relación no puede
participar en otra.
La agregación (aggregation) resuelve esto: se trata a la relación
proj_guide, junto con sus participantes, como un conjunto de entidades de
nivel superior, que puede participar en relaciones. En el diagrama se dibuja
un rectángulo alrededor del rombo y sus participantes, y la nueva relación
sale de ese rectángulo:
+--------------------------------------------------+
|                                                  |
|   instructor --- <proj_guide> --- student        |
|                       |                          |
|                    project                       |
|                                                  |
+--------------------------------------------------+
                        ^
                        |
                   <eval_for>
                       ||
                   +------------+
                   | evaluation |
                   +------------+
Leído desde la evaluación, eval_for es muchos a uno de evaluation a la
agregación: cada evaluación es de exactamente una guía (flecha hacia el
rectángulo grande y línea doble del lado de evaluation), y una guía puede
tener varias evaluaciones, o ninguna todavía.
Regla. La tabla de una relación R entre una agregación y un conjunto de entidades E tiene la clave primaria de la relación agregada (las claves de sus participantes), la clave primaria de E y los atributos descriptivos de R. La clave foránea hacia la agregación apunta a la tabla de la relación agregada, no a cada participante por separado.
Como cada evaluación es de una sola guía, con participación total, eval_for
se funde en evaluation (la regla de fusión de siempre):
CREATE TABLE university.evaluation (
  evaluation_id integer PRIMARY KEY,
  instructor_id integer NOT NULL,
  student_id    integer NOT NULL,
  project_id    integer NOT NULL,
  evaluated_on  date NOT NULL,
  grade         integer NOT NULL CHECK (grade BETWEEN 0 AND 20),
  CONSTRAINT evaluation_proj_guide_fk FOREIGN KEY (instructor_id, student_id, project_id)
    REFERENCES university.proj_guide
);
La clave foránea compuesta hacia proj_guide es lo que la agregación
garantiza. La instructora 11, el estudiante 21 y el proyecto 31 existen, pero
ella no guía a ese estudiante en ese proyecto:
psql:extended-demo.sql:25: ERROR:  insert or update on table "evaluation" violates foreign key constraint "evaluation_proj_guide_fk"
DETAIL:  Key (instructor_id, student_id, project_id)=(11, 21, 31) is not present in table "proj_guide".
Con tres claves foráneas separadas (una a cada tabla), esa fila habría entrado.
Decisiones de diseño
El modelo E-R deja varias formas de describir lo mismo. Silberschatz (sec. 6.9) discute las más frecuentes. Ninguna tiene una respuesta universal: depende de qué preguntas debe responder la base de datos.
¿Entidad o atributo?
El teléfono de un socio puede ser un atributo multivaluado {phone} o un
conjunto de entidades phone con una relación hacia member. La diferencia
aparece cuando el teléfono tiene datos propios: si la biblioteca quiere
guardar de cada número si es celular o fijo y si acepta mensajes, ya no es un
valor, es una cosa con atributos, y conviene una entidad. Si solo es el
número, basta el atributo.
Lo mismo pasa con la ciudad de una agencia en Chasqui. Hoy city y region
son atributos: no se guarda nada de una ciudad, solo su nombre. El día que
se necesite un dato de la ciudad (su población, su código de ubigeo), la
ciudad pasa a ser una entidad, y city deja de ser atributo de agency para
convertirse en una relación. Mientras sea un atributo, nada impide escribir
'Cusco' en una fila y 'cusco' en otra.
El libro señala dos errores comunes (sec. 6.9):
- Usar la clave primaria de otro conjunto de entidades como atributo, en vez
de una relación. Es el
sender_idde la sección de atributos redundantes. - Usar como atributos de una relación las claves primarias de sus
participantes. Un rombo
writescon atributosisbnyauthor_idrepite lo que ya dicen sus líneas.
¿Entidad o relación?
El requisito 5 de la biblioteca dice que un socio puede llevarse el mismo
ejemplar muchas veces. Si el préstamo fuera un conjunto de relaciones
borrows(member, copy) con atributos descriptivos loaned_on, due_on y
returned_on, cada par (socio, ejemplar) aparecería a lo más una vez: el
segundo préstamo de Rosa sobre el mismo ejemplar no tendría dónde ir. Un
conjunto de relaciones no puede tener dos relaciones con las mismas entidades.
Por eso loan es un conjunto de entidades, con su propia clave loan_id y
dos relaciones muchos a uno: borrows hacia member y loan_of hacia
copy, las dos totales del lado de loan. Al fundirlas, quedan como claves
foráneas NOT NULL en la tabla loan de
library.sql:
  member_id   integer NOT NULL,
  isbn        text NOT NULL,
  copy_no     integer NOT NULL,
  ...
  CONSTRAINT loan_member_fk FOREIGN KEY (member_id) REFERENCES member,
  CONSTRAINT loan_copy_fk FOREIGN KEY (isbn, copy_no) REFERENCES copy,
La clave foránea hacia copy es compuesta, porque la clave de un ejemplar lo
es. Los préstamos 1 y 2 de los datos de ejemplo son de Rosa, sobre el mismo
ejemplar, en abril y en mayo.
La regla general: si el vínculo puede repetirse entre las mismas entidades, o si tiene sus propias relaciones, conviene una entidad. La otra pregunta del guion, si un envío de Chasqui es una entidad o una relación entre su remitente y su destinatario, se responde igual: un envío tiene viaje, eventos, agencias de origen y destino. Tiene relaciones propias, así que es una entidad.
El resto del requisito 5, “un ejemplar no puede estar en dos préstamos sin devolver”, es una restricción de cardinalidad sobre un subconjunto de las filas: entre los préstamos abiertos, cada ejemplar aparece a lo más una vez.
CREATE UNIQUE INDEX loan_open_copy_uq ON loan (isbn, copy_no) WHERE returned_on IS NULL;psql:library-demo.sql:35: ERROR: duplicate key value violates unique constraint "loan_open_copy_uq"
DETAIL: Key (isbn, copy_no)=(9786120000035, 1) already exists.
23505En PostgreSQL. Un índice único parcial (
CREATE UNIQUE INDEX ... WHERE ...) exige la unicidad solo entre las filas que cumplen elWHERE. No es SQL estándar, y no se puede escribir comoCONSTRAINT ... UNIQUEdentro deCREATE TABLE: es un índice, aunque el error que da es el mismo 23505 de unUNIQUE. Una vez devuelto el préstamo, la fila sale del índice y el ejemplar se puede volver a prestar.
¿Binaria o n-aria?
En una clínica, un médico le receta un medicamento a un paciente. ¿Es una
relación ternaria prescribes(doctor, patient, drug) o tres binarias,
treats(doctor, patient), takes(patient, drug) y uses(doctor, drug)?
No son equivalentes. Supongan que la doctora Salas atiende a Pedro y a Lucía,
que Pedro toma ibuprofeno y que la doctora Salas recetó ibuprofeno (a Lucía).
Con las binarias:
| treats | takes | uses |
|---|---|---|
| (Salas, Pedro) | (Pedro, ibuprofeno) | (Salas, ibuprofeno) |
| (Salas, Lucía) |
Las tres tablas son compatibles con “Salas le recetó ibuprofeno a Pedro”, que
no pasó (Pedro lo toma por receta de otro médico). Las binarias guardan los
tres pares, pero no cuál tripleta ocurrió. La ternaria guarda la tripleta
(Salas, Lucía, ibuprofeno) y nada más.
Silberschatz muestra que una relación n-aria siempre se puede reemplazar por un conjunto de entidades artificial E, con un identificador propio, y n relaciones binarias desde E hacia cada participante (cada receta es una entidad con su médico, su paciente y su medicamento). A veces es lo que se hace, sobre todo si la receta tiene más datos y relaciones propias. Pero cuesta algo: hay que inventar el identificador, hay que agregar una restricción para que no haya dos entidades E con la misma tripleta, y algunas restricciones de cardinalidad de la ternaria no se pueden expresar sobre las binarias.
Al revés, una ternaria es un error si en realidad son hechos independientes. La pregunta es siempre si el hecho necesita a todos los participantes a la vez.
¿Dónde van los atributos de una relación?
En una relación uno a uno o muchos a uno, un atributo descriptivo se puede
mover al conjunto de entidades del lado “muchos” (sec. 6.9): como cada
entidad de ese lado participa en a lo más una relación, el valor queda
determinado por la entidad. Si Chasqui guardara a qué hora se cargó un envío
en su viaje, ese dato es de travels_on, pero puede ir en shipment: un
envío va en a lo más un viaje. Al fundir travels_on en shipment, la
columna loaded_at terminaría ahí de todas formas.
En un muchos a muchos no se puede: position es de cada par (libro, autor) y
no de uno de los dos. Moverla a book diría que todos los autores del libro
ocupan el mismo lugar.
Otras notaciones
La notación del libro no es la única (Silberschatz, sec. 6.10). La del libro
desciende de la de Peter Chen (1976), con rombos para las relaciones. Crow’s
foot, que vimos en la Sesión A, es la de casi todas las herramientas. Y los
diagramas de clases UML, que conocen del curso de Programación Orientada
a Objetos: una clase es un conjunto de entidades, una asociación es una
relación binaria, la multiplicidad (1, 0..1, *, 1..*) va en cada
extremo, y la especialización es la generalización de UML, con la flecha de
punta hueca hacia la superclase, como en el libro.
La misma información en las tres, para tres relaciones de la biblioteca:
| Libro (Silberschatz) | Crow’s foot | UML | |
|---|---|---|---|
publishes: cada libro, exactamente una editorial; cada editorial, cero o más libros |
book == <publishes> --> publisher |
`book >o------ | |
assigned: uno a uno, parcial de los dos lados |
member <-- <assigned> --> locker |
`member | o------o |
writes: muchos a muchos, total del lado del libro |
book == <writes> --- author |
`book |
Fíjense en la última fila. En UML, el 1..* va junto a Author y dice
“cada libro tiene uno o más autores”; en la etiqueta l..h del libro, ese
mismo hecho se escribe 1..* junto a book (“cada libro participa en una o
más relaciones writes”). Es el error común de la sección de cardinalidades:
el libro anota cada restricción junto a la entidad de la que habla; crow’s
foot y UML, en el extremo opuesto.
Para dibujar el diseño lógico a partir de texto está dbdiagram.io, con el lenguaje DBML. Una parte de la biblioteca:
Table book {
  isbn text [pk]
  title text [not null]
  publisher_id integer [not null, ref: > publisher.publisher_id]
}
ref: > es muchos a uno desde la columna hacia la tabla referenciada. La
herramienta dibuja el resultado en crow’s foot. Es un diagrama de tablas, no
un diagrama E-R: la relación writes aparecería como la tabla
book_author.
El código de la semana y make test
Dentro del contenedor, en code/week-06, make crea la base de datos
chasqui_w06 y le agrega los esquemas del capítulo: library (la
biblioteca) y, para el E-R extendido, isa_levels, isa_leaves,
isa_single y university. Las tablas de Chasqui quedan en public, sin
cambios. make test vuelve a crear todo, corre los scripts y las pruebas:
$ make test
chasqui-load chasqui_w06
Base de datos chasqui_w06 lista.
...
✔ 23514 al COMMIT: un libro sin autores
...
ℹ tests 55
ℹ pass 55
ℹ fail 0| Archivo | Qué muestra |
|---|---|
library.sql |
La traducción del diagrama de la biblioteca, con datos de ejemplo |
library-demo.sql |
Cada restricción del diagrama, violada a propósito, con su SQLSTATE |
extended.sql |
Las tres traducciones de la especialización y la agregación |
extended-demo.sql |
Qué restricción conserva cada traducción |
queries.sql |
Las consultas del capítulo, cada una con -- name: ... |
library.test.mjs |
Cardinalidad, participación, entidad débil y especialización de la biblioteca, por SQLSTATE |
extended.test.mjs |
Lo que acepta y lo que rechaza cada traducción del E-R extendido |
queries.test.mjs |
Los resultados de queries.sql que aparecen en el capítulo |
Las pruebas que cambian datos terminan en ROLLBACK, salvo la del
constraint trigger diferido, que tiene que llegar al COMMIT para ver el
error (y comprueba que el libro no quedó). Cada prueba de error mira el
SQLSTATE (err.code) y el nombre de la restricción (err.constraint): por
eso todas las restricciones del capítulo tienen nombre.
Resumen
- El diseño pasa por requisitos, diseño conceptual (E-R), lógico (tablas) y físico. Los peligros son la redundancia y la incompletitud.
- Un conjunto de entidades se describe con atributos: simples o compuestos, mono o multivaluados, almacenados o derivados, con o sin nulos.
- Un conjunto de relaciones es un subconjunto del producto de sus conjuntos de entidades: la misma combinación no se repite. Los roles nombran a los participantes; los atributos descriptivos son del vínculo y no entran en la clave.
- La cardinalidad da el máximo (flecha: “a lo más uno”); la participación, el mínimo (línea doble: total). Son restricciones sobre toda instancia válida: los datos solo las refutan. La etiqueta l..h del libro habla de la entidad junto a la que está; crow’s foot y UML, de la del otro extremo.
- Clave de una relación: la unión de las claves en un muchos a muchos, la del lado “muchos” en un muchos a uno, cualquiera en un uno a uno.
- Una entidad débil depende de su owner por una relación identificadora muchos a uno y total; su clave es la del owner más el discriminador.
- En el diagrama, el vínculo con otra entidad es una relación, nunca un atributo con su clave.
- Traducción: fuerte → tabla; compuesto → una columna por componente;
multivaluado → tabla (owner, valor); derivado → vista; débil → clave del
owner + discriminador, con
ON DELETE CASCADE, y sin tabla para la identificadora; muchos a muchos → tabla asociativa; muchos a uno → clave foránea en el lado “muchos”,NOT NULLsi es total; uno a uno → igual, conUNIQUE. - La participación total del lado “uno”, la de un muchos a muchos y la de un multivaluado necesitan un constraint trigger diferido.
- Especialización y generalización: herencia, disjunta o con solapamiento, total o parcial. Se traduce por nivel, solo con subclases o con una tabla; cada opción pierde restricciones distintas. La agregación deja que una relación participe en otra.
- Entidad o atributo, entidad o relación, binaria o n-aria: depende de si hay datos o relaciones propios, de si el vínculo se repite y de si el hecho necesita a todos los participantes a la vez.
Ejercicios
- Para
recipient,travels_onyfollowsde Chasqui, escriban las etiquetas l..h de la notación del libro en los dos extremos y las marcas de crow’s foot en los dos extremos. Expliquen por qué las etiquetas y las marcas aparecen “cruzadas”. - Escriban una consulta que cuente cuántos clientes de Chasqui nunca
recibieron un envío, y otra que cuente cuántos nunca mandaron ni
recibieron. ¿Qué dicen esos números de la participación de
customerensendery enrecipient? ¿Qué no pueden decir? - Una clínica numera las camas dentro de cada piso (cama 1, 2, 3 del piso 4)
y registra de cada cama si tiene oxígeno. ¿Qué es el conjunto de entidades
bed? Dibújenlo con su owner, marquen el discriminador y la relación identificadora, y escriban elCREATE TABLE. ¿Qué cambiaría si las camas tuvieran un número único en todo el hospital? - Traduzcan a tablas este fragmento del ejemplo del libro:
course(course_id, title, credits);section, débil decourse, con discriminador(sec_id, semester, year);student(id, name); ytakes, muchos a muchos entrestudentysection, con el atributograde. ¿Cuál es la clave detakes? ¿Cuántas columnas tiene? ¿Puede un estudiante llevar dos veces el mismo curso en el mismo semestre? ¿Y en semestres distintos? - Chasqui decide guardar varios teléfonos por cliente. Escriban la tabla
customer_phoney la sentenciaINSERT ... SELECTque la llena a partir decustomer.phone, enchasqui_w06. ¿Cuántas filas tiene? ¿Qué pasa con los clientes sin teléfono? ¿Qué harían después con la columnacustomer.phone? - En la biblioteca, todo socio debe tener al menos un teléfono. Escriban un
constraint trigger diferido que lo haga cumplir, con el SQLSTATE 23514.
¿Sobre qué tablas y qué operaciones tiene que dispararse? Pruébenlo con una
transacción que hace commit y otra que hace
SET CONSTRAINTS ALL IMMEDIATEantes de unROLLBACK. Cuiden que borrar un socio no dispare un falso error. - La especialización de
memberes total, perolibrary.sqlno lo garantiza (la pruebala totalidad de la especialización no está garantizadalo muestra). Escriban la restricción que falta. ¿Alcanza con revisar al insertar enmember? - Los vehículos de Chasqui son buses, camiones o furgonetas (
kind). Supongan que de los buses se guarda el número de asientos y de los camiones el tipo de carrocería. Dibujen la especialización con sus restricciones y escriban dos traducciones: una tabla por nivel y una sola tabla. Para cada una, ¿qué consulta lista todos los vehículos con sus datos? ¿Cuál impide un bus con tipo de carrocería? loanes una entidad conloan_id. Una alternativa es dejarla como relación entrememberycopyy agregarloaned_ona su clave primaria. Escriban esa tabla. ¿Siguen pudiendo exigir las dos partes del requisito 5? ¿Puede un socio llevarse el mismo ejemplar dos veces el mismo día? ¿Es eso un problema?- En
university, una evaluación referencia a la tripleta deproj_guide. Supongan que ahora cada guía tiene a lo más una evaluación. ¿Qué cambia en la cardinalidad deeval_for, en el diagrama y en la tablaevaluation? Escriban la restricción que falta y pruébenla en una transacción conROLLBACK. Por último, dibujen en crow’s foot el diagrama de la biblioteca: ¿qué pasa conpositiony con la especialización?