
Apuntes · Capítulo 5Modelo relacional y SQL
SQL desde un programa y SQL avanzado
SQL desde un programa y SQL avanzado
Hasta ahora escribimos SQL a mano en psql: una consulta, un resultado, la
siguiente consulta. Así se aprende el lenguaje, pero así no se usa una base de
datos. La agencia de Chasqui en Cusco no tiene a alguien escribiendo INSERT
cada vez que llega un paquete: tiene un programa que lee los datos del
formulario, arma las sentencias, las envía al DBMS y muestra el resultado. La
semana pasada vimos cómo el esquema protege los datos con restricciones; esta
semana vemos lo que pasa del otro lado, en el programa que los escribe.
El capítulo tiene dos partes. En la primera conectamos Node.js con PostgreSQL
usando el driver pg: cómo se abre una conexión, qué es un pool, cómo llegan
las filas y sus tipos a JavaScript, por qué una consulta se escribe siempre con
parámetros ($1, $2) y qué pasa cuando no (la inyección SQL), y cómo se
agrupan varias sentencias en una transacción desde el programa. Lo comparamos
todo el tiempo con JDBC, que ya conocen del curso de Programación Orientada a
Objetos y que es lo que usa el libro.
En la segunda parte volvemos al DBMS y vemos cuatro herramientas que van más
allá del SQL de las semanas anteriores: funciones y procedimientos guardados en
la base de datos, triggers que el motor ejecuta solo cuando cambian los datos,
consultas recursivas que recorren la red de rutas hasta donde llegue, y window
functions, que calculan rankings, acumulados y promedios móviles sin colapsar
las filas como hace GROUP BY.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “Cómo habla un programa con el DBMS” y “El ataque”, de “Inyección SQL”. Sesión B: “Funciones en SQL” y “Qué es un trigger”.
- En clase. Sesión A: “Conectarse con
pg”, “Inyección SQL” y “Transacciones desde Node.js”. Sesión B: “Funciones y procedimientos”, “Triggers”, “Consultas recursivas” y “Window functions”.- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 5.1, 9.8.1 y 5.2–5.5. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-05, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
Cómo habla un programa con el DBMS
PostgreSQL es un proceso servidor. Un programa que quiere usarlo es un cliente: abre una conexión de red (o un socket local), se autentica, y desde ahí la conversación es siempre la misma:
- El cliente envía el texto de una sentencia SQL.
- El servidor la analiza, la planifica y la ejecuta.
- El servidor devuelve un resultado: filas con sus columnas y tipos, o la cantidad de filas modificadas, o un error.
- El cliente convierte esas filas en valores de su lenguaje: objetos, números, textos, fechas.
psql es un cliente más; su trabajo es mostrar las filas en una tabla. Un
programa en Node.js o en Java hace lo mismo, con una biblioteca que habla el
protocolo de PostgreSQL: el driver. En Java el driver implementa la
interfaz estándar JDBC; en Node.js usamos pg
(también llamado node-postgres), que viene instalado en el contenedor del
curso.
Silberschatz (sec. 5.1) distingue el SQL dinámico, en que el programa
arma el texto de la consulta en tiempo de ejecución y lo envía con una
biblioteca (JDBC, ODBC, pg), del SQL embebido, en que el SQL va escrito
dentro del programa y un preprocesador lo traduce antes de compilar. Hoy casi
todo es SQL dinámico, y eso es lo que hace pg.
Idea clave. Hay dos lenguajes en juego. JavaScript decide qué consulta mandar y qué hacer con el resultado; SQL decide cómo se obtienen los datos. Entre ambos viaja texto, y ese detalle es la raíz de la inyección SQL que veremos más adelante.
Lo mismo en Java y en Node.js
El libro usa JDBC. Lo que aprendieron en Java se traduce casi palabra por
palabra a pg. Este es un fragmento en Java que busca a un cliente por su DNI:
try (Connection conn = DriverManager.getConnection(url, user, password);
     PreparedStatement ps = conn.prepareStatement(
         "SELECT first_name, last_name FROM customer WHERE dni = ?")) {
    ps.setString(1, dni);
    try (ResultSet rs = ps.executeQuery()) {
        while (rs.next()) {
            System.out.println(rs.getString("first_name") + " " + rs.getString("last_name"));
        }
    }
}
El equivalente con pg es el comienzo de connect.mjs, que vemos en la
siguiente sección. La correspondencia, pieza por pieza:
| JDBC (Java) | pg (Node.js) |
|---|---|
Connection |
pg.Client |
DataSource con connection pool |
pg.Pool |
PreparedStatement con ? y setString(1, ...) |
query(texto, [valores]) con $1, $2 |
ResultSet que se recorre con next() |
result.rows, un arreglo ya completo |
rs.getString("col"), rs.getBigDecimal("col") |
row.col, con el tipo que elija pg |
executeUpdate() devuelve las filas modificadas |
result.rowCount |
try-with-resources o finally { conn.close(); } |
finally { client.release(); } o pool.end() |
conn.setAutoCommit(false), commit(), rollback() |
BEGIN, COMMIT, ROLLBACK con el mismo client |
SQLException.getSQLState() |
err.code |
Dos diferencias importan. Primero, en Java las llamadas bloquean el hilo
hasta que llega la respuesta; en Node.js todo es asíncrono y se escribe con
await. Segundo, JDBC numera los parámetros con ? y los asigna uno por uno
con setString, setInt; PostgreSQL los numera en el texto ($1, $2) y
pg los recibe todos juntos en un arreglo.
Conectarse con pg
Client: una conexión
Un pg.Client es una conexión con el servidor. Se crea, se abre con
connect(), se usa y se cierra con end(). ¿A qué servidor se conecta? Si no
le pasamos opciones, pg toma la configuración de las mismas variables de
entorno que usa psql: PGHOST, PGPORT, PGUSER, PGPASSWORD y
PGDATABASE (libpq Environment Variables).
En el contenedor, PGHOST y PGUSER ya están definidas; nosotros solo
elegimos la base de datos. Las opciones explícitas, como
new pg.Client({ database: 'chasqui' }), tienen prioridad sobre las variables.
connect.mjs empieza así:
const client = new pg.Client();
await client.connect();
try {
  const result = await client.query('SELECT name, city FROM agency WHERE region = $1', ['Puno']);
  console.log('rows:', result.rows);
  console.log('rowCount:', result.rowCount);
  console.log('fields:', result.fields.map((f) => f.name));
} finally {
  await client.end();
}
$ PGDATABASE=chasqui_w05 node connect.mjs
rows: [
{ name: 'Puno - Centro', city: 'Puno' },
{ name: 'Juliaca - Centro', city: 'Juliaca' }
]
rowCount: 2
fields: [ 'name', 'city' ]El resultado de query es un objeto con varias propiedades. Las que más se
usan:
rows: un arreglo con un objeto por fila y una propiedad por columna. Las propiedades se llaman como las columnas del resultado, así que un alias (o.name AS origin) cambia el nombre de la propiedad.rowCount: cuántas filas devolvió unSELECTo cuántas modificó unINSERT,UPDATEoDELETE.fields: el nombre y el tipo de cada columna.command: la sentencia que se ejecutó ('SELECT','UPDATE', …).
Un Client suelto sirve para un script corto que hace un par de consultas y
termina. Para una aplicación que atiende muchos pedidos no sirve: abrir una
conexión con PostgreSQL cuesta (el servidor crea un proceso nuevo para cada
conexión y la autentica), y una sola conexión atiende una consulta a la vez.
Pool: conexiones que se prestan
Un pg.Pool mantiene un grupo de conexiones abiertas (hasta max, 10 por
defecto) y las presta. pool.query(texto, valores) hace tres cosas: toma una
conexión libre (o abre una nueva si no hay y no se llegó a max), ejecuta la
consulta y devuelve la conexión al pool. Es la misma idea que un
DataSource con connection pool en Java.
const pool = new pg.Pool({ max: 5 });
try {
  const { rows } = await pool.query('SELECT ... WHERE s.shipment_id = $1', [1]);
  // ...
} finally {
  await pool.end(); // sin esto, el proceso de Node no termina
}
pool.end() cierra todas las conexiones. Si un script se olvida de llamarlo,
hace su trabajo, imprime todo lo que tenía que imprimir… y no termina: las
conexiones abiertas mantienen vivo el proceso de Node. Lo probamos con un
script de tres líneas sin pool.end(): tardó 10 segundos en terminar, que es
lo que el pool espera por defecto (idleTimeoutMillis) antes de cerrar una
conexión que nadie usa. En un script que se corre a mano parece colgado; en
uno que abre conexiones nuevas cada cierto tiempo, no termina nunca.
Idea clave. En una aplicación se crea un pool al arrancar y se comparte. Las funciones que hacen consultas lo reciben como parámetro y no lo cierran: quien lo crea, lo cierra. Así se pueden probar con un pool de prueba. Es lo que hacen todas las funciones de
queries.mjs.
/** Los clientes con ese DNI (cero o uno, porque dni es UNIQUE). */
export async function findCustomerByDni(db, dni) {
  const result = await db.query(
    `SELECT customer_id, dni, first_name, last_name, phone, city
     FROM customer
     WHERE dni = $1`,
    [dni],
  );
  return result.rows;
}
El parámetro se llama db porque puede ser un Pool o un Client: los dos
tienen un método query con la misma forma. Eso nos va a servir para las
transacciones.
Los tipos: lo que llega a JavaScript
PostgreSQL tiene muchos más tipos que JavaScript. pg decide cómo convertir
cada uno, y algunas decisiones sorprenden. La segunda parte de
connect.mjs consulta un envío y muestra el tipo de JavaScript de cada
columna:
const { rows } = await pool.query(
  `SELECT s.shipment_id, s.weight_kg, s.price, s.created_at, s.delivered_at,
          count(e.seq) AS events
   FROM shipment s
     JOIN shipment_event e ON e.shipment_id = s.shipment_id
   WHERE s.shipment_id = $1
   GROUP BY s.shipment_id`,
  [1],
);
{
shipment_id: 1,
weight_kg: '64.60',
price: '88.17',
created_at: 2026-01-29T00:46:00.000Z,
delivered_at: 2026-02-04T23:30:00.000Z,
events: '4'
}
shipment_id number
weight_kg string
price string
created_at Date
delivered_at Date
events string
suma con texto: 88.1764.60
suma con Number: 152.76999999999998Columna por columna:
integer(shipment_id) llega comonumber. Unnumberde JavaScript es un double de 64 bits, que representa exactamente cualquier entero de 32 bits.numeric(weight_kg,price) llega comostring.numerices un decimal exacto de precisión arbitraria; convertirlo a double perdería precisión. El costo se ve en la penúltima línea:+entre dos textos los concatena. Para operar hay que convertir conNumber(...), y la última línea muestra lo que se pierde:152.76999999999998en vez de152.77.biginttambién llega comostring. Ojo concount(*): en PostgreSQL devuelvebigint, así queeventses'4', no4. Unbigintllega hasta 2⁶³ − 1, y unnumbersolo representa enteros exactos hasta 2⁵³ − 1.timestamptzllega como unDatede JavaScript, que representa un instante. Node lo muestra en UTC (laZfinal); enpsqlel mismo valor se ve como2026-01-28 19:46:00-05, en hora de Lima. Es el mismo instante.NULLllega comonull, en cualquier tipo.
En PostgreSQL. Las conversiones viven en el paquete
pg-typesy se pueden cambiar por tipo (por su OID) conpg.types.setTypeParser, por ejemplo para quebigintllegue comoBigInt. Otra opción es convertir en la consulta:count(*)::integeroprice::float8, sabiendo que la segunda pierde exactitud. En JDBC la elección la hace el programa al leer:rs.getBigDecimal("price")ors.getDouble("price").
Error común.
assert.equal(rows[0].price, 88.17)falla, porquerows[0].pricees'88.17'. Comparen con el texto ('88.17') o conviertan conNumber(...)sabiendo que pueden perder precisión. Con montos de dinero que se suman, no conviertan anumber: sumen en SQL.
Errores: err.code
Cuando el servidor rechaza una sentencia, la promesa de query se rechaza con
un error que trae los campos que manda PostgreSQL. El más útil es err.code,
el código SQLSTATE de cinco caracteres
(Appendix A. Error Codes).
Este es el error al insertar un cliente con un DNI que ya existe, con los
campos que imprimimos desde Node:
{
  code: '23505',
  constraint: 'customer_dni_key',
  detail: 'Key (dni)=(61830975) already exists.',
  message: 'duplicate key value violates unique constraint "customer_dni_key"',
  table: 'customer'
}
Los códigos que más se ven son los de la semana pasada: 23505
(unique_violation), 23503 (foreign_key_violation), 23514
(check_violation), 23502 (not_null_violation); además 42P01 (la tabla
no existe) y 42601 (error de sintaxis). Con err.code el programa
distingue “ese DNI ya está registrado”, que es culpa del usuario y tiene
respuesta, de “se cayó la conexión”, que no. addCustomer en
queries.mjs lo hace así:
} catch (err) {
  if (err.code === UNIQUE_VIOLATION && err.constraint === 'customer_dni_key') {
    throw new CustomerError(`el DNI ${dni} ya está registrado`, { cause: err });
  }
  if (err.code === CHECK_VIOLATION) {
    throw new CustomerError('el DNI o el celular no tienen el formato correcto', { cause: err });
  }
  throw err; // cualquier otro error (conexión caída, etc.) sigue de largo
}
Aquí se ve por qué la semana pasada insistimos en ponerles nombre a las
restricciones: err.constraint es lo que permite saber cuál regla se
violó. Y el mensaje para el usuario no incluye el SQL ni el mensaje técnico:
mostrar el texto de la consulta en pantalla le da pistas a un atacante.
Inyección SQL
El ataque
Supongamos que alguien escribe el buscador por DNI pegando el texto que el
usuario escribió dentro de la consulta, con un template string.
unsafe.mjs:
export async function findCustomerByDniUnsafe(db, dni) {
  return db.query(
    `SELECT customer_id, dni, first_name, last_name, phone, city
     FROM customer
     WHERE dni = '${dni}'`,
  );
}
Con un DNI normal funciona igual que la versión buena. Pero el DBMS no recibe
“un DNI”: recibe un texto de SQL que el programa armó, y parte de ese texto lo
escribió el usuario. Si el usuario escribe ' OR '1'='1, el texto que llega
al servidor es:
SELECT customer_id, dni, first_name, last_name, phone, city
FROM customer
WHERE dni = '' OR '1'='1'
La primera comilla del usuario cierra la cadena que abrió el programa, y el
resto es SQL. La condición '1'='1' es verdadera para todas las filas: la
consulta devuelve todos los clientes con sus teléfonos.
Peor: el usuario puede cerrar la sentencia con ; y escribir otra. Con
'; DELETE FROM shipment_event; -- el texto queda
SELECT ... FROM customer WHERE dni = ''; DELETE FROM shipment_event; --'donde -- convierte en comentario la comilla que sobraba. Son dos
sentencias. injection.mjs prueba las dos
versiones con los mismos datos; el DELETE se hace dentro de una transacción
que termina en ROLLBACK, y el script se niega a correr si la base de datos no
es chasqui_w05:
$ PGDATABASE=chasqui_w05 node injection.mjs
dni = "61830975"
  vulnerable:    filas = 1
  parametrizada: filas = 1
dni = "' OR '1'='1"
  vulnerable:    filas = 1800
  parametrizada: filas = 0
dni = "'; DELETE FROM shipment_event; --"
  eventos antes:  46421
  la vulnerable devolvió 2 resultados: SELECT 0, DELETE 46421
  eventos después: 0
  eventos tras ROLLBACK: 46421
  parametrizada: filas = 0, eventos = 46421
La versión vulnerable devolvió los 1800 clientes con el primer ataque y borró
los 46 421 eventos con el segundo. pg ejecutó las dos sentencias porque una
consulta sin parámetros viaja con el protocolo simple de PostgreSQL, que
acepta varias sentencias separadas por ; en un mismo texto; en ese caso
query devuelve un arreglo con un resultado por sentencia.
Silberschatz (subsec. 9.8.1) cuenta el mismo ataque con JDBC: un programa que
concatena el texto del usuario en un Statement en vez de usar un
PreparedStatement. El lenguaje no importa; el error es tratar datos como si
fueran código.
La defensa: consultas parametrizadas
La versión buena es la de queries.mjs:
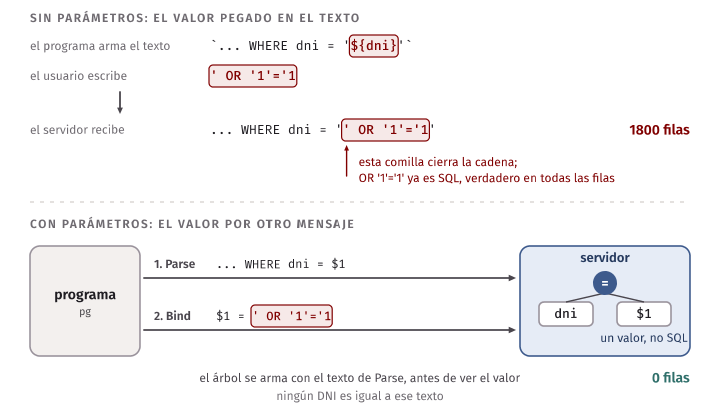
db.query('SELECT ... FROM customer WHERE dni = $1', [dni]);Con valores, pg usa el protocolo extendido: envía primero el texto de la
consulta con los marcadores $1, $2 (mensaje Parse), y después, aparte,
los valores (mensaje Bind). El servidor analiza la consulta y arma su
árbol de sintaxis antes de ver los valores; cuando llegan, ya se sabe que
$1 es un valor que se compara con dni. No hay forma de que un valor cambie la
estructura de la consulta: ' OR '1'='1 es solo un DNI que no existe, y por
eso la versión parametrizada devuelve 0 filas con los dos ataques.
Además, el protocolo extendido no acepta dos sentencias en un mismo texto. Si lo intentamos con parámetros:
42601 cannot insert multiple commands into a prepared statementIdea clave. Con parámetros, el texto de la consulta lo escribe solo el programador y los datos del usuario viajan por otro canal. Por eso es la primera defensa que recomienda OWASP (Defense Option 1: Prepared Statements), y por eso en este curso toda consulta con datos que vienen de afuera se escribe con
$1,$2.
En PostgreSQL.
pgusa por defecto una sentencia preparada sin nombre, que dura hasta la siguiente consulta de esa conexión. Si se le pasaname(pool.query({ name: 'by-dni', text, values })), la deja preparada en esa conexión y la reutiliza, como unPreparedStatementque se ejecuta muchas veces. Para la seguridad da igual: lo que protege es que los valores vayan separados del texto.
Error común. “Escapar” las comillas a mano (
dni.replaceAll("'", "''")) o validar con una lista negra de caracteres. Es fácil olvidar un caso (otra codificación, un campo que no es texto, una función que alguien agrega después sin escapar). Validar el formato sí ayuda, como segunda capa: un DNI son 8 dígitos (/^\d{8}$/) y lo que no cumpla se rechaza antes de llegar a la base de datos. Pero la consulta igual va con$1.
Lo que $1 no puede reemplazar
Un parámetro reemplaza un valor: un literal de texto, un número, una
fecha. No puede reemplazar un nombre de tabla o de columna ni una palabra
clave, porque esas partes tienen que conocerse para analizar la consulta,
antes de que lleguen los valores. ORDER BY $1 no ordena por la columna cuyo
nombre está en $1: ordena por un valor constante, es decir, no ordena nada.
Si el usuario elige el orden, se compara su elección con una lista fija y se
usa solo lo que está en la lista. routesFrom en queries.mjs:
const ROUTE_ORDER = {
  tarifa: 'r.base_fare',
  distancia: 'r.distance_km',
  destino: 'd.name',
};
const DIRECTION = { asc: 'ASC', desc: 'DESC' };

export async function routesFrom(db, city, order = 'tarifa', direction = 'asc') {
  if (!Object.hasOwn(ROUTE_ORDER, order) || !Object.hasOwn(DIRECTION, direction)) {
    throw new RangeError(`orden no permitido: ${order} ${direction}`);
  }
  const column = ROUTE_ORDER[order];
  const dir = DIRECTION[direction];
  const result = await db.query(
    `SELECT ... FROM route r ... WHERE o.city = $1
     ORDER BY ${column} ${dir}, r.route_id`,
    [city],
  );
  return result.rows;
}
Aquí sí hay un template string, pero lo que se pega en el texto sale de
ROUTE_ORDER y DIRECTION, que escribió el programador; el usuario solo
elige una clave. Si manda 'base_fare; DROP TABLE route', no está en la lista
y la función lanza RangeError sin tocar la base de datos. Object.hasOwn
evita que una clave como 'constructor' encuentre algo heredado del
prototipo. La ciudad, que es un valor, sigue yendo en $1.
Transacciones desde Node.js
Todo o nada, con un mismo client
Marcar un envío como entregado son dos cambios: el UPDATE de shipment y el
INSERT de su evento 'delivered' en shipment_event. Si el programa se cae
entre los dos, o el segundo falla, la base de datos queda con un envío
entregado sin su evento. Tienen que ser una transacción: o se guardan los dos o
ninguno.
En psql ya lo vieron: BEGIN, las sentencias, COMMIT. Si no hay BEGIN,
PostgreSQL trabaja en modo autocommit: cada sentencia es su propia
transacción y hace commit al terminar. Desde un programa es lo mismo, con una
condición: BEGIN, las sentencias y el COMMIT tienen que ir por la misma
conexión, porque una transacción vive en una conexión.
deliver.mjs:
export async function deliverShipment(pool, shipmentId, agencyId, at = new Date()) {
  const client = await pool.connect();
  try {
    await client.query('BEGIN');
    const updated = await client.query(
      `UPDATE shipment
       SET status = 'delivered', delivered_at = $2
       WHERE shipment_id = $1 AND status = 'in_transit'`,
      [shipmentId, at],
    );
    if (updated.rowCount !== 1) {
      throw new Error(`el envío ${shipmentId} no existe o no está en tránsito`);
    }
    const event = await client.query(
      `INSERT INTO shipment_event (shipment_id, seq, at, agency_id, kind)
       SELECT $1, max(seq) + 1, $2, $3, 'delivered'
       FROM shipment_event
       WHERE shipment_id = $1
       RETURNING seq`,
      [shipmentId, at, agencyId],
    );
    await client.query('COMMIT');
    return event.rows[0].seq;
  } catch (err) {
    await client.query('ROLLBACK');
    throw err;
  } finally {
    client.release();
  }
}
Las piezas:
pool.connect()presta una conexión para nosotros solos hasta que la devolvamos. Todas las sentencias van porclient.query.- Si cualquier sentencia falla, o si el
UPDATEno encontró el envío, se salta alcatch, que haceROLLBACKy vuelve a lanzar el error para que lo vea quien llamó. - El
finallydevuelve la conexión al pool conclient.release(), haya salido bien o mal. Es el try-with-resources de Java. - El
INSERT ... SELECT max(seq) + 1calcula el número de secuencia del evento nuevo, yRETURNING seqlo devuelve sin otra consulta.
En PostgreSQL.
RETURNINGno es SQL estándar. Devuelve columnas de las filas que insertó, modificó o borró la sentencia; con unINSERTsirve, por ejemplo, para recuperar una clave generada por el DBMS y usarla en el siguienteINSERTde la misma transacción. En JDBC lo mismo se hace congetGeneratedKeys().
Las pruebas lo verifican con una agencia que no existe: el UPDATE se
ejecuta, el INSERT falla con 23503 por la clave foránea de
shipment_event.agency_id, y después el envío 248 sigue en in_transit, con
delivered_at en NULL y su último evento en seq = 3, como antes.
Este patrón es el que usarán en P2 para registrar envíos y asignarlos a
viajes. Fíjense en que la función recibe el pool, no un client: la
transacción es asunto suyo, y quien la llama no tiene que saber cómo se hace.
El error de pool.query('BEGIN')
La tentación es escribir la transacción con pool.query:
await pool.query('BEGIN');
await pool.query('UPDATE ...');
await pool.query('COMMIT');   // o ROLLBACK en el catch
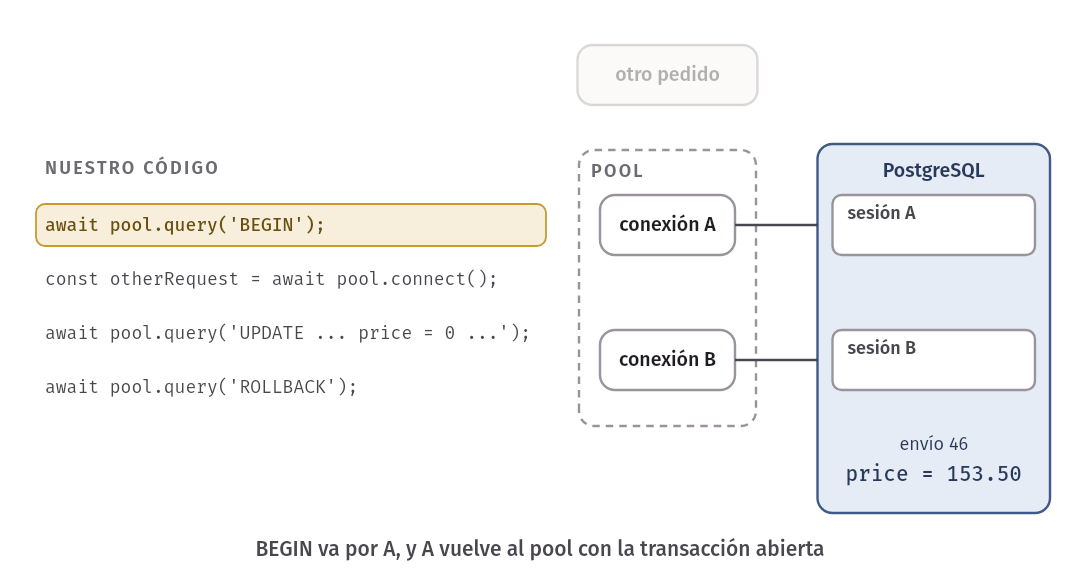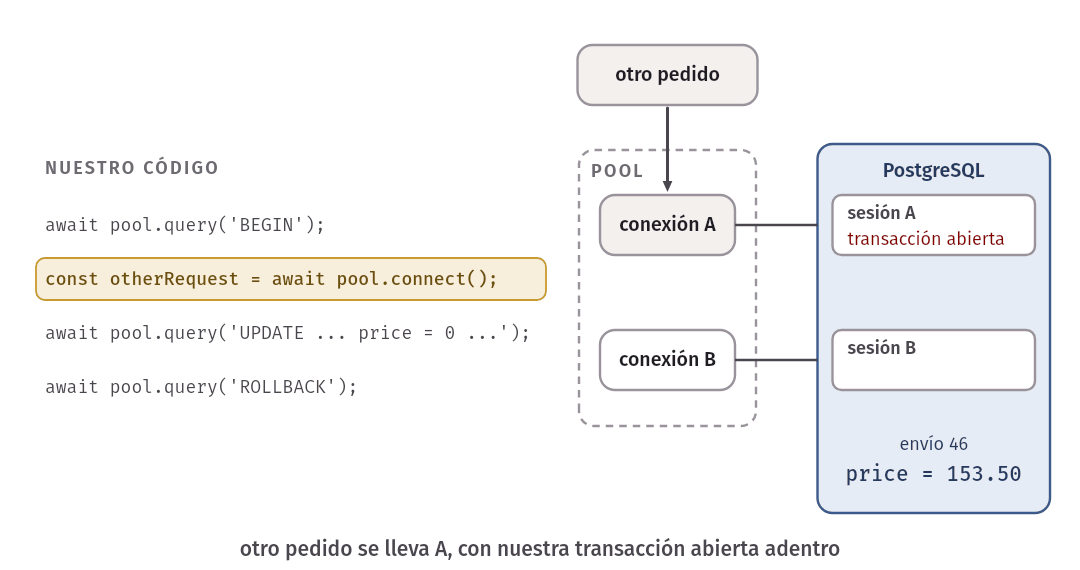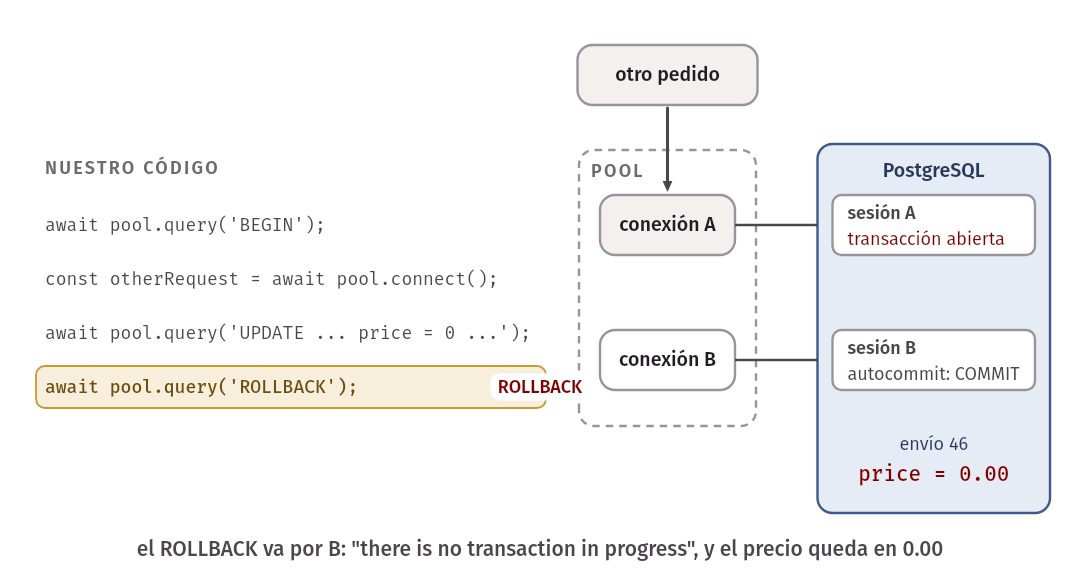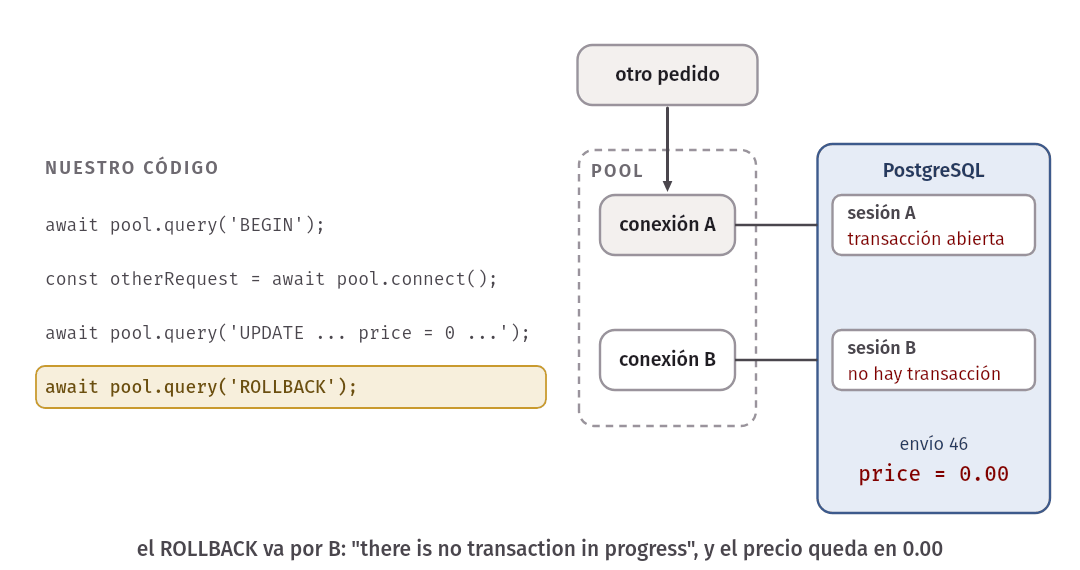
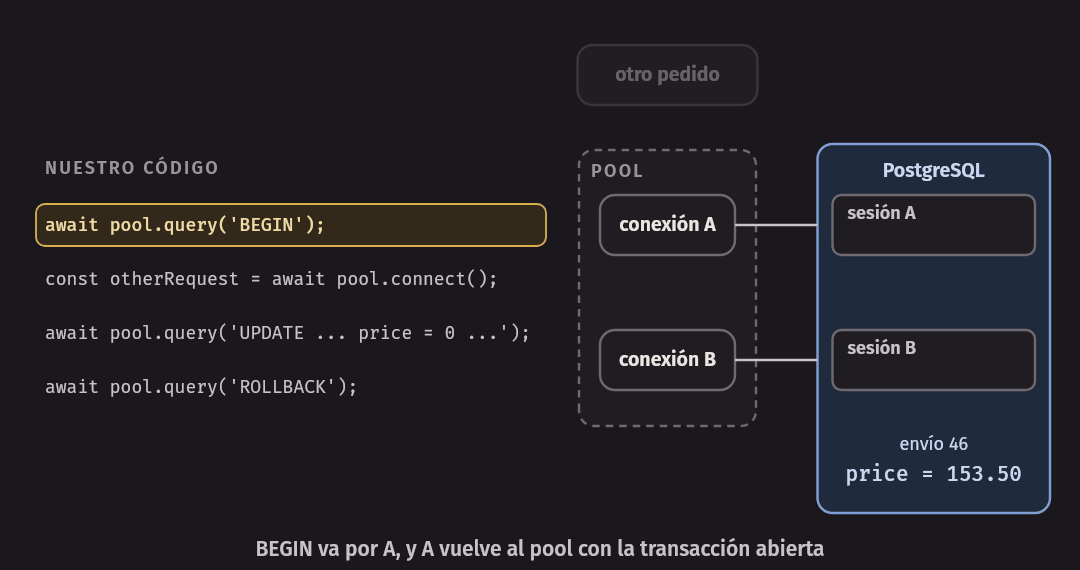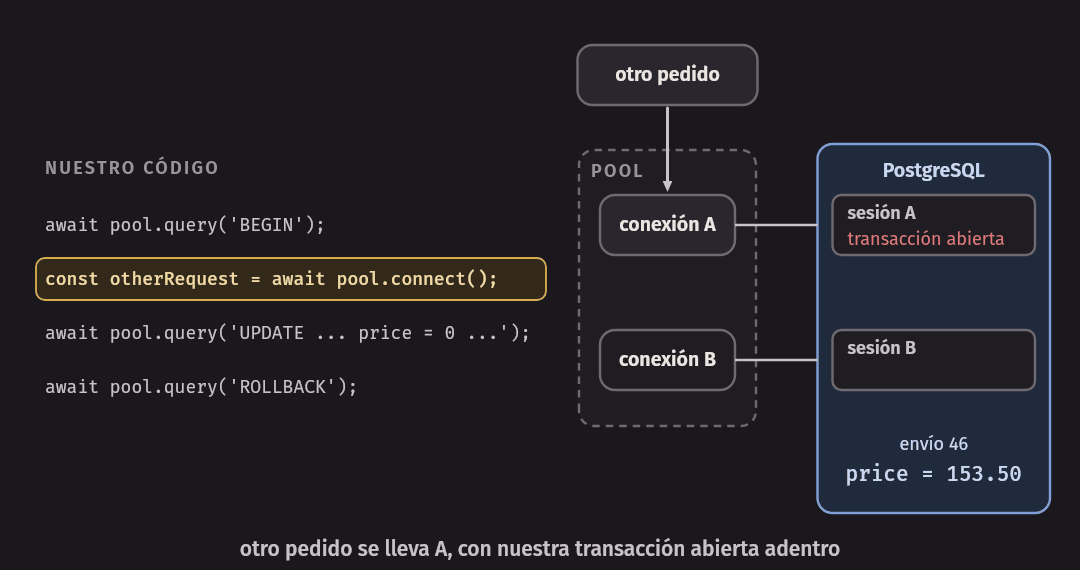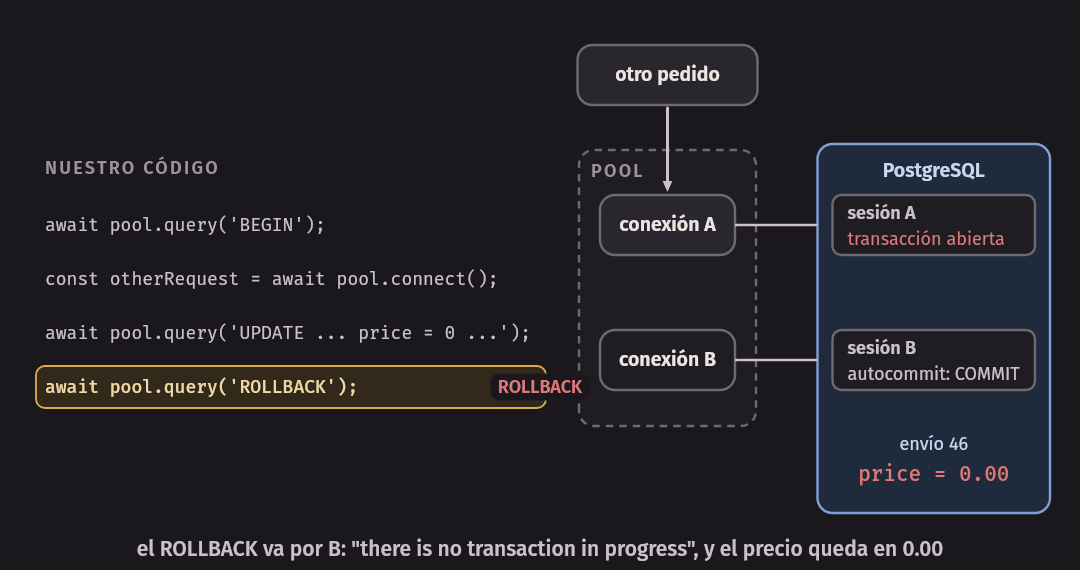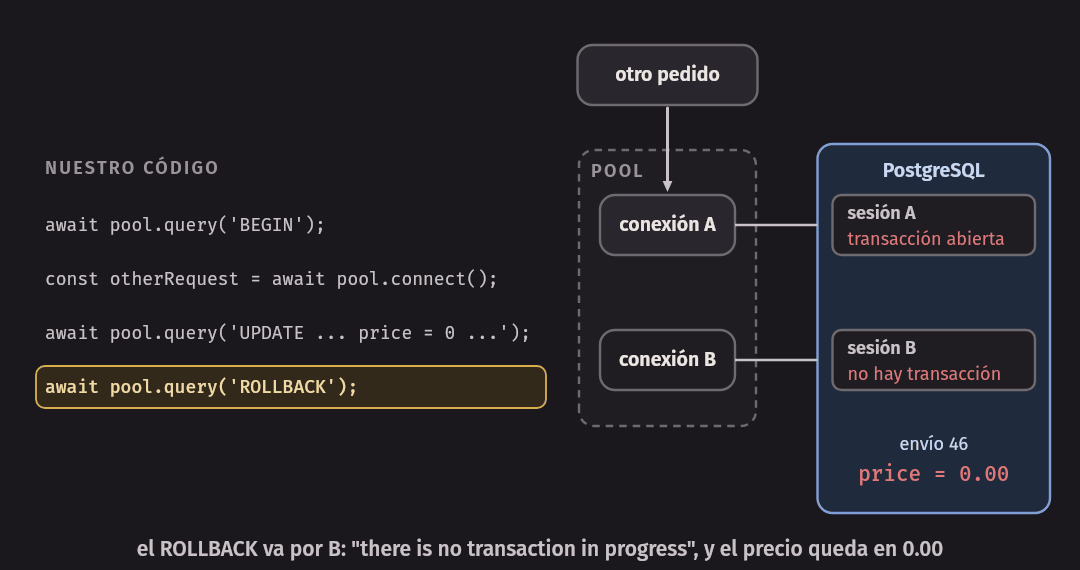
Cada pool.query toma una conexión libre del pool, ejecuta y la devuelve.
Nada garantiza que sea la misma conexión cada vez. Si llegan dos pedidos a la
vez, que es lo normal en una aplicación, el BEGIN cae en la conexión A, el
otro pedido se lleva A, y nuestro UPDATE va por la conexión B, en
autocommit. wrong-transaction.mjs
fuerza ese caso:
await pool.query('BEGIN');                 // conexión A; vuelve al pool con la transacción abierta
const otherRequest = await pool.connect(); // otro pedido se lleva la conexión A
await pool.query('UPDATE shipment SET price = 0 WHERE shipment_id = $1', [SHIPMENT]); // va por B
console.log('ROLLBACK...');
await pool.query('ROLLBACK');              // también por B, donde no hay transacción
$ PGDATABASE=chasqui_w05 node wrong-transaction.mjs
precio del envío 46 al empezar: 153.50
ROLLBACK...
aviso de PostgreSQL: there is no transaction in progress
precio del envío 46 después del ROLLBACK: 0.00El ROLLBACK llegó a una conexión sin transacción (PostgreSQL lo avisa con un
warning, que pg entrega como evento notice y nadie suele escuchar) y el
UPDATE ya había hecho commit. Y hay un segundo problema, más silencioso: la
conexión A volvió al pool con una transacción abierta, y lo que haga el otro
pedido con ella queda dentro de esa transacción, que nadie va a cerrar. Cuando
escribimos el script por primera vez, la sentencia que restauraba el precio
cayó justamente en A y se perdió al cerrar el pool; por eso el script ahora
hace ROLLBACK en A antes de devolverla.
Con un solo usuario y consultas una detrás de otra, el pool suele devolver la misma conexión y el código mal escrito “funciona”. Por eso este error pasa las pruebas y aparece en producción.
Error común. Abrir la transacción con
pool.query('BEGIN').BEGIN, las sentencias yCOMMIT/ROLLBACKvan siempre por el mismo client, obtenido conpool.connect().
Error común. Olvidar
client.release(). Cada conexión que no se devuelve queda prestada para siempre; cuando se prestan lasmax, el siguientepool.connect()opool.queryespera una conexión libre que nunca llega, y el programa se cuelga sin ningún error. Por esoreleaseva en elfinally, no al final deltry.
Funciones y procedimientos
Pasamos a la Sesión B. Hasta ahora toda la lógica estaba en el programa: la base de datos guardaba datos y el programa decidía qué hacer con ellos. SQL también permite guardar código en la base de datos: funciones, procedimientos y triggers. Silberschatz (sec. 5.2) los presenta con la sintaxis del estándar (SQL/PSM); cada DBMS tiene la suya, y en PostgreSQL el lenguaje procedural más usado es PL/pgSQL.
Funciones en SQL
Una función con LANGUAGE sql es una consulta con nombre y parámetros. El
precio de un envío en Chasqui es la tarifa base de la ruta, más S/ 0.90 por
kilo, más el 1 % del valor declarado si lo hay.
functions.sql:
CREATE OR REPLACE FUNCTION shipment_fare(p_route_id integer,
                                         p_weight numeric,
                                         p_declared numeric DEFAULT NULL)
RETURNS numeric
LANGUAGE sql
STABLE
AS $$
  SELECT round(r.base_fare + 0.9 * p_weight + 0.01 * coalesce(p_declared, 0), 2)
  FROM route r
  WHERE r.route_id = p_route_id;
$$;- El cuerpo va entre
$$ ... $$, una forma de escribir una cadena sin tener que duplicar las comillas de adentro. - Los parámetros llevan el prefijo
p_para no confundirlos con columnas. DEFAULT NULLhace opcional el último parámetro.STABLEle dice al optimizador que la función no modifica la base de datos y que, dentro de una misma sentencia, con los mismos argumentos devuelve lo mismo. Una función que no lee tablas seríaIMMUTABLE; una que modifica datos o depende de algo que cambia en cada llamada (comorandom()) esVOLATILE, el valor por defecto.- Si la ruta no existe, el
SELECTno devuelve filas y la función devuelveNULL.
Se usa como cualquier función de SQL, en el SELECT, en el WHERE o donde
vaya una expresión:
chasqui_w05=# SELECT shipment_fare(1, 10);
 shipment_fare
---------------
         42.00
(1 row)
La ruta 1 (Lima - La Victoria → Trujillo) tiene tarifa base S/ 33.00, y 33 + 0.9 · 10 = 42. ¿La fórmula es correcta? Una consulta la compara con el precio guardado de cada envío (la ruta de un envío es la que tiene su mismo origen y destino):
chasqui_w05=# SELECT count(*) AS total,
                     count(*) FILTER (WHERE s.price = shipment_fare(r.route_id, s.weight_kg, s.declared_value)) AS iguales
              FROM shipment s
                JOIN route r ON r.origin_agency_id = s.origin_agency_id AND r.dest_agency_id = s.dest_agency_id;
 total | iguales
-------+---------
 12000 |   12000
(1 row)
Funciones en PL/pgSQL
Con LANGUAGE plpgsql el cuerpo es un bloque con variables (DECLARE),
IF, ciclos y manejo de errores. quote_fare cotiza un envío a partir del
origen y el destino, y avisa si los datos no tienen sentido:
CREATE OR REPLACE FUNCTION quote_fare(p_origin integer,
                                      p_dest integer,
                                      p_weight numeric,
                                      p_declared numeric DEFAULT NULL)
RETURNS numeric
LANGUAGE plpgsql
STABLE
AS $$
DECLARE
  v_fare numeric;
BEGIN
  IF p_weight IS NULL OR p_weight <= 0 THEN
    RAISE EXCEPTION 'peso inválido: %', p_weight
      USING ERRCODE = 'check_violation';
  END IF;

  SELECT base_fare INTO v_fare
  FROM route
  WHERE origin_agency_id = p_origin AND dest_agency_id = p_dest;

  IF NOT FOUND THEN
    RAISE EXCEPTION 'no hay ruta de la agencia % a la agencia %', p_origin, p_dest
      USING ERRCODE = 'no_data_found';
  END IF;

  RETURN round(v_fare + 0.9 * p_weight + 0.01 * coalesce(p_declared, 0), 2);
END;
$$;
SELECT ... INTO guarda el resultado en una variable, y FOUND dice si el
último SELECT encontró una fila. RAISE EXCEPTION aborta la sentencia que
llamó a la función con un error; % se reemplaza por los argumentos, y
ERRCODE elige el SQLSTATE que va a ver el programa en err.code:
chasqui_w05=# SELECT quote_fare(1, 7, 10, 500);
 quote_fare
------------
      47.00
(1 row)

chasqui_w05=# SELECT quote_fare(1, 29, 10);
ERROR:  no hay ruta de la agencia 1 a la agencia 29
CONTEXT:  PL/pgSQL function quote_fare(integer,integer,numeric,numeric) line 15 at RAISE
chasqui_w05=# SELECT quote_fare(1, 7, -2);
ERROR:  peso inválido: -2
CONTEXT:  PL/pgSQL function quote_fare(integer,integer,numeric,numeric) line 6 at RAISE
En la primera, 33 + 9 + 0.01 · 500 = 47. Desde Node, el segundo error llega
con err.code === 'P0002' y el tercero con '23514'; las pruebas lo
verifican.
En PostgreSQL.
CREATE OR REPLACE FUNCTIONreemplaza la función si ya existe con los mismos tipos de parámetros. PostgreSQL permite overloading: dos funciones con el mismo nombre y distintos tipos de parámetros son funciones distintas, y\df shipment_fareenpsqllas lista.
Funciones que devuelven tablas
Una función puede devolver un conjunto de filas con RETURNS TABLE (...), y
entonces se usa en el FROM, como una tabla con parámetros. routes_from
lista las rutas que salen de una ciudad con cuántos envíos llevó cada una:
CREATE OR REPLACE FUNCTION routes_from(p_city text)
RETURNS TABLE (route_id integer, origin text, dest text, base_fare numeric, shipments bigint)
LANGUAGE sql
STABLE
AS $$
  SELECT r.route_id, o.name, d.name, r.base_fare, count(s.shipment_id)
  FROM route r
    JOIN agency o ON o.agency_id = r.origin_agency_id
    JOIN agency d ON d.agency_id = r.dest_agency_id
    LEFT JOIN shipment s ON s.origin_agency_id = r.origin_agency_id
                        AND s.dest_agency_id = r.dest_agency_id
  WHERE o.city = p_city
  GROUP BY r.route_id, o.name, d.name, r.base_fare;
$$;
chasqui_w05=# SELECT * FROM routes_from('Cusco') ORDER BY shipments DESC;
route_id | origin | dest | base_fare | shipments
----------+-----------------+---------------------------+-----------+-----------
44 | Cusco - Wanchaq | Lima - La Victoria | 38.00 | 138
46 | Cusco - Wanchaq | Lima - Los Olivos | 38.50 | 123
109 | Cusco - Wanchaq | Puerto Maldonado - Centro | 23.00 | 92
86 | Cusco - Wanchaq | Abancay - Centro | 13.50 | 92
100 | Cusco - Wanchaq | Arequipa - Centro | 24.00 | 89
106 | Cusco - Wanchaq | Juliaca - Centro | 18.00 | 76
(6 rows)El LEFT JOIN y el count(s.shipment_id) (no count(*)) hacen que una ruta
sin envíos aparezca con 0, como vimos en la semana 3. El libro llama a esto
table functions (sec. 5.2); se parecen a una vista, con la diferencia de
que reciben parámetros.
Procedimientos
Un procedimiento (CREATE PROCEDURE) se invoca con CALL y no devuelve
un valor. En PostgreSQL tiene una capacidad que una función no tiene: puede
hacer COMMIT o ROLLBACK por dentro. Sirve para tareas de mantenimiento que
procesan datos por partes y quieren ir guardando el avance.
refresh_agency_stats recalcula una tabla de resumen por agencia:
CREATE OR REPLACE PROCEDURE refresh_agency_stats()
LANGUAGE plpgsql
AS $$
BEGIN
  DELETE FROM agency_stats;
  INSERT INTO agency_stats (agency_id, shipments, revenue, refreshed_at)
  SELECT a.agency_id, count(s.shipment_id), coalesce(sum(s.price), 0), now()
  FROM agency a
    LEFT JOIN shipment s ON s.origin_agency_id = a.agency_id
  GROUP BY a.agency_id;
  COMMIT;
END;
$$;
chasqui_w05=# CALL refresh_agency_stats();
CALL
chasqui_w05=# SELECT * FROM agency_stats ORDER BY revenue DESC LIMIT 5;
agency_id | shipments | revenue | refreshed_at
-----------+-----------+-----------+-------------------------------
1 | 1823 | 116713.45 | 2026-10-31 20:48:56.003195-05
3 | 1168 | 71252.76 | 2026-10-31 20:48:56.003195-05
2 | 974 | 60320.42 | 2026-10-31 20:48:56.003195-05
8 | 698 | 45282.52 | 2026-10-31 20:48:56.003195-05
9 | 539 | 41478.76 | 2026-10-31 20:48:56.003195-05
(5 rows)El COMMIT de adentro solo funciona si el CALL no está dentro de una
transacción que abrió quien llama:
chasqui_w05=# BEGIN;
BEGIN
chasqui_w05=*# CALL refresh_agency_stats();
ERROR:  invalid transaction termination
CONTEXT:  PL/pgSQL function refresh_agency_stats() line 9 at COMMIT
Tiene sentido: la transacción es de quien la abrió, y un procedimiento no puede hacer commit de un trabajo que no es suyo.
¿En la base de datos o en la aplicación?
Si se puede escribir en las dos partes, ¿dónde va la lógica? No hay una regla
única, pero sí un criterio: una regla que debe cumplirse sin importar qué
programa escriba los datos va en la base de datos. El script de una
migración, la aplicación de la agencia y el analista que corrige un dato a
mano en psql pasan todos por el DBMS; solo uno de ellos pasa por el código
de la aplicación. Por eso las restricciones de la semana 4 están en el
esquema.
En sentido contrario, la lógica que depende de la interfaz, de servicios
externos o de reglas de negocio que cambian seguido suele ir en la aplicación,
donde es más fácil de probar, de versionar y de depurar. Una función como
shipment_fare está en el medio: ponerla en la base de datos garantiza que
todos calculen el precio igual, a cambio de que cambiar la tarifa sea un
cambio en la base de datos.
Triggers
Qué es un trigger
Un trigger es una función que el DBMS ejecuta sola cuando ocurre un evento
sobre una tabla: un INSERT, un UPDATE o un DELETE (Silberschatz,
sec. 5.3). Se define con tres datos:
- El evento: qué sentencia sobre qué tabla lo dispara. Con
UPDATE OF statusse limita a losUPDATEque asignan esa columna. - El momento:
BEFORE(antes de guardar cada fila, con la posibilidad de cambiarla o descartarla) oAFTER(después, cuando el cambio ya está hecho). - La granularidad:
FOR EACH ROW(una vez por cada fila afectada) oFOR EACH STATEMENT(una vez por sentencia, aunque afecte cero filas o diez mil).
Opcionalmente, una condición WHEN (...) que se evalúa antes de llamar a la
función. En un trigger de fila, la función ve dos registros: OLD, la fila
como estaba (en UPDATE y DELETE), y NEW, la fila como va a quedar (en
INSERT y UPDATE).
En PostgreSQL. El trigger y su código van por separado: primero una función que devuelve
trigger(escrita en PL/pgSQL, sin parámetros) y despuésCREATE TRIGGER ... EXECUTE FUNCTION nombre(). En el estándar y en el libro, el cuerpo va dentro del mismoCREATE TRIGGER, conREFERENCING NEW ROW AS nrow; en PostgreSQL los registros se llaman siempreNEWyOLD.
AFTER: un log de cambios de estado
Queremos saber quién cambió el estado de cada envío y cuándo, sin depender de
que cada programa se acuerde de anotarlo. triggers.sql
crea una tabla de log y un trigger AFTER UPDATE OF status que inserta una
fila por cada envío que cambia de estado:
CREATE TABLE IF NOT EXISTS shipment_status_log (
  log_id      bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  shipment_id integer NOT NULL REFERENCES shipment,
  old_status  text NOT NULL,
  new_status  text NOT NULL,
  changed_at  timestamptz NOT NULL DEFAULT now(),
  changed_by  text NOT NULL DEFAULT current_user
);

CREATE OR REPLACE FUNCTION log_status_change()
RETURNS trigger
LANGUAGE plpgsql
AS $$
BEGIN
  INSERT INTO shipment_status_log (shipment_id, old_status, new_status)
  VALUES (NEW.shipment_id, OLD.status, NEW.status);
  RETURN NULL;  -- en un trigger AFTER el valor de retorno se ignora
END;
$$;

CREATE OR REPLACE TRIGGER shipment_status_log_trg
  AFTER UPDATE OF status ON shipment
  FOR EACH ROW
  WHEN (OLD.status IS DISTINCT FROM NEW.status)
  EXECUTE FUNCTION log_status_change();
¿Por qué el WHEN, si ya dice UPDATE OF status? Porque UPDATE OF status
dispara el trigger cuando status aparece en el SET, aunque el valor no
cambie: UPDATE shipment SET status = status lo dispararía. El WHEN deja
pasar solo los cambios reales, y usa IS DISTINCT FROM en vez de <> para
que la comparación con NULL dé verdadero o falso y no desconocido (aquí
status es NOT NULL, pero es una buena costumbre).
BEFORE: cambiar la fila antes de guardarla
Un trigger BEFORE de fila puede modificar NEW, y lo que devuelve es la
fila que se va a guardar. Si devuelve NULL, la operación sobre esa fila se
cancela sin error. Este llena delivered_at con la hora actual cuando un
envío pasa a 'delivered' y nadie dio la fecha:
CREATE OR REPLACE FUNCTION fill_delivered_at()
RETURNS trigger
LANGUAGE plpgsql
AS $$
BEGIN
  IF NEW.status = 'delivered' AND NEW.delivered_at IS NULL THEN
    NEW.delivered_at := now();
  END IF;
  RETURN NEW;  -- la fila que se va a guardar
END;
$$;

CREATE OR REPLACE TRIGGER shipment_fill_delivered_at_trg
  BEFORE UPDATE OF status ON shipment
  FOR EACH ROW
  EXECUTE FUNCTION fill_delivered_at();
Con un trigger AFTER esto no se podría: cuando corre, la fila ya está
guardada, y cambiar NEW no tiene efecto. Para corregirla habría que hacer
otro UPDATE, y eso vuelve a disparar los triggers (ver el error común más
abajo).
Los dos triggers en acción
Dentro de una transacción que termina en ROLLBACK, para no cambiar los
datos, entregamos el envío 46:
chasqui_w05=# BEGIN;
BEGIN
chasqui_w05=*# UPDATE shipment SET status = 'delivered' WHERE shipment_id = 46
               RETURNING shipment_id, status, delivered_at;
 shipment_id |  status   |         delivered_at
-------------+-----------+-------------------------------
          46 | delivered | 2026-10-31 20:54:29.512552-05
(1 row)

UPDATE 1
chasqui_w05=*# SELECT shipment_id, old_status, new_status, changed_by FROM shipment_status_log;
 shipment_id | old_status | new_status | changed_by
-------------+------------+------------+------------
          46 | in_transit | delivered  | postgres
(1 row)
El UPDATE no mencionaba delivered_at y, sin embargo, quedó lleno: lo hizo
el trigger BEFORE. Y el log tiene la fila del cambio: la puso el trigger
AFTER. Ninguno de los dos depende del programa que hizo el UPDATE.
delivered_at es la hora del día en que se corrió el ejemplo, no una fecha de
los datos: now() es la hora de inicio de la transacción actual.
FOR EACH STATEMENT y las tablas de transición
Un trigger de sentencia se dispara una vez por sentencia, y no tiene NEW ni
OLD. Para ver las filas afectadas, el estándar (y PostgreSQL) ofrece las
tablas de transición: con REFERENCING NEW TABLE AS changed, la función
puede consultar changed como una tabla con todas las filas nuevas de la
sentencia. Este trigger anota, por cada UPDATE sobre shipment, cuántas
filas cambió; su función hace INSERT INTO shipment_update_batch (rows_count) SELECT count(*) FROM changed:
CREATE OR REPLACE TRIGGER shipment_update_batch_trg
  AFTER UPDATE ON shipment
  REFERENCING NEW TABLE AS changed
  FOR EACH STATEMENT
  EXECUTE FUNCTION log_update_batch();
Seguimos en la misma transacción del ejemplo anterior:
chasqui_w05=*# UPDATE shipment SET status = 'returned' WHERE status = 'in_transit' AND origin_agency_id = 1;
UPDATE 14
chasqui_w05=*# UPDATE shipment SET price = price WHERE shipment_id = 2;
UPDATE 1
chasqui_w05=*# SELECT batch_id, rows_count FROM shipment_update_batch;
 batch_id | rows_count
----------+------------
        1 |          1
        2 |         14
        3 |          1
(3 rows)

chasqui_w05=*# SELECT count(*) FROM shipment_status_log;
 count
-------
    15
(1 row)

chasqui_w05=*# ROLLBACK;
ROLLBACK
Tres sentencias UPDATE, tres filas en shipment_update_batch: una por
sentencia, con 1, 14 y 1 filas. En cambio, el log de estados tiene 15 filas:
una por cada envío que cambió de estado (1 + 14); el UPDATE del precio no
cambió ningún estado y el trigger de fila no se disparó. Las pruebas
verifican además que un UPDATE que no afecta ninguna fila también dispara el
trigger de sentencia, con rows_count = 0.
En PostgreSQL. Cuando varios triggers se disparan por el mismo evento y en el mismo momento, PostgreSQL los ejecuta en orden alfabético por nombre. Los
BEFOREde fila corren antes de que se verifiquen las restriccionesCHECKyNOT NULL, así que unBEFOREpuede completar un valor que la restricción exige.
Errores comunes con triggers
Error común. Un trigger que modifica la misma tabla que lo dispara.
trigger_loop.sqlcrea, dentro de una transacción que termina enROLLBACK, un triggerAFTER UPDATE ON shipmentcuya función haceUPDATE shipment .... EseUPDATEvuelve a disparar el trigger, que hace otroUPDATE, y así hasta que se acaba la pila:psql:/work/code/week-05/trigger_loop.sql:22: ERROR: stack depth limit exceeded HINT: Increase the configuration parameter "max_stack_depth" (currently 2048kB), after ensuring the platform's stack depth limit is adequate. CONTEXT: SQL statement "UPDATE shipment SET price = NEW.price WHERE shipment_id = NEW.shipment_id" PL/pgSQL function touch_shipment() line 3 at SQL statement SQL statement "UPDATE shipment SET price = NEW.price WHERE shipment_id = NEW.shipment_id" PL/pgSQL function touch_shipment() line 3 at SQL statement ...El arreglo casi siempre es un trigger
BEFOREque cambiaNEWen vez de hacer otroUPDATE. (ElHINTsugiere aumentar la pila: no es la solución.)
Error común. Usar un trigger para algo que una restricción ya hace mejor. “El peso es positivo” es un
CHECK; “la agencia existe” es una clave foránea. Una restricción es declarativa, el optimizador la conoce, se verifica siempre y su error tiene un código estándar. Un trigger es código que hay que escribir bien, que puede tener errores y que se puede desactivar. Se reserva para lo que una restricción no puede expresar: reglas que miran otras filas u otras tablas, o efectos como el log de arriba.
Silberschatz (sec. 5.3.3) agrega otro caso: los triggers pueden disparar
acciones inesperadas cuando se cargan datos de un backup o se replican, porque
la acción ya se hizo una vez en el origen. Por eso hay formas de desactivarlos
(ALTER TABLE ... DISABLE TRIGGER), y por eso conviene que un trigger haga
poco y se entienda leyendo solo su definición.
Consultas recursivas
La clausura transitiva
¿A qué agencias se puede llegar desde Lima - La Victoria usando una o más
rutas? Con una ruta, es un SELECT sobre route. Con exactamente dos, un join
de route consigo misma. Con tres, dos joins. Pero no sabemos cuántas rutas
hacen falta, y el álgebra relacional de la semana 2 no tiene un operador para
“tantas veces como haga falta”: cada expresión tiene un número fijo de joins, y
para cualquier número fijo hay una red de rutas con caminos más largos.
Lo que buscamos es la clausura transitiva de la relación route: el par
(a, b) está en la clausura si hay una ruta de a a b, o si hay una ruta de a a
algún c y (c, b) está en la clausura. La definición se usa a sí misma, y SQL
la expresa con WITH RECURSIVE (Silberschatz, sec. 5.4).
recursive.sql:
WITH RECURSIVE reachable (agency_id) AS (
    SELECT dest_agency_id
    FROM route
    WHERE origin_agency_id = 1
  UNION
    SELECT r.dest_agency_id
    FROM reachable re
      JOIN route r ON r.origin_agency_id = re.agency_id
)
SELECT count(*) AS agencies
FROM reachable;
agencies
----------
28
(1 row)Una CTE recursiva tiene dos partes unidas por UNION o UNION ALL:
- La parte no recursiva (arriba): las agencias a un tramo de Lima - La Victoria. Son 14.
- La parte recursiva (abajo): menciona a
reachabley avanza un tramo desde lo que ya se alcanzó.
Cómo se evalúa: hasta el punto fijo
El DBMS no ejecuta la recursión llamándose a sí mismo; la evalúa por iteraciones:
- Ejecuta la parte no recursiva. Su resultado va al resultado final y a una tabla de trabajo.
- Ejecuta la parte recursiva usando como
reachablesolo la tabla de trabajo (las filas nuevas de la vuelta anterior). - Con
UNION, descarta las filas repetidas, tanto dentro del resultado de la vuelta como las que ya estaban en el resultado final. Lo que queda va al resultado final y pasa a ser la nueva tabla de trabajo. - Si la tabla de trabajo quedó vacía, termina. Si no, vuelve al paso 2.
Aquí: la vuelta 0 da las 14 agencias a un tramo; la primera vuelta recursiva, las que están a dos tramos y no se habían visto; y así, hasta una vuelta en que todas las agencias que se alcanzan ya estaban. Como hay 29 agencias, las vueltas no pueden producir filas nuevas para siempre. El resultado es el punto fijo de la definición: un conjunto que, al aplicarle la parte recursiva, no cambia.
El libro explica por qué esto funciona: la parte recursiva debe ser
monótona, es decir, si la relación recursiva crece, su resultado no puede
achicarse. Por eso el estándar no permite, en la parte recursiva, agregación
sobre la relación recursiva ni NOT EXISTS o EXCEPT contra ella: con esas
operaciones agregar filas podría quitar otras, y la iteración no tendría un
punto fijo bien definido.
¿Por qué 28 y no 29? La consulta unreachable_from_lima busca las agencias
que no están en la clausura, con WHERE a.agency_id NOT IN (SELECT agency_id FROM reachable):
 agency_id |       name
-----------+------------------
        29 | Iquitos - Centro
(1 row)
A Iquitos no llega ninguna carretera, y no tiene rutas. Las otras 28 incluyen
a la propia Lima - La Victoria, que se alcanza yendo y volviendo (por ejemplo,
a Lima - Los Olivos y de regreso). (El NOT IN es seguro aquí porque
agency_id nunca es NULL; recuerden de la semana 3 lo que pasa cuando la
subconsulta trae un NULL.)
Ciclos: UNION frente a UNION ALL
La red de rutas tiene ciclos: hay ruta de Lima a Cusco y de Cusco a Lima. Con
UNION, que descarta lo ya visto, los ciclos no importan. Pero en cuanto la
CTE lleva algo más que la agencia, como el número de tramos, cada vuelta
produce filas distintas (la misma agencia con un tramo más), UNION ya no
descarta nada y la recursión sigue dando vueltas al ciclo. Con UNION ALL
pasa lo mismo aunque no haya columnas extra. En recursive.sql la consulta
endless lo muestra, con un tiempo límite para que no se quede corriendo:
SET statement_timeout = '2s';
WITH RECURSIVE trip_path (agency_id, hops) AS (
    SELECT dest_agency_id, 1 FROM route WHERE origin_agency_id = 1
  UNION ALL
    SELECT r.dest_agency_id, tp.hops + 1
    FROM trip_path tp
      JOIN route r ON r.origin_agency_id = tp.agency_id
)
SELECT count(*) FROM trip_path;
RESET statement_timeout;
SET
psql:/work/code/week-05/recursive.sql:109: ERROR: canceling statement due to statement timeout
RESET(La misma consulta con UNION en vez de UNION ALL también se corta por el
tiempo límite: las filas (agencia, tramos) nunca se repiten.)
Hay tres formas de controlar los ciclos:
- Limitar los tramos:
WHERE tp.hops < 4en la parte recursiva. - Guardar el camino en un arreglo y no volver a una agencia que ya está
en él:
path || r.dest_agency_idpara extenderlo yr.dest_agency_id <> ALL (path)para filtrar. - La cláusula
CYCLEde PostgreSQL, que hace lo mismo que la opción 2 sin escribir el arreglo a mano.
La consulta hops_from_lima combina las dos primeras y calcula el menor
número de tramos hasta cada agencia; aquí mostramos solo las que están a tres
o más:
WITH RECURSIVE trip_path (agency_id, hops, path) AS (
    SELECT dest_agency_id, 1, ARRAY[1, dest_agency_id]
    FROM route
    WHERE origin_agency_id = 1
  UNION ALL
    SELECT r.dest_agency_id, tp.hops + 1, tp.path || r.dest_agency_id
    FROM trip_path tp
      JOIN route r ON r.origin_agency_id = tp.agency_id
    WHERE r.dest_agency_id <> ALL (tp.path)
      AND tp.hops < 4
)
SELECT a.name, min(tp.hops) AS hops
FROM trip_path tp
  JOIN agency a ON a.agency_id = tp.agency_id
GROUP BY a.name
HAVING min(tp.hops) >= 3
ORDER BY hops, a.name;
name | hops
-------------------+------
Pucallpa - Centro | 3
Puno - Centro | 3
Tacna - Centro | 3
(3 rows)Contadas todas, hay 14 agencias a un tramo, 10 a dos y 3 a tres: las 27
alcanzables distintas de Lima - La Victoria. Ella misma no aparece, porque el
arreglo empieza con ella y el filtro no deja volver. Con el arreglo, la recursión terminaría aunque no tuviera el límite
de tramos, porque un camino sin agencias repetidas tiene a lo más 28 tramos.
Pero el número de caminos simples crece muy rápido con el largo, así que el
límite sigue siendo necesario para que la consulta sea rápida. La agregación
(min) va afuera de la CTE, no en la parte recursiva, por la regla de
monotonía.
La cláusula CYCLE hace el trabajo del arreglo: después de la CTE se escribe
CYCLE agency_id SET is_cycle USING path, y PostgreSQL agrega dos columnas,
path con el camino y is_cycle que marca la fila que repite una agencia; esa
fila no se sigue expandiendo.
WITH RECURSIVE trip_path (agency_id, hops) AS (
    SELECT 1, 0
  UNION ALL
    SELECT r.dest_agency_id, tp.hops + 1
    FROM trip_path tp
      JOIN route r ON r.origin_agency_id = tp.agency_id
    WHERE tp.hops < 4
) CYCLE agency_id SET is_cycle USING path
SELECT count(*) FILTER (WHERE NOT is_cycle) AS paths,
       count(*) FILTER (WHERE is_cycle) AS cycles,
       count(DISTINCT agency_id) FILTER (WHERE NOT is_cycle) AS agencies
FROM trip_path;
paths | cycles | agencies
-------+--------+----------
1018 | 604 | 28
(1 row)Aquí la parte no recursiva es la propia agencia 1 con 0 tramos, para que también ella quede en el camino. Hay 1018 caminos sin repetir agencias, de 0 a 4 tramos (el de 0 tramos es la agencia 1 sola), y 604 filas que cerraron un ciclo y se descartaron.
En PostgreSQL.
CYCLEy su parienteSEARCH(que agrega una columna para ordenar el resultado en anchura o en profundidad) son cláusulas del estándar SQL, y PostgreSQL las tiene desde la versión 14. Antes, el control de ciclos se escribía a mano con el arreglo. Las CTE recursivas, conWITH RECURSIVE, son estándar desde SQL:1999.
Ejemplo resuelto: la combinación más barata de Lima a Puno
Con el camino guardado, también podemos sumar las tarifas tramo por tramo y quedarnos con las combinaciones más baratas para llegar a Puno - Centro (agency_id 18):
WITH RECURSIVE trip_path (agency_id, hops, fare, path) AS (
    SELECT dest_agency_id, 1, base_fare::numeric, ARRAY[1, dest_agency_id]
    FROM route
    WHERE origin_agency_id = 1
  UNION ALL
    SELECT r.dest_agency_id, tp.hops + 1, tp.fare + r.base_fare, tp.path || r.dest_agency_id
    FROM trip_path tp
      JOIN route r ON r.origin_agency_id = tp.agency_id
    WHERE r.dest_agency_id <> ALL (tp.path)
      AND tp.hops < 4
)
SELECT tp.hops, tp.fare,
       (SELECT string_agg(a.city, ' → ' ORDER BY p.ord)
        FROM unnest(tp.path) WITH ORDINALITY AS p (agency_id, ord)
          JOIN agency a ON a.agency_id = p.agency_id) AS cities
FROM trip_path tp
WHERE tp.agency_id = 18
ORDER BY tp.fare, tp.hops
LIMIT 3;
hops | fare | cities
------+-------+--------------------------------------
3 | 66.50 | Lima → Cusco → Juliaca → Puno
3 | 76.00 | Lima → Arequipa → Juliaca → Puno
4 | 76.00 | Lima → Lima → Cusco → Juliaca → Puno
(3 rows)La subconsulta del SELECT convierte el arreglo de agencias en el texto con
las ciudades (WITH ORDINALITY numera los elementos para mantener el orden).
La tercera fila empieza con “Lima → Lima”: es un tramo de La Victoria a otra
agencia de Lima antes de salir de la ciudad. La mejor combinación tiene la
garantía de ser la más barata entre las de a lo más 4 tramos; con este
límite no podemos asegurar que no haya una más barata con más tramos.
Fíjense en el ::numeric de la parte no recursiva. Sin él, PostgreSQL
rechaza la consulta:
ERROR:  recursive query "trip_path" column 3 has type numeric(8,2) in non-recursive term but type numeric overall
LINE 2:     SELECT dest_agency_id, 1, base_fare, ARRAY[1, dest_agency_id]...
                                      ^
HINT:  Cast the output of the non-recursive term to the correct type.
Las columnas de una CTE recursiva deben tener exactamente el mismo tipo en las
dos partes. base_fare es numeric(8,2), pero la suma tp.fare + r.base_fare es numeric sin precisión fija, así que hay que convertir en la
parte no recursiva, como sugiere el HINT.
Idea clave. Una consulta recursiva calcula un punto fijo: arranca con la parte no recursiva y agrega lo que produce la parte recursiva hasta que no aparece nada nuevo. Termina solo si en algún momento deja de aparecer algo nuevo, y eso es responsabilidad de quien la escribe:
UNIONsobre columnas que se repiten, un límite de tramos o un control de ciclos.
Window functions
Calcular por fila mirando a otras filas
GROUP BY resume: de 47 clientes de Puno saca una fila con count = 47.
Muchas preguntas necesitan otra cosa: un valor por fila que dependa de otras
filas relacionadas. ¿En qué puesto está este cliente dentro de su ciudad?
¿Cuánto lleva vendido la agencia hasta este envío? ¿Cuánto tiempo pasó desde
el evento anterior de este envío? Para eso están las window functions
(Silberschatz, sec. 5.5), que se reconocen por la cláusula OVER:
chasqui_w05=# SELECT city, count(*) FROM customer WHERE city IN ('Puno','Tacna') GROUP BY city;
 city  | count
-------+-------
 Puno  |    47
 Tacna |    46
(2 rows)

chasqui_w05=# SELECT customer_id, city, count(*) OVER (PARTITION BY city) AS in_city
              FROM customer WHERE city IN ('Puno','Tacna') ORDER BY city, customer_id LIMIT 4;
 customer_id | city | in_city
-------------+------+---------
           2 | Puno |      47
           6 | Puno |      47
          54 | Puno |      47
          91 | Puno |      47
(4 rows)
La segunda consulta no colapsa las filas: cada cliente sigue en su fila, y al lado tiene el conteo de su ciudad.
La cláusula OVER define la ventana de cada fila con tres piezas, todas
opcionales:
PARTITION BY: divide las filas en grupos; la función de cada fila solo ve las de su partición. SinPARTITION BY, todo el resultado es una partición.ORDER BY: ordena las filas dentro de la partición. Las funciones de ranking lo necesitan, y cambia el frame por defecto (ver más abajo).- El frame: qué filas de la partición, relativas a la fila actual, entran
en el cálculo de una función de agregación (
sum,avg, …).
¿Cuándo se evalúan? Después de FROM, WHERE, GROUP BY y HAVING, y antes
de ORDER BY y LIMIT. Eso tiene dos consecuencias: una window function puede
usar agregados (rank() OVER (ORDER BY sum(price) DESC)), y no puede ir en el
WHERE, que ya se evaluó.
Ranking: rank, dense_rank y row_number
Las tres numeran las filas según el ORDER BY de la ventana. Se diferencian
en los empates. window.sql ordena las rutas por
tarifa:
SELECT route_id, base_fare,
       rank()       OVER w AS rank,
       dense_rank() OVER w AS dense_rank,
       row_number() OVER w AS row_number
FROM route
WINDOW w AS (ORDER BY base_fare DESC)
ORDER BY base_fare DESC, route_id
LIMIT 10;
route_id | base_fare | rank | dense_rank | row_number
----------+-----------+------+------------+------------
37 | 49.50 | 1 | 1 | 2
38 | 49.50 | 1 | 1 | 3
39 | 49.50 | 1 | 1 | 4
40 | 49.50 | 1 | 1 | 5
41 | 49.50 | 1 | 1 | 1
42 | 49.50 | 1 | 1 | 6
25 | 45.50 | 7 | 2 | 8
26 | 45.50 | 7 | 2 | 7
23 | 45.00 | 9 | 3 | 9
24 | 45.00 | 9 | 3 | 10
(10 rows)rank()es 1 más el número de filas que van estrictamente antes. Seis rutas empatan con 49.50 y tienen rank 1; la siguiente tiene rank 7, porque hay seis antes. Deja huecos, como en una competencia: si seis empatan en primer lugar, no hay segundo.dense_rank()no deja huecos: es 1 más el número de valores distintos que van antes. Las de 45.50 tienen dense_rank 2.row_number()numera 1, 2, 3, … sin repetir, y entre filas empatadas el orden es arbitrario: aquí la ruta 41 quedó con 1 y la 37 con 2. Otra ejecución, con otro plan, podría numerarlas distinto.
WINDOW w AS (...) le pone nombre a una ventana para no repetirla en las
tres columnas.
Error común. Usar
row_number()para “los tres primeros” cuando hay empates, y que el resultado cambie entre ejecuciones. Si los empates deben entrar todos, usenrank()(y acepten que pueden salir más de tres); si tiene que ser exactamente uno por puesto, agreguen alORDER BYde la ventana una columna que desempate, como la clave primaria.
Los primeros de cada grupo
¿Quiénes son los dos clientes que más gastaron en envíos (como remitentes) en
cada ciudad del sur? El ranking se hace por ciudad (PARTITION BY c.city) y
sobre el total de cada cliente, que es un agregado:
WITH spent AS (
  SELECT c.city, c.customer_id, c.last_name, sum(s.price) AS total,
         rank() OVER (PARTITION BY c.city ORDER BY sum(s.price) DESC) AS pos
  FROM customer c
    JOIN shipment s ON s.sender_id = c.customer_id
  WHERE c.city IN ('Arequipa', 'Cusco', 'Puno', 'Tacna')
  GROUP BY c.city, c.customer_id, c.last_name
)
SELECT city, pos, customer_id, last_name, total
FROM spent
WHERE pos <= 2
ORDER BY city, pos, customer_id;
city | pos | customer_id | last_name | total
----------+-----+-------------+-------------------+---------
Arequipa | 1 | 1637 | Condori Ramírez | 3362.86
Arequipa | 2 | 847 | Huanca Mamani | 3315.56
Cusco | 1 | 1066 | Torres Sánchez | 4107.83
Cusco | 2 | 1742 | Rojas García | 1553.43
Puno | 1 | 1588 | Paredes Yupanqui | 3212.32
Puno | 2 | 1373 | Gutiérrez Silva | 2734.15
Tacna | 1 | 1412 | Quispe Vargas | 3454.62
Tacna | 2 | 623 | Villanueva Vargas | 2900.55
(8 rows)El orden de evaluación explica la forma de la consulta: primero el JOIN y el
WHERE, después el GROUP BY que suma por cliente, después el rank() sobre
esas sumas. El filtro pos <= 2 no puede ir en el mismo SELECT, porque su
WHERE se evalúa antes que el ranking:
chasqui_w05=# SELECT route_id FROM route WHERE rank() OVER (ORDER BY base_fare DESC) <= 3;
ERROR:  window functions are not allowed in WHERE
LINE 1: SELECT route_id FROM route WHERE rank() OVER (ORDER BY base_...
                                         ^
La solución es la de la consulta: calcular el ranking en una CTE (o una
subconsulta en el FROM) y filtrar afuera.
Agregados con ventana: el acumulado
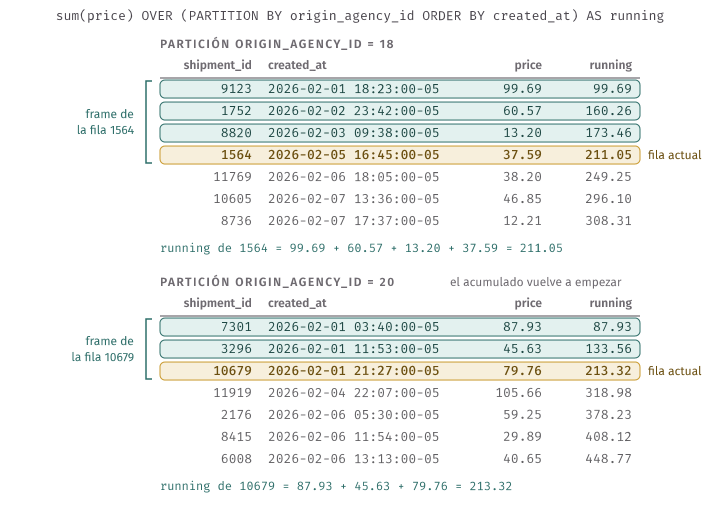
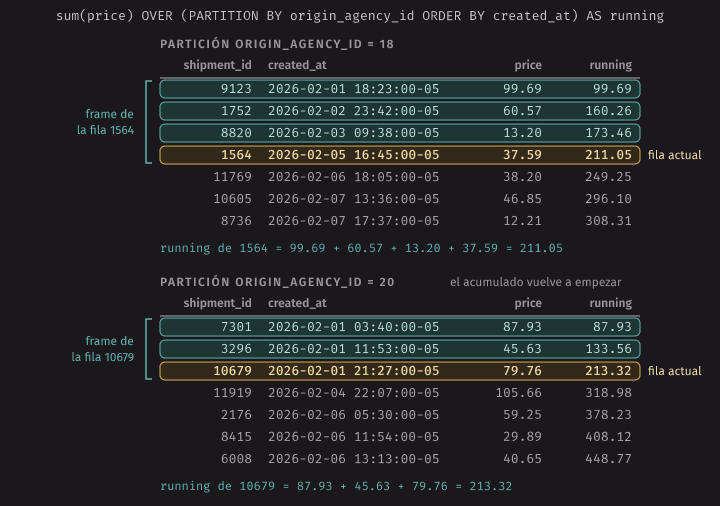
Una función de agregación con OVER deja de colapsar las filas. Con
ORDER BY en la ventana, sum da el acumulado: la suma desde el principio de
la partición hasta la fila actual. El acumulado de ventas de dos agencias,
envío por envío, en la primera semana de febrero:
SELECT origin_agency_id AS agency, shipment_id, created_at, price,
       sum(price) OVER (PARTITION BY origin_agency_id ORDER BY created_at) AS running
FROM shipment
WHERE origin_agency_id IN (18, 20)
  AND created_at >= '2026-02-01' AND created_at < '2026-02-08'
ORDER BY origin_agency_id, created_at;
agency | shipment_id | created_at | price | running
--------+-------------+------------------------+--------+---------
18 | 9123 | 2026-02-01 18:23:00-05 | 99.69 | 99.69
18 | 1752 | 2026-02-02 23:42:00-05 | 60.57 | 160.26
18 | 8820 | 2026-02-03 09:38:00-05 | 13.20 | 173.46
18 | 1564 | 2026-02-05 16:45:00-05 | 37.59 | 211.05
18 | 11769 | 2026-02-06 18:05:00-05 | 38.20 | 249.25
18 | 10605 | 2026-02-07 13:36:00-05 | 46.85 | 296.10
18 | 8736 | 2026-02-07 17:37:00-05 | 12.21 | 308.31
20 | 7301 | 2026-02-01 03:40:00-05 | 87.93 | 87.93
20 | 3296 | 2026-02-01 11:53:00-05 | 45.63 | 133.56
20 | 10679 | 2026-02-01 21:27:00-05 | 79.76 | 213.32
20 | 11919 | 2026-02-04 22:07:00-05 | 105.66 | 318.98
20 | 2176 | 2026-02-06 05:30:00-05 | 59.25 | 378.23
20 | 8415 | 2026-02-06 11:54:00-05 | 29.89 | 408.12
20 | 6008 | 2026-02-06 13:13:00-05 | 40.65 | 448.77
(14 rows)En la primera fila de Tacna (20) el acumulado vuelve a empezar: cada partición
es independiente. Aquí la ventana se calcula sobre las filas que dejó pasar el
WHERE, así que el acumulado es “desde el 1 de febrero”, no desde el inicio
de los datos.
Frames
¿Qué filas suma exactamente sum(price) OVER (...)? Las de su frame. Las
reglas por defecto:
- Sin
ORDER BYen la ventana, el frame es la partición completa:sum(price) OVER ()es el total, igual en todas las filas. - Con
ORDER BY, el frame por defecto esRANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW: desde el inicio de la partición hasta la fila actual y todas las que empatan con ella en elORDER BY(sus peers).
chasqui_w05=# SELECT shipment_id, price, sum(price) OVER (ORDER BY created_at) AS running, sum(price) OVER () AS total
              FROM shipment WHERE origin_agency_id = 18 AND created_at >= '2026-02-01' AND created_at < '2026-02-04' ORDER BY created_at;
 shipment_id | price | running | total
-------------+-------+---------+--------
        9123 | 99.69 |   99.69 | 173.46
        1752 | 60.57 |  160.26 | 173.46
        8820 | 13.20 |  173.46 | 173.46
(3 rows)
Lo de los peers importa cuando hay empates: si dos envíos tuvieran el mismo
created_at, los dos mostrarían el acumulado que ya incluye a ambos. Si se
quiere avanzar fila por fila, se escribe el frame en filas, ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW, con un desempate en el ORDER BY.
El frame también sirve para un promedio móvil. ROWS BETWEEN 6 PRECEDING AND CURRENT ROW toma la fila actual y las seis anteriores. Contamos los
envíos de cada día de Lima - La Victoria (que tiene envíos todos los días de
los datos) y los promediamos de siete en siete:
WITH daily AS (
  SELECT (created_at AT TIME ZONE 'America/Lima')::date AS day, count(*) AS shipments
  FROM shipment
  WHERE origin_agency_id = 1
  GROUP BY 1
), smoothed AS (
  SELECT day, shipments,
         round(avg(shipments) OVER (ORDER BY day ROWS BETWEEN 6 PRECEDING AND CURRENT ROW), 2) AS avg_7
  FROM daily
)
SELECT day, shipments, avg_7
FROM smoothed
WHERE day BETWEEN '2026-03-01' AND '2026-03-07'
ORDER BY day;
day | shipments | avg_7
------------+-----------+-------
2026-03-01 | 9 | 9.71
2026-03-02 | 5 | 9.14
2026-03-03 | 7 | 9.43
2026-03-04 | 11 | 10.00
2026-03-05 | 12 | 9.86
2026-03-06 | 10 | 9.86
2026-03-07 | 11 | 9.29
(7 rows)El filtro por fechas va afuera, en la consulta que lee smoothed, por la
misma razón de antes: si estuviera junto a la ventana, el 1 de marzo no vería
los seis días de febrero que le corresponden, y su promedio sería solo de un
día. Y ROWS cuenta filas, no días: si un día no tuviera envíos, no habría
fila para él y la ventana tomaría un día más atrás. Para contar días se usa
RANGE BETWEEN '6 days' PRECEDING AND CURRENT ROW, que mide la distancia en
el valor del ORDER BY.
lag y lead: la fila anterior y la siguiente
lag(expr) devuelve el valor de expr en la fila anterior de la partición
(según el ORDER BY de la ventana), y lead(expr), el de la siguiente. En la
primera fila, lag da NULL. El tiempo entre cada evento de un envío y el
anterior:
SELECT shipment_id, seq, kind, at,
       at - lag(at) OVER (PARTITION BY shipment_id ORDER BY seq) AS since_previous
FROM shipment_event
WHERE shipment_id = 1
ORDER BY seq;
shipment_id | seq | kind | at | since_previous
-------------+-----+-----------+------------------------+-----------------
1 | 1 | received | 2026-01-28 19:46:00-05 |
1 | 2 | departed | 2026-02-02 12:00:00-05 | 4 days 16:14:00
1 | 3 | arrived | 2026-02-02 16:30:00-05 | 04:30:00
1 | 4 | delivered | 2026-02-04 18:30:00-05 | 2 days 02:00:00
(4 rows)El paquete esperó 4 días y 16 horas en la agencia de Piura antes de salir, el
viaje a Chiclayo duró 4 horas y media, y el destinatario lo recogió dos días
después. Sin window functions esto sería un self join de shipment_event con
la condición e2.seq = e1.seq - 1.
ROLLUP y CUBE
La sec. 5.5 del libro presenta también otras extensiones de GROUP BY para
reportes con subtotales. GROUP BY ROLLUP (a, b) calcula los grupos de
(a, b), después los de (a) solo y por último el total (): es lo mismo que
GROUPING SETS ((a, b), (a), ()). CUBE (a, b) calcula todas las
combinaciones: (a, b), (a), (b) y (). Los ingresos por región y ciudad
de la agencia de origen en dos regiones del sur, con una columna más que
explicamos enseguida (la consulta rollup de window.sql es la misma sin
esa columna y con Arequipa):
SELECT a.region, a.city, grouping(a.region, a.city) AS g, sum(s.price) AS revenue
FROM shipment s
  JOIN agency a ON a.agency_id = s.origin_agency_id
WHERE a.region IN ('Puno', 'Tacna')
GROUP BY ROLLUP (a.region, a.city)
ORDER BY a.region, a.city;
region | city | g | revenue
--------+---------+---+----------
Puno | Juliaca | 0 | 19904.93
Puno | Puno | 0 | 7279.80
Puno | | 1 | 27184.73
Tacna | Tacna | 0 | 8393.39
Tacna | | 1 | 8393.39
| | 3 | 35578.12
(6 rows)Las filas con city vacía son los subtotales por región, y la última es el
total general. Ese vacío es un NULL que significa “todas las ciudades”, y
podría confundirse con un NULL real de los datos. La función grouping(...)
los distingue: devuelve un bit por columna, 1 si la columna fue agregada en
esa fila.
g = 1 (binario 01) es un subtotal por región: se agregó city. g = 3
(binario 11) es el total: se agregaron las dos. Con CUBE (a.region, a.city)
sobre las mismas dos regiones salen 9 filas: 3 por (region, city), 2 por
region, 3 por city y 1 total.
Idea clave.
GROUP BYcolapsa filas en grupos; una window function calcula sobre un grupo de filas pero deja cada fila en su lugar. Si necesitan un dato de la fila y un dato de su grupo en la misma fila (su puesto, su porcentaje del total, la diferencia con la anterior), es una window function.
El código de la semana y make test
Dentro del contenedor, en code/week-05, make crea la base de datos
chasqui_w05 y le carga functions.sql y triggers.sql; make test la
vuelve a crear y corre las pruebas:
$ make test
chasqui-load chasqui_w05
Base de datos chasqui_w05 lista.
psql -X -q -v ON_ERROR_STOP=1 -d chasqui_w05 -f functions.sql -f triggers.sql
PGDATABASE=chasqui_w05 node --test --test-concurrency=1 --test-reporter=spec
✔ la base de datos es chasqui_w05
✔ findCustomerByDni encuentra un DNI conocido
✔ findCustomerByDni con un DNI inexistente devuelve []
✔ los ataques no le hacen nada a la versión parametrizada
✔ la versión vulnerable devuelve todos los clientes con ' OR '1'='1
✔ la versión vulnerable ejecuta un DELETE inyectado (y el ROLLBACK lo deshace)
✔ con parámetros no se pueden mandar dos sentencias
✔ tipos: integer es number, numeric y bigint son string, timestamptz es Date
...
ℹ tests 40
ℹ pass 40
ℹ fail 0
...| Archivo | Qué muestra |
|---|---|
connect.mjs |
Client y Pool, la forma del resultado y los tipos que llegan a JavaScript |
queries.mjs |
Consultas parametrizadas, orden elegido de una lista fija y traducción de errores con err.code |
unsafe.mjs |
La versión vulnerable del buscador por DNI (solo para el ataque) |
injection.mjs |
El ataque contra la versión vulnerable y la parametrizada; solo corre sobre chasqui_w05 |
deliver.mjs |
Una transacción con pool.connect(), BEGIN, COMMIT, ROLLBACK y release() |
wrong-transaction.mjs |
Por qué pool.query('BEGIN') no abre una transacción para lo que sigue |
functions.sql |
Funciones en SQL y en PL/pgSQL, una función que devuelve una tabla y un procedimiento |
triggers.sql |
Triggers BEFORE y AFTER, de fila y de sentencia |
trigger_loop.sql |
Un trigger que se dispara a sí mismo (termina con error a propósito) |
recursive.sql |
Consultas recursivas sobre la red de rutas |
window.sql |
Ranking, acumulados, frames, lag y ROLLUP |
app.test.mjs |
Pruebas de la Sesión A, incluidos los scripts |
sql.test.mjs |
Pruebas de la Sesión B |
Las consultas de recursive.sql y window.sql empiezan con una línea
-- name: .... sqlfile.mjs parte el archivo
por esas líneas, y sql.test.mjs corre cada consulta por su nombre y compara
con los resultados que aparecen en este capítulo: si alguien cambia una
consulta en el archivo, la prueba lo nota. Para verlas en psql, basta
\i recursive.sql.
Las pruebas que cambian datos lo hacen dentro de una transacción que termina
en ROLLBACK, o sobre envíos que ninguna otra prueba usa. Aun así, el
Makefile corre los archivos de prueba uno después del otro
(--test-concurrency=1): node --test los corre en paralelo por defecto, y
el DELETE inyectado de una prueba no debe coincidir con los conteos de
otra.
Resumen
- Un programa habla con el DBMS por una conexión: envía el texto de una
sentencia y recibe filas o un error. En Node.js se usa el driver
pg; en Java, JDBC.ClientesConnection,PoolesDataSource,$1es el?de unPreparedStatement. - Un
Clientes una conexión (connect,end); unPoolpresta conexiones (pool.query,pool.connect,pool.end). Una aplicación crea un pool y lo comparte; las funciones lo reciben y no lo cierran. result.rowses un arreglo de objetos;result.rowCount, las filas devueltas o modificadas.integerllega comonumber;numericybigint(incluidocount(*)) comostring;timestamptzcomoDate;NULLcomonull.- Los errores traen
err.code(SQLSTATE) yerr.constraint; con ellos el programa distingue los errores del usuario de los demás. - Inyección SQL: si el texto del usuario se pega en la consulta, el
usuario escribe SQL. Sin parámetros,
pgacepta varias sentencias en un texto. La defensa son las consultas parametrizadas: el texto y los valores viajan por separado y un valor nunca se interpreta como SQL. $1reemplaza valores, no nombres de columnas ni palabras clave; esas partes se eligen de una lista fija escrita por el programador.- Una transacción desde Node.js va por un solo client:
pool.connect(),BEGIN, sentencias,COMMIT,ROLLBACKen elcatchyrelease()en elfinally.pool.query('BEGIN')no sirve. - Una función (
CREATE FUNCTION) puede ser una consulta con parámetros (LANGUAGE sql) o un bloque PL/pgSQL con variables,IFyRAISE EXCEPTION; conRETURNS TABLEse usa en elFROM. Un procedimiento se llama conCALLy puede hacerCOMMITpor dentro. - Un trigger ejecuta una función ante
INSERT,UPDATEoDELETE.BEFOREpuede cambiarNEW;AFTERve el cambio hecho.FOR EACH ROWse dispara por fila;FOR EACH STATEMENT, una vez por sentencia, y ve las filas con tablas de transición. Lo que una restricción puede expresar no va en un trigger. WITH RECURSIVEcalcula un punto fijo: la parte no recursiva, más lo que agrega la parte recursiva vuelta a vuelta, hasta que no aparece nada nuevo. Expresa la clausura transitiva, que el álgebra relacional no puede con un número fijo de joins. Los ciclos se controlan conUNION, un límite, un arreglo con el camino oCYCLE.- Una window function (
OVER) calcula un valor por fila mirando su ventana:PARTITION BY,ORDER BYy el frame.rankdeja huecos,dense_rankno,row_numbernumera sin repetir y desempata al azar. Se evalúan después delWHERE, así que para filtrar por ellas se usa una CTE.ROLLUPyCUBEagregan subtotales.
Ejercicios
-
Para cada columna de esta consulta, digan qué tipo de PostgreSQL tiene el resultado y qué tipo de JavaScript recibe
pg:SELECT sum(price), max(price), count(*), max(created_at), max(shipment_id), sum(shipment_id), avg(shipment_id) FROM shipment. Ojo consumyavgsobre una columnainteger. Comprueben las respuestas conpg_typeof(...)enpsqly con un script que imprimatypeofde cada valor. -
Un compañero escribe
pool.query(SELECT * FROM route ORDER BY ${req.order})para que el usuario ordene la lista de rutas. Escriban un valor dereq.orderque haga que la consulta borre la tablatrip. ¿Por qué no se arregla conORDER BY $1? Reescriban la función con una lista fija. -
Este código tiene dos errores. Encuéntrenlos, digan qué síntoma produce cada uno y corríjanlo:
async function moveShipment(pool, shipmentId, tripId) { const client = await pool.connect(); await client.query('BEGIN'); await pool.query('UPDATE shipment SET trip_id = $2 WHERE shipment_id = $1', [shipmentId, tripId]); await client.query('COMMIT'); client.release(); } -
Creen un pool con
max: 2y una función que hacepool.connect()y una consulta, pero no llama arelease(). Llámenla tres veces seguidas. ¿Qué pasa en la tercera? AgreguenconnectionTimeoutMillis: 2000al pool y repitan. ¿Qué cambia? -
Escriban una función
customer_spent(p_customer_id integer) RETURNS numericenLANGUAGE sqlque devuelva cuánto gastó un cliente como remitente. ¿Qué devuelve para un cliente que nunca envió nada? ¿Y para uncustomer_idque no existe? Si quieren que en el primer caso devuelva 0 y en el segundo lance un error, ¿qué lenguaje necesitan? Escríbanla. -
Escriban
shipments_between(p_from date, p_to date) RETURNS TABLE (...)que devuelva, por agencia de origen, cuántos envíos se registraron entre esas fechas (en hora de Lima). Úsenla en elFROMcon unJOINaagencyy unORDER BY. -
Agreguen a
customeruna columnaupdated_at timestamptzy un trigger que la llene connow()en cadaUPDATE. ¿Debe serBEFOREoAFTER? ¿De fila o de sentencia? Pruébenlo dentro de una transacción conROLLBACK. ¿Qué pasa conupdated_atsi elUPDATEasigna los mismos valores que ya tenía la fila? Si no quieren que cambie en ese caso, ¿qué agregan alCREATE TRIGGER? -
Escriban un trigger
AFTER DELETE ON customer FOR EACH ROWque guarde en una tabladeleted_customerel DNI y el nombre del cliente borrado (usenOLD). Intenten borrar el cliente 1, que tiene envíos. ¿Queda algo endeleted_customer? Expliquen el resultado con lo que saben de claves foráneas y de atomicidad de una sentencia. Después borren, dentro de una transacción conROLLBACK, un cliente que registren ustedes sin envíos. -
Con una consulta recursiva, listen las agencias a las que se llega desde Tacna - Centro con a lo más dos tramos, con el camino de cada una (como texto). ¿Cuántas son? Comparen con el número de agencias a las que se llega sin límite de tramos.
-
En la sección de ciclos dijimos que la consulta con
UNIONy la columnahops, sin límite, no termina. Expliquen por qué con la evaluación por iteraciones: ¿qué filas tiene la tabla de trabajo en cada vuelta? Después escriban una versión sin arreglo que dé el menor número de tramos a cada agencia, con un límite de tramos que no dependa de esta red en particular sino del número de agencias (SELECT count(*) FROM agency). Expliquen por qué ese límite basta para no perder ningún camino más corto. ¿Por qué no se puede poner elminen la parte recursiva? -
Para cada envío entregado en marzo desde Lima - La Victoria, muestren su precio, el precio promedio de los envíos de esa agencia en marzo y la diferencia, en una sola consulta y sin subconsultas. Después agreguen el porcentaje que representa cada envío del total de su día.
-
La consulta
top_customers_by_cityusarank(). ¿En qué caso devolvería más de dos filas para una ciudad? ¿Y condense_rank()? ¿Y conrow_number()? Escriban una versión que devuelva exactamente dos por ciudad, siempre las mismas en cada ejecución. Por último, escriban la consultarollupconGROUPING SETSen vez deROLLUPy comprueben que da las mismas filas.