
Apuntes · Capítulo 4Modelo relacional y SQL
Joins, vistas e integridad
Joins, vistas e integridad
En las semanas 2 y 3 combinamos tablas poniendo varias en el FROM y
escribiendo la condición que las une en el WHERE, junto con los filtros. Esa
forma es correcta y es la traducción directa del álgebra: un producto
cartesiano seguido de una selección. Pero tiene dos problemas. El primero es de
lectura: en un WHERE largo no se distingue qué condición une tablas y cuál
filtra filas. El segundo es de poder expresivo: con un producto y una
selección solo se obtienen las filas que tienen pareja en la otra tabla. La
agencia de Iquitos, que todavía no despachó ningún envío, desaparece de
cualquier reporte de “envíos por agencia”.
Este capítulo tiene dos partes. En la primera vemos las expresiones de
join de SQL: JOIN ... ON, USING, NATURAL JOIN (y por qué no lo usamos)
y los outer joins, que conservan las filas sin pareja. Después vemos las
vistas: consultas con nombre que se usan como si fueran tablas, las vistas
materializadas y las vistas que aceptan INSERT y UPDATE.
En la segunda parte pasamos de leer datos a protegerlos. Un esquema no es solo
una lista de columnas: también es un conjunto de reglas que la base de datos
hace cumplir sin importar qué programa escriba los datos. Vemos las
restricciones de integridad (NOT NULL, UNIQUE, CHECK, claves
primarias y foráneas con sus acciones, restricciones diferidas), qué hacer con
las reglas que ninguna de ellas puede expresar, los tipos de datos de SQL
(con cuidado en fechas y horas), los dominios, los esquemas y, al
final, la autorización: quién puede leer o modificar qué, con roles,
GRANT y REVOKE.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “Del producto cartesiano al join”, “
JOIN ... ON” y la “Definición” de “Outer joins”. Sesión B: “Sobre una sola tabla:NOT NULL,UNIQUE,CHECK” y la “Definición” de “Integridad referencial”.- En clase. Sesión A: “Expresiones de join”, “Outer joins”, “Vistas” y “Transacciones, en una frase”. Sesión B: “Restricciones de integridad”, “Integridad referencial”, “Reglas que miran otras tablas”, “Tipos de datos”, “Esquemas” y “Autorización”.
- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 4.1–4.2 y 4.4–4.7; la 4.3, solo como presentación. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-04, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
Todas las salidas de este capítulo salen de la base de datos chasqui_w04,
que make crea en la carpeta de la semana: los datos de Chasqui, las vistas
de views.sql y un esquema aparte, demo, con
tres tablas pequeñas que usamos para las restricciones
(demo.sql). Lo presentamos cuando lo
necesitemos.
Expresiones de join
Del producto cartesiano al join
Recordemos la definición del álgebra. El producto cartesiano r × s junta cada tupla de r con cada tupla de s; si r tiene n tuplas y s tiene m, el resultado tiene n · m. Un theta join es un producto seguido de una selección:
r ⋈θ s = σθ(r × s)
donde θ es un predicado sobre los atributos de r y de s. Cuando θ es una conjunción de igualdades, se llama equi-join. Casi todos los joins que escribimos son equi-joins entre una clave foránea y la clave que referencia.
SQL tiene una sintaxis para cada una. El producto cartesiano explícito es
CROSS JOIN:
SELECT count(*) FROM agency CROSS JOIN vehicle; count
-------
696
(1 row)29 agencias por 24 vehículos. FROM agency, vehicle da lo mismo: la coma en
el FROM es un CROSS JOIN. Rara vez se quiere un producto cartesiano
completo; se escribe CROSS JOIN cuando sí se quiere, para que quien lea la
consulta sepa que no es un olvido.
JOIN ... ON
El theta join se escribe r JOIN s ON θ. Los envíos que salen de agencias de
la región Cusco, primero como en la semana 2 y después con JOIN:
SELECT count(*)
FROM shipment s, agency a
WHERE s.origin_agency_id = a.agency_id
  AND a.region = 'Cusco';

SELECT count(*)
FROM shipment s
  JOIN agency a ON a.agency_id = s.origin_agency_id
WHERE a.region = 'Cusco';
count
-------
610
(1 row)
count
-------
610
(1 row)El resultado es el mismo, y EXPLAIN muestra el mismo plan para las dos (un
hash join entre shipment y las agencias de Cusco). La diferencia es para
quien lee: la condición que dice cómo se relacionan las
tablas está junto al JOIN, y el WHERE queda para los filtros. Cuando hay
cuatro o cinco tablas, olvidar una condición de join en un WHERE largo
produce un producto cartesiano silencioso; con JOIN ... ON cada tabla trae
su condición al lado.
JOIN es una abreviatura de INNER JOIN. Inner quiere decir que solo
quedan las combinaciones que cumplen la condición; en la próxima sección
veremos los outer joins, que conservan más.
USING
Cuando las columnas que se igualan tienen el mismo nombre en las dos tablas,
USING las nombra una vez:
SELECT trip_id, shipment_id, route_id, weight_kg, departure_at
FROM shipment JOIN trip USING (trip_id)
WHERE shipment_id = 1;
trip_id | shipment_id | route_id | weight_kg | departure_at
---------+-------------+----------+-----------+------------------------
996 | 1 | 58 | 64.60 | 2026-02-02 12:00:00-05
(1 row)shipment JOIN trip USING (trip_id) significa ON shipment.trip_id = trip.trip_id, con una diferencia en el resultado: la columna trip_id
aparece una sola vez, y se puede nombrar sin prefijo. Con ON, un
SELECT * muestra dos columnas trip_id (una de cada tabla) y escribir
trip_id a secas da error por ambigüedad (column reference "trip_id" is ambiguous). Las pruebas de la semana comprueban las dos cosas.
NATURAL JOIN
El natural join del álgebra iguala todos los atributos que tienen el mismo nombre en los dos esquemas. Si R y S son los esquemas de r y s, y R ∩ S = {A1, …, Ak}, entonces
r ⋈ s = ΠR ∪ S(σr.A1 = s.A1 ∧ … ∧ r.Ak = s.Ak(r × s))
El resultado tiene los atributos de R ∪ S, cada atributo común una sola vez.
Si R ∩ S es vacío, el natural join es el producto cartesiano. En SQL se
escribe r NATURAL JOIN s: es un USING con la lista de columnas comunes
calculada por el motor.
Con un esquema pensado para eso, el natural join es elegante. En un esquema real, es una trampa. Veamos dos casos de Chasqui:
SELECT count(*) FROM customer NATURAL JOIN agency;     -- combina por city
SELECT count(*) FROM shipment NATURAL JOIN route;      -- por origin_agency_id y dest_agency_id
count
-------
3433
(1 row)
count
-------
12000
(1 row)La única columna que customer y agency tienen en común es city. La
consulta empareja a cada cliente con cada agencia de su ciudad, algo que
nadie pidió. Un cliente de Lima aparece tres veces, una por cada agencia de
Lima:
SELECT c.customer_id, c.last_name, a.name
FROM customer c NATURAL JOIN agency a
WHERE c.customer_id = 3;
customer_id | last_name | name
-------------+---------------+--------------------
3 | Ramos Herrera | Lima - La Victoria
3 | Ramos Herrera | Lima - Los Olivos
3 | Ramos Herrera | Lima - Ate
(3 rows)El segundo caso parece funcionar: shipment y route comparten
origin_agency_id y dest_agency_id, y cada envío encuentra la ruta de su
par origen-destino. Ahora supongamos que alguien agrega, con toda razón, una
columna created_at a route. shipment ya tiene una. Lo probamos dentro de
una transacción que deshacemos al final (la sección de transacciones explica
BEGIN y ROLLBACK):
BEGIN;
ALTER TABLE route ADD COLUMN created_at timestamptz NOT NULL DEFAULT now();
SELECT count(*) FROM shipment NATURAL JOIN route;
SELECT count(*) FROM shipment JOIN route USING (origin_agency_id, dest_agency_id);
ROLLBACK;
count
-------
0
(1 row)
count
-------
12000
(1 row)La misma consulta, sin cambiar una letra, pasó de 12000 filas a cero: ahora
también exige que el envío y la ruta se hayan creado en el mismo instante. No
hubo ningún error ni advertencia. La versión con USING nombra sus columnas y
sigue dando lo mismo.
Error común. Confiar en
NATURAL JOIN. La condición de join depende de los nombres de todas las columnas de las dos tablas, incluidas las que se agreguen en el futuro, y no está escrita en la consulta. En el curso se usaONoUSING, que dicen explícitamente qué se iguala.
La misma tabla dos veces
Un envío tiene un remitente y un destinatario, y los dos son clientes. Para
mostrar los dos nombres hay que hacer join con customer dos veces, con
un alias distinto para cada papel:
SELECT s.shipment_id,
       snd.first_name || ' ' || snd.last_name AS sender,
       rcp.first_name || ' ' || rcp.last_name AS recipient
FROM shipment s
  JOIN customer snd ON snd.customer_id = s.sender_id
  JOIN customer rcp ON rcp.customer_id = s.recipient_id
WHERE s.shipment_id <= 3
ORDER BY s.shipment_id;
shipment_id | sender | recipient
-------------+---------------------------+------------------------
1 | Luis Mamani Chávez | Gonzalo Herrera Flores
2 | Kevin Quispe Sánchez | Rosa Choque Ramos
3 | Gonzalo Rodríguez Sánchez | Renzo Ruiz Mamani
(3 rows)Cada alias es, para el álgebra, una copia renombrada de la relación
(ρsnd(customer) y ρrcp(customer)). Lo mismo pasa con
route, que apunta dos veces a agency; la vista route_detail de más
adelante lo hace. Aquí USING no sirve: las columnas que se igualan tienen
nombres distintos (sender_id y customer_id).
Outer joins
Definición
Un inner join descarta las tuplas que no tienen pareja. Un outer join las
conserva y completa con NULL los atributos del otro lado. Formalmente, si r
tiene esquema R y s tiene esquema S, el left outer join es
r ⟕θ s = (r ⋈θ s) ∪ ((r − ΠR(r ⋈θ s)) × {(null, …, null)})
donde la tupla de nulos tiene un NULL por cada atributo de S. En palabras:
el inner join, más cada tupla de r que no encontró pareja, completada con
nulos. El right outer join r ⟖ s hace lo mismo con las tuplas de s, y el
full outer join r ⟗ s, con las de ambos lados.
En SQL: LEFT [OUTER] JOIN, RIGHT [OUTER] JOIN y FULL [OUTER] JOIN, con
ON o USING. La palabra OUTER es opcional.
LEFT JOIN en Chasqui
Todas las agencias con su cantidad de envíos de origen, incluidas las que no despacharon ninguno:
SELECT a.name, count(s.shipment_id) AS shipments
FROM agency a
  LEFT JOIN shipment s ON s.origin_agency_id = a.agency_id
GROUP BY a.agency_id, a.name
ORDER BY shipments
LIMIT 3;
name | shipments
-----------------------+-----------
Iquitos - Centro | 0
Tumbes - Centro | 61
Huancavelica - Centro | 75
(3 rows)Con un inner join, Iquitos no aparecería: no tiene ninguna fila en shipment
con la que emparejarse. El LEFT JOIN la conserva con una fila en la que
todas las columnas de s son NULL, y el GROUP BY la convierte en un grupo
de una fila.
count(*) después de un LEFT JOIN
Esa fila completada con NULL es una fila de verdad, y count(*) cuenta
filas:
SELECT a.name, count(*) AS wrong, count(s.shipment_id) AS right
FROM agency a
  LEFT JOIN shipment s ON s.origin_agency_id = a.agency_id
WHERE a.agency_id IN (10, 29)
GROUP BY a.agency_id, a.name;
name | wrong | right
------------------+-------+-------
Iquitos - Centro | 1 | 0
Tumbes - Centro | 61 | 61
(2 rows)Error común. Contar con
count(*)después de unLEFT JOIN. Una agencia sin envíos aparece con 1. Se cuenta una columna del lado derecho que no pueda serNULLen una fila con pareja, normalmente su clave:count(s.shipment_id). Como vimos la semana pasada,count(columna)ignora losNULL.
ON frente a WHERE en un outer join
Ahora queremos los envíos entregados por agencia de origen, otra vez con
todas las agencias. La condición s.status = 'delivered' puede ir en el ON
o en el WHERE, y no da lo mismo:
SELECT a.name, count(s.shipment_id) AS delivered
FROM agency a
  LEFT JOIN shipment s ON s.origin_agency_id = a.agency_id
WHERE a.agency_id IN (10, 29)
  AND s.status = 'delivered'
GROUP BY a.agency_id, a.name;
name | delivered
-----------------+-----------
Tumbes - Centro | 56
(1 row)SELECT a.name, count(s.shipment_id) AS delivered
FROM agency a
LEFT JOIN shipment s ON s.origin_agency_id = a.agency_id
AND s.status = 'delivered'
WHERE a.agency_id IN (10, 29)
GROUP BY a.agency_id, a.name; name | delivered
------------------+-----------
Iquitos - Centro | 0
Tumbes - Centro | 56
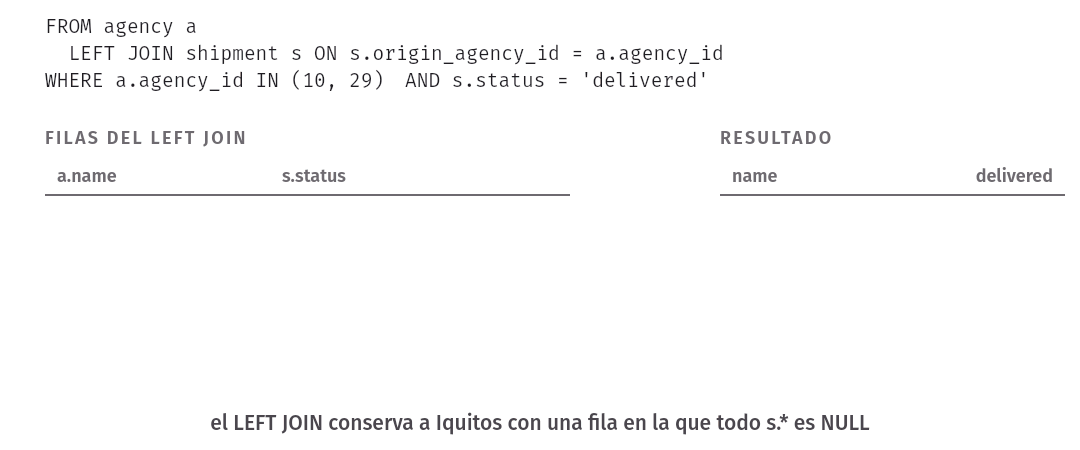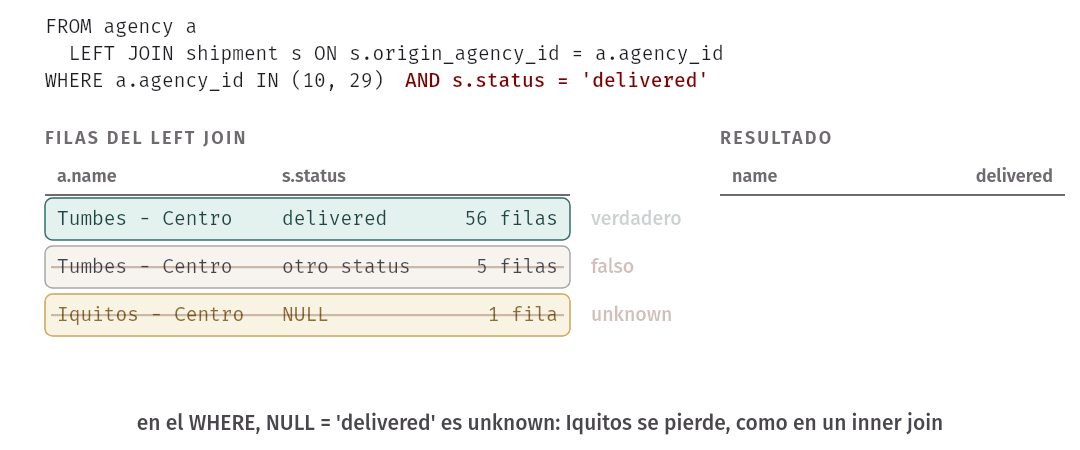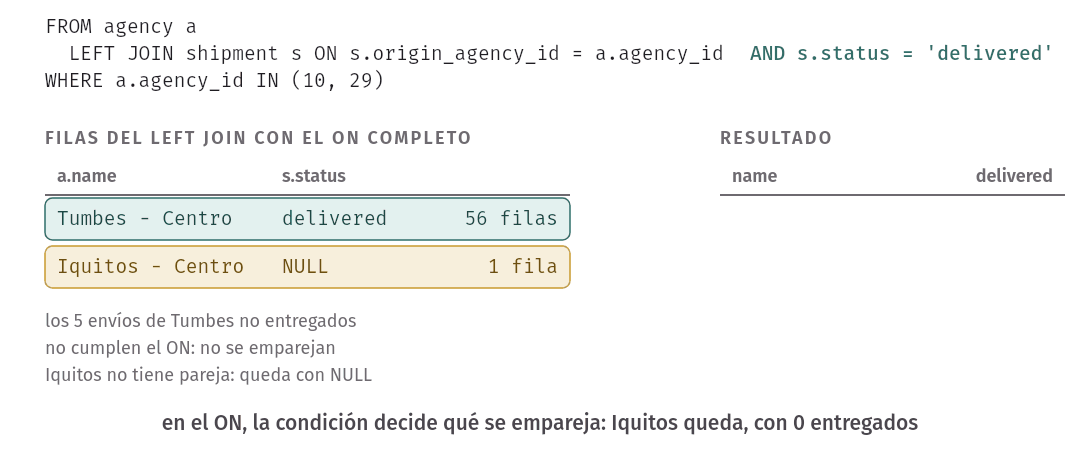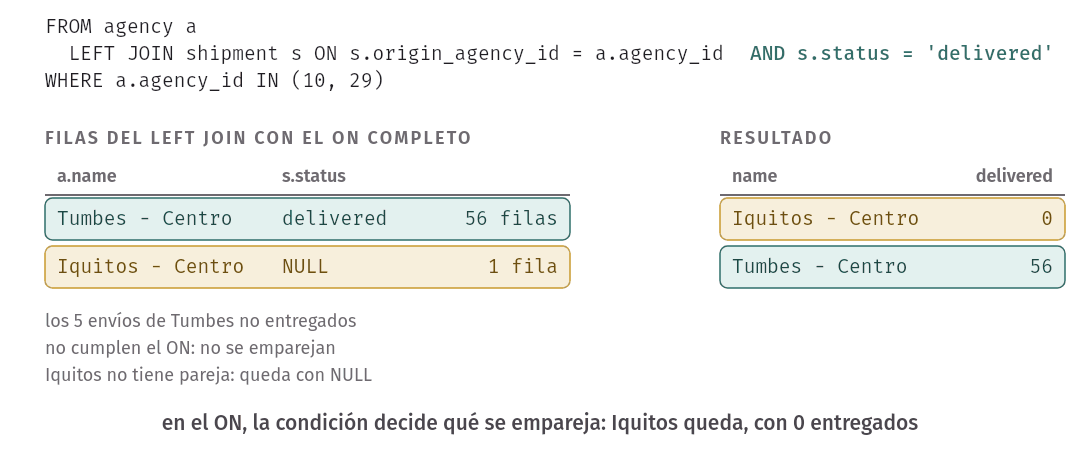
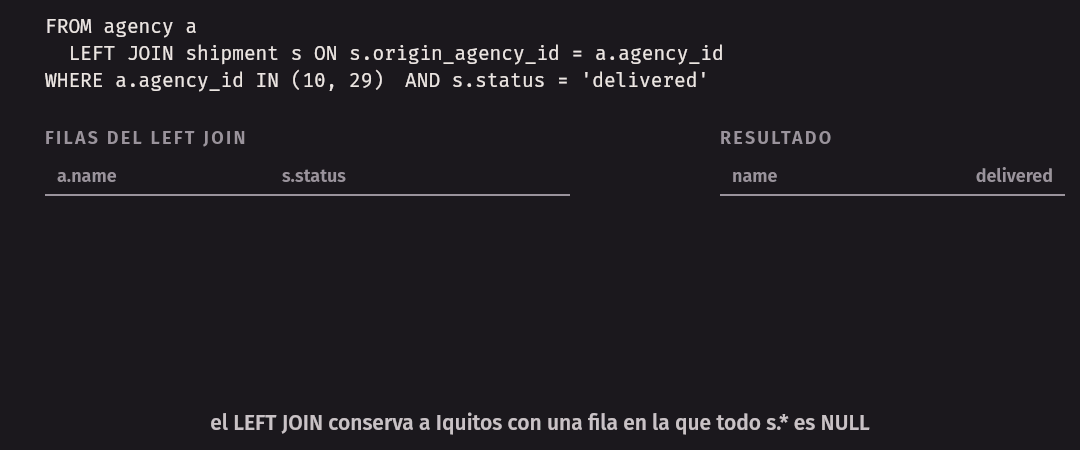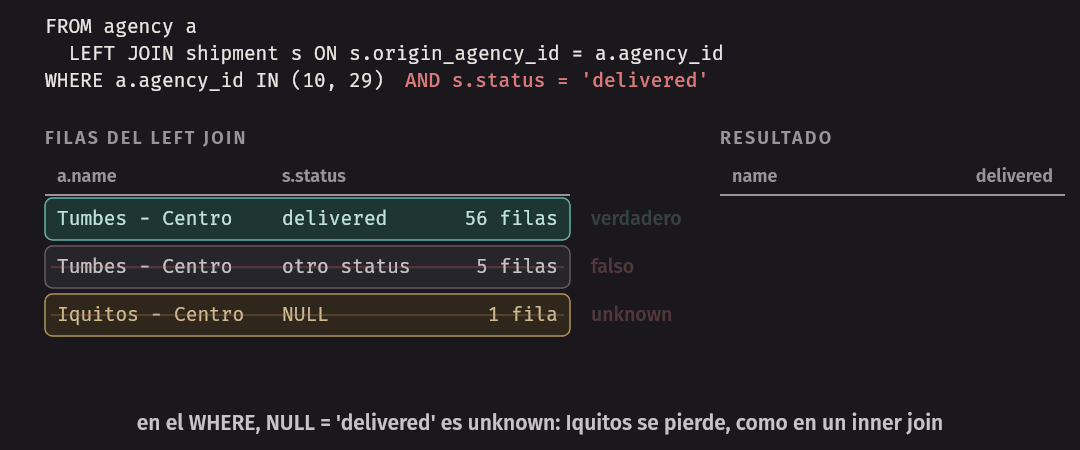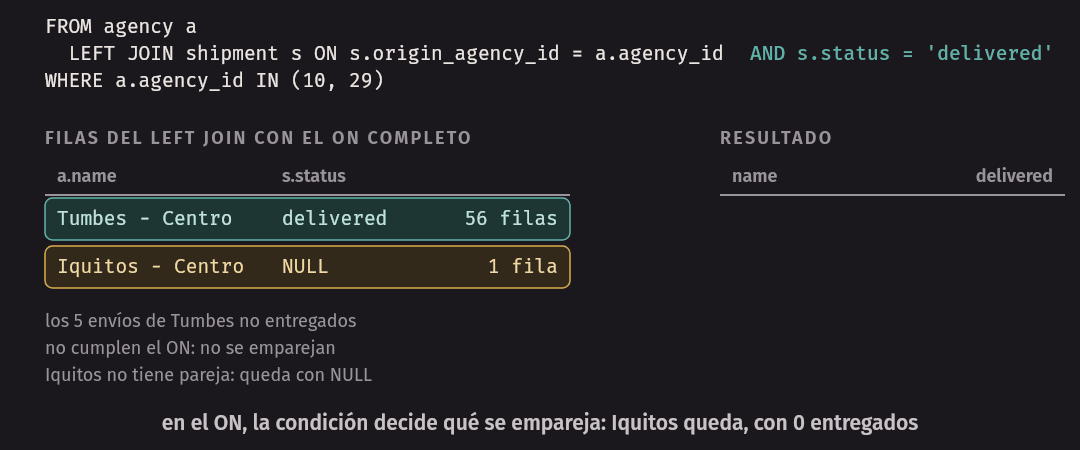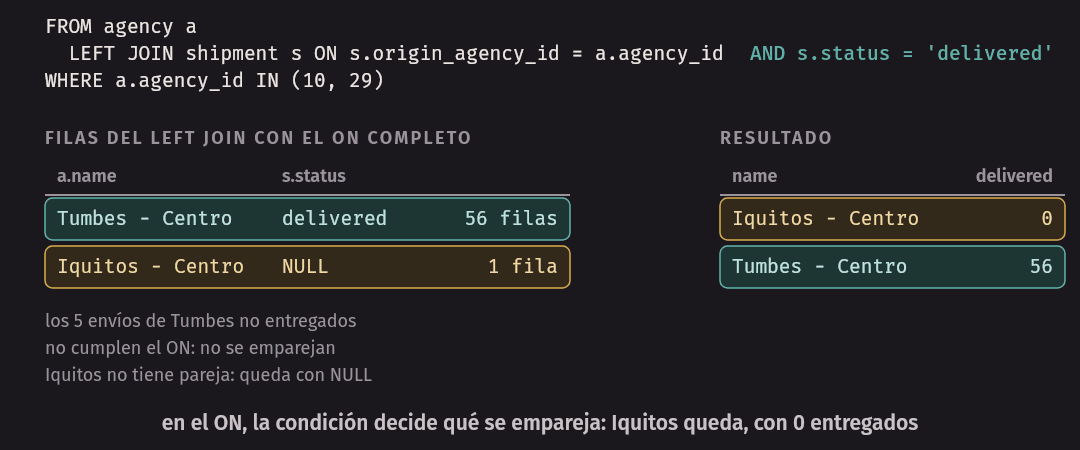
(2 rows)Iquitos desapareció de la primera. La razón está en el orden lógico de
evaluación: el FROM (con sus joins) se calcula primero y el WHERE filtra
después. La fila de Iquitos sale del LEFT JOIN con s.status en NULL;
NULL = 'delivered' es unknown, y el WHERE solo deja pasar lo verdadero.
El resultado es exactamente el de un inner join: el LEFT no sirvió de nada.
En la segunda, la condición es parte del emparejamiento: Iquitos no tiene
ningún envío entregado que cumpla el ON, así que el LEFT JOIN la conserva
con nulos, como queríamos.
Idea clave. En un inner join, una condición en el
ONo en elWHEREda lo mismo. En un outer join, no: elONdecide qué filas se emparejan; elWHEREdecide qué filas quedan después. Una condición sobre la tabla que se completa con nulos (la derecha en unLEFT JOIN) va en elON, salvo que sea justamenteIS NULL.
El error inverso también existe. Una condición sobre la tabla izquierda
puesta en el ON no quita ninguna fila izquierda; solo impide que se
emparejen:
SELECT count(*) AS rows, count(s.shipment_id) AS with_shipment
FROM agency a
  LEFT JOIN shipment s ON s.origin_agency_id = a.agency_id
                      AND a.region = 'Tumbes';
rows | with_shipment
------+---------------
89 | 61
(1 row)Quien escribió esto quería los envíos de Tumbes, y obtuvo 89 filas: los 61
envíos de Tumbes y las otras 28 agencias, cada una con una fila de nulos. Un
filtro sobre la tabla que se conserva entera va en el WHERE.
Anti-join: lo que no tiene pareja
El LEFT JOIN con IS NULL en el WHERE encuentra las filas que no
tienen pareja. Los clientes que nunca enviaron nada:
SELECT count(*)
FROM customer c
  LEFT JOIN shipment s ON s.sender_id = c.customer_id
WHERE s.shipment_id IS NULL;
count
-------
82
(1 row)Aquí el WHERE sobre la tabla derecha es intencional: después del join, solo
las filas completadas con nulos tienen s.shipment_id en NULL, porque en
una fila con pareja es la clave primaria de un envío. Es la misma pregunta que
NOT EXISTS de la semana 3; las pruebas comprueban que dan lo mismo. Se
llama anti-join. (El resultado es el mismo, pero el plan no siempre: en
esta base de datos, EXPLAIN muestra un Hash Right Anti Join para NOT EXISTS y un Hash Right Join seguido de un filtro para la versión con LEFT JOIN. Cómo se ejecutan los joins y cómo se leen los planes es tema de las
semanas 11 y 12.)
RIGHT JOIN y FULL JOIN
r RIGHT JOIN s es s LEFT JOIN r. La consulta anterior, con las tablas al
revés:
SELECT count(*)
FROM shipment s
  RIGHT JOIN customer c ON s.sender_id = c.customer_id
WHERE s.shipment_id IS NULL;
count
-------
82
(1 row)Es habitual escribir siempre LEFT JOIN, con la tabla que se conserva
primero, para que la consulta se lea de izquierda a derecha.
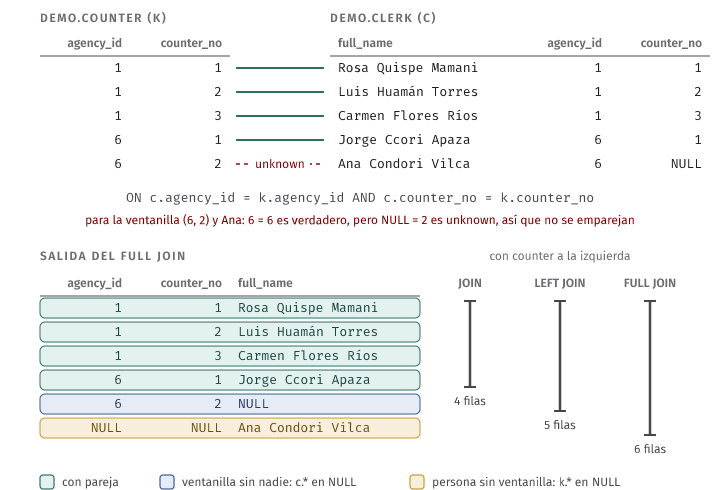
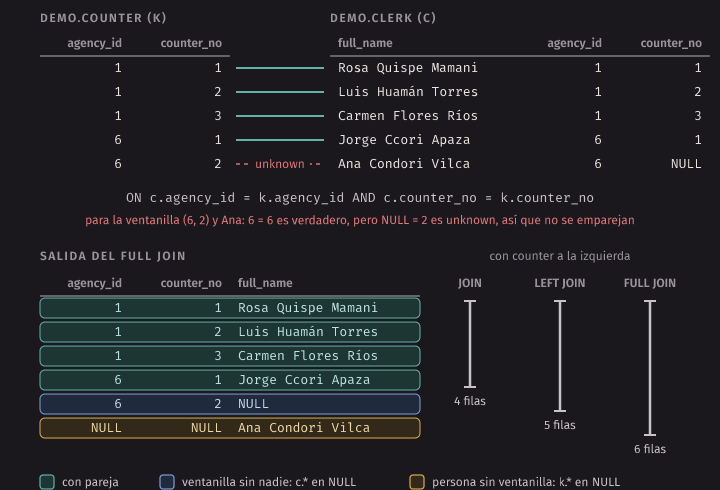
El FULL JOIN conserva las filas sin pareja de los dos lados. Para verlo
usamos las tablas del esquema demo: demo.counter tiene las ventanillas de
atención de cada agencia y demo.clerk, el personal que atiende en ellas. Hay
una ventanilla sin nadie asignado y una persona sin ventanilla:
SELECT k.agency_id, k.counter_no, c.full_name
FROM demo.counter k
  FULL JOIN demo.clerk c ON c.agency_id = k.agency_id
                        AND c.counter_no = k.counter_no
ORDER BY k.agency_id, k.counter_no;
agency_id | counter_no | full_name
-----------+------------+--------------------
1 | 1 | Rosa Quispe Mamani
1 | 2 | Luis Huamán Torres
1 | 3 | Carmen Flores Ríos
6 | 1 | Jorge Ccori Apaza
6 | 2 |
| | Ana Condori Vilca
(6 rows)La ventanilla 2 de Cusco (agencia 6) sale con full_name en NULL; Ana
Condori, que no tiene ventanilla, sale con las columnas de k en NULL. El
join tiene dos condiciones porque la clave de una ventanilla es el par
(agencia, número); lo veremos en la Sesión B.
Resumen de las formas de join
| Forma | Qué conserva | Columnas comunes en el resultado |
|---|---|---|
r CROSS JOIN s |
todas las combinaciones | todas, repetidas |
r JOIN s ON θ |
las combinaciones que cumplen θ | todas, repetidas |
r JOIN s USING (a, b) |
las que coinciden en a y b |
a y b una vez |
r NATURAL JOIN s |
las que coinciden en todas las comunes | las comunes una vez |
r LEFT JOIN s ... |
lo anterior, más las de r sin pareja | según ON o USING |
r RIGHT JOIN s ... |
lo anterior, más las de s sin pareja | según ON o USING |
r FULL JOIN s ... |
lo anterior, más las sin pareja de ambos | según ON o USING |
En PostgreSQL. Con
USINGen unFULL JOIN, la columna común del resultado escoalesce(r.a, s.a): toma el valor del lado que lo tenga. Es lo que se quiere casi siempre. ConONse ven las dos columnas, y una de ellas esNULLen las filas sin pareja.
Vistas
Una consulta con nombre
Una vista (view) es una relación virtual definida por una consulta.
CREATE VIEW v AS consulta guarda la consulta, no su resultado. Cada vez
que otra consulta usa v, el motor la reemplaza por su definición (el libro
lo llama view expansion) y la calcula con los datos de ese momento.
La primera vista de views.sql muestra cada
ruta con el nombre de sus dos agencias:
CREATE VIEW route_detail AS
SELECT r.route_id,
       o.name AS origin_name,
       d.name AS dest_name,
       r.distance_km,
       r.base_fare
FROM route r
  JOIN agency o ON o.agency_id = r.origin_agency_id
  JOIN agency d ON d.agency_id = r.dest_agency_id;
Después se usa como una tabla:
SELECT * FROM route_detail WHERE route_id <= 3; route_id | origin_name | dest_name | distance_km | base_fare
----------+--------------------+--------------------+-------------+-----------
2 | Trujillo - Centro | Lima - La Victoria | 555 | 33.00
1 | Lima - La Victoria | Trujillo - Centro | 555 | 33.00
3 | Lima - La Victoria | Chimbote - Centro | 368 | 24.50
(3 rows)(Sin ORDER BY, el orden de las filas no está garantizado, y aquí se nota.)
Las vistas sirven para dos cosas. La primera, no repetir: el doble join con
agency se escribe una vez y todas las consultas que necesiten los nombres de
las agencias usan route_detail. La segunda, mostrar a cada usuario solo lo
que le corresponde; eso lo vemos en la sección de autorización.
Una vista se puede definir sobre otra vista. long_route se apoya en
route_detail:
CREATE VIEW long_route AS
SELECT route_id, origin_name, dest_name, distance_km
FROM route_detail
WHERE distance_km > 800;
SELECT count(*) FROM long_route; count
-------
10
(1 row)La expansión es recursiva: long_route se reemplaza por su definición, que
menciona route_detail, que a su vez se reemplaza por la suya, hasta que
solo quedan tablas. Como dice el libro, este proceso termina siempre que las
definiciones no sean recursivas, es decir, que ninguna vista dependa de sí
misma.
Una vista no guarda datos
Como la vista se recalcula, ve los cambios en el acto. Dentro de una transacción que después deshacemos, alargamos la ruta 1 a 900 km:
BEGIN;
UPDATE route SET distance_km = 900 WHERE route_id = 1;
SELECT count(*) FROM long_route;
count
-------
11
(1 row)No hubo que “actualizar” la vista: no hay nada guardado que actualizar.
En PostgreSQL.
\sv long_routeenpsqlmuestra la definición guardada. Si la vista se definió conSELECT *, el motor expande el asterisco al crear la vista: una columna que se agregue después a la tabla no aparece en la vista. Es una razón más para nombrar las columnas.
Vistas materializadas
Una vista materializada sí guarda su resultado, como una tabla. Se consulta sin recalcular nada, lo que conviene cuando la consulta es cara y se lee mucho. El precio es que puede quedar desactualizada. El estándar SQL no las define; el libro las presenta en la sección 4.2.3 y cada motor tiene su sintaxis. En PostgreSQL:
CREATE MATERIALIZED VIEW route_trip_stats AS
SELECT r.route_id,
       count(t.trip_id)                    AS trips,
       avg(t.arrival_at - t.departure_at)  AS avg_duration
FROM route r
  LEFT JOIN trip t ON t.route_id = r.route_id
GROUP BY r.route_id;
Seguimos en la misma transacción. Agregamos un viaje a la ruta 1 y miramos la
vista antes y después de REFRESH:
INSERT INTO trip (trip_id, route_id, vehicle_id, departure_at, arrival_at)
VALUES (90001, 1, 1, '2026-10-30 07:00-05', '2026-10-30 19:00-05');
SELECT trips FROM route_trip_stats WHERE route_id = 1;
REFRESH MATERIALIZED VIEW route_trip_stats;
SELECT trips FROM route_trip_stats WHERE route_id = 1;
ROLLBACK;
trips
-------
75
(1 row)
trips
-------
76
(1 row)Hasta el REFRESH, la vista materializada seguía diciendo 75. REFRESH
vuelve a ejecutar la consulta completa y reemplaza el contenido.
En PostgreSQL.
REFRESH MATERIALIZED VIEWbloquea las lecturas de la vista mientras se recalcula.REFRESH MATERIALIZED VIEW CONCURRENTLYlas permite, pero exige un índiceUNIQUEsobre la vista. PostgreSQL no mantiene vistas materializadas de forma incremental: siempre recalcula todo. Otros motores (Oracle, SQL Server) sí actualizan algunas vistas materializadas automáticamente con cada cambio.
Vistas actualizables
¿Qué significa hacer UPDATE sobre una vista, si la vista no tiene filas
propias? Solo tiene sentido si cada fila de la vista corresponde a una fila de
una tabla, de modo que el cambio se pueda traducir. El estándar (sec. 4.2.4
del libro) considera actualizable una vista cuyo FROM tiene una sola
relación, cuyo SELECT tiene solo nombres de atributos (sin expresiones,
agregados ni DISTINCT), sin GROUP BY ni HAVING, y tal que las columnas
que no aparecen en la vista pueden quedar en NULL (no son NOT NULL ni
parte de la clave primaria).
truck muestra solo los camiones:
CREATE VIEW truck AS
SELECT vehicle_id, plate, kind, capacity_kg
FROM vehicle
WHERE kind = 'truck'
WITH CHECK OPTION;
Un UPDATE sobre la vista cambia la tabla, y solo puede tocar filas que la
vista muestra:
BEGIN;
UPDATE truck SET capacity_kg = capacity_kg + 500 WHERE vehicle_id = 11 RETURNING *;
UPDATE truck SET capacity_kg = 1 WHERE vehicle_id = 19;      -- 19 es una van
vehicle_id | plate | kind | capacity_kg
------------+---------+-------+-------------
11 | P5Z-632 | truck | 11800
(1 row)
UPDATE 1
UPDATE 0El vehículo 19 existe, pero es una van: para la vista no existe, y el UPDATE
no lo encuentra. ¿Y si una modificación produce una fila que la vista no
mostraría? Sin WITH CHECK OPTION, el motor la acepta y la fila “desaparece”
de la vista. Con WITH CHECK OPTION, la rechaza:
UPDATE truck SET kind = 'van' WHERE vehicle_id = 11;
INSERT INTO truck (vehicle_id, plate, kind, capacity_kg) VALUES (99, 'Z9Z-999', 'van', 1500);
INSERT INTO truck (vehicle_id, plate, kind, capacity_kg) VALUES (99, 'Z9Z-999', 'truck', 9000);
ROLLBACK;
ERROR: new row violates check option for view "truck"
DETAIL: Failing row contains (11, P5Z-632, van, 11800).
ERROR: new row violates check option for view "truck"
DETAIL: Failing row contains (99, Z9Z-999, van, 1500).
INSERT 0 1Una vista con join, en cambio, no es actualizable automáticamente: ¿a cuál de las tablas iría el cambio?
UPDATE route_detail SET base_fare = 50 WHERE route_id = 1;ERROR: cannot update view "route_detail"
DETAIL: Views that do not select from a single table or view are not automatically updatable.
HINT: To enable updating the view, provide an INSTEAD OF UPDATE trigger or an unconditional ON UPDATE DO INSTEAD rule.En PostgreSQL. Una vista es automáticamente actualizable si su
FROMtiene una sola tabla o vista actualizable, y no usaDISTINCT,GROUP BY,HAVING,LIMIT,UNIONni funciones de agregación o de ventana. Una columna calculada (price * 2) se puede leer pero no actualizar. Para todo lo demás está el triggerINSTEAD OFque sugiere el mensaje; los triggers se ven en la semana 5. El error deWITH CHECK OPTIONtiene SQLSTATE44000(with_check_option_violation).
Transacciones, en una frase
Una transacción es un grupo de sentencias que se aplica entero o no se aplica. Ya las usamos para probar cambios sin dejar rastro:
SELECT count(*) FROM shipment_event WHERE shipment_id = 1;
BEGIN;
DELETE FROM shipment_event WHERE shipment_id = 1;
SELECT count(*) FROM shipment_event WHERE shipment_id = 1;
ROLLBACK;
SELECT count(*) FROM shipment_event WHERE shipment_id = 1;
count
-------
4
(1 row)
DELETE 4
count
-------
0
(1 row)
ROLLBACK
count
-------
4
(1 row)BEGIN abre la transacción, COMMIT la confirma y ROLLBACK la deshace.
Fuera de un BEGIN, psql hace commit automático de cada sentencia suelta
(autocommit). El estándar dice que una transacción empieza sola con la
primera sentencia; PostgreSQL y casi todos los motores, en cambio, usan
autocommit por defecto. Qué ve una transacción de lo que hacen las otras, y
cómo sobrevive el commit a una caída, es tema de las semanas 13 a 15.
En PostgreSQL. Las sentencias de definición (
CREATE,ALTER,DROP) también son transaccionales: elALTER TABLE route ADD COLUMNde la sección deNATURAL JOINse deshizo con elROLLBACK. No es así en todos los motores: Oracle y MySQL hacen commit implícito antes de una sentencia de definición.
Restricciones de integridad
Una restricción de integridad (integrity constraint) es una condición que
toda instancia válida de la base de datos debe cumplir. Se declara una vez, en
el esquema, y el motor la verifica en cada INSERT, UPDATE y DELETE: la
sentencia que la violaría falla y no cambia nada. La regla protege los datos
sin importar qué programa los escriba: el sistema del counter, un script de
carga o alguien en psql.
Sobre una sola tabla: NOT NULL, UNIQUE, CHECK
NOT NULLprohíbe el valor nulo en una columna. Las columnas de la clave primaria lo llevan implícito.UNIQUE (A1, …, Ak)dice que esos atributos forman una superclave: no hay dos filas con los mismos valores en todos ellos. Con una salvedad: la comparación solo se hace entre filas sinNULLen esas columnas (lo vemos enseguida). Si además ningún subconjunto propio es superclave, es una clave candidata; el motor no verifica la minimalidad.PRIMARY KEYesUNIQUEmásNOT NULL, y hay una sola por tabla.CHECK (P)exige que el predicado P se cumpla en cada fila. P puede mencionar varias columnas de la misma fila.
El esquema de partida de Chasqui ya tiene varias. Algunas de vehicle y
shipment, tal como están en
schema.sql:
kind        text NOT NULL CHECK (kind IN ('bus', 'truck', 'van')),
capacity_kg integer NOT NULL CHECK (capacity_kg > 0)
...
declared_value   numeric(10, 2) CHECK (declared_value >= 0),
delivered_at     timestamptz CHECK (delivered_at >= created_at)
La última relaciona dos columnas: un envío no puede entregarse antes de
crearse. Una implicación (“si p, entonces q”) se escribe con la equivalencia
p → q ≡ ¬p ∨ q. En la tabla demo.claim (los reclamos de los clientes por un
envío) hay una: si el reclamo tiene una compensación (refund), tiene que
haber sido aceptado.
CONSTRAINT claim_refund_needs_accepted_ck CHECK (refund IS NULL OR status = 'accepted')INSERT INTO demo.claim (shipment_id, refund) VALUES (1, 50);
INSERT INTO demo.claim (shipment_id, status, refund) VALUES (1, 'accepted', 50);ERROR: new row for relation "claim" violates check constraint "claim_refund_needs_accepted_ck"
DETAIL: Failing row contains (3, 1, open, 2026-10-31 20:56:30.919608-05, null, 50.00).
INSERT 0 1CHECK y NULL
Un CHECK rechaza solo cuando el predicado es falso. Si es unknown, la
fila pasa. Con la lógica de tres valores de la semana 3, eso ocurre cada vez
que una columna del predicado es NULL:
SELECT NULL::numeric > 0 AS result;
INSERT INTO demo.claim (shipment_id, refund) VALUES (1, NULL);
INSERT INTO demo.claim (shipment_id, refund) VALUES (1, 0);
result
--------
(1 row)
INSERT 0 1
ERROR: new row for relation "claim" violates check constraint "claim_refund_ck"
DETAIL: Failing row contains (2, 1, open, 2026-10-31 20:56:30.919608-05, null, 0.00).claim_refund_ck es CHECK (refund > 0). Con refund nulo el predicado es
unknown y la fila entra; con 0 es falso y la fila se rechaza. Para un
refund opcional, es justo lo que se quiere. Si la columna fuera
obligatoria, el CHECK no basta: además lleva NOT NULL.
Lo mismo explica por qué el CHECK (delivered_at >= created_at) de
shipment acepta los envíos no entregados, con delivered_at nulo, sin que
nadie haya escrito delivered_at IS NULL OR ...: la comparación con NULL es
unknown y el CHECK no la rechaza. Escribir el IS NULL OR no está mal
(deja la intención a la vista), pero no cambia nada.
Error común. Leer un
CHECKcomo si fuera unWHERE. ElWHEREconserva solo lo verdadero; elCHECKrechaza solo lo falso. Lo unknown sale de unWHEREy entra por unCHECK. Cada vez que escriban unCHECK, pregúntense qué pasa si cada columna que menciona esNULL.
UNIQUE y NULL
UNIQUE tampoco considera iguales dos NULL, así que admite varias filas con
NULL en la columna. 259 de los 1800 clientes no tienen teléfono, y los
demás teléfonos son distintos. Dentro de una transacción:
SELECT count(*) AS customers, count(phone) AS with_phone FROM customer;
ALTER TABLE customer ADD CONSTRAINT customer_phone_uq UNIQUE (phone);
ALTER TABLE customer DROP CONSTRAINT customer_phone_uq;
ALTER TABLE customer ADD CONSTRAINT customer_phone_uq UNIQUE NULLS NOT DISTINCT (phone);
customers | with_phone
-----------+------------
1800 | 1541
(1 row)
ALTER TABLE
ALTER TABLE
ERROR: could not create unique index "customer_phone_uq"
DETAIL: Key (phone)=(null) is duplicated.El primer UNIQUE se acepta a pesar de los 259 nulos. Con NULLS NOT DISTINCT (estándar SQL:2023, en PostgreSQL desde la versión 15) los nulos
cuentan como iguales entre sí, y entonces sí hay duplicados.
Nombrar las restricciones y leer el error
Cuando una sentencia viola una restricción, el error dice cuál. Si la restricción no tiene nombre, PostgreSQL inventa uno, y no siempre es claro:
UPDATE shipment SET delivered_at = created_at - interval '1 day'
WHERE shipment_id = 1;
ERROR: new row for relation "shipment" violates check constraint "shipment_check"
DETAIL: Failing row contains (1, 178, 337, 9, 8, 996, 64.60, 1453.00, 88.17, delivered, 2026-01-28 19:46:00-05, 2026-01-27 19:46:00-05).shipment_check no dice nada; quien recibe el error tiene que ir a buscar
qué regla es. Con CONSTRAINT shipment_delivered_after_created_ck CHECK (...)
el mensaje se explica solo. Por eso en demo.sql todas las restricciones
llevan nombre, con un sufijo que indica el tipo (_pk, _fk, _uq, _ck).
Además del texto, cada error trae un código SQLSTATE de cinco caracteres, definido por el estándar. Los de la clase 23 (integrity constraint violation) son los que más vamos a ver:
| SQLSTATE | Nombre | Lo produce |
|---|---|---|
23502 |
not_null_violation | NOT NULL |
23503 |
foreign_key_violation | clave foránea |
23505 |
unique_violation | UNIQUE, PRIMARY KEY |
23514 |
check_violation | CHECK, también el de un dominio |
En psql, \set VERBOSITY verbose muestra el código y los campos del error:
\set VERBOSITY verbose
INSERT INTO customer (customer_id, dni, first_name, last_name, city)
VALUES (9001, '61830975', 'Rosa', 'Quispe', 'Puno');
ERROR: 23505: duplicate key value violates unique constraint "customer_dni_key"
DETAIL: Key (dni)=(61830975) already exists.
SCHEMA NAME: public
TABLE NAME: customer
CONSTRAINT NAME: customer_dni_key
LOCATION: _bt_check_unique, nbtinsert.c:666Un programa no lee el texto (que puede cambiar entre versiones o idiomas),
sino el código y el nombre de la restricción. En Node.js, pg los pone en
err.code y err.constraint; así una aplicación distingue “ese DNI ya está
registrado” de un fallo de conexión. Lo usan las pruebas de esta semana y lo
retomamos en la semana 5. Las otras tres violaciones, sobre las tablas de
Chasqui:
INSERT INTO shipment (shipment_id, sender_id, recipient_id, origin_agency_id,
                      dest_agency_id, weight_kg, price, status, created_at)
VALUES (90001, 99999, 1, 1, 6, 2.5, 30, 'registered', now());

INSERT INTO vehicle (vehicle_id, plate, kind, capacity_kg)
VALUES (99, 'M0T-001', 'moto', 150);

INSERT INTO shipment (shipment_id, sender_id, recipient_id, origin_agency_id,
                      dest_agency_id, weight_kg, status, created_at)
VALUES (90001, 1, 2, 1, 6, 2.5, 'registered', now());
ERROR: insert or update on table "shipment" violates foreign key constraint "shipment_sender_id_fkey"
DETAIL: Key (sender_id)=(99999) is not present in table "customer".
ERROR: new row for relation "vehicle" violates check constraint "vehicle_kind_check"
DETAIL: Failing row contains (99, M0T-001, moto, 150).
ERROR: null value in column "price" of relation "shipment" violates not-null constraint
DETAIL: Failing row contains (90001, 1, 2, 1, 6, null, 2.50, null, null, registered, 2026-10-31 20:56:30.919608-05, null).En PostgreSQL. Desde la versión 18, los
NOT NULLtambién son restricciones con nombre en el catálogo (\d+ demo.clerklas lista comoclerk_dni_not_null, etc.). Aun así, el error de una violación deNOT NULLidentifica la columna: enpg,err.columnes'price'. Las pruebas compruebanerr.columny no dependen del nombre.
Agregar una restricción a una tabla con datos
ALTER TABLE ... ADD CONSTRAINT verifica la regla contra todas las filas
que ya existen. Si alguna no la cumple, la restricción no se agrega:
ALTER TABLE demo.counter
  ADD CONSTRAINT counter_recent_ck CHECK (opened_on >= '2025-01-01');
ERROR: check constraint "counter_recent_ck" of relation "counter" is violated by some rowHay que encontrar esas filas (con la negación del predicado en un WHERE),
decidir qué hacer con ellas y volver a intentar. PostgreSQL permite además
ADD CONSTRAINT ... NOT VALID, que verifica solo las filas nuevas y deja la
validación de las antiguas para un VALIDATE CONSTRAINT posterior; sirve en
tablas enormes, pero mientras tanto la regla no se cumple en todos los datos.
Integridad referencial
Definición
Sean r1 y r2 relaciones, K una clave candidata de r1 y α un conjunto de atributos de r2 compatible con K. La restricción de integridad referencial de α hacia K exige que, para cada tupla t2 de r2, exista una tupla t1 de r1 con t1[K] = t2[α]. Dicho con el álgebra: Πα(r2) ⊆ ΠK(r1). α es una clave foránea (foreign key) de r2; r2 es la relación que referencia y r1, la referenciada.
En SQL, FOREIGN KEY (α) REFERENCES r1 (K). Si se omite la lista K, se usa
la clave primaria de r1.
Qué puede referenciar una clave foránea
El destino tiene que ser una clave: el motor exige una restricción PRIMARY KEY o UNIQUE declarada exactamente sobre las columnas referenciadas. En
demo.counter la clave es el par (agency_id, counter_no); counter_no
solo se repite en cada agencia, así que no se puede referenciar solo:
CREATE TABLE demo.counter_note (
  counter_no smallint REFERENCES demo.counter (counter_no),
  note       text
);
ERROR: there is no unique constraint matching given keys for referenced table "counter"(SQLSTATE 42830, invalid_foreign_key.) Tiene sentido: si dos agencias
tienen una ventanilla 1, ¿a cuál apunta una nota con counter_no = 1?
Si se declara UNIQUE sobre un conjunto de columnas que ya contiene una
clave, ese conjunto es una superclave y el UNIQUE no agrega ninguna
restricción sobre los datos; aun así, el motor lo acepta como destino de una
clave foránea. Lo que exige es la declaración, no la minimalidad.
Claves foráneas compuestas
Una persona del personal (demo.clerk) trabaja en una agencia y, si tiene
ventanilla, en una ventanilla de esa misma agencia. Como la clave de
counter es compuesta, la clave foránea también lo es:
CONSTRAINT clerk_agency_fk FOREIGN KEY (agency_id) REFERENCES agency,
CONSTRAINT clerk_counter_fk FOREIGN KEY (agency_id, counter_no)
  REFERENCES demo.counter
  ON DELETE SET NULL (counter_no)
  ON UPDATE CASCADE
  DEFERRABLE INITIALLY IMMEDIATE
Las acciones y el DEFERRABLE los explicamos enseguida. Lo importante ahora:
la clave foránea compuesta no solo dice “la ventanilla 3 existe”, dice “la
ventanilla 3 de esta agencia existe”. La agencia 1 tiene una ventanilla 3;
la 6 no:
INSERT INTO demo.clerk (dni, full_name, agency_id, counter_no)
VALUES ('46789012', 'Pedro Salas Ugarte', 6, 3);
ERROR: insert or update on table "clerk" violates foreign key constraint "clerk_counter_fk"
DETAIL: Key (agency_id, counter_no)=(6, 3) is not present in table "counter".Dos claves foráneas simples, agency_id hacia agency y counter_no hacia
“alguna ventanilla”, no podrían expresar esa regla: la que la expresa es la
compuesta, que apunta a una clave candidata compuesta.
Claves foráneas y NULL
¿Qué pasa si alguna columna de la clave foránea es NULL? Ana Condori no
tiene ventanilla: su counter_no es NULL y la fila se aceptó. El estándar
define tres modos (MATCH SIMPLE, MATCH PARTIAL y MATCH FULL;
PostgreSQL no implementa PARTIAL), y el que se usa por defecto es MATCH SIMPLE: si
alguna columna de la clave foránea es NULL, la restricción no se verifica.
Con una columna, es lo esperable (un envío sin viaje asignado tiene trip_id
nulo). Con varias, tiene una consecuencia menos obvia: el resto de las
columnas tampoco se verifica. Si quitamos clerk_agency_fk (dentro de una
transacción), una agencia inexistente pasa:
ALTER TABLE demo.clerk DROP CONSTRAINT clerk_agency_fk;
INSERT INTO demo.clerk (dni, full_name, agency_id, counter_no)
VALUES ('47890123', 'Elena Paz Soto', 999, NULL);
SELECT full_name, agency_id, counter_no FROM demo.clerk WHERE agency_id = 999;
ALTER TABLE
INSERT 0 1
full_name | agency_id | counter_no
----------------+-----------+------------
Elena Paz Soto | 999 |
(1 row)Por eso demo.clerk tiene las dos claves foráneas: la compuesta para la
ventanilla y la simple para la agencia, que se verifica siempre porque
agency_id es NOT NULL. La alternativa, MATCH FULL, exige que la clave
foránea sea toda nula o toda no nula; aquí no sirve, porque rechazaría a Ana
(agencia sí, ventanilla no). Las pruebas lo comprueban.
Qué pasa al borrar o actualizar la fila referenciada
Una clave foránea no solo se verifica al insertar en la tabla que referencia; también al borrar o actualizar en la referenciada. Si se borra una agencia que tiene rutas, las rutas quedarían apuntando a nada. La acción por defecto es rechazar la sentencia:
DELETE FROM agency WHERE agency_id = 6;ERROR: update or delete on table "agency" violates foreign key constraint "route_origin_agency_id_fkey" on table "route"
DETAIL: Key (agency_id)=(6) is still referenced from table "route".Las acciones posibles, para ON DELETE y para ON UPDATE:
| Acción | Al borrar o actualizar la fila referenciada |
|---|---|
NO ACTION (por defecto) |
error si quedan filas que la referencian; se verifica al final de la sentencia y se puede diferir |
RESTRICT |
error si hay filas que la referencian; se verifica de inmediato y no se puede diferir |
CASCADE |
se borran (o se actualizan) también las filas que la referencian |
SET NULL |
las columnas de la clave foránea pasan a NULL |
SET DEFAULT |
las columnas de la clave foránea toman su valor por defecto |
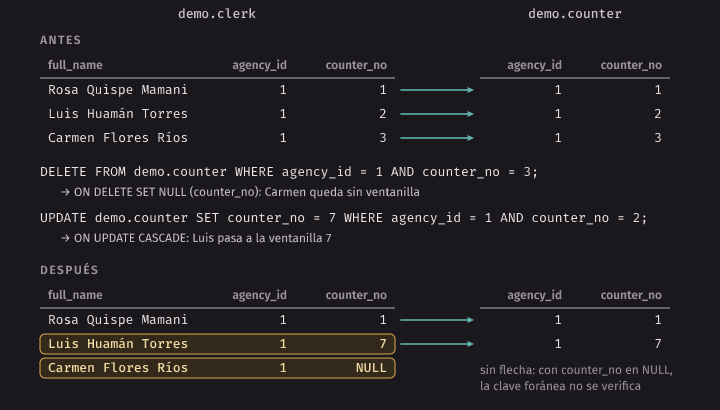
En demo, borrar una agencia borra sus ventanillas (counter_agency_fk es
ON DELETE CASCADE); borrar una ventanilla deja a su personal sin ventanilla
(ON DELETE SET NULL (counter_no)), y renumerar una ventanilla arrastra a su
personal (ON UPDATE CASCADE):
SELECT full_name, agency_id, counter_no FROM demo.clerk WHERE agency_id = 1 ORDER BY dni;
DELETE FROM demo.counter WHERE agency_id = 1 AND counter_no = 3;
UPDATE demo.counter SET counter_no = 7 WHERE agency_id = 1 AND counter_no = 2;
SELECT full_name, agency_id, counter_no FROM demo.clerk WHERE agency_id = 1 ORDER BY dni;
full_name | agency_id | counter_no
--------------------+-----------+------------
Rosa Quispe Mamani | 1 | 1
Luis Huamán Torres | 1 | 2
Carmen Flores Ríos | 1 | 3
(3 rows)
DELETE 1
UPDATE 1
full_name | agency_id | counter_no
--------------------+-----------+------------
Rosa Quispe Mamani | 1 | 1
Luis Huamán Torres | 1 | 7
Carmen Flores Ríos | 1 |
(3 rows)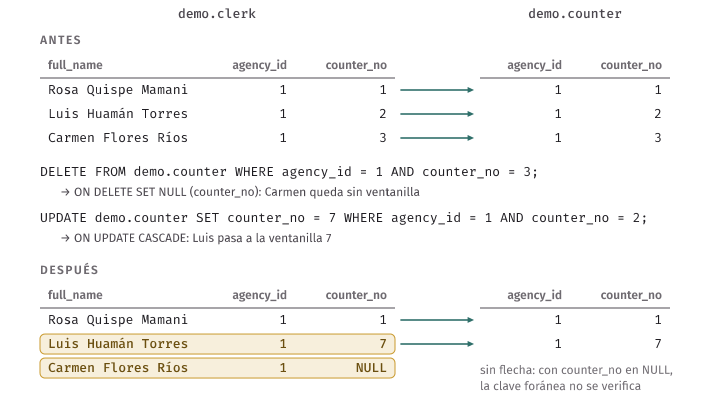
Y el CASCADE desde agency, con una agencia nueva que no tiene rutas:
INSERT INTO agency (agency_id, name, city, region)
VALUES (30, 'Nasca - Centro', 'Nasca', 'Ica');
INSERT INTO demo.counter (agency_id, counter_no) VALUES (30, 1), (30, 2);
DELETE FROM agency WHERE agency_id = 30;
SELECT count(*) FROM demo.counter WHERE agency_id = 30;
INSERT 0 1
INSERT 0 2
DELETE 1
count
-------
0
(1 row)En PostgreSQL.
SET NULL (counter_no), con lista de columnas, existe desde la versión 15 y no es estándar. Con unSET NULLa secas, el motor pondríaNULLen todas las columnas de la clave foránea, también enagency_id, y comoagency_idesNOT NULL, el borrado de la ventanilla fallaría con23502. Las pruebas lo comprueban.
¿Qué acción elegir? Depende de qué significa la relación. Una fila que no
tiene sentido sin la otra (una ventanilla sin su agencia) es candidata a
CASCADE. Una fila que es historia que no se debe perder (un envío ya
entregado) pide RESTRICT o NO ACTION: que el borrado falle y alguien
decida. SET NULL sirve cuando la relación es opcional y la fila sigue
teniendo sentido sola. CASCADE es cómodo y peligroso: un solo DELETE puede
borrar miles de filas en otras tablas sin que nadie las haya nombrado. En P1
ustedes deciden la acción de cada clave foránea de Chasqui y la justifican.
Restricciones diferidas
A veces una transacción pasa, a mitad de camino, por un estado que viola una
restricción, aunque al final la cumple. Por ejemplo, si se registra a una
persona en una ventanilla que se crea en la misma transacción, pero en el
orden “primero la persona, después la ventanilla”. Por defecto, una clave
foránea se verifica al final de cada sentencia y el primer INSERT falla.
Una restricción DEFERRABLE se puede diferir: verificar recién al hacer
commit. Una clave foránea DEFERRABLE INITIALLY IMMEDIATE se comporta como
una normal hasta que una transacción pide lo contrario con SET CONSTRAINTS; DEFERRABLE INITIALLY DEFERRED se difiere siempre. clerk_counter_fk es de las
primeras:
BEGIN;
SET CONSTRAINTS demo.clerk_counter_fk DEFERRED;
INSERT INTO demo.clerk (dni, full_name, agency_id, counter_no)
VALUES ('48901234', 'Raúl Inga Paucar', 6, 3);
INSERT INTO demo.counter (agency_id, counter_no) VALUES (6, 3);
SET CONSTRAINTS demo.clerk_counter_fk IMMEDIATE;
ROLLBACK;
BEGIN
SET CONSTRAINTS
INSERT 0 1
INSERT 0 1
SET CONSTRAINTS
ROLLBACKEl primer INSERT no falló aunque la ventanilla (6, 3) todavía no existía.
SET CONSTRAINTS ... IMMEDIATE verifica en ese momento todo lo pendiente; ya
estaba bien, así que no hubo error. Si nadie crea la ventanilla, el error
aparece en el COMMIT, y la transacción entera se deshace:
BEGIN;
SET CONSTRAINTS demo.clerk_counter_fk DEFERRED;
INSERT INTO demo.clerk (dni, full_name, agency_id, counter_no)
VALUES ('48901234', 'Raúl Inga Paucar', 6, 4);
COMMIT;
BEGIN
SET CONSTRAINTS
INSERT 0 1
ERROR: insert or update on table "clerk" violates foreign key constraint "clerk_counter_fk"
DETAIL: Key (agency_id, counter_no)=(6, 4) is not present in table "counter".El uso clásico son los ciclos de claves foráneas: si A referencia a B y B a A,
y las dos columnas son NOT NULL, la primera fila no se puede insertar sin
diferir una de las dos restricciones.
En PostgreSQL. Solo se pueden diferir
UNIQUE,PRIMARY KEY, las claves foráneas y las restriccionesEXCLUDE.NOT NULLyCHECKse verifican siempre de inmediato:CHECK (...) DEFERRABLEda el errorCHECK constraints cannot be marked DEFERRABLE. Hay además una diferencia con el estándar: unUNIQUEno diferible se verifica fila por fila, no al final de la sentencia. Renumerar 1, 2, 3 como 2, 3, 4 con un soloUPDATEfalla, aunque el resultado final no tiene duplicados; conUNIQUE DEFERRABLEfunciona:
BEGIN;
CREATE TABLE demo.slot (n integer UNIQUE);
INSERT INTO demo.slot VALUES (1), (2), (3);
UPDATE demo.slot SET n = n + 1;
CREATE TABLE demo.slot2 (n integer UNIQUE DEFERRABLE);
INSERT INTO demo.slot2 VALUES (1), (2), (3);
UPDATE demo.slot2 SET n = n + 1;
ROLLBACK;
ERROR: duplicate key value violates unique constraint "slot_n_key"
DETAIL: Key (n)=(2) already exists.
CREATE TABLE
INSERT 0 3
UPDATE 3Reglas que miran otras tablas
Todas las restricciones que vimos miran una fila (NOT NULL, CHECK),
una tabla (UNIQUE) o dos tablas con una forma fija (la clave
foránea: “existe una fila con este valor”). Hay reglas que no entran en
ninguno de esos moldes. Por ejemplo, en demo.claim: la compensación de un
reclamo no puede superar el valor declarado de su envío. La regla mira
claim y shipment a la vez, y no es una clave foránea.
Aserciones
El estándar SQL tiene para esto la aserción (assertion): un predicado sobre toda la base de datos que debe ser siempre verdadero.
CREATE ASSERTION refund_within_value CHECK (NOT EXISTS (
  SELECT 1 FROM demo.claim c JOIN shipment s USING (shipment_id)
  WHERE c.refund > s.declared_value));
ERROR: CREATE ASSERTION is not yet implemented
LINE 1: CREATE ASSERTION refund_within_value CHECK (NOT EXISTS (
^PostgreSQL no las implementa, y casi ningún otro motor lo hace. La razón es
el costo: una aserción general habría que verificarla después de cada cambio
en cualquiera de las tablas que menciona, y deducir automáticamente qué parte
basta revisar es difícil. El estándar también permite subconsultas dentro de
un CHECK, que tendrían el mismo problema; PostgreSQL tampoco las acepta:
ALTER TABLE demo.claim ADD CONSTRAINT claim_refund_within_value_ck
  CHECK (refund <= (SELECT declared_value FROM shipment s
                    WHERE s.shipment_id = claim.shipment_id));
ERROR: cannot use subquery in check constraintEl truco que no funciona
Es tentador esconder la subconsulta dentro de una función y llamar a la
función desde el CHECK. El motor lo acepta, y al principio parece
funcionar:
CREATE FUNCTION demo.declared_value_of(p_shipment_id integer) RETURNS numeric
  LANGUAGE sql STABLE
  AS 'SELECT declared_value FROM shipment WHERE shipment_id = p_shipment_id';
ALTER TABLE demo.claim ADD CONSTRAINT claim_refund_within_value_ck
  CHECK (refund <= demo.declared_value_of(shipment_id));
INSERT INTO demo.claim (shipment_id, status, refund) VALUES (1, 'accepted', 2000);
INSERT INTO demo.claim (shipment_id, status, refund) VALUES (1, 'accepted', 1000);
CREATE FUNCTION
ALTER TABLE
ERROR: new row for relation "claim" violates check constraint "claim_refund_within_value_ck"
DETAIL: Failing row contains (5, 1, accepted, 2026-10-31 20:56:30.940571-05, null, 2000.00).
INSERT 0 1El envío 1 declaró 1453 soles; 2000 se rechaza y 1000 entra. Pero un CHECK
se verifica solo cuando cambia la fila de la tabla que lo tiene. Si cambia
el envío, nadie vuelve a mirar el reclamo:
UPDATE shipment SET declared_value = 100 WHERE shipment_id = 1;
SELECT c.refund, s.declared_value
FROM demo.claim c JOIN shipment s USING (shipment_id);
UPDATE 1
refund | declared_value
---------+----------------
1000.00 | 100.00
(1 row)La regla está rota y la base de datos no se enteró. La documentación de
PostgreSQL advierte, además, que un CHECK así puede hacer fallar la
restauración de un backup, porque las tablas se cargan en un orden en el que
la función todavía no encuentra los datos.
Idea clave. Un
CHECKno puede mirar otras tablas, ni directamente ni a través de una función. Las alternativas para una regla que mira varias tablas son: (1) reorganizar el esquema para que una clave o una clave foránea la exprese (como hicimos con la ventanilla de la misma agencia); (2) un trigger, una función que el motor ejecuta ante cada cambio en cada tabla involucrada, que vemos en la semana 5; (3) hacerla cumplir en la aplicación, sabiendo que cualquier otro programa que escriba en la base de datos se la puede saltar. En P1 hay una regla de este tipo; decidan cuál de estas opciones aplica y justifíquenlo.
Tipos de datos
Fechas y horas
SQL tiene varios tipos para el tiempo, y confundirlos produce errores de horas enteras:
| Tipo | Qué guarda | Ejemplo |
|---|---|---|
date |
un día del calendario | DATE '2026-07-28' |
time |
una hora del día, sin fecha | TIME '09:30' |
timestamp |
fecha y hora “de pared”, sin zona | TIMESTAMP '2026-07-28 09:00' |
timestamptz |
un instante | TIMESTAMPTZ '2026-07-28 09:00-05' |
interval |
una duración | INTERVAL '1 day 2 hours' |
timestamptz es la abreviatura de PostgreSQL para timestamp with time zone.
El nombre engaña: no guarda una zona horaria. Guarda un instante (por
dentro, en UTC) y, al mostrarlo, lo convierte a la zona de la sesión. En
Chasqui todas las horas son timestamptz, y chasqui-load deja la zona de la
base de datos en America/Lima (UTC−5; el Perú no usa horario de verano):
SHOW timezone;
SELECT shipment_id, created_at FROM shipment WHERE shipment_id = 1;
SET timezone = 'UTC';
SELECT shipment_id, created_at FROM shipment WHERE shipment_id = 1;
SET timezone = 'America/Lima';
TimeZone
--------------
America/Lima
(1 row)
shipment_id | created_at
-------------+------------------------
1 | 2026-01-28 19:46:00-05
(1 row)
SET
shipment_id | created_at
-------------+------------------------
1 | 2026-01-29 00:46:00+00
(1 row)Es el mismo instante, mostrado de dos maneras; nótese que en UTC ya es el
día siguiente. Un timestamp sin zona, en cambio, no es un instante: “28 de
julio a las 9:00” ocurre en momentos distintos en Lima y en Madrid. AT TIME ZONE convierte entre los dos tipos: aplicado a un timestamp, lo interpreta
en esa zona y da un timestamptz; aplicado a un timestamptz, da la hora de
pared en esa zona:
SELECT TIMESTAMP '2026-07-28 09:00' AS ts,
       TIMESTAMPTZ '2026-07-28 09:00' AS tstz,
       TIMESTAMP '2026-07-28 09:00' AT TIME ZONE 'UTC' AS ts_read_as_utc;
ts | tstz | ts_read_as_utc
---------------------+------------------------+------------------------
2026-07-28 09:00:00 | 2026-07-28 09:00:00-05 | 2026-07-28 04:00:00-05
(1 row)El literal timestamptz sin zona se interpretó en la zona de la sesión
(Lima). El tercero dice: “las 9:00 en UTC”, que en Lima son las 4:00.
SELECT created_at,
       created_at AT TIME ZONE 'America/Lima' AS lima_local,
       created_at AT TIME ZONE 'Europe/Madrid' AS madrid_local,
       CAST(created_at AS date) AS lima_date
FROM shipment
WHERE shipment_id = 1;
created_at | lima_local | madrid_local | lima_date
------------------------+---------------------+---------------------+------------
2026-01-28 19:46:00-05 | 2026-01-28 19:46:00 | 2026-01-29 01:46:00 | 2026-01-28
(1 row)Error común. Agrupar por día con
CAST(created_at AS date)sin pensar en la zona de la sesión. La fecha de un instante depende de la zona: el envío 1 se creó el 28 de enero en Lima y el 29 en UTC. Si un reporte “por día” tiene que ser en hora de Lima, escriban la zona explícitamente ((created_at AT TIME ZONE 'America/Lima')::date) y no dependan de la configuración de quien lo ejecute.
La resta de dos instantes es un interval:
SELECT trip_id, departure_at, arrival_at, arrival_at - departure_at AS duration
FROM trip
WHERE trip_id = 996;

SELECT avg(arrival_at - departure_at) AS avg_duration,
       max(arrival_at - departure_at) AS max_duration
FROM trip;
trip_id | departure_at | arrival_at | duration
---------+------------------------+------------------------+----------
996 | 2026-02-02 12:00:00-05 | 2026-02-02 16:30:00-05 | 04:30:00
(1 row)
avg_duration | max_duration
-----------------+--------------
08:54:31.118644 | 22:30:00
(1 row)avg y max funcionan con intervalos. Los 14 viajes que todavía no llegaron
tienen arrival_at nulo, su duración es NULL y avg los ignora. Con
fechas, la resta da un número entero de días y sumar un entero avanza días:
SELECT DATE '2026-12-25' - DATE '2026-10-31' AS days_to_christmas,
       DATE '2026-10-31' + 30 AS plus_30_days,
       TIMESTAMPTZ '2026-10-31 18:00' + INTERVAL '1 day 2 hours' AS later,
       extract(dow FROM DATE '2026-10-31') AS day_of_week;
days_to_christmas | plus_30_days | later | day_of_week
-------------------+--------------+------------------------+-------------
55 | 2026-11-30 | 2026-11-01 20:00:00-05 | 6
(1 row)(dow es el día de la semana, de 0 el domingo a 6 el sábado.)
Conversión de tipos
CAST(x AS tipo) es la forma estándar; x::tipo, la de PostgreSQL. Dan lo
mismo. Un caso donde importa convertir es la división entera:
SELECT CAST('42.50' AS numeric) + 1 AS with_cast,
       '42.50'::numeric + 1 AS with_colons,
       7 / 2 AS int_division,
       7 / 2.0 AS numeric_division,
       CAST(7 AS numeric) / 2 AS cast_division;
with_cast | with_colons | int_division | numeric_division | cast_division
-----------+-------------+--------------+--------------------+--------------------
43.50 | 43.50 | 3 | 3.5000000000000000 | 3.5000000000000000
(1 row)Entre dos enteros, / es la división entera, como en C y en Java. Para un
porcentaje (100 * returned / total), conviertan uno de los operandos a
numeric antes de dividir.
Valores por defecto y columnas identity
DEFAULT expresión da el valor de una columna cuando el INSERT no la
menciona. En demo.claim, status empieza en 'open' y opened_at en
now(), el instante de la transacción. En demo.counter, opened_on es
DEFAULT current_date.
Para las claves generadas, el estándar tiene las columnas identity:
clerk_id integer GENERATED ALWAYS AS IDENTITYEl motor asigna 1, 2, 3, … con un generador de secuencia. GENERATED ALWAYS
no deja que el usuario elija el valor, salvo que lo pida expresamente;
GENERATED BY DEFAULT sí lo deja.
INSERT INTO demo.clerk (clerk_id, dni, full_name, agency_id)
VALUES (100, '49012345', 'Marco Tito Huanca', 1);
INSERT INTO demo.clerk (clerk_id, dni, full_name, agency_id)
OVERRIDING SYSTEM VALUE
VALUES (100, '49012345', 'Marco Tito Huanca', 1);
ERROR: cannot insert a non-DEFAULT value into column "clerk_id"
DETAIL: Column "clerk_id" is an identity column defined as GENERATED ALWAYS.
HINT: Use OVERRIDING SYSTEM VALUE to override.
INSERT 0 1(SQLSTATE 428C9.) Una secuencia no retrocede con un ROLLBACK ni con un
INSERT fallido: el valor que entregó queda usado. Por eso en los errores de
demo.claim de este capítulo aparecen los claim_id 2, 3 y 5: los valores 1
y 4 se los llevaron inserciones que sí funcionaron, pero que después se
deshicieron con ROLLBACK. Una clave generada sirve
para identificar, no para contar.
En PostgreSQL. La forma antigua es
serial: una abreviatura que crea una columnainteger, una secuencia y unDEFAULT nextval(...). Funciona, pero no es estándar y no impide que alguien escriba un valor a mano que después choque con la secuencia. En el curso se usaGENERATED ALWAYS AS IDENTITY. El esquema de partida de Chasqui no usa ninguna de las dos: sus claves vienen dadas por el generador de datos.
Dominios y enums
Un dominio (domain) es un tipo con nombre construido sobre otro, con
restricciones. El DNI aparece en customer y en demo.clerk; en vez de
repetir el CHECK, se define una vez:
CREATE DOMAIN demo.dni AS char(8)
  CONSTRAINT dni_format_ck CHECK (VALUE ~ '^[0-9]{8}$');
VALUE es el valor que se está verificando. Toda columna de tipo demo.dni
hereda la restricción:
INSERT INTO demo.clerk (dni, full_name, agency_id) VALUES ('1234567X', 'Sin DNI', 1);ERROR: value for domain demo.dni violates check constraint "dni_format_ck"El código es 23514, como cualquier CHECK, y valen las mismas reglas: un
NULL pasa el CHECK del dominio, así que la columna lleva su propio NOT NULL.
Un enum es un tipo con una lista fija de valores, ordenados en el orden en que se declararon:
CREATE TYPE demo.claim_status AS ENUM ('open', 'accepted', 'rejected');INSERT INTO demo.claim (shipment_id, status) VALUES (1, 'closed');
SELECT enum_range(NULL::demo.claim_status);ERROR: invalid input value for enum demo.claim_status: "closed"
LINE 1: ... INTO demo.claim (shipment_id, status) VALUES (1, 'closed');
^
enum_range
--------------------------
{open,accepted,rejected}
(1 row)El error ya no es de restricción (es 22P02, invalid_text_representation):
'closed' no es un valor del tipo. Frente a text con CHECK (status IN (...)), como en shipment, el enum ocupa menos y documenta el tipo, pero
agregar un valor exige ALTER TYPE, y quitar uno no es posible sin recrear el
tipo. Las dos opciones son razonables; Chasqui usa CHECK.
Índices, como anuncio
Un índice es una estructura auxiliar que permite encontrar filas sin recorrer toda la tabla. No cambia el resultado de ninguna consulta, solo su velocidad. Se crea con una línea:
CREATE INDEX shipment_sender_idx ON shipment (sender_id);\d shipment lo lista junto al que PostgreSQL creó solo para la clave
primaria:
Indexes:
    "shipment_pkey" PRIMARY KEY, btree (shipment_id)
    "shipment_sender_idx" btree (sender_id)
Cada PRIMARY KEY y cada UNIQUE crea un índice automáticamente (así
verifica el motor que no haya duplicados sin leer toda la tabla). Una clave
foránea, no: el índice sobre la columna que referencia hay que crearlo a
mano si se necesita. Cómo funcionan los índices y cuándo convienen es el tema
de la semana 10.
Esquemas
Un servidor de PostgreSQL tiene varias bases de datos; cada base de datos
tiene varios esquemas; cada esquema tiene tablas, vistas, tipos y
funciones. El nombre completo de una tabla es esquema.tabla. (El libro llama
a estos niveles catalog y schema; en PostgreSQL el catálogo es la base de
datos.)
      List of schemas
  Name  |       Owner
--------+-------------------
 demo   | postgres
 public | pg_database_owner
(2 rows)
Las tablas de Chasqui están en public, el esquema que trae toda base de
datos nueva. Las de esta semana, en demo. Cuando una consulta nombra una
tabla sin esquema, el motor la busca en los esquemas de search_path, en
orden:
SHOW search_path;
SELECT count(*) FROM clerk;
SET search_path = demo, public;
SELECT full_name, name FROM clerk JOIN agency USING (agency_id) WHERE counter_no IS NULL;
search_path
-----------------
"$user", public
(1 row)
ERROR: relation "clerk" does not exist
LINE 1: SELECT count(*) FROM clerk
^
SET
full_name | name
-------------------+-----------------
Ana Condori Vilca | Cusco - Wanchaq
(1 row)"$user" es un esquema con el nombre del usuario, si existe. Con demo
adelante, clerk se encuentra en demo y agency en public. Los esquemas
sirven para separar partes de una aplicación, para que varios usuarios
trabajen en la misma base de datos sin chocar con los nombres, y para dar
permisos por grupo de tablas.
Autorización
Privilegios
Cada tabla tiene un owner, el rol que la creó, que puede hacer todo con
ella. Los demás solo pueden lo que se les concede. Los privilegios sobre una
tabla o vista son SELECT, INSERT, UPDATE, DELETE, REFERENCES
(declarar una clave foránea que la referencie), TRUNCATE, TRIGGER y, desde
PostgreSQL 17, MAINTAIN (VACUUM, ANALYZE, REFRESH MATERIALIZED VIEW
y otras tareas de mantenimiento). Se
conceden con GRANT y se quitan con REVOKE:
GRANT SELECT, INSERT ON shipment TO counter_clerk;
REVOKE INSERT ON shipment FROM counter_clerk;SELECT, UPDATE, INSERT y REFERENCES se pueden dar por columna:
GRANT UPDATE (status, delivered_at) ON shipment TO courier.
Roles
En PostgreSQL, usuarios y grupos son la misma cosa: roles. Un usuario es
un rol con el atributo LOGIN, que le permite conectarse. Un rol puede ser
miembro de otro y hereda sus privilegios. Así se dan los privilegios a un
rol que representa una función (el personal del counter) y se agrega a ese rol
cada persona que la cumple.
El script roles.sql arma este escenario dentro
de una transacción que termina en ROLLBACK. Los roles son de todo el
servidor, no de una base de datos, y así no quedan rastros:
CREATE ROLE counter_clerk;
CREATE ROLE courier;
CREATE ROLE analyst;
CREATE ROLE maria LOGIN;
GRANT counter_clerk TO maria;

GRANT SELECT ON customer, agency TO counter_clerk;
GRANT INSERT ON shipment TO counter_clerk;
GRANT SELECT ON shipment TO courier;
GRANT UPDATE (status, delivered_at) ON shipment TO courier;
GRANT SELECT ON customer_public TO analyst;
counter_clerk puede leer clientes y agencias y registrar envíos, pero no
modificarlos; courier puede ver los envíos y marcarlos como entregados;
analyst solo puede leer la vista customer_public.
Probar con SET ROLE
El usuario postgres es superusuario: ningún privilegio lo limita. Para
ver qué puede hacer otro rol hay que convertirse en él con SET ROLE (y
volver con RESET ROLE):
SET ROLE maria;
SELECT current_user, count(*) AS customers FROM customer;
INSERT INTO shipment (shipment_id, sender_id, recipient_id, origin_agency_id,
                      dest_agency_id, weight_kg, price, status, created_at)
VALUES (12001, 1, 2, 1, 6, 2.5, 30, 'registered', now());
UPDATE shipment SET price = 0 WHERE shipment_id = 12001;
SELECT count(*) FROM shipment;
RESET ROLE;
current_user | customers
--------------+-----------
maria | 1800
(1 row)
INSERT 0 1
ERROR: permission denied for table shipment
ERROR: permission denied for table shipmentmaria lee clientes e inserta envíos gracias a su pertenencia a
counter_clerk; no puede cambiar precios ni, de hecho, leer los envíos. El
SQLSTATE de estos errores es 42501 (insufficient_privilege).
Con los privilegios por columna, courier puede marcar un envío como
entregado, pero no tocar su precio:
SET ROLE courier;
UPDATE shipment SET status = 'delivered', delivered_at = now() WHERE shipment_id = 46;
UPDATE shipment SET price = 0 WHERE shipment_id = 46;
RESET ROLE;
UPDATE 1
ERROR: permission denied for table shipment(El UPDATE necesita también SELECT sobre las columnas del WHERE; por
eso courier tiene SELECT sobre shipment.)
Vistas como mecanismo de seguridad
Un analista necesita los clientes para sus reportes, pero no sus DNI ni sus teléfonos. La solución es una vista sin esas columnas y ningún privilegio sobre la tabla:
CREATE VIEW customer_public AS
SELECT customer_id, first_name, last_name, city
FROM customer;
SET ROLE analyst;
SELECT * FROM customer_public WHERE customer_id <= 2;
SELECT dni, phone FROM customer WHERE customer_id <= 2;
RESET ROLE; customer_id | first_name | last_name | city
-------------+------------+-----------------+----------
1 | Wilmer | Chávez Ríos | Ayacucho
2 | Piero | García Castillo | Puno
(2 rows)
ERROR: permission denied for table customerFunciona porque la vista lee customer con los privilegios de su owner,
no con los de quien la consulta. El analista tiene permiso sobre la vista, y
la vista, a través de su owner, sobre la tabla.
En PostgreSQL. Desde la versión 15, una vista creada
WITH (security_invoker = true)hace lo contrario: lee las tablas con los privilegios de quien la consulta. Para filtrar filas (cada agencia ve solo sus envíos), PostgreSQL tiene row-level security:ALTER TABLE ... ENABLE ROW LEVEL SECURITYyCREATE POLICYcon un predicado por rol. Lo mencionamos solo como referencia.
WITH GRANT OPTION y REVOKE ... CASCADE
Quien recibe un privilegio WITH GRANT OPTION puede a su vez concederlo. Al
revocarlo, ¿qué pasa con lo que concedió? El libro lo describe con un grafo
de autorización: un privilegio se conserva mientras haya un camino desde el
owner hasta el rol.
GRANT SELECT ON route TO counter_clerk WITH GRANT OPTION;
SET ROLE counter_clerk;
GRANT SELECT ON route TO analyst;
RESET ROLE;
REVOKE SELECT ON route FROM counter_clerk;
REVOKE SELECT ON route FROM counter_clerk CASCADE;
SET ROLE analyst;
SELECT count(*) FROM route;
RESET ROLE;
GRANT
SET
GRANT
RESET
ERROR: dependent privileges exist
HINT: Use CASCADE to revoke them too.
REVOKE
SET
ERROR: permission denied for table route
RESETEn PostgreSQL. El libro dice que en la mayoría de los sistemas la revocación en cascada es el comportamiento por defecto. En PostgreSQL el defecto es
RESTRICT: si el privilegio se cedió a otros, elREVOKEfalla y hay que escribirCASCADEpara quitar también los privilegios que dependían de él.
Al final, \dp shipment muestra quién puede qué. Cada letra es un privilegio
(r = SELECT, a = INSERT, w = UPDATE, d = DELETE, D =
TRUNCATE, x = REFERENCES, t = TRIGGER, m = MAINTAIN), seguida de
quién lo concedió:
                                    Access privileges
 Schema |   Name   | Type  |     Access privileges      |  Column privileges   | Policies
--------+----------+-------+----------------------------+----------------------+----------
 public | shipment | table | postgres=arwdDxtm/postgres+| status:             +|
        |          |       | counter_clerk=a/postgres  +|   courier=w/postgres+|
        |          |       | courier=r/postgres         | delivered_at:       +|
        |          |       |                            |   courier=w/postgres |
(1 row)
El código de la semana y make test
La carpeta code/week-04 tiene:
| Archivo | Qué hace |
|---|---|
views.sql |
las vistas route_detail, long_route, route_trip_stats, truck y customer_public |
demo.sql |
el esquema demo: el dominio dni, el enum claim_status y las tablas counter, clerk y claim |
joins.sql |
las consultas de la Sesión A |
views-demo.sql |
el uso de las vistas, con REFRESH y WITH CHECK OPTION |
constraints.sql |
las violaciones de restricciones, las acciones referenciales, las restricciones diferidas y las aserciones |
types.sql |
fechas, horas, intervalos y conversiones |
roles.sql |
roles, GRANT, REVOKE y SET ROLE |
*.test.mjs |
las pruebas, con node:test y pg |
Todos los scripts que cambian algo lo hacen dentro de BEGIN ... ROLLBACK, y
se pueden correr las veces que quieran. Los que tienen errores a propósito
empiezan con \set ON_ERROR_ROLLBACK on, una opción de psql que pone un
savepoint antes de cada sentencia: un error deshace solo esa sentencia y la
transacción sigue. Dentro del contenedor:
$ cd code/week-04
$ make
$ psql -d chasqui_w04
chasqui_w04=# \i constraints.sql
Las pruebas verifican lo que dicen estos apuntes contra la base de datos.
Cada una abre una transacción, intenta la sentencia y comprueba el código del
error, sin dejar nada escrito. El patrón, de
db.mjs y
constraints.test.mjs:
test('23503: un envío con un remitente que no existe', async () => {
  await inRollback(async (client) => {
    const err = await expectError(client,
      `INSERT INTO ${SHIPMENT_COLS} VALUES (90001, 99999, 1, 1, 6, 2.5, 30, 'registered', now())`);
    assert.equal(err.code, '23503');
    assert.equal(err.constraint, 'shipment_sender_id_fkey');
  });
});
inRollback pide una conexión al pool, abre una transacción y la deshace al
final pase lo que pase. expectError pone un savepoint, ejecuta la sentencia
y devuelve el error (o hace fallar la prueba si no hubo error). Las pruebas de
roles crean roles con el prefijo w04_, también dentro de la transacción.
$ make test
...
✔ 23505: un DNI repetido (7.497042ms)
✔ 23503: un envío con un remitente que no existe (1.416125ms)
✔ 23503: borrar una agencia que tiene rutas (1.265167ms)
✔ 23514: un vehículo de tipo moto (1.491959ms)
✔ 23502: un envío sin precio (0.980791ms)
...
ℹ tests 43
ℹ pass 43
ℹ fail 0
Resumen
r JOIN s ON θes el theta join σθ(r × s); separa la condición de join de los filtros delWHERE.CROSS JOINes el producto cartesiano.USING (a)iguala columnas del mismo nombre y las muestra una vez.NATURAL JOINiguala todas las columnas de nombre común, también las que se agreguen mañana.customer NATURAL JOIN agencycombina porcity; agregarcreated_ataroutedejóshipment NATURAL JOIN routeen cero filas sin ningún error. Se usaONoUSING.- Para usar una tabla en dos papeles (remitente y destinatario) se hace join dos veces con alias distintos.
- Un outer join conserva las filas sin pareja y completa con
NULL.LEFT,RIGHTyFULLsegún qué lado se conserva. Después de unLEFT JOINse cuentacount(s.clave), nocount(*). - En un outer join,
ONdecide qué se empareja yWHEREqué queda. Un filtro sobre la tabla completada con nulos va en elON; en elWHEREconvierte el outer join en inner join. ConIS NULLen elWHEREse obtiene un anti-join. - Una vista guarda una consulta, no datos, y siempre está al día. Una
vista materializada guarda el resultado y se pone al día con
REFRESH. Una vista simple sobre una tabla es actualizable;WITH CHECK OPTIONrechaza filas que la vista no mostraría (44000). - Una transacción se aplica entera o no se aplica:
BEGIN,COMMIT,ROLLBACK. En PostgreSQL, el DDL también es transaccional. NOT NULL,UNIQUE,CHECK,PRIMARY KEYyFOREIGN KEYse declaran con nombre. UnCHECKrechaza solo lo falso: lo unknown pasa.UNIQUEadmite variosNULL, salvoNULLS NOT DISTINCT. Los códigos:23502,23503,23505,23514.- Una clave foránea apunta a columnas con
PRIMARY KEYoUNIQUEdeclarado exactamente sobre ellas. Una clave foránea compuesta hacia una clave compuesta expresa reglas que dos simples no pueden. ConMATCH SIMPLE, una clave foránea con algúnNULLno se verifica. - Acciones al borrar o actualizar lo referenciado:
NO ACTION(por defecto),RESTRICT,CASCADE,SET NULL,SET DEFAULT. Una restricciónDEFERRABLEse puede verificar al hacer commit; en PostgreSQL,NOT NULLyCHECKno se pueden diferir. - Un
CHECKno puede mirar otras tablas: PostgreSQL no tieneCREATE ASSERTIONni subconsultas enCHECK, y esconderlas en una función deja reglas rotas. Las opciones: reorganizar el esquema, un trigger (semana 5) o la aplicación. timestamptzguarda un instante y lo muestra en la zona de la sesión;timestampes una hora de pared sin zona. La resta de instantes es uninterval.CAST(x AS t)ox::t.DEFAULT,GENERATED ALWAYS AS IDENTITY(estándar;seriales la forma antigua), dominios (CREATE DOMAIN), enums (CREATE TYPE ... AS ENUM) e índices (CREATE INDEX).- Base de datos → esquema → tabla;
search_pathdecide dónde se buscan los nombres sin calificar. - Privilegios con
GRANTyREVOKE, también por columna. Un usuario es un rol conLOGIN; los roles se heredan. Una vista da acceso a parte de una tabla.WITH GRANT OPTIONpermite ceder; en PostgreSQL,REVOKEesRESTRICTpor defecto y hace faltaCASCADE.
Ejercicios
-
Sin ejecutarlas, digan qué columnas usa como condición cada uno de estos natural joins y cuántas columnas tiene el resultado:
shipment NATURAL JOIN trip,shipment NATURAL JOIN shipment_event,shipment_event NATURAL JOIN agency. ¿Cuál de los tres hace lo que alguien esperaría? Compruébenlo enpsql. -
Escriban la cantidad de viajes de cada vehículo que salieron en marzo de 2026 (en hora de Lima), incluidos los vehículos que no tuvieron ninguno. ¿Dónde va la condición sobre la fecha? Escriban también la versión equivocada y expliquen por qué da menos filas.
-
Los clientes que nunca recibieron un envío, de tres maneras: con
LEFT JOIN ... IS NULL, conNOT EXISTSy conEXCEPT. ¿Dan lo mismo? ¿Y si usaranNOT INcon una subconsulta sobrerecipient_id? -
Sin ejecutarla, digan cuántas filas devuelve esta consulta y cuántas tienen
s.shipment_idno nulo. Después compruébenlo.SELECT a.agency_id, s.shipment_id FROM agency a LEFT JOIN shipment s ON s.origin_agency_id = a.agency_id AND s.weight_kg > 1000; -
Creen una vista
customer_activitycon, para cada cliente, la cantidad de envíos que mandó y la cantidad que recibió (cero si no hay). ¿Es actualizable? Intenten unUPDATEsobre ella y lean el error. ¿Qué cambiaría si fuera una vista materializada y mañana se registran cien envíos? -
En
demo.claim,closed_atdebería tener valor si y solo si el reclamo ya no está'open'. Escriban eseCHECKcon nombre. Prueben las cuatro combinaciones (abierto o no, con o sinclosed_at) dentro de una transacción. Pista: piensen qué devuelve su predicado cuandoclosed_atesNULL, y si elCHECKlo rechaza o no. -
¿Qué acción
ON DELETEdebería tenerclaim_shipment_fk? Den un argumento paraCASCADEy otro paraRESTRICT. Elijan uno, cámbienlo conALTER TABLEy prueben qué pasa al borrar un envío que tiene reclamos. (Ojo:shipment_eventtambién referencia ashipment.) -
Rosa Quispe (ventanilla 1) y Luis Huamán (ventanilla 2) de la agencia 1 intercambian ventanillas. ¿Se puede hacer con un solo
UPDATEsobredemo.clerk? ¿Y si además existieraUNIQUE (agency_id, counter_no)endemo.clerk(una persona por ventanilla)? ¿Qué tendrían que declarar para que el intercambio funcione? -
Escriban la duración promedio de los viajes de cada ruta en horas, como número con un decimal (pista:
extract(epoch FROM ...)da segundos), y los viajes que salieron entre las 22:00 y las 05:00 en hora de Lima. ¿Cambia el segundo resultado si ejecutanSET timezone = 'UTC'antes? Hagan que no cambie. -
Diseñen los privilegios de un rol
courierque solo puede ver los envíos y marcarlos como entregados. Escríbanlos, pruébenlos conSET ROLEdentro de una transacción y muestren un intento decourierque falle. ¿Puedecourierborrar un evento deshipment_event? -
La regla “un cliente no puede tener más de tres reclamos abiertos a la vez” ¿se puede escribir como
CHECK? ¿ComoUNIQUE? Escriban la aserción que la expresaría en SQL estándar y expliquen qué cambios en qué tablas tendría que vigilar un trigger para hacerla cumplir. -
(Más difícil.) Un analista tiene
SELECTsobrecustomer_publicy ningún privilegio sobrecustomer. Alguien recrea la vista consecurity_invoker = true. ¿Qué pasa con las consultas del analista? Y sinsecurity_invoker: si el analista tuviera el privilegio de crear vistas, ¿podría crear una vista sobrecustomerque muestre los DNI? Pruébenlo conSET ROLE.