
Apuntes · Capítulo 3Modelo relacional y SQL
Conjuntos, NULL, agregación y subconsultas
Conjuntos, NULL, agregación y subconsultas
La semana pasada escribimos las primeras consultas SELECT-FROM-WHERE y
vimos que cada una tiene una traducción al álgebra relacional: WHERE es una
selección σ, la lista del SELECT es una proyección Π y varias tablas en el
FROM son un producto cartesiano. También vimos la primera diferencia
importante entre el álgebra y SQL: el álgebra trabaja con conjuntos y SQL con
multiconjuntos, porque una tabla y el resultado de una consulta pueden tener
filas repetidas.
Este capítulo completa el SQL de consultas en dos partes. En la primera
combinamos resultados con las operaciones de conjuntos (UNION, INTERSECT,
EXCEPT), estudiamos con cuidado el valor NULL y la lógica de tres valores
que trae consigo, y resumimos datos con funciones de agregación, GROUP BY y
HAVING. En la segunda anidamos consultas dentro de otras (subconsultas con
IN, EXISTS, SOME y ALL, en el FROM, escalares y con WITH) y
terminamos con las sentencias que modifican datos: INSERT, UPDATE y
DELETE.
El hilo que une todo es NULL. Casi todas las sorpresas de este capítulo
(una consulta que devuelve cero filas sin avisar, un promedio que no es la
suma entre la cantidad, un NOT IN que no encuentra nada) vienen de olvidar
cómo se comporta. Por eso vamos despacio y cada afirmación viene con una
consulta sobre los datos de Chasqui y su salida real.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “Unión, intersección y diferencia” y “Qué significa
NULL”. Sesión B: de “Subconsultas anidadas”, “Pertenencia:IN” y “NOT INy la trampa delNULL”.- En clase. Sesión A: “Operaciones de conjuntos”, “
NULLy la lógica de tres valores”, “Funciones de agregación” y “GROUP BYyHAVING”. Sesión B: “Subconsultas anidadas”, “Subconsultas enFROM,WITHy subconsultas escalares” y “Modificación de la base de datos”.- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 3.5–3.9. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-03, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
Todas las salidas de este capítulo salen de la base de datos de ejemplo de
Chasqui, con \pset null '∅' para que los NULL se vean como ∅ en vez de
como una celda vacía. Recuerden los tamaños: 29 agencias, 1800 clientes, 120
rutas, 5914 viajes, 12 000 envíos y 46 421 eventos.
Operaciones de conjuntos
Unión, intersección y diferencia
En el álgebra relacional, dos relaciones r y s son compatibles si tienen la misma aridad (la misma cantidad de atributos) y el dominio del i-ésimo atributo de r es compatible con el del i-ésimo de s. Solo entre relaciones compatibles se definen:
- la unión r ∪ s: las tuplas que están en r, en s o en ambas;
- la intersección r ∩ s: las tuplas que están en las dos;
- la diferencia r − s: las tuplas de r que no están en s.
La unión y la intersección son conmutativas; la diferencia no. Además, la intersección no es una operación primitiva: r ∩ s = r − (r − s).
SQL tiene una operación para cada una: UNION, INTERSECT y EXCEPT. Se
escriben entre dos consultas completas, y las dos tienen que devolver la misma
cantidad de columnas con tipos compatibles. Los nombres de las columnas del
resultado son los de la primera consulta.
Las ciudades donde Chasqui tiene una agencia o algún cliente:
SELECT count(*) AS ciudades
FROM (SELECT city FROM agency UNION SELECT city FROM customer) AS t;
ciudades
----------
26
(1 row)(La consulta de afuera solo cuenta las filas; las subconsultas en el FROM
se explican en detalle en la sesión B.) Hay 29 agencias y 1800 clientes, pero
26 ciudades: UNION elimina los duplicados, igual que la unión del
álgebra. Las ciudades con clientes pero sin agencia:
SELECT city FROM customer
EXCEPT
SELECT city FROM agency;
city
------
(0 rows)Ninguna: todos los clientes de Chasqui viven en una ciudad con agencia. Para ver una diferencia que no sea vacía, comparemos remitentes y destinatarios. Los clientes que enviaron algo pero nunca recibieron nada, los que recibieron pero nunca enviaron, y los que hicieron las dos cosas:
SELECT count(*) AS solo_remitentes
FROM (SELECT sender_id FROM shipment
      EXCEPT
      SELECT recipient_id FROM shipment) AS t;
solo_remitentes
-----------------
20
(1 row)Si se invierte el orden de los operandos, el resultado es otro (40 clientes
solo recibieron), y con INTERSECT salen 1698 clientes que enviaron y
recibieron. Las tres cifras suman 1758, los clientes que aparecen en algún
envío; los otros 42 no aparecen en ninguno.
Idea clave.
UNION,INTERSECTyEXCEPTcomparan filas completas, no columnas sueltas. Por eso las dos consultas deben devolver filas de la misma forma. Si no, PostgreSQL respondeeach UNION query must have the same number of columns.
Multiconjuntos: UNION ALL, INTERSECT ALL y EXCEPT ALL
Una tabla de SQL es un multiconjunto (bag): la misma fila puede aparecer
varias veces. Las operaciones sin ALL devuelven un conjunto, sin repeticiones.
Con ALL se usa la semántica de multiconjuntos. Si una fila t aparece m
veces en el primer operando y n veces en el segundo, entonces en el
resultado aparece:
| Operación | Copias de t en el resultado |
|---|---|
UNION ALL |
m + n |
INTERSECT ALL |
mín(m, n) |
EXCEPT ALL |
máx(m − n, 0) |
UNION, INTERSECT, EXCEPT |
0 o 1 |
Con UNION ALL, las ciudades de agencias y clientes ya no son 26 filas sino
29 + 1800:
SELECT count(*) AS filas
FROM (SELECT city FROM agency UNION ALL SELECT city FROM customer) AS t;
filas
-------
1829
(1 row)EXCEPT ALL resta copias. Lima tiene tres agencias y Arequipa dos; si a la
lista de ciudades de las agencias se le quita una copia de cada ciudad, quedan
exactamente las repeticiones:
SELECT city FROM agency
EXCEPT ALL
SELECT DISTINCT city FROM agency
ORDER BY city;
city
----------
Arequipa
Lima
Lima
(3 rows)En sets-null-aggregates.sql
hay dos listas pequeñas escritas con VALUES para comprobar las fórmulas de
INTERSECT ALL y EXCEPT ALL.
Idea clave.
UNION ALLes más barato queUNION: no tiene que buscar duplicados (lo que exige ordenar o usar una hash table). Si se sabe que los operandos no comparten filas, o si las repeticiones importan, se usaUNION ALL.
En PostgreSQL.
INTERSECTtiene más precedencia queUNIONyEXCEPT, que se evalúan de izquierda a derecha:a UNION b INTERSECT cesa UNION (b INTERSECT c). Ante la duda, paréntesis. UnORDER BYo unLIMITal final se aplica al resultado de toda la operación, no a la última consulta; para aplicarlo a una parte, esa parte va entre paréntesis.
NULL y la lógica de tres valores
Qué significa NULL
NULL es un marcador que indica que falta un valor: no se conoce, o no
aplica. En Chasqui aparece en cinco columnas: customer.phone (259 clientes
no dieron teléfono), shipment.declared_value (4864 envíos no declararon
valor), shipment.trip_id (los 500 envíos registrados todavía no tienen
viaje), shipment.delivered_at (los que no se entregaron) y
trip.arrival_at (14 viajes que aún no llegan). Todas las demás columnas son
NOT NULL.
NULL no es el número 0 ni el texto vacío '': un envío con
declared_value = 0 declaró que no vale nada; uno con declared_value NULL
no declaró. La pregunta que hay que hacerse siempre es: ¿qué debería
responder la consulta para una fila cuyo valor no se conoce? SQL tiene una
respuesta fija para cada operación, y vale la pena conocerla en detalle.
Aritmética y comparaciones
Una operación aritmética con un operando NULL da NULL: si no se sabe
cuánto es x, tampoco se sabe cuánto es x + 10. Una comparación (=,
<>, <, >, <=, >=) con un operando NULL no da verdadero ni falso:
da un tercer valor de verdad, unknown (desconocido). Esto incluye
comparar NULL consigo mismo:
SELECT 10 + NULL AS suma,
       NULL = NULL AS igual,
       NULL <> NULL AS distinto,
       NULL IS NULL AS es_null;
suma | igual | distinto | es_null
------+-------+----------+---------
∅ | ∅ | ∅ | t
(1 row)En PostgreSQL, unknown se representa con el NULL del tipo boolean, por
eso NULL = NULL también se muestra como ∅. NULL = NULL es unknown
porque dos valores desconocidos pueden ser iguales o no: no hay forma de
saberlo. La única pregunta que siempre tiene respuesta es ¿es NULL?, y se
hace con IS NULL.
Tres valores de verdad
Con tres valores de verdad, los conectores lógicos necesitan tablas nuevas. La regla para recordarlas: unknown se comporta como “quizás verdadero, quizás falso”, y el resultado es unknown solo si de verdad depende de cuál de los dos sea.
- p
ANDq es falso si alguno es falso (no importa el otro); verdadero si los dos son verdaderos; unknown en los demás casos. - p
ORq es verdadero si alguno es verdadero (no importa el otro); falso si los dos son falsos; unknown en los demás casos. NOTunknown es unknown.
PostgreSQL produce la tabla completa si se combinan los tres valores de
boolean consigo mismos:
SELECT p, q, p AND q AS p_and_q, p OR q AS p_or_q, NOT p AS not_p
FROM (VALUES (true), (false), (NULL::boolean)) AS a(p)
CROSS JOIN (VALUES (true), (false), (NULL::boolean)) AS b(q)
ORDER BY p DESC NULLS LAST, q DESC NULLS LAST;
p | q | p_and_q | p_or_q | not_p
---+---+---------+--------+-------
t | t | t | t | f
t | f | f | t | f
t | ∅ | ∅ | t | f
f | t | f | t | t
f | f | f | f | t
f | ∅ | f | ∅ | t
∅ | t | ∅ | t | ∅
∅ | f | f | ∅ | ∅
∅ | ∅ | ∅ | ∅ | ∅
(9 rows)Fíjense en las filas 6 y 8: false AND unknown es falso y true OR unknown
(fila 3) es verdadero. Ahí unknown no contamina el resultado.
WHERE se queda solo con lo verdadero
La regla que más importa: WHERE y HAVING conservan las filas cuyo
predicado es verdadero, y descartan las que dan falso o unknown. Las
consecuencias no son intuitivas. Esta consulta cuenta los envíos según su
valor declarado, con count(*) FILTER (WHERE ...), que cuenta solo las
filas que cumplen la condición (lo veremos con más detalle al final de la
sesión A):
SELECT count(*) AS total,
       count(*) FILTER (WHERE declared_value > 500) AS mayor,
       count(*) FILTER (WHERE declared_value <= 500) AS menor_igual,
       count(*) FILTER (WHERE declared_value > 500
                           OR declared_value <= 500) AS cualquiera,
       count(*) FILTER (WHERE declared_value IS NULL) AS sin_valor
FROM shipment;
total | mayor | menor_igual | cualquiera | sin_valor
-------+-------+-------------+------------+-----------
12000 | 6039 | 1097 | 7136 | 4864
(1 row)declared_value > 500 OR declared_value <= 500 parece una tautología, pero
no lo es: para los 4864 envíos sin valor declarado, las dos comparaciones son
unknown, y unknown OR unknown es unknown. Solo se conservan 7136 de los
12 000 envíos, exactamente 12 000 − 4864.
Tampoco NOT rescata a esas filas. Si se piensa “los envíos que no valen más
de 500”, la tentación es escribir NOT (declared_value > 500) y esperar
12 000 − 6039 = 5961 filas. Pero:
SELECT count(*) AS no_mayor
FROM shipment
WHERE NOT (declared_value > 500);
no_mayor
----------
1097
(1 row)Son los mismos 1097 de declared_value <= 500: NOT unknown es unknown y
los envíos sin valor declarado se quedan fuera también aquí. En lógica de dos
valores, p y NOT p parten las filas en dos; en SQL, las parten en
tres: las que cumplen p, las que cumplen NOT p y aquellas para las que
p es unknown.
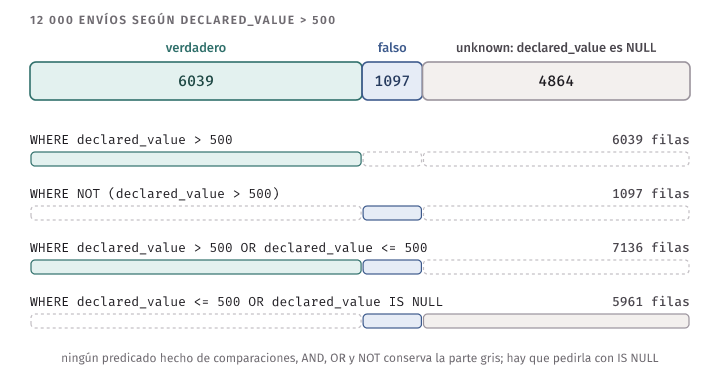
Idea clave. Para que una consulta incluya las filas con
NULL, hay que pedirlo explícitamente:WHERE declared_value <= 500 OR declared_value IS NULL. Ninguna combinación de comparaciones,AND,ORyNOTlo hace sola.
IS NULL, IS UNKNOWN, IS DISTINCT FROM y coalesce
Error común. Escribir
WHERE phone = NULL. La comparación es unknown para todas las filas, así que la consulta devuelve cero filas, sin error ni advertencia:igual_null ------------ 0 (1 row)La forma correcta es
WHERE phone IS NULL, que devuelve los 259 clientes sin teléfono. Para lo contrario,IS NOT NULL.
IS NULL e IS NOT NULL siempre dan verdadero o falso, nunca unknown.
Hay más predicados así, que preguntan por el valor de verdad en vez de
propagarlo:
-
p
IS TRUE, pIS FALSEy pIS UNKNOWN(con sus versionesIS NOT ...) preguntan qué valor de verdad tiene una condición. Los envíos para los quedeclared_value > 500es unknown:SELECT count(*) AS desconocido FROM shipment WHERE (declared_value > 500) IS UNKNOWN;desconocido ------------- 4864 (1 row) -
a
IS DISTINCT FROMb es como<>, pero trata dosNULLcomo iguales y unNULLcomo distinto de cualquier valor; nunca da unknown. Su contrario esIS NOT DISTINCT FROM. Sirve, por ejemplo, para comparar dos columnas que pueden serNULL(¿cambió el teléfono de un cliente?).SELECT NULL IS DISTINCT FROM NULL AS d1, NULL IS DISTINCT FROM 5 AS d2, 5 IS NOT DISTINCT FROM 5 AS d3;d1 | d2 | d3 ----+----+---- f | t | t (1 row)
La función coalesce(a, b, ...) devuelve su primer argumento que no es
NULL. Es la forma usual de mostrar un valor por defecto:
SELECT customer_id, first_name, coalesce(phone, 'sin teléfono') AS phone
FROM customer
WHERE customer_id BETWEEN 1 AND 6
ORDER BY customer_id;
customer_id | first_name | phone
-------------+------------+--------------
1 | Wilmer | 909975104
2 | Piero | 946039842
3 | Milagros | sin teléfono
4 | Luz | 967016439
5 | Gladys | 931723617
6 | Renzo | 987485715
(6 rows)En PostgreSQL. Existe un parámetro,
transform_null_equals, que hace quex = NULLse lea comox IS NULL, por compatibilidad con un programa antiguo de Microsoft. Está apagado por defecto (SHOW transform_null_equalsrespondeoff) y no conviene encenderlo: el código deja de funcionar en cualquier otra base de datos y la regla general (cualquier comparación conNULLes unknown) deja de valer en un caso.
Donde dos NULL sí son iguales
Hay un lugar donde SQL trata dos NULL como el mismo valor: al eliminar o
juntar duplicados. DISTINCT, UNION, INTERSECT, EXCEPT y GROUP BY
consideran que dos filas son duplicadas si en cada columna los valores son
iguales o ambos son NULL (es decir, usan IS NOT DISTINCT FROM, no =).
SELECT NULL AS x UNION SELECT NULL; x
---
∅
(1 row)Si UNION usara =, las dos filas no serían duplicadas (NULL = NULL es
unknown) y quedarían ambas. Una forma de recordarlo: en un WHERE, la
pregunta es “¿estos dos valores son iguales?” y la respuesta honesta es “no
se sabe”; al eliminar duplicados, la pregunta es “¿estas dos filas son
copias una de la otra?”, y dos NULL en la misma columna lo son.
| Contexto | ¿NULL es igual a NULL? |
|---|---|
=, <>, IN, comparaciones en WHERE, ON, HAVING |
no: unknown |
IS NOT DISTINCT FROM |
sí |
DISTINCT, UNION, INTERSECT, EXCEPT (con o sin ALL) |
sí |
GROUP BY |
sí: todos los NULL forman un grupo |
Funciones de agregación
Definición
Una función de agregación recibe una colección de valores (un multiconjunto) y devuelve un solo valor. SQL tiene cinco básicas:
| Función | Devuelve | Tipos de entrada |
|---|---|---|
count |
cuántos valores hay | cualquiera |
sum |
la suma | numéricos |
avg |
el promedio | numéricos |
min, max |
el menor y el mayor | cualquier tipo con orden (números, texto, fechas) |
Dos reglas fijan su comportamiento con NULL, y conviene aprenderlas tal
cual:
- Las cinco funciones ignoran los
NULLde su entrada, salvocount(*), que cuenta filas y no mira ningún valor. - Sobre una colección vacía,
countdevuelve 0 y todas las demás devuelvenNULL. Una colección que solo tieneNULLcuenta como vacía para las funciones que no soncount(*), porque losNULLse ignoran.
(PostgreSQL tiene otras funciones de agregación que no siguen la primera
regla: array_agg, que arma un arreglo con los valores, conserva los NULL.
Las dos reglas son las del estándar para las cinco básicas.)
Con DISTINCT dentro del paréntesis, la función primero elimina los
duplicados de su entrada: count(DISTINCT city).
count(*), count(columna) y count(DISTINCT columna)
Las tres formas de count responden preguntas distintas:
SELECT count(*) AS filas, count(phone) AS con_telefono,
       count(DISTINCT city) AS ciudades
FROM customer;
filas | con_telefono | ciudades
-------+--------------+----------
1800 | 1541 | 26
(1 row)count(*) cuenta filas: 1800 clientes. count(phone) cuenta valores no
NULL de phone: 1541 clientes dieron teléfono (y 1800 − 1541 = 259 no).
count(DISTINCT city) cuenta valores distintos no NULL: 26 ciudades.
Error común. Usar
count(columna)para contar filas. Mientras la columna seaNOT NULLda lo mismo quecount(*), y el error no se nota. El día en que la columna admiteNULL, la cuenta baja sin aviso. Si la pregunta es “cuántas filas”, se escribecount(*).
avg y los NULL
Como avg ignora los NULL, el promedio del valor declarado es el promedio
entre los envíos que declararon valor, no entre todos:
SELECT round(avg(declared_value), 2) AS promedio,
       round(sum(declared_value) / count(*), 2) AS sum_entre_filas,
       round(sum(declared_value) / count(declared_value), 2) AS sum_entre_valores
FROM shipment;
promedio | sum_entre_filas | sum_entre_valores
----------+-----------------+-------------------
1512.33 | 899.33 | 1512.33
(1 row)avg(declared_value) es sum(declared_value) / count(declared_value). Si se
divide entre count(*), el resultado es otra cosa: el promedio suponiendo que
los envíos sin valor declarado valen 0, lo que en general no es cierto. Cuál
de los dos se quiere depende de la pregunta, pero hay que saber cuál se está
calculando.
Agregados sobre cero filas
Una consulta con funciones de agregación y sin GROUP BY trata a todas
las filas que pasan el WHERE como un solo grupo, y devuelve exactamente
una fila, aunque ninguna fila pase el WHERE (salvo que un HAVING
descarte ese único grupo). Ningún envío tiene precio
negativo (hay un CHECK), así que:
SELECT count(*) AS n, count(price) AS n_price, sum(price) AS suma,
       avg(price) AS promedio, min(price) AS minimo, max(price) AS maximo
FROM shipment
WHERE price < 0;
n | n_price | suma | promedio | minimo | maximo
---+---------+------+----------+--------+--------
0 | 0 | ∅ | ∅ | ∅ | ∅
(1 row)Una fila, con los dos count en 0 y lo demás en NULL. En cambio, con
GROUP BY, cero filas de entrada forman cero grupos, y el resultado es
vacío:
SELECT status, count(*) AS n
FROM shipment
WHERE price < 0
GROUP BY status;
status | n
--------+---
(0 rows)La segunda regla también se cumple cuando hay filas pero todos los valores
son NULL. Los 4864 envíos sin valor declarado:
SELECT count(*) AS filas, count(declared_value) AS valores,
       sum(declared_value) AS suma,
       coalesce(sum(declared_value), 0) AS suma_o_cero
FROM shipment
WHERE declared_value IS NULL;
filas | valores | suma | suma_o_cero
-------+---------+------+-------------
4864 | 0 | ∅ | 0
(1 row)sum de una colección sin valores es NULL, no 0. Si un informe necesita un
0 (por ejemplo, los ingresos de una agencia que todavía no envió nada), se
escribe coalesce(sum(...), 0).
Idea clave. “Cero filas” y “una fila con
NULL” son respuestas distintas, y la diferencia la decide la presencia deGROUP BY. Un programa que lee el resultado tiene que estar preparado para la que le corresponde: conGROUP BYpuede no haber filas; sinGROUP BY(y sinHAVING), siempre hay una, y el valor puede serNULL.
GROUP BY y HAVING
Agrupamiento
GROUP BY parte las filas en grupos: dos filas van al mismo grupo si
tienen los mismos valores en las columnas de agrupamiento. Después, el
SELECT produce una fila por grupo, y las funciones de agregación se
calculan sobre las filas de cada grupo. Los envíos por estado:
SELECT status, count(*) AS n
FROM shipment
GROUP BY status
ORDER BY n DESC;
status | n
------------+-------
delivered | 11115
registered | 500
returned | 319
in_transit | 66
(4 rows)En el álgebra relacional, la agregación se escribe con la letra γ (gamma):
GγF(r), donde G son los atributos de agrupamiento y
F las funciones. La consulta anterior es
statusγcount(*)(shipment). Si G es vacío, toda la
relación es un solo grupo: es el caso sin GROUP BY de la sección anterior.
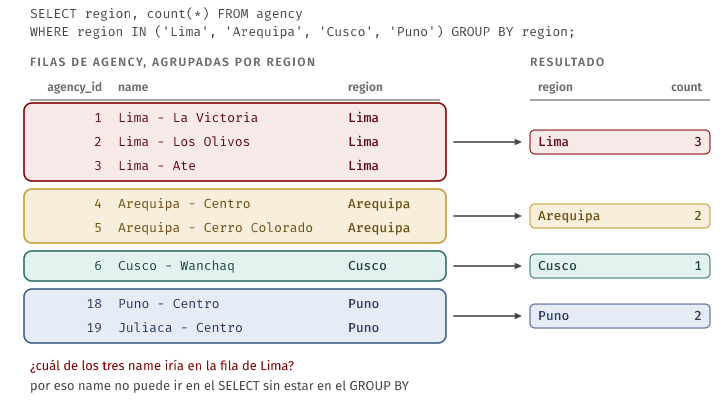
Como el resultado tiene una fila por grupo, cada expresión del SELECT
debe tener un único valor por grupo. De ahí la regla: toda columna del
SELECT que no está dentro de una función de agregación tiene que estar en
el GROUP BY. Si no, ¿cuál de los valores del grupo se mostraría?
SELECT region, name, count(*)
FROM agency
GROUP BY region;
ERROR: column "agency.name" must appear in the GROUP BY clause or be used in an aggregate function
LINE 1: SELECT region, name, count(*)
^La región Lima tiene tres agencias con tres nombres distintos; la consulta no tiene una respuesta bien definida y PostgreSQL la rechaza.
En PostgreSQL. La regla tiene una excepción, que está en el estándar: si se agrupa por la clave primaria de una tabla, se puede usar cualquier otra columna de esa tabla en el
SELECT, porque depende funcionalmente de la clave (hay un úniconamepor cadaagency_id). Los ingresos por agencia de origen se pueden escribir así:SELECT a.agency_id, a.name, sum(s.price) AS ingresos FROM agency a, shipment s WHERE s.origin_agency_id = a.agency_id GROUP BY a.agency_id ORDER BY ingresos DESC LIMIT 5;agency_id | name | ingresos -----------+--------------------+----------- 1 | Lima - La Victoria | 116713.45 3 | Lima - Ate | 71252.76 2 | Lima - Los Olivos | 60320.42 8 | Chiclayo - Centro | 45282.52 9 | Piura - Castilla | 41478.76 (5 rows)PostgreSQL solo reconoce esta dependencia a partir de una clave primaria (no de una restricción
UNIQUE). No todos los motores la reconocen; para que la consulta sea portable, se agregaa.namealGROUP BY.
NULL en la columna de agrupamiento
Como se vio en la tabla de la sección de NULL, GROUP BY trata a todos los
NULL como un mismo valor: forman un solo grupo. Agrupando los envíos por
viaje, los 500 envíos que todavía no tienen viaje quedan juntos:
SELECT trip_id, count(*) AS n
FROM shipment
GROUP BY trip_id
ORDER BY n DESC, trip_id
LIMIT 3;
trip_id | n
---------+-----
∅ | 500
2160 | 10
307 | 9
(3 rows)Esto produce una diferencia sutil entre la cantidad de grupos y
count(DISTINCT ...): DISTINCT (como GROUP BY) junta los NULL en un
valor más, pero count(DISTINCT trip_id), como toda función de agregación,
los ignora:
SELECT (SELECT count(*) FROM (SELECT DISTINCT trip_id FROM shipment) AS d)
         AS valores_distintos,
       count(DISTINCT trip_id) AS count_distinct
FROM shipment;
valores_distintos | count_distinct
-------------------+----------------
4877 | 4876
(1 row)HAVING: filtrar grupos
WHERE filtra filas antes de agrupar; HAVING filtra grupos después de
agrupar. Por eso la condición de HAVING puede usar funciones de
agregación, y solo puede referirse a columnas de agrupamiento o a agregados
(la misma regla que el SELECT). Las rutas con más de 50 viajes:
SELECT count(*) AS rutas
FROM (SELECT route_id
      FROM trip
      GROUP BY route_id
      HAVING count(*) > 50) AS t;
rutas
-------
58
(1 row)En los datos de ejemplo, las rutas tienen 25, 26, 75 o 76 viajes: 58 de las 120 pasan el umbral.
El orden lógico de una consulta
Con todas las cláusulas, una consulta se entiende si se lee en este orden, que es el orden lógico en que se evalúan (el motor puede ejecutarlas de otra forma, pero el resultado tiene que ser este):
FROM: el producto de las tablas.WHERE: se conservan las filas cuyo predicado es verdadero.GROUP BY: se forman los grupos.HAVING: se conservan los grupos cuyo predicado es verdadero.SELECT: se calcula una fila por grupo (o por fila, si no hay agrupamiento), yDISTINCTsi lo hay.UNION,INTERSECT,EXCEPT, si los hay.ORDER BYyLIMIT.
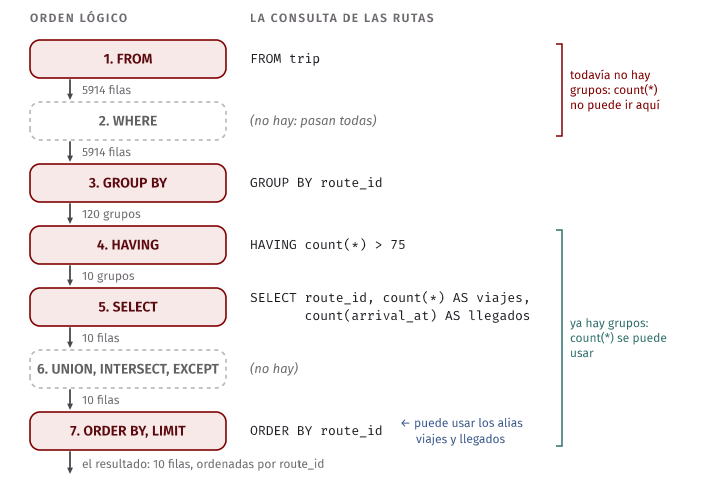
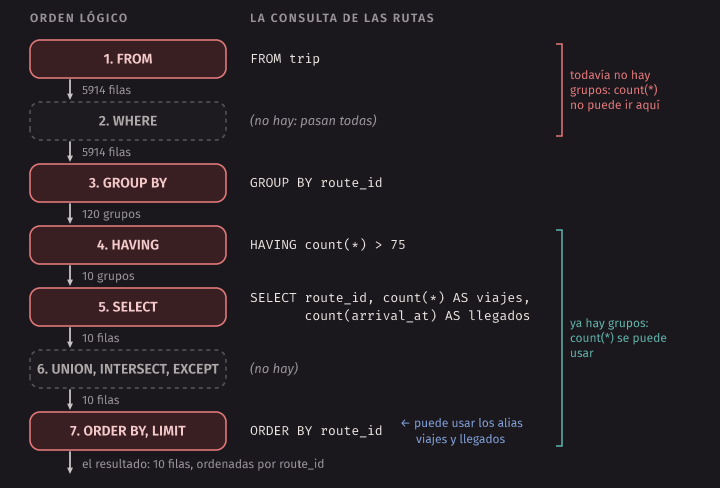
Este orden explica varias reglas. Un alias definido en el SELECT (AS n)
se puede usar en ORDER BY, que viene después, pero no en WHERE ni en
HAVING, que vienen antes. Y una función de agregación no puede ir en
WHERE, porque cuando se evalúa WHERE todavía no hay grupos.
WHERE o HAVING
Error común. Poner la condición sobre un agregado en
WHERE:SELECT route_id FROM trip WHERE count(*) > 50 GROUP BY route_id;ERROR: aggregate functions are not allowed in WHERE LINE 3: WHERE count(*) > 50 ^La condición va en
HAVING count(*) > 50.
El error contrario no da mensaje: olvidar el filtro sobre filas en el
WHERE hace que se cuenten filas que no correspondían, y la respuesta cambia
sin aviso. Las rutas con más de 75 viajes son 10, y en cada una hay un viaje
que todavía no llega:
SELECT route_id, count(*) AS viajes, count(arrival_at) AS llegados
FROM trip
GROUP BY route_id
HAVING count(*) > 75
ORDER BY route_id;
route_id | viajes | llegados
----------+--------+----------
7 | 76 | 75
12 | 76 | 75
14 | 76 | 75
15 | 76 | 75
16 | 76 | 75
25 | 76 | 75
33 | 76 | 75
34 | 76 | 75
36 | 76 | 75
49 | 76 | 75
(10 rows)Si la pregunta es “las rutas con más de 75 viajes que ya llegaron”, la
condición arrival_at IS NOT NULL es sobre cada viaje, va en WHERE y se
aplica antes de contar:
SELECT route_id, count(*) AS viajes
FROM trip
WHERE arrival_at IS NOT NULL
GROUP BY route_id
HAVING count(*) > 75
ORDER BY route_id;
route_id | viajes
----------+--------
(0 rows)Ninguna. Las dos consultas responden preguntas distintas, y las dos son
correctas para su pregunta; usar la primera para responder la segunda es el
error silencioso. Tampoco se puede mover arrival_at IS NOT NULL a
HAVING: arrival_at no es una columna de agrupamiento y PostgreSQL
lo rechaza con el mismo mensaje de GROUP BY de antes. Una condición sobre
una columna de agrupamiento (HAVING status = 'delivered' con GROUP BY status) sí es válida en HAVING, pero conviene ponerla en WHERE: el
resultado es el mismo y el motor descarta las filas antes de agrupar.
Agregación con FILTER
count(*) FILTER (WHERE condición) aplica la función solo a las filas del
grupo que cumplen la condición. Es SQL estándar y permite calcular varias
cuentas en una sola pasada por la tabla, sin una consulta por cada una. Los
envíos de las cinco regiones con más envíos, con cuántos se entregaron y
cuántos se devolvieron:
SELECT a.region,
       count(*) AS envios,
       count(*) FILTER (WHERE s.status = 'delivered') AS entregados,
       count(*) FILTER (WHERE s.status = 'returned') AS devueltos
FROM agency a, shipment s
WHERE s.origin_agency_id = a.agency_id
GROUP BY a.region
ORDER BY envios DESC
LIMIT 5;
region | envios | entregados | devueltos
------------+--------+------------+-----------
Lima | 3965 | 3706 | 107
Áncash | 873 | 816 | 21
Arequipa | 842 | 778 | 18
Lambayeque | 698 | 644 | 17
Cusco | 610 | 559 | 16
(5 rows)FILTER funciona con cualquier función de agregación (sum(price) FILTER (WHERE ...)), y la condición del FILTER sigue la misma regla que WHERE:
se cuentan las filas para las que es verdadera.
Subconsultas anidadas
Una subconsulta (subquery) es una consulta SELECT-FROM-WHERE escrita
dentro de otra. Puede ir en el WHERE (o en el HAVING), donde se compara
con un valor de la consulta de afuera; en el FROM, donde actúa como una
tabla; o en el SELECT, donde produce un valor. Empezamos por el WHERE, con
las cuatro formas de usar una subconsulta como conjunto: IN, SOME, ALL y
EXISTS.
Pertenencia: IN
x IN (subconsulta) es verdadero si x es igual a alguno de los valores
que devuelve la subconsulta. Los clientes que enviaron algo:
SELECT count(*) AS remitentes
FROM customer
WHERE customer_id IN (SELECT sender_id FROM shipment);
remitentes
------------
1718
(1 row)La subconsulta devuelve un sender_id por envío, con muchas repeticiones,
pero eso no importa: IN pregunta por pertenencia, y cada cliente aparece una
vez en el resultado porque la consulta de afuera recorre customer. Es la
diferencia con un join entre customer y shipment, que repetiría al cliente
una vez por cada envío.
IN también acepta una lista escrita a mano, city IN ('Puno', 'Juliaca'),
y una tupla: (origin_agency_id, dest_agency_id) IN (SELECT ...).
NOT IN y la trampa del NULL
Para entender NOT IN hay que escribir IN como lo que es, una cadena de
OR, y aplicar la lógica de tres valores:
- x
IN(v1, …, vn) es x = v1OR…ORx = vn. - x
NOT IN(v1, …, vn) esNOTde lo anterior, o sea x ≠ v1AND…ANDx ≠ vn.
Si alguno de los vi es NULL, la comparación x ≠ NULL es
unknown, y el AND completo ya no puede ser verdadero: es falso (si x está
en la lista) o unknown (si no está). Un NOT IN cuya lista contiene un
NULL nunca es verdadero:
SELECT 3 NOT IN (1, 2)       AS sin_null,
       3 NOT IN (1, 2, NULL) AS con_null,
       1 NOT IN (1, 2, NULL) AS presente,
       3 IN (1, 2, NULL)     AS in_con_null;
sin_null | con_null | presente | in_con_null
----------+----------+----------+-------------
t | ∅ | f | ∅
(1 row)En Chasqui la trampa aparece con una pregunta natural: los viajes que no
llevan ningún envío. Los 500 envíos registrados aún no tienen viaje, así que
shipment.trip_id tiene NULL:
SELECT count(*) AS viajes_vacios
FROM trip
WHERE trip_id NOT IN (SELECT trip_id FROM shipment);
viajes_vacios
---------------
0
(1 row)Cero filas, sin error y sin advertencia, aunque hay 1038 viajes vacíos. Hay
tres maneras correctas de escribirla. La primera saca los NULL de la
subconsulta:
SELECT count(*) AS viajes_vacios
FROM trip
WHERE trip_id NOT IN (SELECT trip_id FROM shipment WHERE trip_id IS NOT NULL);
La segunda, la recomendada, usa NOT EXISTS (que se explica más abajo):
SELECT count(*) AS viajes_vacios
FROM trip t
WHERE NOT EXISTS (SELECT 1 FROM shipment s WHERE s.trip_id = t.trip_id);
La tercera es una diferencia de conjuntos, que trata los NULL como iguales
entre sí y no como comparaciones unknown:
SELECT count(*) AS viajes_vacios
FROM (SELECT trip_id FROM trip
      EXCEPT
      SELECT trip_id FROM shipment) AS t;
Las tres devuelven lo mismo:
 viajes_vacios
---------------
          1038
(1 row)
Error común. Usar
NOT IN (subconsulta)cuando la columna de la subconsulta admiteNULL. Hoy puede funcionar porque no hay ningúnNULL; el día en que alguien inserta uno, la consulta empieza a devolver cero filas. Cuando la columna admiteNULL, se escribeNOT EXISTS.
NOT IN y NOT EXISTS tampoco son equivalentes cuando el que es NULL es el
valor de afuera: si x es NULL y la subconsulta no es vacía, x NOT IN
(…) es unknown, mientras que NOT EXISTS con la condición s.a = x es
verdadero (no existe ninguna fila con s.a = NULL). Aquí no pasa porque
trip.trip_id es la clave primaria.
Comparación con conjuntos: SOME y ALL
IN pregunta por igualdad. Para otras comparaciones, SQL tiene dos
cuantificadores. Sea θ uno de =, <>, <, <=, >, >=:
- x θ
SOME(S) es verdadero si x θ v es verdadero para algún v de S. (ANYes sinónimo deSOME.) - x θ
ALL(S) es verdadero si x θ v es verdadero para todos los v de S.
De las definiciones salen dos equivalencias: = SOME es lo mismo que IN, y
<> ALL es lo mismo que NOT IN, con la misma trampa del NULL. En cambio,
<> SOME no es NOT IN: es verdadero si hay algún valor distinto de x,
lo que casi siempre ocurre.
Los envíos más caros que todos los que salieron de Tumbes - Centro (agencia 10):
SELECT count(*) AS mas_caros
FROM shipment
WHERE price > ALL (SELECT price FROM shipment WHERE origin_agency_id = 10);
mas_caros
-----------
409
(1 row)Y los más caros que alguno de Tumbes, con > SOME, son 11 902 de 12 000.
La primera consulta también se puede escribir comparando con un máximo,
price > (SELECT max(price) FROM shipment WHERE origin_agency_id = 10), y da
los mismos 409. Pero las dos formas no son equivalentes en general, y la
diferencia está, otra vez, en los casos borde.
SOME es una cadena de OR y ALL es una cadena de AND, así que con
NULL en el conjunto se comportan como esas cadenas:
SELECT 5 > ALL (VALUES (1), (2))         AS all_sin_null,
       5 > ALL (VALUES (1), (NULL::int)) AS all_unknown,
       5 > ALL (VALUES (9), (NULL::int)) AS all_falso,
       5 > SOME (VALUES (9), (NULL::int)) AS some_unknown,
       5 > SOME (VALUES (1), (NULL::int)) AS some_verdad;
all_sin_null | all_unknown | all_falso | some_unknown | some_verdad
--------------+-------------+-----------+--------------+-------------
t | ∅ | f | ∅ | t
(1 row)Y sobre un conjunto vacío, la cadena de AND vacía es verdadera y la de
OR vacía es falsa, como el “para todo” y el “existe” de la lógica:
SELECT 5 > ALL (SELECT 1 WHERE false)  AS all_vacio,
       5 > SOME (SELECT 1 WHERE false) AS some_vacio,
       5 > (SELECT max(1) WHERE false)  AS max_vacio,
       NULL::int NOT IN (SELECT 1 WHERE false) AS null_not_in_vacio;
all_vacio | some_vacio | max_vacio | null_not_in_vacio
-----------+------------+-----------+-------------------
t | f | ∅ | t
(1 row)Aquí está la diferencia entre > ALL y > max: si la subconsulta no
devuelve filas, > ALL es verdadero (5 es mayor que todos los elementos de
un conjunto vacío), pero max de nada es NULL y 5 > NULL es unknown. Si
la agencia 10 no hubiera enviado nada, la versión con ALL devolvería los
12 000 envíos y la versión con max, ninguno. La última columna muestra que
incluso un NULL está “fuera” de un conjunto vacío.
EXISTS y las subconsultas correlacionadas
EXISTS (subconsulta) es verdadero si la subconsulta devuelve al menos
una fila, y NOT EXISTS, si no devuelve ninguna. Nunca es unknown. Lo que
devuelve la subconsulta no importa, solo si hay filas; por costumbre se
escribe SELECT 1.
EXISTS casi siempre va con una subconsulta correlacionada: una
subconsulta que usa una columna de la consulta de afuera. Los clientes que
nunca recibieron un envío:
SELECT count(*) AS nunca_recibieron
FROM customer c
WHERE NOT EXISTS (SELECT 1 FROM shipment s WHERE s.recipient_id = c.customer_id);
nunca_recibieron
------------------
62
(1 row)c.customer_id viene de afuera. Conceptualmente, la subconsulta se evalúa
una vez por cada fila de customer, con c.customer_id reemplazado por
el valor de esa fila: para el cliente 1 se pregunta si existe un envío con
recipient_id = 1, para el cliente 2 con recipient_id = 2, etc. (El motor
no la ejecuta así: la convierte en un tipo de join, y los algoritmos de join
y el optimizador se estudian en las semanas 11 y 12. Pero el resultado es el
que da esta lectura.)
La regla para resolver los nombres es la de los lenguajes de programación con
bloques: un nombre sin prefijo se busca primero en el FROM de la subconsulta
y, si no está, en el de afuera. Por eso conviene poner alias distintos
(s, c) y usarlos siempre, para que se vea qué columna es de qué nivel.
Muchas preguntas se pueden escribir de varias formas. Los clientes que fueron
remitentes y también destinatarios salen con INTERSECT (como en la sección
de conjuntos), con dos IN o con dos EXISTS correlacionados; las tres
versiones están en subqueries.sql y
devuelven 1698.
“Para todo” con doble negación
SQL no tiene un cuantificador “para todo” sobre filas. Se obtiene con la equivalencia de la lógica: ∀a P(a) ⇔ ¬∃a ¬P(a). Los clientes que enviaron paquetes a todas las agencias de la región Lima son los clientes para los que no existe una agencia de Lima a la que no hayan enviado:
SELECT count(*) AS a_todas_lima
FROM customer c
WHERE NOT EXISTS (
  SELECT 1
  FROM agency a
  WHERE a.region = 'Lima'
    AND NOT EXISTS (SELECT 1
                    FROM shipment s
                    WHERE s.sender_id = c.customer_id
                      AND s.dest_agency_id = a.agency_id));
a_todas_lima
--------------
175
(1 row)Se lee de adentro hacia afuera. La subconsulta más interna pregunta si el
cliente c envió algo a la agencia a. La del medio busca una agencia de
Lima para la que la respuesta sea no: un “contraejemplo”. La de afuera se
queda con los clientes sin contraejemplo. Es la división del álgebra
relacional: Πsender_id, dest_agency_id(shipment) ÷
Πagency_id(σregion = ‘Lima’(agency)), con los atributos
renombrados para que coincidan.
Una alternativa es contar: un cliente envió a todas las agencias de Lima si la cantidad de agencias de Lima distintas a las que envió es igual a la cantidad de agencias de Lima.
SELECT count(*) AS a_todas_lima
FROM (SELECT s.sender_id
      FROM shipment s, agency a
      WHERE s.dest_agency_id = a.agency_id AND a.region = 'Lima'
      GROUP BY s.sender_id
      HAVING count(DISTINCT a.agency_id) =
             (SELECT count(*) FROM agency WHERE region = 'Lima')) AS t;
También da 175. Pero las dos versiones difieren cuando el divisor es
vacío. Si se pregunta por una región que no tiene agencias, no hay
contraejemplos para nadie y la versión con NOT EXISTS devuelve a todos los
clientes:
SELECT count(*) AS a_todas_ninguna
FROM customer c
WHERE NOT EXISTS (
  SELECT 1
  FROM agency a
  WHERE a.region = 'Lima Metropolitana'
    AND NOT EXISTS (SELECT 1
                    FROM shipment s
                    WHERE s.sender_id = c.customer_id
                      AND s.dest_agency_id = a.agency_id));
a_todas_ninguna
-----------------
1800
(1 row)Es la respuesta de la lógica: todo cliente envió a “todas” las agencias de un conjunto vacío, incluso los que nunca enviaron nada. Con un divisor vacío, el resultado depende de qué recorre la consulta de afuera, y hay tres respuestas distintas:
| Versión | Clientes con la región 'Lima Metropolitana' |
|---|---|
Doble NOT EXISTS recorriendo customer |
1800: todos los clientes |
Doble NOT EXISTS recorriendo SELECT DISTINCT sender_id FROM shipment |
1718: todos los remitentes |
La versión que cuenta, con GROUP BY y HAVING |
0: el join con agency no deja filas que agrupar |
La segunda es la división del álgebra: r ÷ s toma sus tuplas de r, así
que con s vacío devuelve Πsender_id(shipment), los 1718
remitentes, y no a los clientes que nunca enviaron. Ninguna de las tres es un
error, pero hay que saber cuál quiere la pregunta. Las tres consultas están en
subqueries.sql.
En PostgreSQL. El libro presenta un predicado
UNIQUE (subconsulta), verdadero si la subconsulta no devuelve filas repetidas. Es parte del estándar, pero PostgreSQL no lo implementa. Se reemplaza con unGROUP BYyHAVING count(*) > 1dentro de unNOT EXISTS.
Subconsultas en FROM, WITH y subconsultas escalares
Subconsultas en FROM
El resultado de una consulta es una relación, así que se puede usar donde va
una tabla: en el FROM. Así se filtra sobre el resultado de una agregación
sin usar HAVING, o se agrega en dos niveles. El precio promedio de los
envíos de cada ruta (un envío está en una ruta a través de su viaje), y las
rutas cuyo promedio pasa de S/ 80:
SELECT route_id, round(avg_price, 2) AS avg_price
FROM (SELECT t.route_id, avg(s.price) AS avg_price
      FROM shipment s, trip t
      WHERE s.trip_id = t.trip_id
      GROUP BY t.route_id) AS route_price
WHERE avg_price > 80
ORDER BY avg_price DESC;
route_id | avg_price
----------+-----------
40 | 88.47
38 | 88.14
31 | 87.35
39 | 85.78
42 | 85.31
41 | 84.66
37 | 84.06
26 | 82.77
23 | 80.58
24 | 80.27
(10 rows)La subconsulta tiene un nombre (route_price) y sus columnas también
(avg_price); la consulta de afuera las usa como las de cualquier tabla.
En PostgreSQL. Desde la versión 16, PostgreSQL acepta una subconsulta en el
FROMsin alias:SELECT count(*) FROM (SELECT city FROM agency WHERE region = 'Puno')funciona y devuelve 2. El estándar SQL exige el alias, y las versiones anteriores de PostgreSQL y otros motores lo rechazan. Pónganlo siempre.
WITH: nombrar pasos intermedios
Cuando la subconsulta es larga, o se usa más de una vez, conviene sacarla de
la consulta y darle un nombre con WITH. Cada definición de un WITH es una
CTE (common table expression): una relación temporal que solo existe
mientras dura la consulta. Es el equivalente de la asignación ← del álgebra.
El peso total transportado por cada ruta, y cuántas rutas están por encima
del promedio:
WITH route_load AS (
  SELECT t.route_id, sum(s.weight_kg) AS total_kg
  FROM shipment s, trip t
  WHERE s.trip_id = t.trip_id
  GROUP BY t.route_id
)
SELECT count(*) AS rutas_sobre_promedio,
       (SELECT count(*) FROM route_load) AS rutas
FROM route_load
WHERE total_kg > (SELECT avg(total_kg) FROM route_load);
rutas_sobre_promedio | rutas
----------------------+-------
58 | 120
(1 row)route_load se usa tres veces y se define una. Sin WITH, habría que
copiar la misma subconsulta en tres lugares. Un WITH puede definir varias
CTE separadas por comas, y cada una puede usar las anteriores. Los envíos que
pagaron más del doble del promedio de su ruta, los cinco más caros en
proporción:
WITH route_price AS (
  SELECT t.route_id, avg(s.price) AS avg_price
  FROM shipment s, trip t
  WHERE s.trip_id = t.trip_id
  GROUP BY t.route_id
)
SELECT s.shipment_id, t.route_id, s.price, round(rp.avg_price, 2) AS avg_price,
       round(s.price / rp.avg_price, 2) AS veces
FROM shipment s, trip t, route_price rp
WHERE s.trip_id = t.trip_id
  AND t.route_id = rp.route_id
  AND s.price > 2 * rp.avg_price
ORDER BY veces DESC, s.shipment_id
LIMIT 5;
shipment_id | route_id | price | avg_price | veces
-------------+----------+--------+-----------+-------
7901 | 120 | 165.57 | 42.10 | 3.93
8666 | 65 | 168.18 | 46.40 | 3.62
11952 | 113 | 152.76 | 44.39 | 3.44
822 | 28 | 174.97 | 51.07 | 3.43
10437 | 52 | 154.04 | 45.94 | 3.35
(5 rows)Sin el LIMIT son 946 envíos.
WITH RECURSIVE, que permite que una CTE se use a sí misma, se ve en la
semana 5.
Subconsultas escalares
Una subconsulta escalar devuelve una sola fila con una sola columna, y
se puede usar donde va un valor: en el SELECT, en el WHERE, en un SET.
La cantidad de eventos de algunos envíos:
SELECT s.shipment_id, s.status,
       (SELECT count(*)
        FROM shipment_event e
        WHERE e.shipment_id = s.shipment_id) AS eventos
FROM shipment s
WHERE s.shipment_id IN (1, 36, 46, 63)
ORDER BY s.shipment_id;
shipment_id | status | eventos
-------------+------------+---------
1 | delivered | 4
36 | registered | 1
46 | in_transit | 2
63 | returned | 4
(4 rows)La subconsulta es correlacionada (usa s.shipment_id) y, con count(*) y
sin GROUP BY, siempre devuelve exactamente una fila. La comparación con
(SELECT max(price) FROM shipment WHERE origin_agency_id = 10) de la sección
de SOME y ALL también era una subconsulta escalar.
Si una subconsulta escalar no devuelve filas, su valor es NULL:
SELECT (SELECT name FROM agency WHERE agency_id = 99) AS agencia; agencia
---------
∅
(1 row)Y si devuelve más de una fila, es un error al ejecutar, no al compilar la consulta. El motor no sabe de antemano cuántas filas va a devolver:
SELECT name,
       (SELECT shipment_id FROM shipment s
        WHERE s.origin_agency_id = a.agency_id) AS envio
FROM agency a;
ERROR: more than one row returned by a subquery used as an expressionLATERAL
Una subconsulta en el FROM normalmente no puede usar columnas de las otras
tablas del mismo FROM. Con LATERAL sí puede: se evalúa una vez por cada
fila de las tablas que están a su izquierda, como una subconsulta
correlacionada que devuelve una tabla. El último evento de cada envío:
SELECT s.shipment_id, s.status, last.seq, last.kind
FROM shipment s
CROSS JOIN LATERAL (SELECT e.seq, e.kind
                    FROM shipment_event e
                    WHERE e.shipment_id = s.shipment_id
                    ORDER BY e.seq DESC
                    LIMIT 1) AS last
WHERE s.shipment_id IN (1, 36, 46, 63)
ORDER BY s.shipment_id;
shipment_id | status | seq | kind
-------------+------------+-----+-----------
1 | delivered | 4 | delivered
36 | registered | 1 | received
46 | in_transit | 2 | departed
63 | returned | 4 | returned
(4 rows)Con una subconsulta escalar se podría obtener el último seq o el último
kind, pero no los dos a la vez; LATERAL devuelve varias columnas. Es un
tema opcional: los joins se estudian en la semana 4.
Modificación de la base de datos
Una receta para probar sin miedo
Las sentencias de esta sección cambian datos. Para probarlas sin dañar la
base de datos, se escriben entre BEGIN; y ROLLBACK;: dentro de ese bloque
se ven los cambios, y al final ROLLBACK los deshace todos. Por ahora es una
receta; qué es una transacción y por qué funciona se estudia en la semana 13.
Todo el código de esta sección está en
modification.sql, y cada bloque termina
con ROLLBACK.
INSERT
INSERT ... VALUES agrega filas escritas a mano. Se nombran las columnas, en
el orden en que van los valores; las que no se nombran reciben su valor por
defecto (NULL si no se declaró otro). Un cliente nuevo y un envío suyo,
todavía sin viaje:
INSERT INTO customer (customer_id, dni, first_name, last_name, phone, city)
VALUES (1801, '70000001', 'Rosa', 'Quispe Mamani', NULL, 'Cusco');

INSERT INTO shipment (shipment_id, sender_id, recipient_id, origin_agency_id,
                      dest_agency_id, trip_id, weight_kg, declared_value,
                      price, status, created_at)
VALUES (12001, 1801, 152, 6, 1, NULL, 2.50, NULL, 18.00, 'registered', now());
INSERT 0 1
INSERT 0 1psql responde con la cantidad de filas insertadas (el 0 es un resto
histórico, siempre vale 0). delivered_at no se nombró y quedó en NULL.
Las restricciones del esquema se revisan en cada fila: un dni repetido o un
sender_id que no existe hacen fallar la sentencia completa.
INSERT ... SELECT inserta el resultado de una consulta. Por ejemplo, una
tabla con los remitentes frecuentes (15 envíos o más):
CREATE TABLE frequent_sender (
  customer_id integer PRIMARY KEY REFERENCES customer,
  shipments   integer NOT NULL,
  total_paid  numeric(10, 2)
);

INSERT INTO frequent_sender (customer_id, shipments)
SELECT sender_id, count(*)
FROM shipment
GROUP BY sender_id
HAVING count(*) >= 15;
CREATE TABLE
INSERT 0 100El motor evalúa el SELECT completo antes de insertar la primera fila.
Eso importa cuando se inserta en la misma tabla que se consulta: INSERT INTO t SELECT * FROM t duplica las filas de t una vez, en lugar de quedarse
insertando para siempre las filas que acaba de insertar.
UPDATE
UPDATE cambia valores de las filas que cumplen el WHERE. El SET puede
usar los valores actuales de la fila. Subir 5 % la tarifa de las rutas de
más de 500 km y 3 % la de las demás:
SELECT sum(base_fare) AS antes FROM route;

UPDATE route
SET base_fare = CASE
                  WHEN distance_km > 500 THEN round(base_fare * 1.05, 2)
                  ELSE round(base_fare * 1.03, 2)
                END;

SELECT sum(base_fare) AS despues FROM route;
antes
---------
2814.00
(1 row)
UPDATE 120
despues
---------
2920.34
(1 row)La expresión CASE elige un valor según la primera condición WHEN que sea
verdadera (o el ELSE). En una sola sentencia se aplica una regla a cada
fila, y cada fila se actualiza una vez. Con dos UPDATE seguidos hay que
pensar en el orden cuando la condición mira la misma columna que se cambia.
Si la regla fuera “5 % a las tarifas de hasta S/ 30 y 3 % a las de más de
S/ 30”, una tarifa de S/ 29.00 pasaría a S/ 30.45 con el primer UPDATE y el
segundo la volvería a subir, a S/ 31.36. El CASE evita el problema.
El WHERE de un UPDATE puede tener subconsultas. Un 10 % más en las rutas
con más de 75 viajes:
UPDATE route
SET base_fare = round(base_fare * 1.10, 2)
WHERE route_id IN (SELECT route_id
                   FROM trip
                   GROUP BY route_id
                   HAVING count(*) > 75);
UPDATE 10Y el SET puede usar una subconsulta escalar correlacionada. La columna
total_paid de frequent_sender quedó en NULL; se calcula para cada
remitente con la suma de sus envíos:
UPDATE frequent_sender f
SET total_paid = (SELECT sum(s.price)
                  FROM shipment s
                  WHERE s.sender_id = f.customer_id);

SELECT customer_id, shipments, total_paid
FROM frequent_sender
ORDER BY total_paid DESC
LIMIT 3;
UPDATE 100
customer_id | shipments | total_paid
-------------+-----------+------------
908 | 73 | 4632.96
1020 | 62 | 4508.43
657 | 69 | 4369.63
(3 rows)Aquí todos los remitentes tienen envíos. Si alguno no tuviera, la subconsulta
sumaría cero filas y total_paid quedaría en NULL; con coalesce(..., 0) alrededor quedaría en 0.
DELETE
DELETE FROM tabla WHERE condición borra las filas que cumplen la condición;
no se pueden borrar columnas sueltas. Borremos los envíos con precio menor
al promedio:
DELETE FROM shipment
WHERE price < (SELECT avg(price) FROM shipment);
ERROR: update or delete on table "shipment" violates foreign key constraint "shipment_event_shipment_id_fkey" on table "shipment_event"
DETAIL: Key (shipment_id)=(2) is still referenced from table "shipment_event".La clave foránea de shipment_event protege la integridad referencial: no se
puede borrar un envío que todavía tiene eventos. Hay que borrar primero los
eventos de esos envíos. (Después de un error dentro de BEGIN, PostgreSQL
rechaza las sentencias siguientes hasta el ROLLBACK; por eso se hace
ROLLBACK y se empieza un bloque nuevo.)
SELECT round(avg(price), 2) AS promedio,
       count(*) FILTER (WHERE price < (SELECT avg(price) FROM shipment)) AS bajo_promedio
FROM shipment;

DELETE FROM shipment_event
WHERE shipment_id IN (SELECT shipment_id
                      FROM shipment
                      WHERE price < (SELECT avg(price) FROM shipment));

DELETE FROM shipment
WHERE price < (SELECT avg(price) FROM shipment);
promedio | bajo_promedio
----------+---------------
60.50 | 7532
(1 row)
DELETE 29090
DELETE 7532Se borraron los 7532 envíos que estaban bajo el promedio de S/ 60.50. Pero
al borrar los más baratos, el promedio sube. Si el motor recalculara el
promedio después de cada fila borrada, iría borrando más y más envíos. No lo
hace: primero evalúa la condición para todas las filas y después borra las
que la cumplen. Después del DELETE, el promedio es otro y hay envíos por
debajo del promedio nuevo, que no se borraron:
SELECT count(*) AS quedan, round(avg(price), 2) AS promedio_nuevo,
       count(*) FILTER (WHERE price < (SELECT avg(price) FROM shipment))
         AS bajo_promedio_nuevo
FROM shipment;
quedan | promedio_nuevo | bajo_promedio_nuevo
--------+----------------+---------------------
4468 | 97.60 | 2508
(1 row)Lo mismo vale para UPDATE (la condición y los valores nuevos se calculan
con los datos de antes de la sentencia) y para el INSERT ... SELECT de
antes.
RETURNING
En PostgreSQL.
INSERT,UPDATEyDELETEaceptan una cláusulaRETURNINGque devuelve las filas modificadas, como unSELECT. No es SQL estándar, pero es muy útil desde un programa: evita una segunda consulta para saber qué cambió. Marcar el envío nuevo como entregado:UPDATE shipment SET status = 'delivered', delivered_at = now() WHERE shipment_id = 12001 RETURNING shipment_id, status, delivered_at IS NOT NULL AS tiene_fecha;shipment_id | status | tiene_fecha -------------+-----------+------------- 12001 | delivered | t (1 row) UPDATE 1Desde Node.js, con un parámetro:
pool.query('UPDATE shipment SET status = $1, delivered_at = now() WHERE shipment_id = $2 RETURNING *', ['delivered', id]).
UPDATE y DELETE sin WHERE
Error común. Olvidar el
WHEREen unUPDATEo unDELETE. La sentencia es válida y modifica todas las filas:UPDATE route SET base_fare = 0;UPDATE 120Las 120 rutas quedaron gratis. Antes de un
UPDATEoDELETEsobre datos que importan, escriban primero elSELECTcon el mismoWHERE, revisen cuántas filas devuelve y solo entonces cámbienlo por la modificación. Y en el laboratorio, siempre entreBEGINyROLLBACK.
Al final de modification.sql, después de todos los ROLLBACK, una consulta
confirma que nada cambió:
 clientes | envios | eventos | tarifas | tabla_nueva
----------+--------+---------+---------+-------------
     1800 |  12000 |   46421 | 2814.00 | ∅
(1 row)
Incluso el CREATE TABLE frequent_sender se deshizo: en PostgreSQL, las
sentencias que crean tablas también participan del ROLLBACK.
El código de la semana y make test
Dentro del contenedor, en code/week-03:
$ make test
chasqui-load chasqui_w03
Base de datos chasqui_w03 lista.
psql -X -q -v ON_ERROR_STOP=1 -d chasqui_w03 -f sets-null-aggregates.sql > /dev/null
psql -X -q -v ON_ERROR_STOP=1 -d chasqui_w03 -f subqueries.sql > /dev/null
psql -X -q -v ON_ERROR_STOP=1 -d chasqui_w03 -f modification.sql > /dev/null
PGDATABASE=chasqui_w03 node --test --test-concurrency=1 --test-reporter=spec
✔ un agregado no puede ir en WHERE (5.235791ms)
✔ las columnas del SELECT deben estar en GROUP BY (2.368375ms)
...
✔ subconsulta escalar sin filas vale NULL (0.254791ms)
✔ LATERAL: el último evento de cada envío (0.595708ms)
ℹ tests 45
ℹ suites 0
ℹ pass 45
ℹ fail 0
...
make test vuelve a crear la base de datos chasqui_w03, corre los tres
archivos de ejemplos (si alguna consulta falla, se detiene) y después las
pruebas. Las pruebas fijan los números de este capítulo: si alguien cambia una
consulta de los apuntes y el resultado deja de ser el que dice el texto, una
prueba falla.
| Archivo | Qué muestra |
|---|---|
sets-null-aggregates.sql |
Sesión A: operaciones de conjuntos, NULL, agregación, GROUP BY, HAVING y FILTER |
subqueries.sql |
Sesión B: IN, NOT IN, SOME/ALL, EXISTS, división, FROM, WITH, escalares y LATERAL |
modification.sql |
INSERT, UPDATE y DELETE, cada bloque entre BEGIN y ROLLBACK |
errors.sql |
Las consultas que fallan a propósito; se corre a mano y no se detiene en el primer error |
db.mjs |
El pool de conexiones que comparten las pruebas |
null-aggregates.test.mjs |
Pruebas de la sesión A: lógica de tres valores, count, agregados sobre cero filas |
subqueries.test.mjs |
Pruebas de la sesión B: la trampa de NOT IN, cuantificadores con conjuntos vacíos, división |
modification.test.mjs |
Pruebas de las modificaciones, cada una en su transacción con ROLLBACK |
errors.test.mjs |
Los mensajes de error que cita el capítulo |
Dos detalles de las pruebas en Node.js. Primero, el driver pg devuelve los
bigint (lo que devuelve count) y los numeric (sum, avg, price)
como texto, porque un número de JavaScript no puede representarlos sin
perder precisión. Por eso las pruebas escriben count(*)::int o comparan
con '2920.34'. Segundo, un pool reparte las consultas entre varias
conexiones, y BEGIN, la modificación y ROLLBACK tienen que ir por la
misma: la función inRollback de
modification.test.mjs pide una
conexión con pool.connect(), hace todo con ella y la devuelve en un
finally. Por la misma razón (dos archivos de prueba que modifican las
mismas filas a la vez podrían bloquearse entre sí), el Makefile corre los
archivos de prueba de uno en uno, con --test-concurrency=1.
Resumen
UNION,INTERSECTyEXCEPTson ∪, ∩ y − entre consultas con filas de la misma forma, y eliminan duplicados. ConALLusan semántica de multiconjuntos: m + n, mín(m, n) y máx(m − n, 0) copias.NULLmarca un valor que falta. La aritmética conNULLdaNULL; una comparación conNULL, inclusoNULL = NULL, da unknown.- Lógica de tres valores:
false AND unknownes falso,true OR unknownes verdadero,NOT unknownes unknown.WHEREyHAVINGconservan solo lo verdadero, así que pOR NOTp no devuelve todas las filas. = NULLnunca es verdadero: se escribeIS NULL.IS DISTINCT FROMcompara tratando dosNULLcomo iguales;coalescereemplaza unNULL.DISTINCT, las operaciones de conjuntos yGROUP BYsí tratan dosNULLcomo iguales: todos losNULLde la columna agrupada forman un grupo.- Las cinco funciones de agregación ignoran los
NULL, salvocount(*). Sobre una colección vacía (o de purosNULL),countda 0 y las demásNULL.avg(x)essum(x) / count(x), nosum(x) / count(*). - Sin
GROUP BY(niHAVING), una consulta con agregados devuelve una fila aunque no haya filas de entrada; conGROUP BY, cero filas de entrada dan cero filas. - Toda columna del
SELECTfuera de un agregado debe estar enGROUP BY(PostgreSQL acepta también las que dependen de la clave primaria agrupada).HAVINGfiltra grupos;WHERE, filas. Orden lógico:FROM,WHERE,GROUP BY,HAVING,SELECT,ORDER BY. FILTER (WHERE ...)aplica un agregado a una parte del grupo.INes una cadena deORyNOT INuna deAND: unNOT INcon unNULLen la subconsulta nunca es verdadero. Se usaNOT EXISTS.SOMEes “para algún” yALL“para todos”. Sobre un conjunto vacío,ALLes verdadero ySOMEfalso; por eso> ALLy> max(...)difieren cuando la subconsulta es vacía.- Una subconsulta correlacionada usa columnas de afuera y se evalúa,
conceptualmente, una vez por fila. “Para todo” se escribe con dos
NOT EXISTS(la división del álgebra); con un divisor vacío es verdadero para todo lo que recorre la consulta de afuera. - Una subconsulta en el
FROMlleva alias;WITHnombra pasos intermedios; una subconsulta escalar sin filas valeNULLy con más de una fila es un error al ejecutar. INSERT,UPDATEyDELETEevalúan sus condiciones y subconsultas antes de modificar.CASEaplica reglas distintas en un soloUPDATE.RETURNINGes de PostgreSQL. SinWHEREse modifican todas las filas.
Ejercicios
- Sin ejecutarlas, digan qué valor tiene cada expresión:
NULL = NULL,NULL IS NULL,NOT (NULL > 5),(NULL > 5) IS UNKNOWN,true OR NULL,false OR NULL,NULL IS DISTINCT FROM NULL,2 IN (1, NULL),1 IN (1, NULL),2 NOT IN (1, NULL). Después compruébenlas enpsqlcon\pset null '∅'. - Una consulta devuelve
count(*) = 1800ycount(phone) = 1541sobrecustomer. ¿Cuántas filas devuelveSELECT * FROM customer WHERE phone = NULL? ¿YSELECT count(*) FROM customer WHERE phone = NULL? Expliquen por qué la segunda devuelve una fila aunque la primera no devuelva ninguna. - Escriban la consulta de los envíos “que no valen más de 500” de forma que incluya los que no declararon valor. Comprueben que devuelve 12 000 − 6039 filas.
- Sean r = {a, a, a, b, c} y s = {a, b, b, d} dos multiconjuntos de una
columna. Calculen a mano r
UNION ALLs, rINTERSECT ALLs, rEXCEPT ALLs y sEXCEPT ALLr, y verifíquenlo conVALUES. - Ingresos por agencia de destino, con el nombre de la agencia, de mayor a
menor, incluyendo una columna con los ingresos de los envíos ya entregados
(con
FILTER). ¿Qué agencia está primera? - La tabla
triptiene 5914 viajes. Escriban, para cada vehículo, cuántos viajes hizo y cuántos todavía no llegan. Después, solo los vehículos con algún viaje sin llegar. ¿La condición va enWHEREo enHAVING? Hay dos formas correctas de escribirla, una con cada cláusula; den las dos. - ¿Por qué esta consulta da un error? Corríjanla sin cambiar lo que
pregunta:
SELECT origin_agency_id, status, count(*) FROM shipment GROUP BY origin_agency_id HAVING count(*) > 100; - Los clientes que nunca enviaron nada, de tres formas:
NOT IN,NOT EXISTSyEXCEPT. ¿Hay riesgo de la trampa delNULLconNOT INen este caso? Miren la definición deshipment.sender_iden el esquema. - Los envíos cuyo valor declarado es mayor que el de todos los envíos que
salieron de Tumbes - Centro (agencia 10). Escríbanla con
> ALLy con> (SELECT max(...)). ¿Dan lo mismo? ¿Por qué? Pista: hay envíos de Tumbes sin valor declarado. - Con
NOT EXISTS, los vehículos que han hecho viajes por todas las rutas que salen de Lima (agency.city = 'Lima'). ¿Cuántos son? Verifiquen el resultado contando, para cada vehículo, cuántas rutas distintas de Lima recorrió. ¿Qué devuelve la consulta conNOT EXISTSsi se pregunta por las rutas que salen de una ciudad sin agencias? - Con
WITH, el peso promedio de los envíos de cada ruta y, para cada ruta, el envío más pesado. Hagan una versión conLATERALy comparen. - Dentro de
BEGIN;…ROLLBACK;: inserten el cliente 1801 y su envío 12001 como en la sección deINSERT, y un eventoreceivedpara ese envío. Después borren al cliente con todo lo suyo: sus eventos, sus envíos y el cliente. ¿En qué orden tienen que ir las tres sentenciasDELETE? ¿Qué pasa si intentan borrar primero al cliente? Copien el mensaje de error.