
Apuntes · Capítulo 2Modelo relacional y SQL
Álgebra relacional y SQL básico
Álgebra relacional y SQL básico
La semana pasada definimos qué es una relación: un conjunto de tuplas sobre un
esquema, con atributos que toman valores de un dominio, y con claves que
identifican a cada tupla. Vimos el esquema de Chasqui, la empresa de
encomiendas que nos acompaña todo el semestre, y comprobamos con psql que
sus tablas existen y tienen datos. Lo que no hicimos es preguntarle algo
interesante a la base de datos. Ese es el tema de esta semana.
El capítulo tiene dos partes. En la primera estudiamos el álgebra
relacional, un lenguaje pequeño y formal en el que cada operación recibe
relaciones y devuelve una relación. No es un lenguaje que se escriba en el
trabajo diario, pero es el modelo con el que el motor de base de datos piensa
las consultas: cuando PostgreSQL recibe una consulta, la traduce a algo muy
parecido a una expresión del álgebra y la reescribe hasta encontrar una forma
barata de evaluarla. En la segunda parte pasamos a SQL: definimos tablas
con CREATE TABLE y escribimos las primeras consultas SELECT-FROM-WHERE.
En todo el camino vamos a traducir del álgebra a SQL y a mirar con cuidado la
única diferencia de fondo entre los dos: el álgebra trabaja con conjuntos y SQL
con multiconjuntos.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “Lenguajes de consulta” y, de “Las operaciones fundamentales”, “Selección σ” y “Proyección Π”. Sesión B: “SQL: el lenguaje” y “La estructura básica de una consulta”.
- En clase. Sesión A: “Las operaciones fundamentales” y “Consultas equivalentes”. Sesión B: “Definición de datos”, “La estructura básica de una consulta”, “Operaciones básicas adicionales” y “Del álgebra a SQL”.
- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 2.5–2.6 y 3.1–3.4; el capítulo 27 en línea (cálculo relacional), opcional. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-02, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
Todas las salidas de este capítulo salen de la base de datos chasqui_w02,
una copia de chasqui que crea make en la carpeta de la semana. Si quieren
seguir los ejemplos, entren con psql chasqui_w02 y carguen los archivos con
\i algebra.sql o \i basics.sql.
Lenguajes de consulta
Un lenguaje de consulta (query language) es el lenguaje con el que un usuario le pide información a la base de datos. Silberschatz los clasifica en dos grupos:
- En un lenguaje procedimental, el usuario indica la secuencia de operaciones que hay que hacer sobre los datos para obtener el resultado: “toma la tabla de agencias, quédate con las de Puno, y de esas, solo el nombre”.
- En un lenguaje declarativo (o no procedimental), el usuario describe qué información quiere, sin decir cómo obtenerla: “los nombres de las agencias de Puno”. El sistema decide el cómo.
El álgebra relacional es procedimental. El cálculo relacional de tuplas y el de dominios, que el libro presenta en el capítulo 27 en línea, son declarativos. SQL es, ante todo, declarativo, aunque toma ideas de los dos. Un programador escribe SQL; el motor lo traduce a operaciones del álgebra (o a una versión extendida de ella) y elige en qué orden ejecutarlas. Por eso conviene conocer el álgebra aunque nunca se escriba en un programa: es el idioma del procesador de consultas, que estudiaremos en las semanas 11 y 12.
Idea clave. Cada operación del álgebra recibe una o dos relaciones y devuelve una relación. Como el resultado es otra vez una relación, se le puede aplicar otra operación. A esta propiedad se le llama clausura, y es la que permite armar consultas grandes componiendo operaciones pequeñas.
Notación
Usamos la notación de Silberschatz. Una relación se escribe con su nombre en
minúscula (agency, route); su esquema, cuando hace falta, en mayúscula
(R, S). Las operaciones son:
| Operación | Símbolo | Tipo |
|---|---|---|
| Selección (selection) | σ | unaria |
| Proyección (projection) | Π | unaria |
| Renombramiento (rename) | ρ | unaria |
| Unión | ∪ | binaria |
| Diferencia de conjuntos | − | binaria |
| Producto cartesiano (Cartesian product) | × | binaria |
| Intersección | ∩ | binaria |
| Join, natural join | ⋈θ, ⋈ | binaria |
| Asignación | ← | (para escribir en pasos) |
Los parámetros de una operación van como subíndice: σregion = ‘Puno’(agency). En los predicados usamos las comparaciones =, ≠, <, ≤, >, ≥ y los conectivos ∧ (y), ∨ (o) y ¬ (no).
En todo el capítulo suponemos que en el álgebra no hay valores nulos. Cuando
un atributo de SQL vale NULL, una comparación con él no es verdadera, y la
fila no pasa un filtro; las reglas completas (la lógica de tres valores) son
tema de la semana 3. Aquí aparece un solo caso, en el join por trip_id.
Las operaciones fundamentales
Selección σ
La selección se queda con las tuplas de una relación que cumplen un predicado P:
σP(r) = { t | t ∈ r ∧ P(t) }
El resultado tiene el mismo esquema que r y a lo más tantas tuplas como r. El predicado puede comparar un atributo con una constante o dos atributos entre sí, y combinar comparaciones con ∧, ∨ y ¬. Los buses con capacidad de más de 5000 kg:
σkind = ‘bus’ ∧ capacity_kg > 5000(vehicle)
En SQL, la selección es la cláusula WHERE
(algebra.sql, A1):
SELECT *
FROM vehicle
WHERE kind = 'bus' AND capacity_kg > 5000
ORDER BY vehicle_id;
vehicle_id | plate | kind | capacity_kg
------------+---------+------+-------------
4 | R5D-706 | bus | 5500
7 | L8P-227 | bus | 5100
8 | F4K-555 | bus | 5900
(3 rows)Dos propiedades se usan todo el tiempo. Una selección con una conjunción se puede partir en dos selecciones seguidas (cascada), y dos selecciones seguidas se pueden aplicar en cualquier orden:
σP₁ ∧ P₂(r) = σP₁(σP₂(r)) = σP₂(σP₁(r))
La prueba selección: σ a∧b (r) = σ a (σ b (r)) de
algebra.test.mjs lo comprueba con este
mismo ejemplo.
Proyección Π
La proyección se queda con algunos atributos de cada tupla. Si A₁, …, Aₖ son atributos de r:
ΠA₁, …, Aₖ(r) = { t[A₁, …, Aₖ] | t ∈ r }
donde t[A₁, …, Aₖ] es la tupla t restringida a esos atributos. Lo delicado es que el resultado es un conjunto, así que si dos tuplas de r coinciden en A₁, …, Aₖ, en el resultado aparecen una sola vez. Las ciudades donde viven los clientes de Chasqui:
Πcity(customer)
customer tiene 1800 tuplas, pero solo hay 26 ciudades distintas, así que la
proyección tiene 26 tuplas. Para obtener lo mismo en SQL hay que pedir
DISTINCT (A2):
SELECT DISTINCT city
FROM customer
ORDER BY city;
city
------------------
Abancay
Arequipa
Ayacucho
Cajamarca
Cerro de Pasco
...
Trujillo
Tumbes
(26 rows)(Aquí recortamos la salida; \i algebra.sql la muestra completa.) Volveremos
sobre esta diferencia en la sección de SQL: sin DISTINCT, SELECT city FROM customer devuelve las 1800 filas.
Dos observaciones:
- |ΠA(r)| ≤ |r|. Si los atributos proyectados contienen una
superclave de r, no hay duplicados que eliminar y |ΠA(r)| = |r|.
Πcustomer_id, city(customer) tiene 1800 tuplas porque
customer_ides clave. - Silberschatz permite también expresiones aritméticas en la lista de la
proyección, como Πshipment_id, price · 1.18(shipment). Es lo que
en SQL se escribe
SELECT shipment_id, price * 1.18.
Composición
Como cada operación devuelve una relación, se pueden anidar. Los nombres de las agencias de la región Puno:
Πname(σregion = ‘Puno’(agency))
Se lee de adentro hacia afuera: primero la selección deja las agencias de Puno, después la proyección se queda con su nombre (A3):
SELECT name
FROM agency
WHERE region = 'Puno'
ORDER BY name;
name
------------------
Juliaca - Centro
Puno - Centro
(2 rows)Error común. Proyectar demasiado pronto. En Πname(agency) ya no existe el atributo
city, así que σcity = ‘Cusco’(Πname(agency)) no tiene sentido: la selección pide un atributo que no está en el esquema de su argumento. Primero se selecciona y después se proyecta. SQL da el mismo error si se escribe así, con la proyección en una subconsulta (errors.sql, E1):ERROR: column "city" does not exist LINE 3: WHERE city = 'Cusco'; ^
Proyectar antes sí es válido si se conservan los atributos que la selección necesita: Πname(σregion = ‘Puno’(Πname, region(agency))) da el mismo resultado que la expresión original. Esta reescritura parece inútil, pero es la que hace el motor para no arrastrar columnas que nadie va a usar.
Producto cartesiano ×
El producto cartesiano combina cada tupla de r con cada tupla de s:
r × s = { t q | t ∈ r ∧ q ∈ s }
donde t q es la tupla que tiene los valores de t seguidos de los de q.
El esquema del resultado es la concatenación de los dos esquemas. Si un nombre
de atributo aparece en los dos, se distingue con el nombre de la relación:
en route × agency hay un route.route_id y un agency.agency_id; en
shipment × route habría un shipment.origin_agency_id y un
route.origin_agency_id.
El tamaño es el producto de los tamaños: |r × s| = |r| · |s|. Chasqui tiene 29 agencias y 24 vehículos (A4):
SELECT (SELECT count(*) FROM agency)       AS agencias,
       (SELECT count(*) FROM vehicle)      AS vehiculos,
       (SELECT count(*) FROM agency, vehicle) AS producto;
agencias | vehiculos | producto
----------+-----------+----------
29 | 24 | 696
(1 row)Un producto pequeño se puede mirar entero. Las dos agencias de Puno por las seis vans:
Πname, plate(σregion = ‘Puno’(agency) × σkind = ‘van’(vehicle))
       name       |  plate
------------------+---------
 Juliaca - Centro | C4J-431
 Juliaca - Centro | F6J-635
 Juliaca - Centro | K2U-314
 Juliaca - Centro | K8J-523
 Juliaca - Centro | T5E-356
 Juliaca - Centro | W6X-229
 Puno - Centro    | C4J-431
 Puno - Centro    | F6J-635
 Puno - Centro    | K2U-314
 Puno - Centro    | K8J-523
 Puno - Centro    | T5E-356
 Puno - Centro    | W6X-229
(12 rows)
Son 2 · 6 = 12 tuplas, y ninguna dice nada útil: la van C4J-431 no tiene nada que ver con la agencia de Juliaca. Eso pasa casi siempre. shipment × customer empareja cada envío con todos los clientes, no con su remitente. El producto solo es útil seguido de una selección que se quede con las parejas que tienen sentido, y esa combinación tiene nombre propio.
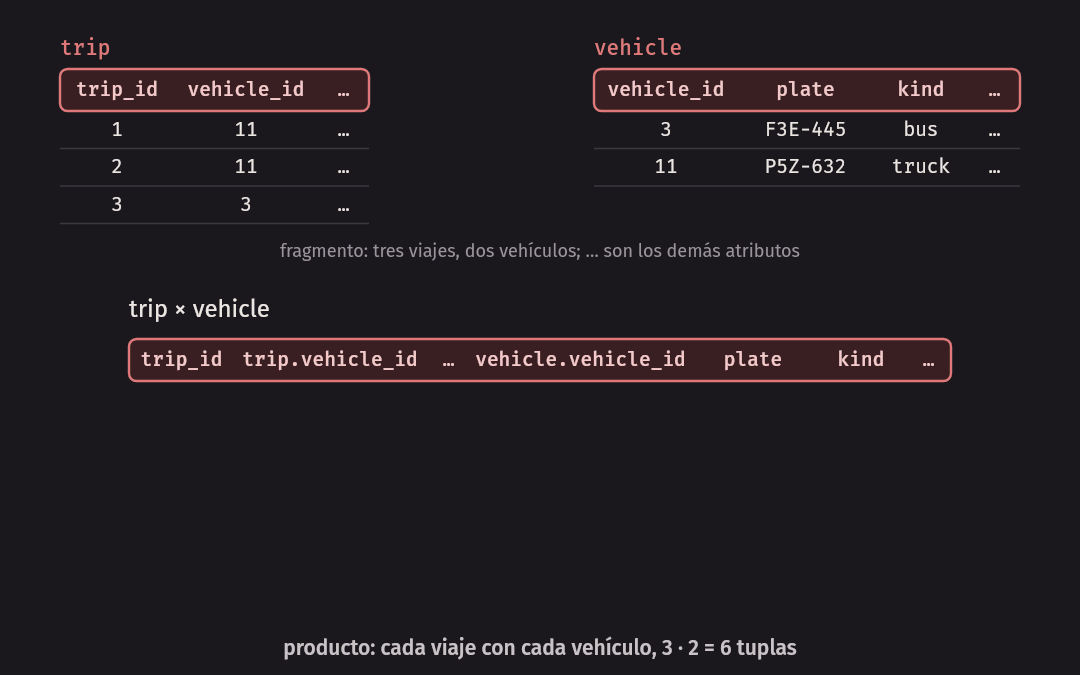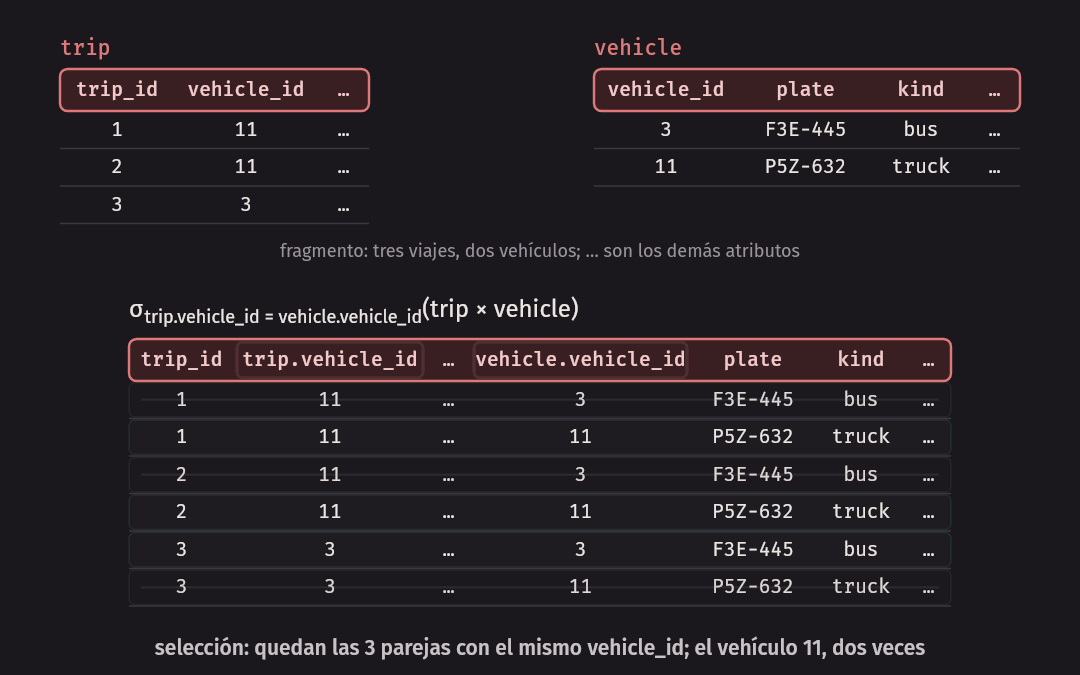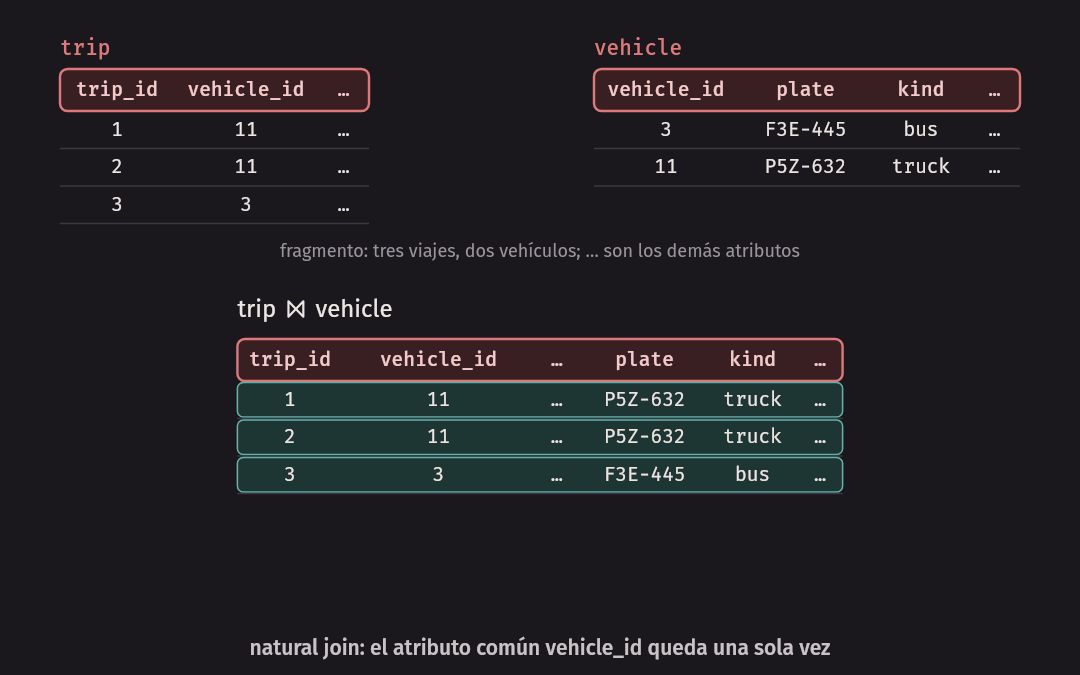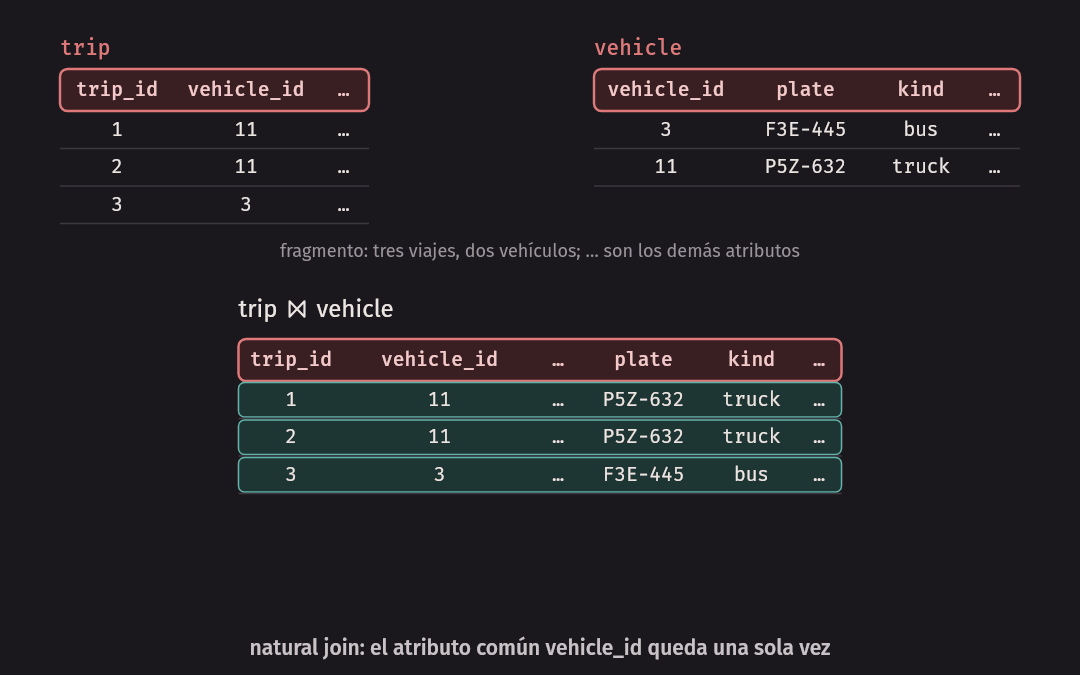
Join θ
El join θ (theta join) es un producto cartesiano seguido de una selección:
r ⋈θ s = σθ(r × s)
donde θ es un predicado sobre los atributos de r y s. Cuando θ es una conjunción de igualdades, se habla de equi-join. Los envíos con el nombre de su remitente:
shipment ⋈sender_id = customer_id customer
De esos, los cinco más pesados de los que pasan de 140 kg (A5):
SELECT s.shipment_id, c.first_name, c.last_name, s.weight_kg
FROM shipment AS s, customer AS c
WHERE s.sender_id = c.customer_id
  AND s.weight_kg > 140
ORDER BY s.weight_kg DESC, s.shipment_id
LIMIT 5;
shipment_id | first_name | last_name | weight_kg
-------------+------------+--------------------+-----------
10499 | Luz | Huamán Sánchez | 148.30
9365 | Ximena | Chávez Gutiérrez | 146.90
3690 | Luz | Yupanqui Sánchez | 146.60
10818 | Piero | Villanueva Ramírez | 146.50
5574 | Luz | Cáceres Vásquez | 146.40
(5 rows)(Sin el LIMIT son 35 envíos.) Con 12000 envíos y 1800 clientes, el producto
tiene 21 600 000 tuplas y el join θ, solo 12000 (A5b):
 producto | join_theta
----------+------------
 21600000 |      12000
(1 row)
¿Por qué exactamente 12000? En general, |r ⋈θ s| puede ir desde 0
hasta |r| · |s|. Pero aquí se cumplen tres cosas: sender_id es NOT NULL,
es clave foránea hacia customer y customer_id es la clave primaria de
customer. La clave foránea y el NOT NULL garantizan que cada envío
encuentra al menos un cliente; la clave primaria garantiza que encuentra a
lo más uno. Entonces cada envío aparece exactamente una vez en el join.
Si falta una de las tres condiciones, el argumento se cae. shipment.trip_id
también es clave foránea, pero admite NULL: un envío registrado que todavía
no sube a un viaje no tiene trip_id. En el join por trip_id, esos envíos
no encuentran pareja (A5c):
 envios | con_viaje | sin_viaje
--------+-----------+-----------
  12000 |     11500 |       500
(1 row)
En PostgreSQL. Lo que aquí escribimos como
FROM shipment AS s, customer AS c WHERE s.sender_id = c.customer_idse puede escribir también comoFROM shipment AS s JOIN customer AS c ON s.sender_id = c.customer_id. Las dos formas son equivalentes para un inner join (la pruebajoin θ: r ⋈θ s = σθ (r × s)lo verifica con las 12000 tuplas), y PostgreSQL no calcula el producto en ninguna de las dos: el optimizador reconoce la condición de join y usa un algoritmo de join. La sintaxisJOIN ... ONes tema de la semana 4; esta semana usamos la forma con coma, que es la de Silberschatz en el capítulo 3.
Natural join
El natural join iguala, sin que haya que nombrarlos, todos los atributos que tienen el mismo nombre en las dos relaciones, y deja cada uno una sola vez. Si R ∩ S = {A₁, …, Aₙ}:
r ⋈ s = ΠR ∪ S(σr.A₁ = s.A₁ ∧ … ∧ r.Aₙ = s.Aₙ(r × s))
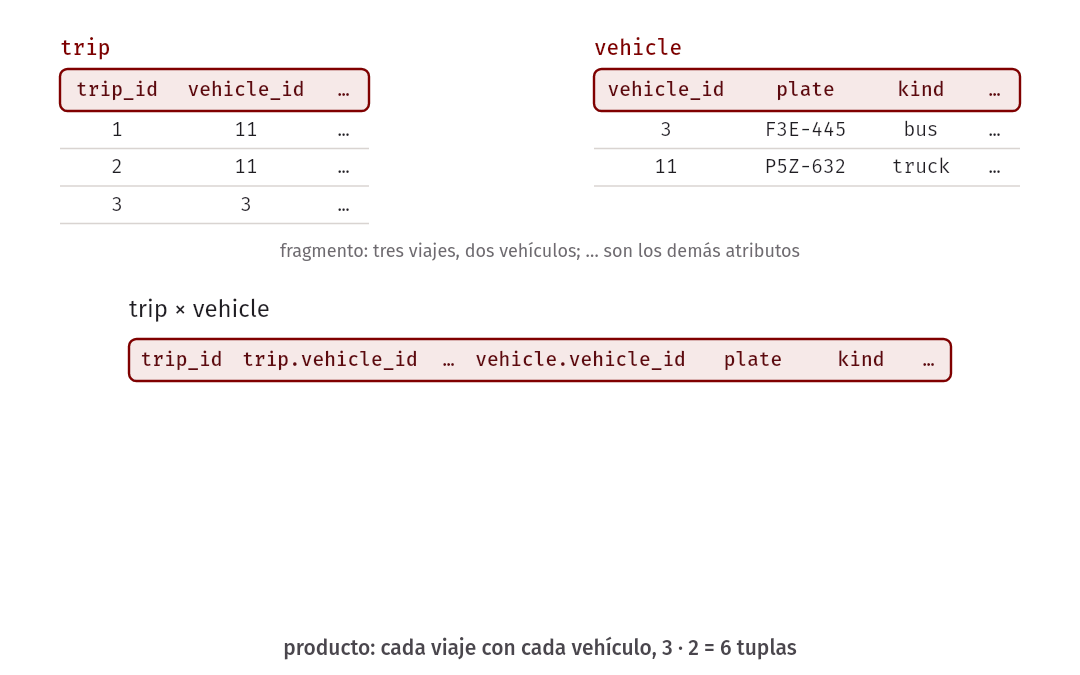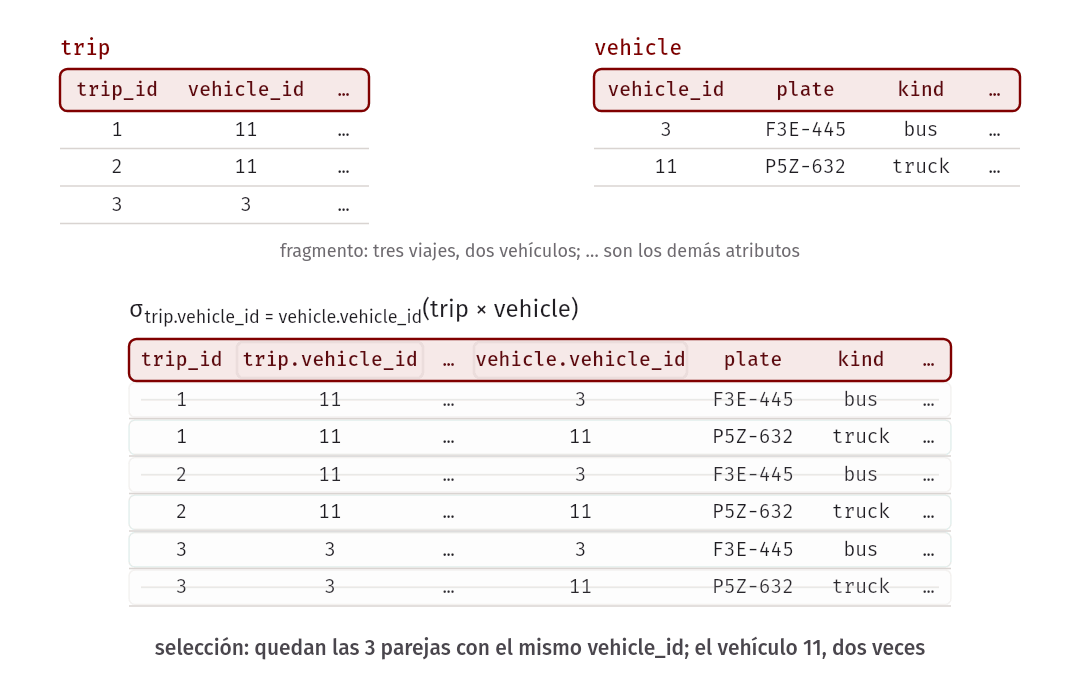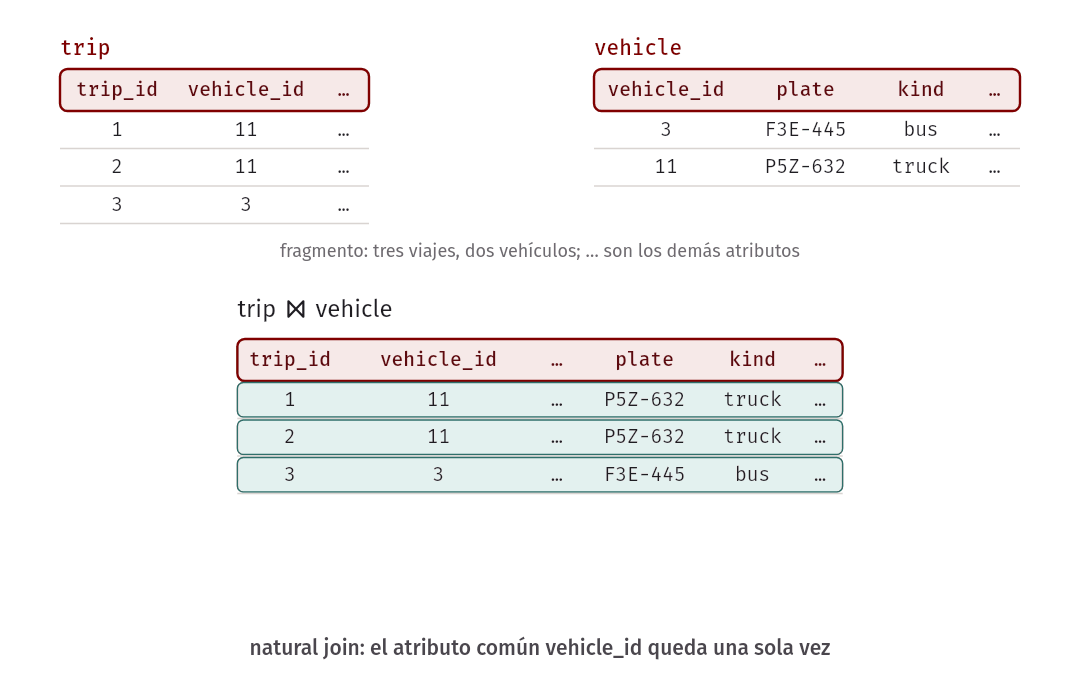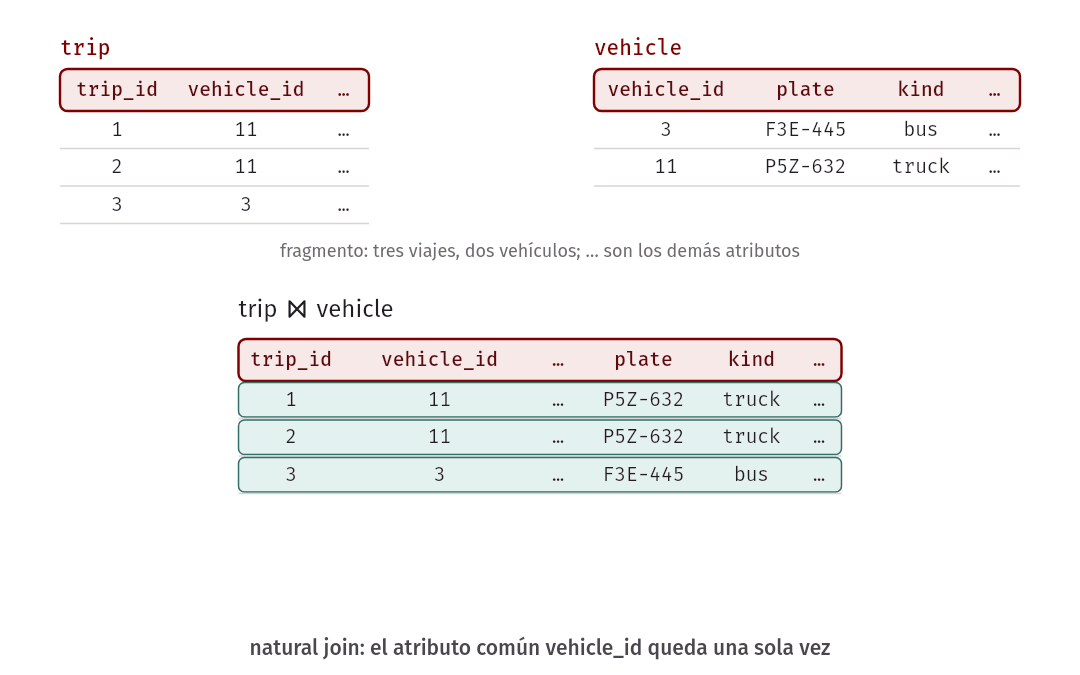
trip y vehicle comparten un solo nombre, vehicle_id, así que
trip ⋈ vehicle es cada viaje con los datos de su vehículo (A6):
SELECT t.trip_id, t.vehicle_id, v.plate, v.kind
FROM trip AS t, vehicle AS v
WHERE t.vehicle_id = v.vehicle_id
ORDER BY t.trip_id
LIMIT 3;
trip_id | vehicle_id | plate | kind
---------+------------+---------+-------
1 | 11 | P5Z-632 | truck
2 | 11 | P5Z-632 | truck
3 | 3 | F3E-445 | bus
(3 rows)Por el mismo argumento de antes, trip ⋈ vehicle tiene exactamente |trip| = 5914 tuplas.
El natural join es cómodo en el pizarrón y peligroso en un esquema real, porque depende de los nombres de los atributos, no de su significado:
customeryagencycomparten el atributocity. customer ⋈ agency empareja cada cliente con cada agencia de su ciudad, y da 3433 tuplas (A6b). Nadie pidió eso.shipmentyroutecompartenorigin_agency_idydest_agency_id. shipment ⋈ route empareja cada envío con la ruta que une sus dos agencias, aunque el envío haya viajado por otro camino.routeyagencyno comparten ningún nombre (la clave de agencia se llamaagency_iden una yorigin_agency_iden la otra). Sin atributos comunes, la conjunción del predicado es vacía y el natural join es el producto cartesiano (A6c):
 natural_join | producto
--------------+----------
         3480 |     3480
(1 row)
Por eso, en este capítulo, cuando juntamos route con agency escribimos
siempre el join θ con la condición explícita, route ⋈origin_agency_id = agency_id agency.
La forma NATURAL JOIN de SQL y sus riesgos se discuten a fondo en la semana 4.
Idea clave. Los joins de esta semana son inner joins: una tupla sin pareja en la otra relación desaparece del resultado, como los 500 envíos sin viaje. Los outer joins, que conservan esas tuplas rellenando con nulos, son otra variante del join; también se ven en la semana 4.
Unión, diferencia e intersección
Las relaciones son conjuntos, así que las operaciones de conjuntos tienen sentido sobre ellas, con una condición. Dos relaciones r y s son compatibles (union-compatible) si:
- tienen la misma aridad (el mismo número de atributos), y
- para cada i, el dominio del i-ésimo atributo de r es el mismo (o es compatible) que el del i-ésimo atributo de s.
Si son compatibles:
- r ∪ s = { t | t ∈ r ∨ t ∈ s }
- r − s = { t | t ∈ r ∧ t ∉ s }
- r ∩ s = { t | t ∈ r ∧ t ∈ s }
El resultado toma los nombres de atributo de r. Casi siempre los argumentos son proyecciones, para que queden compatibles. Los clientes que enviaron o recibieron algún paquete:
Πsender_id(shipment) ∪ Πrecipient_id(shipment)
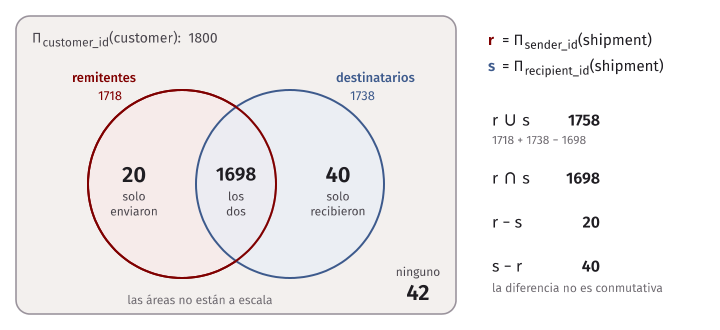
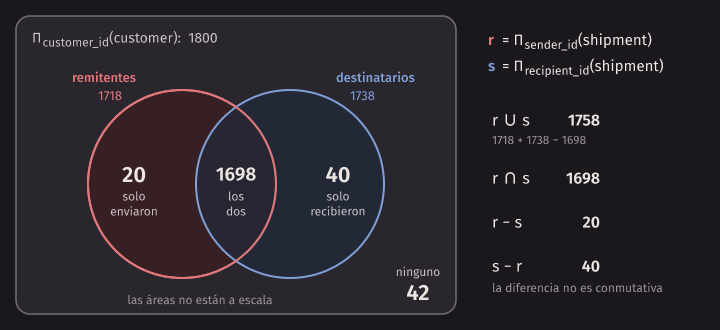
En SQL, ∪ es UNION (A7). El resultado tiene 1758 tuplas. Hay 1718
remitentes distintos y 1738 destinatarios distintos; la unión no da la suma
porque 1698 clientes están en los dos lados, y |r ∪ s| = |r| + |s| − |r ∩ s|
= 1718 + 1738 − 1698 = 1758. La intersección es INTERSECT (A9).
La diferencia responde preguntas del tipo “los que tienen esto pero no aquello”. Las agencias desde las que no sale ninguna ruta:
Πagency_id(agency) − Πorigin_agency_id(route)
En SQL es EXCEPT (A8):
SELECT agency_id FROM agency
EXCEPT
SELECT origin_agency_id FROM route
ORDER BY agency_id;
agency_id
-----------
29
(1 row)Es la agencia de Iquitos, que en los datos de Chasqui no tiene rutas: a Iquitos no se llega por carretera.
Una diferencia también puede ser vacía, y eso es un resultado tan válido como cualquier otro: la relación vacía. Las agencias que son origen de alguna ruta pero nunca destino (A8b):
Πorigin_agency_id(route) − Πdest_agency_id(route)
 origin_agency_id
------------------
(0 rows)
No hay ninguna, porque en Chasqui cada ruta tiene su ruta de vuelta (lo comprobamos más abajo con ρ). Una consulta que devuelve cero filas no es una consulta equivocada; puede ser la respuesta correcta.
A diferencia de ∪ y ∩, la diferencia no es conmutativa. Los remitentes que nunca recibieron un envío, Πsender_id(shipment) − Πrecipient_id(shipment), son 20 (A8c); los destinatarios que nunca enviaron, la diferencia al revés, son 40. Y se pueden combinar: los clientes que no aparecen en ningún envío, ni como remitente ni como destinatario, son 42 (A8d):
Πcustomer_id(customer) − (Πsender_id(shipment) ∪ Πrecipient_id(shipment))
Si las relaciones no son compatibles, la operación no está definida. Πagency_id(agency) ∪ Πname(agency) mezcla enteros con textos, y PostgreSQL la rechaza (E2):
ERROR:  UNION types integer and text cannot be matched
LINE 3: SELECT name FROM agency;
               ^
La compatibilidad mira solo aridades y dominios, no el significado. Πagency_id(agency) ∪ Πvehicle_id(vehicle) es una unión válida de dos conjuntos de enteros, y no significa nada. Que la expresión esté bien formada no la hace una buena consulta.
Renombramiento ρ
Los resultados de las expresiones del álgebra no tienen nombre. El renombramiento les pone uno:
- ρx(E) devuelve el resultado de E con el nombre x.
- ρx(A₁, …, Aₙ)(E) además renombra sus atributos como A₁, …, Aₙ.
Una relación también es una expresión, así que ρ sirve para tener dos copias de la misma relación con nombres distintos. Eso es indispensable cuando una consulta compara una tupla con otra de la misma relación. Las rutas que tienen su ruta de vuelta:
ρr1(route) ⋈r1.origin_agency_id = r2.dest_agency_id ∧ r1.dest_agency_id = r2.origin_agency_id ρr2(route)
Sin ρ no hay forma de escribir la condición: route.origin_agency_id =
route.dest_agency_id compara dos atributos de la misma tupla, que es otra
pregunta (y su respuesta es vacía, porque una restricción CHECK de route lo
prohíbe). En SQL, ρ es el alias de tabla (A10):
SELECT count(*) AS pares_ordenados
FROM route AS r1, route AS r2
WHERE r1.origin_agency_id = r2.dest_agency_id
  AND r1.dest_agency_id = r2.origin_agency_id;
pares_ordenados
-----------------
120
(1 row)Salen las 120 rutas: todas tienen su vuelta. Pero cada par aparece dos veces, una con la ida como r1 y otra con la vuelta como r1. Para ver cada par una sola vez se agrega r1.route_id < r2.route_id al predicado (A10b), y quedan 60:
 ida | vuelta | origin_agency_id | dest_agency_id
-----+--------+------------------+----------------
   1 |      2 |                1 |              7
   3 |      4 |                1 |             11
   5 |      6 |                2 |             11
   7 |      8 |                1 |             12
   9 |     10 |                2 |             12
(5 rows)
(Las cinco primeras; el LIMIT 5 de A10b recorta.)
Asignación ←
Una consulta larga se lee mejor por partes. La asignación x ← E guarda el resultado de E en una variable de relación temporal x, que se puede usar en las expresiones siguientes. No modifica la base de datos. Las rutas que unen dos agencias de la misma región:
o ← ρo(agency)
d ← ρd(agency)
ro ← route ⋈route.origin_agency_id = o.agency_id o
Πroute_id, o.name, d.name, distance_km(σo.region = d.region(ro ⋈route.dest_agency_id = d.agency_id d))
Aquí ρ vuelve a ser indispensable: cada ruta necesita dos agencias, la de
origen y la de destino, y las dos salen de la misma relación. La traducción a
SQL junta los pasos en una sola consulta con dos alias de agency (A11):
SELECT r.route_id, o.name AS origen, d.name AS destino, r.distance_km
FROM route AS r, agency AS o, agency AS d
WHERE r.origin_agency_id = o.agency_id
  AND r.dest_agency_id = d.agency_id
  AND o.region = d.region
ORDER BY r.route_id;
route_id | origen | destino | distance_km
----------+---------------------------+---------------------------+-------------
65 | Chimbote - Centro | Huaraz - Centro | 82
66 | Huaraz - Centro | Chimbote - Centro | 82
103 | Juliaca - Centro | Puno - Centro | 60
104 | Puno - Centro | Juliaca - Centro | 60
113 | Lima - La Victoria | Lima - Los Olivos | 22
114 | Lima - La Victoria | Lima - Ate | 22
115 | Lima - Los Olivos | Lima - La Victoria | 22
116 | Lima - Los Olivos | Lima - Ate | 31
117 | Lima - Ate | Lima - La Victoria | 22
118 | Lima - Ate | Lima - Los Olivos | 31
119 | Arequipa - Centro | Arequipa - Cerro Colorado | 18
120 | Arequipa - Cerro Colorado | Arequipa - Centro | 18
(12 rows)SQL también tiene una forma de escribir en pasos con nombre, la cláusula
WITH, que se ve en la semana 3. La prueba asignación de
algebra.test.mjs ya la usa para
comprobar que la versión en pasos da las mismas 12 rutas.
Operaciones fundamentales y derivadas
No todas las operaciones son necesarias. Silberschatz define una expresión del álgebra relacional así: una relación de la base de datos (o una relación constante) es una expresión; y si E₁ y E₂ son expresiones, también lo son σP(E₁), ΠS(E₁), ρx(E₁), E₁ ∪ E₂, E₁ − E₂ y E₁ × E₂. Esas seis son las operaciones fundamentales. Las demás se expresan con ellas:
- r ∩ s = r − (r − s)
- r ⋈θ s = σθ(r × s)
- el natural join, con ×, σ y Π, como vimos
- la asignación no agrega poder: se puede reemplazar cada variable por la expresión que guarda.
Agregan comodidad, no poder expresivo. La identidad de la intersección se
puede comprobar en SQL con dos EXCEPT (A9b): da los mismos 1698 clientes que
INTERSECT, y la prueba intersección: r ∩ s = r − (r − s) compara las dos
listas completas.
Consultas equivalentes
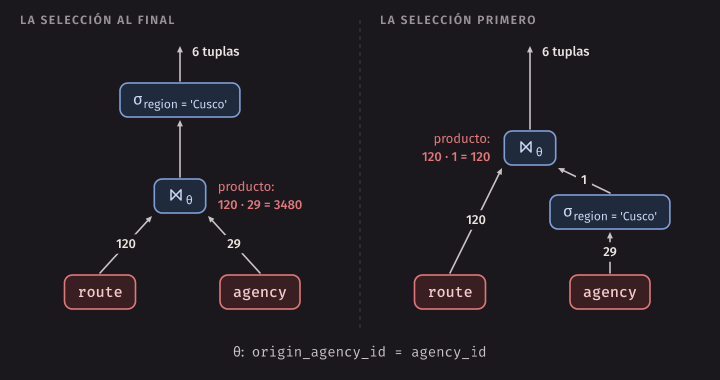
Dos expresiones del álgebra son equivalentes si dan el mismo resultado en toda instancia de la base de datos, no solo en la de hoy. Las rutas que salen de la región Cusco se pueden pedir de dos maneras, con θ: origin_agency_id = agency_id:
σregion = ‘Cusco’(route ⋈θ agency)
route ⋈θ σregion = ‘Cusco’(agency)
La primera junta todas las rutas con todas las agencias y al final filtra; la
segunda filtra primero las agencias y solo después junta. Son equivalentes
porque el predicado region = 'Cusco' usa solo atributos de agency: da lo
mismo aplicarlo antes o después de combinar. Las dos devuelven las mismas seis
rutas (A12):
 route_id | dest_agency_id | distance_km
----------+----------------+-------------
       44 |              1 |         668
       46 |              2 |         673
       86 |             17 |         121
      100 |              4 |         351
      106 |             19 |         221
      109 |             28 |         338
(6 rows)
Pero no cuestan lo mismo. Si se evaluaran tal como están escritas, la primera arma un producto de 120 · 29 tuplas antes de filtrar, y la segunda, uno de 120 · 1, porque en Cusco hay una sola agencia (A12b):
 tuplas_antes_de_sigma | tuplas_con_sigma_adentro
-----------------------+--------------------------
                  3480 |                      120
(1 row)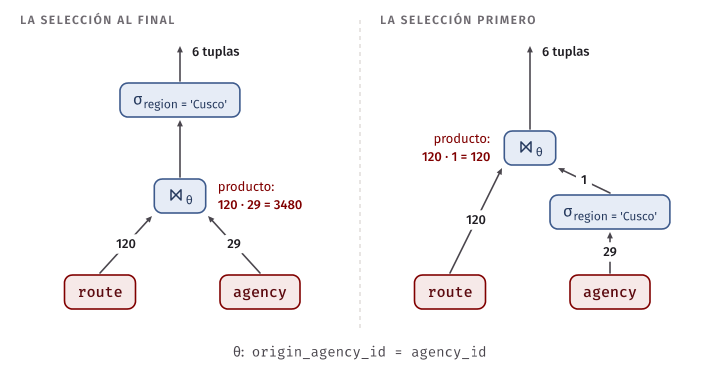
Esta es la idea sobre la que se construye el optimizador de consultas (query optimizer): generar expresiones equivalentes a la que pidió el usuario y elegir la más barata. Las reglas más usadas, todas sobre conjuntos:
| Regla | Equivalencia |
|---|---|
| Cascada de σ | σP₁ ∧ P₂(E) = σP₁(σP₂(E)) |
| σ es conmutativa | σP₁(σP₂(E)) = σP₂(σP₁(E)) |
| Cascada de Π | ΠL₁(ΠL₂(E)) = ΠL₁(E), si L₁ ⊆ L₂ |
| σ y join θ | σθ₁(E₁ ⋈θ₂ E₂) = E₁ ⋈θ₁ ∧ θ₂ E₂ |
| Empujar σ hacia un lado | σP(E₁ ⋈θ E₂) = σP(E₁) ⋈θ E₂, si P usa solo atributos de E₁ |
| ∪ y ∩ conmutativas | E₁ ∪ E₂ = E₂ ∪ E₁, E₁ ∩ E₂ = E₂ ∩ E₁ |
| Join θ conmutativo | E₁ ⋈θ E₂ = E₂ ⋈θ E₁ (salvo el orden de los atributos) |
Y dos cosas que no son equivalencias: r − s ≠ s − r (lo vimos con los 20 y los 40 clientes), y Π no se puede mover por encima de una σ que use un atributo que la proyección elimina (el error de proyectar demasiado pronto).
En PostgreSQL. Uno escribe SQL sin preocuparse de dónde va cada filtro: el optimizador de PostgreSQL aplica reglas como estas por su cuenta, entre muchas otras, y estima el costo de cada alternativa. Cómo lo hace, y cómo ver el plan que eligió con
EXPLAIN, es tema de las semanas 11 y 12.
Error común. Pensar que dos consultas son equivalentes porque hoy devuelven lo mismo. Πorigin_agency_id(route) y Πdest_agency_id(route) son iguales en los datos de Chasqui (por eso la diferencia dio vacía), pero basta registrar una ruta nueva sin su vuelta para que dejen de serlo. La equivalencia es una propiedad de las expresiones, válida para cualquier instancia.
SQL: el lenguaje
SQL nació en IBM a comienzos de los años setenta, como parte del proyecto System R, con el nombre de Sequel. Hoy es un estándar ISO con muchas revisiones, y cada motor implementa un dialecto: casi todo el estándar básico, algo del avanzado y extensiones propias. En el curso usamos el de PostgreSQL 18, y cuando algo no es del estándar lo decimos.
SQL tiene varias partes:
- DDL (data definition language): definir, modificar y borrar esquemas de relaciones; incluye las restricciones de integridad.
- DML (data manipulation language): consultar, insertar, borrar y modificar tuplas.
- Restricciones de integridad: las reglas que los datos deben cumplir; el motor rechaza las modificaciones que las violan.
- Vistas, control de transacciones y autorización (quién puede leer o modificar qué).
- SQL embebido y dinámico: cómo se usa SQL desde un lenguaje de programación, como nuestros scripts de Node.js.
Definición de datos
Tipos básicos
Cada atributo tiene un dominio, que en SQL es un tipo. Los que usamos en Chasqui:
| Tipo | Qué guarda | En Chasqui |
|---|---|---|
integer (o int) |
entero de 4 bytes | agency_id, capacity_kg |
bigint |
entero de 8 bytes | (para contadores muy grandes) |
numeric(p, d) |
decimal exacto: p dígitos, d después del punto | price numeric(8, 2) |
char(n) |
texto de largo fijo n | dni char(8) |
varchar(n) |
texto de largo variable, a lo más n | |
text |
texto sin límite (de PostgreSQL, no estándar) | name, city |
date |
una fecha | |
timestamptz |
un instante, con zona horaria | created_at |
boolean |
verdadero o falso |
numeric(8, 2) admite hasta 999 999,99: ocho dígitos en total, dos de ellos
decimales. En PostgreSQL, text y varchar sin largo se guardan igual; el
largo de varchar(n) es una restricción, no una optimización. Silberschatz usa
varchar(n) porque es el estándar; en Chasqui usamos text salvo que el
largo sea una regla del negocio.
Error común. Guardar dinero en
realodouble precision. Son números binarios de punto flotante: 0,1 no tiene representación exacta en binario, así que las sumas acumulan errores pequeños. Enbasics.sql(B2 y B2b):con_double | con_numeric ------------+------------- f | t (1 row) suma_double | suma_numeric ---------------------+-------------- 0.30000000000000004 | 0.3 (1 row)Para
price,base_farey cualquier monto se usanumeric. Los tipos de punto flotante sirven para medidas físicas, donde un error en el décimo sexto dígito no le importa a nadie.
CREATE TABLE
CREATE TABLE define una relación: su nombre, sus atributos con sus tipos y
sus restricciones. La forma general es
CREATE TABLE r (
  A1 D1,
  A2 D2,
  ...,
  An Dn,
  restricción_1,
  ...,
  restricción_k
);
Las restricciones básicas son tres:
NOT NULLen un atributo prohíbe el valor nulo en él.PRIMARY KEY (A1, …, Am)declara la clave primaria. Sus atributos son automáticamenteNOT NULL, y no puede haber dos tuplas con los mismos valores en ellos.FOREIGN KEY (A1, …, Am) REFERENCES s (B1, …, Bm)declara una clave foránea: los valores de A₁, …, Aₘ en cada tupla tienen que aparecer como valores de la clave de alguna tupla de s (o ser nulos).
En ddl.sql definimos nuestra propia versión,
simplificada, de vehicle y trip. Para no tocar las tablas de Chasqui las
creamos en un esquema aparte, taller (un esquema de PostgreSQL es un espacio
de nombres dentro de la base de datos; SET search_path TO taller hace que
los nombres sin calificar se busquen ahí):
CREATE TABLE vehicle (
  vehicle_id  integer,
  plate       varchar(7) NOT NULL,
  kind        text NOT NULL,
  capacity_kg integer NOT NULL,
  CONSTRAINT vehicle_pk PRIMARY KEY (vehicle_id)
);

CREATE TABLE trip (
  trip_id      integer,
  vehicle_id   integer NOT NULL,
  departure_at timestamptz NOT NULL,
  arrival_at   timestamptz,
  CONSTRAINT trip_pk PRIMARY KEY (trip_id),
  CONSTRAINT trip_vehicle_fk FOREIGN KEY (vehicle_id) REFERENCES vehicle (vehicle_id)
);
Las restricciones llevan nombre (CONSTRAINT trip_vehicle_fk ...) porque ese
nombre es el que aparece en los mensajes de error. \d muestra lo que quedó
definido:
chasqui_w02=# \d taller.trip
                           Table "taller.trip"
    Column    |           Type           | Collation | Nullable | Default
--------------+--------------------------+-----------+----------+---------
 trip_id      | integer                  |           | not null |
 vehicle_id   | integer                  |           | not null |
 departure_at | timestamp with time zone |           | not null |
 arrival_at   | timestamp with time zone |           |          |
Indexes:
    "trip_pk" PRIMARY KEY, btree (trip_id)
Foreign-key constraints:
    "trip_vehicle_fk" FOREIGN KEY (vehicle_id) REFERENCES taller.vehicle(vehicle_id)
trip_id aparece como not null aunque no lo escribimos: lo implica la clave
primaria. Y PostgreSQL creó un índice para la clave primaria, que es como
verifica rápido que no haya duplicados (los índices se ven en la semana 10).
Lo que el motor rechaza
Primero dos inserciones correctas, un vehículo y un viaje que lo usa. Después, cada una de las siguientes viola una restricción, y el motor la rechaza entera:
INSERT INTO trip VALUES (2, 99, '2026-03-16 09:00', NULL);ERROR: insert or update on table "trip" violates foreign key constraint "trip_vehicle_fk"
DETAIL: Key (vehicle_id)=(99) is not present in table "vehicle".INSERT INTO vehicle VALUES (2, NULL, 'van', 900);ERROR: null value in column "plate" of relation "vehicle" violates not-null constraint
DETAIL: Failing row contains (2, null, van, 900).INSERT INTO vehicle VALUES (1, 'T8D-416', 'bus', 4800);ERROR: duplicate key value violates unique constraint "vehicle_pk"
DETAIL: Key (vehicle_id)=(1) already exists.INSERT INTO vehicle VALUES (3, 'ABC-12345', 'truck', 12000);ERROR: value too long for type character varying(7)Lean los mensajes completos: dicen qué restricción se violó (por su nombre),
en qué tabla y con qué valores. La prueba de ddl.sql en
queries.test.mjs no compara esos textos,
que cambian con el idioma del servidor, sino el código de error estándar
(SQLSTATE) de cada sentencia: 23503 para la clave foránea, 23502 para el
NOT NULL, 23505 para la clave duplicada y 22001 para el texto demasiado
largo.
En PostgreSQL. El mensaje de la clave primaria dice unique constraint: PostgreSQL implementa la clave primaria como una restricción de unicidad más
NOT NULL, y usa el mismo mensaje para las dos. ElCHECK, que en Chasqui obliga a quecapacity_kgsea positivo ykindsea uno de tres valores, es la cuarta restricción básica; se ve con las demás restricciones de integridad en la semana 4.
DROP, DELETE y ALTER
Tres sentencias que se confunden:
DELETE FROM r;borra las tuplas de r. La relación sigue existiendo, vacía. ConWHEREborra solo algunas (semana 3).DROP TABLE r;borra la relación: el esquema y todas sus tuplas.ALTER TABLE r ADD COLUMN A D;agrega un atributo. Las tuplas que ya existen quedan conNULLen él.ALTER TABLE r DROP COLUMN A;lo quita.
El motor no deja borrar una tabla de la que dependen otras:
DROP TABLE vehicle;ERROR: cannot drop table vehicle because other objects depend on it
DETAIL: constraint trip_vehicle_fk on table trip depends on table vehicle
HINT: Use DROP ... CASCADE to drop the dependent objects too.La clave foránea de trip apunta a vehicle; si vehicle desapareciera,
esa clave apuntaría a la nada. Con DROP TABLE vehicle CASCADE PostgreSQL
borra también la restricción (no la tabla trip). Al final de ddl.sql,
ALTER TABLE vehicle ADD COLUMN brand text agrega la marca, y la consulta
siguiente muestra la columna nueva en NULL (en psql, un nulo se ve como un
espacio vacío):
 vehicle_id |  plate  | brand
------------+---------+-------
          1 | R2T-605 |
(1 row)
Después, DELETE FROM trip deja trip sin filas pero con su esquema intacto:
SELECT count(*) FROM trip devuelve 0.
La estructura básica de una consulta
Una consulta SQL básica tiene tres cláusulas:
SELECT A1, A2, ..., An
FROM r1, r2, ..., rm
WHERE P;
Su significado se define en términos del álgebra. Para cada combinación de una tupla de r₁, una de r₂, …, una de rₘ (el producto cartesiano), se evalúa P; si es verdadero, se calcula la tupla A₁, …, Aₙ y se agrega al resultado. Es decir:
FROMcorresponde a ×,WHEREcorresponde a σ,SELECTcorresponde a Π,
con una diferencia: SQL no elimina duplicados. La consulta anterior es casi ΠA₁, …, Aₙ(σP(r₁ × r₂ × … × rₘ)), pero con multiconjuntos. Esta es una definición del significado, no del algoritmo: el motor casi nunca calcula el producto.
SELECT * pide todos los atributos, y SELECT r.* todos los de una de las
relaciones del FROM. Si no hay WHERE, el predicado es verdadero para
todas las combinaciones.
Conjuntos y multiconjuntos
Un multiconjunto (multiset o bag) es como un conjunto, pero un elemento
puede aparecer más de una vez. Las tablas de SQL y los resultados de las
consultas son multiconjuntos. Las cinco primeras filas de SELECT city FROM customer, ordenadas por customer_id (B1):
   city
----------
 Ayacucho
 Puno
 Lima
 Tacna
 Lima
(5 rows)
Lima ya apareció dos veces, y todavía faltan 1795 filas. La consulta completa
devuelve una fila por cliente; con DISTINCT devuelve una por ciudad (B1b):
 con_duplicados | sin_duplicados
----------------+----------------
           1800 |             26
(1 row)
SELECT DISTINCT city FROM customer es la traducción fiel de Πcity(customer).
También se puede escribir SELECT ALL city, que es lo mismo que sin nada:
pide conservar los duplicados.
¿Por qué SQL no elimina duplicados siempre? Por dos razones prácticas. Eliminarlos cuesta: hay que ordenar el resultado o armar una tabla hash, y en una consulta con millones de filas eso es caro. Y muchas veces los duplicados importan: si se quiere el peso total de los envíos de una agencia, dos envíos de 2,5 kg no son “el mismo” envío. La semántica de multiconjuntos se puede precisar operación por operación: si una tupla aparece c₁ veces en r, σ la deja c₁ veces si cumple el predicado; Π produce una copia por cada tupla de origen; y si una tupla t₁ aparece c₁ veces en r y una tupla t₂ aparece c₂ veces en s, la tupla t₁t₂ aparece c₁ · c₂ veces en r × s.
Error común. Agregar
DISTINCT“por si acaso”. Si elSELECTincluye una clave (por ejemploshipment_id), no puede haber duplicados, yDISTINCTsolo agrega trabajo. Y si los hay, a veces son información: se pierde la cuenta de cuántas veces apareció cada valor. Hay que pensar si la pregunta habla de un conjunto o de un multiconjunto.
Varias tablas en FROM
Con varias relaciones en FROM, el WHERE se encarga de la condición de join.
Los envíos con el apellido del remitente (B3):
SELECT s.shipment_id, c.last_name, s.price
FROM shipment AS s, customer AS c
WHERE s.sender_id = c.customer_id
ORDER BY s.shipment_id
LIMIT 5;
shipment_id | last_name | price
-------------+-------------------+--------
1 | Mamani Chávez | 88.17
2 | Quispe Sánchez | 32.16
3 | Rodríguez Sánchez | 104.46
4 | Yupanqui Ramírez | 58.15
5 | García Rojas | 51.99
(5 rows)Con tres relaciones se necesitan dos condiciones de join. Los envíos con el nombre completo del remitente y la ciudad de la agencia de origen, que en el álgebra es
Πshipment_id, first_name, last_name, city((shipment ⋈sender_id = customer_id customer) ⋈shipment.origin_agency_id = agency_id agency)
y en SQL (B4):
SELECT s.shipment_id, c.first_name || ' ' || c.last_name AS remitente,
       a.city AS ciudad_origen
FROM shipment AS s, customer AS c, agency AS a
WHERE s.sender_id = c.customer_id
  AND s.origin_agency_id = a.agency_id
ORDER BY s.shipment_id
LIMIT 5;
shipment_id | remitente | ciudad_origen
-------------+---------------------------+----------------
1 | Luis Mamani Chávez | Piura
2 | Kevin Quispe Sánchez | Cerro de Pasco
3 | Gonzalo Rodríguez Sánchez | Cusco
4 | José Yupanqui Ramírez | Tarapoto
5 | Lucía García Rojas | Chiclayo
(5 rows)Ojo: customer también tiene un atributo city, la ciudad donde vive el
cliente. Por eso se escribe a.city: aquí se pide la ciudad de la agencia.
Error común. Olvidar la condición de join. Sin
WHERE,FROM shipment, customeres el producto cartesiano, y el motor lo calcula sin quejarse (B3b):filas ---------- 21600000 (1 row)Son 12000 · 1800 filas sin ningún error. Una regla práctica: con m relaciones en
FROMhacen falta al menos m − 1 condiciones de join. Si una consulta devuelve muchísimas más filas de las esperadas, lo primero que hay que revisar es eso.
Cuando dos relaciones del FROM tienen un atributo con el mismo nombre, hay
que calificarlo. shipment y route tienen los dos origin_agency_id (E3):
ERROR:  column reference "origin_agency_id" is ambiguous
LINE 1: SELECT shipment_id, origin_agency_id
                            ^
Operaciones básicas adicionales
Renombrar con AS
AS renombra atributos del resultado y relaciones del FROM, y cumple el
papel de ρ:
SELECT price * 1.18 AS totalle pone nombre a una columna calculada. SinAS, PostgreSQL la llama?column?.FROM shipment AS sle da un alias corto a una relación. A partir de ahí, en esa consulta, la relación se llamas(el nombre original ya no se puede usar para calificar sus atributos).
El alias de tabla es opcional cuando la relación aparece una vez, y
obligatorio cuando aparece dos veces, como route en la consulta de las rutas
de vuelta (A10) o agency en la de las rutas dentro de una región (A11). El
estándar permite omitir la palabra AS en los alias de tabla (FROM shipment s); Oracle, de hecho, no la acepta ahí. En el curso la escribimos siempre.
Patrones de texto: LIKE
LIKE compara un texto con un patrón en el que % reemplaza a cualquier
cadena (incluida la vacía) y _ a exactamente un carácter:
'Q%': empieza con Q.'% Quispe': termina con ” Quispe”.'_3_-%': un carácter, un 3, un carácter, un guion y cualquier cosa.
Los clientes con apellido que empieza con Q son 51 (B6). Las placas que tienen un 3 en la segunda posición (B6):
SELECT plate
FROM vehicle
WHERE plate LIKE '_3_-%'
ORDER BY plate;
plate
---------
F3E-445
G3S-419
H3H-976
J3D-585
L3A-234
S3G-624
(6 rows)En el estándar, y en PostgreSQL, LIKE distingue mayúsculas de minúsculas
(B6b):
 con_like | con_ilike
----------+-----------
        0 |        51
(1 row)
En PostgreSQL.
ILIKEes unLIKEque no distingue mayúsculas. No es estándar: en otros motores se escribelower(last_name) LIKE 'q%'. Para buscar un%o un_literal se antepone una barra invertida, el carácter de escape por defecto (LIKE '100\%'), o se elige otro conESCAPE.
Otras operaciones con texto: || concatena (lo usamos en B4 para armar el
nombre completo), upper y lower cambian a mayúsculas o minúsculas, trim
quita espacios de los extremos y length da el largo.
BETWEEN
x BETWEEN a AND b es una abreviatura de x >= a AND x <= b, con los dos
extremos incluidos. Las rutas de entre 100 y 121 km (B7):
 route_id | distance_km
----------+-------------
       85 |         121
       86 |         121
(2 rows)
Las dos tienen 121 km, el extremo superior: si BETWEEN excluyera los
extremos, el resultado sería vacío. Existe también NOT BETWEEN.
Ordenar: ORDER BY
ORDER BY ordena las filas del resultado por uno o más atributos, en orden
ascendente (ASC, el que se usa si no se dice nada) o descendente (DESC).
Con varios atributos, el segundo desempata al primero. Los diez envíos más
pesados del 16 de marzo de 2026, del más pesado al más liviano (B8):
SELECT shipment_id, weight_kg, created_at
FROM shipment
WHERE created_at >= '2026-03-16' AND created_at < '2026-03-17'
ORDER BY weight_kg DESC, shipment_id
LIMIT 10;
shipment_id | weight_kg | created_at
-------------+-----------+------------------------
3645 | 144.60 | 2026-03-16 12:26:00-05
5074 | 123.10 | 2026-03-16 01:29:00-05
1797 | 113.80 | 2026-03-16 05:55:00-05
6182 | 111.00 | 2026-03-16 19:42:00-05
1306 | 109.60 | 2026-03-16 17:34:00-05
4720 | 102.70 | 2026-03-16 23:20:00-05
10435 | 101.00 | 2026-03-16 17:45:00-05
4251 | 91.60 | 2026-03-16 22:35:00-05
8083 | 89.70 | 2026-03-16 22:47:00-05
4669 | 82.90 | 2026-03-16 06:32:00-05
(10 rows)Tres detalles de esta consulta:
- El filtro de fecha es un intervalo semiabierto,
>=el inicio del día y<el inicio del siguiente.created_ates untimestamptz, y las fechas se interpretan en la zona horaria de la sesión, que en las bases del curso esAmerica/Lima(por eso el-05en la salida). Ese día hay 68 envíos. shipment_iddesempata. Si dos envíos pesaran lo mismo justo en el puesto diez, sin el desempate el motor podría devolver cualquiera de los dos, y la consulta no daría siempre lo mismo.LIMIT 10se queda con las diez primeras filas después de ordenar.
En PostgreSQL.
LIMITno es estándar, aunque lo aceptan PostgreSQL, MySQL y SQLite. El estándar esFETCH FIRST 10 ROWS ONLY, que PostgreSQL también acepta y da el mismo resultado (B8b; la pruebaLIMIT 10 = FETCH FIRST 10 ROWS ONLYlo comprueba).OFFSET nsalta las primeras n filas.
Error común. Suponer un orden sin
ORDER BY. Una relación es un conjunto (y una tabla, un multiconjunto): sus filas no tienen orden. SiSELECT * FROM agencysale ordenado poragency_id, es porque las filas se insertaron en ese orden y la tabla es pequeña; después de unas actualizaciones, o con otro plan de ejecución, puede salir en otro. Si el orden importa, se pide conORDER BY. YLIMITsinORDER BYdevuelve “algunas” filas, no “las primeras”.
El orden lógico de evaluación
Aunque se escribe primero, SELECT es de las últimas cláusulas en
evaluarse. El orden lógico, el que define el significado, es:
FROM: el producto de las relaciones,WHERE: el filtro de cada fila,SELECT: el cálculo de las columnas del resultado (yDISTINCT),ORDER BY: el orden,LIMIT: el recorte.
Es un orden lógico, no el orden en que el motor trabaja de verdad. Pero
explica qué nombres se pueden usar en cada cláusula. Un alias definido en
SELECT todavía no existe cuando se evalúa WHERE (E4):
SELECT price * 1.18 AS total
FROM shipment
WHERE total > 100;
ERROR: column "total" does not exist
LINE 3: WHERE total > 100;
^Se corrige repitiendo la expresión en el WHERE. En ORDER BY, en cambio, el
alias ya existe (B5):
SELECT shipment_id, price, price * 1.18 AS total
FROM shipment
WHERE price * 1.18 > 230
ORDER BY total DESC, shipment_id;
shipment_id | price | total
-------------+--------+----------
3645 | 201.98 | 238.3364
1618 | 196.86 | 232.2948
(2 rows)Un detalle de PostgreSQL: el alias se reconoce en ORDER BY solo cuando
aparece solo, como nombre de columna de salida. Dentro de una expresión ya no:
SELECT price * 1.18 AS total
FROM shipment
ORDER BY total * 2;
ERROR: column "total" does not exist
LINE 3: ORDER BY total * 2;
^Fíjense en que total tiene cuatro decimales: numeric multiplicado por
numeric conserva todos los decimales del producto, sin redondear. Para
mostrarlo con dos, se usa round(price * 1.18, 2).
Del álgebra a SQL
Con lo visto ya se puede traducir cualquier expresión de esta semana. La correspondencia:
| Álgebra | SQL | Observación |
|---|---|---|
| σP(r) | SELECT * FROM r WHERE P |
|
| ΠA, B(r) | SELECT DISTINCT A, B FROM r |
sin DISTINCT quedan duplicados |
| r × s | SELECT * FROM r, s |
|
| r ⋈θ s | SELECT * FROM r, s WHERE θ |
|
| r ⋈ s | FROM r, s WHERE con una igualdad por cada atributo común |
o NATURAL JOIN, semana 4 |
| ρx(r) | FROM r AS x |
|
| r ∪ s | ... UNION ... |
elimina duplicados |
| r − s | ... EXCEPT ... |
elimina duplicados |
| r ∩ s | ... INTERSECT ... |
elimina duplicados |
| x ← E | WITH x AS (E) ... |
semana 3 |
Una receta para traducir una expresión que combina σ, Π y joins: las
relaciones de la expresión (con su ρ, si tienen) van al FROM; todas las
condiciones de join y de selección, unidas con AND, van al WHERE; la Π
exterior va al SELECT, con DISTINCT si puede haber duplicados.
Las operaciones de conjuntos de SQL se comportan distinto que SELECT:
UNION, EXCEPT e INTERSECT sí eliminan duplicados, como en el álgebra.
Para conservarlos hay que pedirlo con ALL (B10):
 union_all | union_conjunto
-----------+----------------
      1829 |             26
(1 row)
UNION ALL junta las 29 ciudades de agency (con repeticiones: Lima tiene
tres agencias) y las 1800 de customer. UNION deja las 26 ciudades
distintas. Las variantes con ALL y su semántica de multiconjuntos son tema
de la semana 3.
Idea clave. La traducción del álgebra a SQL es exacta en contenido, no en cantidad: una consulta SQL sin
DISTINCTdevuelve las mismas tuplas que su expresión del álgebra, pero puede devolver algunas varias veces. Cuando se compara un resultado de SQL con uno del álgebra, hay que compararlos como conjuntos.
Un ejemplo completo. “Los nombres de las agencias de origen de los envíos de más de 145 kg”. En el álgebra:
Πname(σweight_kg > 145(shipment) ⋈origin_agency_id = agency_id agency)
En SQL, con la receta (B11):
SELECT DISTINCT a.name
FROM shipment AS s, agency AS a
WHERE s.origin_agency_id = a.agency_id
  AND s.weight_kg > 145
ORDER BY a.name;
La selección σweight_kg > 145 quedó en el mismo WHERE que la
condición de join: en SQL no se indica dónde va cada filtro, y el optimizador
lo decide. Si se quita el DISTINCT, una agencia que despachó dos envíos
pesados aparece dos veces. El ejercicio 7 les pide correr las dos versiones y
explicar la diferencia.
El código de la semana y make test
La carpeta code/week-02 tiene:
algebra.sql: las expresiones de la sesión A, cada una con su traducción, numeradas A1 a A12 como en este capítulo.basics.sql: las consultas de la sesión B, B1 a B11.ddl.sql: las tablas del esquematallery las inserciones que el motor rechaza.errors.sql: las consultas mal escritas de los recuadros de error común, E1 a E4.algebra.test.mjsyqueries.test.mjs: las pruebas.
Las pruebas hacen dos cosas. Primero comparan formulaciones equivalentes: corren las dos consultas y verifican que devuelven el mismo multiconjunto de filas, sin importar el orden. Por ejemplo, la que verifica que filtrar antes o después del join da lo mismo:
test('equivalencia: σ antes o después del join da lo mismo (6 rutas desde Cusco)', async () => {
  const n = await sameBag(
    `SELECT r.route_id, a.agency_id FROM route AS r, agency AS a
     WHERE r.origin_agency_id = a.agency_id AND a.region = 'Cusco'`,
    `SELECT r.route_id, a.agency_id FROM route AS r,
       (SELECT * FROM agency WHERE region = 'Cusco') AS a
     WHERE r.origin_agency_id = a.agency_id`,
  );
  assert.equal(n, 6);
  ...
});
sameBag convierte cada fila en texto, ordena las dos listas y las compara
con assert.deepEqual. Segundo, verifican cada número que cita este
capítulo: 26 ciudades, 696 tuplas en el producto, 1758 clientes en la unión,
la agencia 29, las 60 parejas de rutas. Si alguien cambia los datos de Chasqui
y un número deja de ser cierto, la prueba falla y avisa que el capítulo quedó
desactualizado. Las pruebas de ddl.sql y errors.sql leen esos archivos,
corren cada sentencia y comparan su SQLSTATE con el esperado.
Para correr todo, dentro del contenedor:
$ cd code/week-02
$ make test
chasqui-load chasqui_w02
Base de datos chasqui_w02 lista.
psql -X -q -v ON_ERROR_STOP=1 -d chasqui_w02 -f algebra.sql > /dev/null
psql -X -q -v ON_ERROR_STOP=1 -d chasqui_w02 -f basics.sql > /dev/null
PGDATABASE=chasqui_w02 node --test --test-reporter=spec
✔ selección: buses de más de 5000 kg (8.495125ms)
✔ selección: σ a∧b (r) = σ a (σ b (r)) (2.711125ms)
...
✔ ddl.sql: el motor rechaza exactamente las filas que violan restricciones (6.447792ms)
ℹ tests 34
ℹ suites 0
ℹ pass 34
ℹ fail 0
make test vuelve a crear la base de datos antes de probar, así que los
experimentos que hagan en chasqui_w02 no afectan a las pruebas. make clean
la borra.
Resumen
- El álgebra relacional es un lenguaje procedimental: una expresión dice qué operaciones aplicar y en qué orden. Cada operación devuelve una relación, así que se componen (clausura).
- Las operaciones fundamentales son σ (filtra tuplas), Π (se queda con atributos y elimina duplicados), ∪, −, × y ρ. La intersección, el join θ, el natural join y la asignación se definen a partir de ellas.
- r ⋈θ s = σθ(r × s). |r × s| = |r| · |s|. Un join por
una clave foránea
NOT NULLhacia una clave primaria tiene exactamente |r| tuplas; si la clave foránea admite nulos, se pierden las tuplas con nulo. - El natural join iguala todos los atributos con el mismo nombre. En
Chasqui eso produce joins que nadie quiso (customer ⋈ agency por
city) o un producto cartesiano (route ⋈ agency). - ∪, − y ∩ exigen relaciones compatibles: misma aridad y dominios compatibles. La diferencia no es conmutativa. Un resultado vacío es un resultado válido.
- ρ permite usar dos veces la misma relación; en SQL es el alias de tabla.
- Dos expresiones son equivalentes si dan lo mismo en toda instancia. Aplicar σ antes del join es equivalente y mucho más barato; es la base del optimizador.
- SQL tiene DDL y DML.
CREATE TABLEdeclara tipos,NOT NULL,PRIMARY KEYyFOREIGN KEY; el motor rechaza las filas que las violan. El dinero va ennumeric, nunca endouble precision. SELECT-FROM-WHEREcorresponde a Π-×-σ, pero sobre multiconjuntos:SELECTno elimina duplicados;SELECT DISTINCTsí.UNION,EXCEPTeINTERSECTeliminan duplicados salvo que se pidaALL.AS,LIKE(%y_),||,BETWEEN(con extremos),ORDER BYcon desempate yLIMIT(oFETCH FIRST, el estándar). SinORDER BYno hay orden.- Orden lógico:
FROM,WHERE,SELECT,ORDER BY,LIMIT. Por eso un alias deSELECTsirve enORDER BYy no enWHERE.
Ejercicios
- Para cada expresión, digan si está bien formada; si lo está, cuál es su esquema, y si no, por qué: (a) Πplate(σcapacity_kg > 1000(vehicle)); (b) σcapacity_kg > 1000(Πplate(vehicle)); (c) Πcity(agency) − Πcity(customer); (d) Πagency_id, name(agency) ∪ Πroute_id(route).
- Traduzcan a SQL y ejecuten en
chasqui_w02: σkind = ‘bus’(vehicle); Πregion(agency); Πfirst_name, last_name(σcity = ‘Trujillo’(customer)). ComparenSELECT region FROM agencyconSELECT DISTINCT region FROM agency. ¿Cuántas filas da cada una y por qué? - Si
agencytuviera 40 tuplas yroute300, ¿cuántas tuplas tendría agency × route? ¿Y agency ⋈agency_id = origin_agency_id route, como mínimo y como máximo? Respondan dos veces: con las restricciones que tienerouteen el esquema de Chasqui, y sin ninguna restricción. - Escriban en álgebra relacional y en SQL: las placas de los vehículos que
hicieron algún viaje por una ruta de más de 800 km. ¿Hace falta
DISTINCT? Comprueben su respuesta contando las filas con y sin él. - Expliquen con un ejemplo de Chasqui por qué hace falta ρ para encontrar los pares de clientes que viven en la misma ciudad. Escriban la expresión y la consulta, de manera que cada par aparezca una sola vez y ningún cliente aparezca emparejado consigo mismo. Sin ejecutarla, estimen si el resultado tendrá cientos, miles o cientos de miles de filas (pista: 772 clientes viven en Lima).
- Demuestren que r ∩ s = r − (r − s) usando la definición de las operaciones como conjuntos. ¿Se puede escribir r ∪ s con − y ∩? ¿Y r − s con ∪ y ∩?
- Corran la consulta de las agencias de origen de los envíos de más de 145 kg
(sección Del álgebra a SQL) con y sin
DISTINCT. ¿Cuántas filas da cada versión? Escriban una consulta que muestre qué agencias aparecen repetidas en la versión sinDISTINCT. - Escriban en álgebra relacional, usando asignación, y después en SQL: los
clientes (nombre y apellido) que enviaron algún paquete a un destinatario
de su misma ciudad. ¿Cuántas veces aparece
customeren la expresión? - ¿Son equivalentes σregion = ‘Cusco’ ∨ distance_km > 600(route ⋈θ agency)
y route ⋈θ σregion = ‘Cusco’ ∨ distance_km > 600(agency),
con θ: origin_agency_id = agency_id? Si no, digan cuál está mal formada o
den una instancia en la que difieran. ¿Qué parte del predicado sí se puede
empujar hacia
agency? - Corrijan la consulta
SELECT price * 1.18 AS total FROM shipment WHERE total > 100;de dos maneras distintas. Después, ordénenla portotalde mayor a menor y muestren solo las primeras 5 filas, de modo que el resultado sea siempre el mismo aunque haya empates. - En una base de pruebas (
CREATE DATABASE lab02;y\c lab02), definanagencyyroutecon clave primaria,NOT NULLy las dos claves foráneas deroute, con nombre. Inserten dos agencias y una ruta entre ellas, e intenten: (a) una ruta hacia una agencia que no existe; (b) borrar conDROP TABLEla tablaagency; (c) borrar conDELETEla agencia de origen de la ruta. Copien los tres mensajes y expliquen cada uno. ¿Qué restricción delroutede Chasqui no pudieron declarar con lo visto esta semana? - Busquen en Chasqui los clientes cuyo apellido paterno (la primera palabra
de
last_name) es Quispe, y los que tienen Quispe como apellido materno (la segunda). Usen soloLIKE. ¿Hay algún cliente que salga en las dos consultas? ¿Qué patrón usarían para encontrarlo directamente?