
Apuntes · Capítulo 1Modelo relacional y SQL
Sistemas de bases de datos y el modelo relacional
Sistemas de bases de datos y el modelo relacional
Casi todos los programas que han escrito hasta ahora guardan sus datos en variables, en arreglos o, como mucho, en un archivo que leen al empezar y escriben al terminar. Funciona mientras los datos son pocos, los usa un solo programa y nadie más los toca. Este curso trata de lo que pasa cuando eso deja de ser cierto: cuando los datos son muchos, los usan varias personas a la vez, tienen que sobrevivir a un corte de luz y deben cumplir reglas que nadie puede saltarse. Para eso existen los sistemas de gestión de bases de datos.
Este primer capítulo tiene dos partes. En la primera vemos qué es un sistema de bases de datos y por qué no basta con archivos: lo comprobamos con Chasqui, la empresa de encomiendas que nos acompaña todo el semestre, y con un programa que guarda sus envíos en archivos CSV. Después vemos las ideas que organizan todo el curso: los niveles de abstracción, el esquema y la instancia, los lenguajes DDL y DML y las piezas de un motor por dentro. En la segunda parte entramos al modelo relacional: qué es exactamente una relación, qué es una clave y cómo se conectan las tablas de Chasqui entre sí.
Ruta de lectura.
- Antes de clase (obligatorio, 15–20 min por sesión). Sesión A: “El curso en una página” y “Chasqui con archivos”. Sesión B: “Relaciones, tuplas y atributos” y “Superclave”.
- En clase. Sesión A: “Qué es un sistema de bases de datos”, “La vista de los datos”, “Lenguajes de bases de datos” y “Diseño, motor, arquitectura y usuarios”. Sesión B: “El modelo relacional” y “Claves”.
- Después de clase. Para repasar, “Resumen” y “Ejercicios”. Del libro de Silberschatz, Korth y Sudarshan (7.ª ed.), secs. 1.1–1.6 y 2.1–2.4; las 1.7 y 1.8, de forma rápida, y la 1.9, opcional. Las lecturas libres y complementarias están en la guía de la semana, y el código del capítulo, en
code/week-01, que se prueba conmake testdentro del contenedor del curso (env/run.sh).
El curso en una página
El curso tiene cuatro partes. La primera, modelo relacional y SQL (semanas 1 a 5), enseña a usar una base de datos: relaciones, claves, álgebra relacional, SQL completo y SQL desde un programa en Node.js. La segunda, diseño de bases de datos (semanas 6 a 8), enseña a decidir qué tablas tener: el modelo entidad-relación, las dependencias funcionales y las formas normales. La tercera, almacenamiento, índices y consultas (semanas 9 a 12), abre el motor por dentro: páginas, buffer pool, B+ trees, algoritmos de join y optimización. La cuarta, transacciones y sistemas distribuidos (semanas 13 a 16), explica cómo el motor mantiene los datos correctos con usuarios concurrentes y después de una caída. El calendario completo, las lecturas de cada semana y las políticas están en el programa del curso.
Todo el semestre trabajarán en un solo proyecto que crece: Chasqui, la
base de datos de una empresa de encomiendas que envía paquetes entre agencias
de todo el Perú. Las primeras entregas (P0 a P2) son de SQL, diseño y una
aplicación en Node.js sobre PostgreSQL. Las últimas (P3 a P5) construyen
quipu, un motor de almacenamiento pequeño, escrito por ustedes en
Node.js, que guarda los mismos datos en páginas, los indexa con un B+ tree,
ejecuta consultas con iteradores y controla la concurrencia con locks. Cada
entrega debe pasar sus pruebas y las de las entregas anteriores. El detalle
está en projects/README.md; P0, el calentamiento,
se publica esta semana.
| Actividad | Cuándo |
|---|---|
| Proyecto (P0–P5) | todo el semestre, con entregas en las semanas 3, 6, 9, 12, 14 y 16 |
| Laboratorios | cada semana |
| Examen parcial | semana 8 |
| Examen final | después de la semana 16 |
El entorno es el mismo para todos: un contenedor Docker con PostgreSQL 18,
el cliente psql y Node.js 26, que funciona igual en Linux, Windows
(WSL2) y macOS. Lo instalan en el laboratorio de esta semana siguiendo
labs/README.md. Todos los resultados que aparecen en
estos apuntes salieron de ese contenedor, con los datos de ejemplo de Chasqui.
Qué es un sistema de bases de datos
Una base de datos (database) es una colección de datos relacionados entre sí, que describen algo del mundo: los envíos de una empresa, las matrículas de una universidad, las cuentas de un banco. Un sistema de gestión de bases de datos (database management system, DBMS) es el software que guarda esa colección y da acceso a ella de forma conveniente y eficiente. Al conjunto de los dos, los datos y el software que los administra, Silberschatz lo llama sistema de bases de datos.
Las bases de datos están en todas partes, aunque no se vean: detrás de la app del banco, del sistema de matrícula, de la tienda en línea, del registro de vuelos de un aeropuerto y de la red social que revisan en el celular. Cada vez que una de esas aplicaciones muestra un saldo o guarda una compra, le está haciendo una consulta a un DBMS. En el curso usamos PostgreSQL, un DBMS relacional de código abierto que viene del proyecto POSTGRES de la Universidad de California en Berkeley.
Chasqui con archivos
Para ver qué resuelve un DBMS, imaginemos que Chasqui no tiene uno. Cada agencia lleva un archivo CSV con los envíos que salen de ella, y un programa propio los mantiene. Cada fila es un envío, y como el archivo no tiene dónde más guardar los datos del remitente, se copian en la fila:
shipment_id,created_at,sender_dni,sender_name,sender_phone,dest_city,weight_kg,price,status
11,2026-01-26,44165965,Patricia Salazar Cárdenas,981313291,Arequipa,10.20,54.68,delivered
17,2026-05-04,14414736,Camila Medina Cáceres,993060280,Arequipa,17.30,78.35,delivered
23,2026-04-11,15094236,Yolanda Espinoza Ramos,923940626,Trujillo,74.50,103.76,delivered
Son las primeras líneas de agency-01.csv, el archivo de la agencia de La
Victoria, en Lima. El programa
files.mjs arma estos archivos a partir de los
datos de ejemplo (un archivo por agencia de origen) y después los usa como lo
haría un sistema hecho a mano. Esto es lo que imprime:
$ node files.mjs
28 archivos, 12000 filas en total
DNI 48479833: 64 filas en 25 archivos, teléfonos 972898189
se corrigieron 9 filas de agency-01.csv; teléfonos ahora: 999000111 972898189
en la base de datos: UPDATE 1
corte de luz reescribiendo agency-02.csv: tenía 974 filas, quedan 487
fila con peso -5.00 agregada sin quejas a agency-03.csv
Son 28 archivos y no 29 porque la agencia de Iquitos no tiene envíos en los datos de ejemplo. Cada una de las líneas siguientes muestra uno de los problemas que Silberschatz enumera en la sección 1.2. Vamos uno por uno.
Redundancia e inconsistencia. La clienta con DNI 48479833, Yolanda Torres
Ramírez, envió 64 paquetes desde 25 agencias distintas. Su teléfono está
copiado en 64 filas de 25 archivos. Eso es redundancia: el mismo dato
guardado en muchos lugares. El problema aparece cuando cambia. Ella avisa en
La Victoria que tiene un número nuevo, y el programa corrige las 9 filas de
agency-01.csv. Los otros 24 archivos siguen con el número viejo. Ahora la
empresa tiene dos teléfonos para la misma persona y no hay forma de saber
cuál es el bueno. Eso es inconsistencia: copias del mismo dato que ya no
coinciden. En la base de datos de Chasqui el teléfono está en una sola fila de
la tabla customer, y el cambio toca exactamente esa fila (UPDATE 1).
Cada pregunta nueva, un programa nuevo. La gerencia pregunta cuántos
envíos hay en cada estado. Con archivos, alguien tiene que escribir una
función que abra los 28 archivos, recorra las filas y vaya contando: es
countByStatus en files.mjs. La semana siguiente preguntarán por el peso
promedio por destino, y habrá que escribir otra. Con un DBMS, la pregunta es
una consulta:
SELECT status, count(*)
FROM shipment
GROUP BY status
ORDER BY status;
status | count
------------+-------
delivered | 11115
in_transit | 66
registered | 500
returned | 319
(4 rows)Las pruebas de la semana comprueban que la función escrita a mano y la consulta dan el mismo resultado. La diferencia es cuánto costó cada una. Silberschatz agrega a esto el aislamiento de los datos (data isolation): cuando los datos están repartidos en archivos con formatos distintos, cada programa nuevo tiene que conocer todos esos formatos. (No hay que confundirlo con el aislamiento de las transacciones, la I de ACID, que veremos en la semana 13.)
Problemas de integridad. Un envío no puede pesar −5 kg. Pero el archivo
no sabe eso: es texto. La última línea de la salida agregó una fila con peso
-5.00 y nadie se quejó. Las reglas del negocio (el peso es positivo, el DNI
tiene 8 dígitos, el estado es uno de cuatro valores) viven escondidas en el
código de los programas que escriben el archivo, si es que viven en algún
lado. Si un programa nuevo se olvida de una, los datos se rompen. En un DBMS
las reglas se declaran una vez, en el esquema, y el motor las verifica en
cada cambio, venga de donde venga:
chasqui=# INSERT INTO shipment (shipment_id, sender_id, recipient_id, origin_agency_id,
                      dest_agency_id, weight_kg, price, status, created_at)
VALUES (12001, 178, 337, 9, 8, -5, 15.00, 'registered', now());
ERROR:  new row for relation "shipment" violates check constraint "shipment_weight_kg_check"
DETAIL:  Failing row contains (12001, 178, 337, 9, 8, null, -5.00, null, 15.00, registered, 2026-10-31 20:51:20.037346-05, null).
Atomicidad. Para corregir un teléfono, el programa reescribe el archivo
completo: lo abre vacío y escribe las filas una por una. Si se va la luz a la
mitad, el archivo queda con la mitad de las filas. En la salida, agency-02.csv
tenía 974 envíos y quedaron 487. Lo que el negocio necesitaba era que el
cambio ocurriera completo o no ocurriera: eso se llama atomicidad. El
ejemplo de Silberschatz es una transferencia entre dos cuentas; en Chasqui
sería registrar un envío y su cobro: no puede quedar uno sin el otro. Un DBMS
agrupa los cambios en transacciones y garantiza que, después de una caída,
cada transacción quedó entera o no dejó rastro. Cómo lo logra es el tema de la
semana 15.
Acceso concurrente. Supongan que a un camión le quedan 50 kg de capacidad y que dos counters, en dos agencias, registran a la vez un envío de 40 kg en ese mismo viaje. Cada programa lee el archivo, ve que hay espacio, agrega su envío y guarda. Los dos vieron “50 kg libres”; el camión termina con 80 kg de más. Con archivos, evitar esto obliga a cada programa a coordinarse con los demás. Un DBMS ofrece control de concurrencia: las transacciones concurrentes se comportan como si se hubieran ejecutado una detrás de otra (semanas 13 y 14).
Seguridad. Quien puede leer el CSV puede leer todo: el DNI, el teléfono y el valor declarado de cada paquete. No hay forma de dejar que un counter vea los envíos pero no los teléfonos. Un DBMS permite dar permisos por tabla, por columna y por operación, y ofrece vistas que muestran solo una parte de los datos (semana 4).
Idea clave. Cada uno de estos problemas se puede resolver a mano en un programa con archivos. El punto es que habría que resolverlos todos, en cada programa, y bien. Un DBMS los resuelve una vez, para todos los programas que usan los datos.
Lo que hace un DBMS
Resumiendo, un DBMS:
- guarda los datos una sola vez, con una estructura que describe qué hay y cómo se relaciona (el esquema);
- responde preguntas nuevas sin programas nuevos, mediante un lenguaje de consultas;
- verifica las restricciones de integridad declaradas en el esquema, en cada cambio;
- ejecuta los cambios en transacciones atómicas, que sobreviven a fallos del sistema;
- controla el acceso concurrente de muchos usuarios;
- controla quién puede ver y cambiar qué.
Y lo hace con datos que no caben en memoria: la base de datos vive en disco y el motor decide qué partes traer a memoria y cuándo. De eso trata la tercera parte del curso.
La vista de los datos
Un DBMS esconde a los usuarios los detalles de cómo se guardan los datos. Para hablar de lo que muestra y de lo que esconde, Silberschatz usa tres ideas: el modelo de datos, los niveles de abstracción y la diferencia entre esquema e instancia.
Modelos de datos
Un modelo de datos (data model) es un conjunto de herramientas conceptuales para describir los datos, sus relaciones, su significado y las restricciones que deben cumplir. Silberschatz menciona cuatro:
- El modelo relacional. Los datos se organizan en tablas, llamadas relaciones. Cada tabla tiene columnas con nombre y cada fila es un registro de un tipo fijo. Es el modelo de casi todos los DBMS en uso y el de este curso.
- El modelo entidad-relación (E-R). Describe el mundo como entidades (un cliente, una agencia) y relaciones entre ellas (un cliente envía un paquete). Se usa para diseñar, antes de escribir tablas (semana 6).
- Los modelos semiestructurados. Cada dato puede tener atributos
distintos; JSON y XML son los ejemplos usuales (semana 8, con el tipo
jsonbde PostgreSQL). - Los modelos basados en objetos. Llevan ideas de la programación orientada a objetos (herencia, identidad de objetos) a las tablas. PostgreSQL tiene algo de esto, pero no lo usaremos.
Error común. Relación tiene dos significados en el curso. En el modelo relacional, una relación es una tabla (relation). En el modelo E-R, una relación es un vínculo entre entidades (relationship). Cuando haya riesgo de confusión lo diremos explícitamente.
Niveles de abstracción
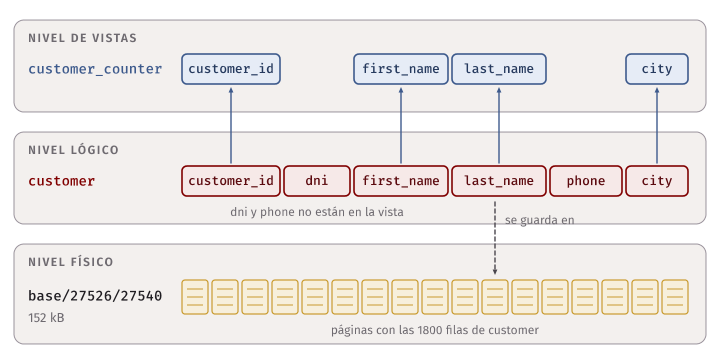
Una tabla de Chasqui se puede mirar desde tres alturas.
- Nivel físico. Cómo están guardados los bytes: en qué archivos, en páginas de qué tamaño, con qué índices. Es el nivel más bajo y el más complicado.
- Nivel lógico. Qué datos hay y cómo se relacionan: hay una tabla
customercon las columnascustomer_id,dni,first_name,last_name,phoneycity, y la tablashipmentapunta a ella. Es el nivel en el que trabajan quienes escriben consultas y quienes diseñan la base de datos. - Nivel de vistas. Lo que ve cada usuario: solo una parte de la base de datos. Un counter de agencia necesita nombres y ciudades de clientes, no sus DNI ni sus teléfonos.
En PostgreSQL se pueden tocar los tres. El nivel físico de customer es un
archivo dentro del directorio de datos del servidor:
SELECT pg_relation_filepath('customer') AS file,
       pg_size_pretty(pg_relation_size('customer')) AS size;
file | size
------------------+--------
base/27526/27540 | 152 kB
(1 row)base/27526 es el directorio de la base de datos y 27540 es el archivo de la
tabla: 152 kB de páginas con las 1800 filas de clientes. (En su contenedor los
números serán otros: son identificadores internos que el servidor asigna al
crear la base de datos.) Nadie escribe consultas pensando en ese archivo. El
nivel lógico es lo que muestra \d customer, que veremos en la segunda
parte. Y el nivel de vistas se arma con una vista (view), una consulta
guardada con nombre que se usa como si fuera una tabla:
CREATE VIEW customer_counter AS
  SELECT customer_id, first_name, last_name, city
  FROM customer;
SELECT * FROM customer_counter ORDER BY customer_id LIMIT 3;
customer_id | first_name | last_name | city
-------------+------------+-----------------+----------
1 | Wilmer | Chávez Ríos | Ayacucho
2 | Piero | García Castillo | Puno
3 | Milagros | Ramos Herrera | Lima
(3 rows)Quien solo tenga permiso sobre customer_counter no ve el DNI ni el teléfono.
Las vistas y los permisos son tema de la semana 4.
Esquema e instancia
La diferencia más importante de esta semana es la que hay entre el diseño de la base de datos y su contenido.
- El esquema (schema) es el diseño: qué tablas hay, qué columnas tiene cada una, de qué tipo son y qué reglas cumplen. Cambia poco: cuando el negocio cambia, no cuando se registra un envío.
- La instancia (instance) es el contenido de la base de datos en un momento dado: las filas que hay ahora. Cambia todo el tiempo.
Silberschatz compara el esquema con la declaración de una variable en un programa (su tipo) y la instancia con el valor que tiene la variable en un momento. Hay un esquema por nivel: el esquema físico describe el almacenamiento, el esquema lógico describe las tablas, y los subesquemas describen lo que ve cada vista. Cuando se dice “el esquema” sin más, se habla del lógico, que es el que más importa a los programas.
En Chasqui, el esquema lógico es el archivo
datasets/chasqui/schema.sql. La instancia
son las 29 agencias, 1800 clientes, 24 vehículos, 120 rutas, 5914 viajes,
12 000 envíos y 46 421 eventos que cargan los datos de ejemplo; mañana serán
otros.
En PostgreSQL. La palabra schema tiene en PostgreSQL un segundo sentido: un namespace dentro de una base de datos, como una carpeta de tablas. Las tablas de Chasqui están en el schema
public, por eso\d customerdiceTable "public.customer". Es otro uso de la misma palabra; en estos apuntes, esquema es siempre el diseño.
Independencia física de los datos
Los niveles de abstracción tienen un propósito práctico: que se pueda cambiar uno sin tocar el de arriba. Un programa tiene independencia física de los datos (physical data independence) si no depende del esquema físico, de modo que no hay que reescribirlo cuando el esquema físico cambia.
Probémoslo. Contamos los clientes de Arequipa, agregamos un índice sobre
city (una estructura auxiliar que permite encontrar filas sin recorrer toda
la tabla) y volvemos a contar. Todo dentro de una transacción que termina en
ROLLBACK, para dejar la base de datos como estaba:
BEGIN;
SELECT count(*) FROM customer WHERE city = 'Arequipa';
EXPLAIN (COSTS OFF) SELECT count(*) FROM customer WHERE city = 'Arequipa';
CREATE INDEX customer_city_idx ON customer (city);
SELECT count(*) FROM customer WHERE city = 'Arequipa';
EXPLAIN (COSTS OFF) SELECT count(*) FROM customer WHERE city = 'Arequipa';
ROLLBACK;
Las dos consultas devuelven lo mismo, 89 clientes. Lo que cambia es la forma
en que el motor los encuentra, y eso es lo que muestra EXPLAIN. Antes del
índice:
                QUERY PLAN
-------------------------------------------
 Aggregate
   ->  Seq Scan on customer
         Filter: (city = 'Arequipa'::text)
(3 rows)
Después:
                        QUERY PLAN
-----------------------------------------------------------
 Aggregate
   ->  Index Only Scan using customer_city_idx on customer
         Index Cond: (city = 'Arequipa'::text)
(3 rows)
Antes, el motor leía la tabla entera (Seq Scan) y se quedaba con las filas de Arequipa. Después, usa el índice para ir directo a ellas. No hace falta entender los planes todavía: los leeremos con cuidado en la semana 12. Lo que importa hoy es que nadie cambió la consulta. El índice es un cambio del nivel físico, y la consulta, que vive en el nivel lógico, no se enteró. Si mañana el administrador de la base de datos borra el índice, la consulta seguirá funcionando, quizá más lenta.
En PostgreSQL. En muchos DBMS, una sentencia del DDL como
CREATE INDEXoCREATE TABLEhace commit automáticamente y no se puede deshacer. En PostgreSQL casi todo el DDL es transaccional: dentro deBEGIN…ROLLBACK, el índice y la vista de los ejemplos desaparecen como si nunca hubieran existido. Por eso los ejemplos deexamples.sqlse pueden correr las veces que quieran.
Lenguajes de bases de datos
Un DBMS ofrece dos clases de lenguaje: uno para definir el esquema y otro para consultar y modificar la instancia. En la práctica los dos son partes del mismo lenguaje, SQL, que estudiaremos de la semana 2 a la 5.
DDL: definir el esquema
El lenguaje de definición de datos (data-definition language, DDL)
describe el esquema. Esta es la definición de customer en schema.sql:
CREATE TABLE customer (
  customer_id integer PRIMARY KEY,
  dni         char(8) NOT NULL UNIQUE CHECK (dni ~ '^[0-9]{8}$'),
  first_name  text NOT NULL,
  last_name   text NOT NULL,
  phone       text CHECK (phone ~ '^9[0-9]{8}$'),
  city        text NOT NULL
);
Además de nombres y tipos de columnas, el DDL declara restricciones de integridad (integrity constraints), las reglas que los datos deben cumplir siempre. Silberschatz menciona, entre otras:
- Restricciones de dominio. Cada atributo toma valores de un dominio: un
integer, un texto de 8 dígitos (CHECK (dni ~ '^[0-9]{8}$')). - Integridad referencial. Un valor que apunta a otra tabla debe existir en ella: el remitente de un envío tiene que ser un cliente registrado. Lo vemos en detalle en la segunda parte.
- Autorización. Quién puede leer, insertar, modificar o borrar qué.
El DBMS guarda el esquema en un diccionario de datos (data dictionary),
también llamado catálogo: un conjunto de tablas especiales con
información sobre los datos, es decir, metadatos. Los meta-comandos de
psql, como \d customer, consultan ese catálogo. El script
keys.mjs también lo hace: lee las claves de cada
tabla de las tablas del catálogo de PostgreSQL (pg_constraint,
pg_attribute).
DML: consultar y modificar
El lenguaje de manipulación de datos (data-manipulation language, DML)
permite leer, insertar, borrar y modificar la instancia. Un cambio de
teléfono, por ejemplo, es una sentencia UPDATE:
UPDATE customer SET phone = '999000111' WHERE dni = '48479833';UPDATE 1Hay dos estilos de DML:
- Procedural: el usuario dice qué datos quiere y cómo obtenerlos,
paso a paso. Es lo que hace
countByStatus: abrir cada archivo, recorrer cada fila, sumar. - Declarativo (o no procedural): el usuario dice qué datos quiere,
sin decir cómo obtenerlos. Es lo que hace
GROUP BY status.
SQL es declarativo. La consulta de los clientes de Arequipa no dice “recorre la tabla” ni “usa el índice”: dice qué filas se quieren, y el motor elige cómo. Esa elección la hace el optimizador de consultas (query optimizer), y por eso el mismo texto SQL pudo ejecutarse de dos formas distintas. Que el lenguaje sea declarativo es lo que hace posible la independencia física.
La parte del DML que solo lee se llama lenguaje de consultas (query language). Una consulta (query) es una sentencia que pide información:
SELECT name, city
FROM agency
WHERE region = 'Puno';
name | city
------------------+---------
Puno - Centro | Puno
Juliaca - Centro | Juliaca
(2 rows)SQL desde un programa
SQL no es un lenguaje de programación completo: no tiene, por ejemplo, forma
de leer lo que escribe el usuario ni de mostrar una ventana. Las aplicaciones
se escriben en un lenguaje de programación y le envían el SQL al DBMS. En
el curso ese lenguaje es JavaScript, con Node.js y el driver
pg. Un driver es la biblioteca que habla
el protocolo de red del DBMS.
import pg from 'pg';

const pool = new pg.Pool();
const { rows } = await pool.query(
  'SELECT count(*) AS n FROM shipment WHERE status = $1',
  ['delivered'],
);
console.log(rows[0], typeof rows[0].n);
await pool.end();
{ n: '11115' } stringDos detalles que van a ver en el laboratorio. Primero, $1 es un
parámetro: el valor 'delivered' viaja aparte del texto de la consulta.
En el curso siempre se escribe así, nunca pegando texto con +; la semana 5
explica por qué (inyección SQL). Segundo, el resultado de count(*) llega
como texto, '11115', y no como número. count(*) devuelve un bigint, un
entero de 64 bits, y un Number de JavaScript no puede representar todos esos
valores sin perder precisión, así que pg prefiere no convertirlo. Cuando
saben que el valor cabe, lo convierten con Number(...).
Diseño, motor, arquitectura y usuarios
Diseño de bases de datos
Antes de escribir CREATE TABLE hay que decidir qué tablas tener. El
diseño de una base de datos empieza por entender qué datos necesita la
organización (la especificación de requisitos), sigue con un diseño
conceptual, normalmente en el modelo E-R, y termina en un diseño
lógico (las tablas) y un diseño físico (índices, organización de
archivos). El esquema de Chasqui con el que empezamos tiene problemas de
diseño a propósito; en P1 lo endurecerán con restricciones y en P2 lo
rediseñarán con las herramientas de las semanas 6 y 7.
El motor por dentro
Por dentro, un DBMS tiene tres componentes grandes. Son también el mapa de la segunda mitad del curso.
| Componente | Qué hace | Semanas |
|---|---|---|
| Gestor de almacenamiento (storage manager) | Guarda los datos en archivos y páginas, los trae a memoria con el buffer manager, mantiene los índices y el diccionario de datos | 9 y 10 |
| Procesador de consultas (query processor) | Interpreta el DDL, traduce cada consulta a un plan de operaciones de bajo nivel, elige el plan más barato y lo ejecuta | 11 y 12 |
| Gestor de transacciones (transaction manager) | Garantiza la atomicidad y la durabilidad con el log, y controla la concurrencia | 13 a 15 |
El gestor de almacenamiento incluye, según Silberschatz, el authorization
and integrity manager (verifica permisos y restricciones), el file manager
(reserva espacio en disco), el buffer manager (decide qué páginas del disco
están en memoria) y el propio gestor de transacciones. El procesador de
consultas tiene el DDL interpreter, el DML compiler (que incluye la
optimización) y el query evaluation engine. En la semana 9 empezarán a
construir sus propias versiones de estas piezas en quipu.
Arquitectura cliente-servidor
PostgreSQL es un sistema cliente-servidor. El servidor es un programa
que corre todo el tiempo, administra los archivos de la base de datos y
ejecuta el SQL que le llega. Los clientes son los programas que se
conectan a él: psql, un script de Node.js, una aplicación web. El cliente no
abre los archivos de la base de datos: le envía SQL al servidor por una
conexión y recibe filas de vuelta.
Dentro del contenedor del curso se puede ver. Mientras un psql tiene una
consulta en curso, la lista de procesos del usuario postgres es esta:
$ ps -o pid,cmd -u postgres
  PID CMD
   19 /usr/lib/postgresql/18/bin/postgres -D /var/lib/postgresql/18/docker
   20 postgres: io worker 0
   21 postgres: io worker 1
   22 postgres: io worker 2
   23 postgres: checkpointer
   24 postgres: background writer
   26 postgres: walwriter
   27 postgres: autovacuum launcher
   28 postgres: logical replication launcher
 1039 postgres: postgres chasqui_w01 [local] SELECT
El proceso 19 es el servidor principal (en la documentación, postmaster).
Los siguientes son procesos auxiliares que corren siempre: los io worker
hacen lecturas de disco por cuenta de los demás (es la entrada y salida
asíncrona que trae PostgreSQL 18); el checkpointer, el background writer
y el walwriter llevan a disco los cambios y el log, temas de las semanas 9
y 15. El último, el 1039, es el que nos interesa: un proceso
servidor por cada conexión (en la documentación, backend). Su nombre dice
el usuario (postgres), la base de datos (chasqui_w01), que el cliente
llegó por un socket local ([local]) y qué está haciendo (SELECT). Cuando
el cliente se desconecta, ese proceso termina. Así lo explica
Architectural Fundamentals.
Desde psql, el meta-comando \conninfo muestra a qué base de datos y como
qué usuario están conectados; su fila Backend PID es justamente el número
del proceso servidor que atiende esa conexión.
Silberschatz distingue además entre aplicaciones de dos capas (two-tier), donde el programa del usuario se conecta directo al DBMS, y de tres capas (three-tier), donde el usuario habla con un servidor de aplicaciones y solo este se conecta a la base de datos. Las aplicaciones web son de tres capas. Los scripts de Node.js del curso son de dos.
Usuarios y administradores
Silberschatz clasifica a los usuarios según cómo usan el sistema: los usuarios finales (naive users), que usan aplicaciones sin saber que hay una base de datos detrás (el counter que registra un envío); los programadores de aplicaciones, que escriben esas aplicaciones (ustedes, en P2); y los usuarios avanzados (sophisticated users), que escriben consultas directamente, como un analista que prepara un reporte en SQL.
El administrador de la base de datos (database administrator, DBA) tiene el control central: define el esquema y la organización física, lo modifica cuando el negocio cambia, da permisos y se encarga del mantenimiento: backups, espacio en disco, rendimiento.
Para leer más. La sección 1.9 de Silberschatz cuenta la historia. El modelo relacional lo propuso Edgar F. Codd en IBM en 1970; los primeros sistemas relacionales fueron System R (IBM) e Ingres (Berkeley). De Ingres salió, en los años ochenta, el proyecto POSTGRES de Michael Stonebraker, que en 1996 se convirtió en PostgreSQL.
El modelo relacional
El modelo relacional describe una base de datos como una colección de
tablas. Su fuerza está en que es simple y, a la vez, tiene una definición
matemática precisa: eso es lo que permite que un motor optimice consultas y
garantice propiedades. En esta parte vemos esa definición, con la tabla
customer de Chasqui como ejemplo.
Relaciones, tuplas y atributos
En el vocabulario del modelo relacional, una tabla se llama relación
(relation), cada fila es una tupla (tuple) y cada columna es un
atributo (attribute). El nombre viene de las matemáticas: una tabla
representa una relación entre conjuntos de valores, y cada fila es una
lista de valores relacionados entre sí. Así se ven las primeras cinco tuplas
de customer:
 customer_id |   dni    | first_name |    last_name    |   phone   |   city
-------------+----------+------------+-----------------+-----------+----------
           1 | 61830975 | Wilmer     | Chávez Ríos     | 909975104 | Ayacucho
           2 | 17232205 | Piero      | García Castillo | 946039842 | Puno
           3 | 36948162 | Milagros   | Ramos Herrera   |           | Lima
           4 | 15433383 | Luz        | Rojas Salazar   | 967016439 | Tacna
           5 | 23448138 | Gladys     | Cruz Ccori      | 931723617 | Lima
(5 rows)
La tupla (1, 61830975, Wilmer, Chávez Ríos, 909975104, Ayacucho) dice que
el cliente 1 tiene ese DNI, se llama Wilmer Chávez Ríos, tiene ese teléfono y
vive en Ayacucho. El teléfono de la tercera tupla está vacío: es NULL, que
veremos en un momento.
Cada atributo tiene un dominio (domain): el conjunto de valores
permitidos. El dominio de customer_id son los enteros; el de dni, las
cadenas de exactamente 8 dígitos; el de city, los textos.
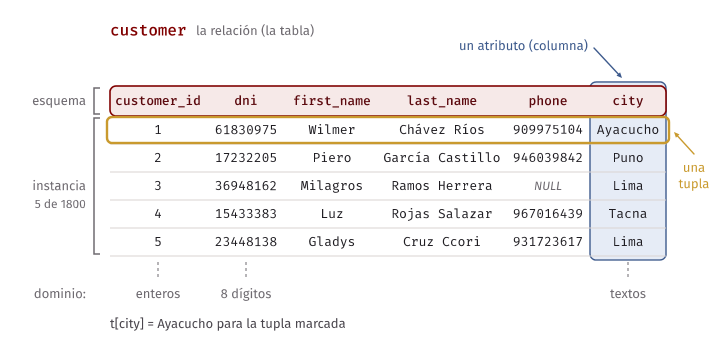
Con esto se puede dar la definición formal. Sean D₁, D₂, …, Dₙ los dominios de los atributos A₁, A₂, …, Aₙ. Una relación r sobre esos atributos es un subconjunto del producto cartesiano de los dominios:
r ⊆ D₁ × D₂ × … × DₙEs decir, cada tupla de r es una lista (v₁, v₂, …, vₙ) con cada
vᵢ ∈ Dᵢ, y la relación es un conjunto de esas listas. Si t es una
tupla y A un atributo, t[A] (o t.A) es el valor de t en ese
atributo: para la primera tupla de arriba, t[city] = Ayacucho.
Esquema de relación e instancia
Lo que vimos para la base de datos completa vale también para cada relación. El esquema de relación (relation schema) es la lista de atributos con sus dominios. Se escribe así:
customer(customer_id, dni, first_name, last_name, phone, city)La instancia de relación (relation instance) son las tuplas que tiene la
relación en un momento dado: las 1800 filas de hoy. Silberschatz usa letras
mayúsculas para el esquema y minúsculas para la instancia: r(R) significa
“la relación r, con esquema R”. Registrar un cliente nuevo cambia la
instancia de customer, no su esquema. Agregar una columna email cambia el
esquema.
En PostgreSQL, el esquema de una relación lo muestra \d:
chasqui=# \d customer
                   Table "public.customer"
   Column    |     Type     | Collation | Nullable | Default
-------------+--------------+-----------+----------+---------
 customer_id | integer      |           | not null |
 dni         | character(8) |           | not null |
 first_name  | text         |           | not null |
 last_name   | text         |           | not null |
 phone       | text         |           |          |
 city        | text         |           | not null |
Indexes:
    "customer_pkey" PRIMARY KEY, btree (customer_id)
    "customer_dni_key" UNIQUE CONSTRAINT, btree (dni)
Check constraints:
    "customer_dni_check" CHECK (dni ~ '^[0-9]{8}$'::text)
    "customer_phone_check" CHECK (phone ~ '^9[0-9]{8}$'::text)
Referenced by:
    TABLE "shipment" CONSTRAINT "shipment_recipient_id_fkey" FOREIGN KEY (recipient_id) REFERENCES customer(customer_id)
    TABLE "shipment" CONSTRAINT "shipment_sender_id_fkey" FOREIGN KEY (sender_id) REFERENCES customer(customer_id)
Las columnas con sus tipos son el esquema de la relación en el sentido del libro. El resto (índices, restricciones, quién la referencia) son restricciones y detalles físicos que iremos entendiendo.
Dominios atómicos
El modelo relacional exige que los dominios sean atómicos: un atributo
guarda un valor, que el modelo trata como indivisible. phone guarda un
teléfono, no una lista de teléfonos separados por comas. Si un cliente tiene
dos celulares, no se escribe '909975104,946039842' en una celda; se crea
otra relación, customer_phone(customer_id, phone), con una tupla por
teléfono. Es la idea que la semana 7 formaliza como primera forma normal.
Ojo con lo que significa “atómico”: depende del uso, no del tipo. Un DNI se
podría ver como 8 dígitos sueltos, pero Chasqui nunca consulta “el tercer
dígito del DNI”: lo usa entero. Para Chasqui es atómico. En cambio, si una
columna guardara 'Lima - La Victoria' y la empresa necesitara consultar
por separado la ciudad y el distrito, ese valor no se estaría usando como
atómico.
Una relación es un conjunto
Como una relación es un conjunto de tuplas, tiene dos propiedades que vale la pena decir en voz alta:
- No hay orden entre las tuplas. Las cinco filas de arriba salieron en ese
orden porque la consulta decía
ORDER BY customer_id. SinORDER BY, el motor puede devolverlas en cualquier orden, y ese orden puede cambiar de una ejecución a otra. Tampoco importa el orden de los atributos para el significado, porque cada valor va con su nombre. - No hay tuplas repetidas. Un conjunto no tiene elementos duplicados.
Las tablas de SQL se apartan de la segunda propiedad: son multiconjuntos
(bags), que sí admiten filas repetidas. La tabla customer no tiene filas
repetidas porque declara una clave, pero el resultado de una consulta puede
tenerlas. SELECT city FROM customer devuelve 1800 filas aunque solo haya 26
ciudades distintas:
SELECT count(*) AS rows, count(DISTINCT city) AS distinct_cities
FROM customer;
rows | distinct_cities
------+-----------------
1800 | 26
(1 row)En el modelo relacional, la proyección de customer sobre city sería un
conjunto de 26 tuplas. En SQL hay que pedirlo con DISTINCT. Esta diferencia
entre conjuntos y multiconjuntos la estudiamos con cuidado en la semana 2.
NULL, primera mirada
A veces un atributo no tiene valor. El modelo relacional usa un valor especial,
NULL, que significa “el valor es desconocido o no aplica”.
Chasqui tiene los dos casos:
customer.phoneesNULLcuando la empresa no conoce el teléfono del cliente. El cliente probablemente tiene uno; no lo sabemos.shipment.delivered_atesNULLcuando el envío todavía no se entregó. Ahí no es que no sepamos la fecha: es que todavía no hay fecha.
count(columna) cuenta solo los valores que no son NULL, lo que permite
ver cuántos hay:
SELECT count(*) AS customers, count(phone) AS with_phone
FROM customer;
customers | with_phone
-----------+------------
1800 | 1541
(1 row)De 1800 clientes, 1541 tienen teléfono: los otros 259 lo tienen en NULL. En
los envíos, la fecha de entrega y el viaje dependen del estado:
SELECT status, count(*) AS shipments, count(delivered_at) AS with_delivered_at,
       count(trip_id) AS with_trip
FROM shipment
GROUP BY status
ORDER BY status;
status | shipments | with_delivered_at | with_trip
------------+-----------+-------------------+-----------
delivered | 11115 | 11115 | 11115
in_transit | 66 | 0 | 66
registered | 500 | 0 | 0
returned | 319 | 0 | 319
(4 rows)Solo los envíos entregados tienen delivered_at. Los 500 envíos registrados
todavía no tienen viaje asignado: su trip_id es NULL.
NULL no es un valor como los demás: no es cero, ni la cadena vacía, ni
“falso”. Por eso complica muchas cosas, empezando por las comparaciones: en
SQL, phone = NULL no se usa para preguntar si falta el teléfono (se escribe
phone IS NULL). Las reglas completas de NULL son tema de la semana 3; el
consejo de Silberschatz para el diseño es evitarlo cuando se pueda. En
schema.sql, NOT NULL marca las columnas que no lo admiten.
En PostgreSQL.
psqlmuestraNULLcomo una celda vacía, que se confunde con la cadena vacía''. El meta-comando\pset null '∅'hace que se vea distinto. Pruébenlo en el laboratorio con la tercera fila decustomer.
El esquema de la base de datos
El esquema de la base de datos es el conjunto de los esquemas de sus relaciones. El de Chasqui tiene siete:
agency(agency_id, name, city, region)
customer(customer_id, dni, first_name, last_name, phone, city)
vehicle(vehicle_id, plate, kind, capacity_kg)
route(route_id, origin_agency_id, dest_agency_id, distance_km, base_fare)
trip(trip_id, route_id, vehicle_id, departure_at, arrival_at)
shipment(shipment_id, sender_id, recipient_id, origin_agency_id, dest_agency_id,
         trip_id, weight_kg, declared_value, price, status, created_at, delivered_at)
shipment_event(shipment_id, seq, at, agency_id, kind)
En palabras: Chasqui tiene agencias en distintas ciudades y clientes
que envían y reciben paquetes. Una ruta une una agencia de origen con
una de destino y tiene una distancia y una tarifa base. Un viaje es una
salida concreta de un vehículo (bus, camión o van) por una ruta, con su
hora de partida y de llegada. Un envío tiene un remitente y un
destinatario (los dos son clientes), una agencia de origen y una de destino,
su peso, su valor declarado, su precio y su estado; cuando se asigna a un
viaje, trip_id dice a cuál. Cada envío acumula eventos: recibido en la
agencia, salió, llegó, entregado o devuelto. El envío 1, por ejemplo:
 shipment_id | seq |           at           | agency_id |   kind
-------------+-----+------------------------+-----------+-----------
           1 |   1 | 2026-01-28 19:46:00-05 |         9 | received
           1 |   2 | 2026-02-02 12:00:00-05 |         9 | departed
           1 |   3 | 2026-02-02 16:30:00-05 |         8 | arrived
           1 |   4 | 2026-02-04 18:30:00-05 |         8 | delivered
(4 rows)
Las horas salen con -05 porque la base de datos usa la zona horaria de Lima.
Este es el esquema con el que trabajarán todo el semestre. No es perfecto, y
no por descuido: en P1 lo harán más estricto y en P2 lo ampliarán y
normalizarán.
Claves
Necesitamos una forma de distinguir una tupla de otra. Como en una relación no hay tuplas repetidas, dos tuplas distintas tienen que diferir en algún atributo. Las claves formalizan qué atributos bastan para distinguirlas.
Superclave
Sea R el esquema de una relación. Un conjunto de atributos K ⊆ R es una superclave (superkey) de R si, en toda instancia válida r de R, no hay dos tuplas distintas que coincidan en todos los atributos de K:
si t₁ ∈ r, t₂ ∈ r y t₁ ≠ t₂, entonces t₁[K] ≠ t₂[K]Dicho de otra forma: conocer los valores de K basta para saber de qué tupla
se habla. En customer:
{customer_id}es superclave: cada cliente tiene su propio número.{dni}es superclave: dos personas no tienen el mismo DNI.{customer_id, city}es superclave: si{customer_id}ya distingue las tuplas, agregarle atributos no puede hacer que deje de distinguirlas. En general, todo superconjunto de una superclave es superclave.- El conjunto de todos los atributos de
customeres superclave. Esto vale para cualquier relación del modelo: como no hay tuplas repetidas, dos tuplas distintas difieren en al menos un atributo. {first_name, last_name}no es superclave: dos clientes pueden llamarse igual. De hecho, en los datos de hoy ya pasa.
La frase “toda instancia válida” es la parte importante de la definición. Una superclave no es una observación sobre las filas que hay hoy: es una regla del negocio sobre todas las filas que podría haber. Que no haya dos clientes con el mismo DNI es cierto porque así funciona el DNI en el Perú, no porque hayamos mirado la tabla.
Clave candidata
{customer_id, city} es superclave, pero city sobra. Una clave
candidata (candidate key) es una superclave mínima: ninguno de sus
subconjuntos propios es superclave. En customer:
{customer_id}es clave candidata: su único subconjunto propio es el conjunto vacío, que no distingue nada (hay más de un cliente).{dni}es clave candidata, por la misma razón.{customer_id, city}no es clave candidata: su subconjunto{customer_id}ya es superclave.{dni, first_name}tampoco: es superclave, pero{dni}también lo es.
Una relación puede tener varias claves candidatas, y no tienen por qué ser
del mismo tamaño. “Mínima” quiere decir que no se le puede quitar ningún
atributo sin que deje de ser superclave; no quiere decir “la de menos
atributos”. En route hay dos claves candidatas de tamaños distintos:
{route_id} y {origin_agency_id, dest_agency_id}, porque entre dos
agencias hay a lo más una ruta en cada sentido. Ninguno de los dos atributos
de la segunda basta solo: de La Victoria (agencia 1) salen 14 rutas.
\d route muestra las dos:
Indexes:
    "route_pkey" PRIMARY KEY, btree (route_id)
    "route_origin_agency_id_dest_agency_id_key" UNIQUE CONSTRAINT, btree (origin_agency_id, dest_agency_id)
route_id | origin_agency_id | dest_agency_id | distance_km | base_fare
----------+------------------+----------------+-------------+-----------
1 | 1 | 7 | 555 | 33.00
2 | 7 | 1 | 555 | 33.00
3 | 1 | 11 | 368 | 24.50
(3 rows)Las rutas 1 y 2 tienen las mismas agencias en orden inverso: son rutas distintas, y por eso la clave es el par ordenado (origen, destino).
Clave primaria
La clave primaria (primary key) es la clave candidata que el diseñador
elige como forma principal de identificar las tuplas. En customer se
eligió {customer_id} y no {dni}. ¿Por qué? Silberschatz da el criterio:
la clave primaria debe ser un atributo cuyo valor no cambie nunca, o casi
nunca. Un DNI no cambia, pero se puede haber registrado mal. Y si mañana
Chasqui acepta clientes extranjeros, que tienen carné de extranjería o
pasaporte y no DNI, la columna dni tendrá que admitir NULL o cambiar de
dominio, algo que una clave primaria no puede hacer. Un número interno como
customer_id no significa nada fuera de la base de datos, así que nunca hay
razones para cambiarlo. Las demás claves candidatas no se
pierden: dni se declara UNIQUE, y el motor también la hace cumplir.
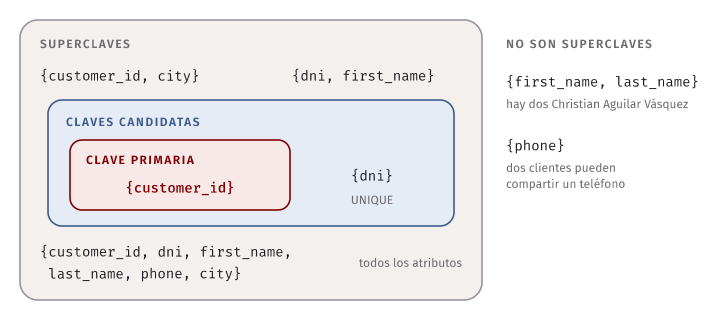
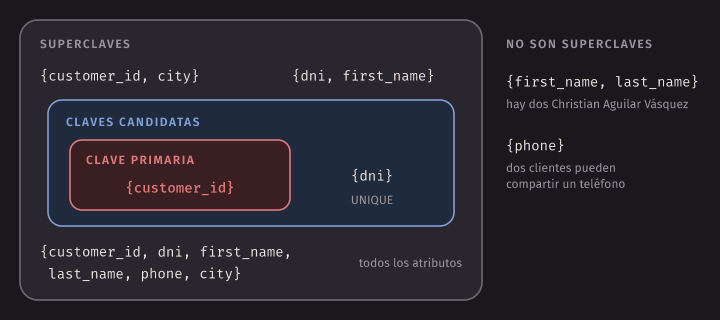
Por convención, los atributos de la clave primaria se escriben primero en el
esquema y se subrayan, como en el diagrama de esquema más abajo. En un
esquema escrito en texto, donde no se puede subrayar, los marcaremos con PK
cuando haga falta.
Una clave primaria puede tener más de un atributo; se dice que es
compuesta. En shipment_event la clave primaria es
(shipment_id, seq): el envío 1 tiene los eventos 1, 2, 3 y 4, y el envío 2
tiene sus propios eventos 1, 2, 3… Ni shipment_id solo ni seq solo
identifican un evento:
SELECT count(*) AS events, count(DISTINCT shipment_id) AS shipments,
       count(DISTINCT (shipment_id, seq)) AS distinct_pairs
FROM shipment_event;
events | shipments | distinct_pairs
--------+-----------+----------------
46421 | 12000 | 46421
(1 row)Hay 46 421 eventos de 12 000 envíos: muchos eventos comparten shipment_id.
Los pares (shipment_id, seq), en cambio, son tantos como los eventos.
En PostgreSQL.
PRIMARY KEYequivale aUNIQUEmásNOT NULLen cada atributo de la clave, y además marca la clave como la primaria (solo puede haber una por tabla). Para hacer cumplirPRIMARY KEYyUNIQUE, PostgreSQL crea automáticamente un índice B+ tree (btreeen la salida de\d): con él, verificar que un DNI nuevo no existe ya no exige recorrer la tabla. Es otro ejemplo de un detalle físico que el nivel lógico no ve.
Comprobar una clave con los datos
¿Cómo se comprueba con SQL si un conjunto de atributos es superclave? Se agrupan las filas por esos atributos y se buscan grupos con más de una fila:
SELECT dni, count(*)
FROM customer
GROUP BY dni
HAVING count(*) > 1;
dni | count
-----+-------
(0 rows)GROUP BY dni junta las filas que tienen el mismo DNI y HAVING count(*) > 1
se queda con los grupos de más de una fila. Ningún grupo: no hay dos clientes
con el mismo DNI. (GROUP BY y HAVING se estudian en la semana 3; por ahora
basta con leerlos así.) Con el nombre completo, en cambio:
SELECT first_name, last_name, count(*)
FROM customer
GROUP BY first_name, last_name
HAVING count(*) > 1
ORDER BY last_name, first_name
LIMIT 5;
first_name | last_name | count
------------+-----------------+-------
Christian | Aguilar Vásquez | 2
Piero | Apaza Huamán | 2
Julia | Ccahua Sánchez | 2
Christian | Ccori Ccahua | 2
Camila | Condori Cruz | 2
(5 rows)Hay dos Christian Aguilar Vásquez. En total, 1800 clientes tienen solo 1773 nombres completos distintos:
 rows | distinct_names
------+----------------
 1800 |           1773
(1 row)
Las dos consultas no dicen lo mismo, y es importante ver por qué.
- La segunda refuta que
{first_name, last_name}sea superclave: encontró dos tuplas distintas que coinciden en esos atributos. Una instancia válida con ese contraejemplo basta para descartarla. - La primera no demuestra que
{dni}sea superclave. Solo dice que la instancia de hoy no tiene un contraejemplo. Que{dni}es clave lo sabemos por el significado del DNI, y lo garantiza la restricciónUNIQUEdel esquema, no la consulta.
Error común. Deducir una clave a partir de los datos de hoy. Miren el teléfono:
SELECT phone, count(*)
FROM customer
WHERE phone IS NOT NULL
GROUP BY phone
HAVING count(*) > 1;
phone | count -------+------- (0 rows)Ningún teléfono se repite hoy. ¿Es
{phone}una clave? No: nada impide que dos clientes compartan un teléfono (una madre y su hija, una empresa con un solo número). El esquema no lo prohíbe, y lo podemos comprobar insertando un segundo cliente con el teléfono de Wilmer Chávez, dentro de una transacción que se deshace al final:BEGIN; INSERT INTO customer (customer_id, dni, first_name, last_name, phone, city) VALUES (1801, '00000001', 'Rosa', 'Chávez Ríos', '909975104', 'Ayacucho'); SELECT customer_id, dni, first_name, last_name, phone FROM customer WHERE phone = '909975104' ORDER BY customer_id; ROLLBACK;customer_id | dni | first_name | last_name | phone -------------+----------+------------+-------------+----------- 1 | 61830975 | Wilmer | Chávez Ríos | 909975104 1801 | 00000001 | Rosa | Chávez Ríos | 909975104 (2 rows)Una instancia válida con dos clientes y un solo teléfono. Una clave es una afirmación sobre todas las instancias válidas, no sobre la actual.
Hay un segundo detalle en esa consulta: el WHERE phone IS NOT NULL. Sin él,
el resultado es otro:
SELECT phone, count(*)
FROM customer
GROUP BY phone
HAVING count(*) > 1;
phone | count
-------+-------
| 259
(1 row)GROUP BY pone todos los NULL en un mismo grupo, y los 259 clientes sin
teléfono aparecen como un “teléfono repetido” 259 veces. No lo es: no sabemos
sus teléfonos, así que no sabemos si coinciden. Para la pregunta de si un
atributo se repite, los NULL hay que tratarlos aparte. Y para una clave
primaria la cuestión ni se plantea: sus atributos no pueden ser NULL,
porque un valor desconocido no sirve para identificar nada.
En PostgreSQL. Una restricción
UNIQUEconsidera distintos a dosNULL: siphonese declararaUNIQUE, se podrían seguir teniendo muchos clientes sin teléfono, y solo se rechazaría repetir un teléfono conocido. Ese es el comportamiento por defecto. Desde la versión 15, PostgreSQL permite pedir lo contrario conUNIQUE NULLS NOT DISTINCT.GROUP BY, en cambio, junta losNULLen un grupo. Las dos reglas conviven, y la semana 3 explica por qué.
El script keys.mjs automatiza esta prueba con
la función checkSuperkey, que cuenta por separado las filas con NULL y los
grupos repetidos:
customer, sobre los datos de hoy:
  {dni}: 0 filas con NULL, 0 grupos repetidos
  {first_name, last_name}: 0 filas con NULL, 27 grupos repetidos
  {phone}: 259 filas con NULL, 0 grupos repetidos
Lean esas tres líneas con lo que vimos: la primera no refuta {dni}, la
segunda refuta {first_name, last_name} y la tercera no refuta {phone},
aunque {phone} no sea clave.
Claves foráneas
Un envío tiene un remitente. En lugar de copiar sus datos en la fila (como en
el CSV), shipment guarda solo sender_id, el customer_id del remitente.
Para que eso tenga sentido, cada sender_id tiene que corresponder a un
cliente que existe. Esa regla es una clave foránea.
Silberschatz la define así. Una restricción de clave foránea (foreign-key
constraint) del atributo (o atributos) A de la relación r₁ hacia la
clave primaria B de la relación r₂ exige que, en toda instancia válida,
para cada tupla t₁ de r₁ exista una tupla t₂ de r₂ con
t₁[A] = t₂[B]. El atributo A es una clave foránea (foreign key)
de r₁; r₁ es la relación que referencia (referencing relation) y r₂
la relación referenciada (referenced relation). En Chasqui,
shipment.sender_id es una clave foránea que referencia a customer: cada
envío apunta a su remitente.
Ojo con el nombre: una clave foránea no tiene por qué ser una clave de la
relación que la tiene. sender_id no lo es: muchos envíos tienen el mismo
sender_id (Yolanda Torres envió 64), así que no identifica envíos. Lo que
referencia es una clave de la otra relación. A veces sí coincide con una
clave propia, o con parte de ella: en shipment_event, como veremos,
shipment_id es clave foránea y a la vez parte de la clave primaria.
El libro distingue además una restricción de integridad referencial (referential-integrity constraint), más general: exige que los valores de ciertos atributos de la relación que referencia aparezcan en ciertos atributos de alguna tupla de la referenciada, aunque estos no sean su clave primaria. La clave foránea es el caso particular en que los atributos referenciados son la clave primaria. A la propiedad de que las referencias apunten a algo que existe se le llama, en general, integridad referencial.
Una relación puede tener varias claves foráneas, incluso hacia la misma
relación. node keys.mjs las lee del catálogo e imprime, por ejemplo:
route: PK {route_id}  UNIQUE {origin_agency_id, dest_agency_id}
  dest_agency_id -> agency
  origin_agency_id -> agency
route tiene dos claves foráneas hacia agency, una para el origen y otra
para el destino. No basta con una porque son dos papeles distintos: una ruta
une dos agencias, y cada una de las dos tiene que existir. Lo mismo pasa
en shipment con el remitente y el destinatario, que son dos clientes. Y
shipment_event.shipment_id es a la vez parte de la clave primaria de
shipment_event y clave foránea hacia shipment: un evento solo existe como
evento de un envío.
Así se ve una tupla de shipment con todas sus referencias:
 shipment_id | sender_id | recipient_id | origin_agency_id | dest_agency_id | trip_id | weight_kg | declared_value | price |  status   |       created_at       |      delivered_at
-------------+-----------+--------------+------------------+----------------+---------+-----------+----------------+-------+-----------+------------------------+------------------------
           1 |       178 |          337 |                9 |              8 |     996 |     64.60 |        1453.00 | 88.17 | delivered | 2026-01-28 19:46:00-05 | 2026-02-04 18:30:00-05
(1 row)
El envío 1 lo mandó el cliente 178 al cliente 337, de la agencia 9 a la 8, en
el viaje 996. Para saber cómo se llama el cliente 178 hay que buscarlo en
customer; combinar tablas así es un join, la operación de la semana 2.
Integridad referencial en acción
El DBMS hace cumplir la clave foránea por los dos lados. No deja crear un envío cuyo remitente no existe:
chasqui=# INSERT INTO shipment (shipment_id, sender_id, recipient_id, origin_agency_id,
                      dest_agency_id, weight_kg, price, status, created_at)
VALUES (12001, 99999, 337, 9, 8, 2.5, 15.00, 'registered', now());
ERROR:  insert or update on table "shipment" violates foreign key constraint "shipment_sender_id_fkey"
DETAIL:  Key (sender_id)=(99999) is not present in table "customer".
Y no deja borrar una agencia a la que todavía apuntan otras filas:
chasqui=# DELETE FROM agency WHERE agency_id = 1;
ERROR:  update or delete on table "agency" violates foreign key constraint "route_origin_agency_id_fkey" on table "route"
DETAIL:  Key (agency_id)=(1) is still referenced from table "route".
Si lo dejara, las rutas que salen de La Victoria quedarían apuntando a una
agencia que no existe. (Se puede pedir otro comportamiento, como borrar
también las filas que la referencian; son las acciones ON DELETE de la
semana 4.) Las claves también se defienden. Un DNI repetido se rechaza con el
nombre de la restricción violada:
ERROR:  duplicate key value violates unique constraint "customer_dni_key"
DETAIL:  Key (dni)=(61830975) already exists.
Una clave primaria repetida da el mismo error con customer_pkey, y una
clave primaria NULL viola la restricción NOT NULL de customer_id.
Todas estas sentencias están en
constraints.sql; córranla con \i constraints.sql y lean cada mensaje. Los nombres como customer_dni_key o
shipment_sender_id_fkey los puso PostgreSQL al crear las restricciones
(tabla, columna y un sufijo). Por eso, cuando el mensaje de error importa, se
les da un nombre explícito con CONSTRAINT, como pide la guía de estilo del
curso.
Claves foráneas y NULL. shipment.trip_id es una clave foránea hacia
trip, pero admite NULL: los 500 envíos registrados todavía no tienen
viaje. En SQL, una clave foránea con valor NULL no se verifica: la
restricción solo exige que, si hay un valor, ese valor exista en trip. Un
trip_id NULL quiere decir “todavía no hay viaje”, no “el viaje
desconocido número tal”.
En PostgreSQL. Silberschatz define la clave foránea hacia la clave primaria de la relación referenciada. SQL y PostgreSQL son un poco más generosos: la columna referenciada puede ser la clave primaria o cualquier conjunto de columnas con una restricción
UNIQUE. Lo que no se puede es apuntar a algo que no sea una clave:chasqui=# CREATE TABLE complaint ( complaint_id integer PRIMARY KEY, city text REFERENCES customer (city) ); ERROR: there is no unique constraint matching given keys for referenced table "customer"Tiene sentido: si dos clientes viven en Lima, ¿a cuál de ellos apuntaría un reclamo con
city = 'Lima'? Cada valor no nulo de una clave foránea apunta a exactamente una tupla, y para eso lo referenciado tiene que ser una clave. Integridades referenciales más generales, como “toda ciudad de un reclamo debe ser la ciudad de algún cliente”, no se pueden declarar conREFERENCES.
Diagrama de esquema
Un diagrama de esquema (schema diagram) dibuja el esquema de la base de datos: cada relación es una caja con su nombre arriba y sus atributos debajo, los atributos de la clave primaria van subrayados, y cada clave foránea es una flecha desde el atributo que referencia hasta la clave primaria de la relación referenciada. Este es el de Chasqui:
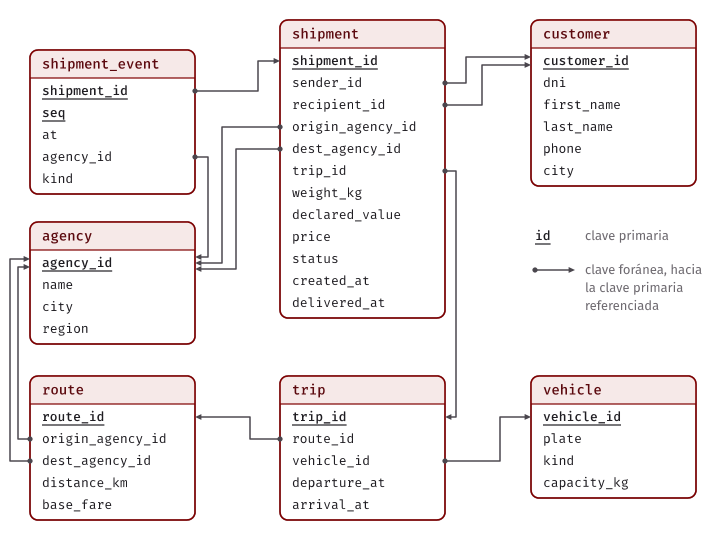
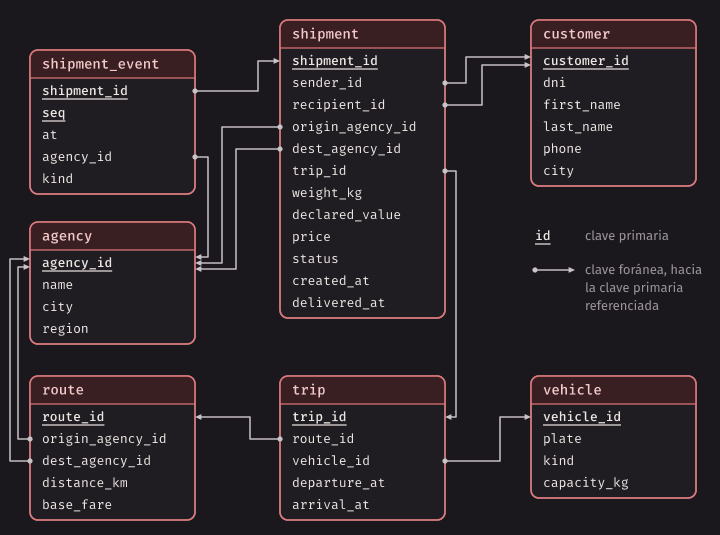
En el laboratorio cada uno lo dibuja a partir de \d. Fíjense en tres cosas. Hay once flechas en total,
porque hay once claves foráneas. Cada flecha llega a la clave primaria de la
relación referenciada; en shipment_event, además, una flecha sale de un
atributo que es parte de la clave primaria. Y el diagrama no
muestra la otra clave candidata de route, {origin_agency_id, dest_agency_id}, ni las restricciones CHECK: un diagrama de esquema
muestra claves primarias y foráneas, no todas las restricciones.
Idea clave. Comparen el diagrama con el CSV del principio. En el CSV, cada envío llevaba copiados el nombre y el teléfono del remitente. En el esquema relacional, el envío solo guarda
sender_id, y los datos del cliente están una vez, encustomer. La clave foránea es la que permite separar los datos sin perder la conexión entre ellos, y la integridad referencial es la que garantiza que esa conexión no apunte al vacío.
El código de la semana y make test
La carpeta code/week-01 tiene:
examples.sql: las consultas de estos apuntes, en orden. Lo que modifica algo va entreBEGINyROLLBACK.constraints.sql: las sentencias que fallan a propósito, una por restricción.files.mjs: Chasqui con archivos CSV.keys.mjs: las claves de cada tabla, leídas del catálogo, y la funcióncheckSuperkey.files.test.mjsykeys.test.mjs: las pruebas.
Dentro del contenedor del curso:
$ cd code/week-01
$ make test
chasqui-load chasqui_w01
Base de datos chasqui_w01 lista.
== examples.sql
psql -X -q -v ON_ERROR_STOP=1 -d chasqui_w01 -f examples.sql > /dev/null
== files.mjs
PGDATABASE=chasqui_w01 node files.mjs
28 archivos, 12000 filas en total
...
== keys.mjs
PGDATABASE=chasqui_w01 node keys.mjs
...
PGDATABASE=chasqui_w01 node --test --test-reporter=spec
✔ un archivo por agencia de origen, con todos los envíos
✔ countByStatus (un programa nuevo) coincide con GROUP BY (una consulta)
...
✔ peso negativo: 23514 en shipment_weight_kg_check
✔ una clave foránea debe apuntar a una clave: 42830
✔ trip_id NULL no se verifica: los envíos registrados no tienen viaje
✔ trip_id que no existe: 23503 en shipment_trip_id_fkey
✔ count(*) llega como texto: bigint no siempre cabe en un Number
ℹ tests 26
ℹ suites 0
ℹ pass 26
ℹ fail 0
make crea la base de datos chasqui_w01 con los datos de ejemplo (es una
copia: los cambios que hagan ahí no tocan chasqui). make test la vuelve a
crear, corre examples.sql con psql (si alguna sentencia falla, se
detiene), ejecuta los dos scripts y luego las pruebas con el runner de Node
(node --test). Las pruebas verifican lo que afirman estos apuntes: qué
claves declara cada tabla, qué conjuntos refutan los datos y qué error da cada
violación. Comparan los errores por su código SQLSTATE (23505 para UNIQUE,
23503 para claves foráneas, 23514 para CHECK, 23502 para NOT NULL)
y por el nombre de la restricción, no por el texto del mensaje. Las pruebas
que modifican datos lo hacen dentro de una transacción que termina en
ROLLBACK. make clean borra chasqui_w01.
files.mjs escribe sus archivos CSV en una carpeta temporal del sistema y la
borra al terminar; no deja nada en la carpeta del curso.
Resumen
- Un DBMS guarda una colección de datos relacionados y da acceso a ella de forma conveniente y eficiente. Frente a archivos manejados por programas propios, evita la redundancia y la inconsistencia, responde preguntas nuevas con consultas, verifica restricciones de integridad, ejecuta transacciones atómicas, controla el acceso concurrente y la seguridad.
- Un modelo de datos describe datos, relaciones, significado y restricciones: relacional, E-R, semiestructurado, basado en objetos.
- Hay tres niveles de abstracción: físico, lógico y de vistas. La independencia física permite cambiar el almacenamiento (por ejemplo, agregar un índice) sin reescribir las consultas.
- El esquema es el diseño y cambia poco; la instancia es el contenido en un momento dado y cambia siempre.
- El DDL define el esquema y sus restricciones, que el DBMS guarda en el diccionario de datos. El DML consulta y modifica. SQL es declarativo: dice qué se quiere y el optimizador decide cómo.
- El motor tiene un gestor de almacenamiento, un procesador de consultas y un gestor de transacciones. PostgreSQL es cliente-servidor, con un proceso servidor por conexión.
- Una relación es un conjunto de tuplas; cada atributo toma valores de un dominio atómico. No hay orden entre tuplas ni tuplas repetidas; las tablas de SQL, en cambio, son multiconjuntos.
NULLsignifica “desconocido o no aplica”. No es un valor como los demás y no puede estar en una clave primaria.- Una superclave identifica a cada tupla en toda instancia válida. Una clave candidata es una superclave mínima. La clave primaria es la candidata elegida, idealmente un valor que no cambia.
- Una consulta con
GROUP BY ... HAVING count(*) > 1sobre los datos de hoy puede refutar una clave, nunca demostrarla. - Una clave foránea obliga a que cada valor apunte a una tupla que existe
en la relación referenciada (integridad referencial). No tiene por qué
ser una clave de su propia relación. Si es
NULL, no se verifica. - Un diagrama de esquema muestra relaciones, claves primarias subrayadas y una flecha por clave foránea.
Ejercicios
- Den tres problemas concretos que tendría Chasqui si guardara sus envíos en
un archivo CSV por agencia, distintos de los ejemplos de
files.mjs. Para cada uno, digan qué parte de un DBMS lo resuelve. - En
files.mjs, la funciónupdatePhonecorrige el teléfono de un cliente en un solo archivo. Escriban una versión que lo corrija en todos. ¿Resuelve eso la inconsistencia? ¿Qué pasa si se va la luz después de corregir 10 de los 25 archivos? ¿Qué pasa si dos agencias corrigen el mismo teléfono al mismo tiempo, con números distintos? - Para cada uno de estos cambios, digan si es un cambio del esquema físico,
del esquema lógico o de la instancia: (a) registrar un envío nuevo;
(b) crear un índice sobre
shipment(status); (c) agregar acustomeruna columnaemail; (d) cambiar el teléfono de un cliente; (e) mover los archivos de la base de datos a un disco más rápido. ¿Cuáles obligarían a reescribir alguna consulta existente? - Escriban en
psqluna consulta que cuente los envíos que salieron de la agencia 1. Miren su plan conEXPLAIN (COSTS OFF). Dentro de una transacción, creen un índice sobreshipment(origin_agency_id), vuelvan a ejecutar la consulta y elEXPLAIN, y terminen conROLLBACK. ¿Cambió el resultado? ¿Cambió el plan? - En
customer, ¿{dni, first_name}es superclave? ¿Es clave candidata? ¿Y{customer_id, dni}? Justifiquen con las definiciones, no con los datos. - ¿Cuántas superclaves tiene una relación con esquema
R(A, B, C)si su única clave candidata es{A}? ¿Y si sus claves candidatas son{A}y{B}? Escríbanlas todas. - Usen
GROUP BYyHAVINGpara averiguar si los datos de hoy refutan que{plate}sea superclave devehicley que{name}lo sea deagency. Hagan lo mismo con{city}enagency. ¿Qué pueden concluir en cada caso, y qué no? - En
trip, ¿creen que{route_id, departure_at}debería ser una clave candidata? ¿Y{vehicle_id, departure_at}? Piensen qué significa cada una para el negocio antes de mirar los datos; después comprueben con una consulta si los datos de hoy refutan alguna. Si una regla que ustedes consideran válida está refutada por los datos, ¿qué dice eso de los datos? - En los datos de hoy,
{shipment_id, kind}no se repite enshipment_event. Compruébenlo con una consulta. ¿Es una clave candidata? Describan una situación real de Chasqui en la que un envío tenga dos eventos del mismo tipo. - Escriban el
INSERTde un envío cuyo destinatario no existe y elDELETEde un cliente que tiene envíos. Antes de ejecutarlos, escriban qué restricción esperan que se viole; después comparen con el mensaje de PostgreSQL. - Chasqui quiere guardar los reclamos de sus clientes: cada reclamo es de un
envío, lo presenta un cliente y lo atiende una agencia. Escriban el
esquema de la relación
complaint, marquen su clave primaria y sus claves foráneas, y agréguenla al diagrama de esquema. ¿El cliente que reclama tiene que ser el remitente del envío? ¿Se puede expresar esa regla con una clave foránea? - Usen
checkSuperkeydekeys.mjsdesde un script propio para probar{origin_agency_id, dest_agency_id}enshipment. ¿Qué devuelve? ¿Por qué ese par es clave candidata enroutepero no tiene por qué serlo enshipment? Expliquen también por quécheckSuperkeyno recibe el nombre de la tabla como parámetro$1.